當您同時擁有獨立運作的語意搜尋(向量嵌入)和詞彙搜尋(BM25)時,下一步就是將它們結合成一個統一的搜尋管線。這種混合方法利用兩種方法的優勢,以提供更準確的結果。
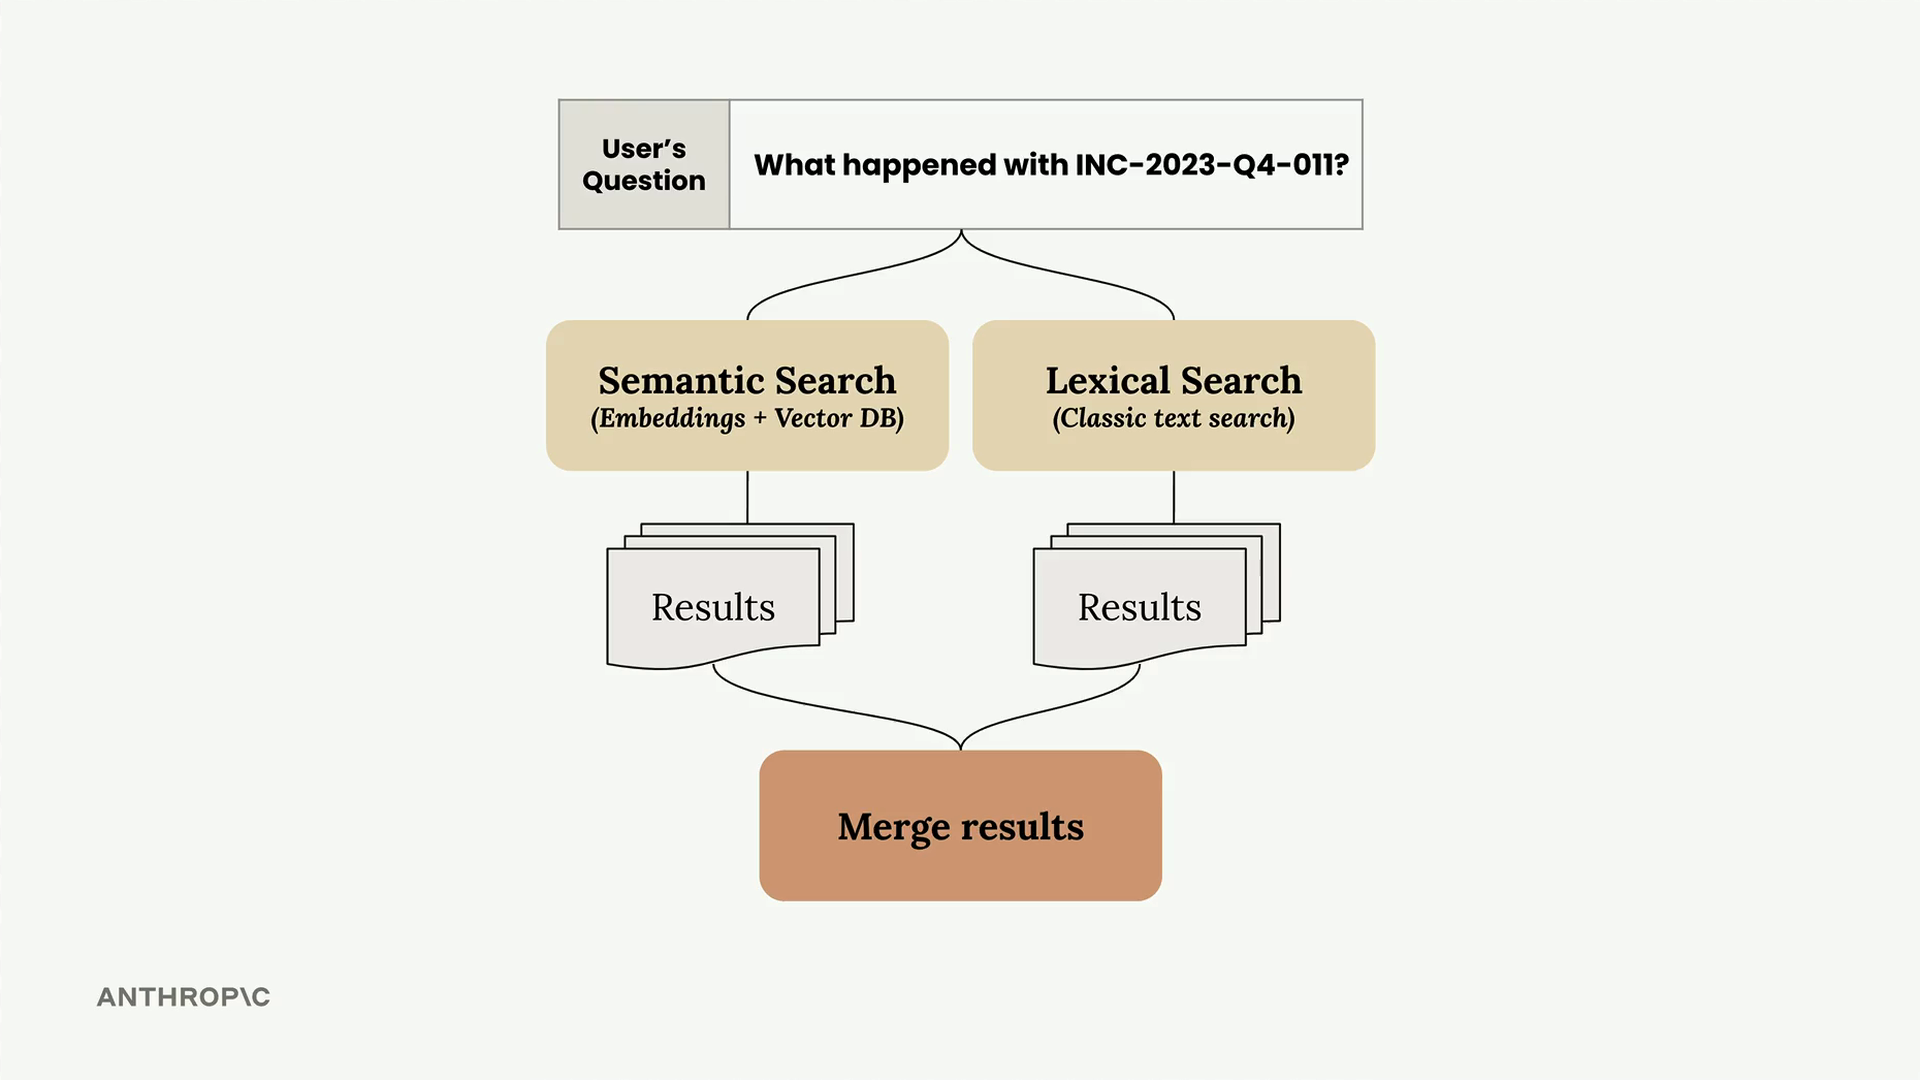
建立統一介面
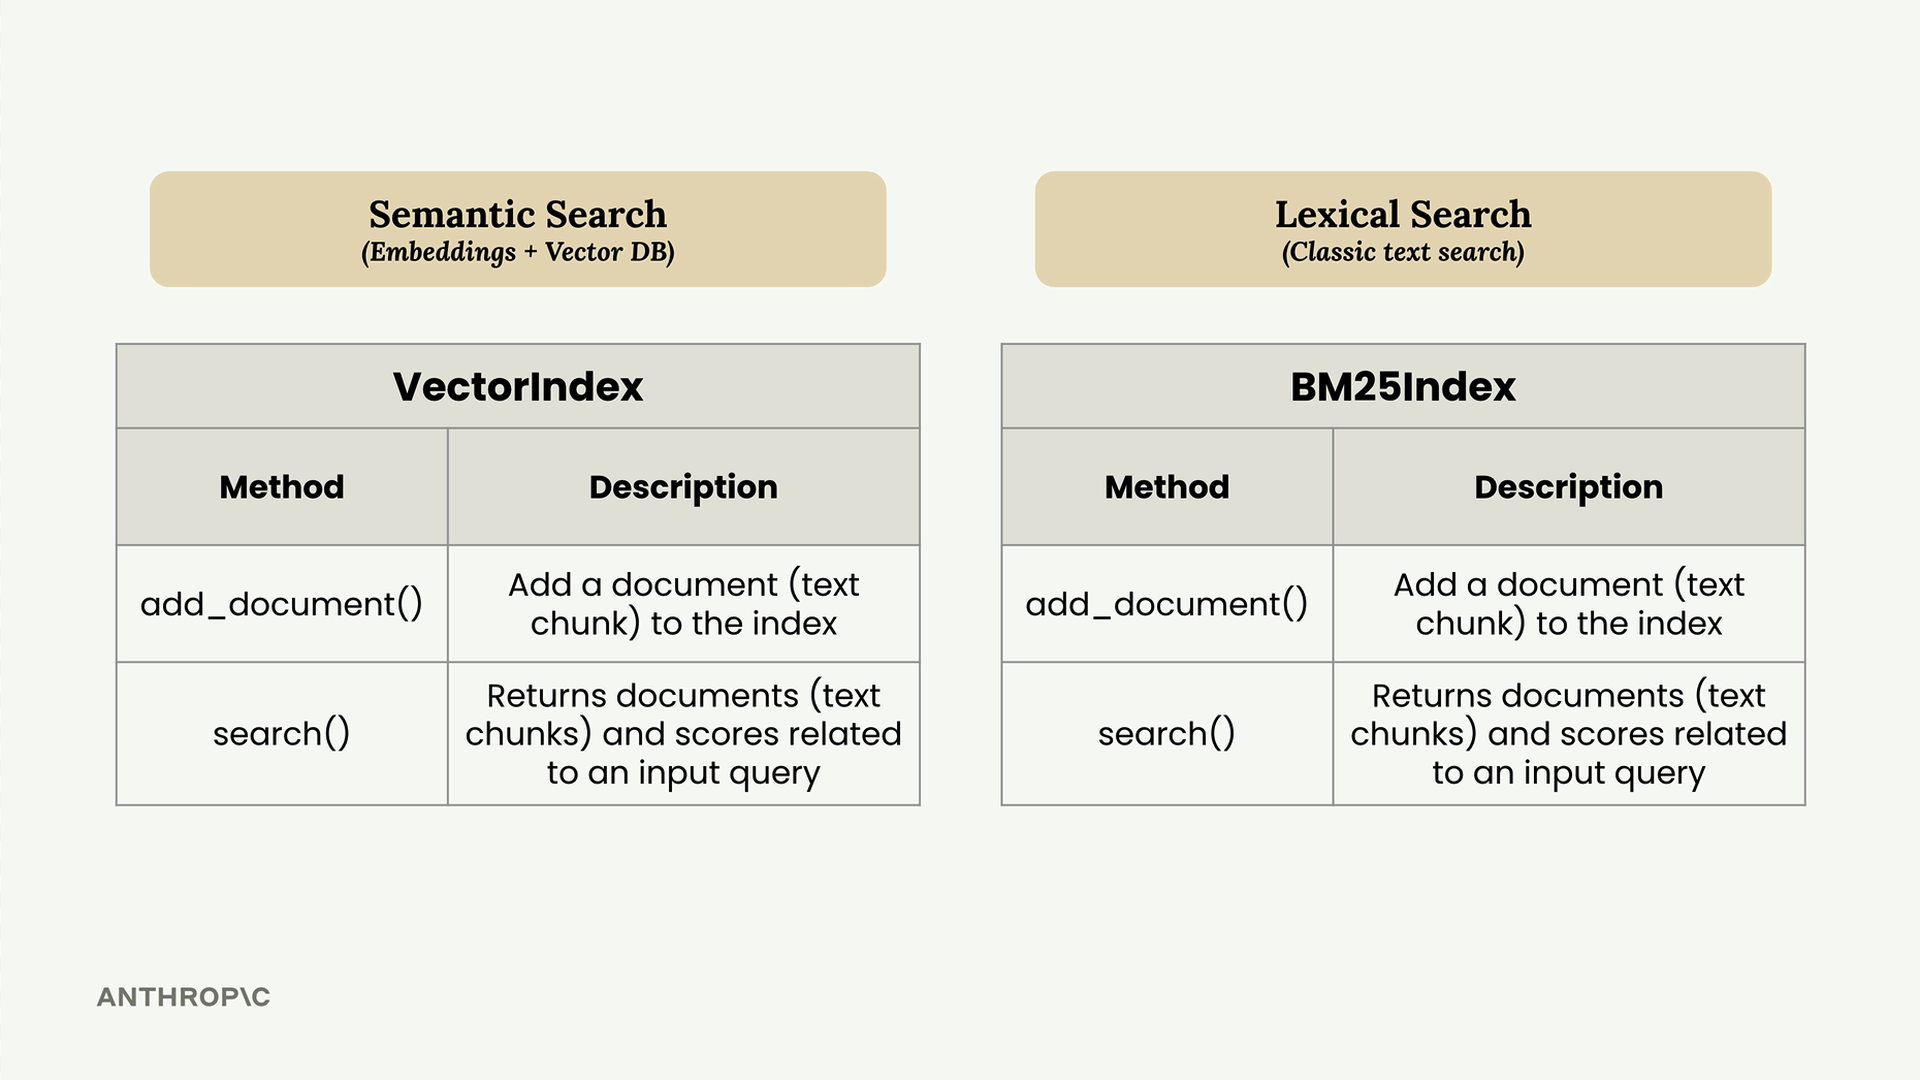
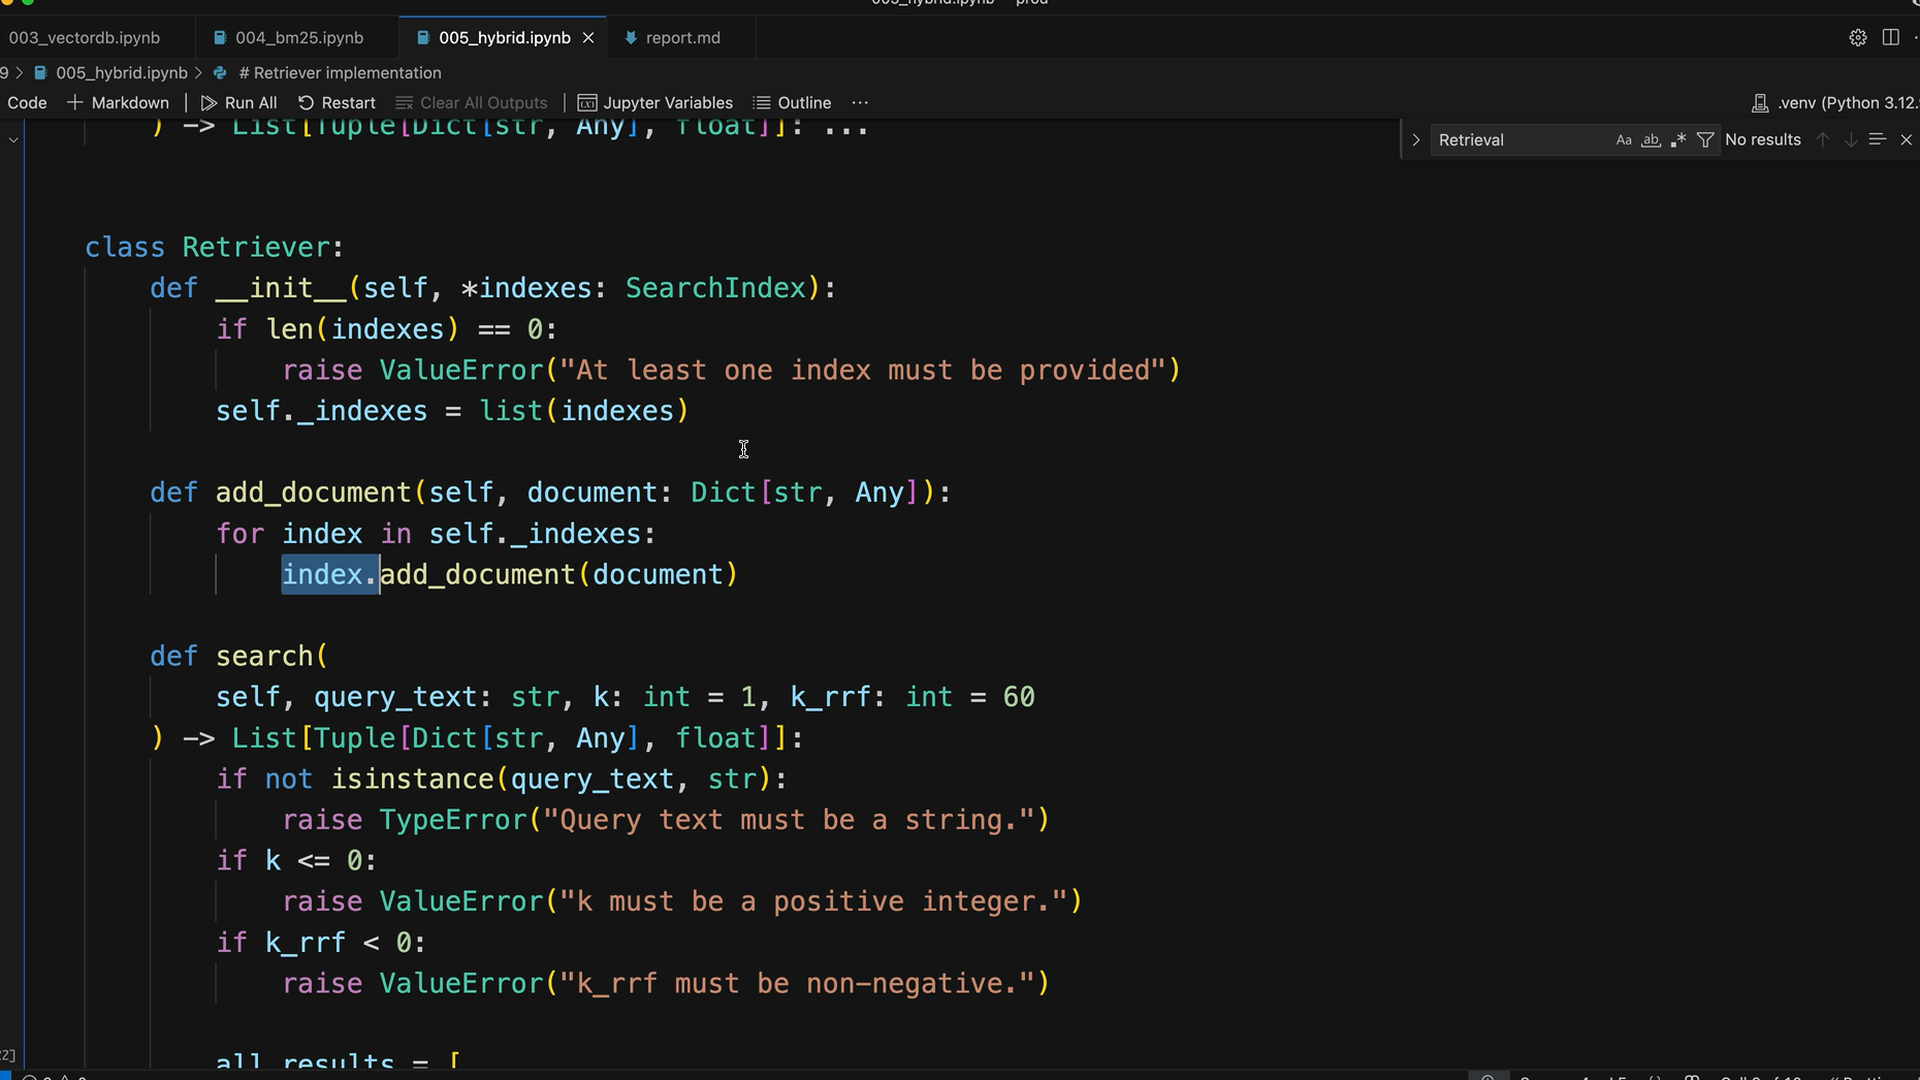
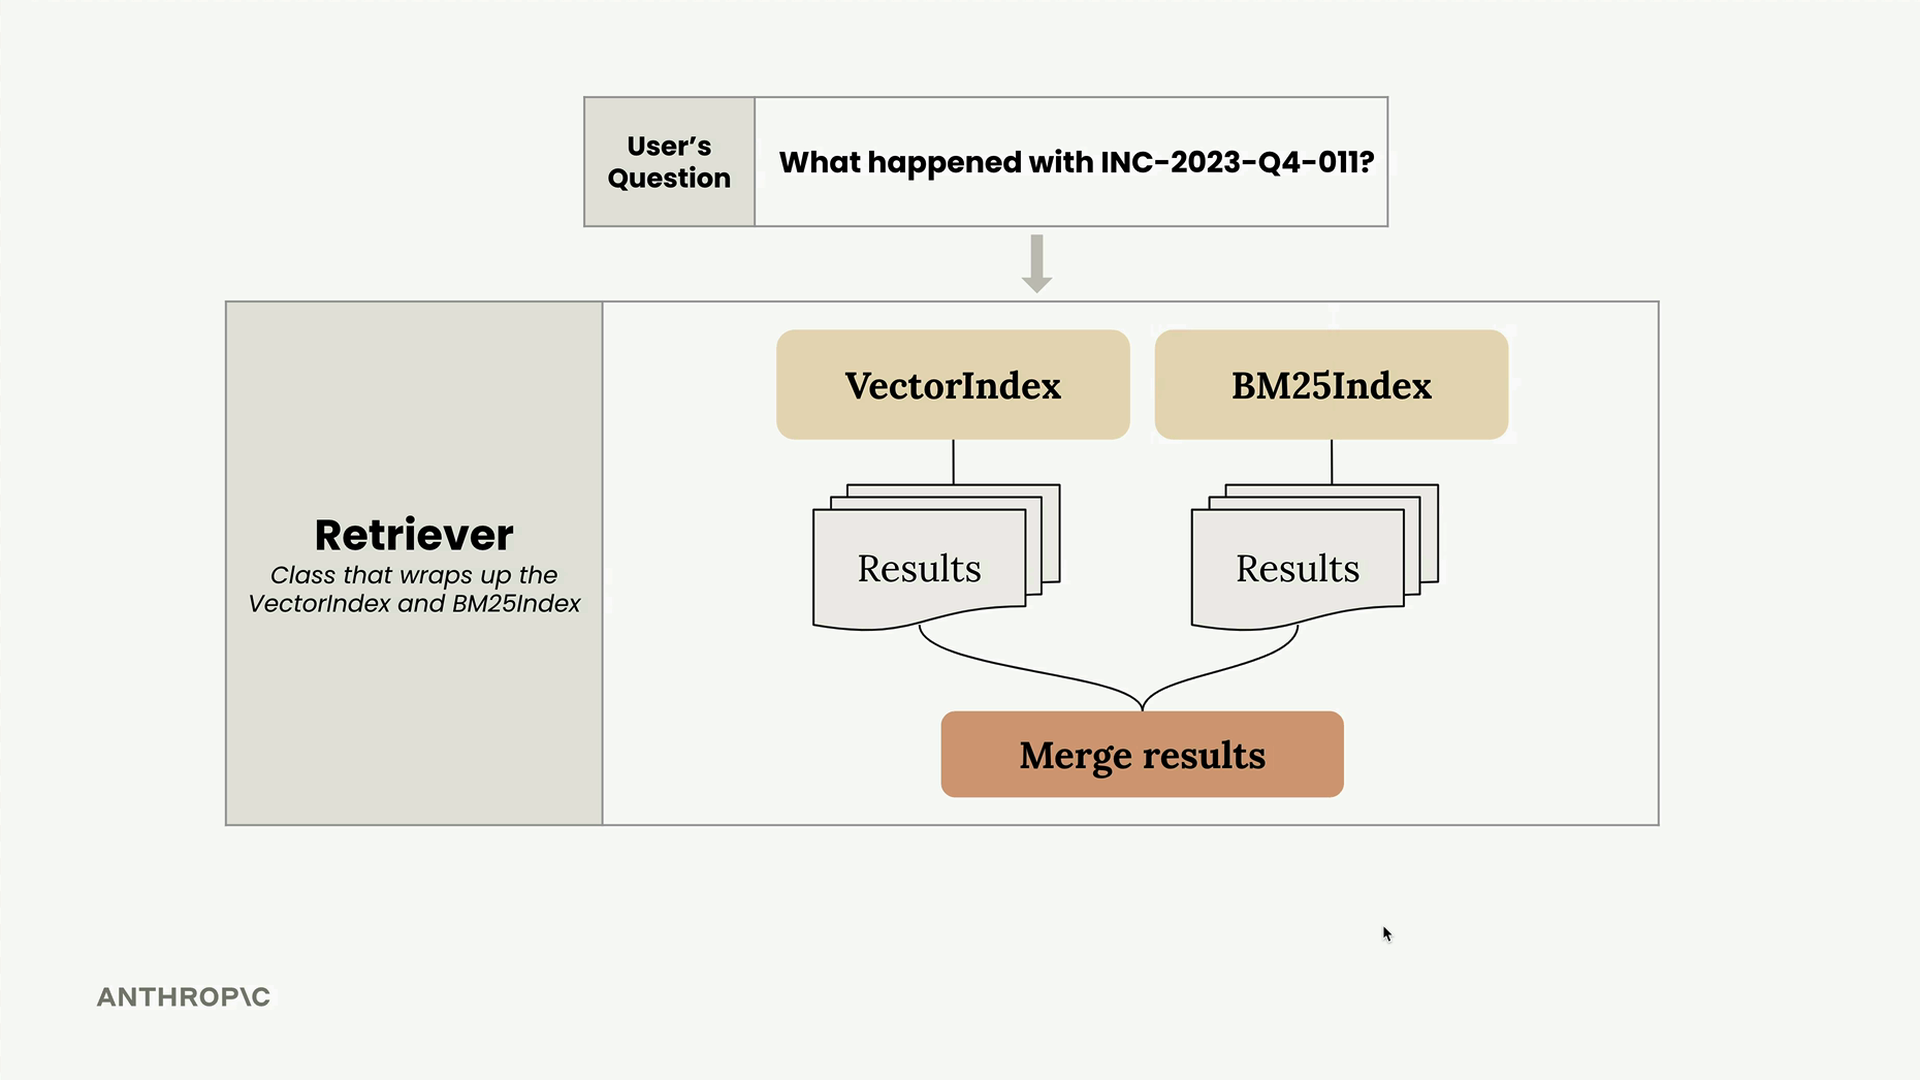
兩種搜尋實作共享幾乎相同的 API——它們都有以相同方式運作的 add_document() 和 search() 方法。這種一致性使得將它們包裝在單一的 Retriever 類別中變得簡單直接。
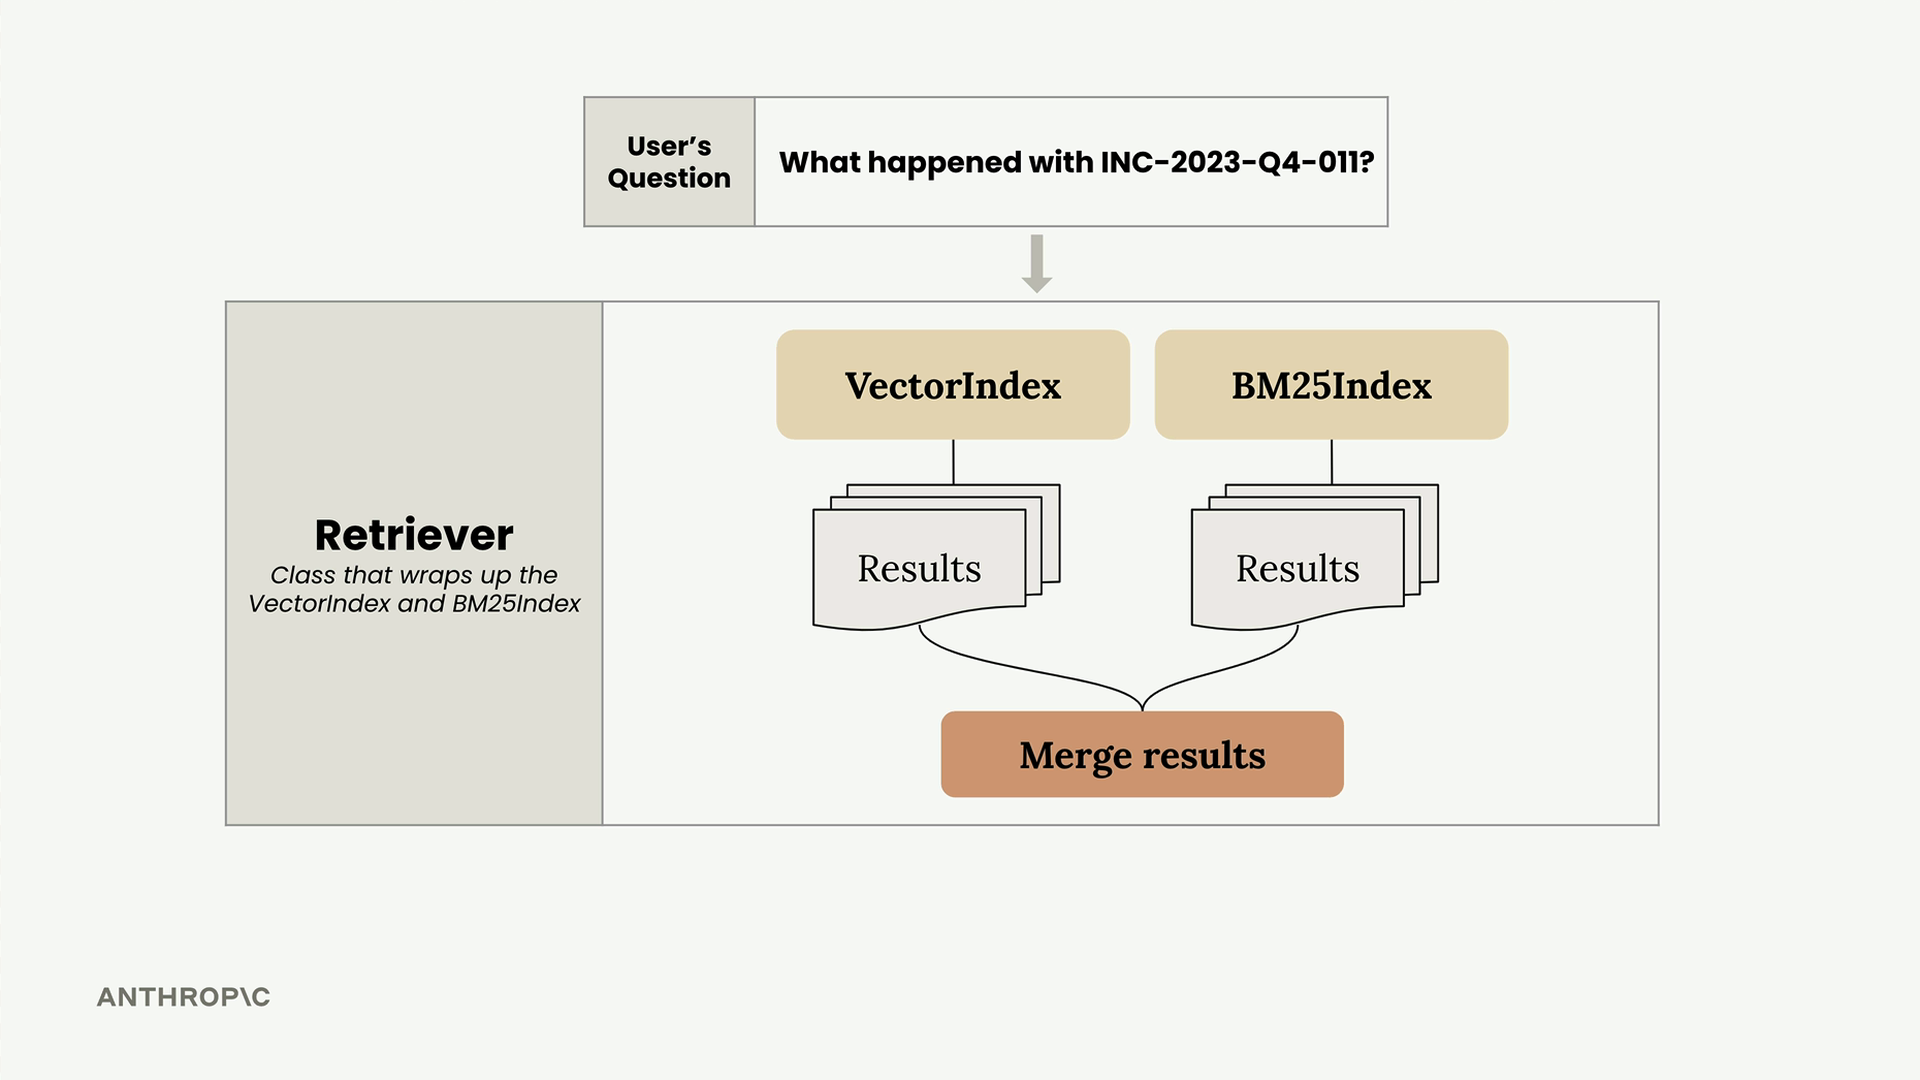
Retriever 扮演協調者的角色,將使用者查詢轉發給兩個索引,收集它們的結果,並將其合併成單一的排名列表。
倒數排名融合(Reciprocal Rank Fusion)
挑戰在於合併來自使用不同評分系統的不同搜尋方法的結果。向量搜尋回傳餘弦相似度分數,而 BM25 回傳相關性分數——您無法直接簡單地合併這些數字。
因此,我們使用一種稱為倒數排名融合(Reciprocal Rank Fusion,RRF)的技術。這種方法著重於結果的排名位置,而非其原始分數。
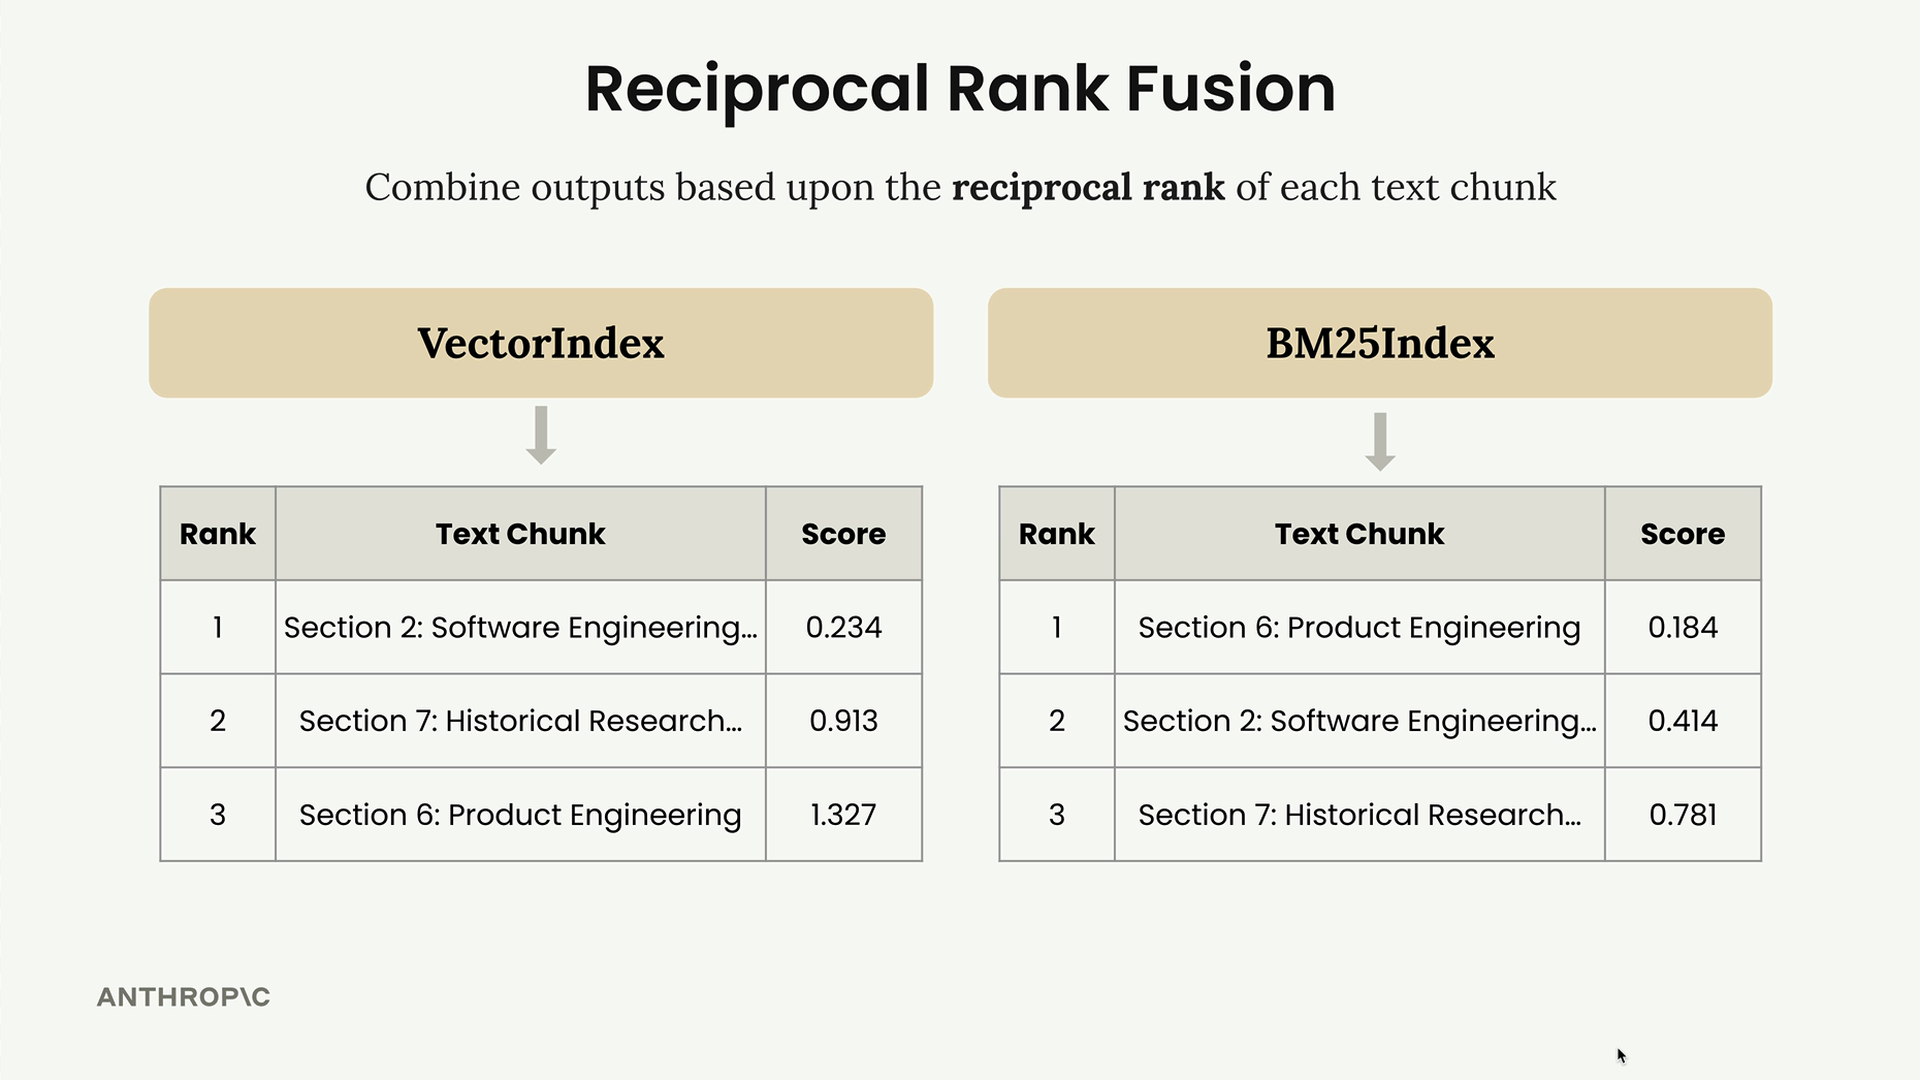
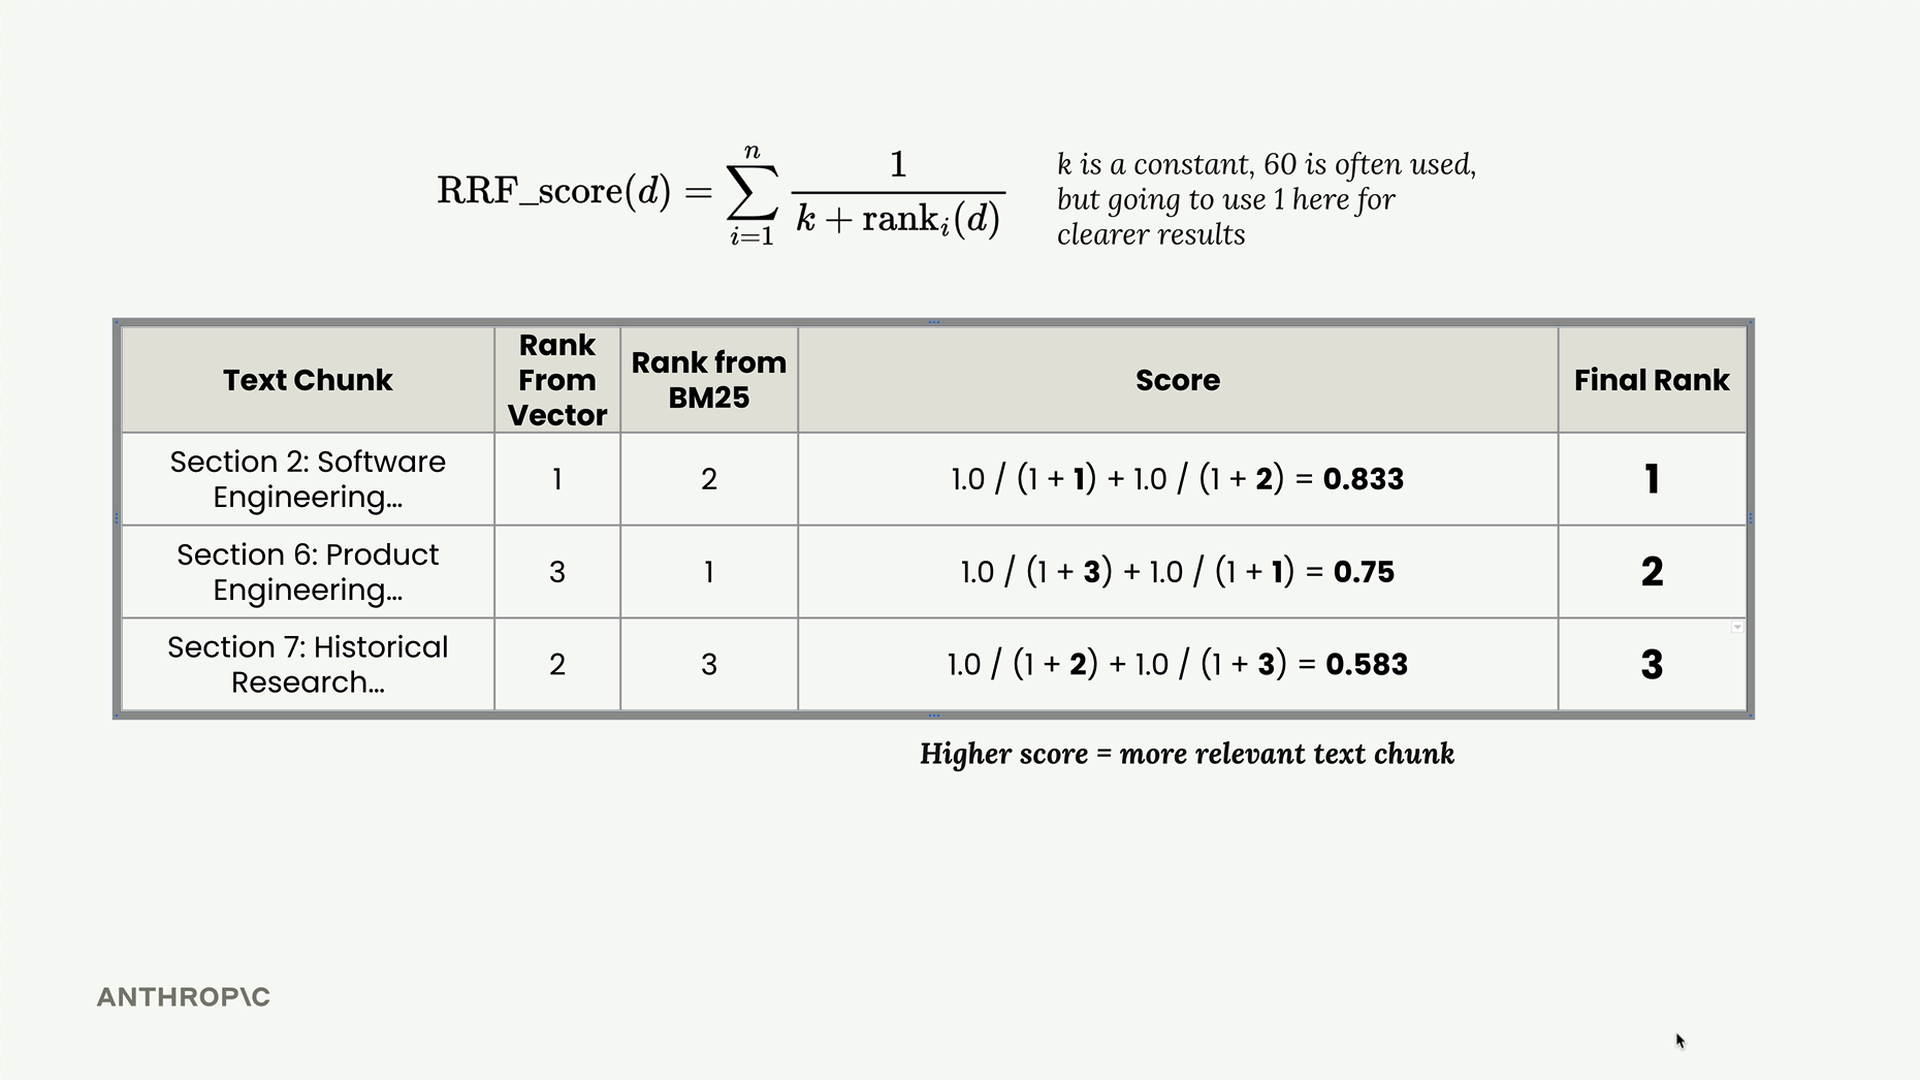
以下透過一個範例說明其運作方式。假設您的向量搜尋依序回傳第 2、7、6 節,而 BM25 回傳第 6、2、7 節。要合併這些結果:
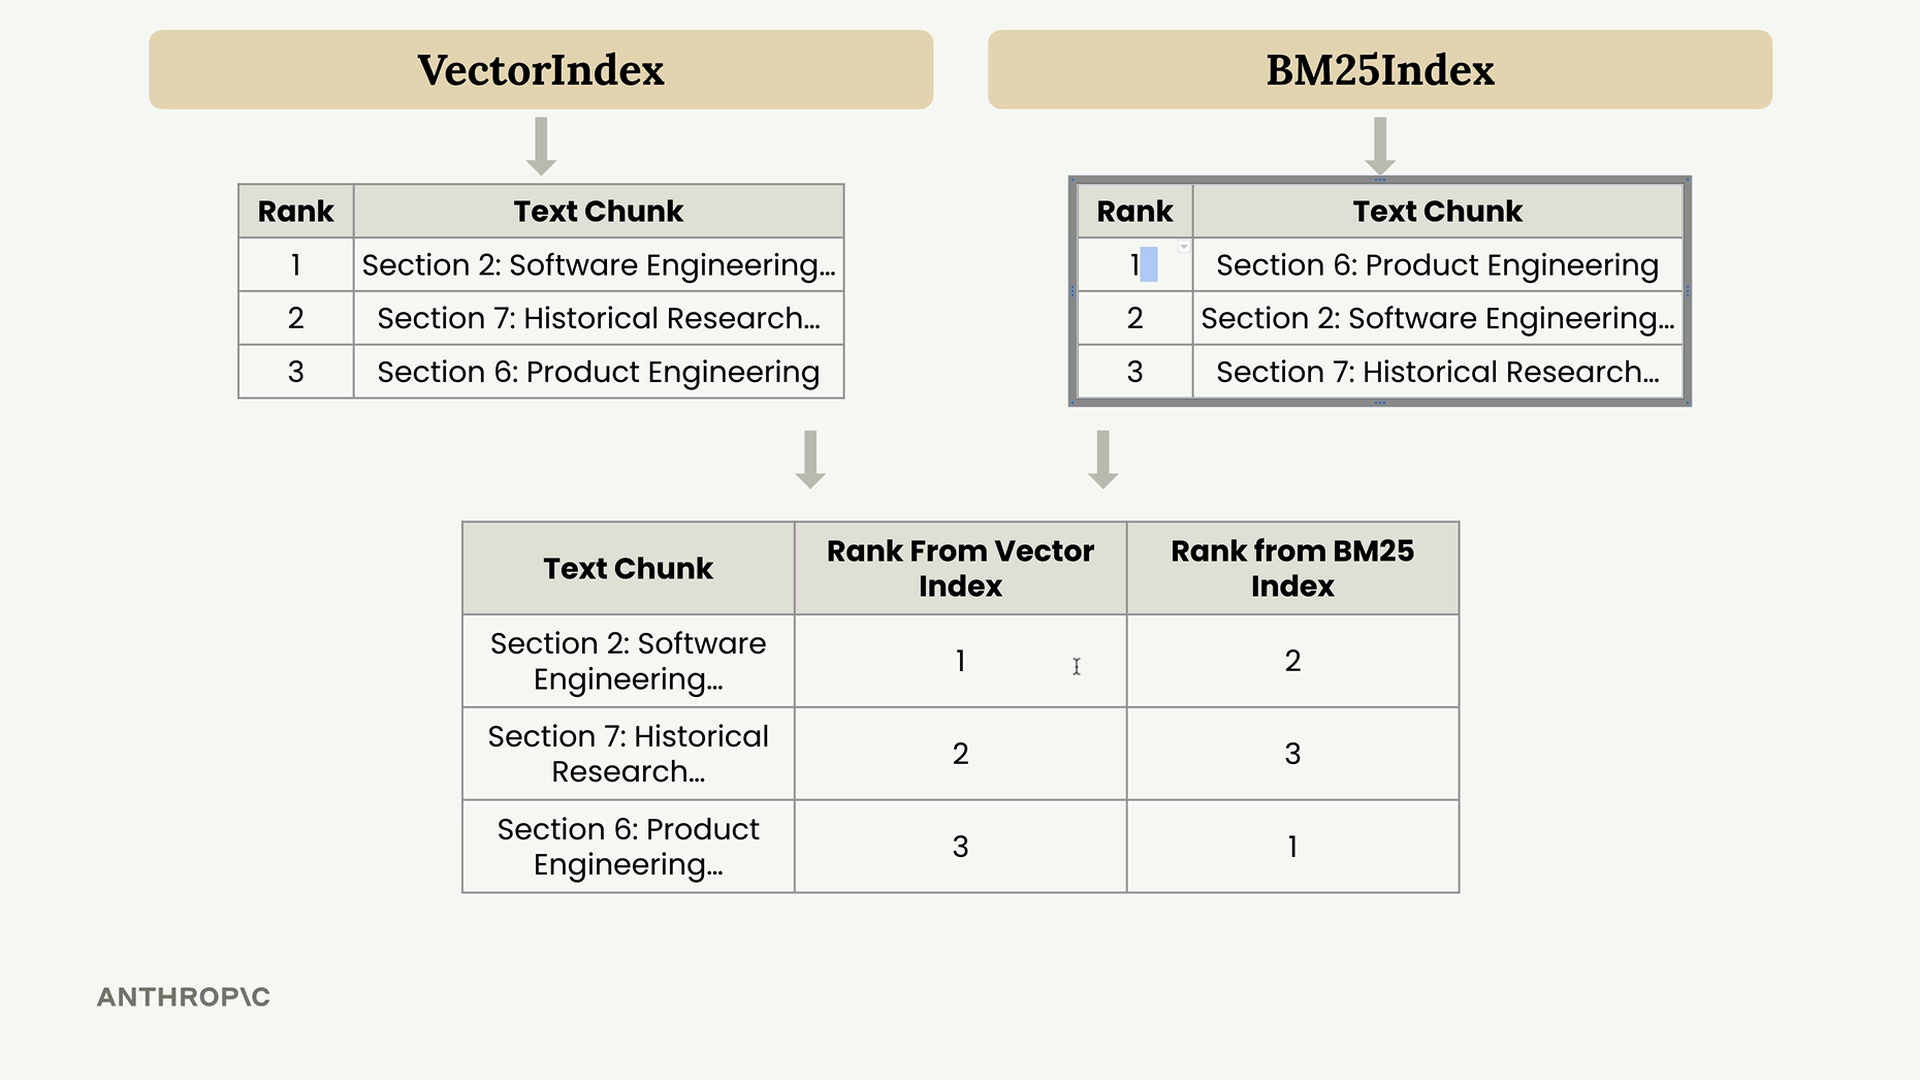
首先,建立一個表格,顯示每個文字區塊及其在兩種搜尋方法中的排名:
- 第 2 節:向量排名 1,BM25 排名 2
- 第 7 節:向量排名 2,BM25 排名 3
- 第 6 節:向量排名 3,BM25 排名 1
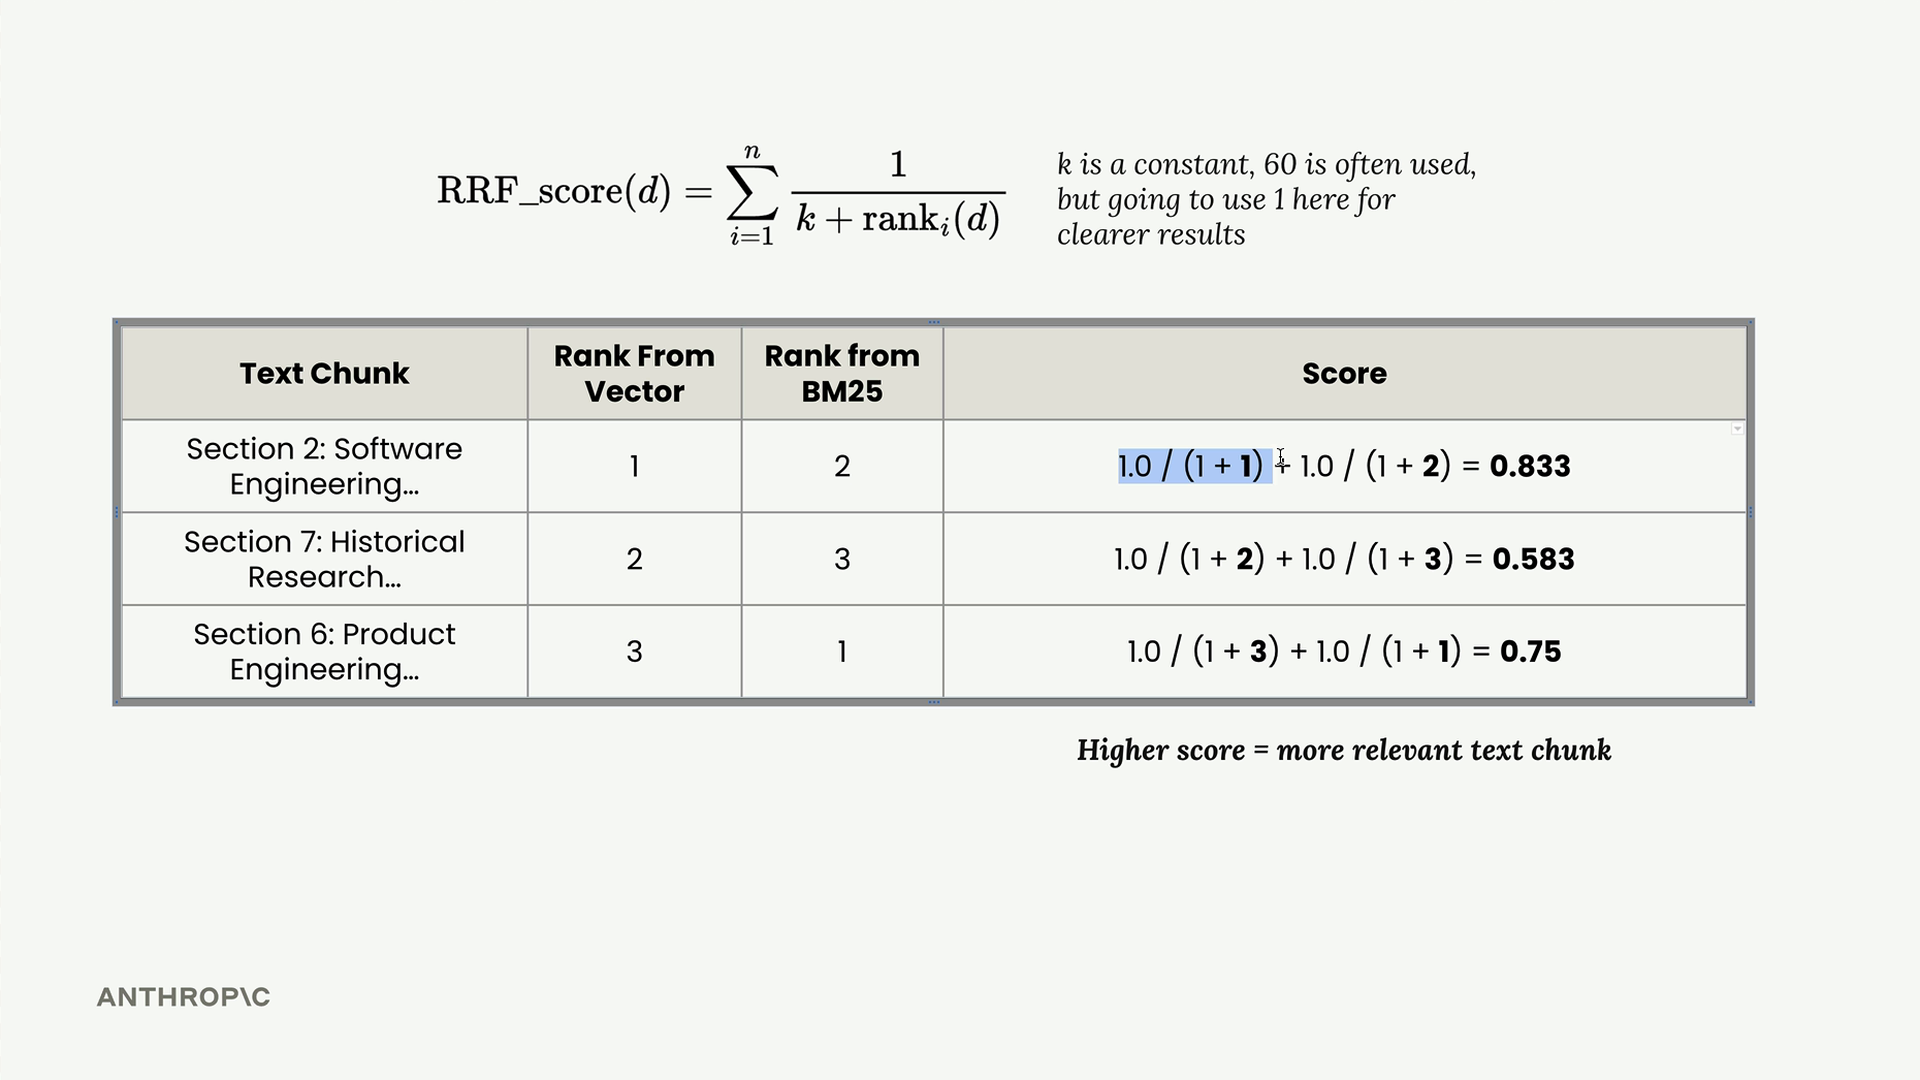
然後套用 RRF 公式來計算每個區塊的綜合分數:
RRF_score(d) = Σ(1 / (k + rank_i(d)))其中 k 是一個常數(通常為 60,但我們將使用 1 以獲得更清晰的結果),而 rank_i(d) 是文件 d 在第 i 個搜尋結果中的排名。
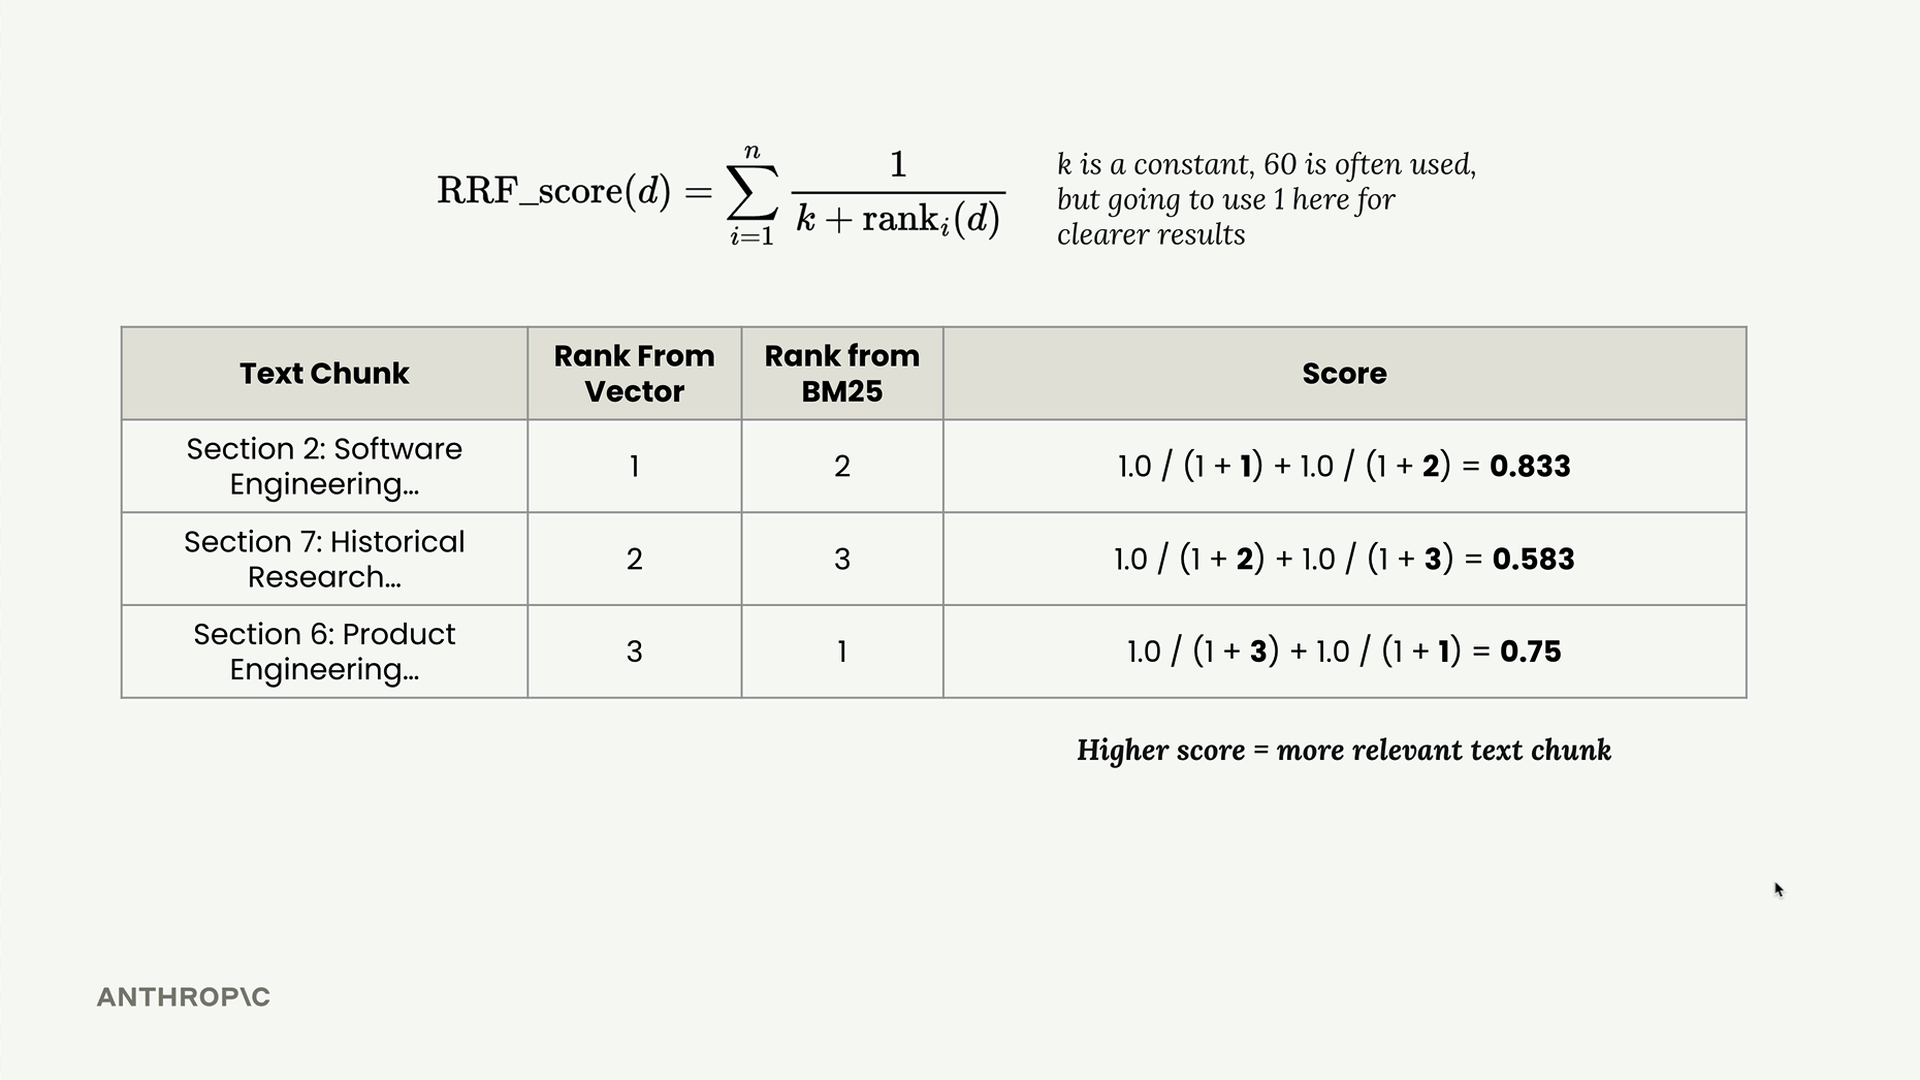
以我們的範例來說:
- 第 2 節:1.0/(1+1) + 1.0/(1+2) = 0.833
- 第 7 節:1.0/(1+2) + 1.0/(1+3) = 0.583
- 第 6 節:1.0/(1+3) + 1.0/(1+1) = 0.75
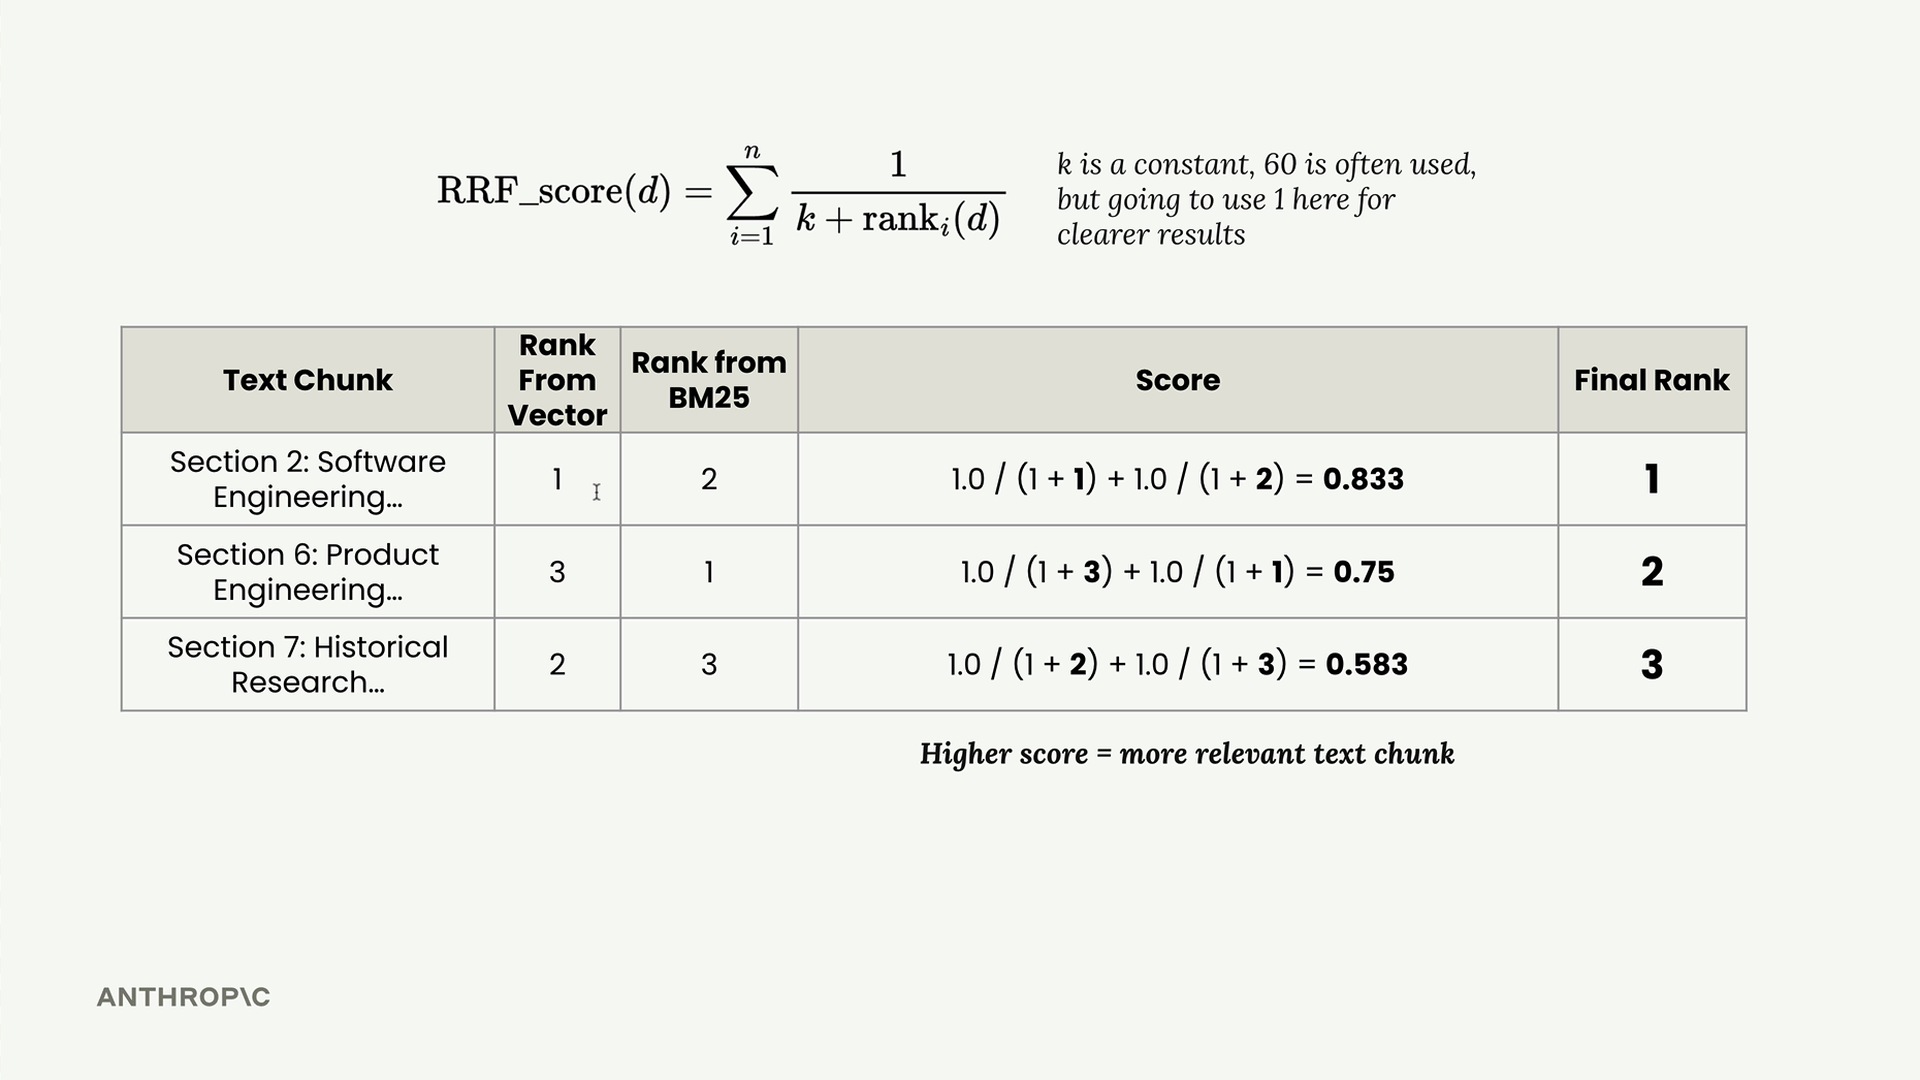
最終排名為:第 2 節(0.833)、第 6 節(0.75)、第 7 節(0.583)。這符合直覺——第 2 節在兩種搜尋中都表現良好,第 6 節結果參差不齊,而第 7 節整體排名較低。
實作
Retriever 類別的實作相當直接:
class Retriever:
    def __init__(self, *indexes):
        self._indexes = list(indexes)

    def add_document(self, document):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text, k=1, k_rrf=60):
        # 從所有索引取得結果
        all_results = [index.search(query_text, k) for index in self._indexes]

        # 套用倒數排名融合(reciprocal rank fusion)
        # ...合併邏輯於此...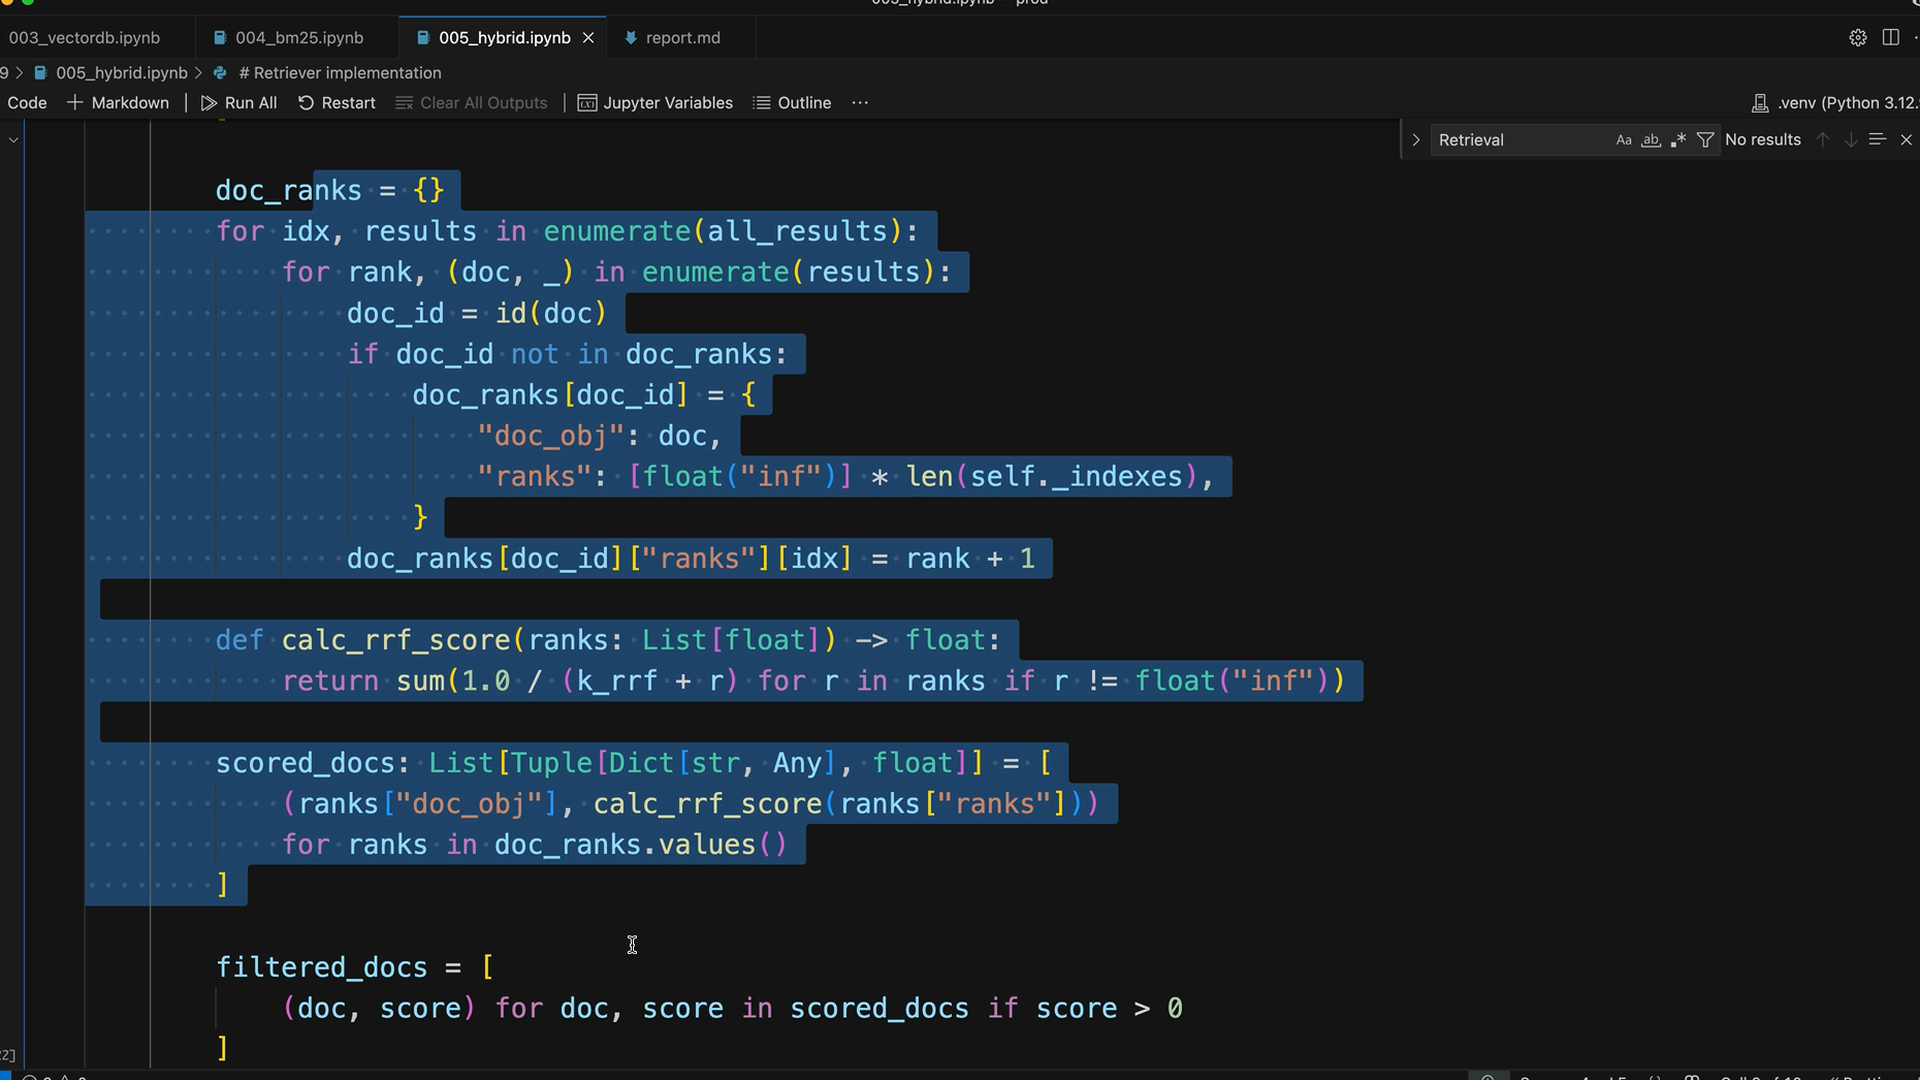
合併邏輯會追蹤所有搜尋結果中的文件排名,計算 RRF 分數,並依其綜合分數排序回傳前 k 個文件。
測試混合方法
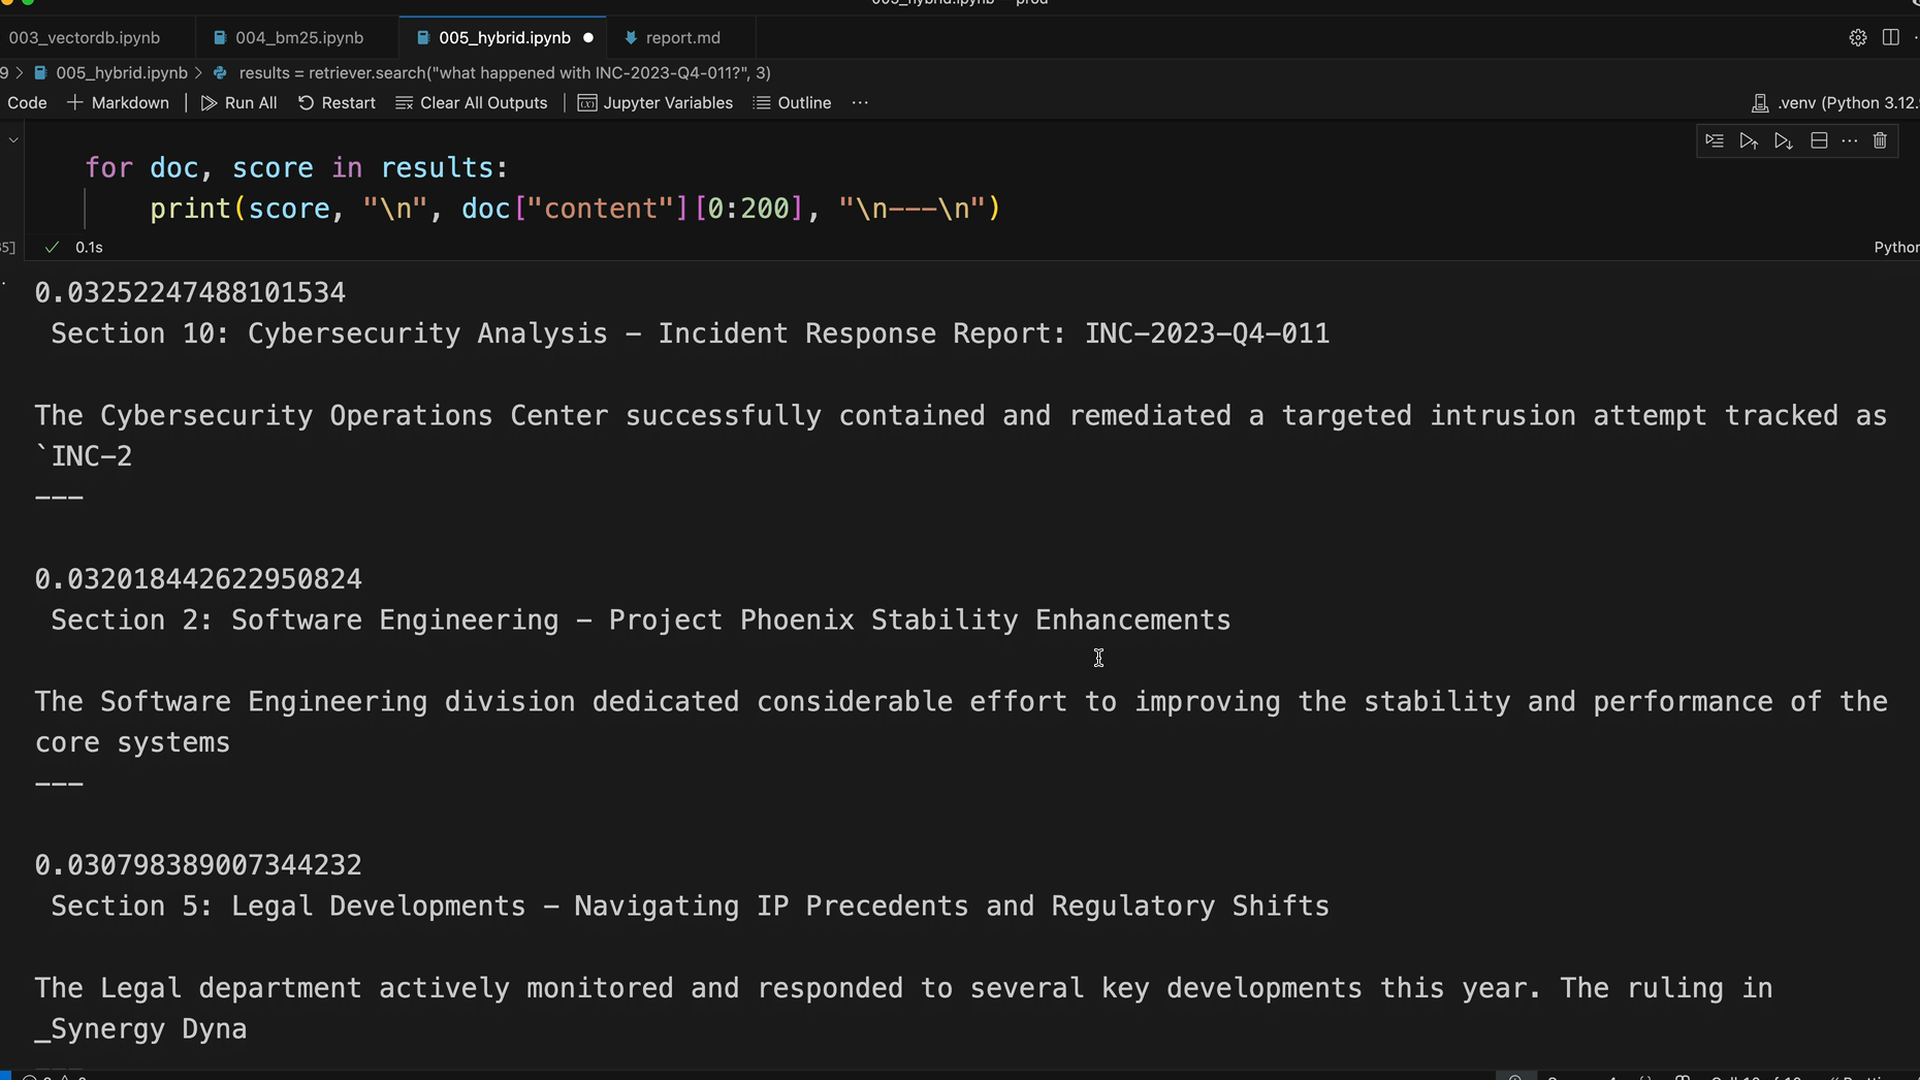
當使用查詢「what happened with INC-2023-Q4-011?」進行測試時,混合方法提供的結果遠比單純的向量搜尋更好:
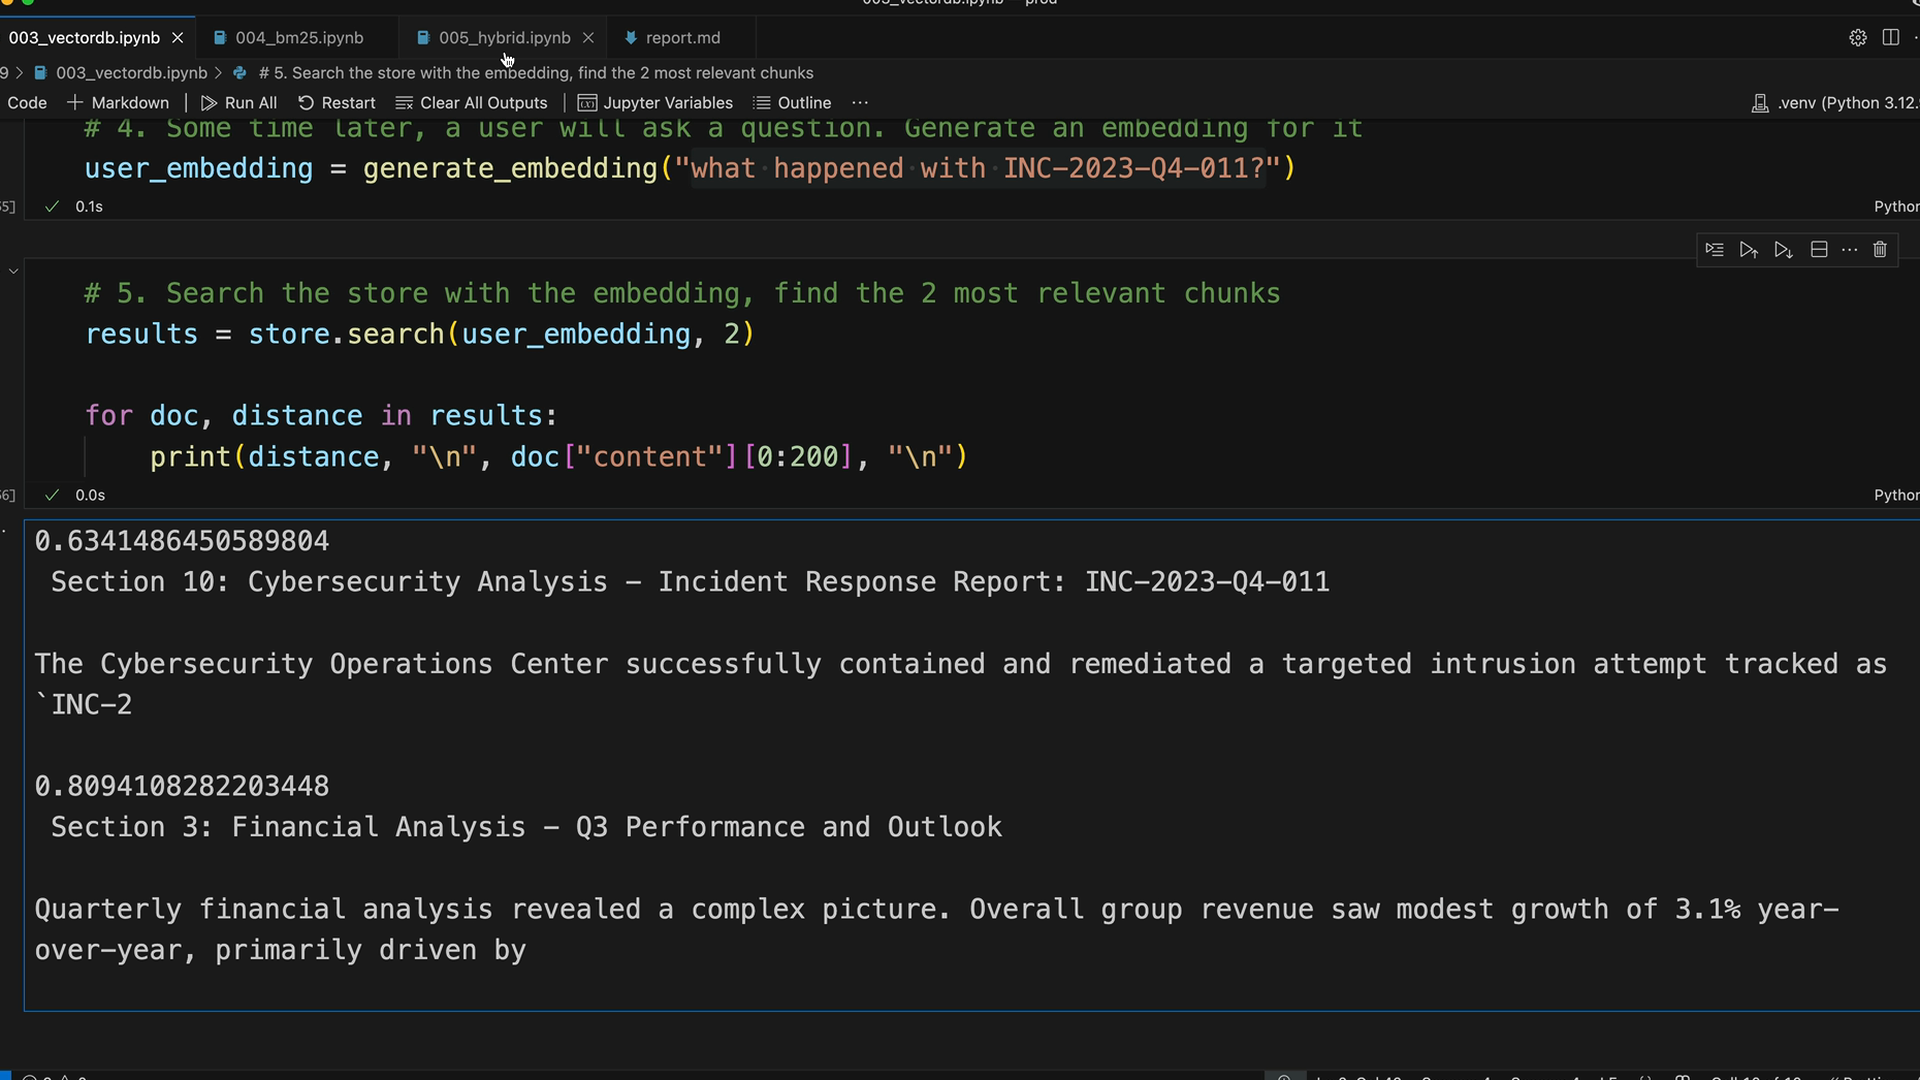
現在的結果正確地優先排列:
- 第 10 節:網路安全分析(實際的事件報告)
- 第 2 節:軟體工程(相關背景資訊)
- 第 5 節:法律發展(相關性較低但仍有關聯)
混合架構的優勢
這種設計提供了多項優勢:
- 模組化設計:每個搜尋索引都以相同的 API 獨立實作
- 易於擴展:您可以透過實作相同的
search()和add_document()介面來新增搜尋方法 - 更高的準確性:結合語意理解與精確的關鍵字比對
- 靈活的融合:無論您結合多少個搜尋索引,RRF 演算法都能正常運作
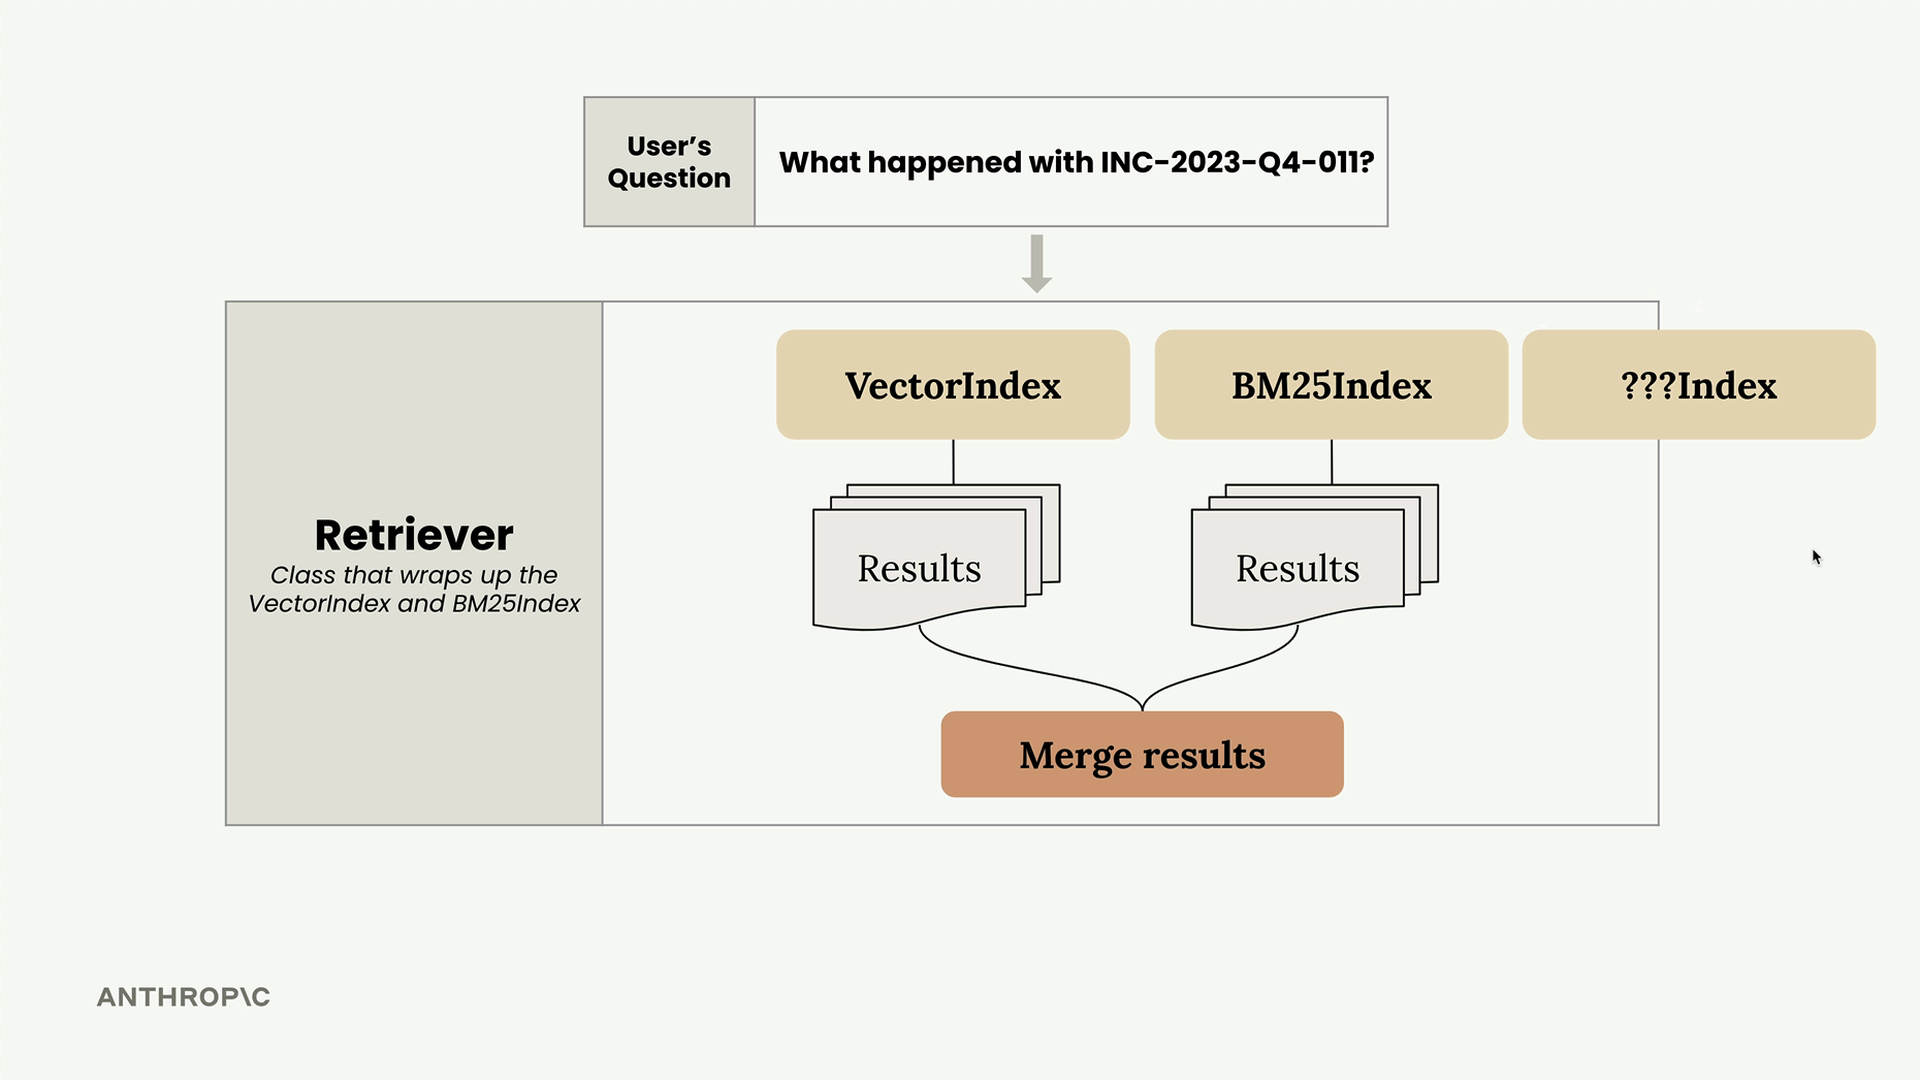
一致的 API 意味著您可以輕鬆新增第三個搜尋索引——或許是專門用於命名實體識別或處理特定文件類型的索引——而 Retriever 會自動將其結果納入最終排名中。
這種混合搜尋基礎提供了比單一方法更為穩健的檢索能力,為您的 RAG 管線在更廣泛的查詢類型上實現更佳效能奠定了基礎。