情境檢索(Contextual retrieval)是一種能提升 RAG 管線準確度的技術,它解決了一個根本性的問題:當您將文件拆分成區塊時,每個區塊都會失去與更廣泛文件情境的連結。
標準分塊的問題
當您將來源文件拆分成區塊以放入向量資料庫時,每個獨立的片段都不再知道自己來自何處,也不知道與文件其餘部分的關係。這可能會損害檢索準確度,因為這些區塊缺乏重要的情境資訊。
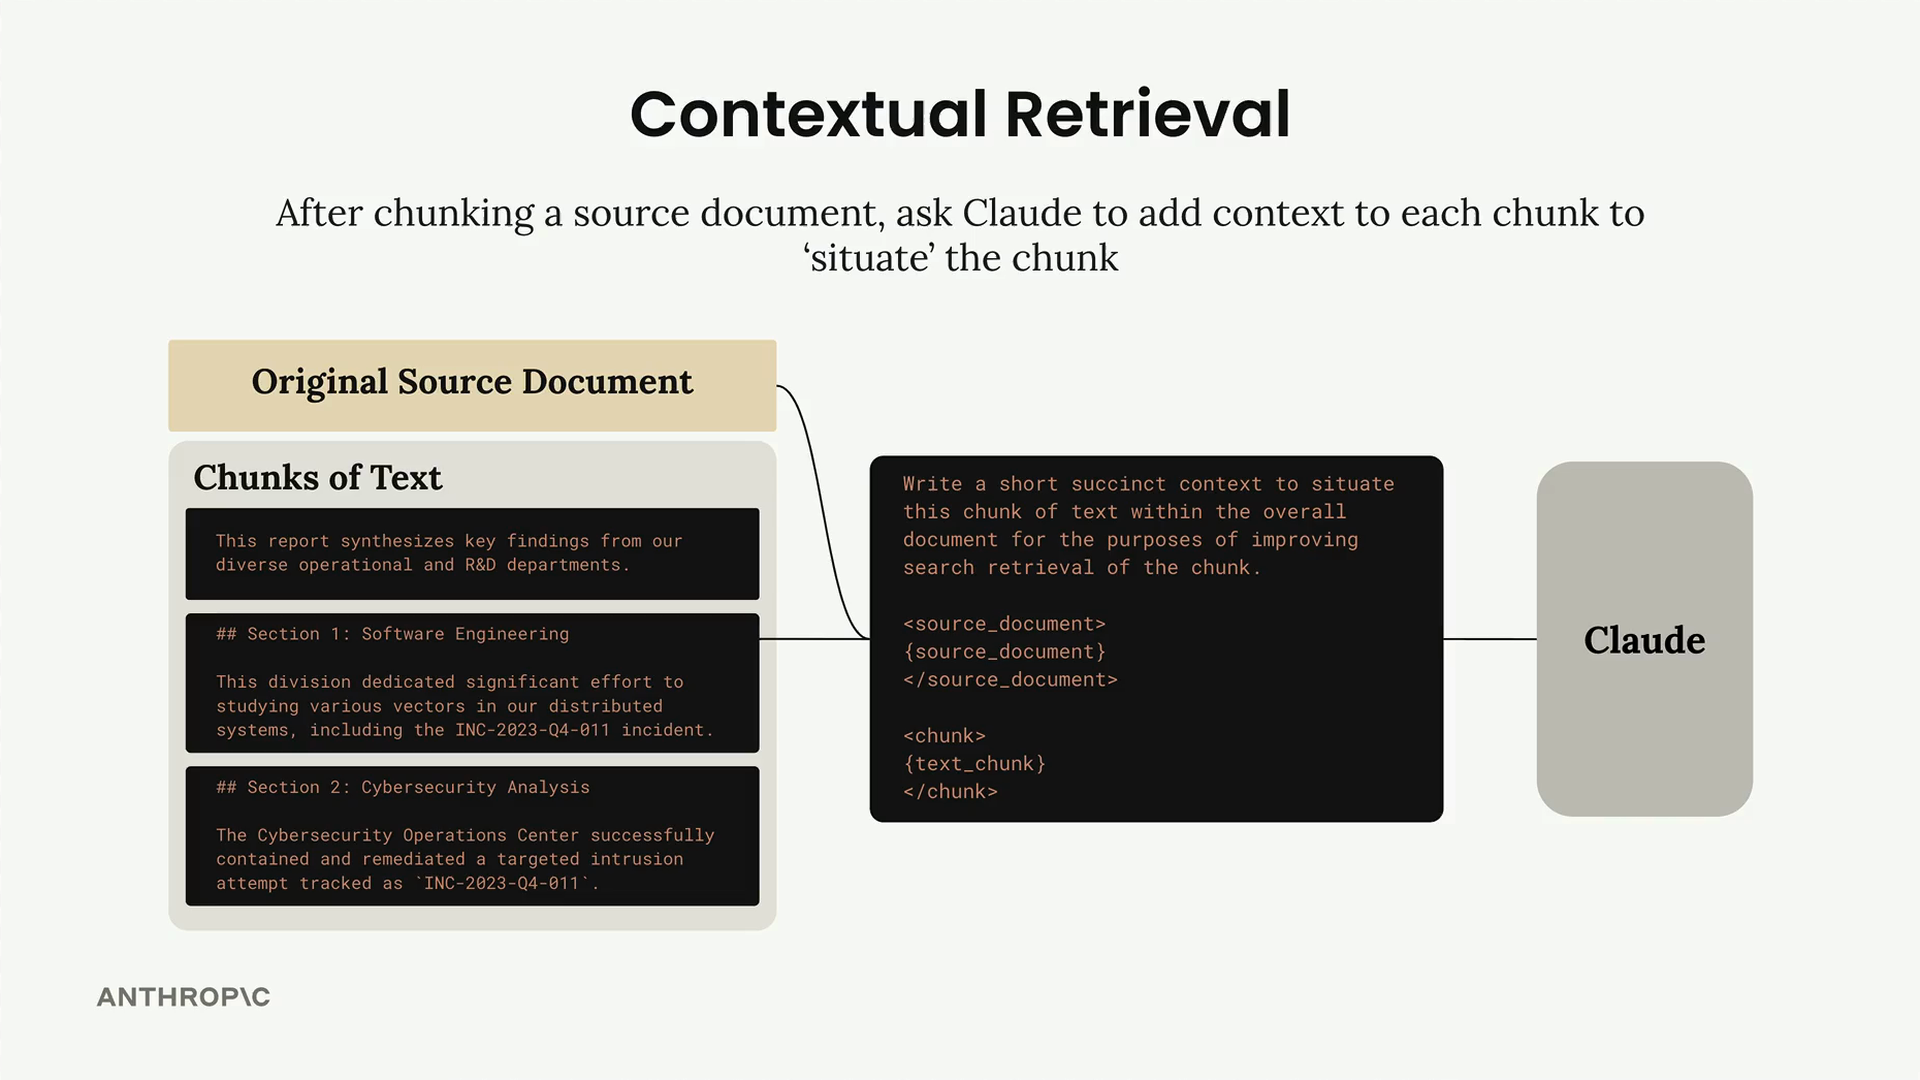
情境檢索的運作方式
情境檢索在將區塊插入您的檢索器資料庫之前,新增了一個預處理步驟。以下是其流程:
- 取出每個獨立的區塊以及原始來源文件
- 將兩者一併傳送給 Claude,並附上特定提示,要求其加入情境
- Claude 會產生一段簡短的摘要,將該區塊「定位」於更大的文件之中
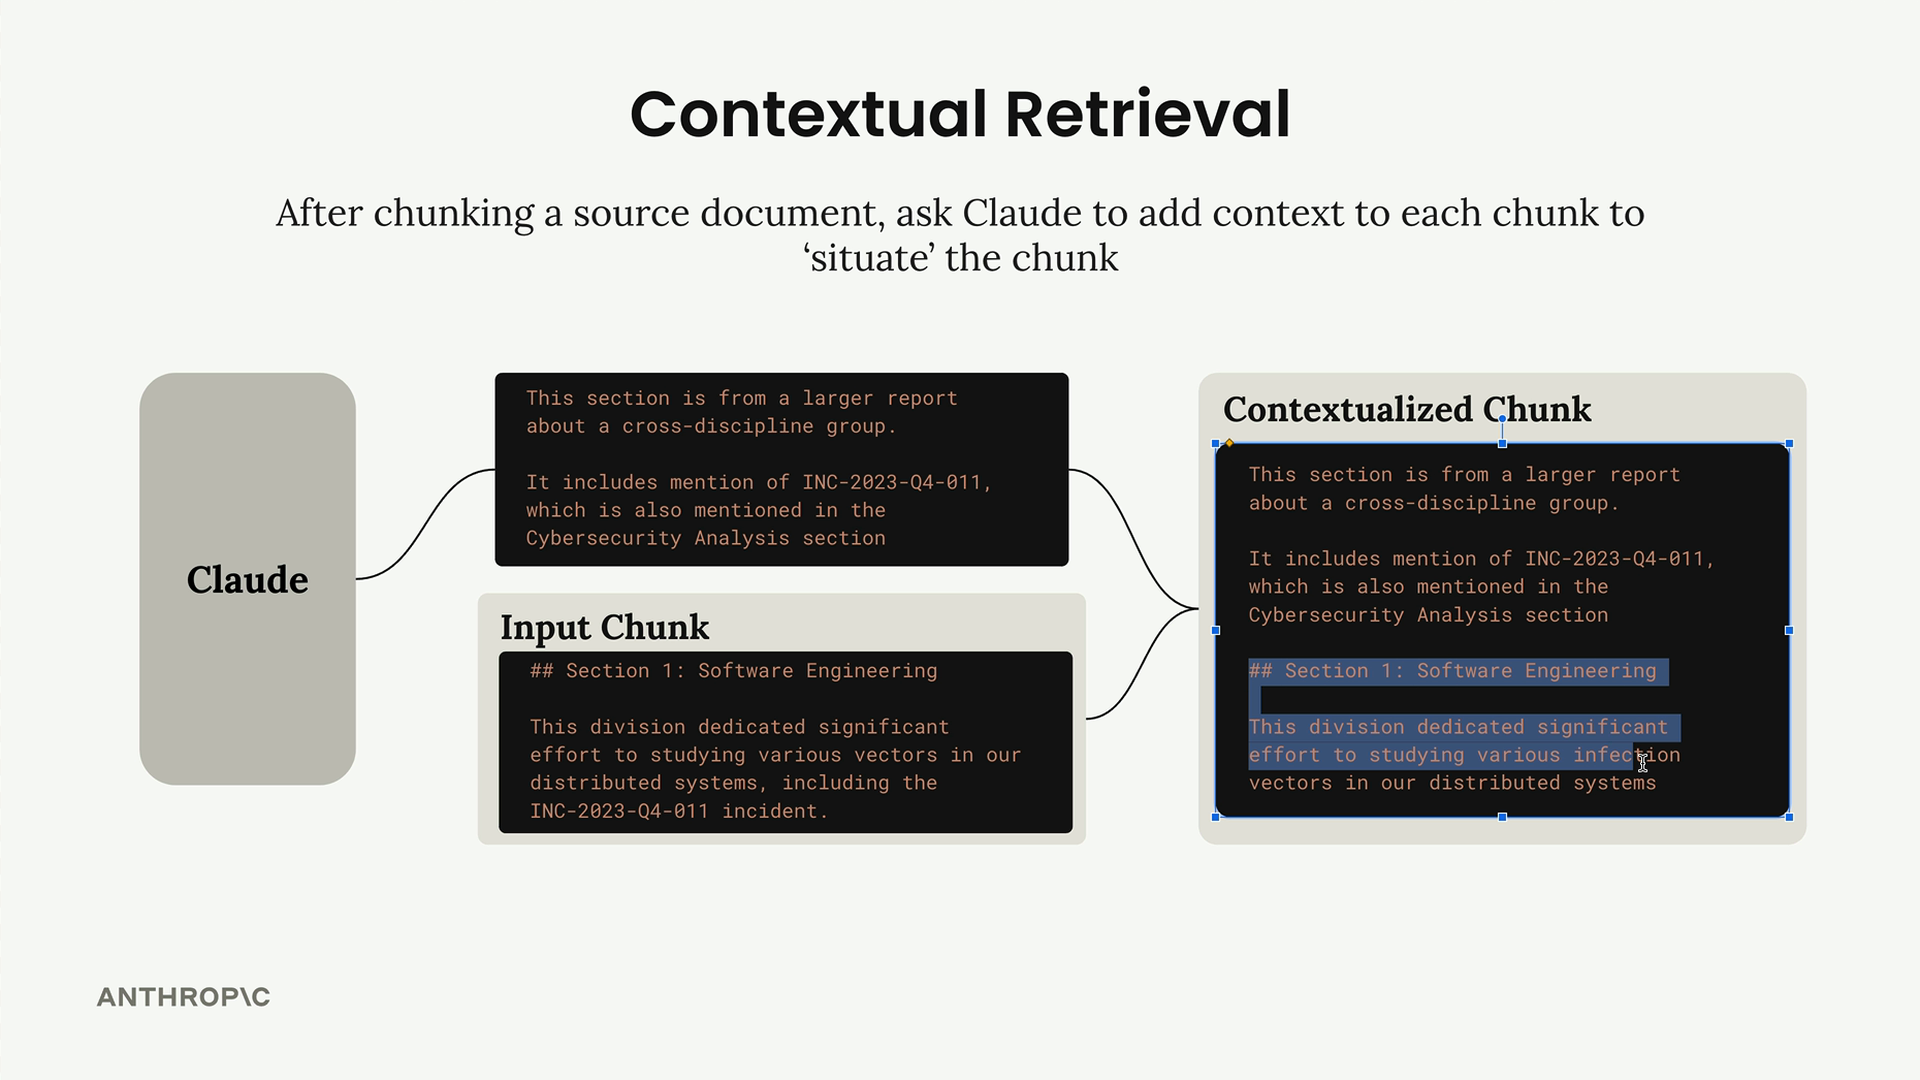
- 將此情境與原始區塊結合,建立一個「情境化區塊」
- 在您的向量索引與 BM25 索引中使用該情境化區塊
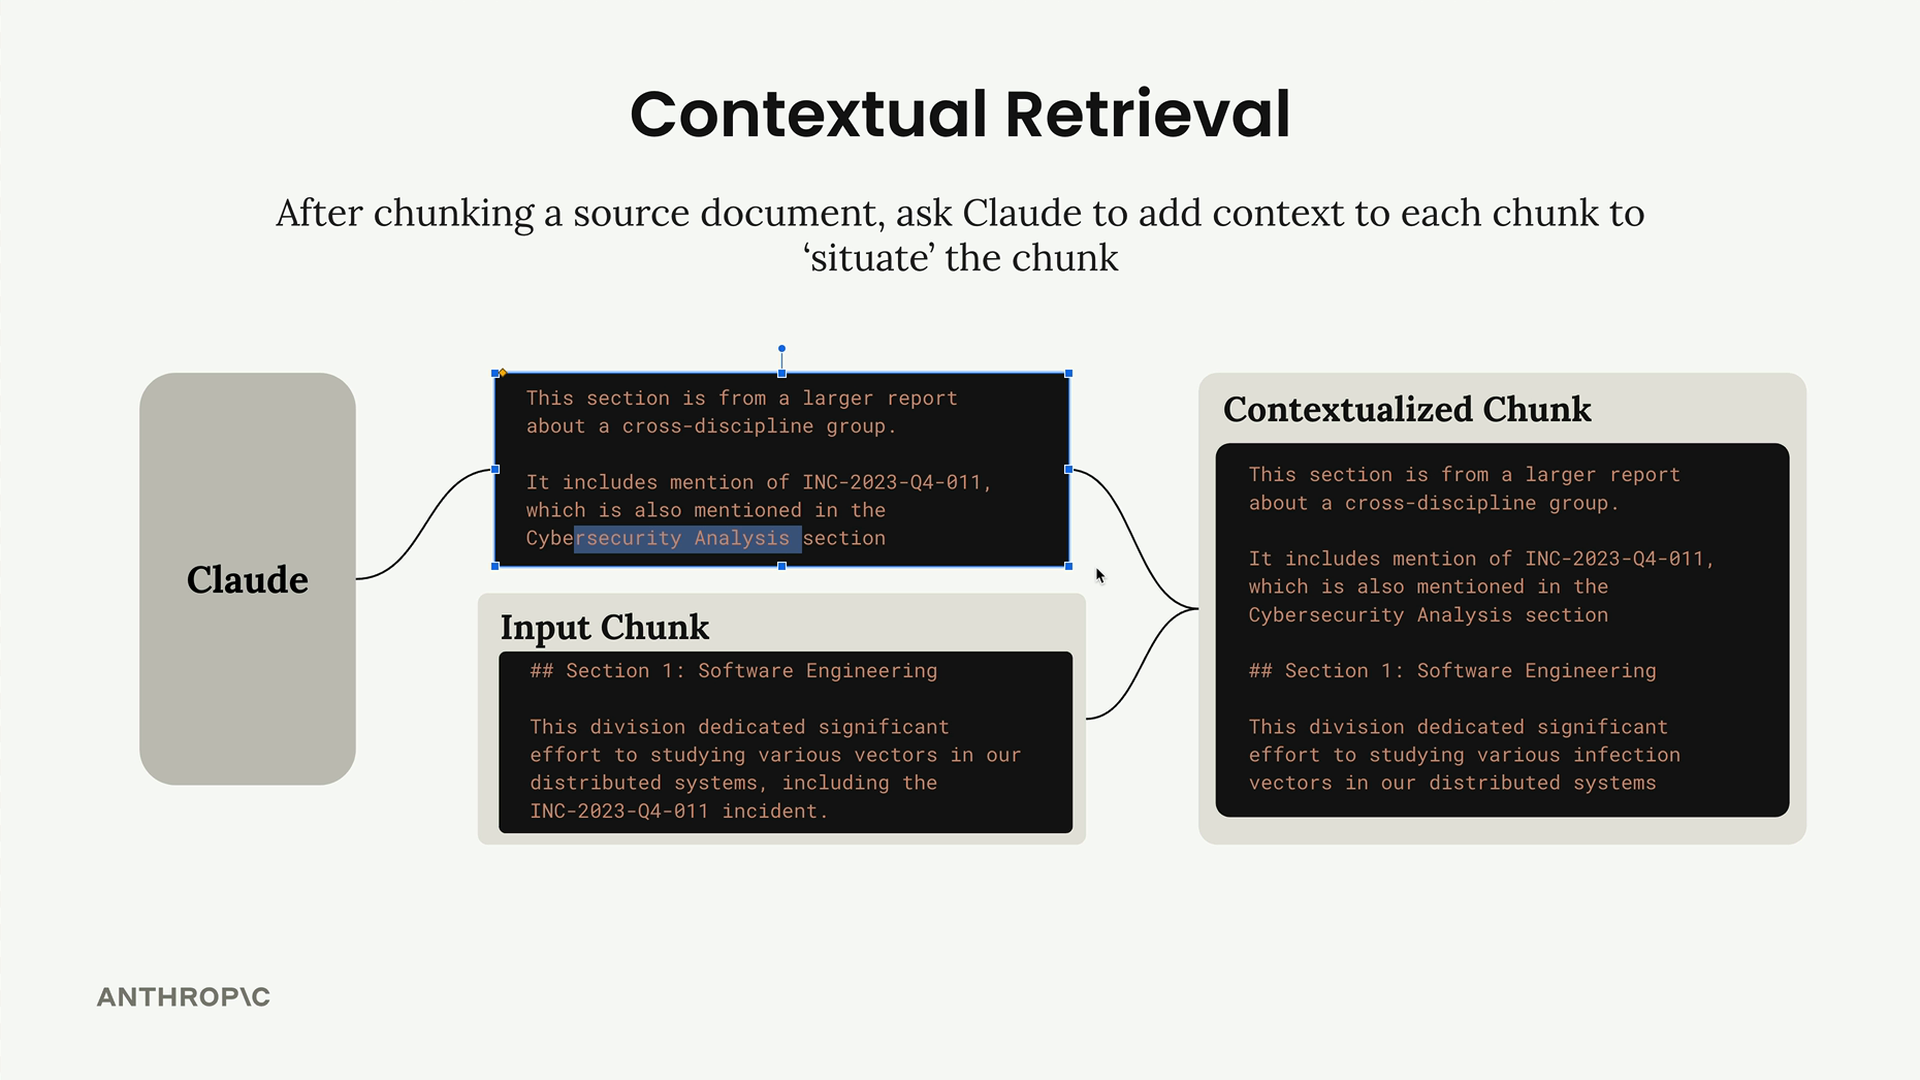
舉例來說,如果您有一個關於軟體工程的章節,其中提到了 2023 年的某個事件,Claude 可能會產生如下的情境:「本節摘自一份關於跨學科小組的較大報告。其中提及了 INC-2023-04-011,該事件在網路安全分析章節中也有提及。」
處理大型文件
一個常見的問題是,您的來源文件太大,無法放入 Claude 的上下文視窗中。您仍然可以透過提供精簡的情境集合來使用情境檢索:
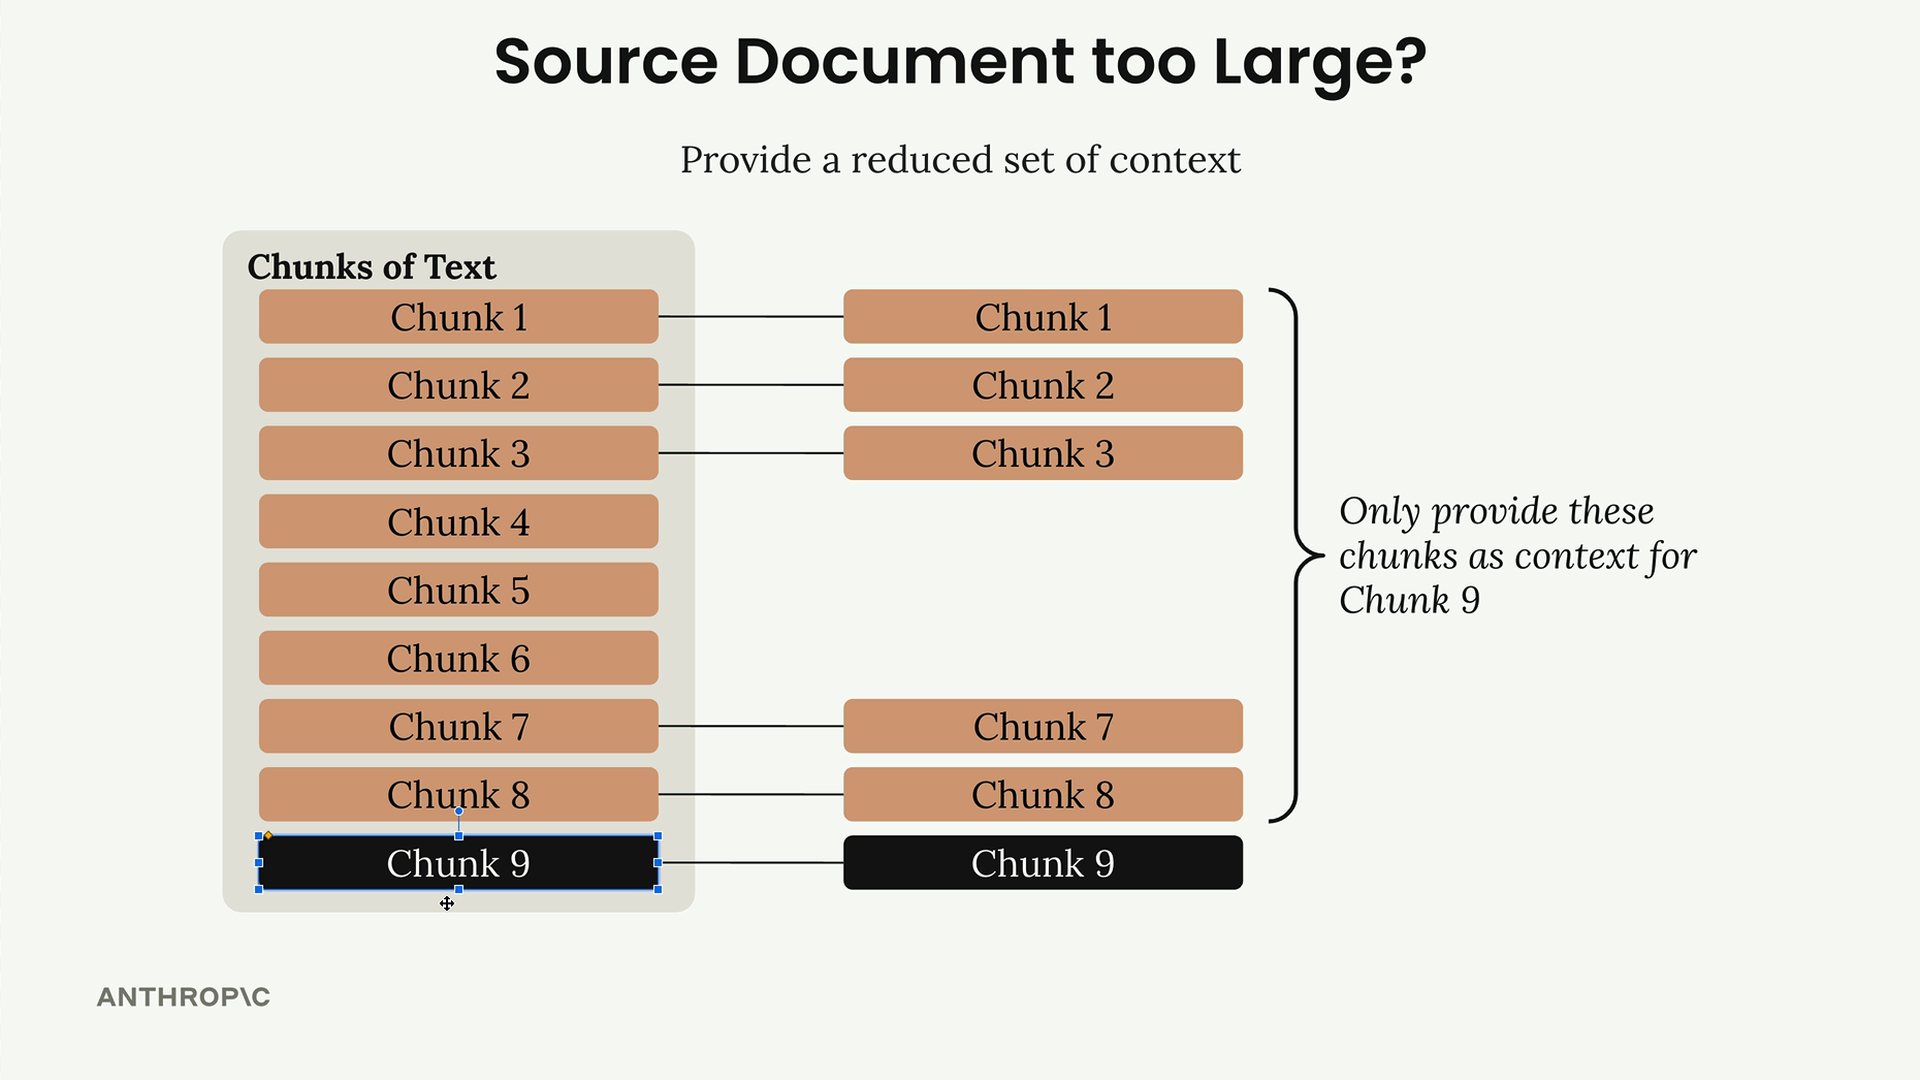
與其納入整份文件,不如提供:
- 文件開頭的幾個區塊(通常包含摘要或概要)
- 緊接在您要情境化的區塊之前的區塊
這種方法能讓 Claude 獲得足夠的資訊來理解文件結構與鄰近情境,同時不會讓提示負擔過重。
實作範例
以下是為區塊新增情境的基本函式:
python
def add_context(text_chunk, source_text):
    prompt = f"""
Write a short and succinct snippet of text to situate this chunk within the
overall source document for the purposes of improving search retrieval of the chunk.

Here is the original source document:
<document>
{source_text}
</document>

Here is the chunk we want to situate within the whole document:
<chunk>
{text_chunk}
</chunk>

Answer only with the succinct context and nothing else.
"""

    messages = []
    add_user_message(messages, prompt)
    result = chat(messages)

    return text_from_message(result) + "\n" + text_chunk
對於大型文件,您可以實作一種策略,用來選取相關的情境區塊:
python
# 為每個區塊加入上下文,然後加入檢索器
num_start_chunks = 2
num_prev_chunks = 2

for i, chunk in enumerate(chunks):
    context_parts = []

    # 從文件開頭取得的初始區塊集合
    context_parts.extend(chunks[: min(num_start_chunks, len(chunks))])

    # 位於目前正在加上上下文的區塊之前的額外區塊
    start_idx = max(0, i - num_prev_chunks)
    context_parts.extend(chunks[start_idx:i])

    context = "\n".join(context_parts)

    contextualized_chunk = add_context(chunk, context)
    retriever.add_document({"content": contextualized_chunk})
何時使用情境檢索
此技術在以下情況最具價值:
- 您的文件各章節之間存在複雜的內部關係
- 區塊引用了文件其他地方定義的概念
- 理解文件結構對於準確檢索至關重要
- 您正在處理技術文件、報告或學術論文
雖然情境檢索會增加處理時間與成本(因為您需要進行額外的 API 呼叫),但對於情境至關重要的複雜文件而言,它能顯著提升檢索準確度。