現在我們已經從概念上理解了 RAG 流程,讓我們透過一個實際範例逐步實作它。我們將完整走過 RAG 流程的五個階段,從文本分塊到為使用者查詢找出相關文件。
設置向量資料庫
在這次實作中,我們將使用一個自訂的 VectorIndex 類別,它提供了儲存和搜尋嵌入向量所需的基本功能。這個類別負責處理向量儲存、距離計算(使用餘弦相似度)以及文件檢索。
五步驟 RAG 實作
讓我們逐步走過 RAG 流程的每個步驟:
步驟 1:依章節分塊文本
首先,我們需要將來源文件拆分成可管理的區塊。我們將使用先前介紹過的基於章節的分塊方法:
chunks = chunk_by_section(text)這會將我們的 report.md 檔案拆分成可以個別處理的邏輯章節。
步驟 2:為每個區塊生成嵌入向量
接下來,我們將每個文本區塊轉換成能捕捉其語義的數值嵌入向量:
embeddings = generate_embedding(chunks)這些嵌入向量讓我們能夠在不同文本片段之間進行數學比較。
步驟 3:將嵌入向量儲存到向量資料庫
現在我們建立向量儲存區,並用我們的嵌入向量及其相關文本來填充它:
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
請注意,我們同時儲存了嵌入向量和原始文本內容。這一點至關重要,因為當我們之後檢索相似的嵌入向量時,我們需要存取實際的文本,而不僅僅是數值向量。對我們開發者來說,單純的嵌入向量本身並沒有用處——我們需要它所代表的人類可讀內容。
步驟 4:為使用者查詢生成嵌入向量
當使用者提出問題時,我們需要將他們的查詢轉換到與我們儲存文件相同的嵌入向量空間中:
user_embedding = generate_embedding("What did the software engineering dept do last year?")步驟 5:搜尋相關文件
最後,我們搜尋向量儲存區以找出最相關的區塊:
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
這會回傳兩個最相似的區塊,以及它們的餘弦距離分數。
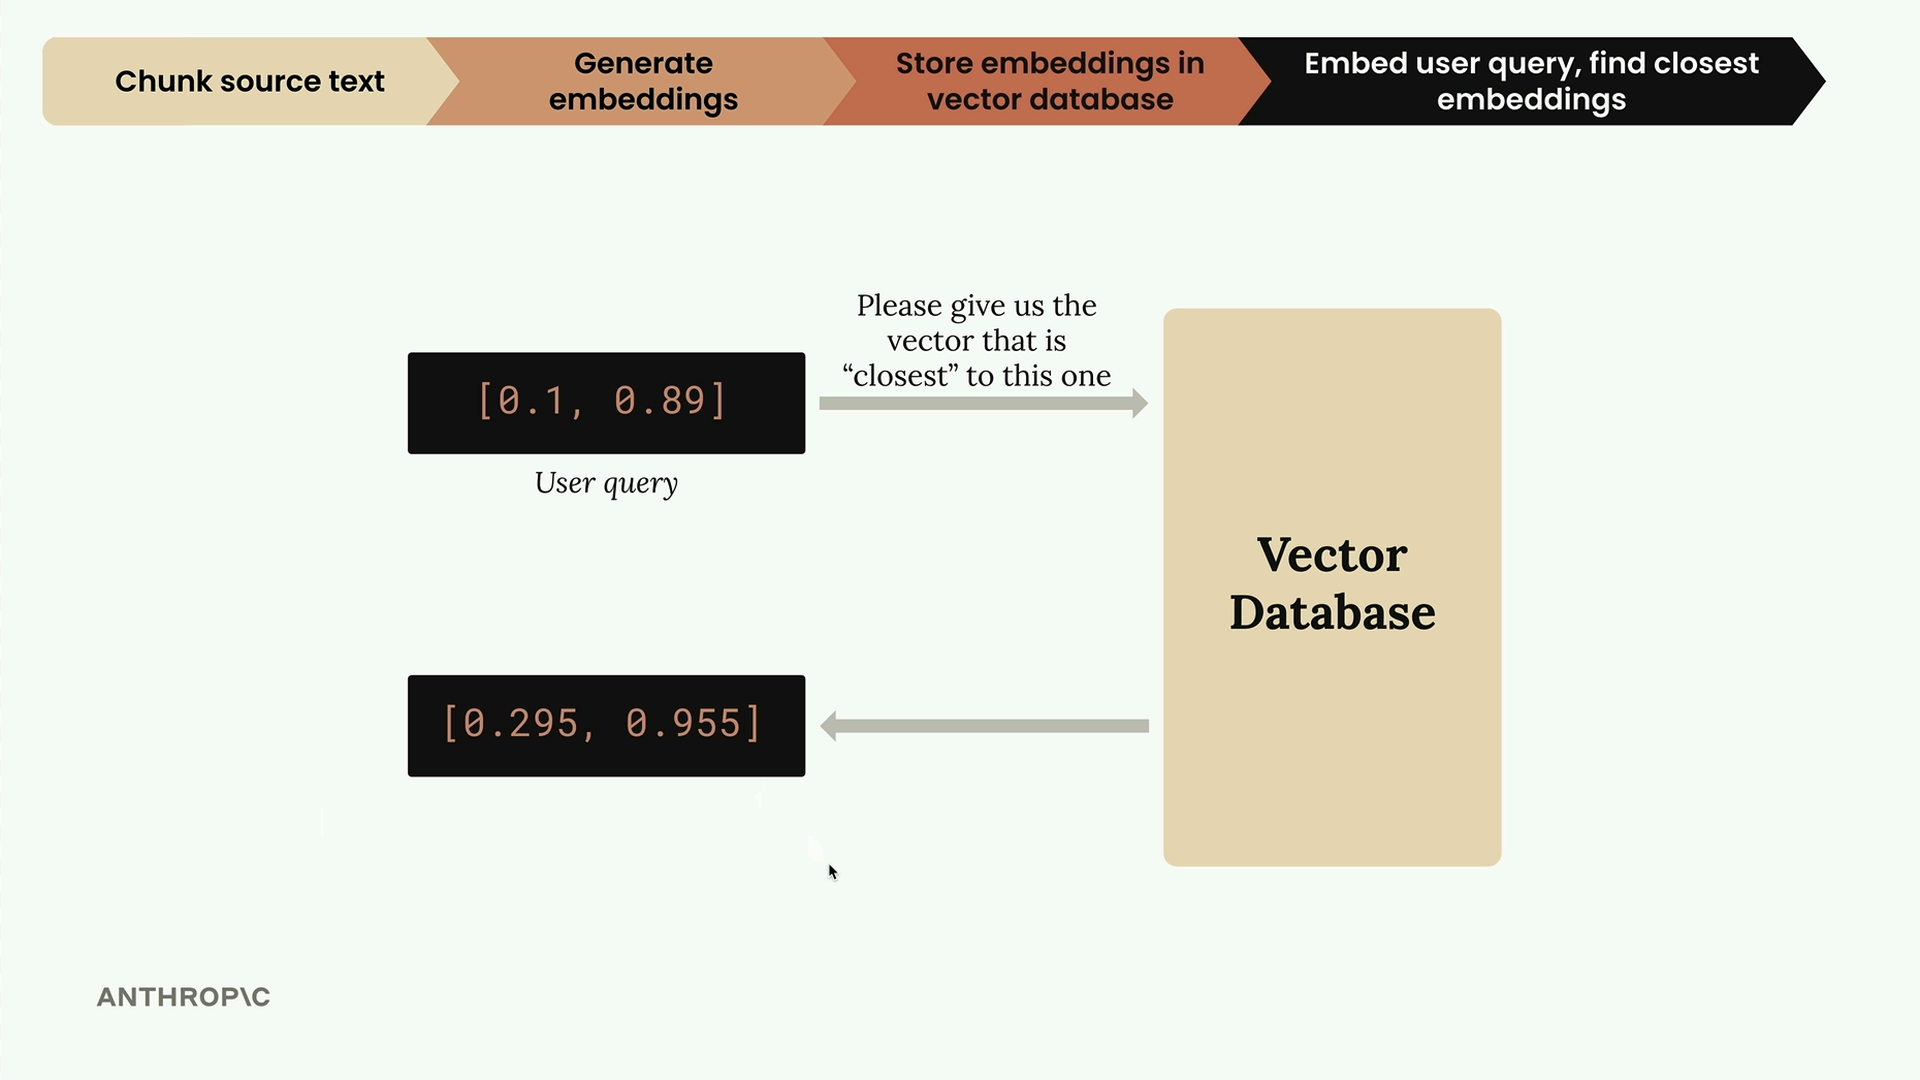
上圖說明了向量資料庫如何處理使用者查詢。當我們提出一個問題時,它會被轉換成一個嵌入向量,資料庫會在高維空間中找出與其「最接近」的儲存向量。
理解結果
當我們針對軟體工程部門的查詢執行這個範例時,我們會得到兩個相關的章節:
- 第 2 節:軟體工程 - Project Phoenix 穩定性增強(距離:0.71)
- 方法論章節(距離:0.72)
距離分數越低,表示內容與我們的查詢越相似。這兩個結果都與我們關於軟體工程部門完成了哪些工作的問題相關。
為何要將內容與嵌入向量一起儲存
您可能會好奇,為什麼我們要將原始文本與每個嵌入向量一起儲存。原因很實際:嵌入向量只是一組數字陣列,對人類來說沒有直接的意義。當我們的搜尋回傳最相似的嵌入向量時,我們需要實際的文本內容,才能理解找到了什麼,並將其用於生成回應。
有些實作方式只儲存一個指向原始文本的 ID,但為了簡化起見,我們選擇將內容直接與每個向量一起儲存。
接下來是什麼
這個實作涵蓋了 RAG 工作流程的核心部分,但仍有可以改進的地方。在實際應用中,您可能會遇到這種基本方法無法如預期運作的情況,我們將在接下來的章節中探討這些改進方案。