在建構 RAG 管線時,您很快就會發現,僅靠語意搜尋並不總能返回最佳結果。有時您需要精確的詞彙匹配,而這正是語意搜尋可能會遺漏的。解決方案是使用一種稱為 BM25 的技術,將語意搜尋與詞彙搜尋結合起來。
僅靠語意搜尋的問題
假設您正在文件中搜尋一個特定的事件 ID,例如「INC-2023-Q4-011」。雖然這個確切的詞彙在相關章節中多次出現,但語意搜尋可能會返回一些語意上相似但實際上不包含您要尋找的特定詞彙的不相關章節。
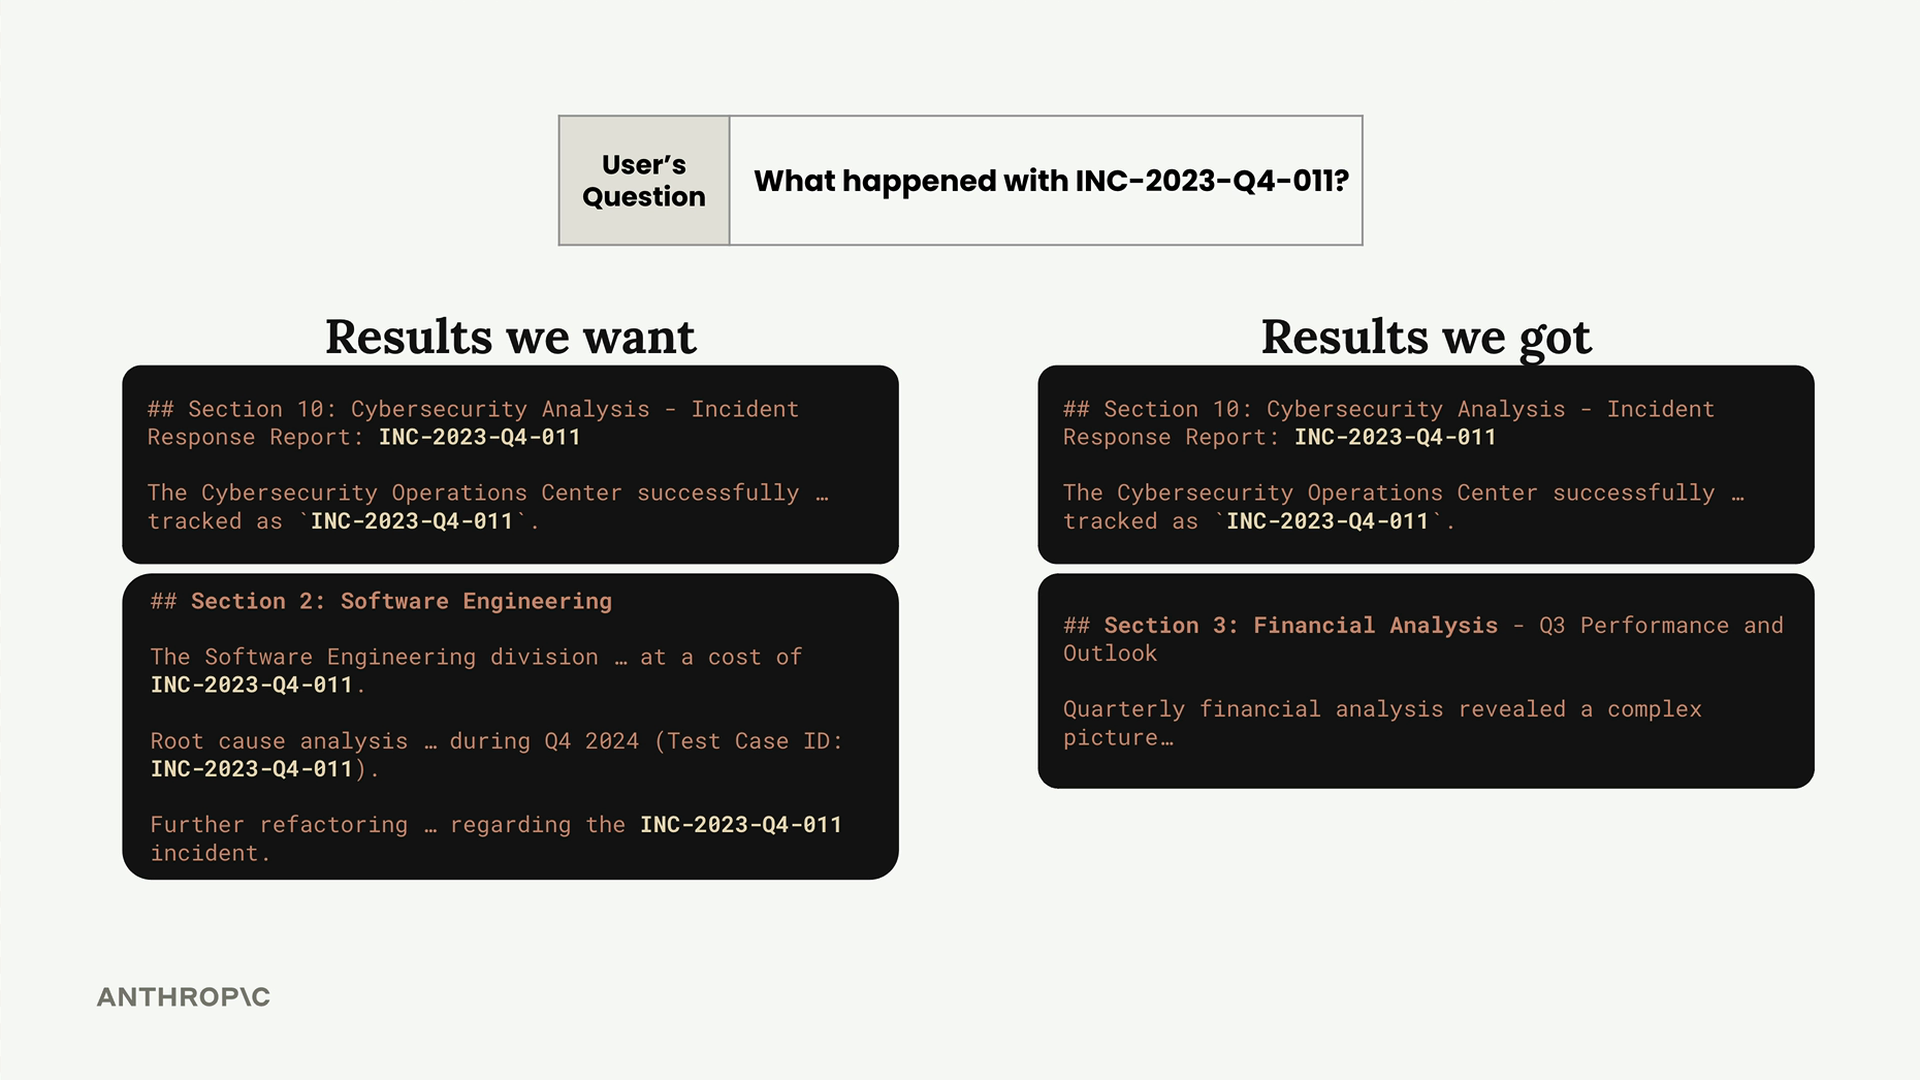
這是因為語意搜尋專注於意義而非精確匹配。當您需要精確的詞彙匹配時,就需要一種不同的方法。
混合搜尋策略
解決方案是並行執行兩種搜尋並合併結果:
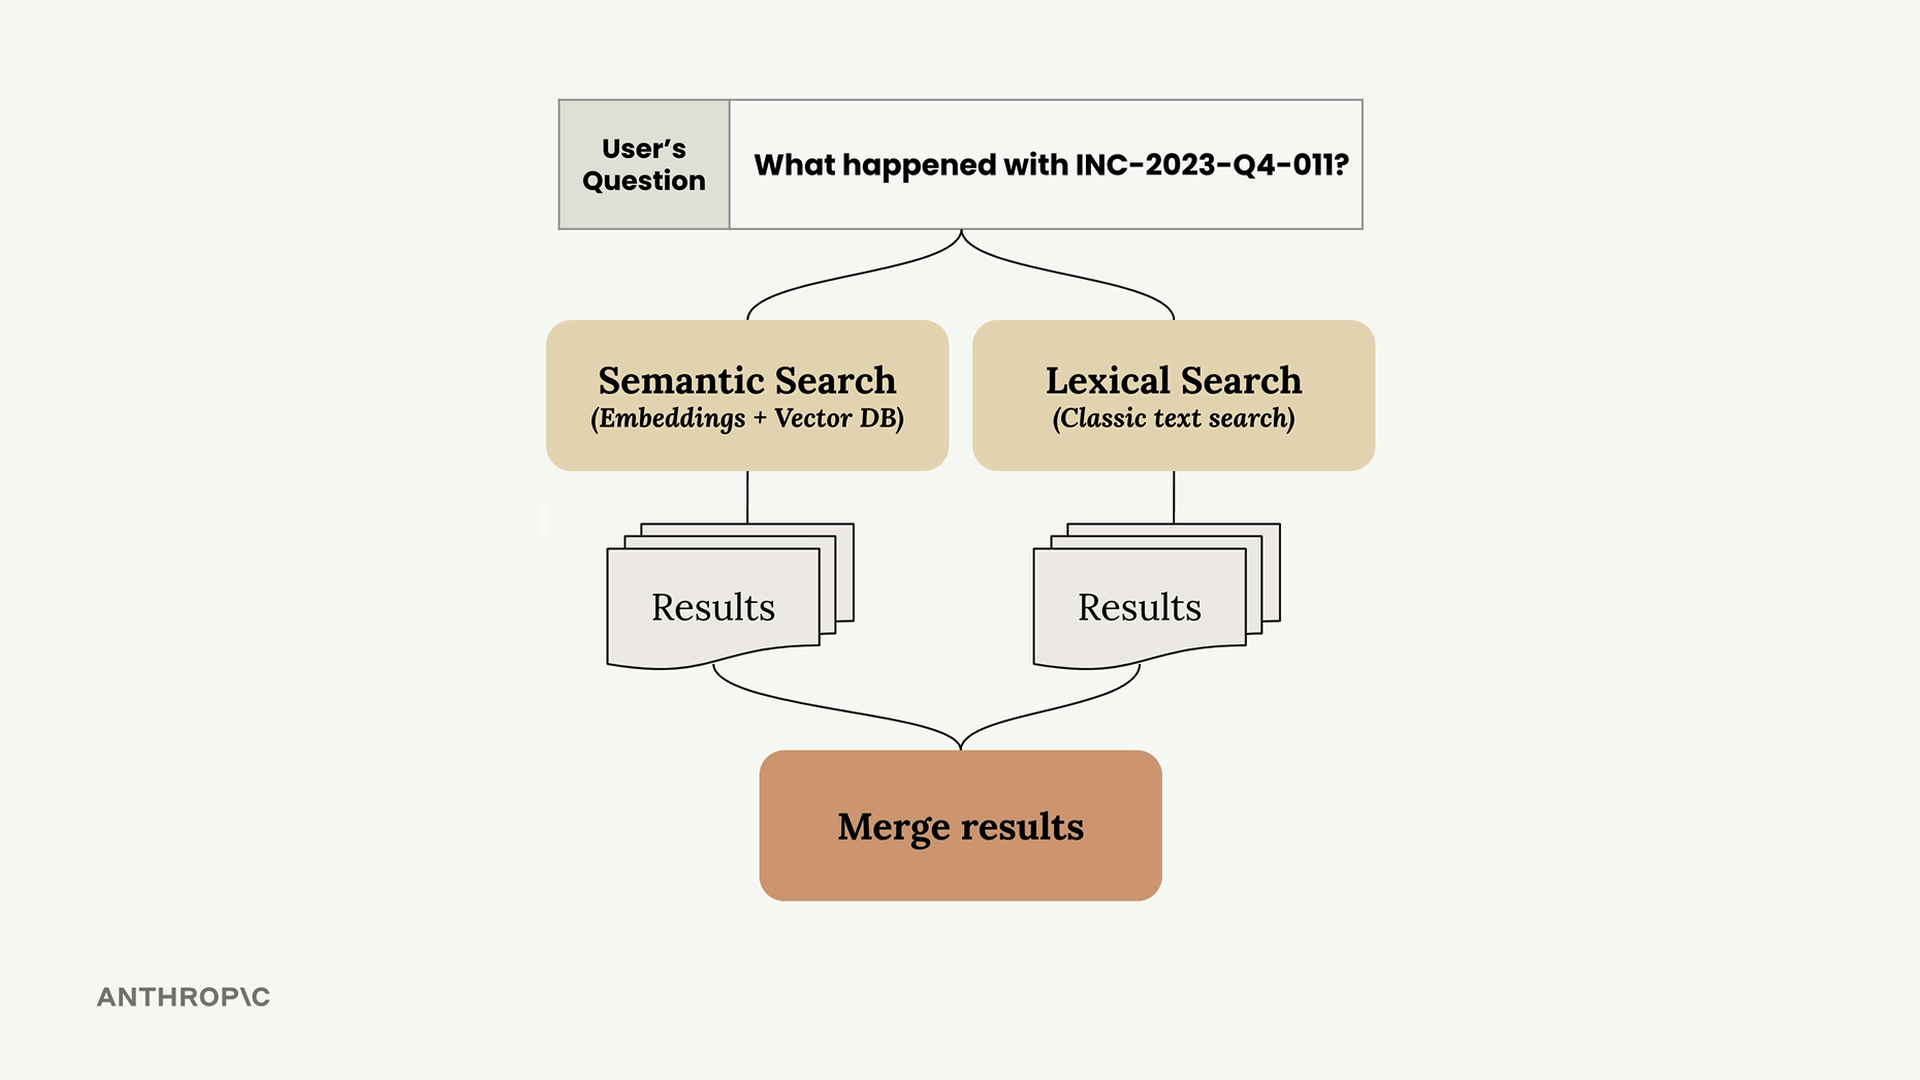
- 語意搜尋 - 使用嵌入向量和向量資料庫進行基於意義的匹配
- 詞彙搜尋 - 使用經典文字搜尋進行精確詞彙匹配
- 合併結果 - 結合兩個結果集以獲得更好的覆蓋範圍
BM25 的運作方式
BM25(Best Match 25)是 RAG 管線中用於詞彙搜尋的一種熱門演算法。以下是它處理搜尋查詢的方式:
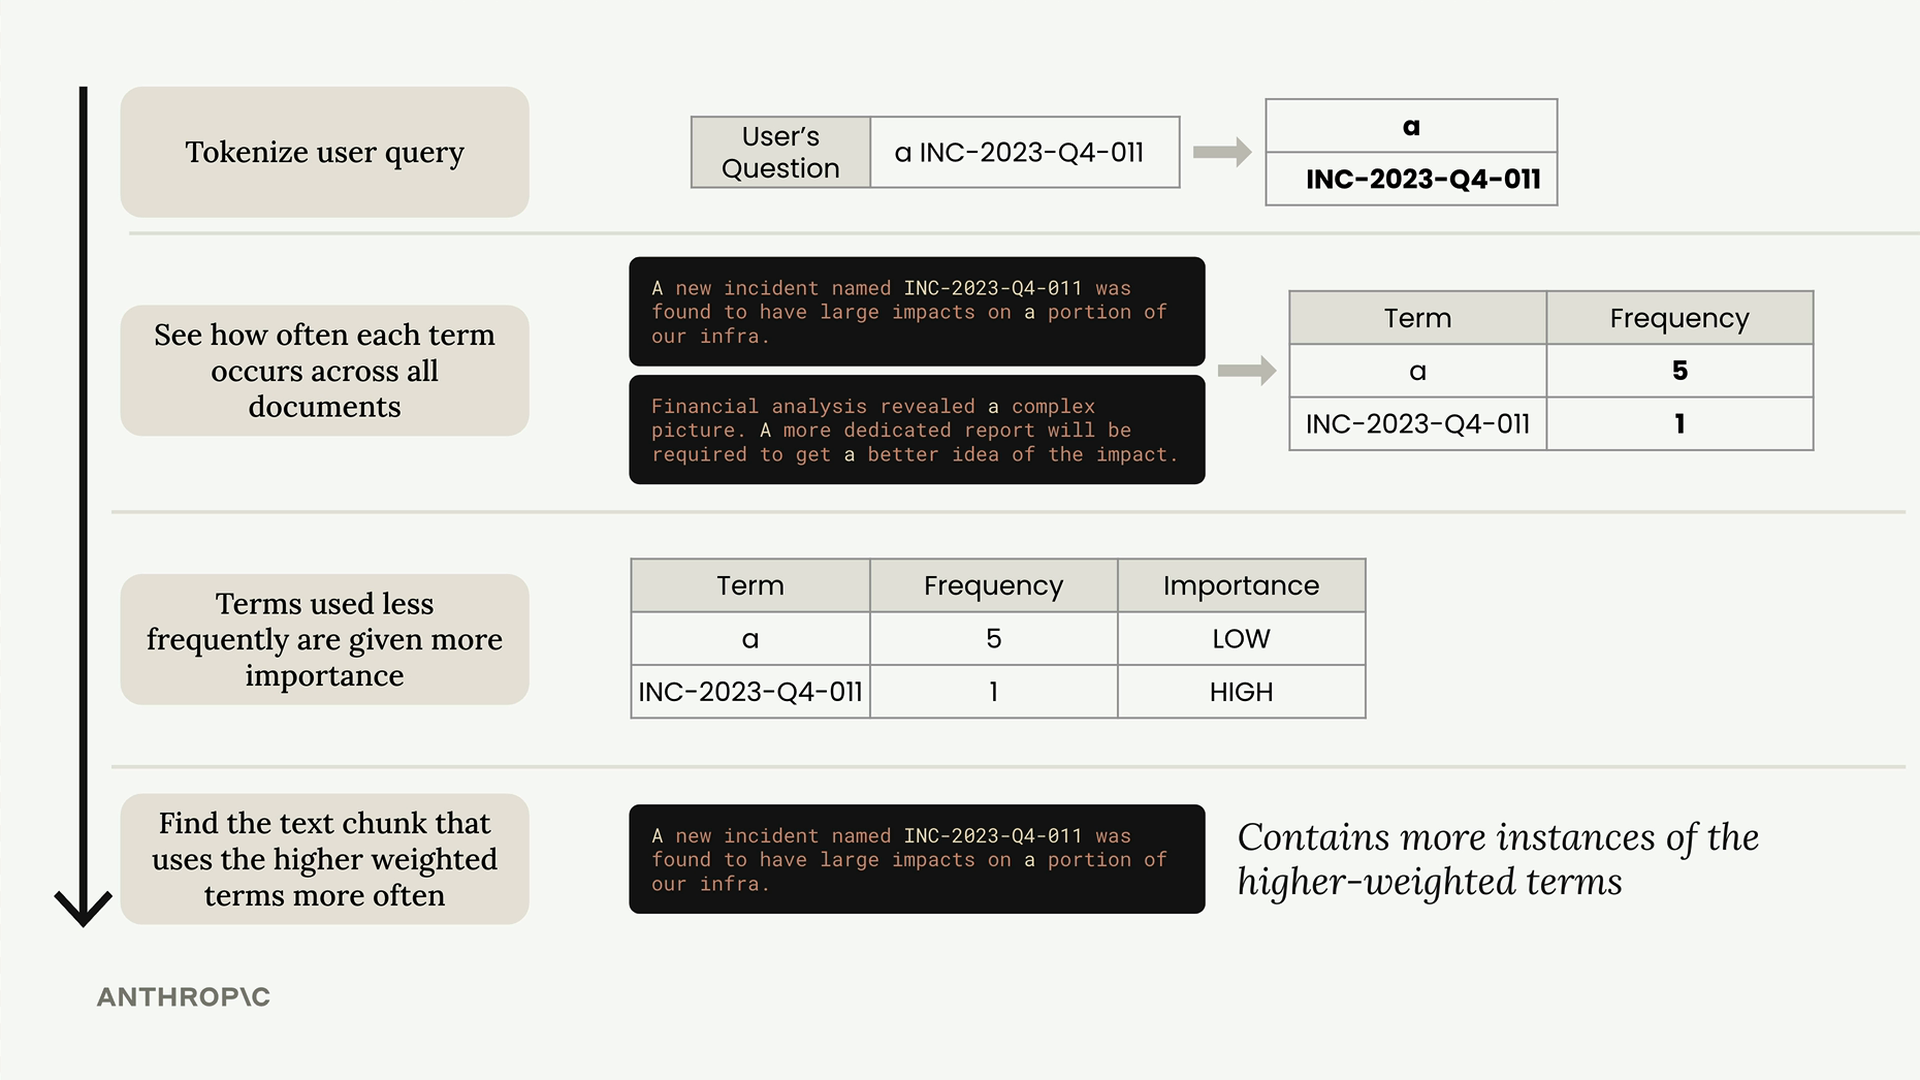
該演算法遵循以下關鍵步驟:
- 將查詢分詞 - 將使用者的問題拆分成個別詞彙
- 計算詞頻 - 查看每個詞彙在所有文件中出現的頻率
- 依稀有度加權詞彙 - 使用頻率較低的詞彙會獲得較高的重要性分數
- 找出最佳匹配 - 返回包含更多高權重詞彙實例的區塊
關鍵的洞見是,像「INC-2023-Q4-011」這樣的稀有詞彙對搜尋的重要性,遠高於像「a」或「the」這樣的常見詞彙。
實作 BM25 搜尋
以下是如何建立一個 BM25 搜尋系統:
# 建立 BM25 儲存庫
store = BM25Index()

# 將文件加入儲存庫
for chunk in chunks:
    store.add_document({"content": chunk})

# 搜尋儲存庫
results = store.search("What happened with INC-2023-Q4-011?", 3)
這個 BM25 實作提供與您的語意搜尋系統相同的 API——兩者都有 add_document() 和 search() 方法,使它們易於一起使用。
更好的搜尋結果
當您對同一個查詢執行 BM25(而該查詢僅靠語意搜尋失敗時),您會得到更好的結果。BM25 不會返回不相關的章節,而是優先處理實際包含您特定搜尋詞彙的章節。
該演算法正確地識別出「INC-2023-Q4-011」是一個稀有且重要的詞彙,並將包含它的文件排名遠高於僅包含查詢中常見詞彙的文件。
下一步
現在您已經讓語意搜尋和詞彙搜尋系統獨立運作,下一步就是合併它們的結果。這種混合方法讓您兩者兼得——結合語意搜尋的上下文理解與詞彙搜尋精確詞彙匹配的精確性。
兩個搜尋系統使用類似的 API,使得並行查詢兩者並將其結果合併成一個更全面的單一結果集變得十分直接。