在使用 Claude 建構應用程式時,了解完整的請求生命週期有助於您架構更好的系統並更有效地除錯問題。讓我們逐步了解當使用者向您的 AI 驅動聊天應用程式發送訊息時會發生什麼事。
完整的請求流程
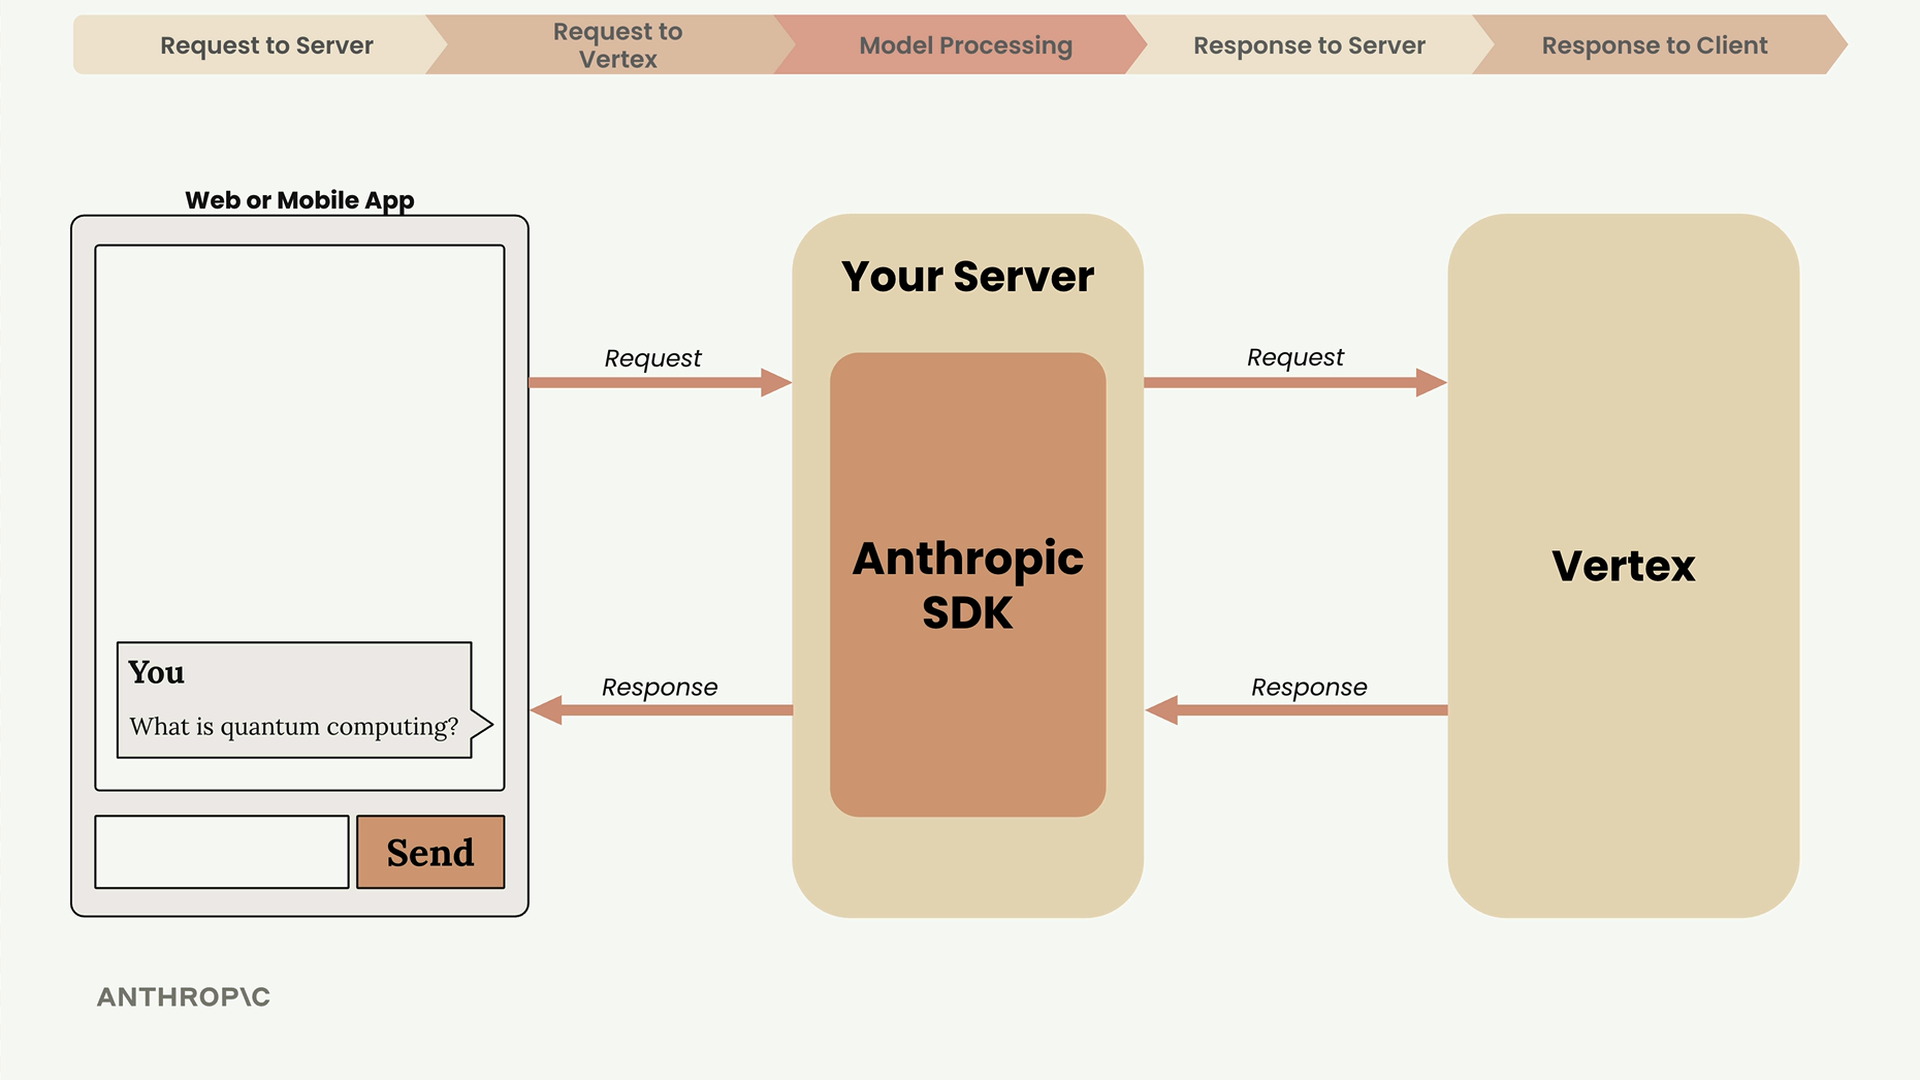
從使用者輸入到 AI 回應的旅程涉及五個不同的步驟:請求至伺服器、請求至 Vertex、模型處理、回應至伺服器,以及回應至客戶端。每個步驟在提供使用者期望的「神奇」回應方面都扮演著至關重要的角色。
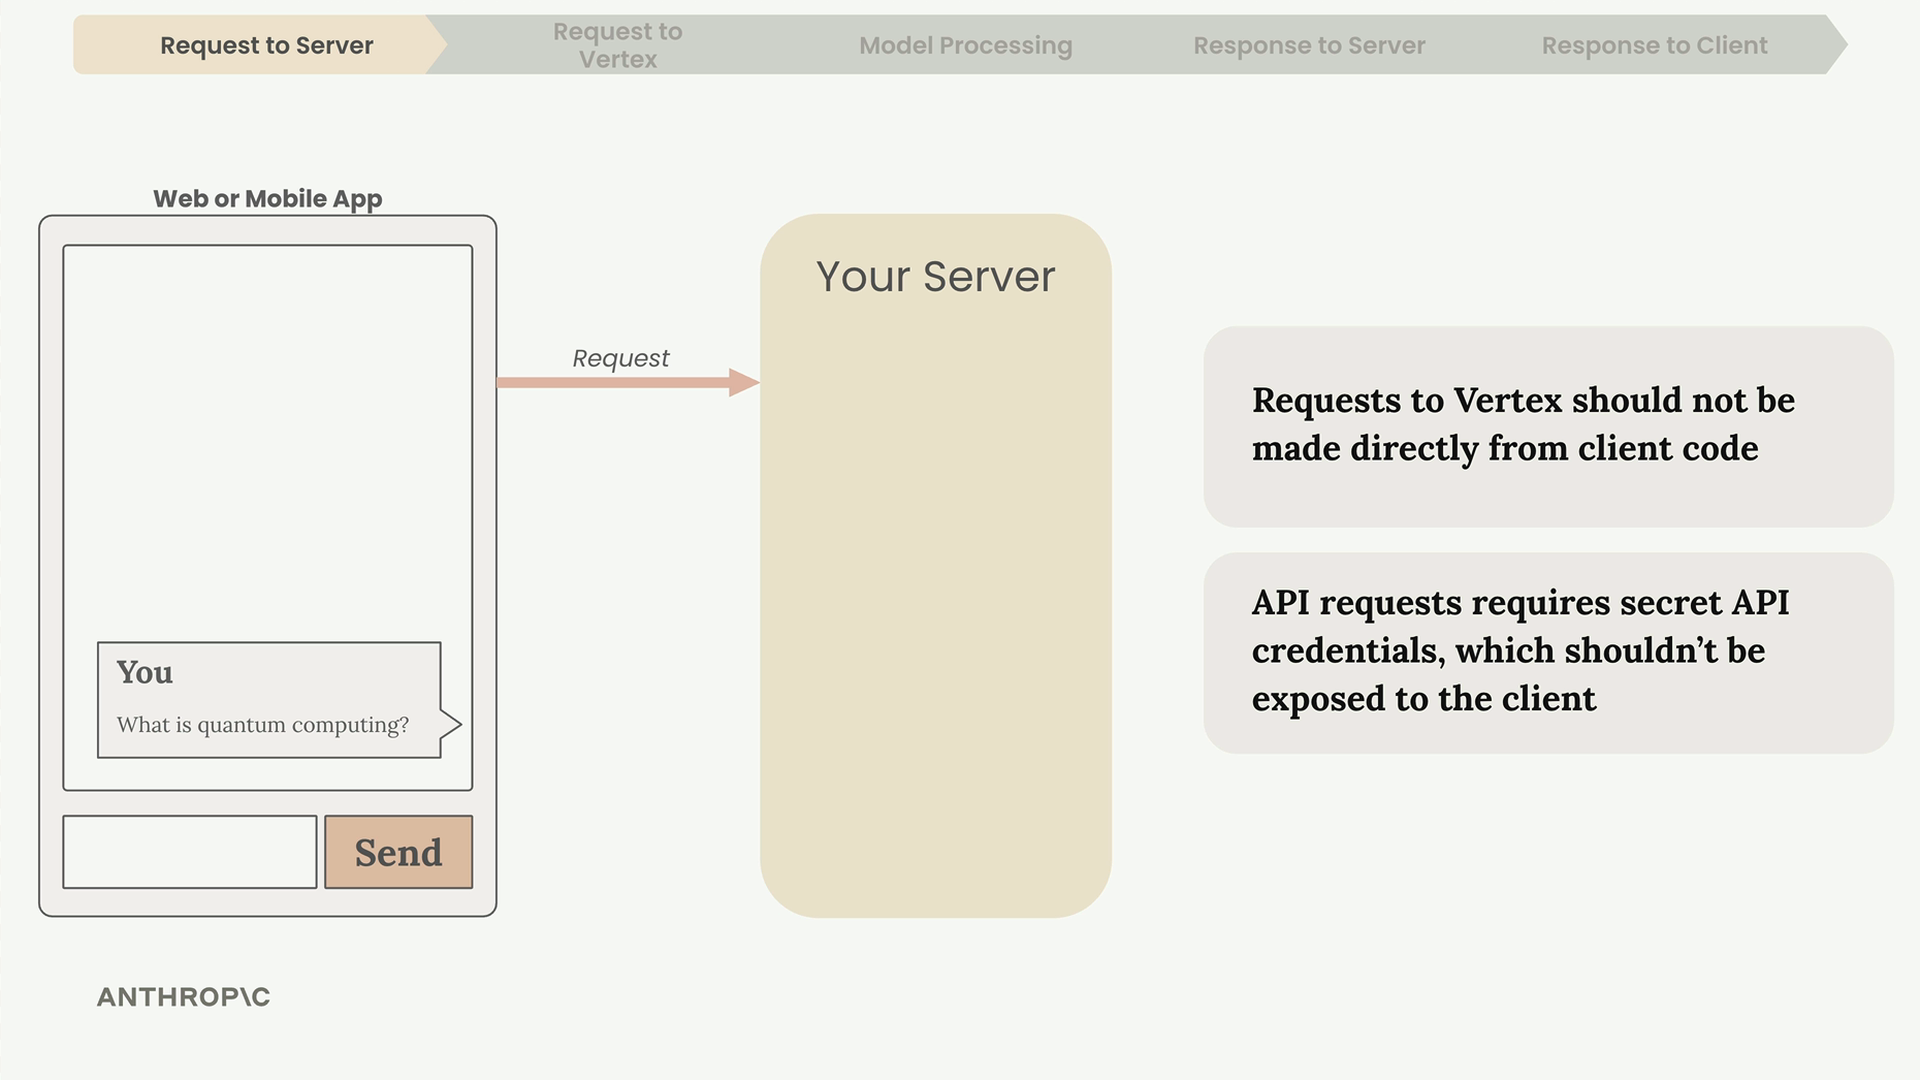
為什麼您需要伺服器
切勿直接從客戶端程式碼發出 API 請求。原因如下:
- API 請求需要必須保持安全的機密憑證
- 在客戶端程式碼中暴露憑證會使任何人都能看到它們
- 您的伺服器充當您的應用程式與 Vertex 之間的安全中介
請務必透過您自己控制和保護的伺服器來路由請求。
發出 API 請求
您的伺服器使用 Anthropic 的 SDK 或 Google 的官方 Vertex SDK 與 Vertex 通訊。Anthropic 提供適用於 Python、TypeScript、Go 和 Ruby 的官方 SDK。
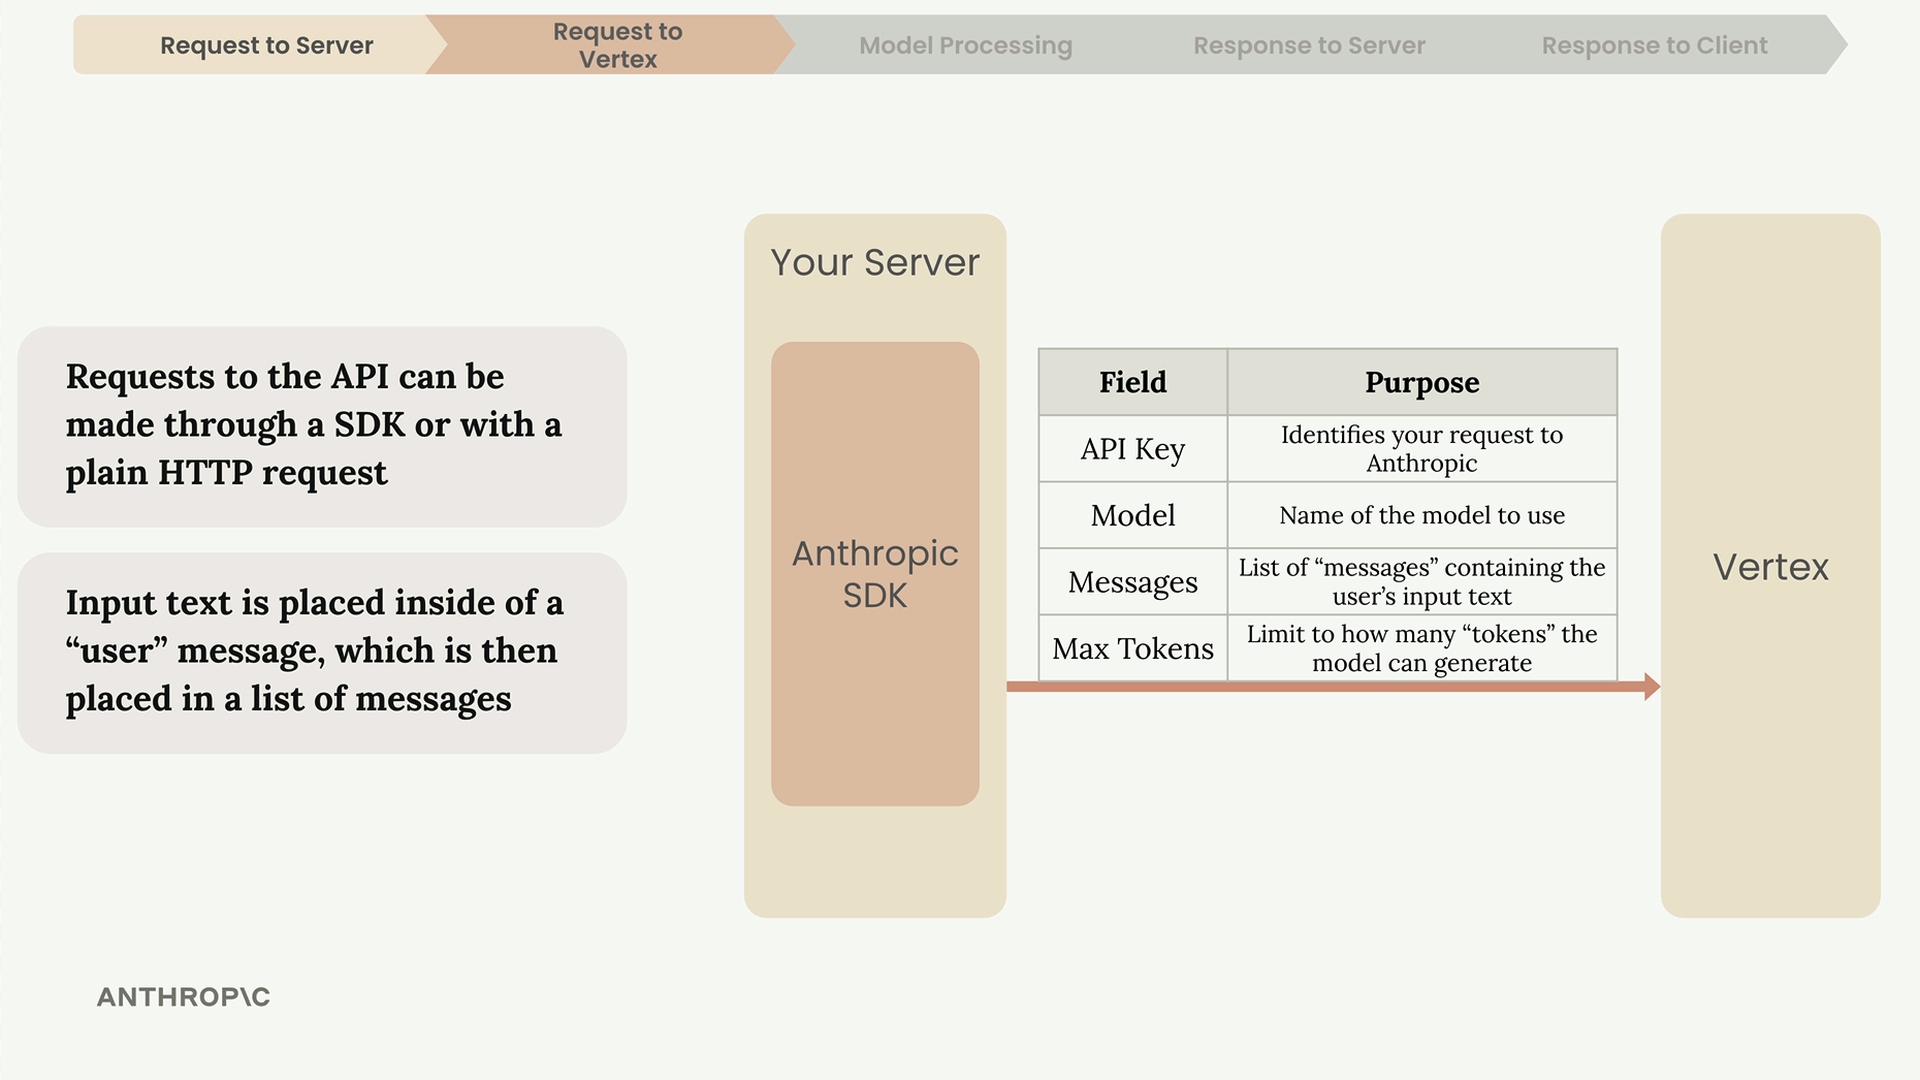
每個請求都必須包含以下關鍵欄位:
- Google Cloud 憑證 - 授權您在 Google Cloud 上的請求
- 模型 - 要使用的特定模型名稱
- 訊息 - 包含使用者輸入文字的清單
- 最大 Token 數 - 限制模型可以生成的 Token 數量
使用者的輸入會被放入一則「user」訊息中,然後該訊息會進入傳送至 API 的訊息清單中。
Claude 內部:文字生成過程
一旦 Vertex 收到您的請求,Claude 會透過四個階段處理它:Token 化、嵌入、語境化和生成。
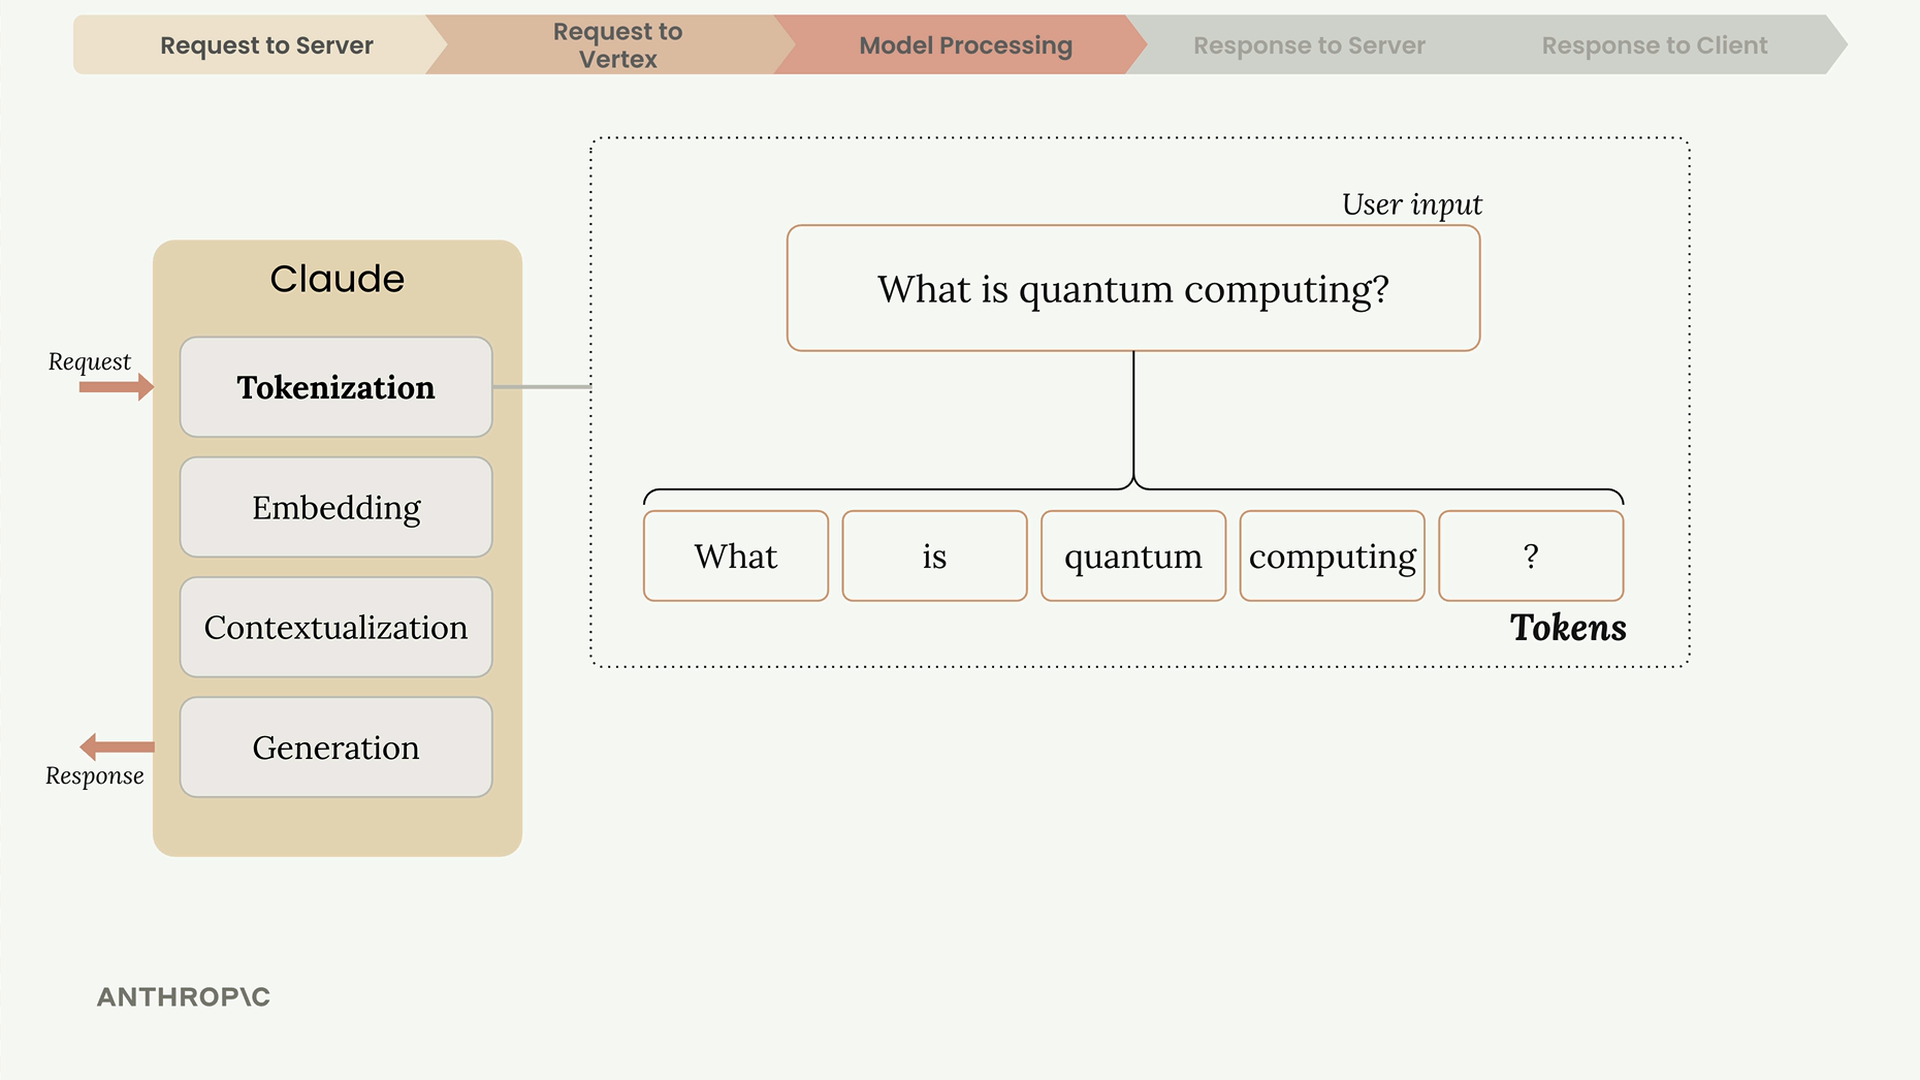
Token 化
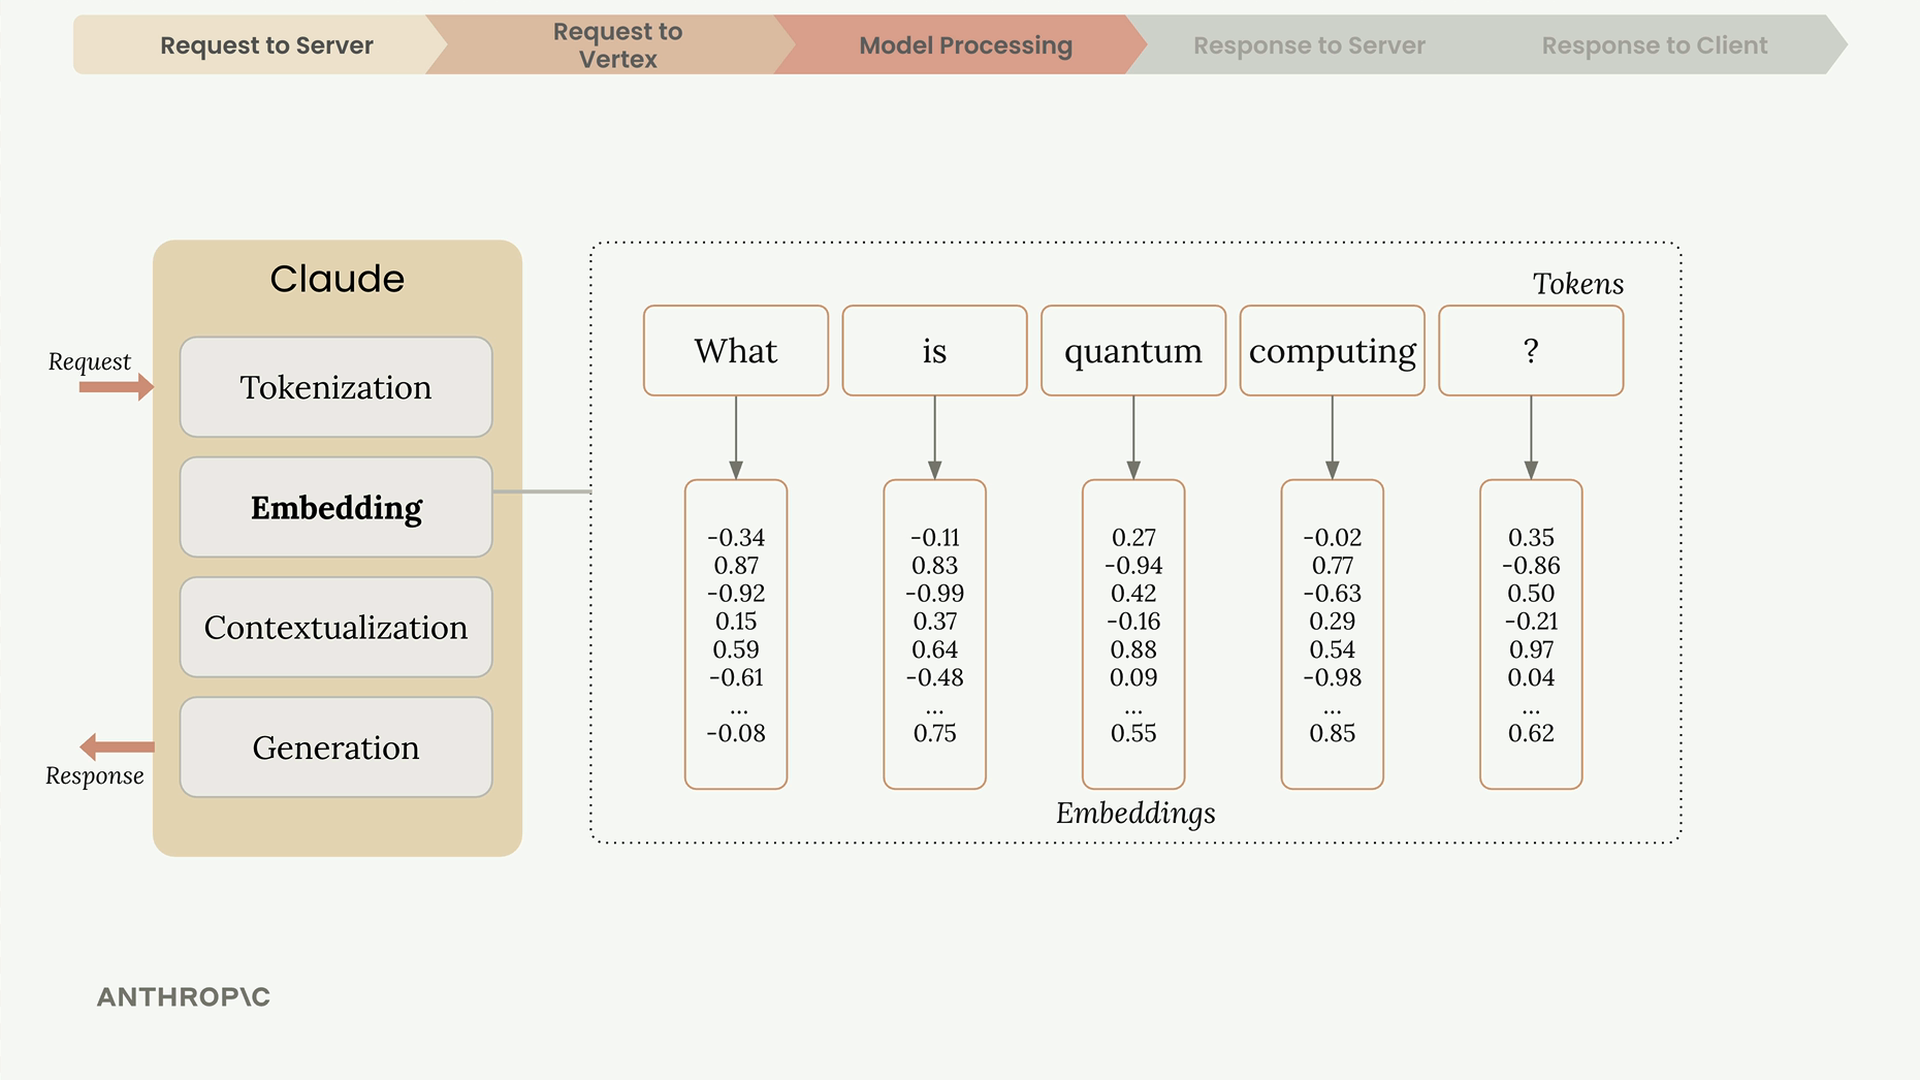
Claude 首先將輸入文字分解成稱為 Token 的較小區塊。這些可以是完整的單字、單字的一部分、空格或符號。為簡化起見,可以將每個單字視為一個 Token。
嵌入
每個 Token 都會被轉換成一個嵌入(embedding)——一長串代表該單字所有可能含義的數字。可以將嵌入視為以數字為基礎的定義。
語境化
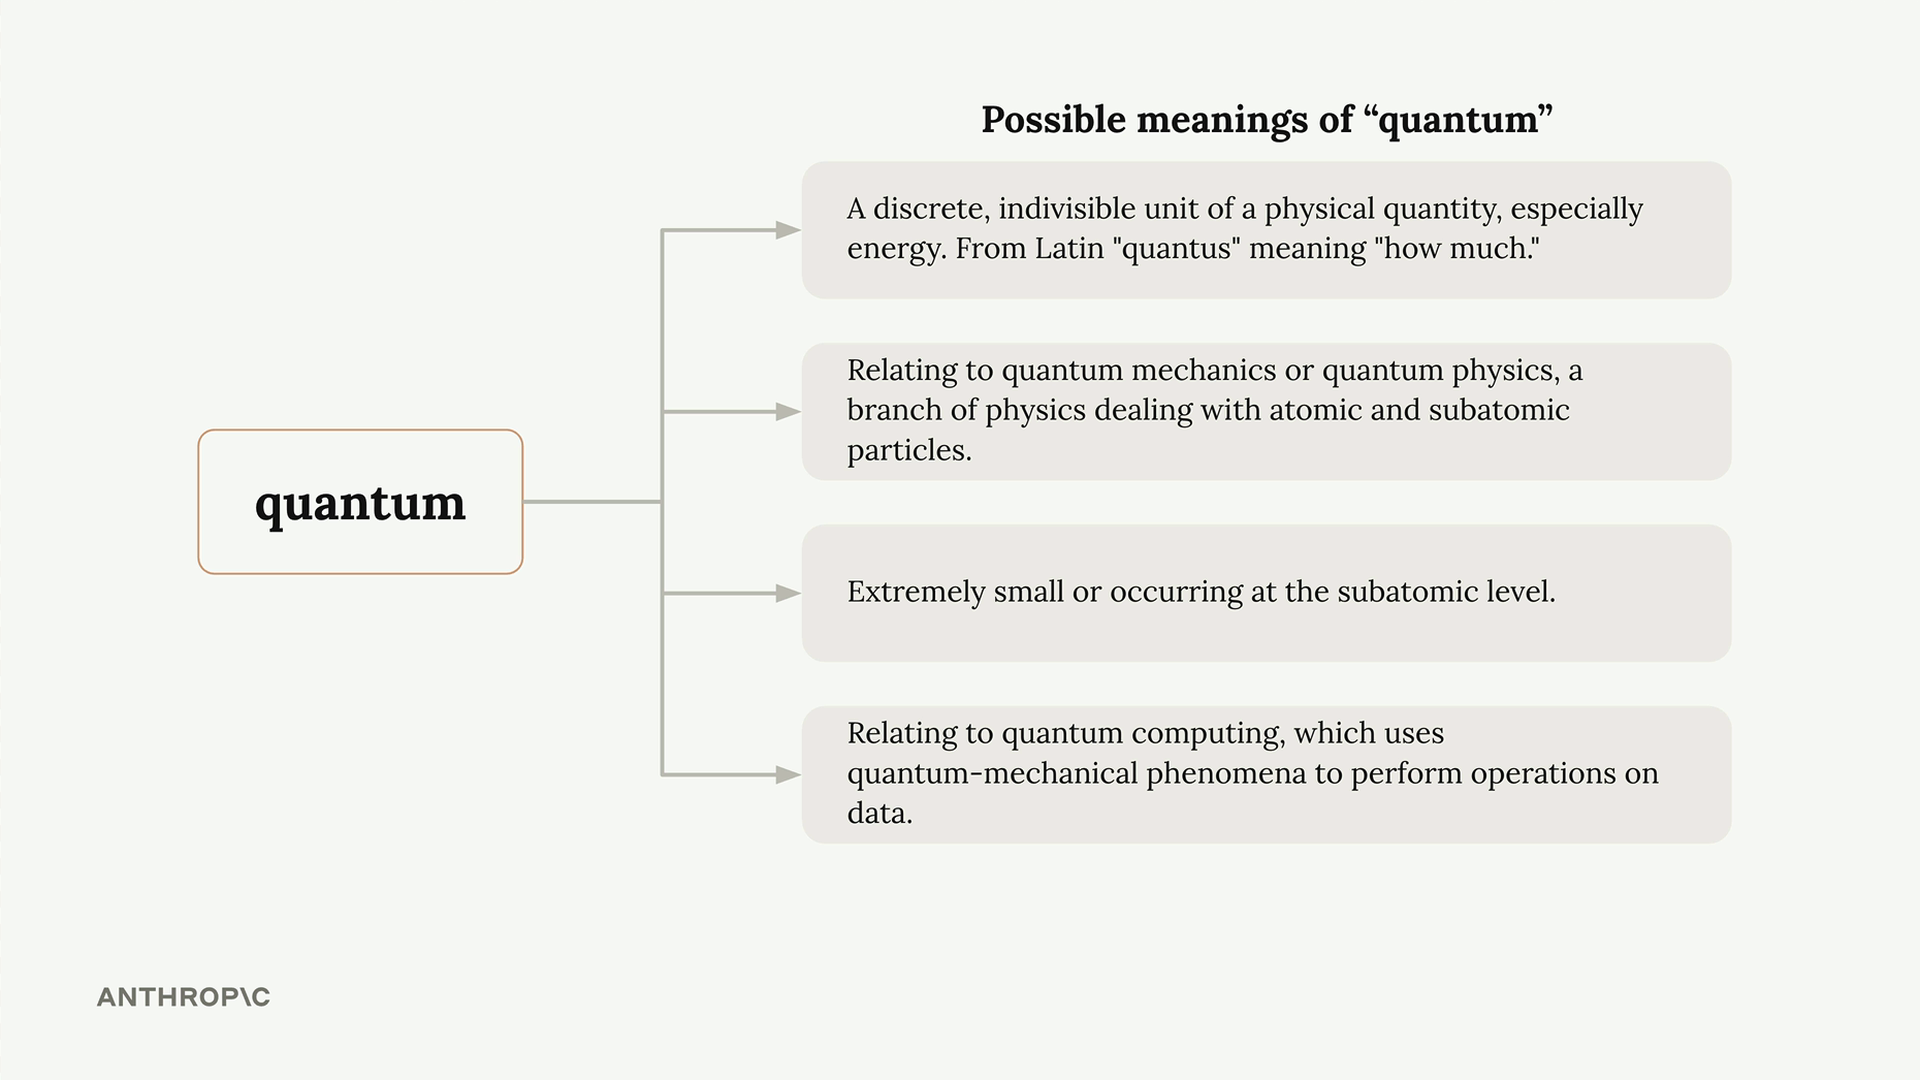
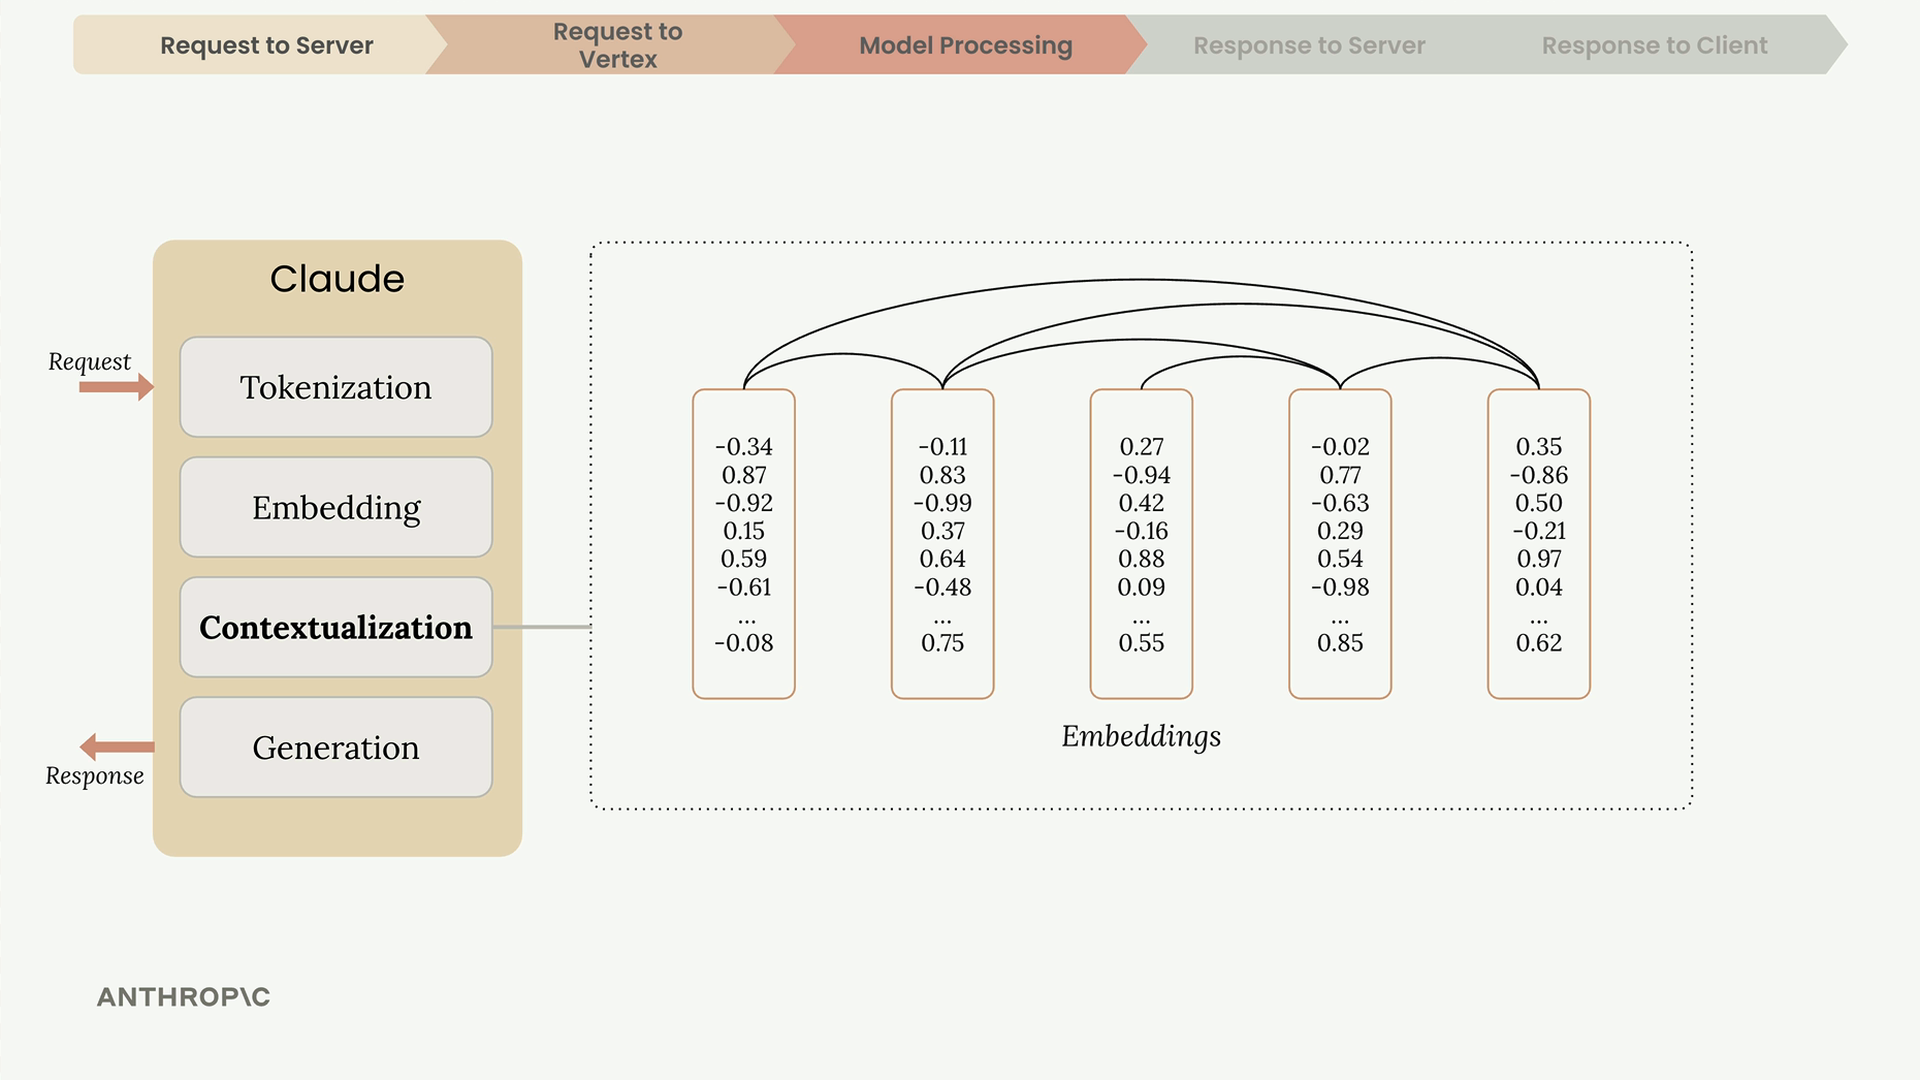
由於單字可能有多重含義,Claude 會使用語境來確定正確的解釋。「quantum」這個詞可能指物理學、運算,或僅僅表示「非常小」——來自周圍單字的語境會釐清其預期含義。
在語境化過程中,每個嵌入都會根據其鄰近的內容進行調整,突顯出在該語境下最合理的含義。
生成
經過語境化的嵌入會通過一個輸出層,該層會為每個可能的下一個單字產生機率。Claude 並不總是選擇機率最高的單字——它會混合使用機率和隨機性,以創造更自然、更多樣化的回應。
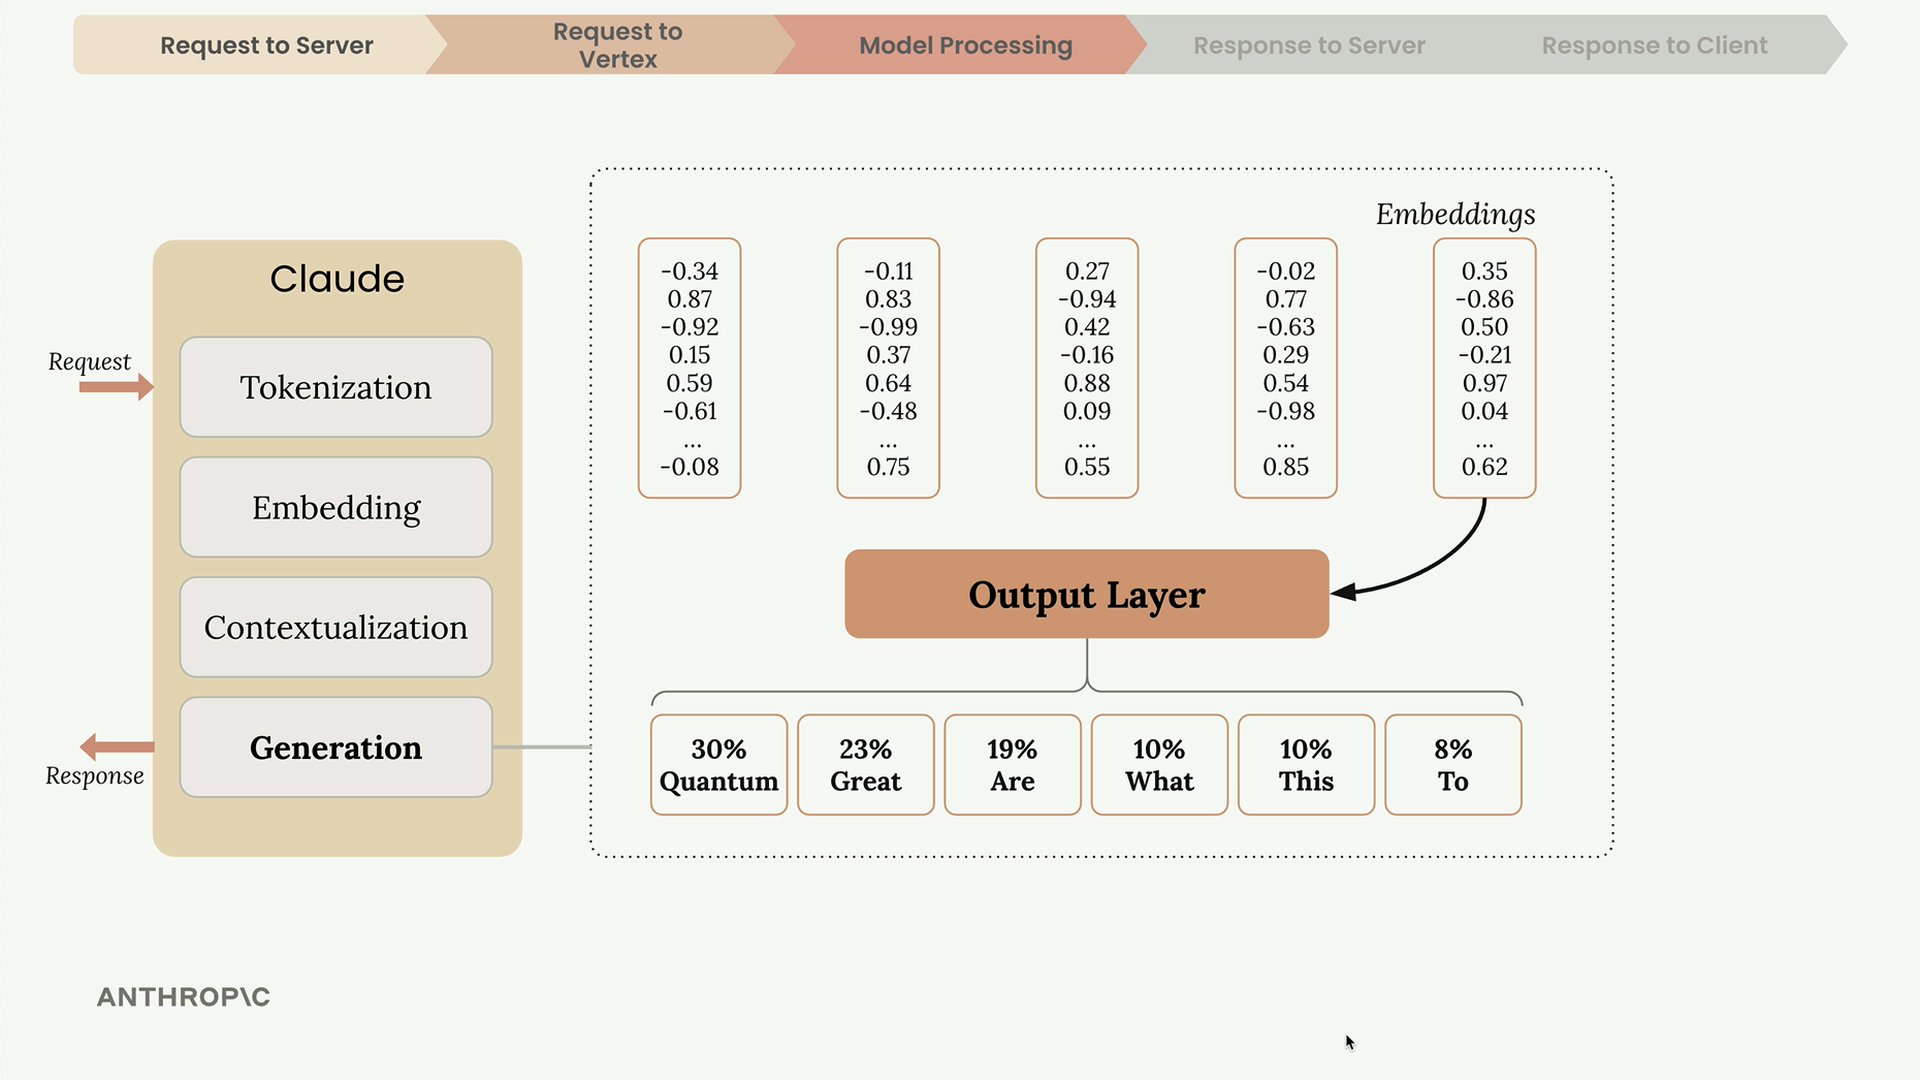
選定一個單字後,Claude 會將其加入序列中,並對下一個單字重複整個過程。
生成何時停止
在生成每個 Token 之後,Claude 會檢查幾個條件以決定是否繼續:
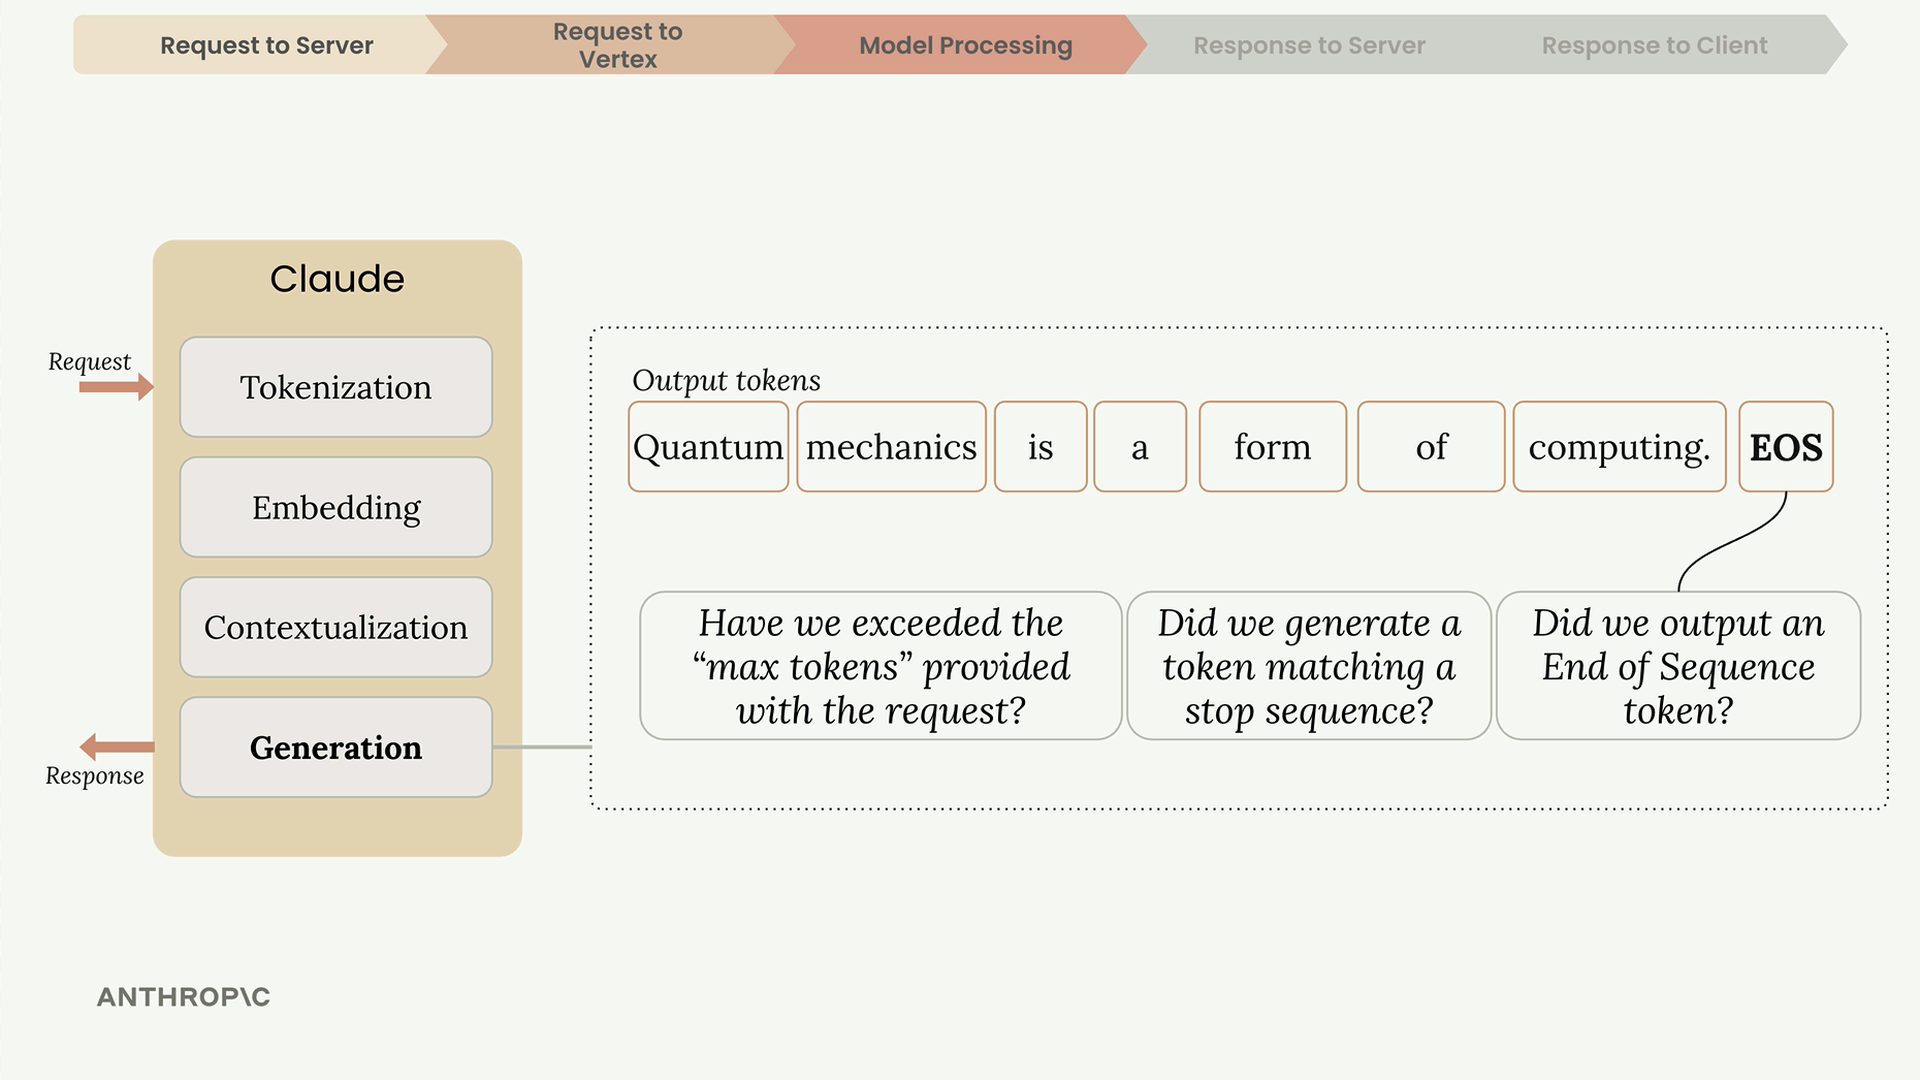
- 達到最大 Token 數 - 是否已達到您指定的限制?
- 自然結束 - 是否生成了序列結束 Token?
- 停止序列 - 是否遇到了預先定義的停止短語?
序列結束 Token 是一個特殊訊號(非可見文字),Claude 用它來表示已達到自然的結論。
回應
一旦生成完成,Vertex 會將回應傳回您的伺服器,其中包含:
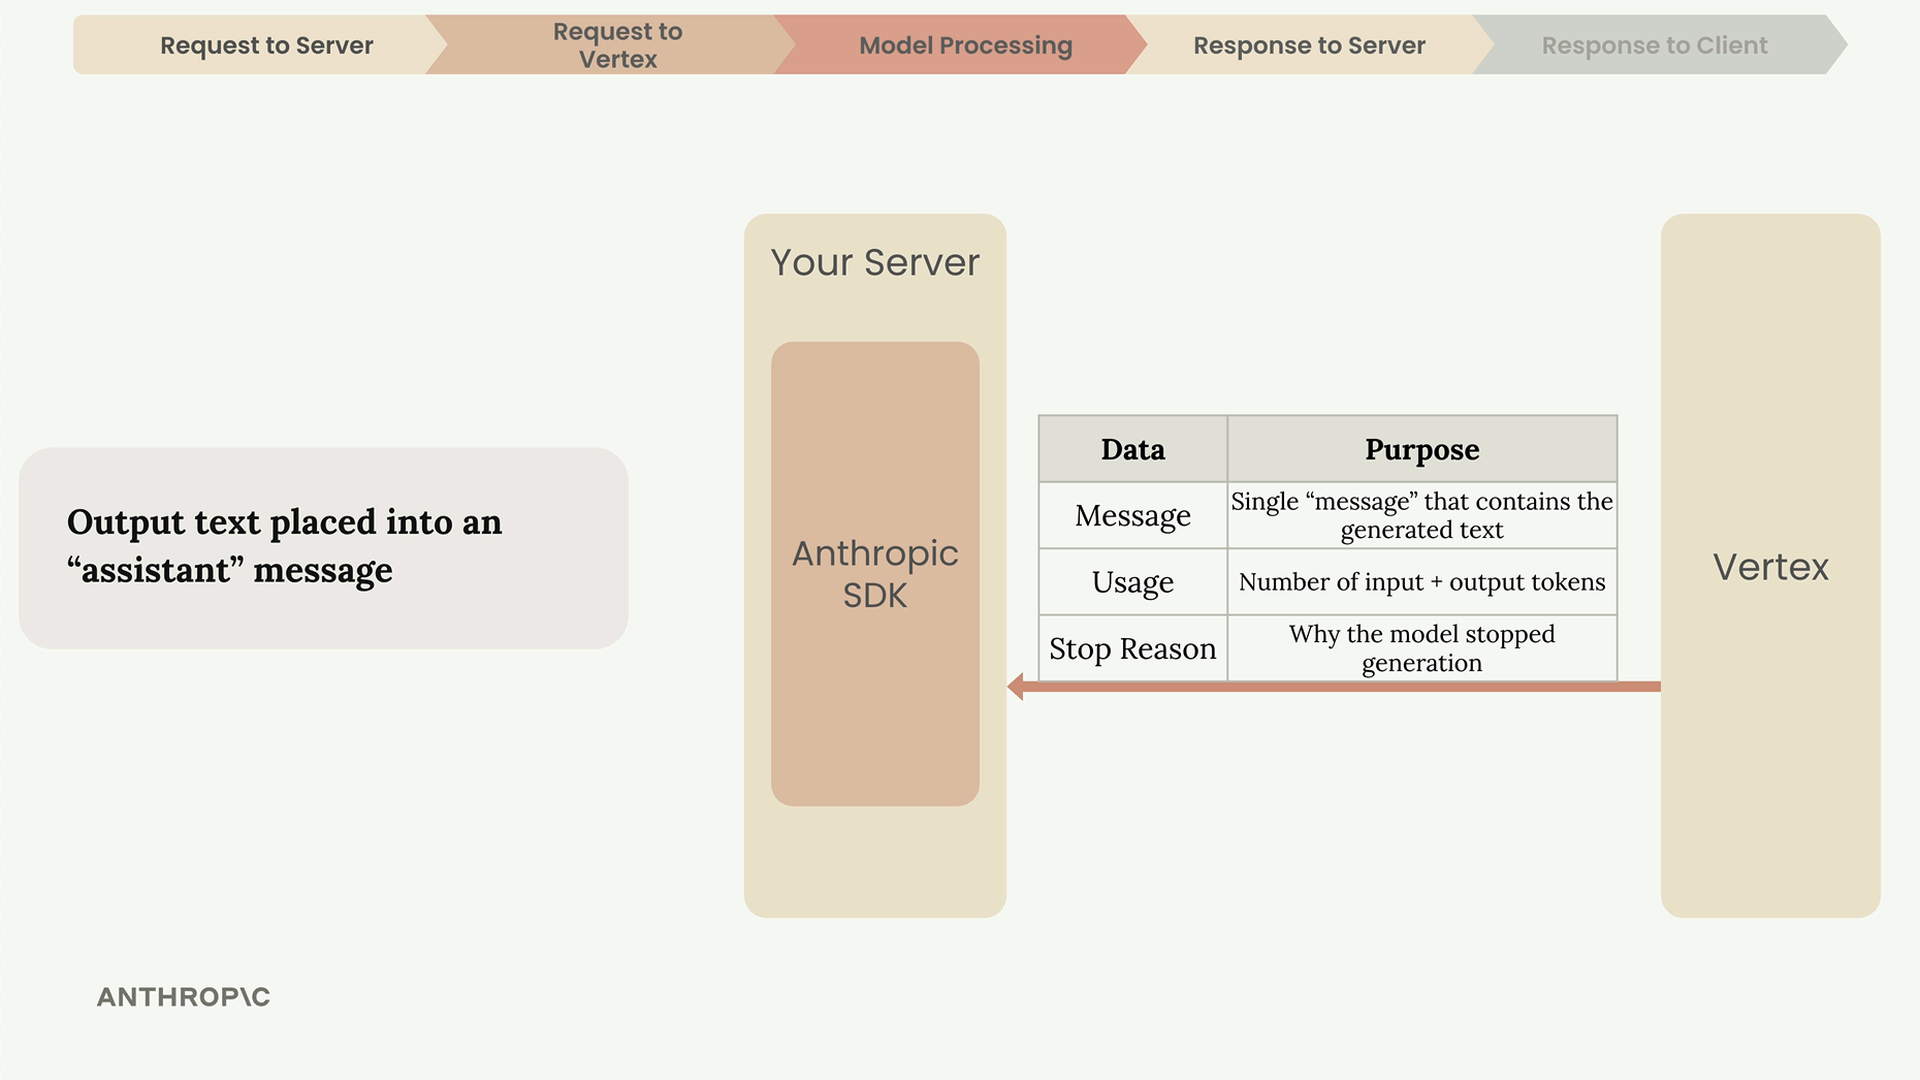
- 訊息 - 生成的文字
- 使用量 - 輸入和輸出 Token 的計數
- 停止原因 - 模型停止生成的原因
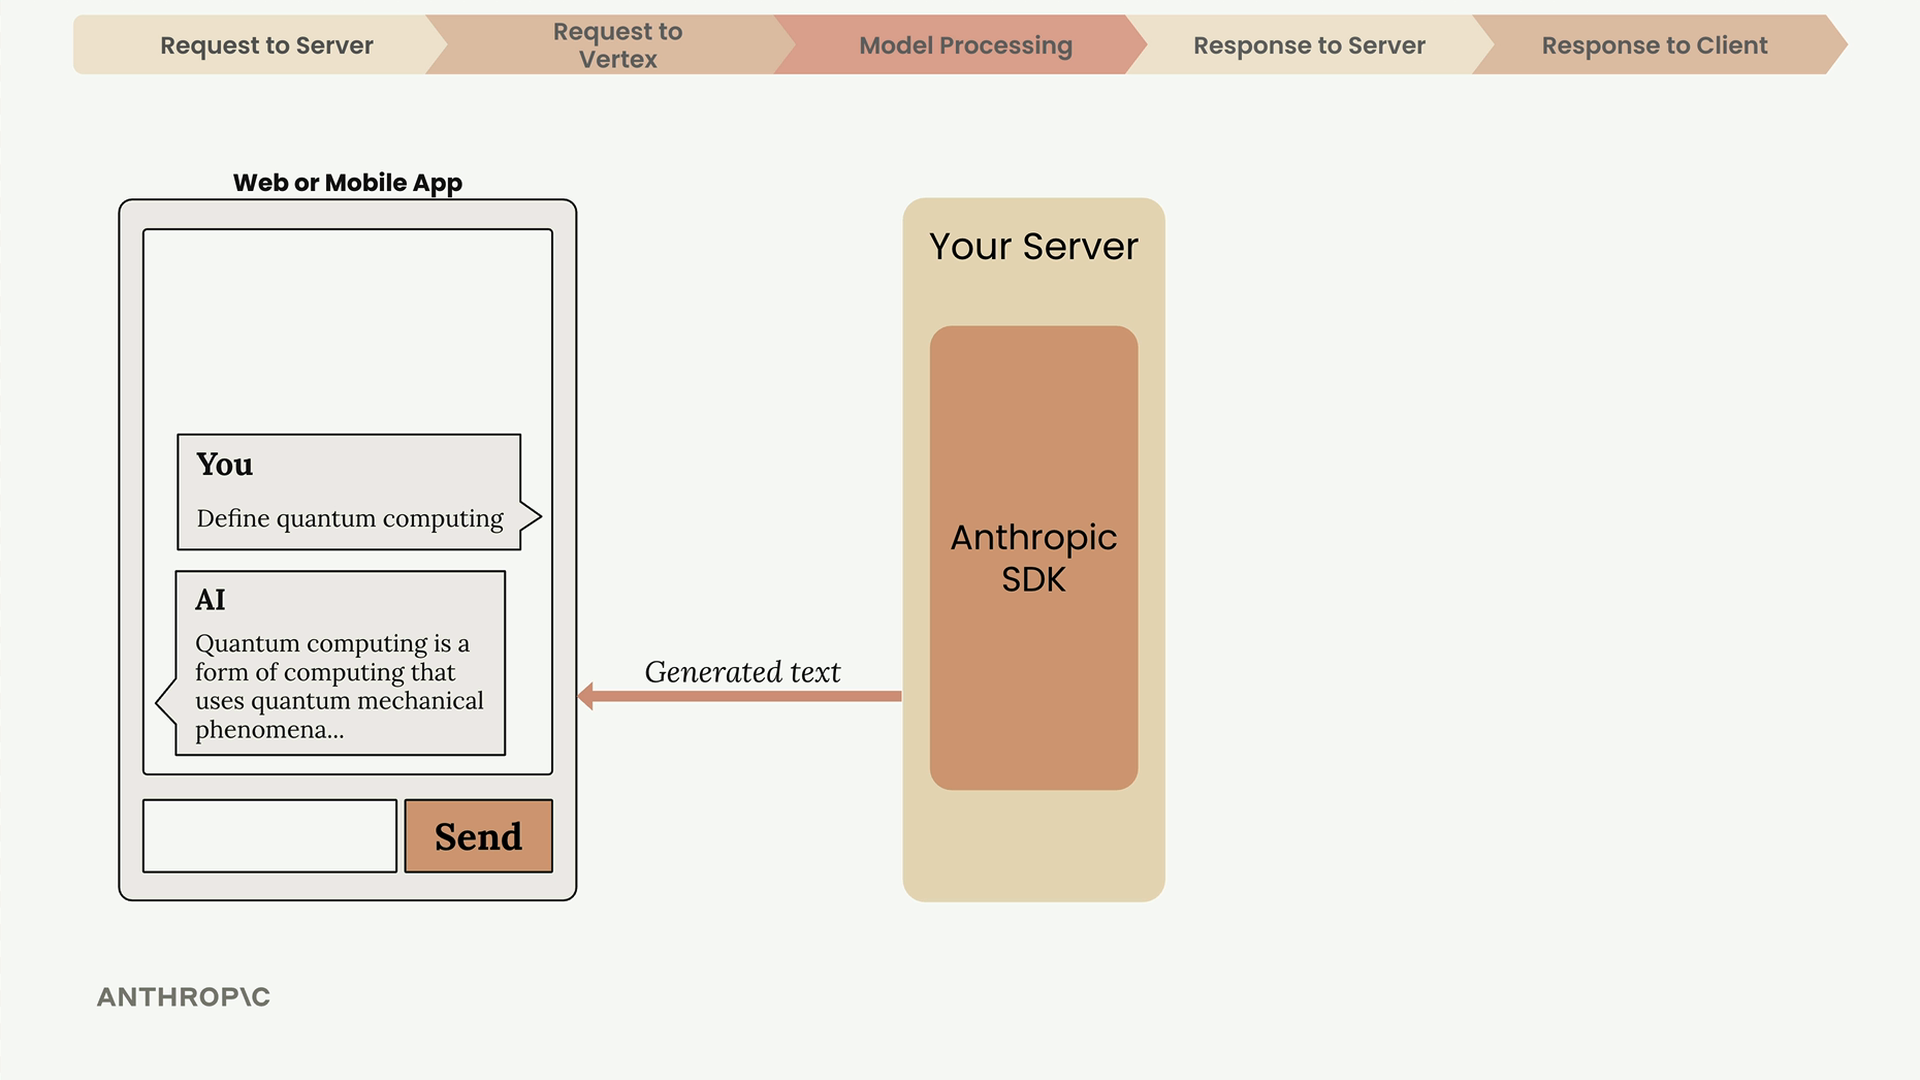
接著,您的伺服器會將生成的文字轉發至您的客戶端應用程式,並顯示在聊天介面中。
完整的全貌
整個過程——從使用者輸入經過 Token 化、嵌入、語境化、生成,再回到使用者——在幾秒鐘內完成。了解這個流程有助於您建構更穩健的應用程式,並在問題出現時進行疑難排解。
關鍵要點:務必使用伺服器作為中介,理解文字生成是一個反覆運算的過程,並留意回應中繼資料以監控使用量並了解模型行為。