Maintenant que nous avons couvert les bases du RAG, du découpage de texte et des embeddings, parcourons le pipeline RAG complet étape par étape. Cet exemple détaillé vous montrera exactement comment toutes les pièces s'assemblent dans une implémentation réelle.
Étape 1 : Découper votre texte source
D'abord, nous prenons notre document source et le découpons en morceaux gérables. Pour cet exemple, nous utiliserons deux sections de texte simples :
- Section 1 : Recherche médicale - « Cette année a vu des avancées significatives dans notre compréhension du XDR-47, un 'bug' que nous n'avions jamais vu auparavant. »
- Section 2 : Ingénierie logicielle - « Cette division a consacré des efforts significatifs à l'étude de divers vecteurs d'infection dans nos systèmes distribués »
Étape 2 : Générer les embeddings
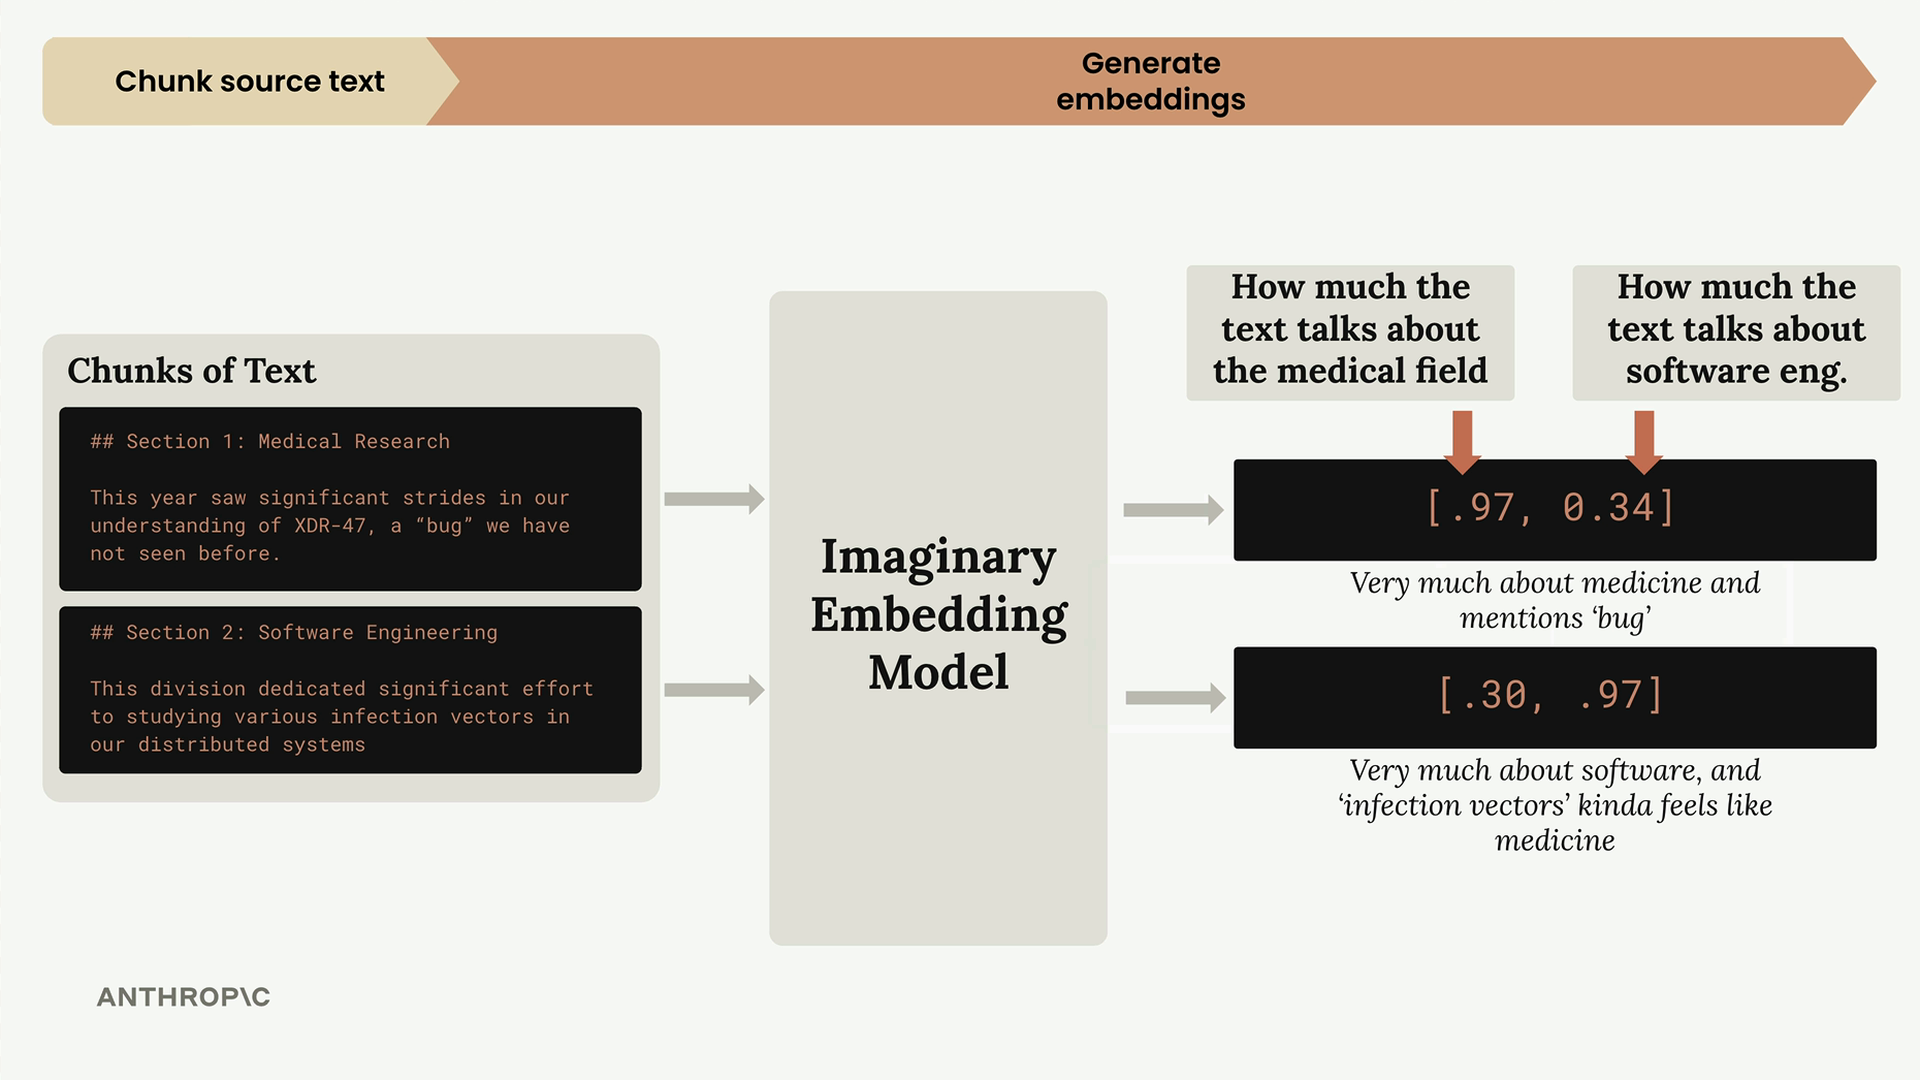
Ensuite, nous convertissons chaque morceau de texte en embeddings numériques. Pour faciliter la compréhension, imaginons que nous disposons d'un modèle d'embedding parfait qui renvoie toujours exactement deux nombres, et que nous savons ce que chaque nombre représente :
Dans notre modèle imaginaire :
- Premier nombre : à quel point le texte parle de médecine
- Deuxième nombre : à quel point le texte parle d'ingénierie logicielle
Ainsi, notre section de recherche médicale obtient [0.97, 0.34] - très médicale, quelque peu liée au logiciel en raison du mot « bug ». La section d'ingénierie logicielle obtient [0.30, 0.97] - très axée sur le logiciel, mais « vecteurs d'infection » a des connotations médicales.
Normalisation
Avant de stocker ces embeddings, ils passent par un processus de normalisation qui met à l'échelle chaque vecteur pour avoir une magnitude de 1,0. Cela est généralement géré automatiquement par votre API d'embedding, mais il est important de comprendre que cela se produit.
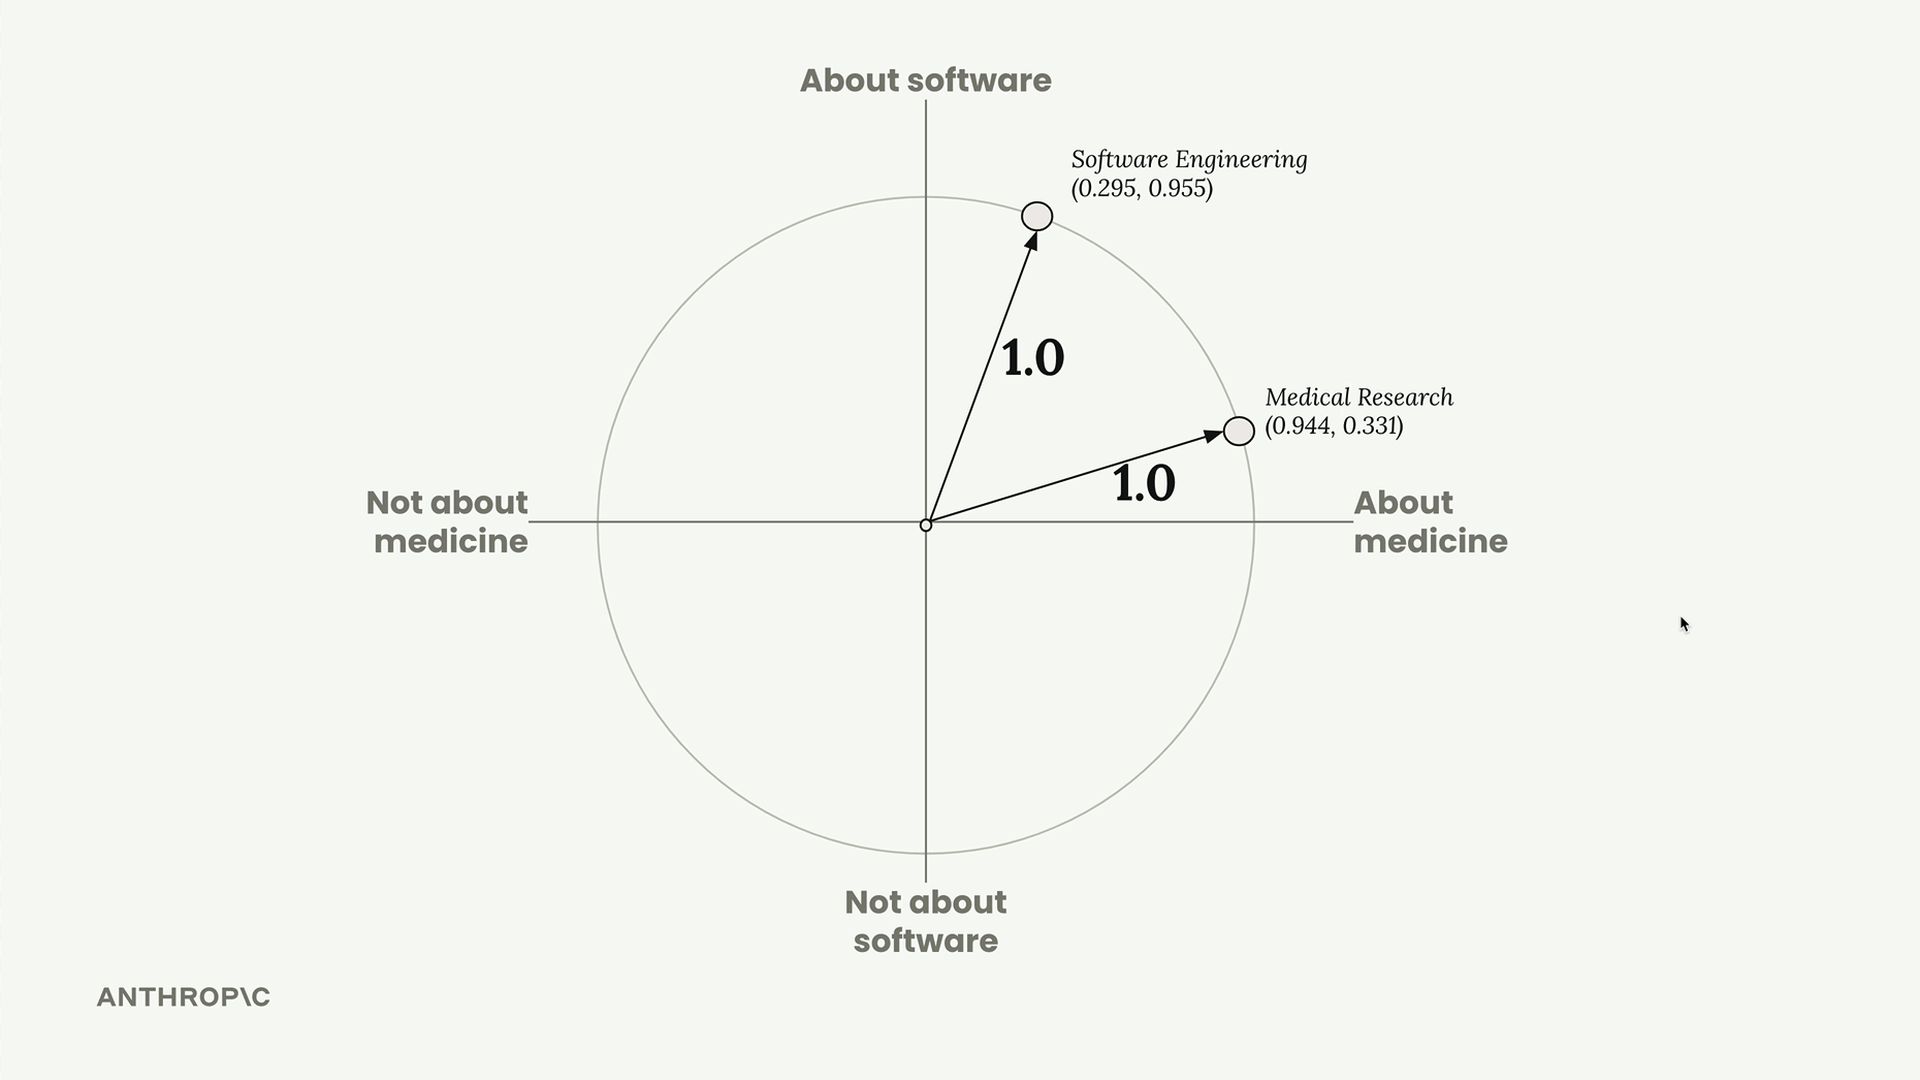
Après normalisation, nos embeddings deviennent [0.944, 0.331] et [0.295, 0.955]. Nous pouvons les visualiser sur un cercle unitaire où les deux points se trouvent exactement sur le bord du cercle.
Étape 3 : Stocker dans une base de données vectorielle
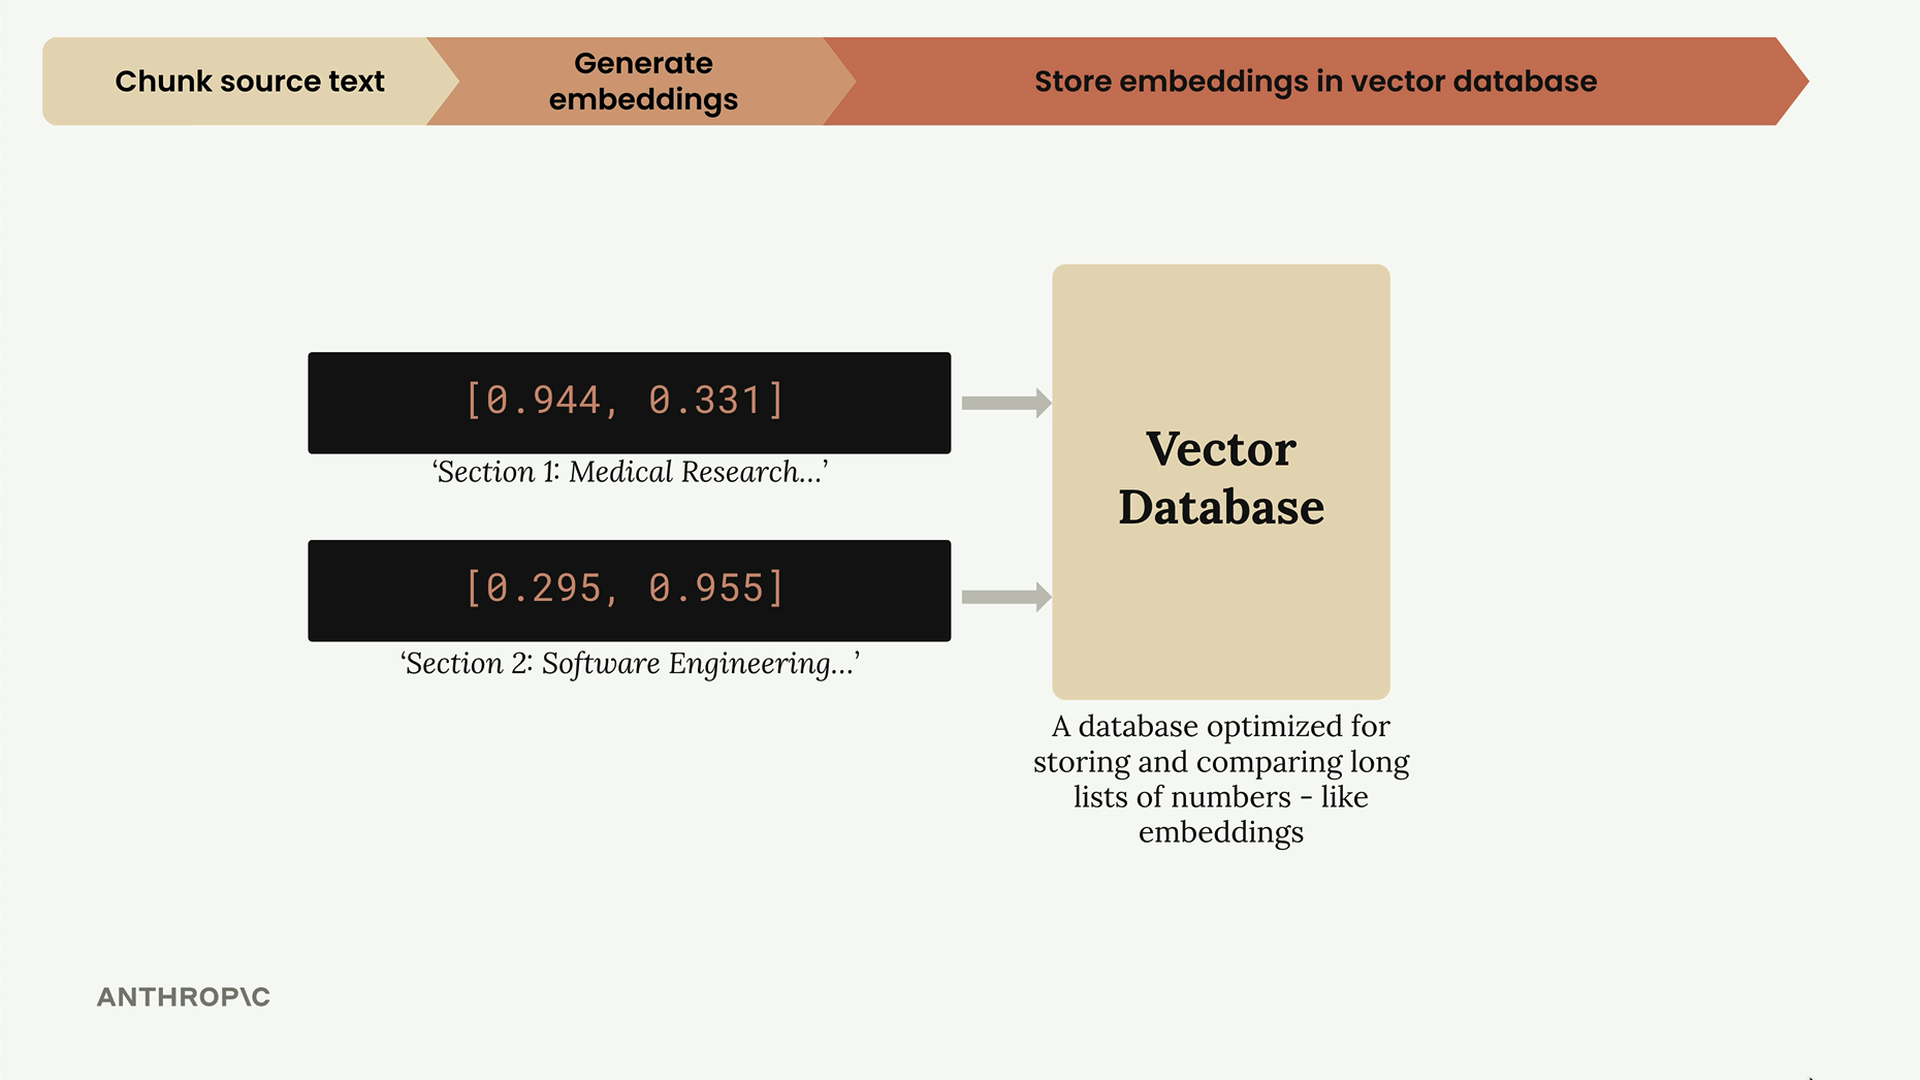
Les embeddings normalisés sont stockés dans une base de données vectorielle - une base de données spécialisée optimisée pour stocker, comparer et rechercher dans de longues listes de nombres comme nos embeddings.
À ce stade, nous faisons une pause. Tout le travail effectué jusqu'à présent était du prétraitement qui se produit à l'avance. Maintenant, nous attendons qu'un utilisateur soumette une requête.
Étape 4 : Traiter la requête de l'utilisateur
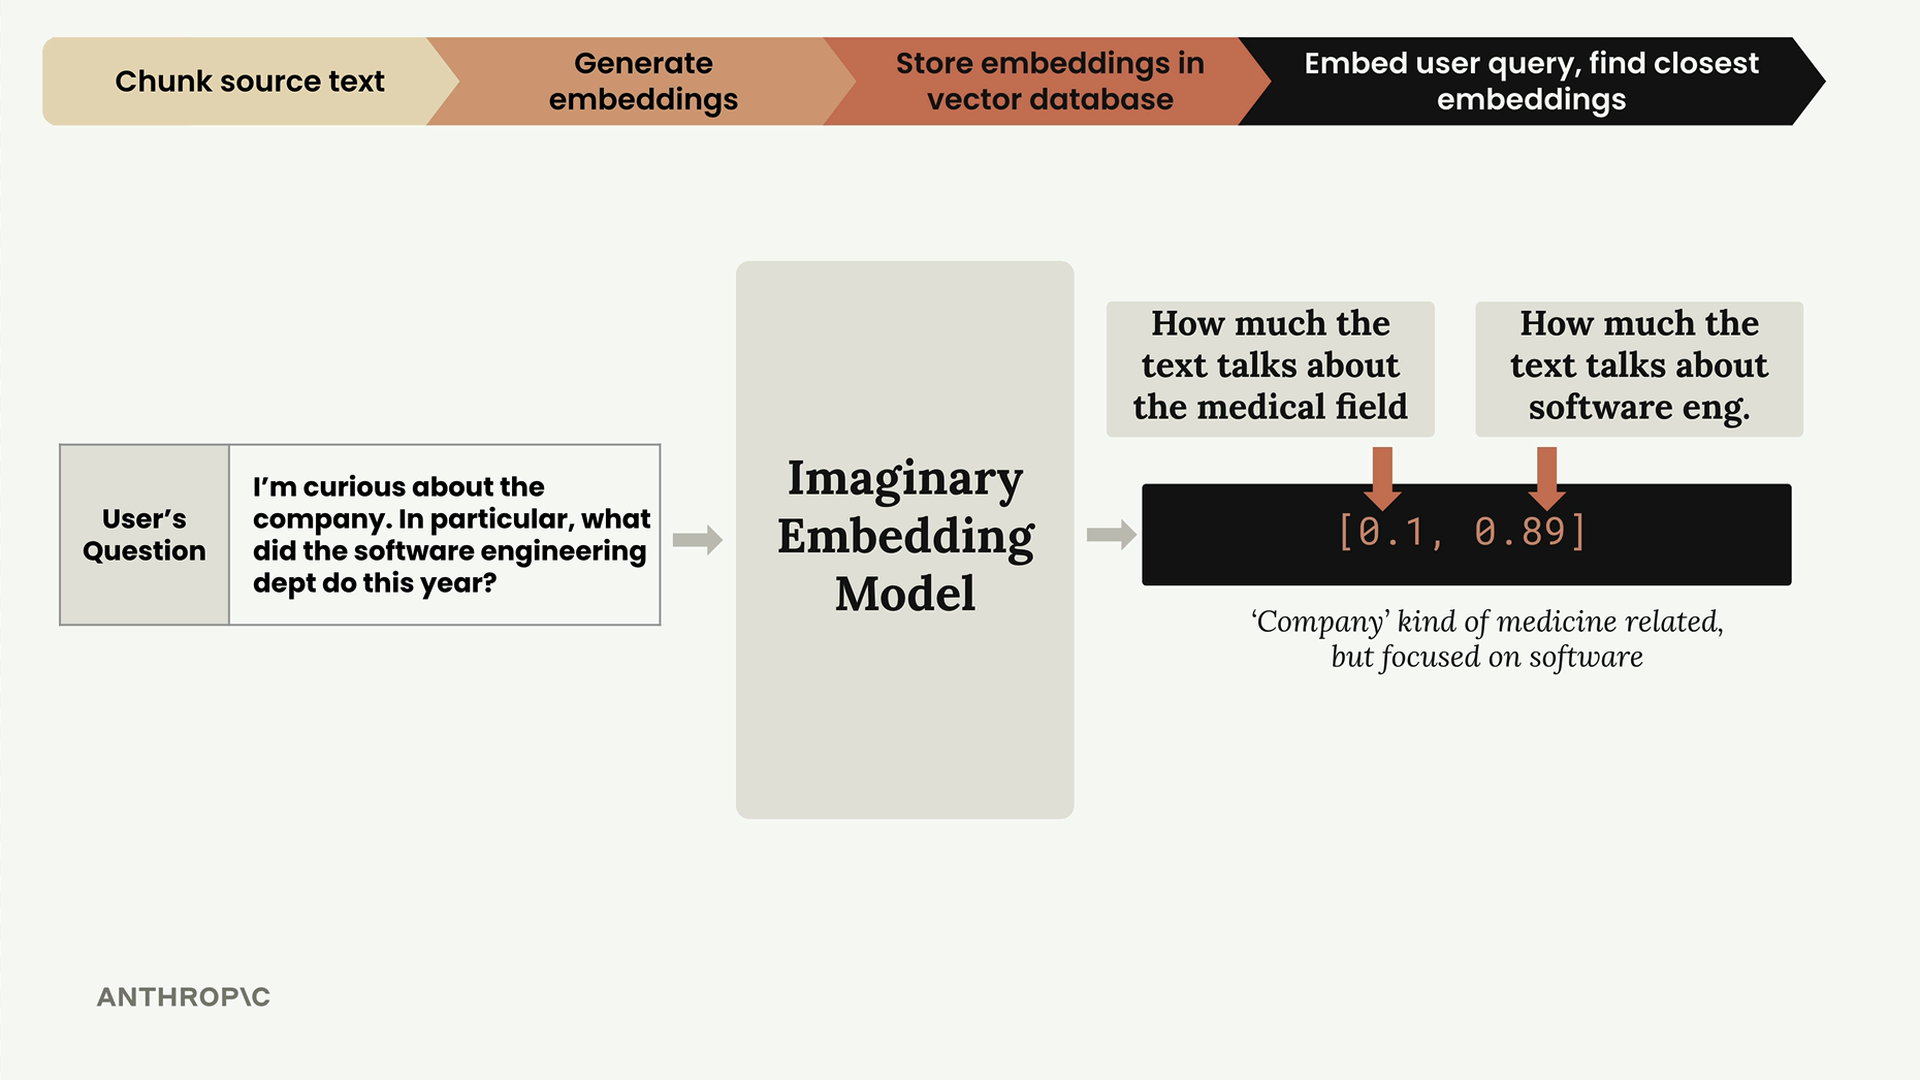
Lorsqu'un utilisateur pose une question comme « Je suis curieux à propos de l'entreprise. En particulier, qu'a fait le département d'ingénierie logicielle cette année ? », nous faisons passer sa requête par le même modèle d'embedding.
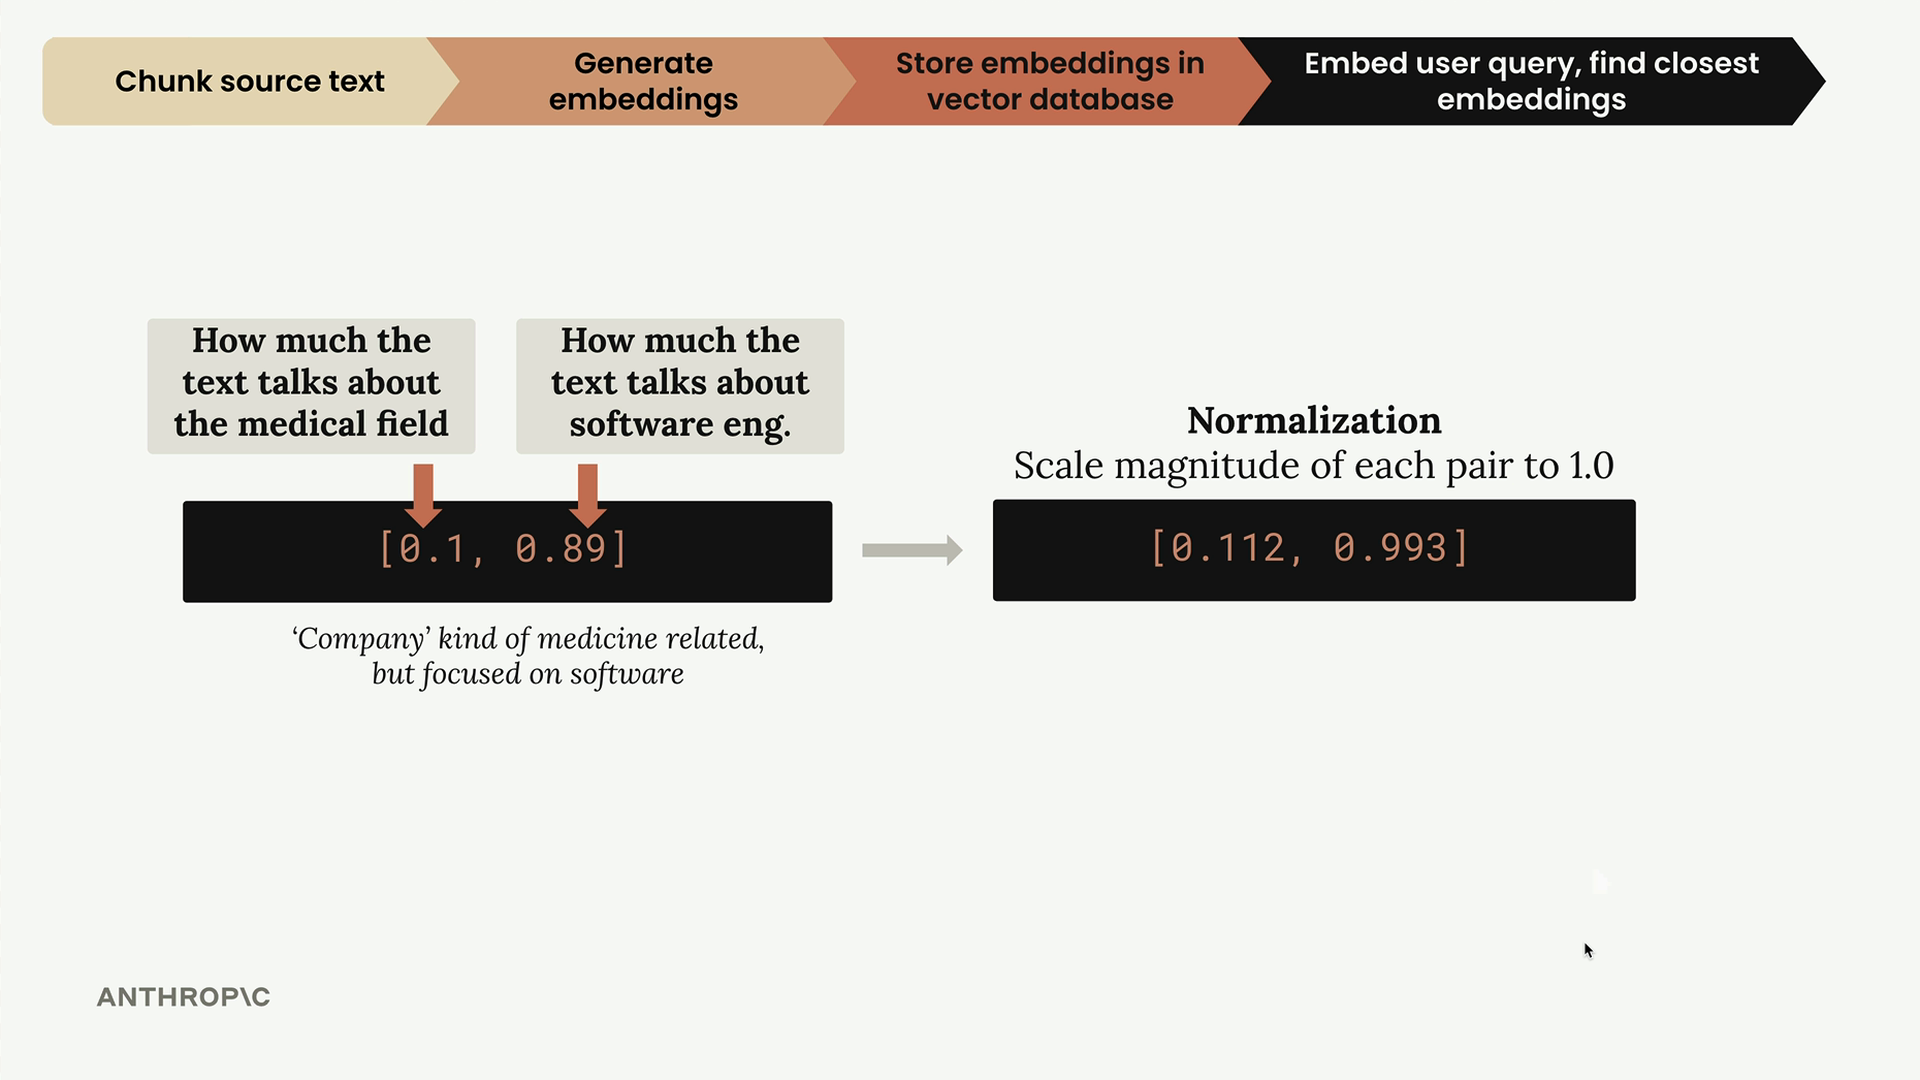
Cette requête est encodée comme [0.1, 0.89] - score médical faible, score d'ingénierie logicielle élevé. Après normalisation, elle devient [0.112, 0.993].
Étape 5 : Trouver des embeddings similaires
Maintenant, nous demandons à la base de données vectorielle : « Trouve l'embedding stocké le plus proche de cet embedding de requête utilisateur. » La base de données renvoie la section d'ingénierie logicielle car c'est la plus similaire.
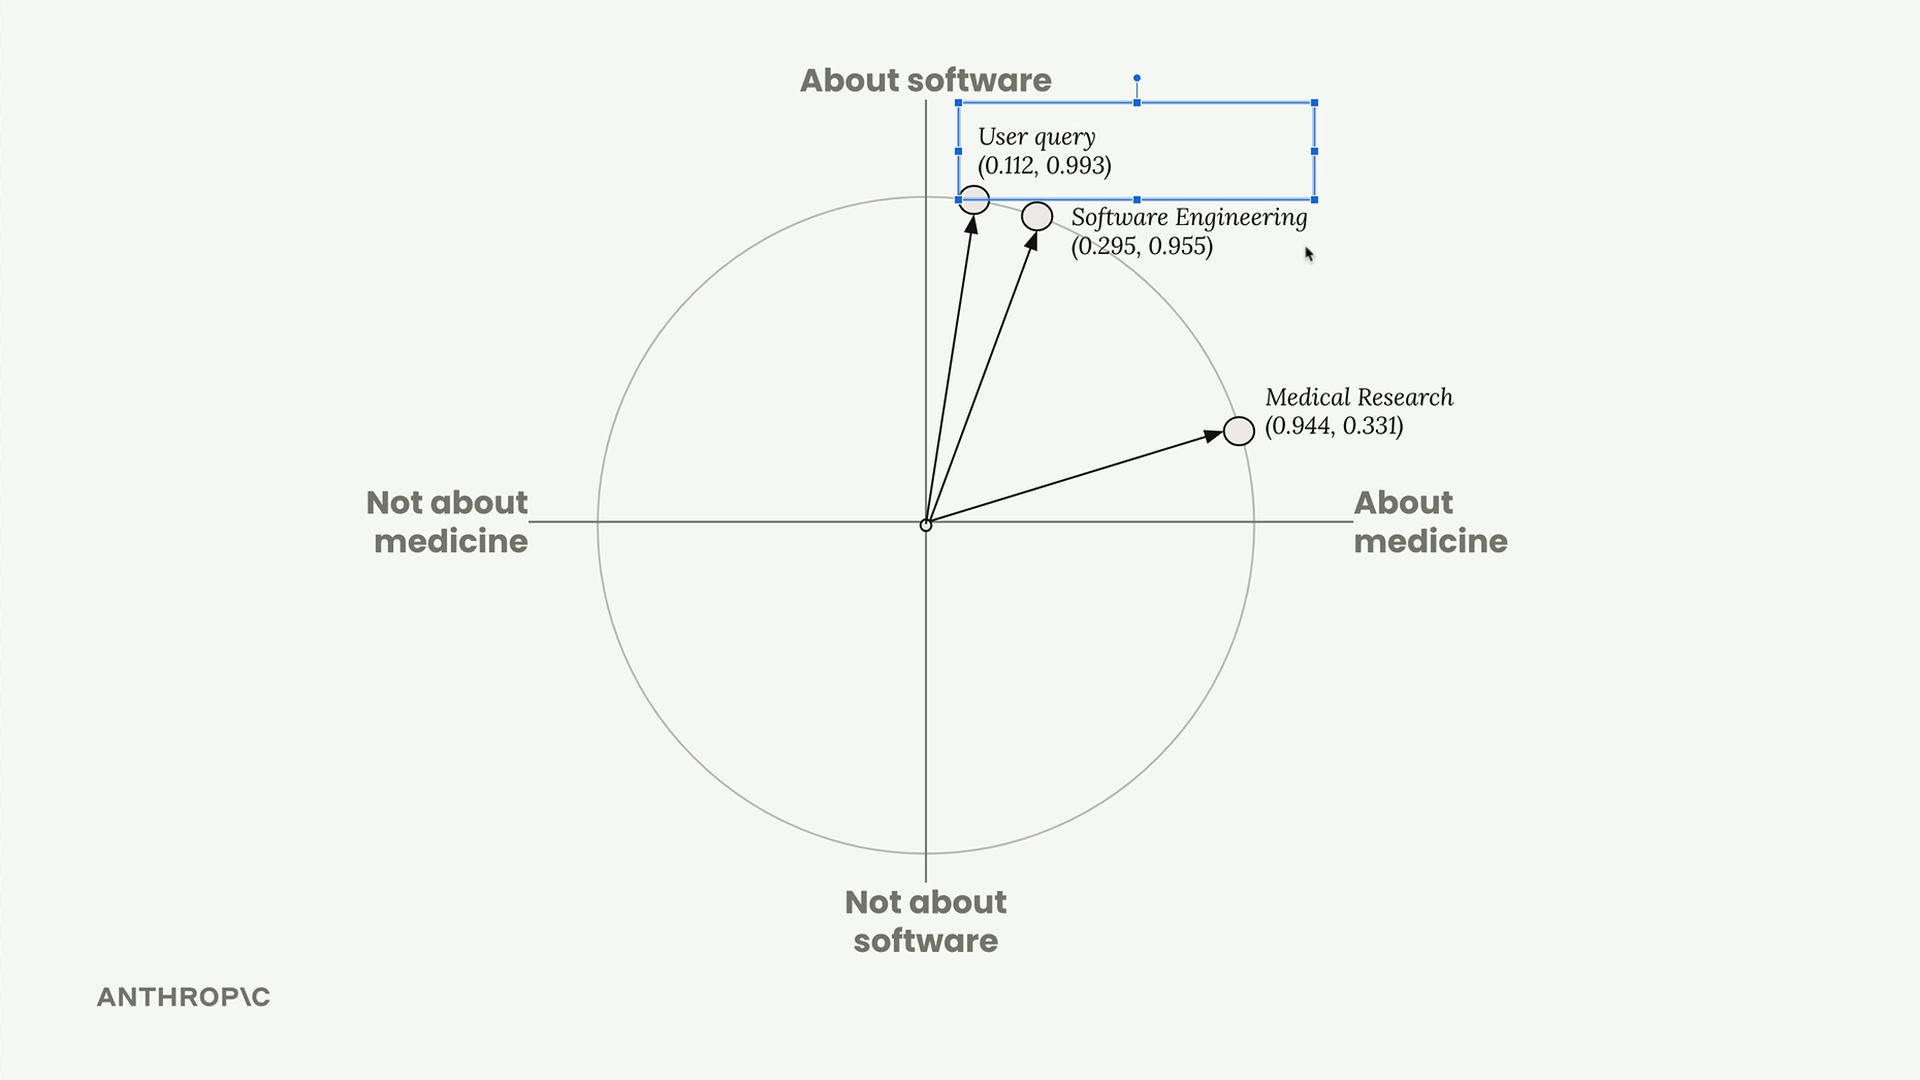
Mais comment la base de données détermine-t-elle ce qui est « le plus proche » ? Elle utilise la similarité cosinus.
Similarité cosinus
La base de données vectorielle calcule le cosinus de l'angle entre les vecteurs pour mesurer la similarité. Cela nous donne un nombre entre -1 et 1 :
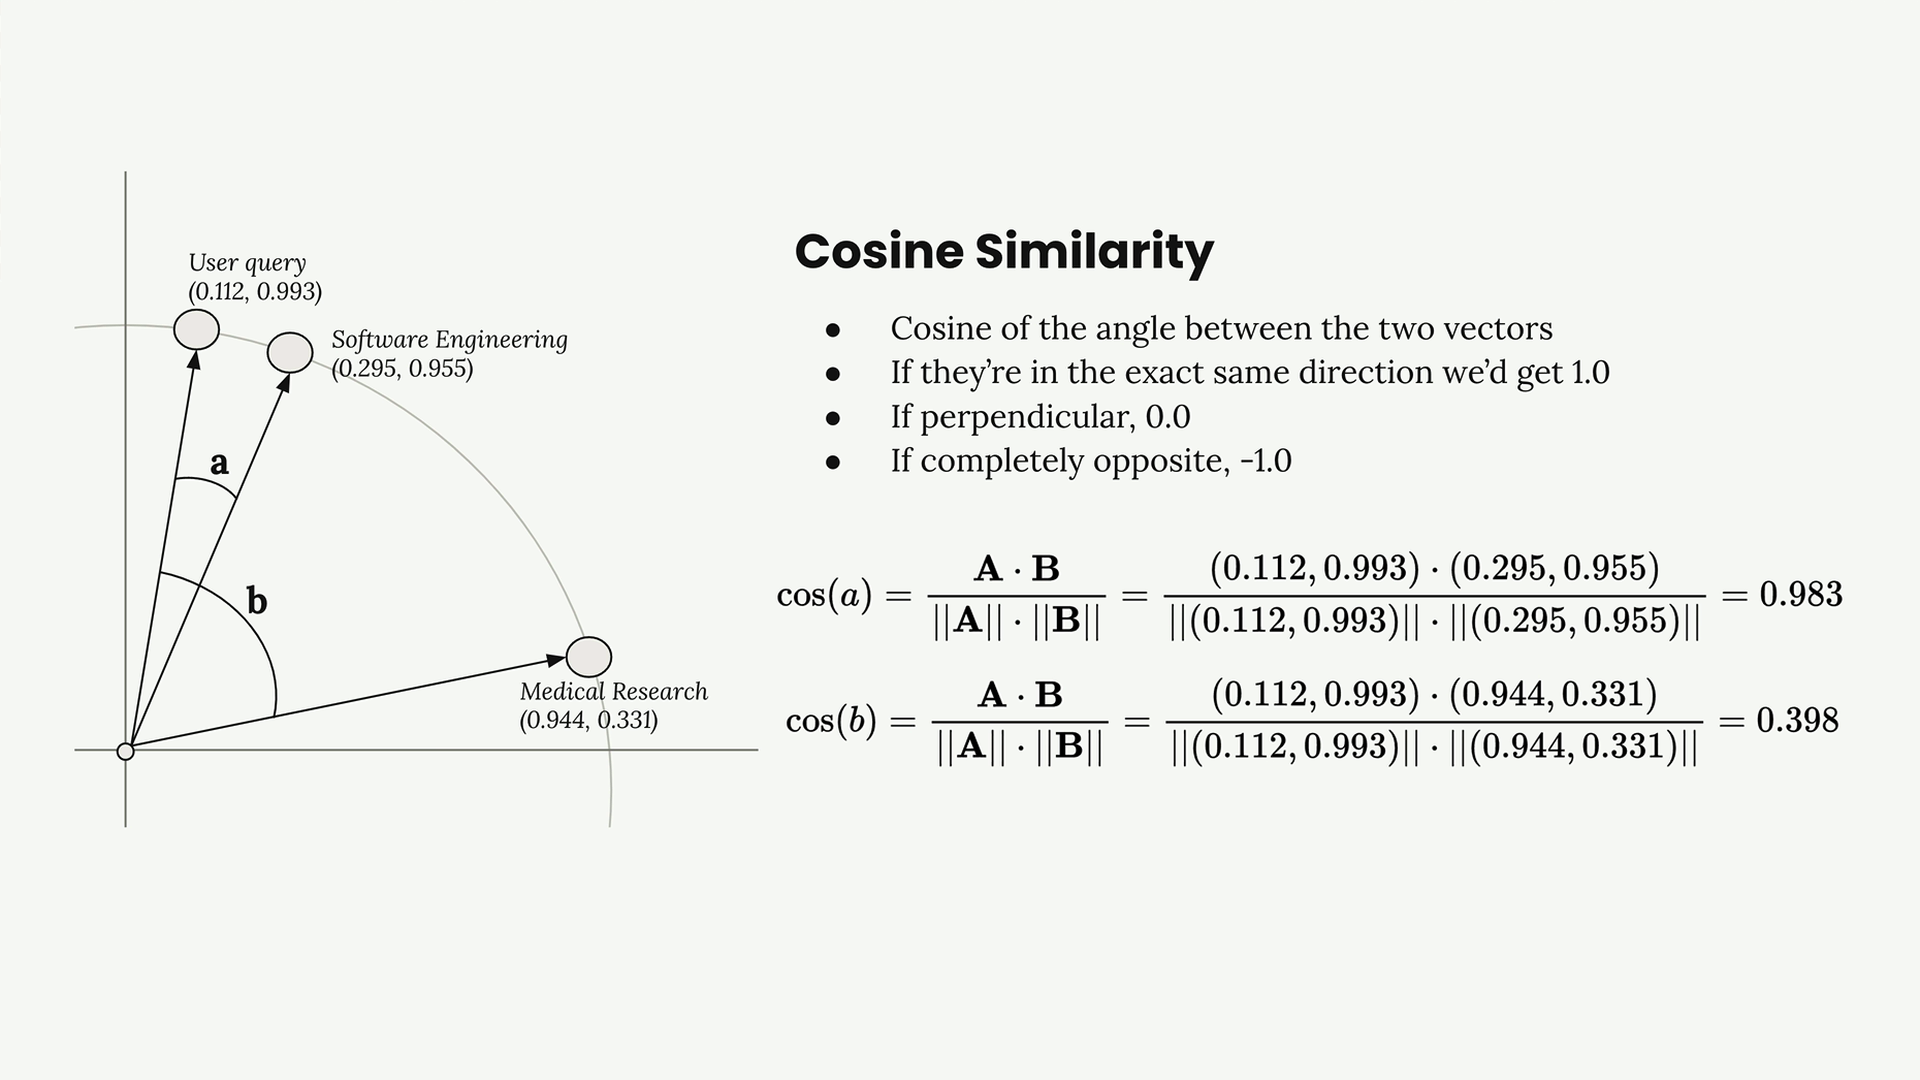
- 1,0 = les vecteurs pointent exactement dans la même direction (très similaires)
- 0,0 = les vecteurs sont perpendiculaires (non liés)
- -1,0 = les vecteurs pointent dans des directions opposées (très différents)
Dans notre exemple :
- Requête utilisateur vs Ingénierie logicielle : similarité cosinus = 0,983 (très similaire !)
- Requête utilisateur vs Recherche médicale : similarité cosinus = 0,398 (moins similaire)
Distance cosinus
Vous verrez souvent la « distance cosinus » dans la documentation des bases de données vectorielles. C'est simplement 1 - similarité cosinus, ce qui inverse l'échelle de sorte que des nombres plus petits signifient plus de similarité :
- 0,0 = très similaire
- 1,0 = perpendiculaire
- 2,0 = complètement opposé
Étape 6 : Construire l'invite finale
Enfin, nous prenons la question de l'utilisateur et le morceau de texte le plus pertinent (section d'ingénierie logicielle) et les combinons en une invite pour Claude :
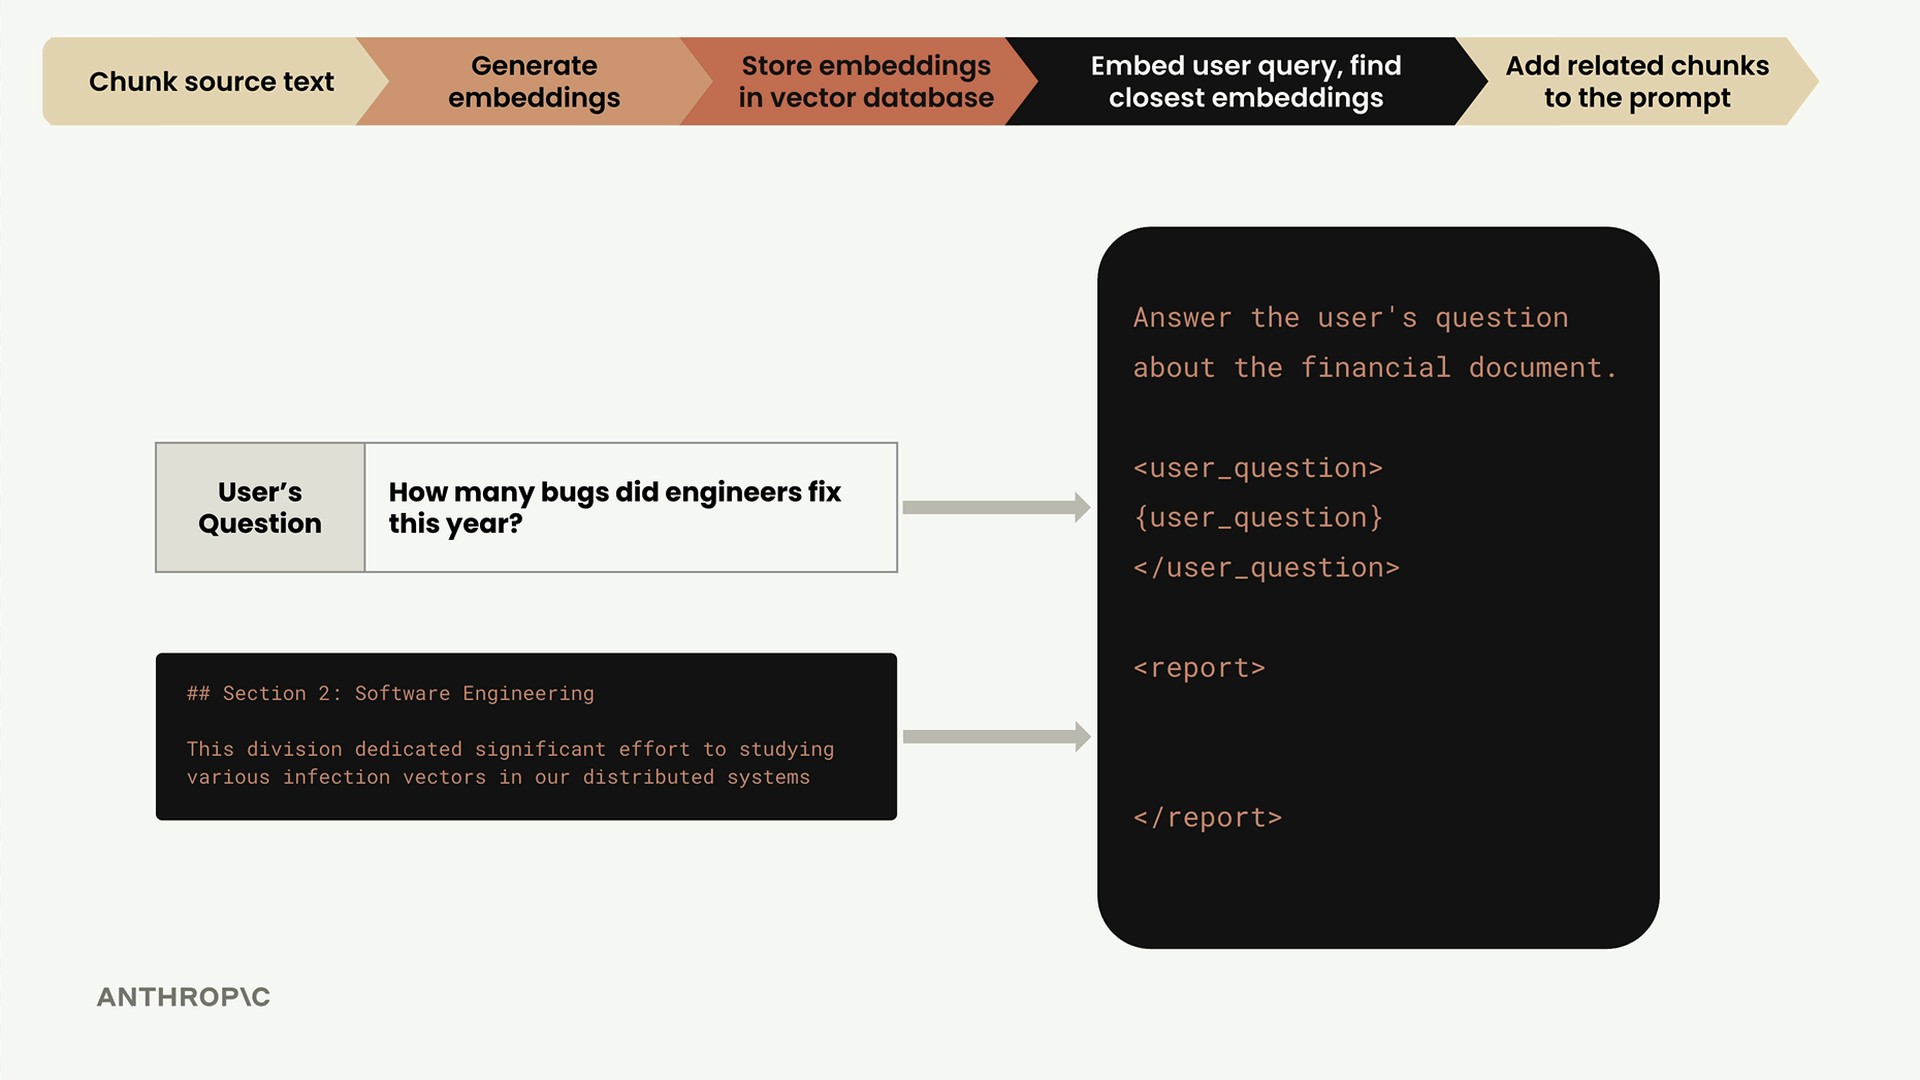
Answer the user's question about the financial document.

<user_question>
How many bugs did engineers fix this year?
</user_question>

<report>
## Section 2: Software Engineering
This division dedicated significant effort to studying various infection vectors in our distributed systems
</report>Et voilà le pipeline RAG complet ! Le système a réussi à trouver le contexte le plus pertinent pour la question de l'utilisateur sur l'ingénierie logicielle et l'a fourni à Claude pour générer une réponse informée.
Ce processus se produit automatiquement chaque fois qu'un utilisateur soumet une requête, permettant à Claude de répondre aux questions en se basant sur vos documents spécifiques plutôt que sur ses seules connaissances générales d'entraînement.