L'approche de récupération hybride que nous avons construite fonctionne bien, mais elle présente encore quelques aspérités. Lorsque nous recherchons « qu'est-ce que l'équipe d'ingénierie a fait avec INC-2023-Q4-011 ? », nous nous attendrions à ce que la section Ingénierie logicielle soit mieux classée puisqu'elle mentionne spécifiquement l'équipe d'ingénierie et l'incident. Cependant, la section Cybersécurité arrive toujours en premier.
C'est là qu'intervient le reclassement (re-ranking) - une technique de post-traitement qui peut considérablement améliorer la précision de la récupération.
Comment fonctionne le reclassement
Le reclassement ajoute une étape supplémentaire après votre processus de recherche hybride. Au lieu de simplement renvoyer les résultats fusionnés de vos index vectoriels et BM25, vous faites passer ces résultats par un LLM pour une réorganisation intelligente.
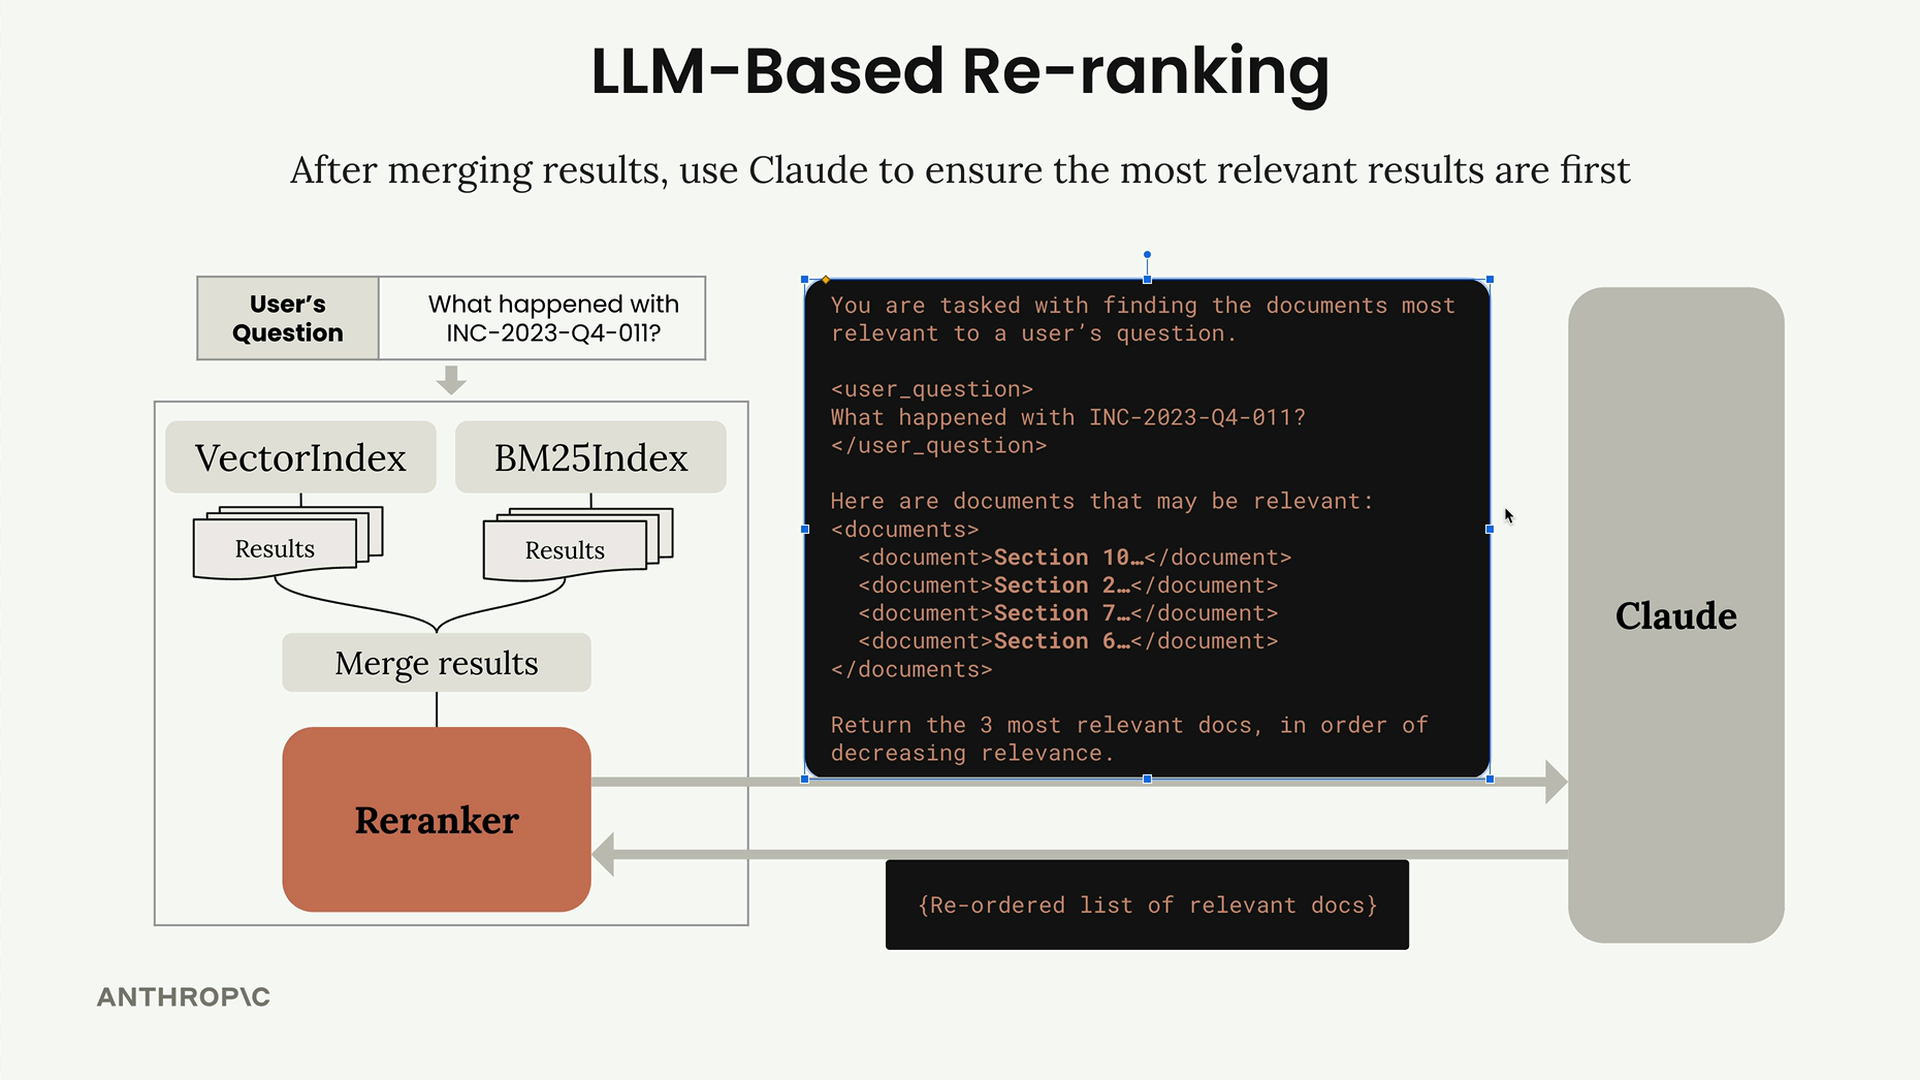
Le processus est simple :
- Exécutez votre recherche hybride existante (vecteur + BM25)
- Fusionnez les résultats comme auparavant
- Envoyez les résultats fusionnés à Claude avec une invite de reclassement
- Récupérez une liste réorganisée des documents les plus pertinents
L'invite de reclassement
La structure de l'invite est simple mais efficace. Vous fournissez à Claude la question de l'utilisateur et tous les documents candidats, puis vous lui demandez de renvoyer les plus pertinents par ordre de pertinence décroissante.
You are about to be given a set of documents, along with an id of each.
Your task is to select the {k} most relevant documents to answer the user's question.

Here is the user's question:
<question>
{query_text}
</question>

Here are the documents to select from:
<documents>
{joined_docs}
</documents>

Respond in the following format:
```json
\{
  "document_ids": str[] # List document ids, \{k\} elements long, sorted in order of decreasing relevance
\}
```Considérations d'efficacité
Une optimisation clé consiste à utiliser des ID de documents plutôt que de demander à Claude de renvoyer des extraits de texte complets. Si vous demandiez à Claude de renvoyer le texte complet de chaque document pertinent, vous perdriez du temps à attendre qu'il copie de grandes quantités de texte.
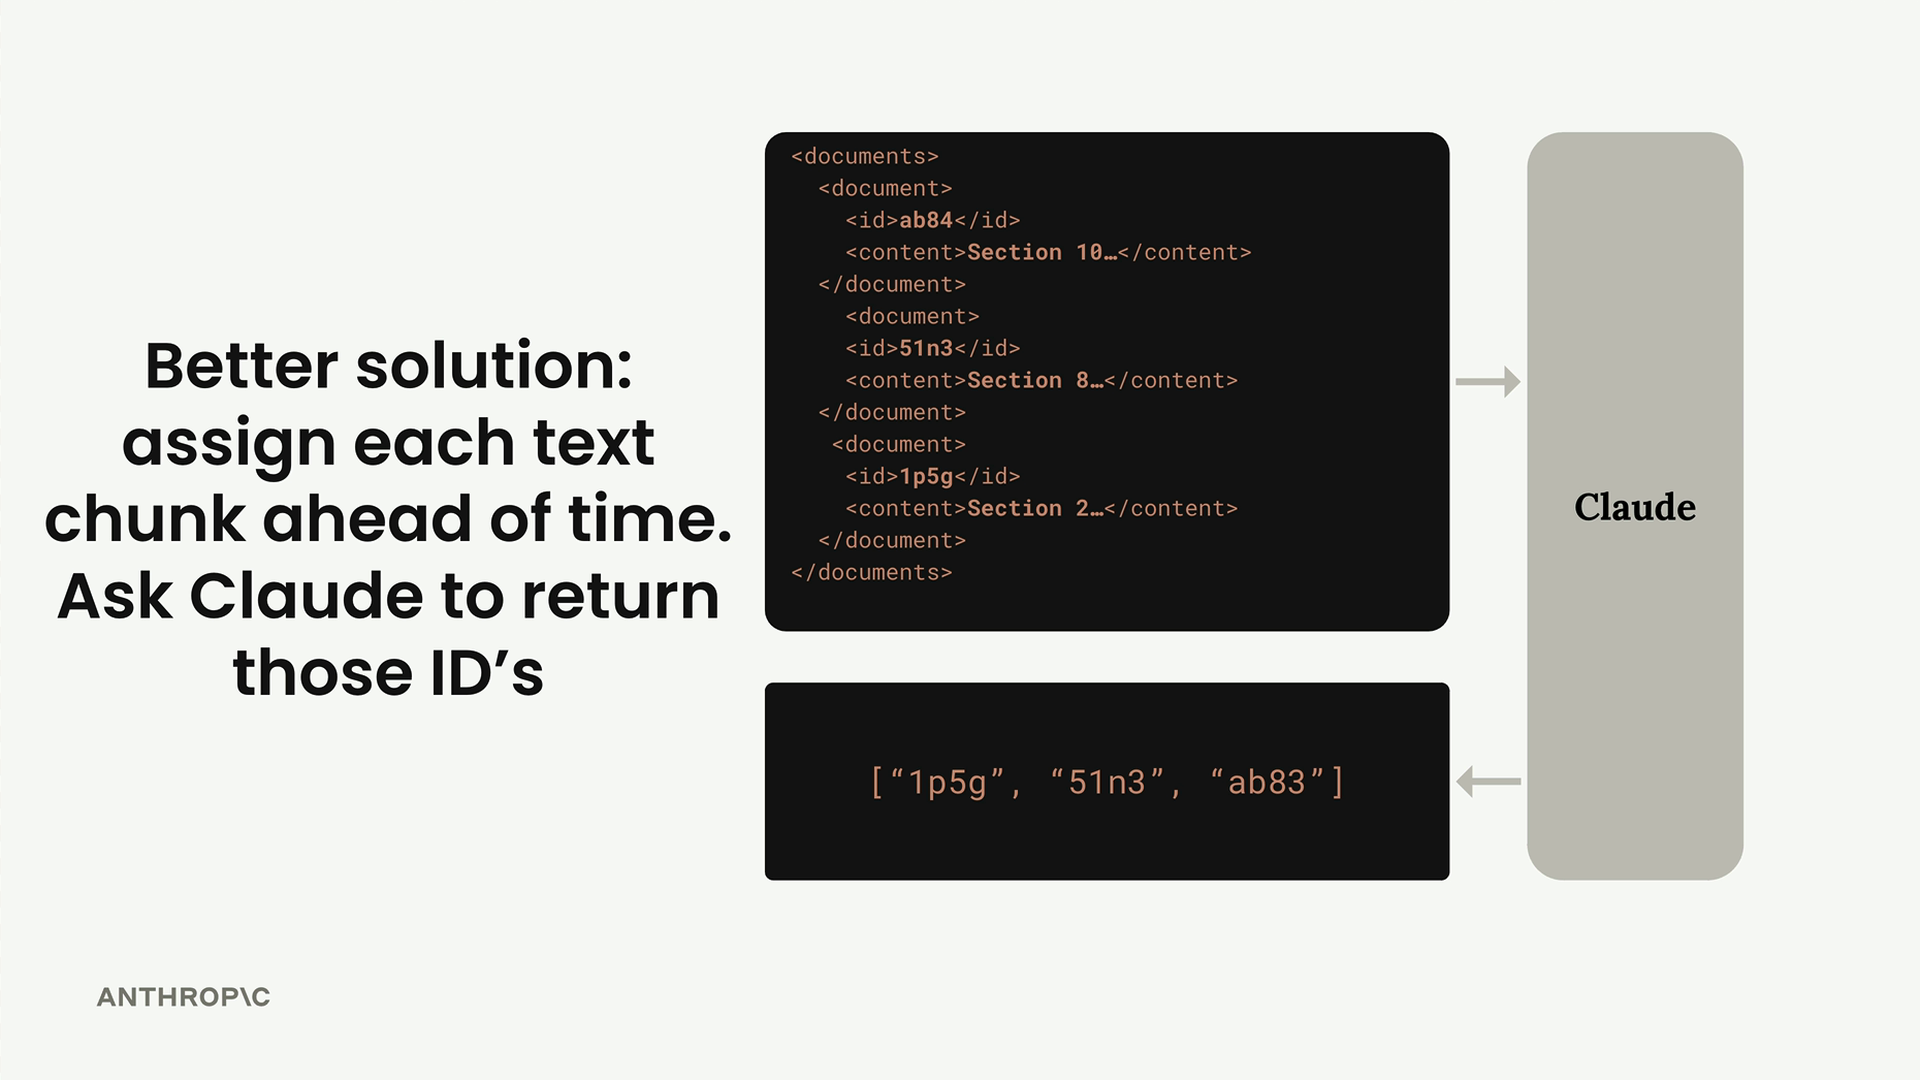
À la place, attribuez à chaque extrait de texte un ID unique à l'avance, puis demandez à Claude de renvoyer uniquement ces ID dans l'ordre préféré. Cela rend le processus de reclassement beaucoup plus rapide tout en vous fournissant les résultats réorganisés dont vous avez besoin.
Mise en œuvre
La fonction de reclassement est appelée automatiquement une fois votre recherche hybride initiale terminée. Voici la structure de base :
def reranker_fn(docs, query_text, k):
    joined_docs = "\n".join([
        f"""
        <document>
        <document_id>{doc["id"]}</document_id>
        <document_content>{doc["content"]}</document_content>
        </document>
        """
        for doc in docs
    ])

    # Construire le prompt avec la question de l'utilisateur et les documents
    # Envoyer à Claude avec un format de réponse JSON
    # Analyser et renvoyer les ID de documents réordonnés
Vous pouvez intégrer cela dans votre récupérateur en passant la fonction de reclassement en paramètre :
retriever = Retriever(bm25_index, vector_index, reranker_fn=reranker_fn)Résultats
L'approche de reclassement montre des améliorations claires. Lors du test de la requête « qu'est-ce que l'équipe d'ingénierie a fait avec INC-2023-Q4-011 ? », la section Ingénierie logicielle apparaît désormais correctement en premier, devant la section Cybersécurité. Claude a réussi à identifier que l'utilisateur demandait spécifiquement l'implication de l'équipe d'ingénierie dans l'incident.
Compromis
Le reclassement s'accompagne de compromis à prendre en compte :
- Latence accrue : Vous devez désormais attendre la fin d'un appel LLM supplémentaire
- Précision améliorée : Le LLM peut comprendre le contexte et l'intention mieux que de simples scores de similarité
- Considérations de coût : Chaque recherche nécessite désormais un appel API LLM
Pour de nombreuses applications, l'amélioration de la précision justifie la latence et le coût supplémentaires, en particulier lorsque la récupération précise est essentielle pour votre cas d'usage.