Lorsque vous créez des applications avec Claude, comprendre le cycle de vie complet d'une requête vous aide à concevoir de meilleurs systèmes et à déboguer les problèmes plus efficacement. Examinons ce qui se passe lorsqu'un utilisateur envoie un message à votre application de chat alimentée par l'IA.
Le flux complet de la requête
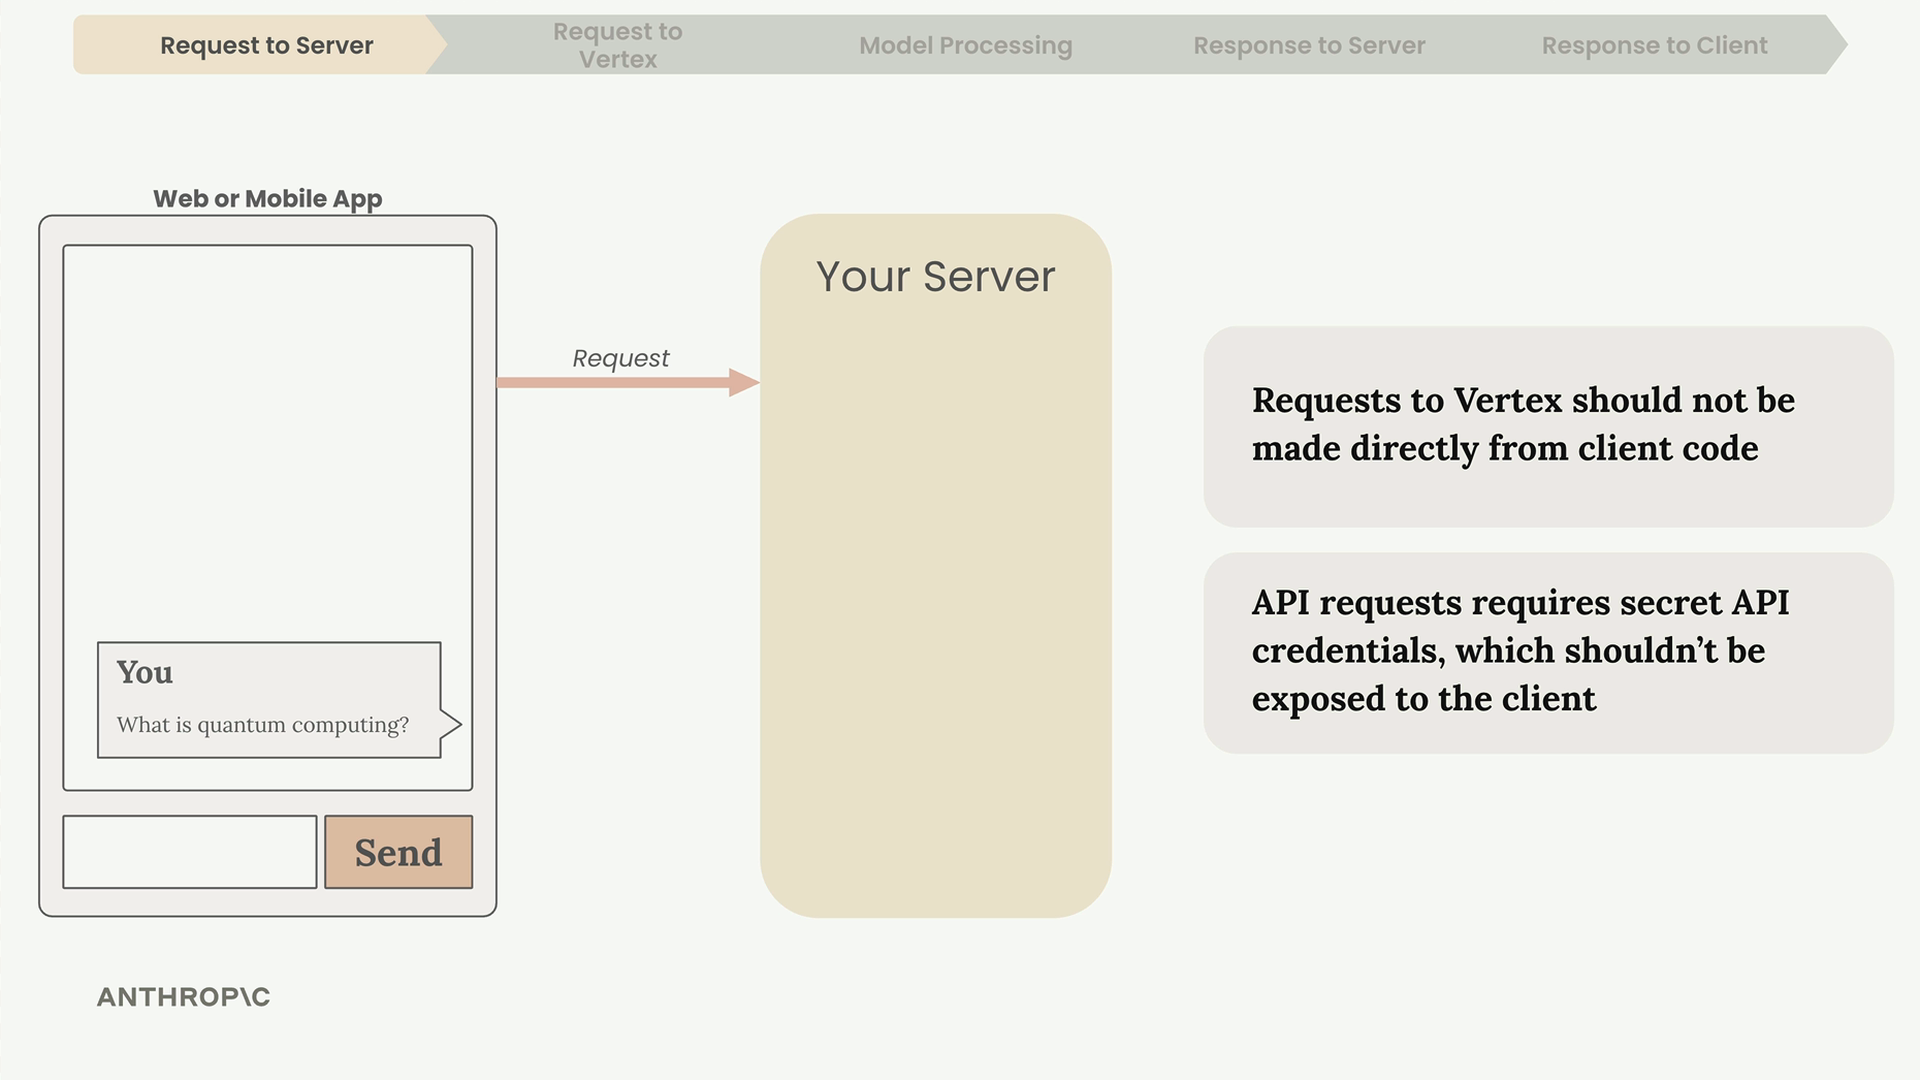
Le parcours de la saisie utilisateur à la réponse de l'IA comporte cinq étapes distinctes : Requête vers le serveur, Requête vers Vertex, Traitement par le modèle, Réponse vers le serveur et Réponse vers le client. Chaque étape joue un rôle crucial dans la fourniture de cette réponse « magique » attendue par les utilisateurs.
Pourquoi vous avez besoin d'un serveur
Ne faites jamais de requêtes API directement depuis du code côté client. Voici pourquoi :
- Les requêtes API nécessitent des identifiants secrets qui doivent rester sécurisés
- Exposer des identifiants dans le code client les rend visibles à tous
- Votre serveur agit comme un intermédiaire sécurisé entre votre application et Vertex
Acheminez toujours les requêtes via votre propre serveur, que vous contrôlez et sécurisez.
Effectuer la requête API
Votre serveur communique avec Vertex en utilisant soit les SDK d'Anthropic, soit les SDK officiels Vertex de Google. Anthropic fournit des SDK officiels pour Python, TypeScript, Go et Ruby.
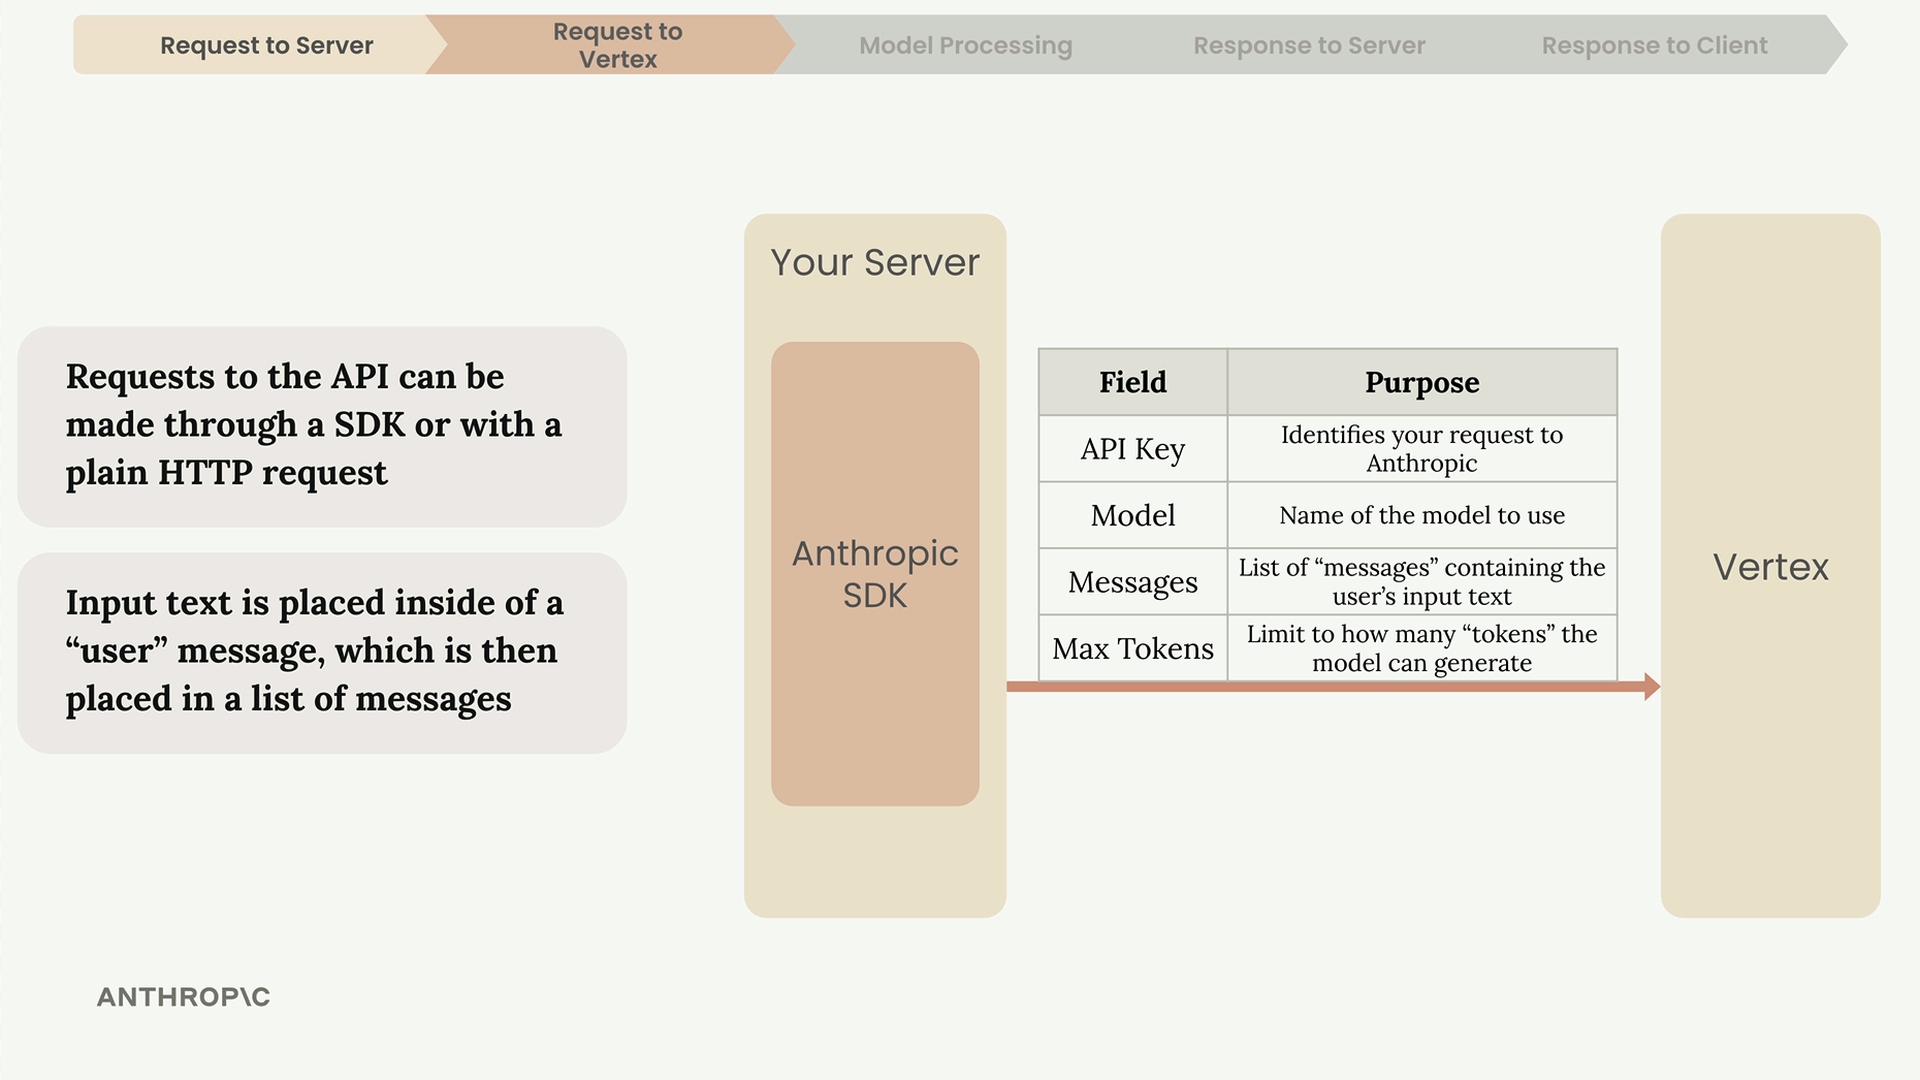
Chaque requête doit inclure ces champs clés :
- Identifiants Google Cloud - Autorisent votre requête sur Google Cloud
- Modèle - Nom du modèle spécifique à utiliser
- Messages - Liste contenant le texte de saisie de l'utilisateur
- Max Tokens - Limite le nombre de jetons que le modèle peut générer
La saisie de l'utilisateur est placée dans un message « user », qui est ensuite intégré dans une liste de messages envoyée à l'API.
À l'intérieur de Claude : le processus de génération de texte
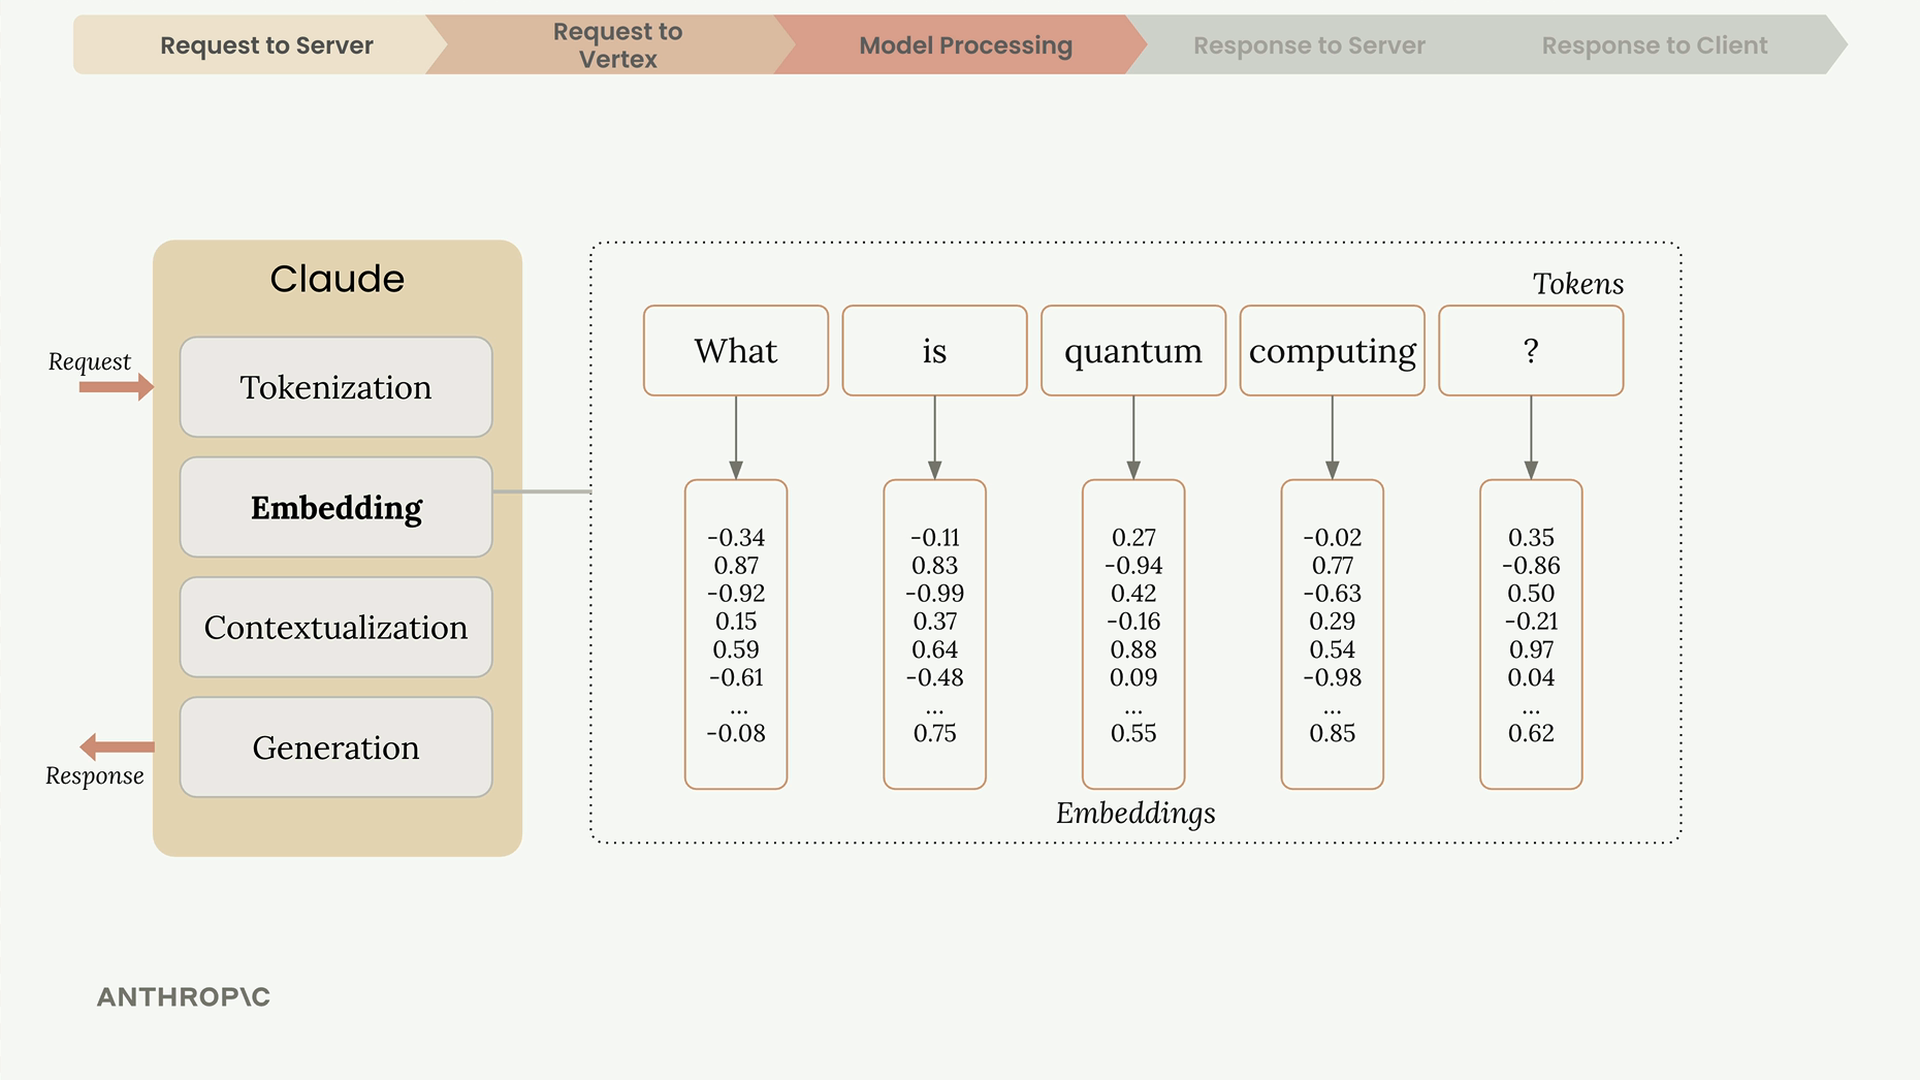
Une fois que Vertex reçoit votre requête, Claude la traite en quatre étapes : Tokenisation, Embedding, Contextualisation et Génération.
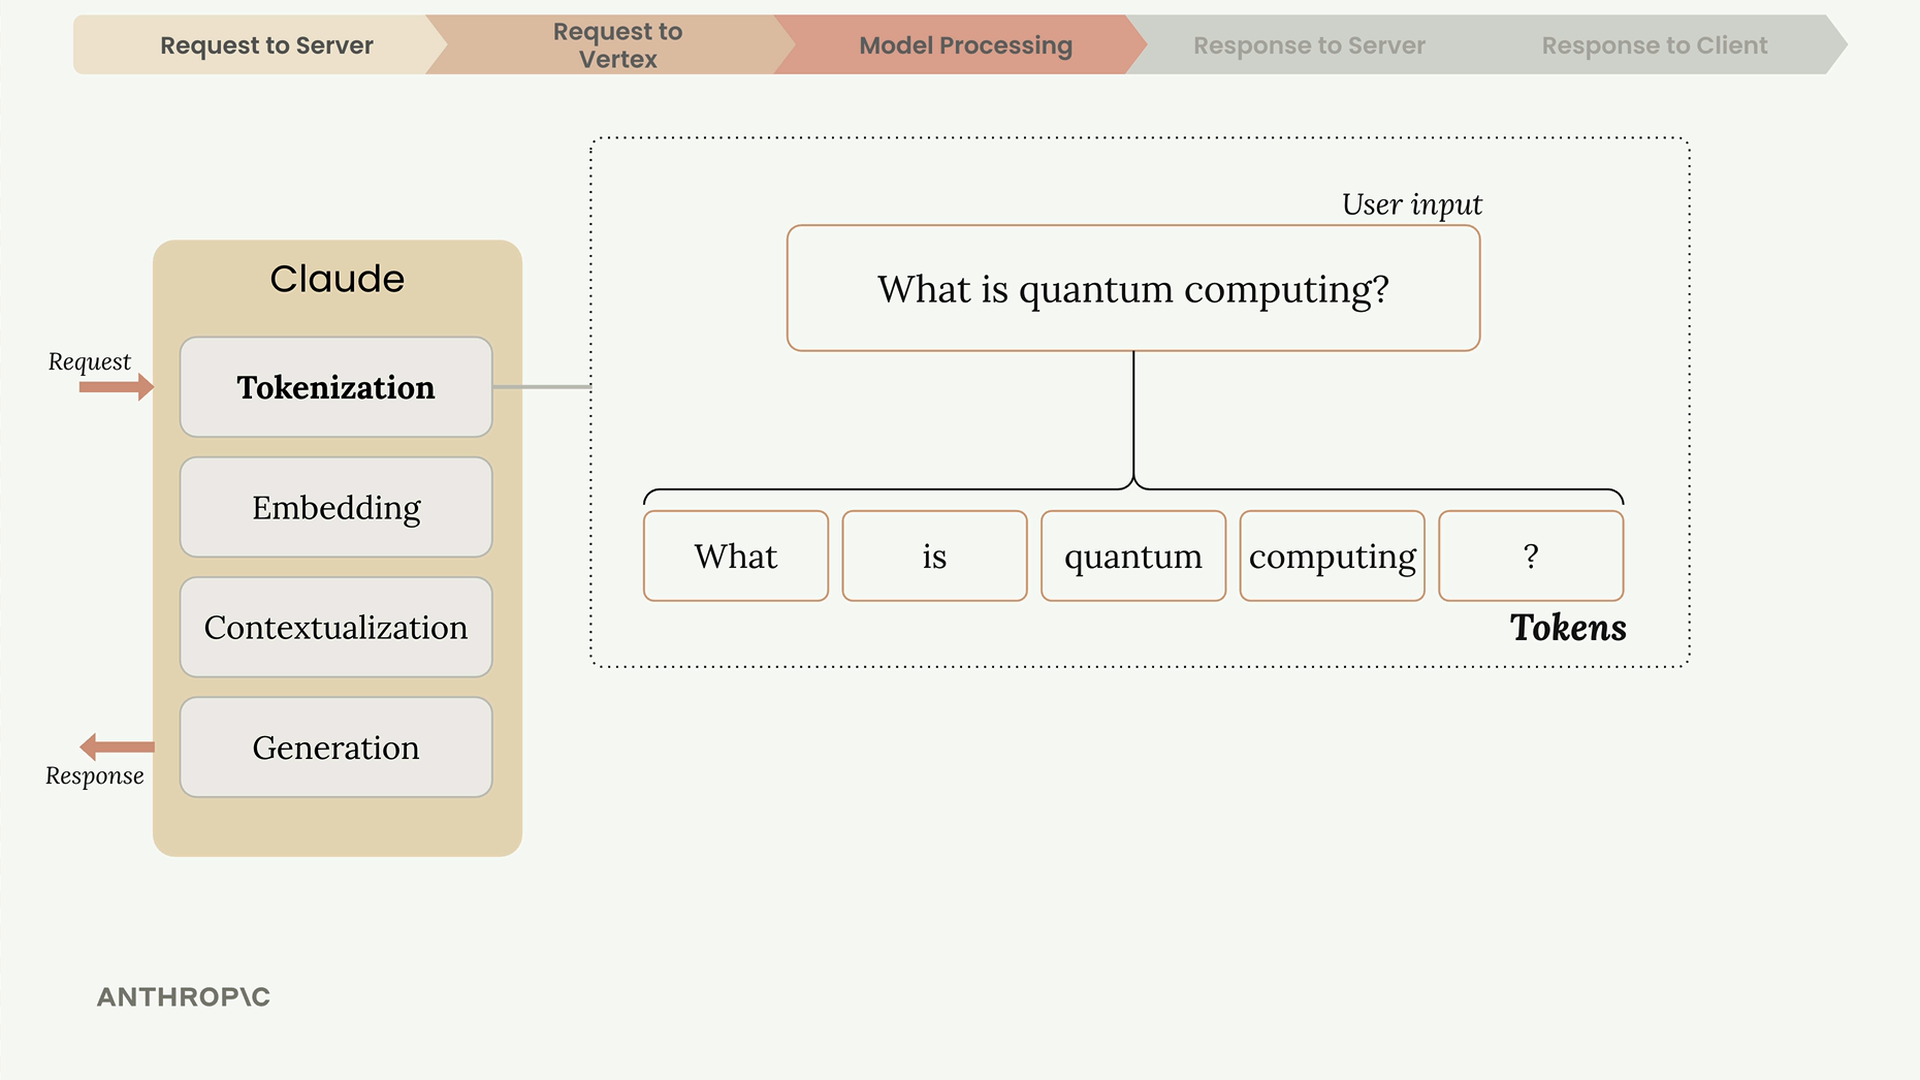
Tokenisation
Claude décompose d'abord le texte de saisie en plus petits morceaux appelés jetons. Ceux-ci peuvent être des mots entiers, des parties de mots, des espaces ou des symboles. Pour simplifier, considérez chaque mot comme un jeton.
Embedding
Chaque jeton est converti en un embedding - une longue liste de nombres qui représente toutes les significations possibles de ce mot. Pensez aux embeddings comme à des définitions numériques.
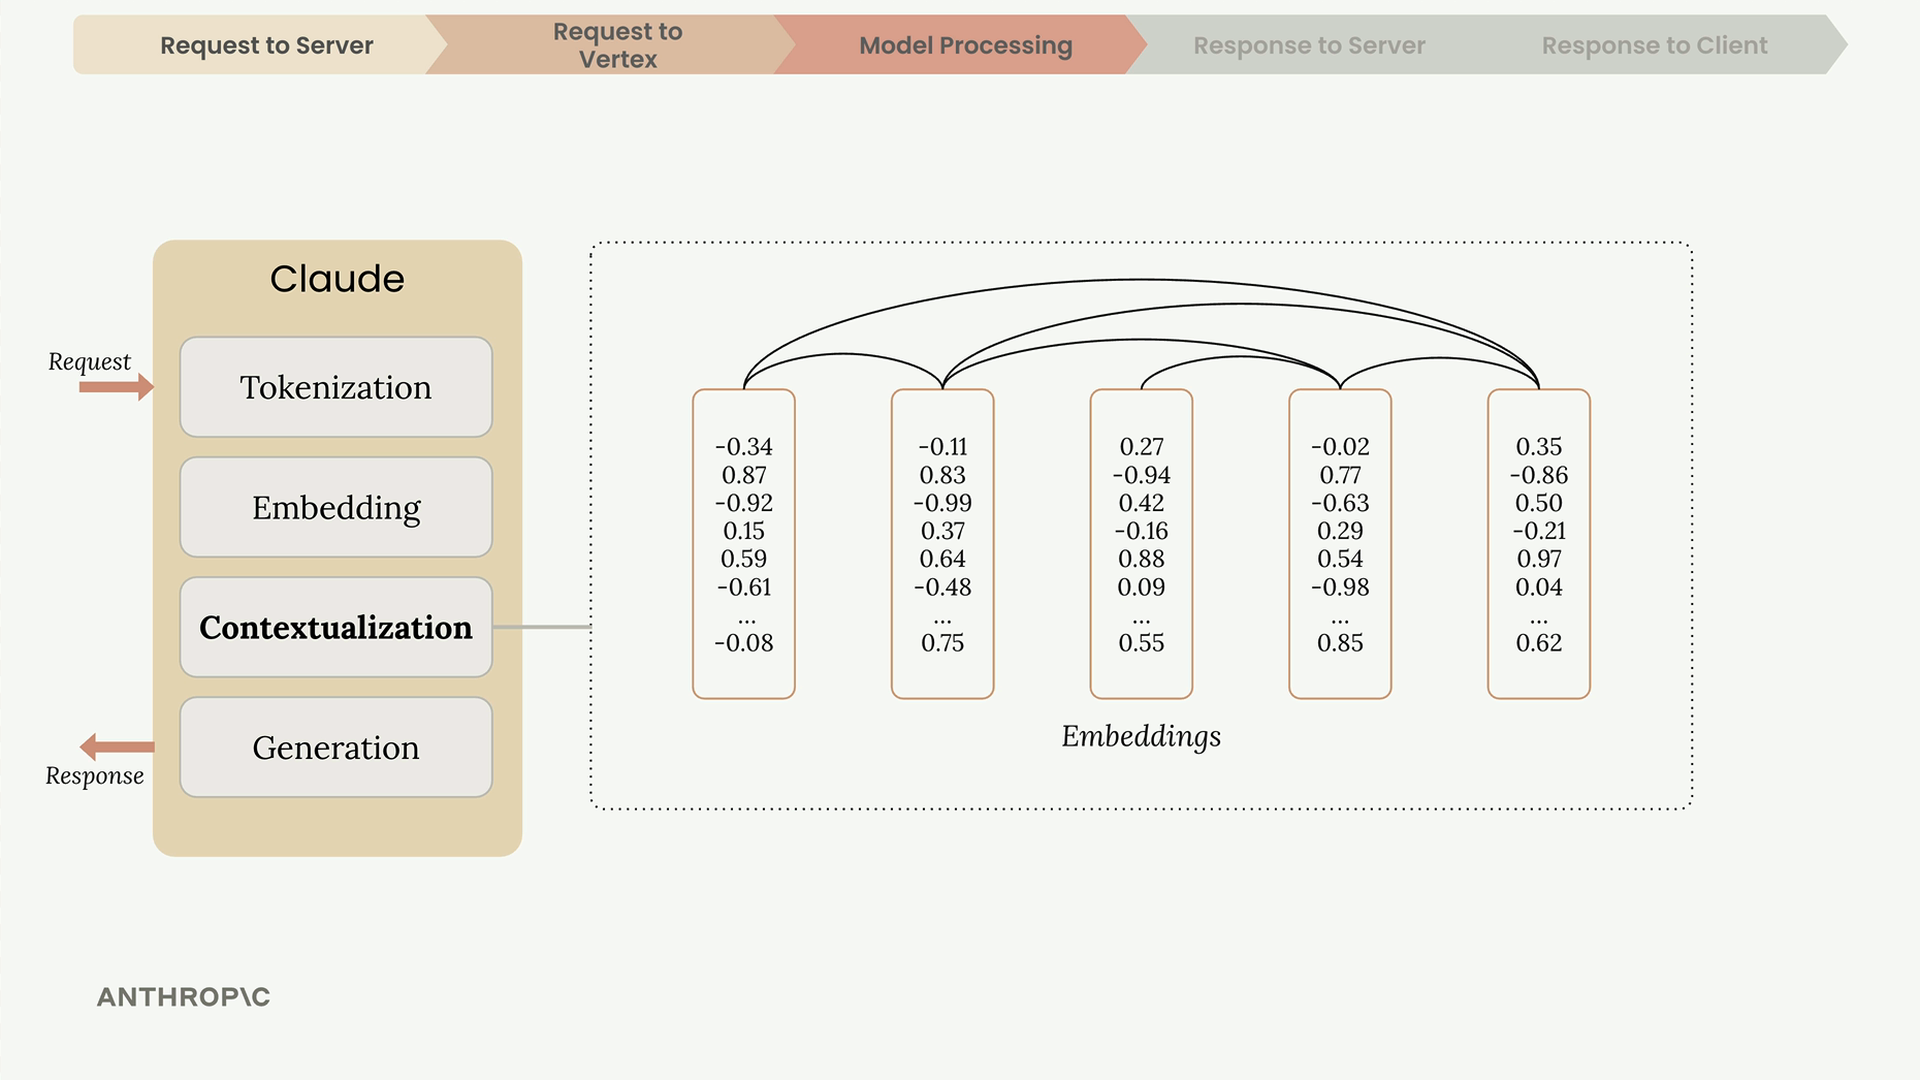
Contextualisation
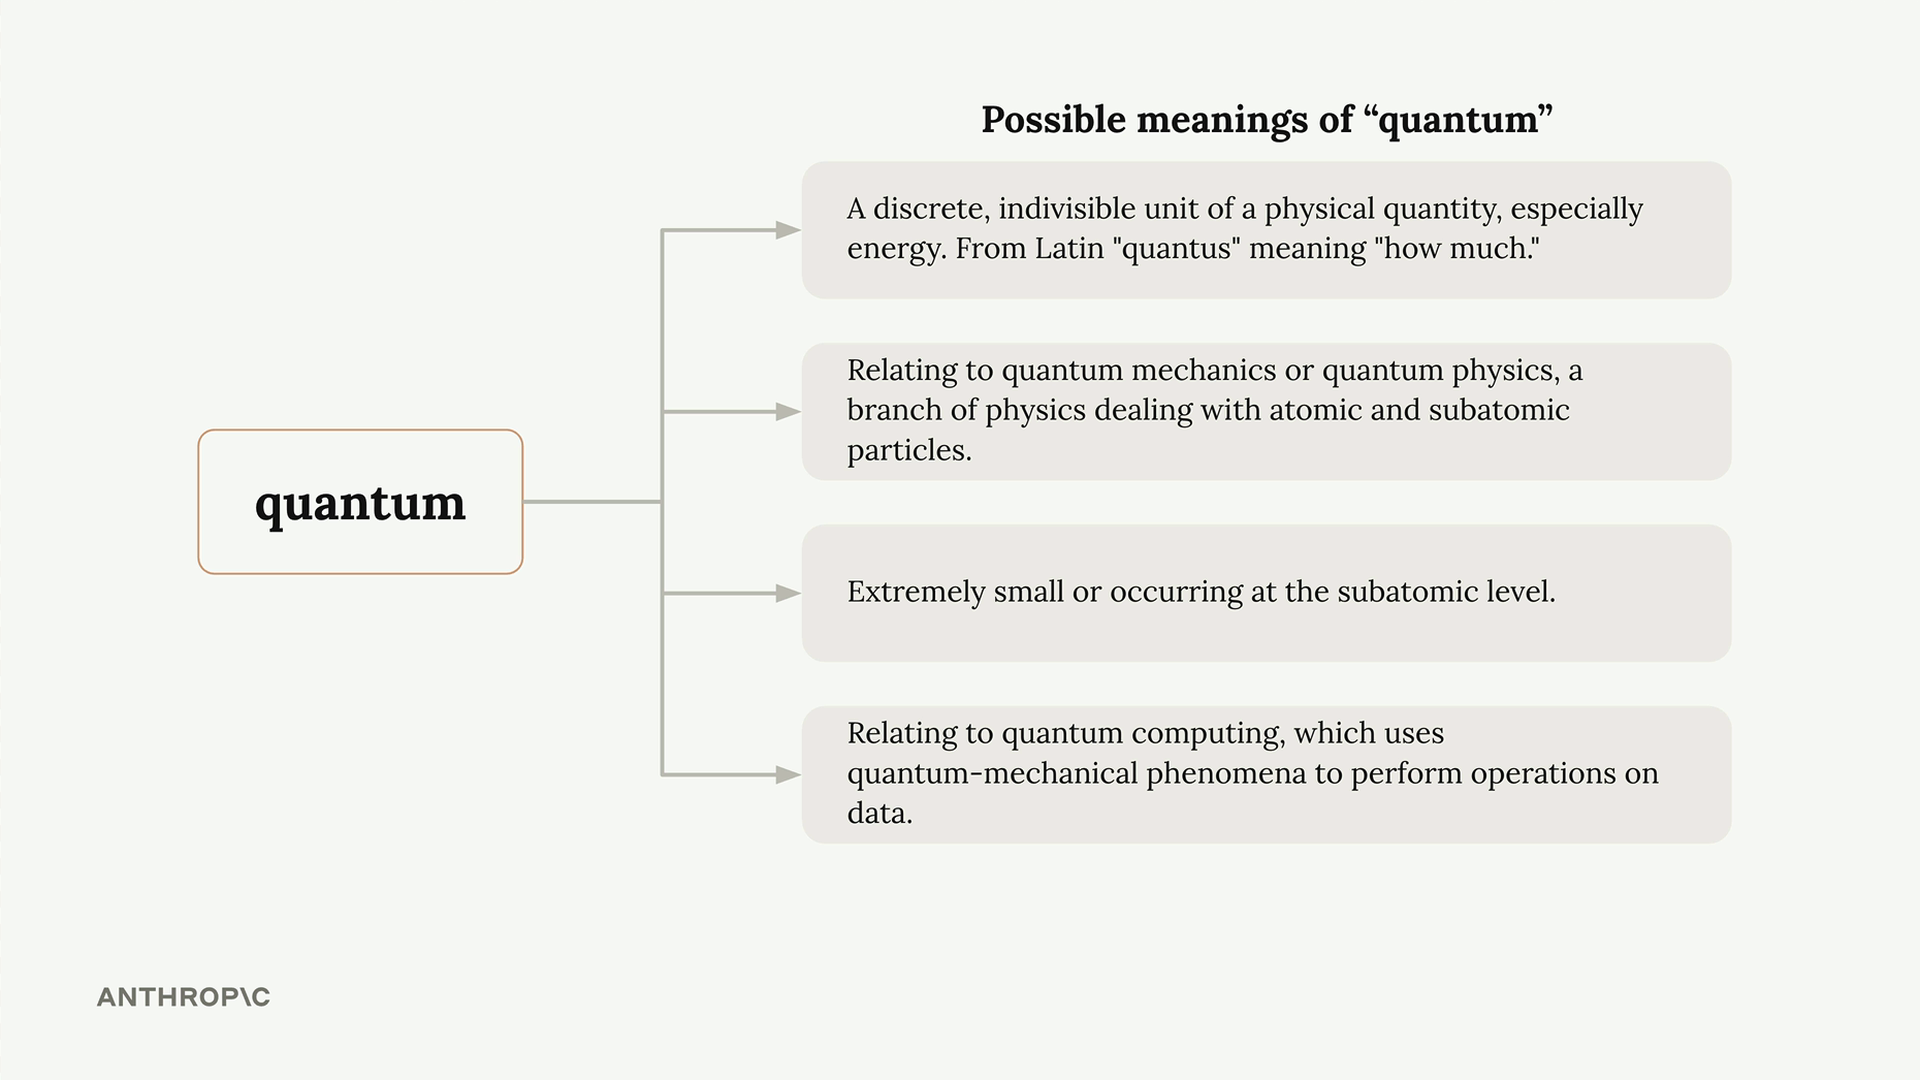
Comme les mots peuvent avoir plusieurs significations, Claude utilise le contexte pour déterminer la bonne interprétation. Le mot « quantum » pourrait faire référence à la physique, à l'informatique, ou simplement signifier « très petit » - le contexte des mots environnants clarifie le sens voulu.
Pendant la contextualisation, chaque embedding est ajusté en fonction de ses voisins, mettant en évidence le sens qui a le plus de sens compte tenu du contexte.
Génération
Les embeddings contextualisés passent par une couche de sortie qui produit des probabilités pour chaque mot suivant possible. Claude ne choisit pas toujours le mot ayant la probabilité la plus élevée - il utilise un mélange de probabilité et de hasard pour créer des réponses plus naturelles et variées.
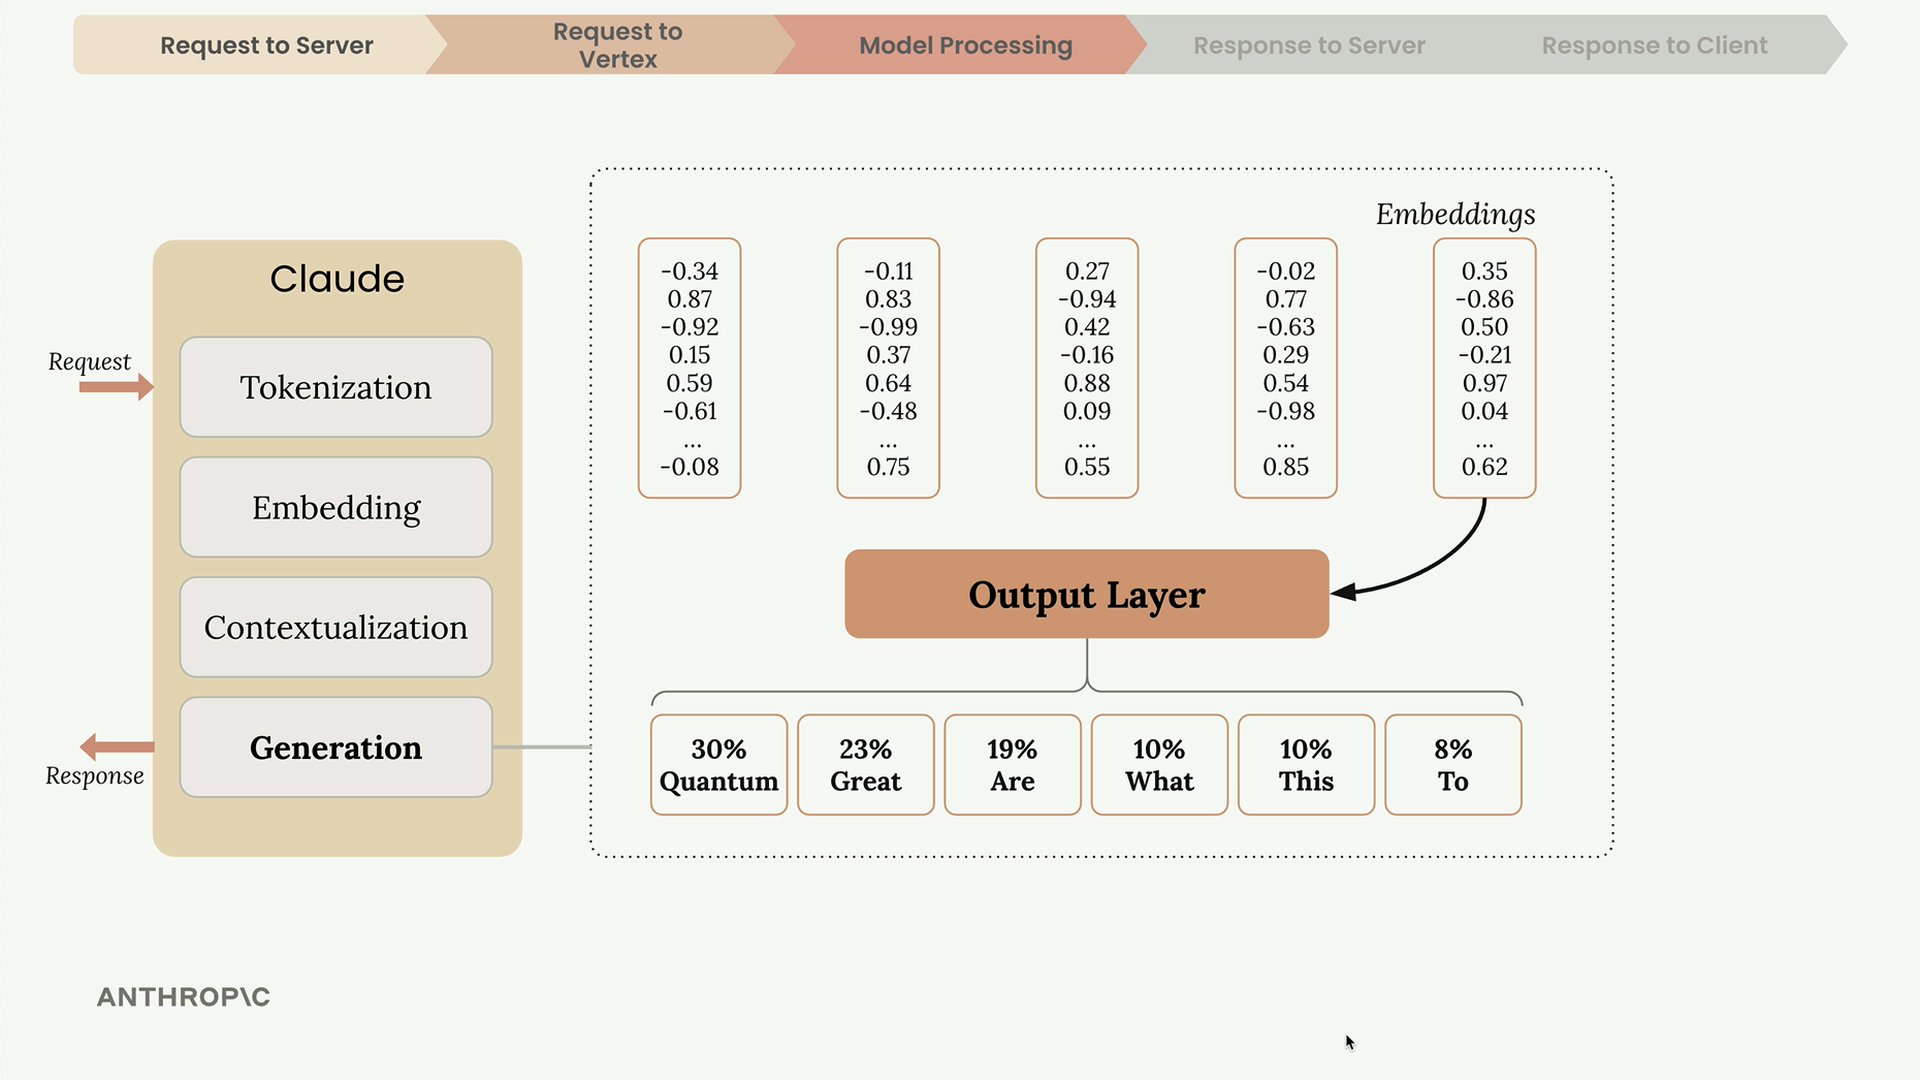
Après avoir sélectionné un mot, Claude l'ajoute à la séquence et répète l'ensemble du processus pour le mot suivant.
Quand la génération s'arrête
Après avoir généré chaque jeton, Claude vérifie plusieurs conditions pour décider s'il doit continuer :
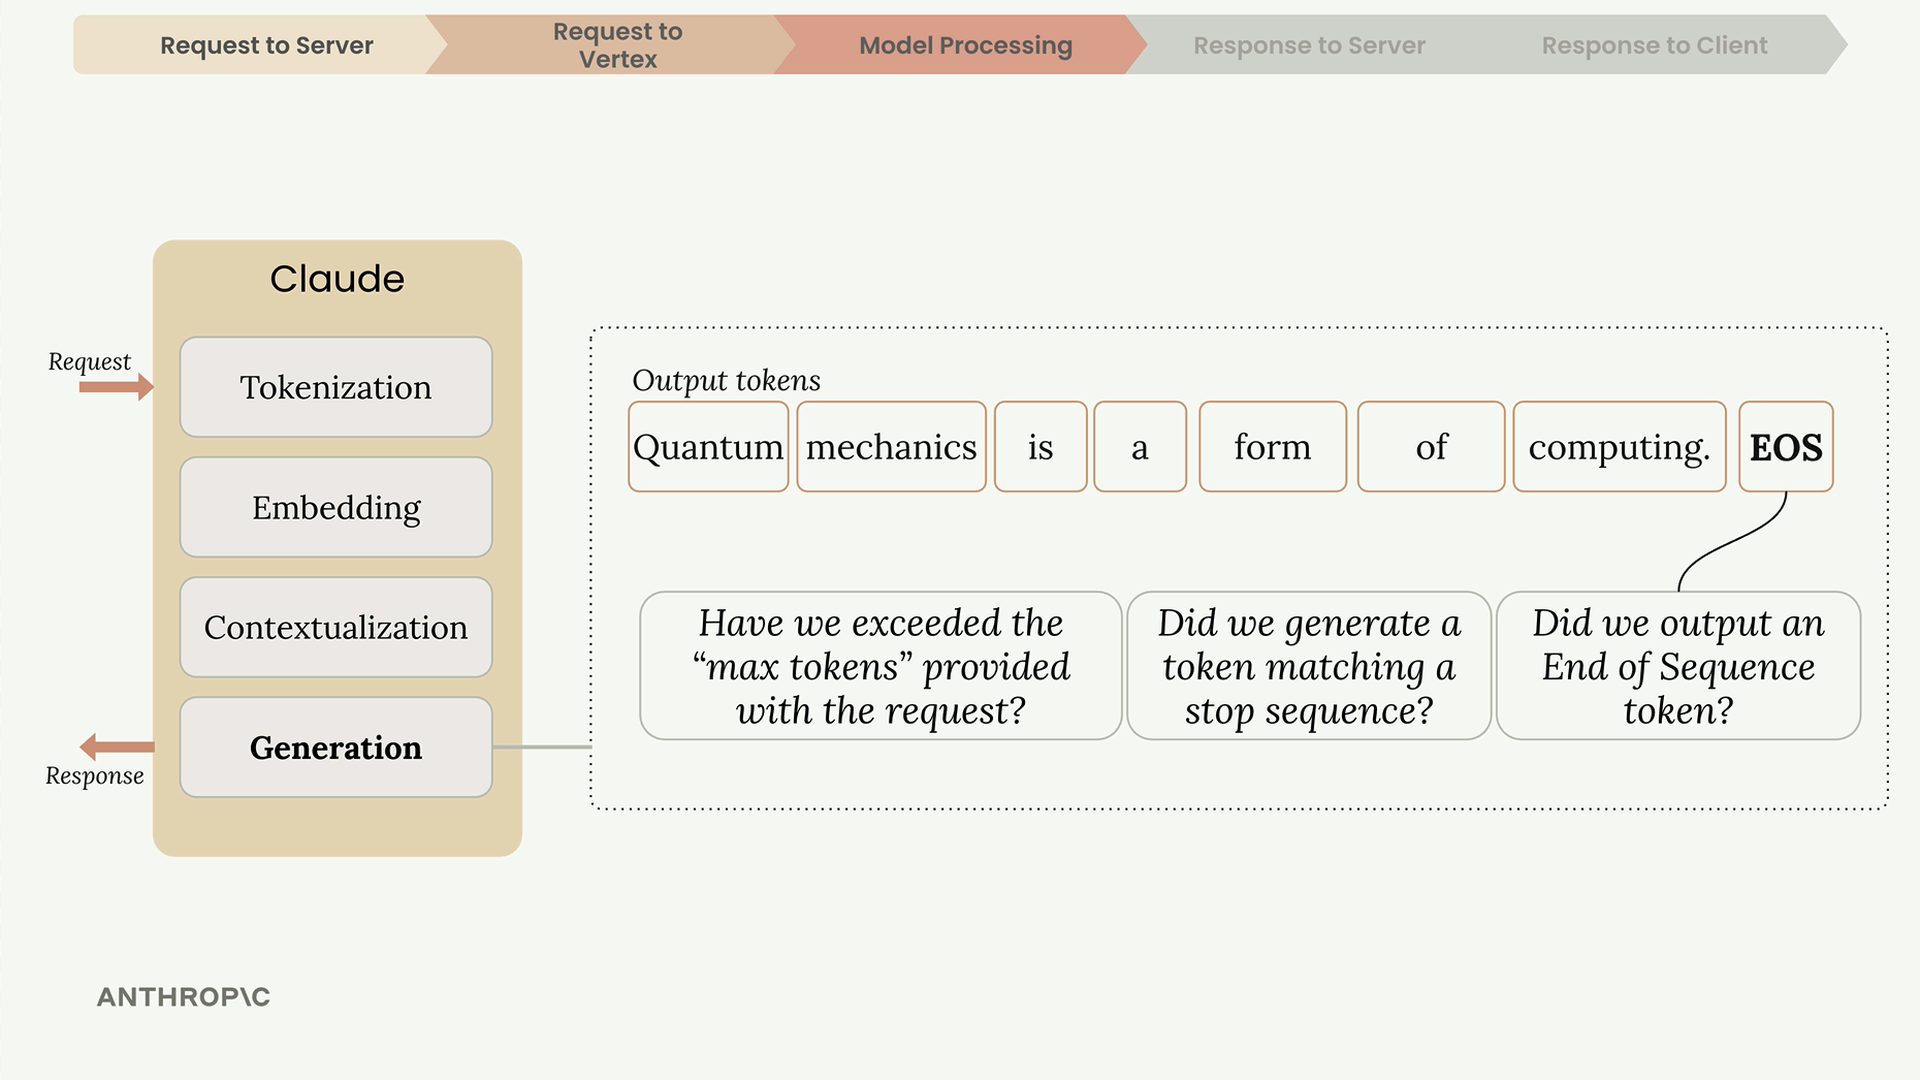
- Nombre maximal de jetons atteint - A-t-il atteint la limite que vous avez spécifiée ?
- Fin naturelle - A-t-il généré un jeton de fin de séquence ?
- Séquence d'arrêt - A-t-il rencontré une phrase d'arrêt prédéfinie ?
Le jeton de fin de séquence est un signal spécial (texte non visible) que Claude utilise pour indiquer qu'il est parvenu à une conclusion naturelle.
La réponse
Une fois la génération terminée, Vertex renvoie une réponse à votre serveur contenant :
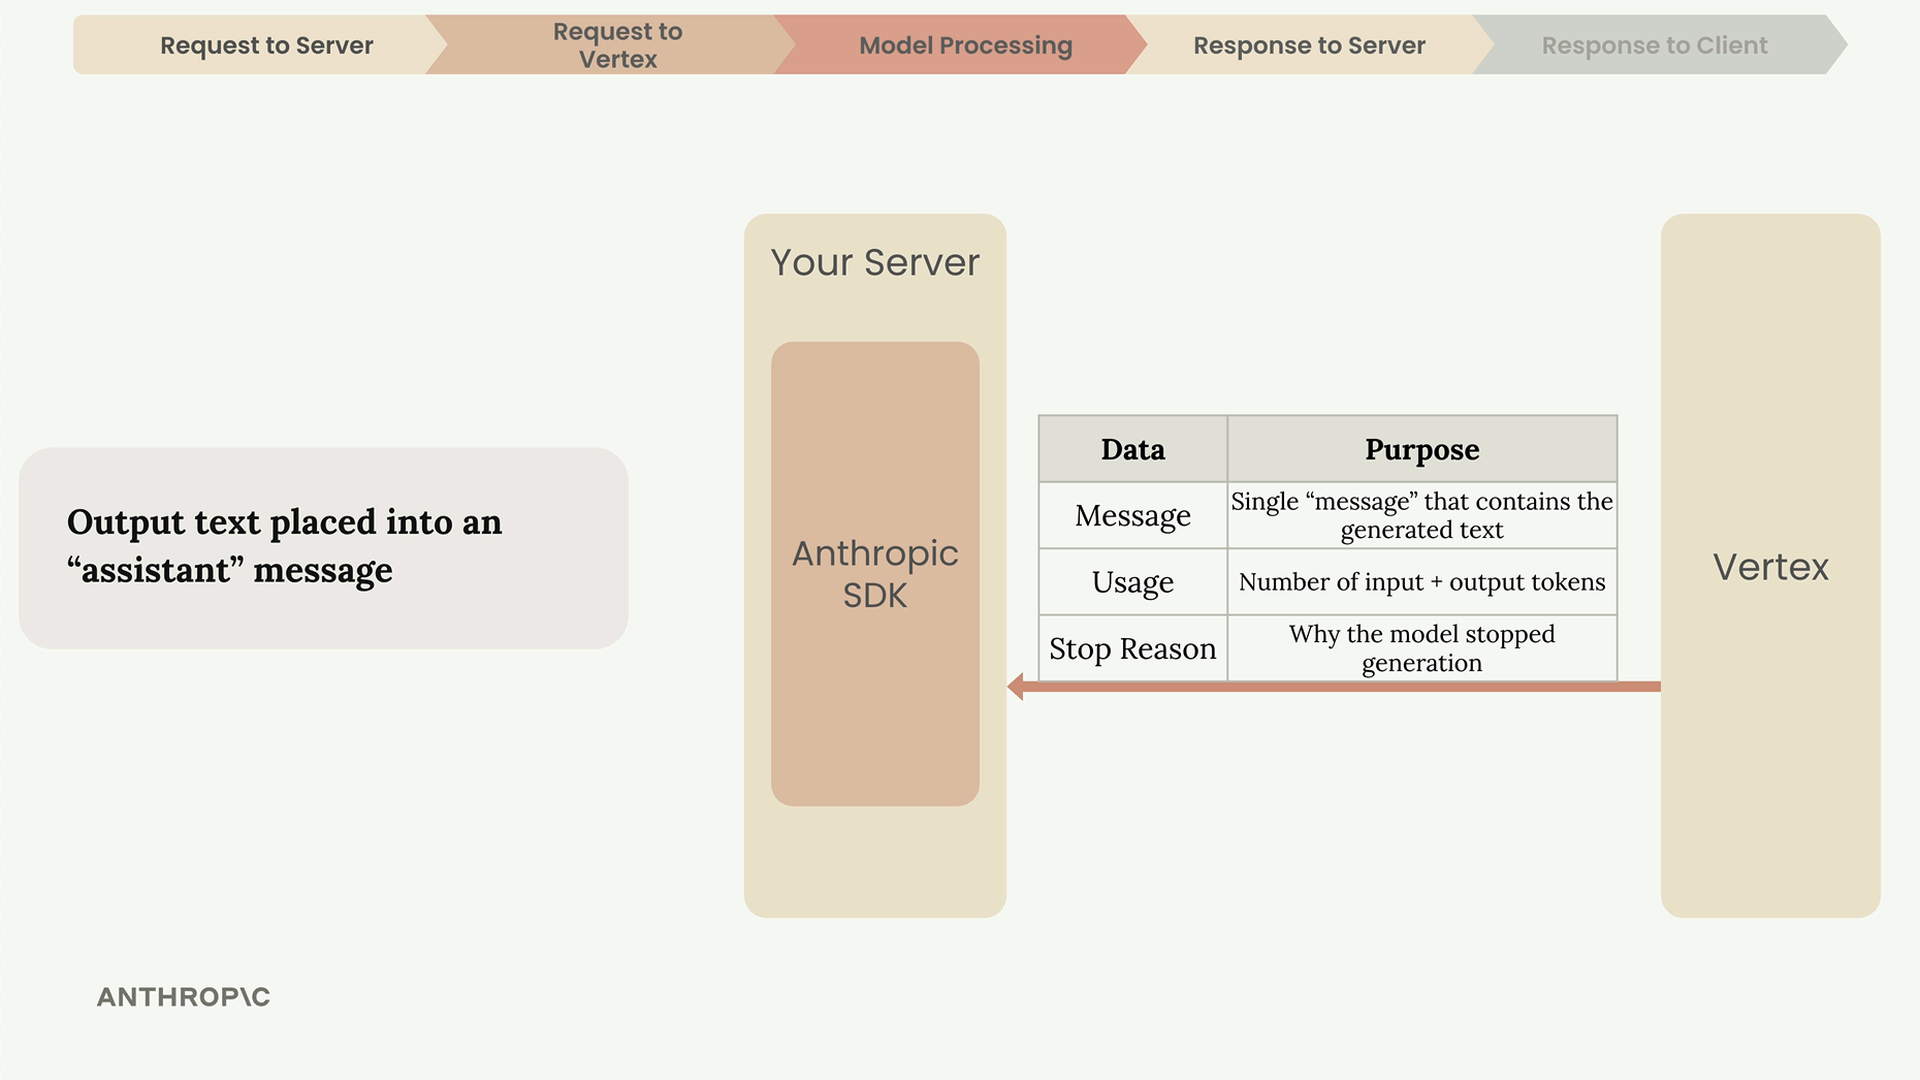
- Message - Le texte généré
- Usage - Décompte des jetons d'entrée et de sortie
- Stop Reason - Pourquoi le modèle a arrêté de générer
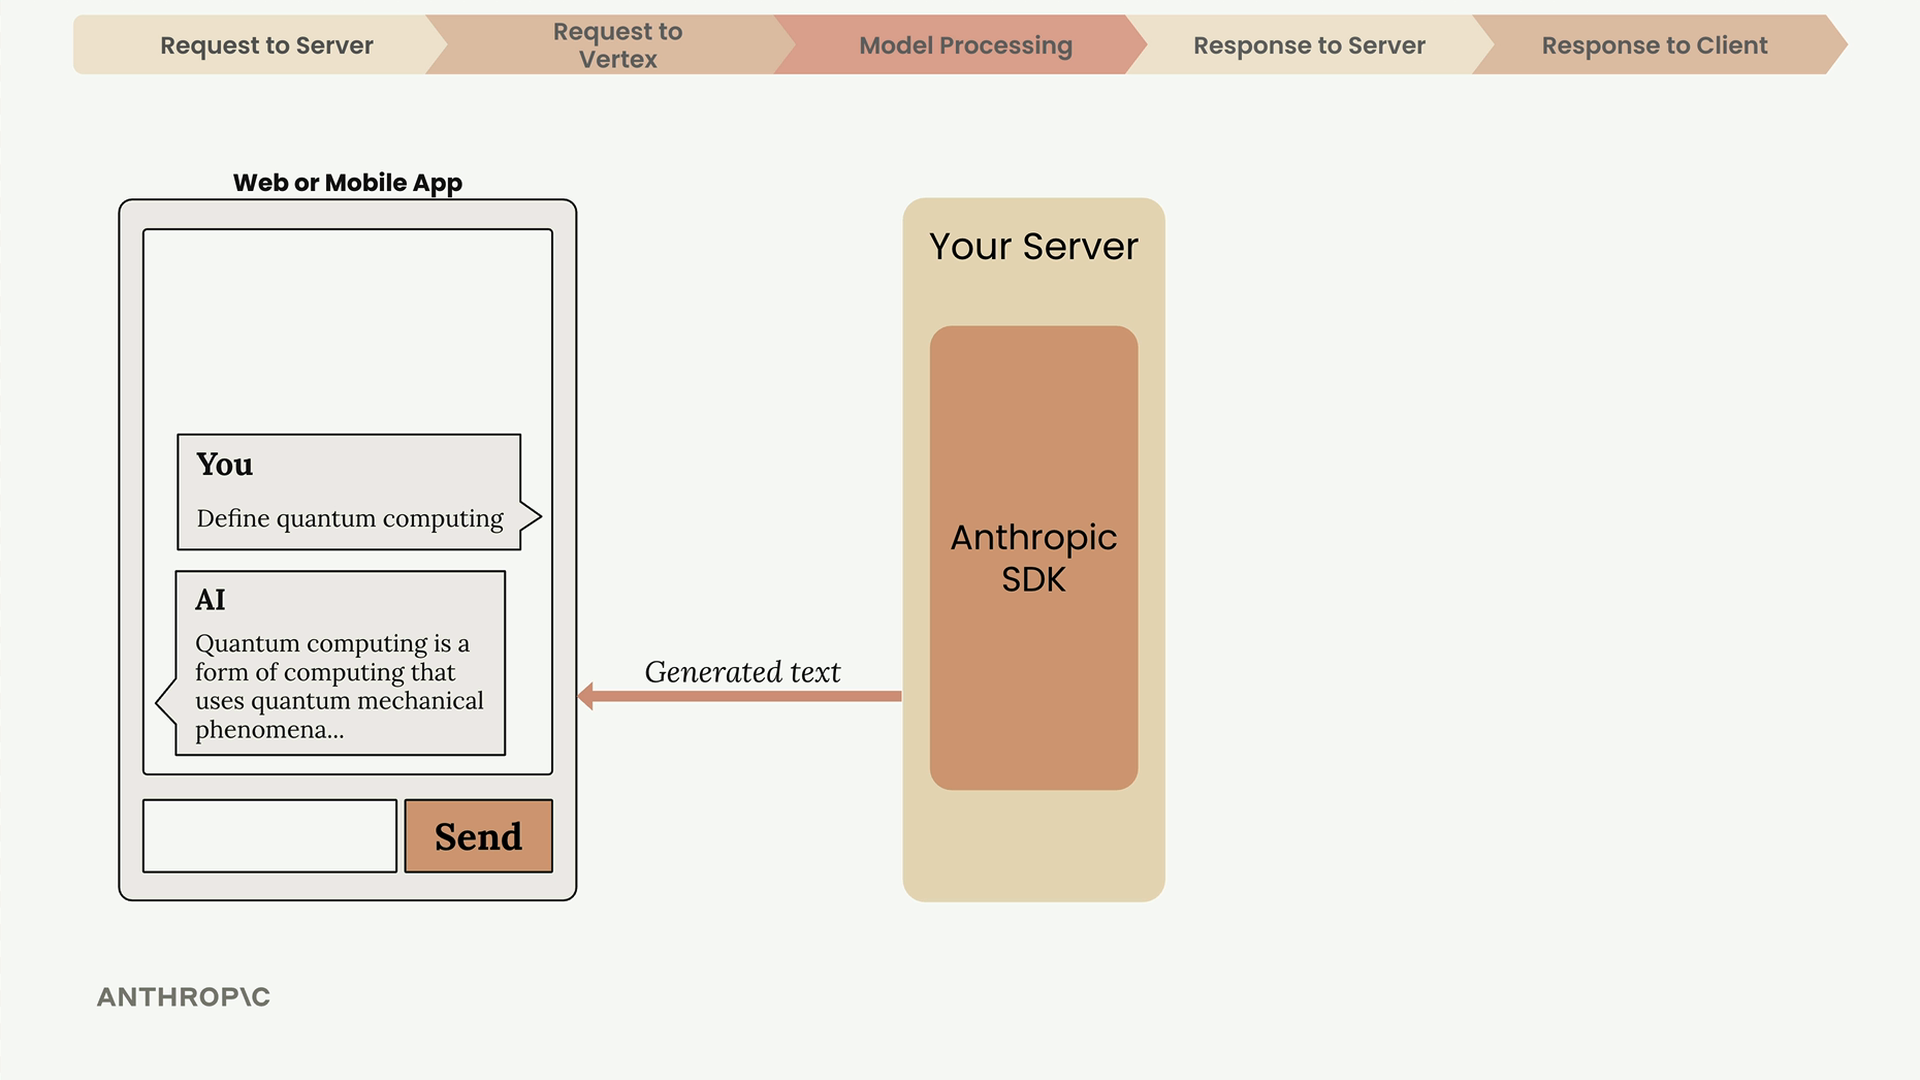
Votre serveur transmet ensuite le texte généré à votre application cliente, où il apparaît dans l'interface de chat.
La vue d'ensemble
Ce processus complet - de la saisie de l'utilisateur en passant par la tokenisation, l'embedding, la contextualisation, la génération, et jusqu'au retour à l'utilisateur - se déroule en quelques secondes. Comprendre ce flux vous aide à créer des applications plus robustes et à résoudre les problèmes lorsqu'ils surviennent.
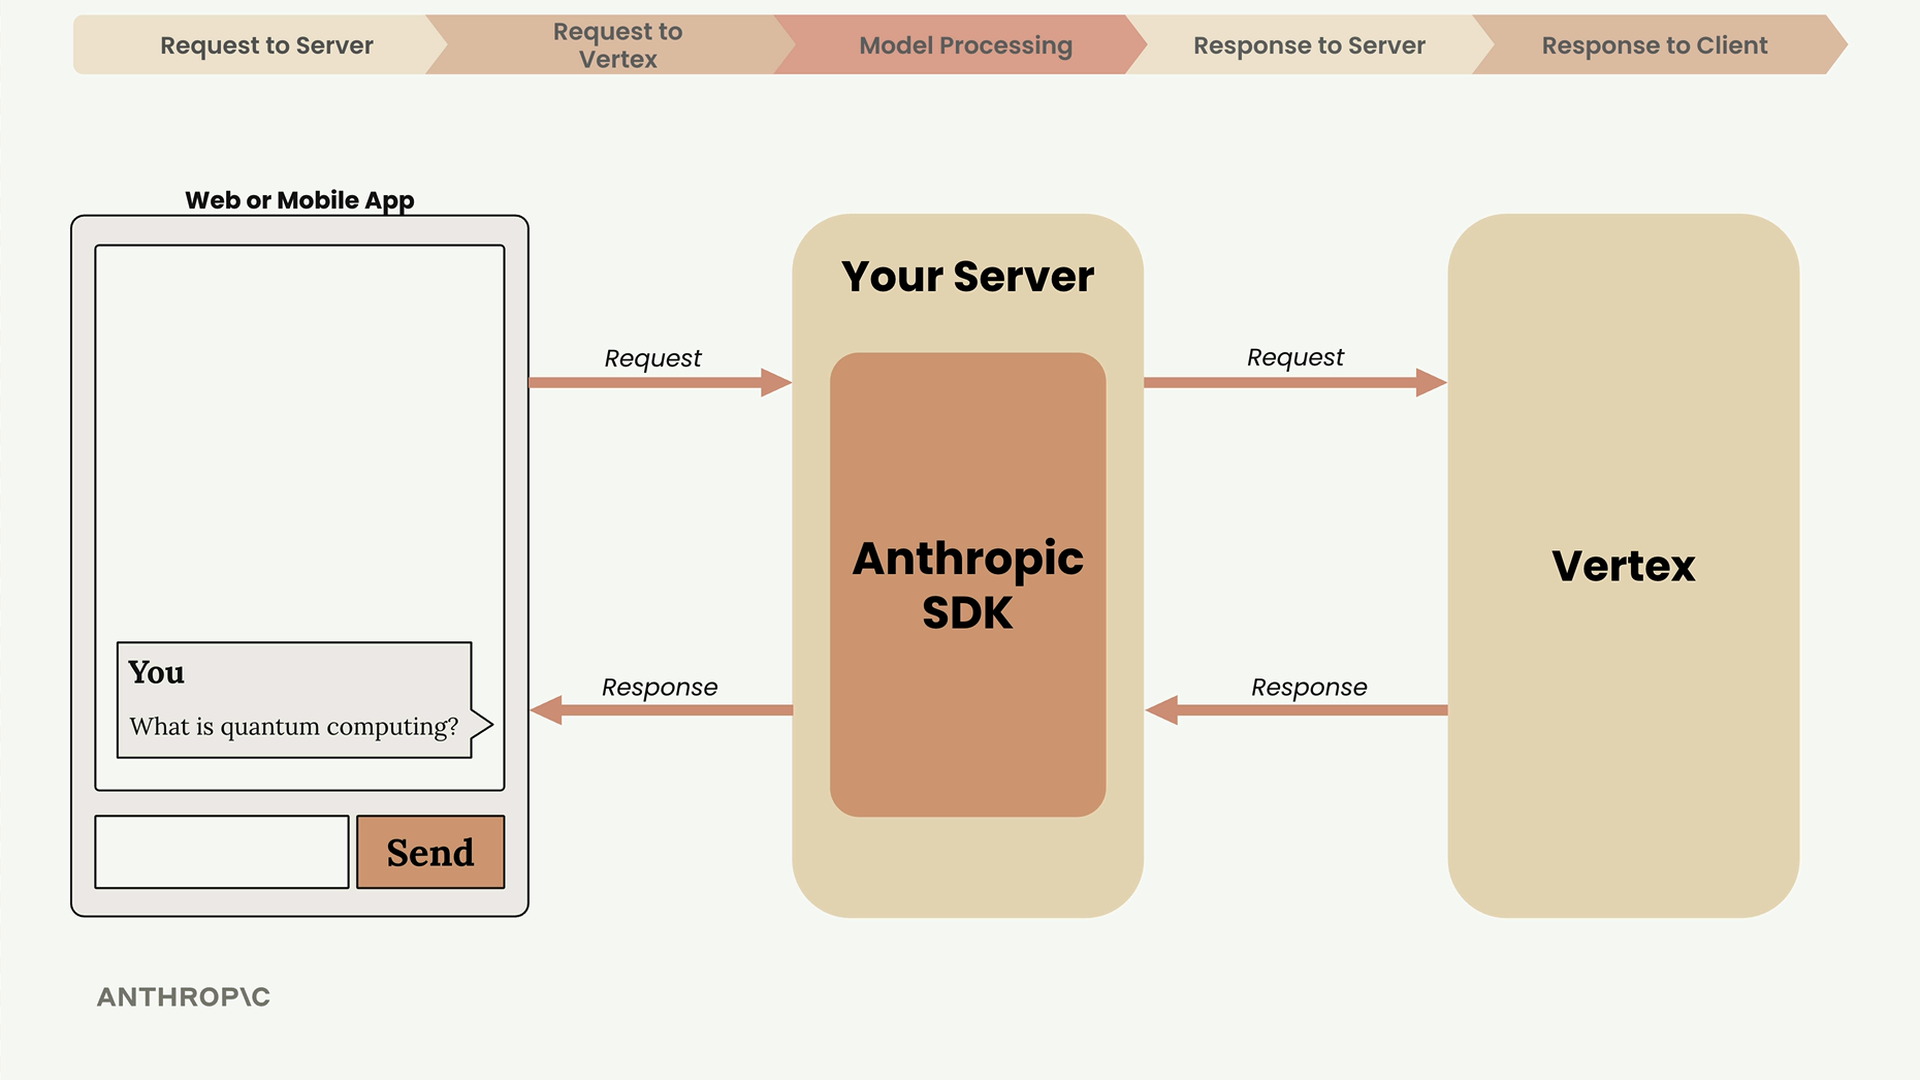
Le point clé à retenir : utilisez toujours un serveur comme intermédiaire, comprenez que la génération de texte est un processus itératif, et portez attention aux métadonnées de la réponse pour surveiller l'usage et comprendre le comportement du modèle.