La mémorisation des requêtes dans Claude fonctionne en stockant le travail de calcul effectué sur les messages afin qu'il puisse être réutilisé dans les requêtes de suivi. Cela rend les requêtes utilisant du contenu mis en cache à la fois moins coûteuses et plus rapides à exécuter.
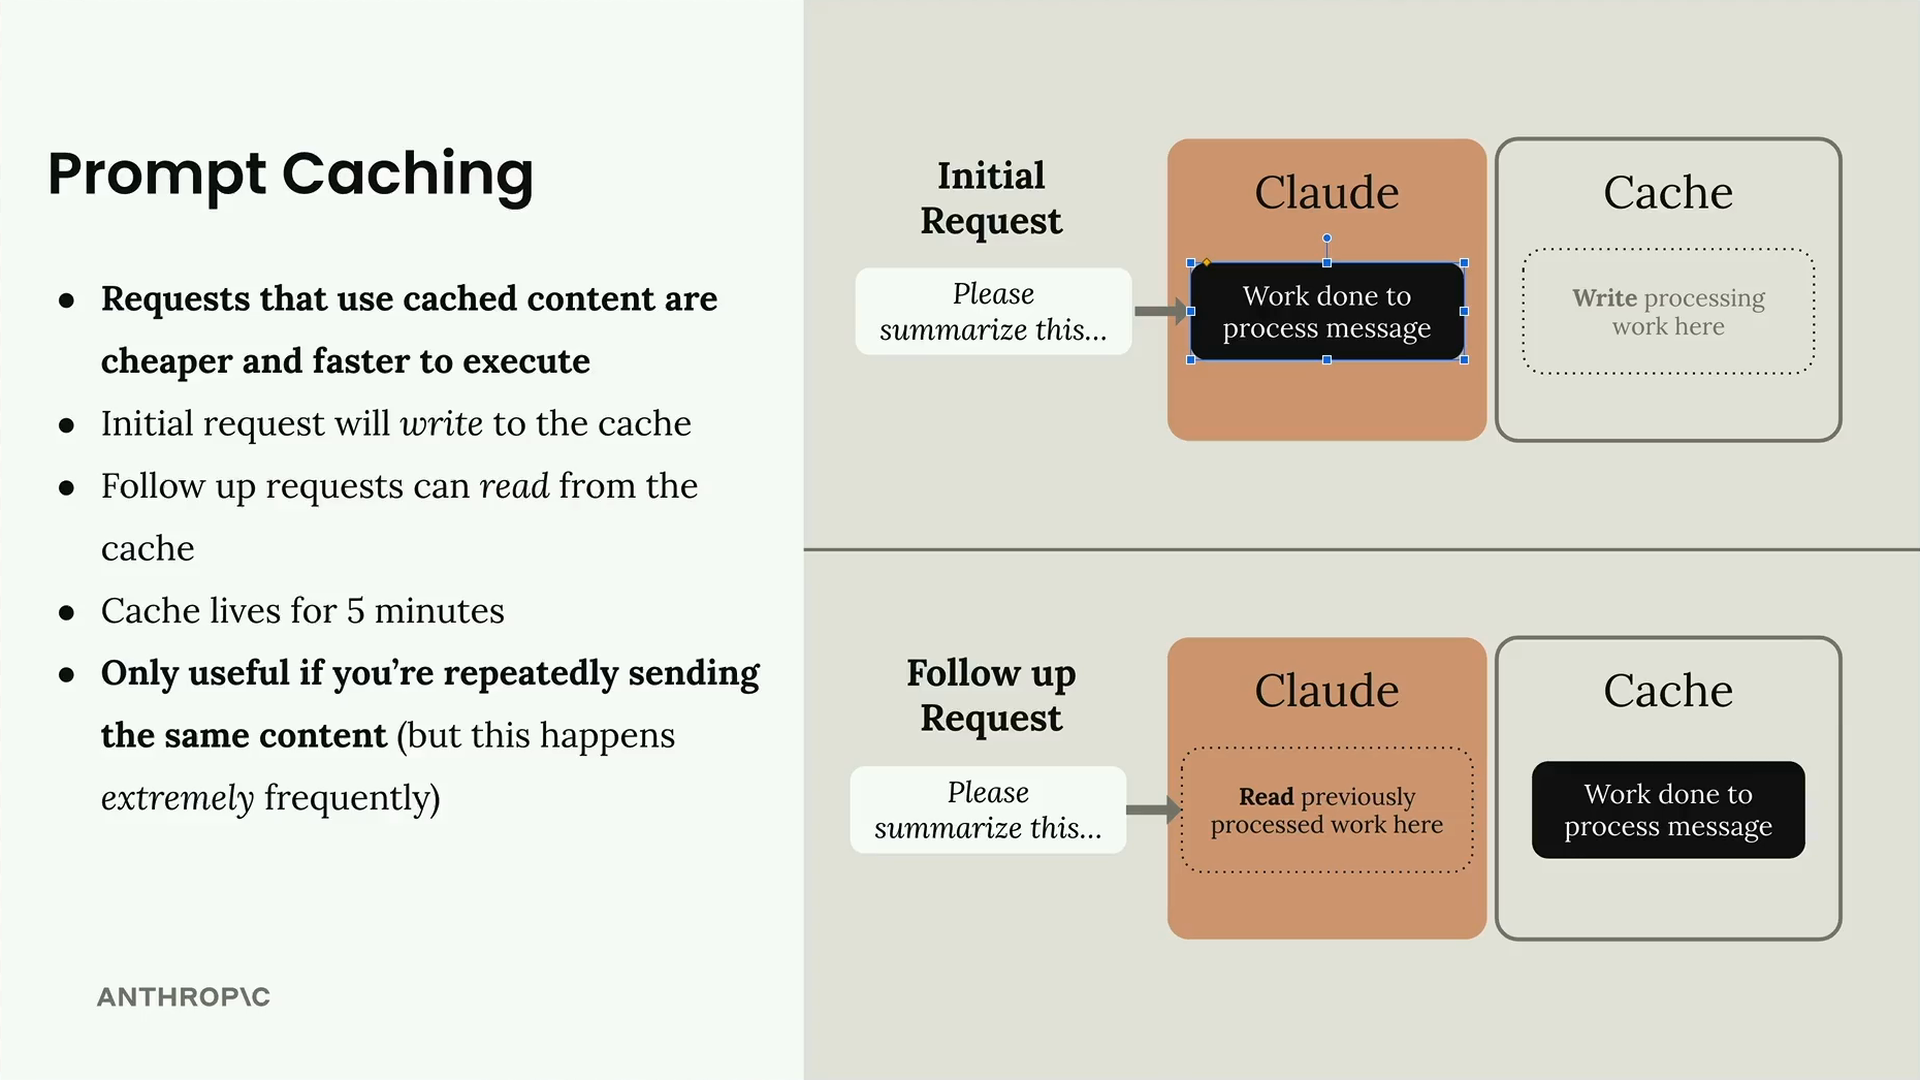
Le processus suit un schéma simple : votre requête initiale écrit dans le cache, et les requêtes de suivi peuvent lire depuis le cache. Le cache vit pendant 5 minutes, donc cette fonctionnalité n'est utile que si vous envoyez à répétition le même contenu - mais cela se produit extrêmement fréquemment dans les applications réelles.
Points de rupture du cache
Le travail effectué sur les messages n'est pas mis en cache automatiquement. Nous devons manuellement ajouter un « point de rupture du cache » à un bloc. Le travail effectué pour tout ce qui précède le point de rupture sera mis en cache, et le cache ne sera utilisé sur les requêtes de suivi que si le contenu jusqu'au point de rupture inclus est identique.
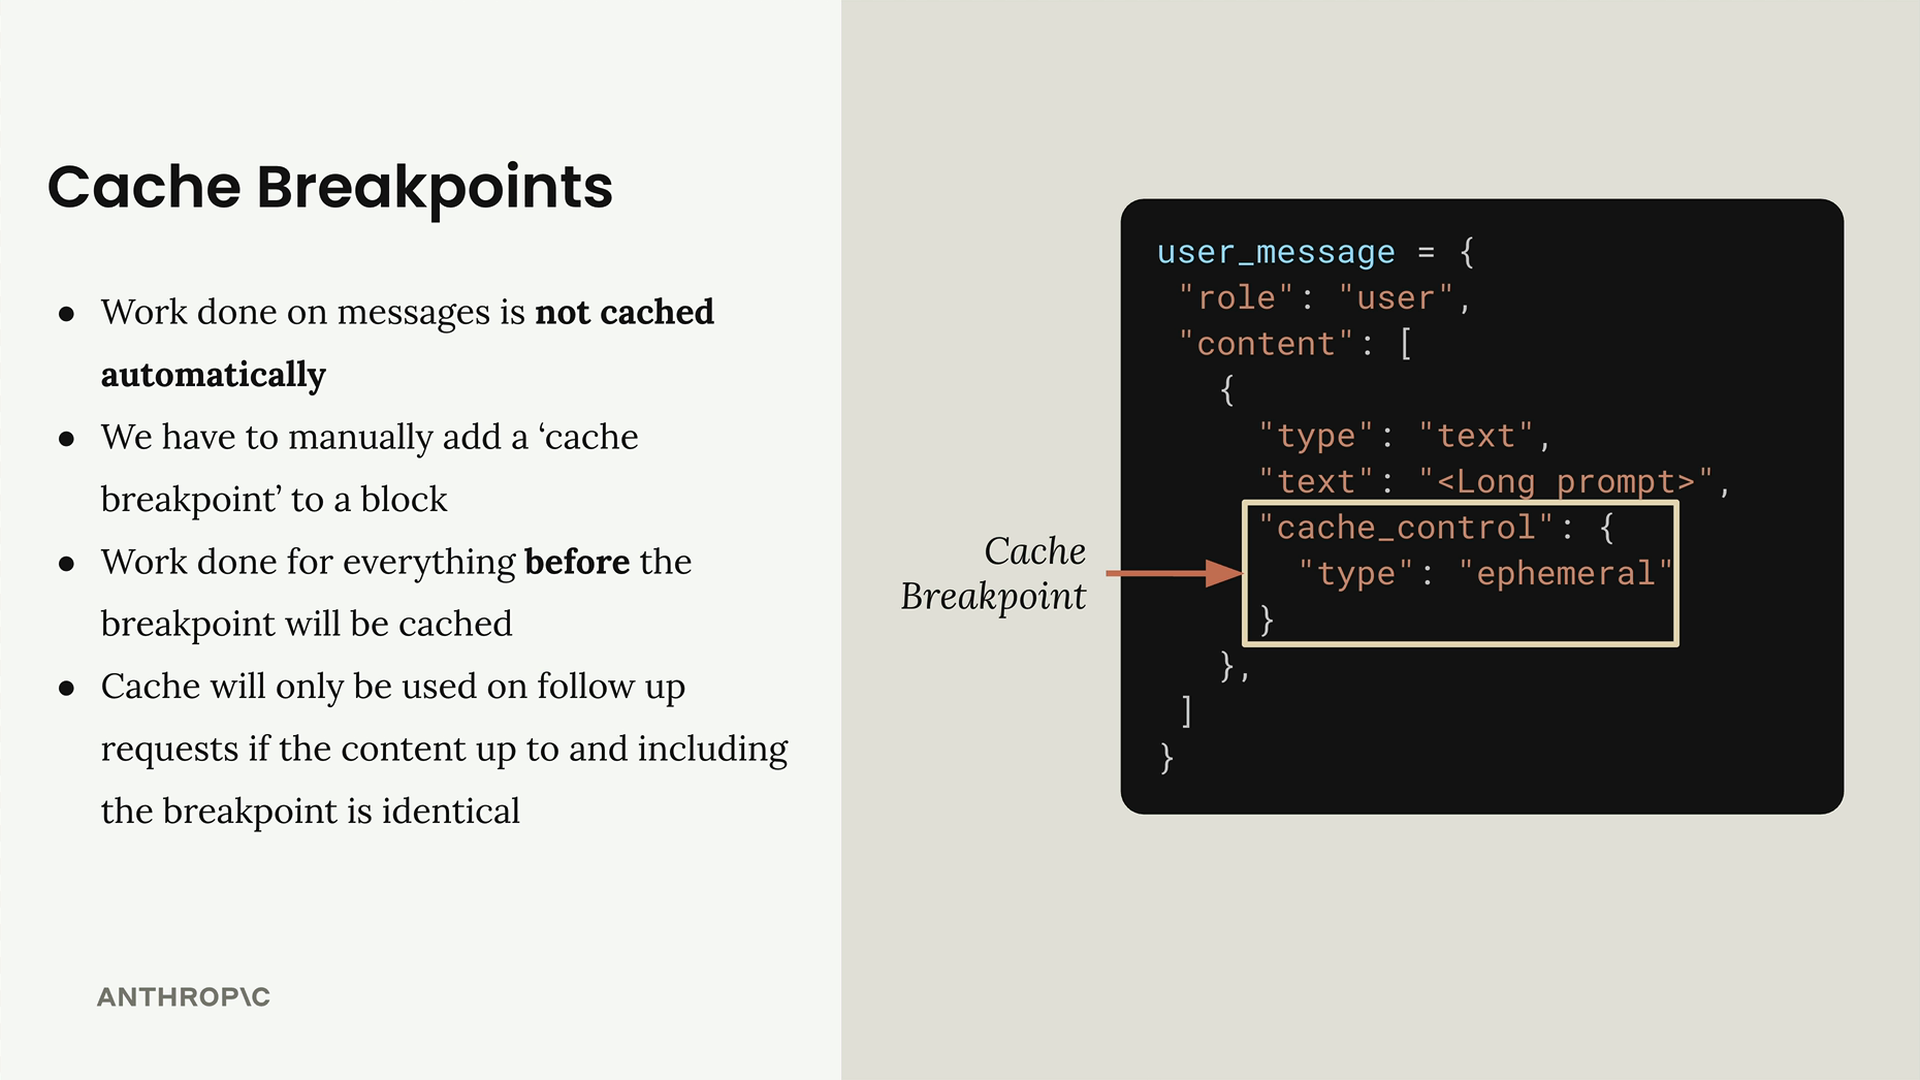
Lorsque vous devez ajouter des points de rupture du cache, vous devez utiliser la forme longue pour écrire les blocs de texte au lieu de la forme abrégée. Voici la différence :
# Forme abrégée - impossible d'ajouter des points d'arrêt de cache
user_message = {
  "role": "user",
  "content": "Hi there!"
}

# Forme longue - requise pour les points d'arrêt de cache
user_message = {
  "role": "user",
  "content": [
    {
      "type": "text",
      "text": "Hi there!",
      "cache_control": {
        "type": "ephemeral"
      }
    }
  ]
}
Fonctionnement des points de rupture du cache
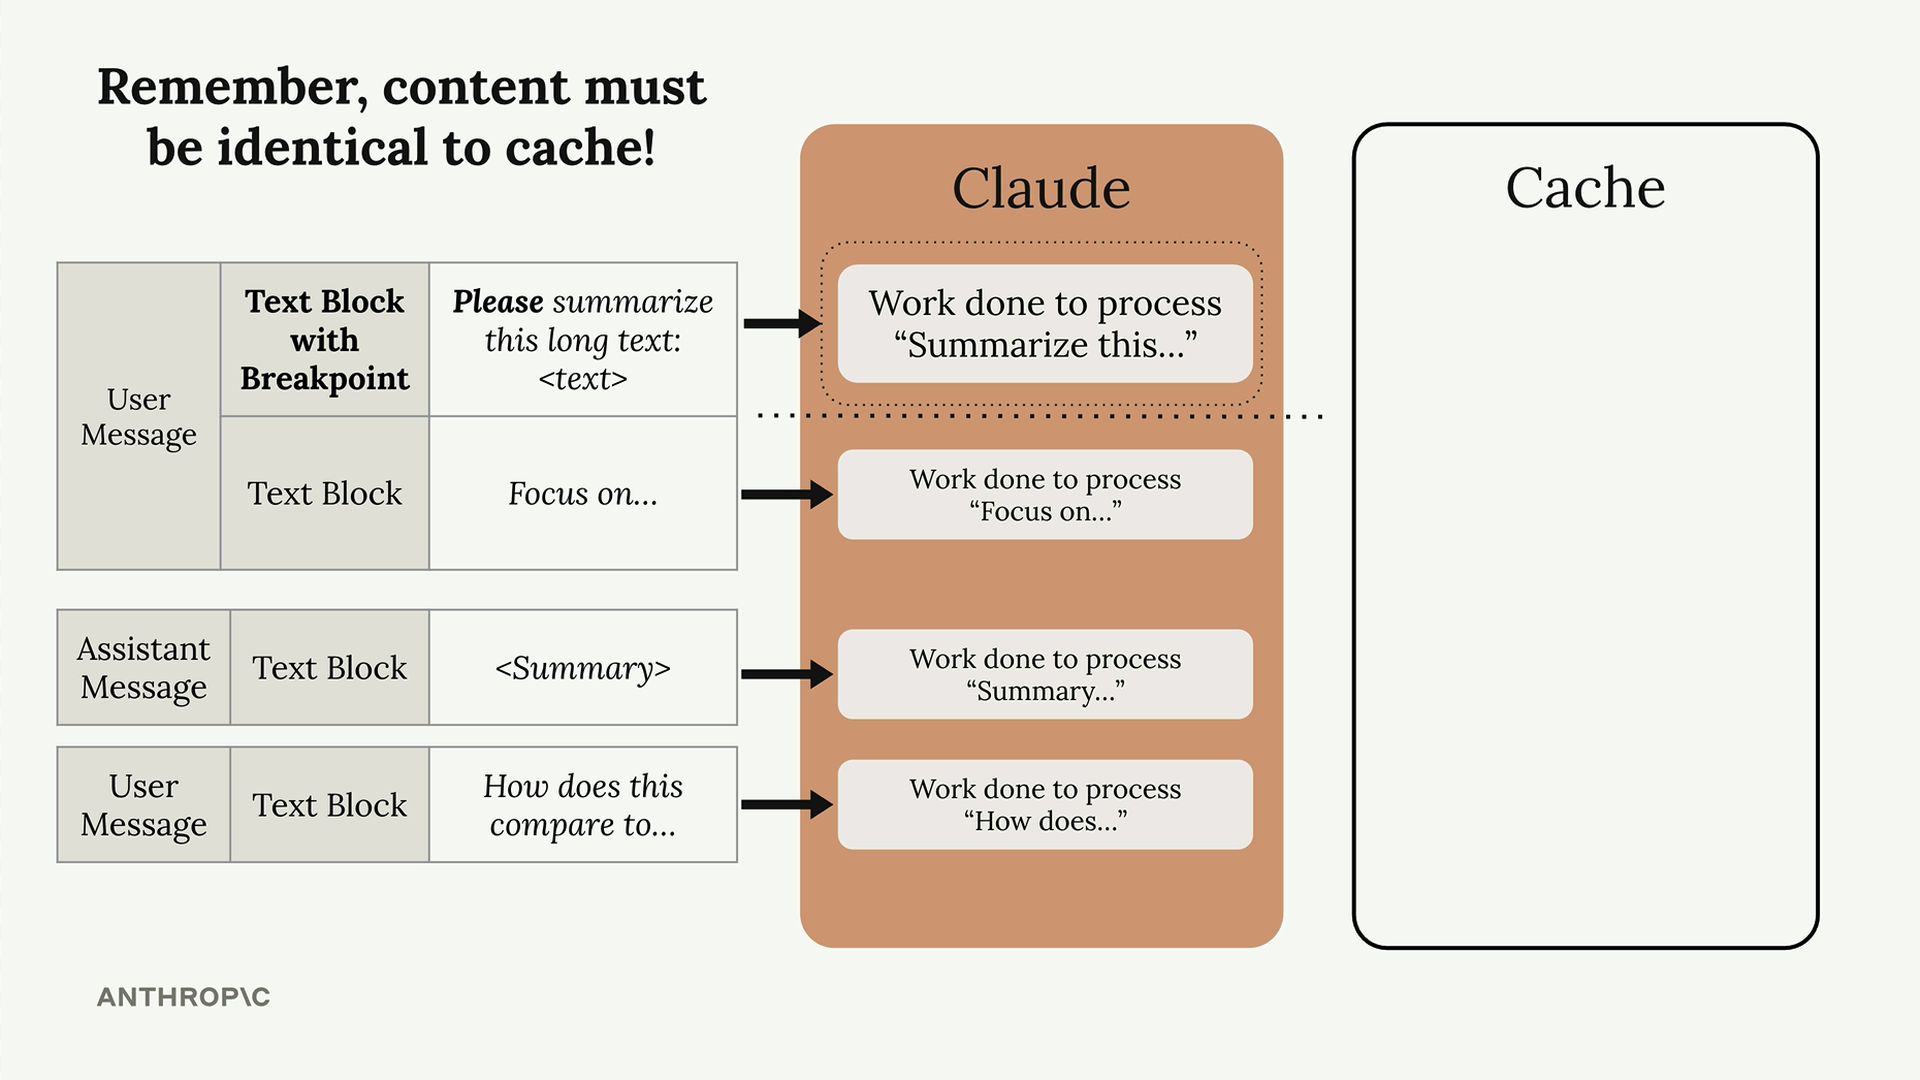
Les points de rupture du cache s'étendent sur plusieurs messages et peuvent aussi mettre en cache les messages de l'assistant. Lorsque vous placez un point de rupture, tout ce qui précède ce point est mis en cache. Rappelez-vous, le contenu doit être identique pour utiliser le cache !
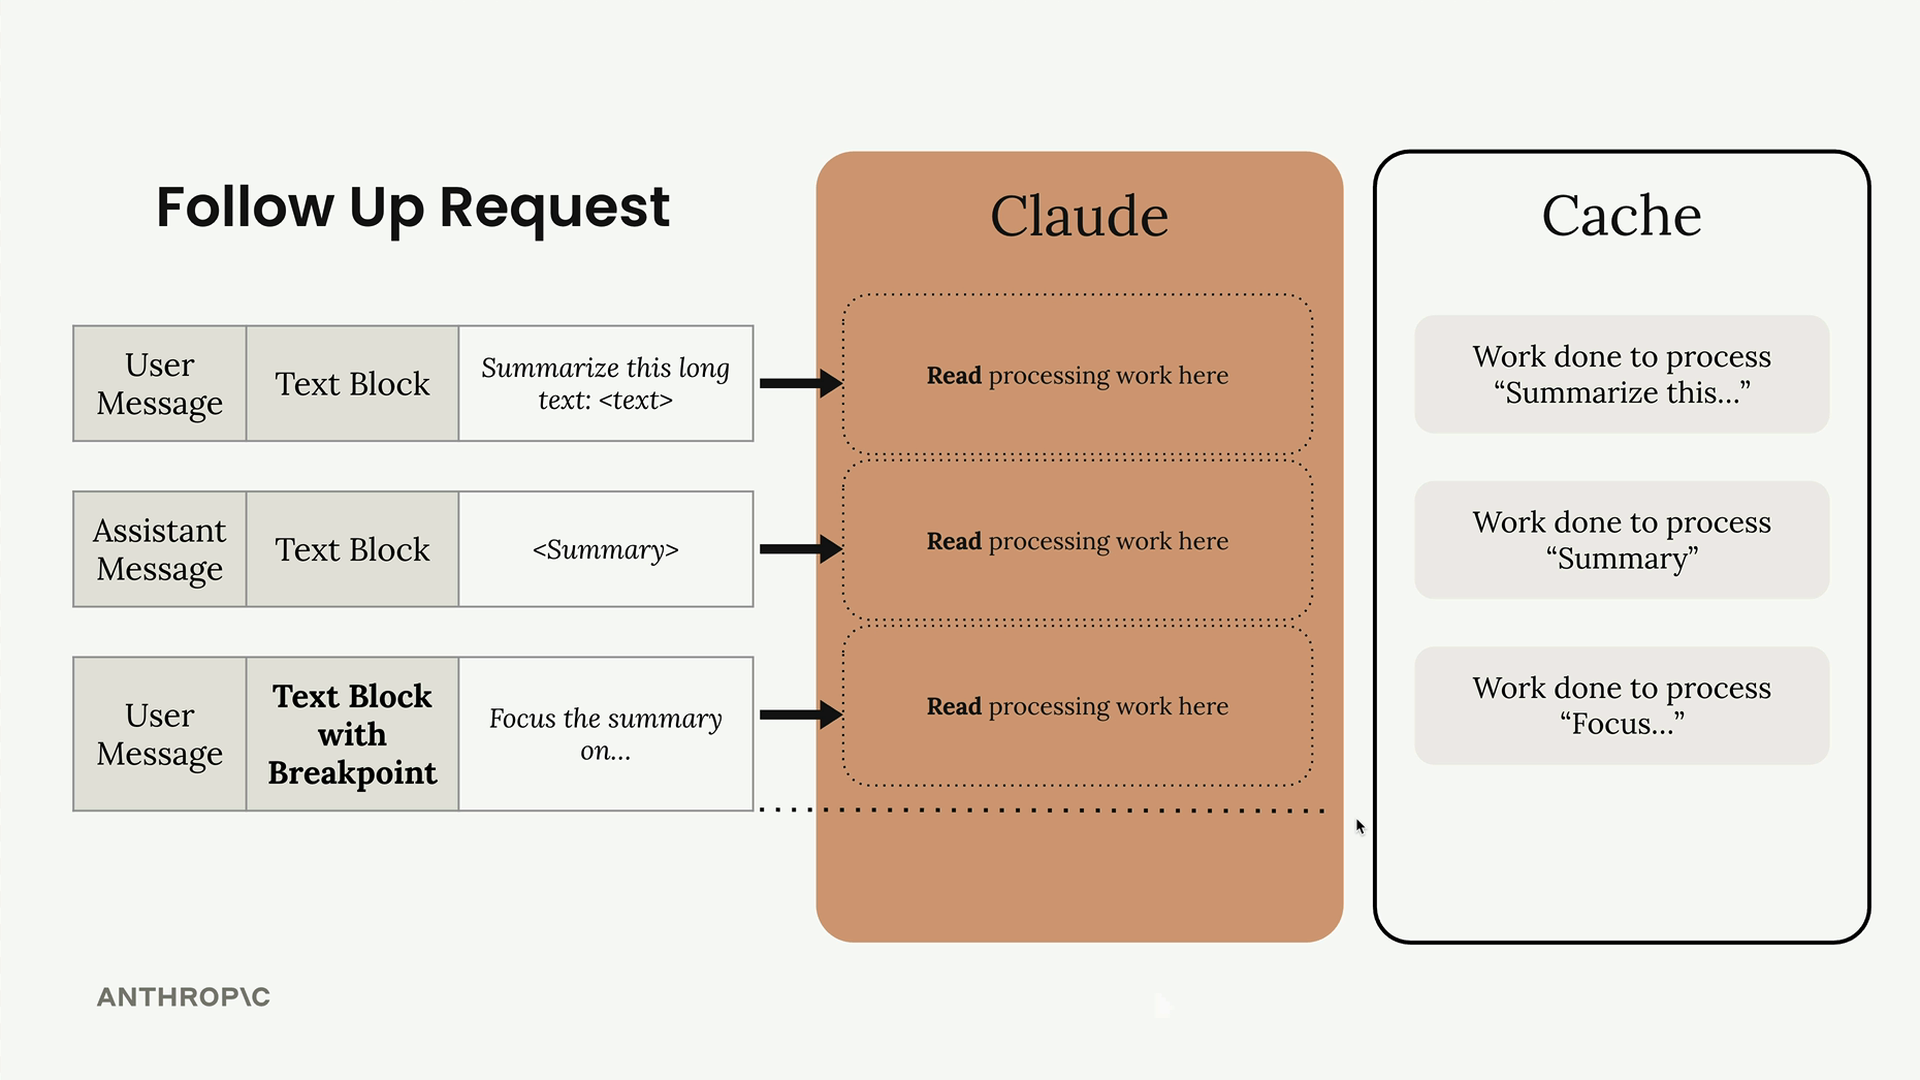
Dans une requête de suivi, Claude lit le travail précédemment traité depuis le cache au lieu de le retraiter :
Emplacement du point de rupture
Vous n'êtes pas limité aux blocs de texte ! Vous pouvez ajouter des points de rupture du cache aux invites système et aux définitions d'outils. Ce sont en fait les opportunités de mise en cache les plus courantes, puisqu'elles changent rarement d'une requête à l'autre.
# Définitions d'outils avec point de rupture du cache
tools = [
  add_duration_to_datetime_schema,
  get_current_datetime_schema,
  {
    "name": "set_reminder",
    "description": "Sets a reminder...",
    "input_schema": { ... },
    "cache_control": {"type": "ephemeral"}
  }
]

# Invite système avec point de rupture du cache
system = [
  {
    "type": "text",
    "text": "You are a senior software...",
    "cache_control": {"type": "ephemeral"}
  }
]
Ordre du cache
En coulisses, les outils, les invites système et les messages sont assemblés dans cet ordre précis lorsqu'ils sont transmis à Claude. Cela affecte le fonctionnement de vos points de rupture du cache.
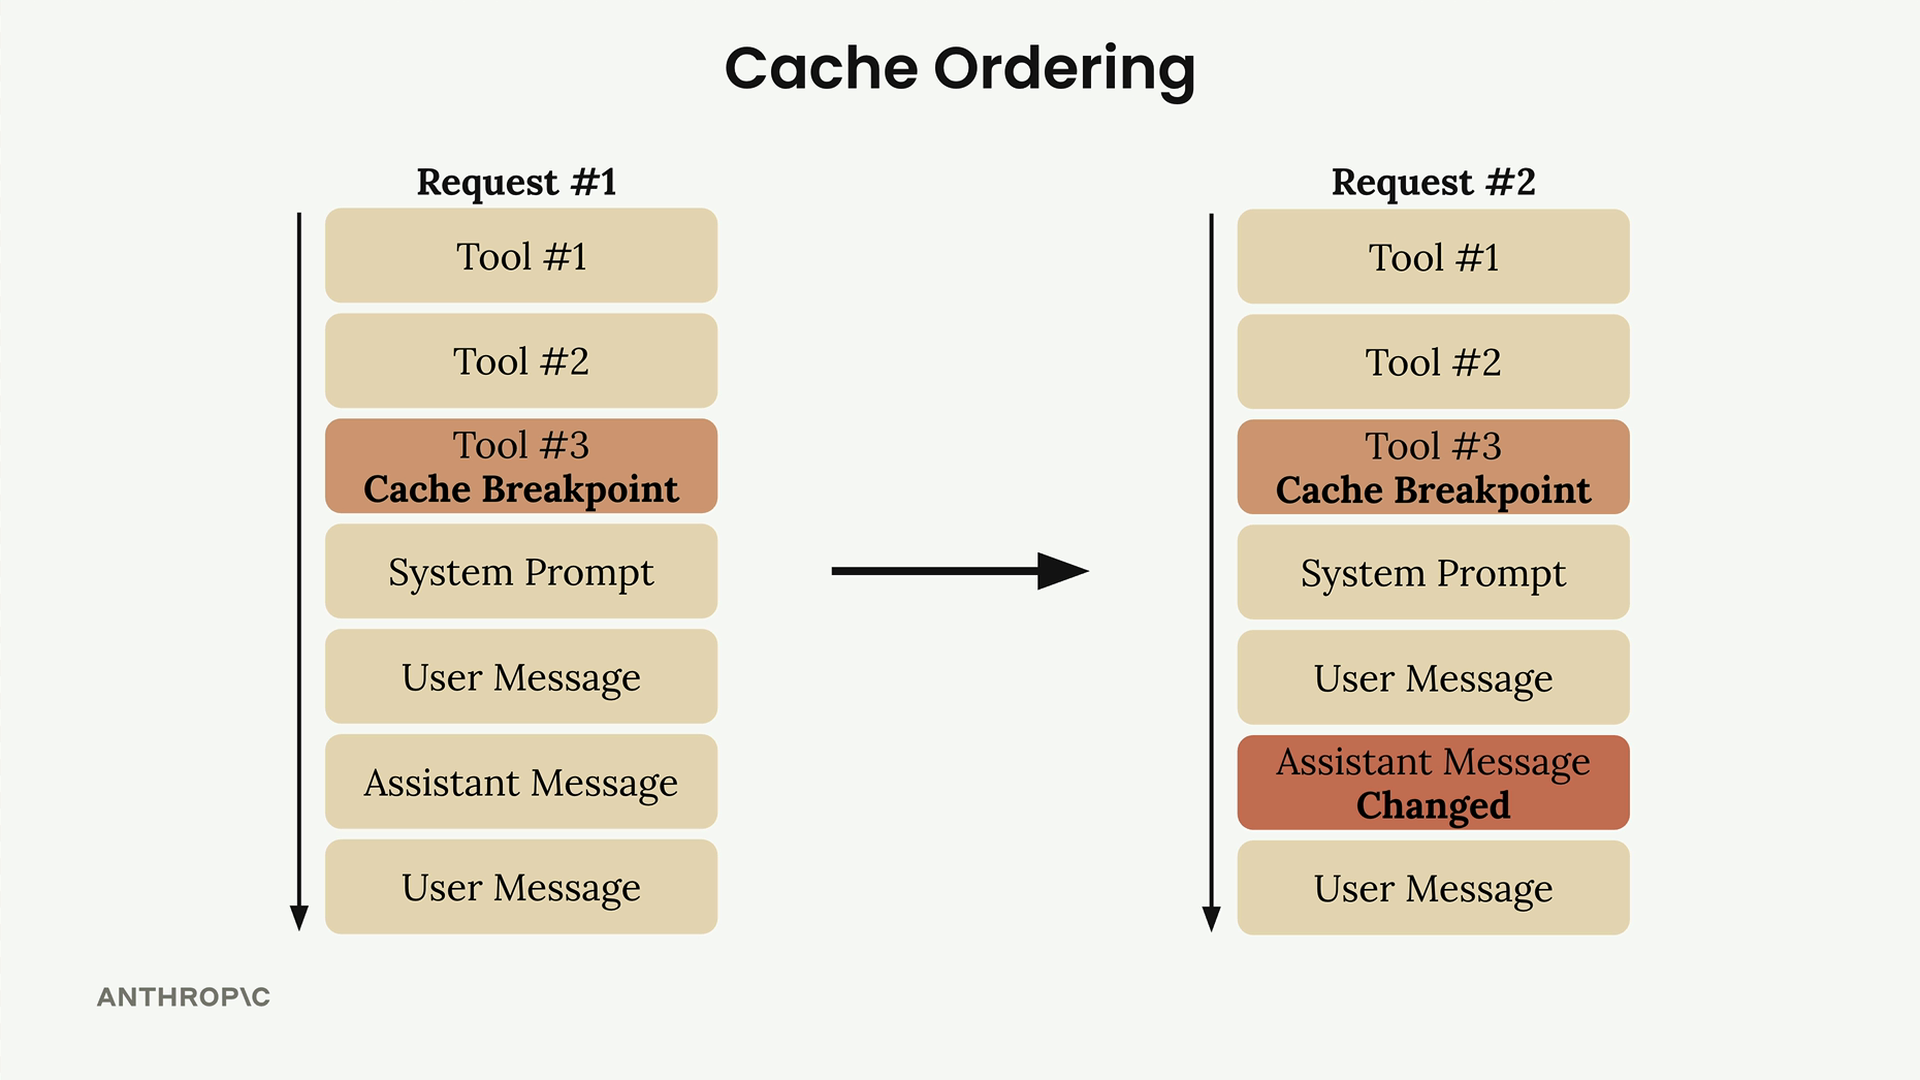
Vous pouvez ajouter jusqu'à quatre points de rupture du cache au total. Si vous placez un point de rupture sur votre dernier outil, tout ce qui précède cet outil est mis en cache, mais l'invite système et les messages ne le seront pas. Cela vous donne un contrôle précis sur ce qui est mis en cache en fonction de ce qui change dans votre application.
Longueur minimale du contenu
Il existe une longueur minimale pour la mise en cache, et elle dépend du modèle. Pour Claude Haiku 4.5, le modèle utilisé dans ce cours, le contenu doit comporter au moins 4 096 jetons pour être mis en cache. Il s'agit de la somme de tous les messages et blocs que vous essayez de mettre en cache, et non de blocs individuels.
Un message comme « Hi there! » est bien trop court pour être mis en cache, mais une requête véritablement longue atteint le minimum. Le contenu en dessous du minimum est simplement traité sans mise en cache, et aucune erreur n'est renvoyée. Pour le vérifier, examinez l'usage de la réponse : cache_creation_input_tokens et cache_read_input_tokens seront tous les deux à 0.
La clé d'une mémorisation des requêtes efficace consiste à identifier les parties de vos requêtes qui restent constantes - généralement vos invites système et vos définitions d'outils - et à placer les points de rupture de manière stratégique afin de maximiser les succès de cache tout en minimisant le retraitement.