Après avoir extrait des fragments de texte d'un document, l'étape suivante dans un pipeline RAG consiste à trouver quels fragments sont les plus pertinents par rapport à la question d'un utilisateur. Il s'agit essentiellement d'un problème de recherche - vous devez parcourir tous vos fragments et identifier ceux qui se rapportent à ce que l'utilisateur demande.
Recherche sémantique
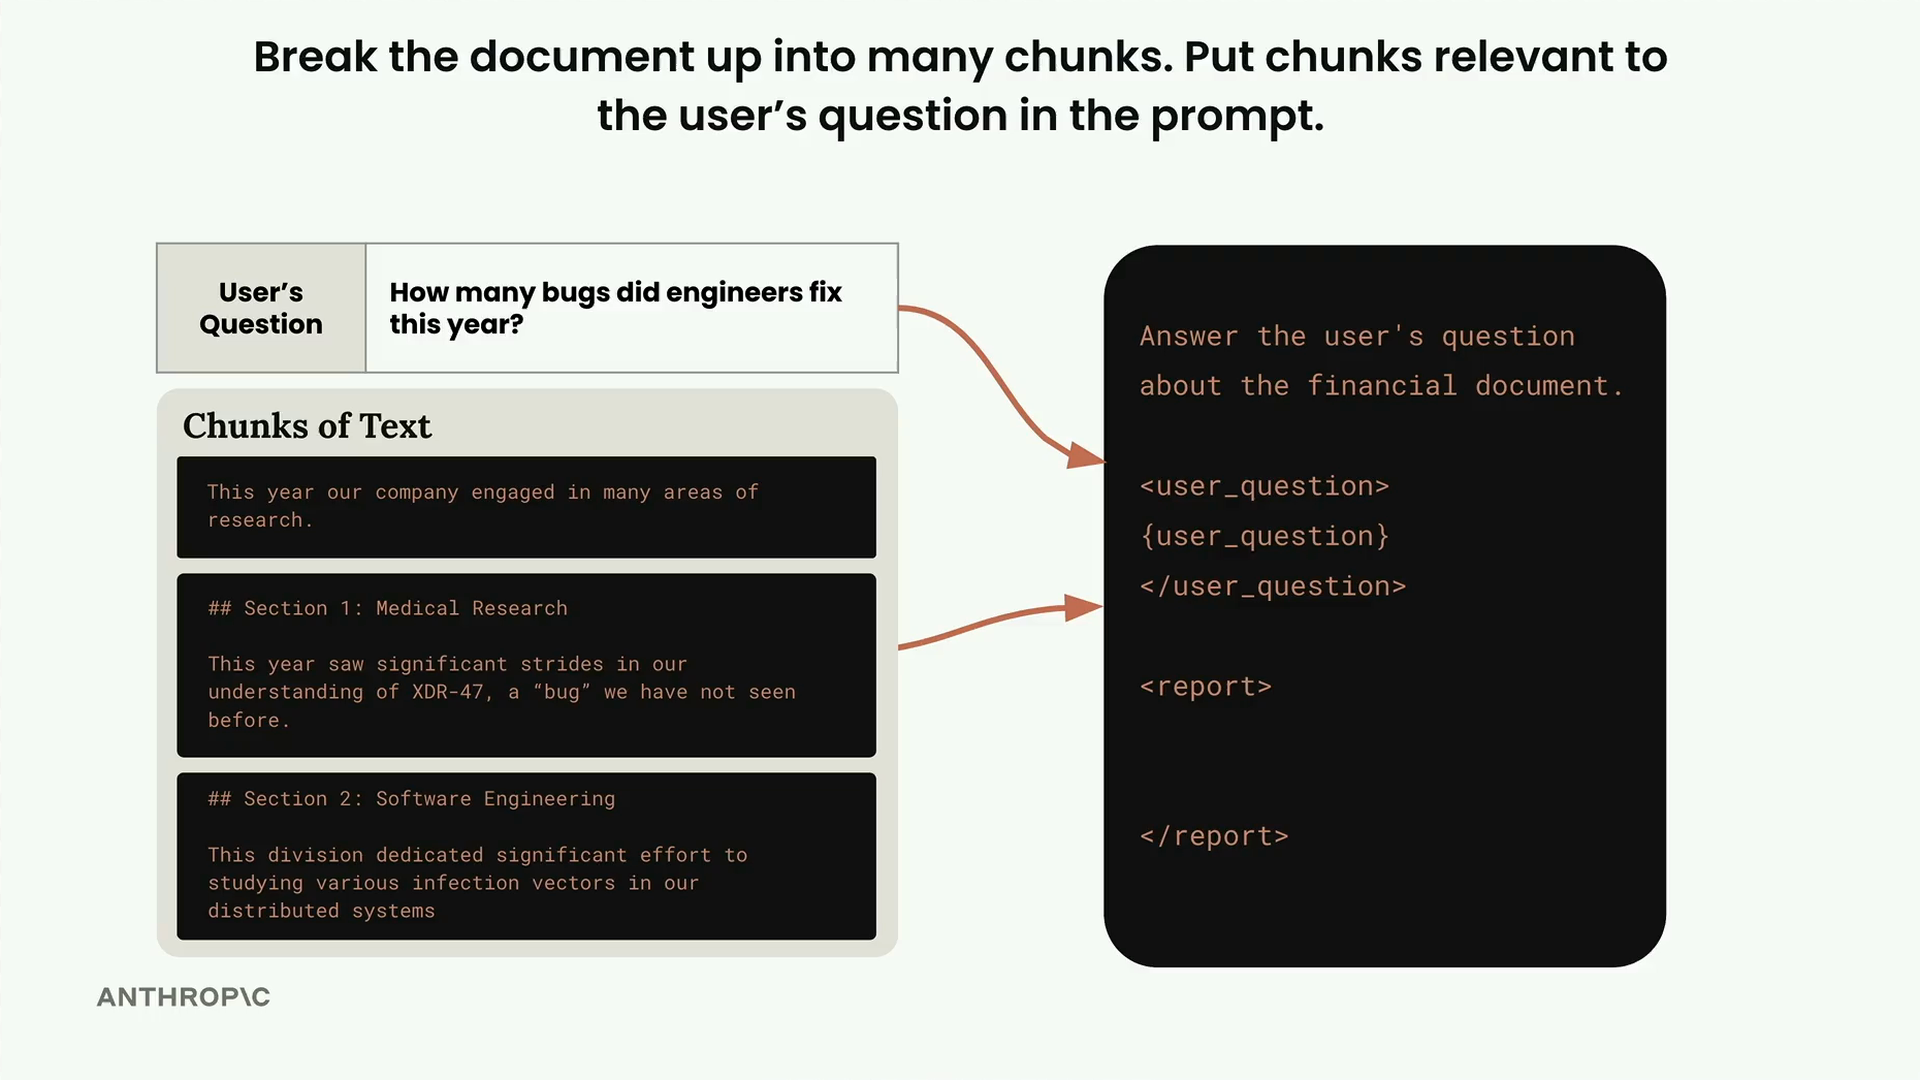
L'approche la plus courante pour trouver des fragments pertinents est la recherche sémantique. Contrairement à la recherche traditionnelle basée sur des mots-clés, la recherche sémantique utilise des embeddings de texte pour comprendre le sens réel à la fois de la question de l'utilisateur et de chaque fragment de texte. Cela permet au système de trouver du contenu conceptuellement lié même lorsque les mots exacts ne correspondent pas.
Que sont les embeddings de texte ?
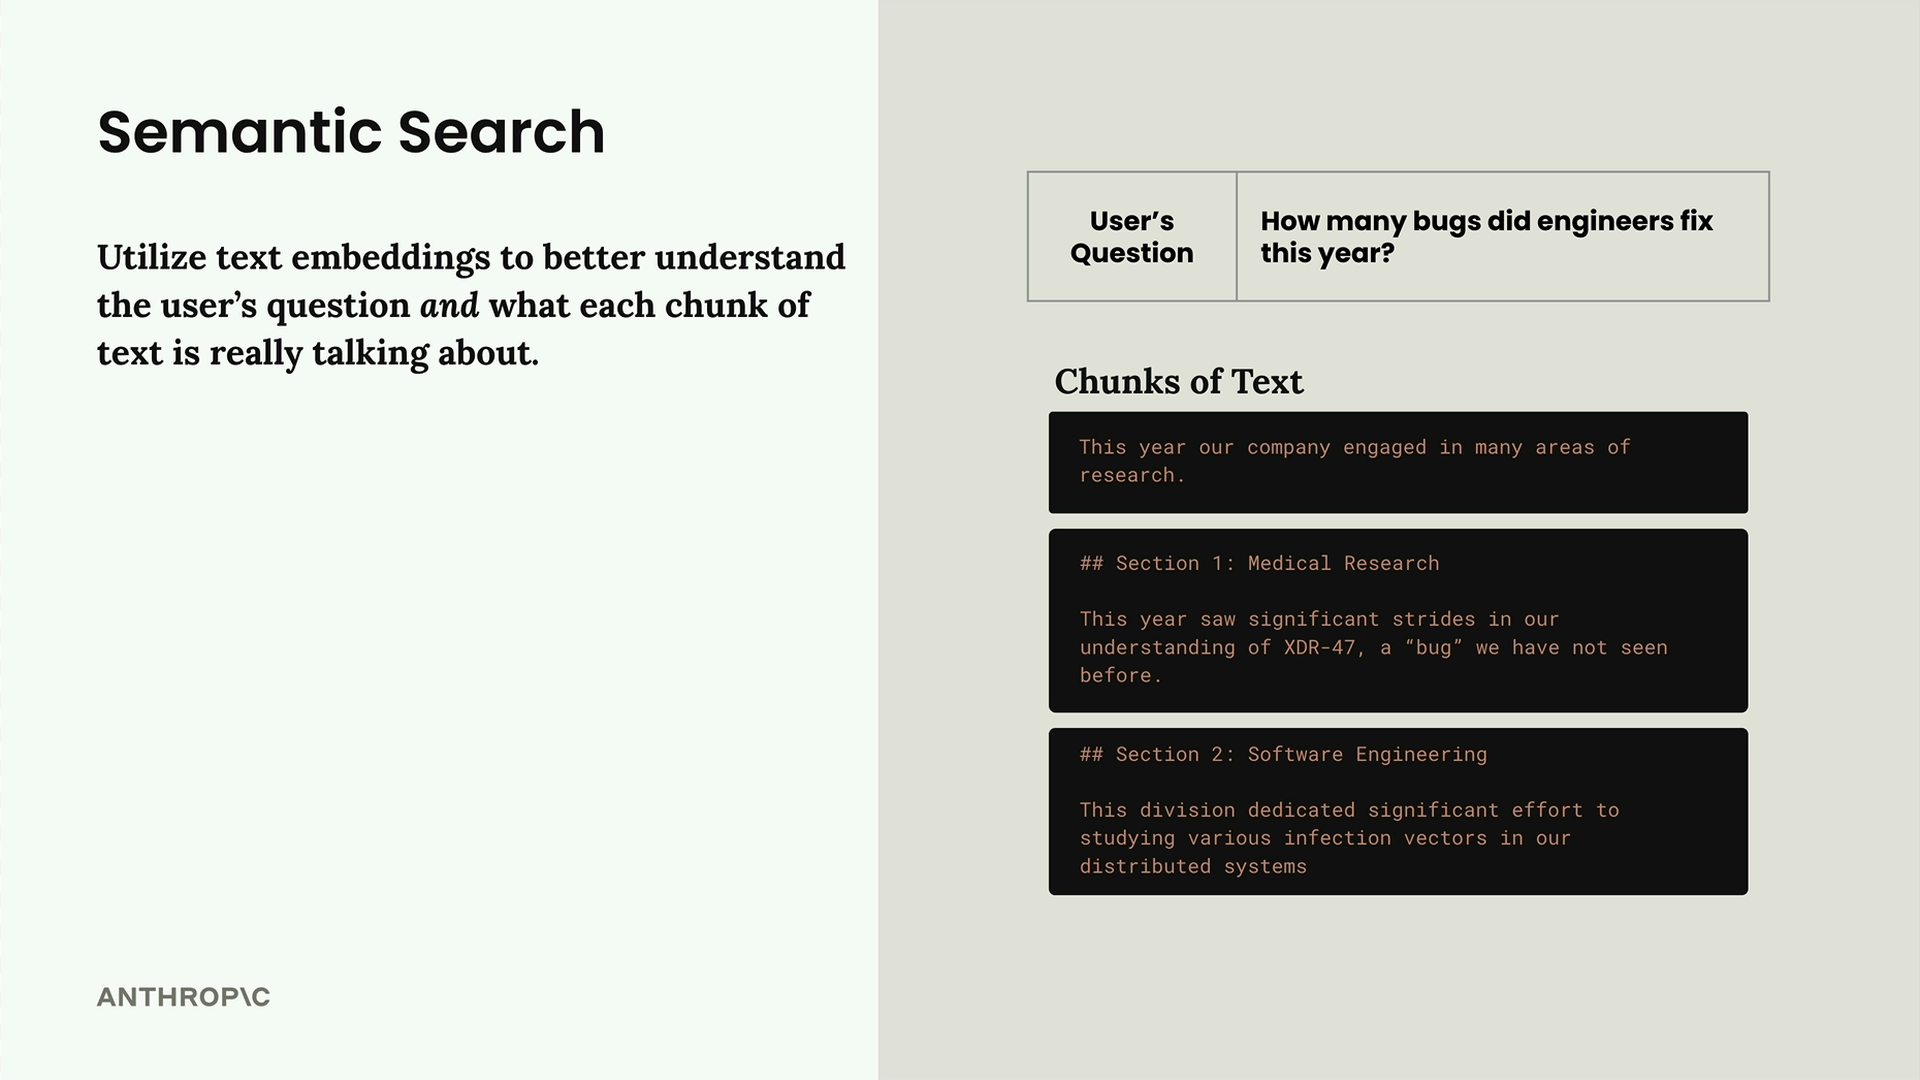
Un embedding de texte est une représentation numérique du sens contenu dans un texte. Pensez-y comme la conversion de mots et de phrases en un format avec lequel les ordinateurs peuvent travailler mathématiquement.
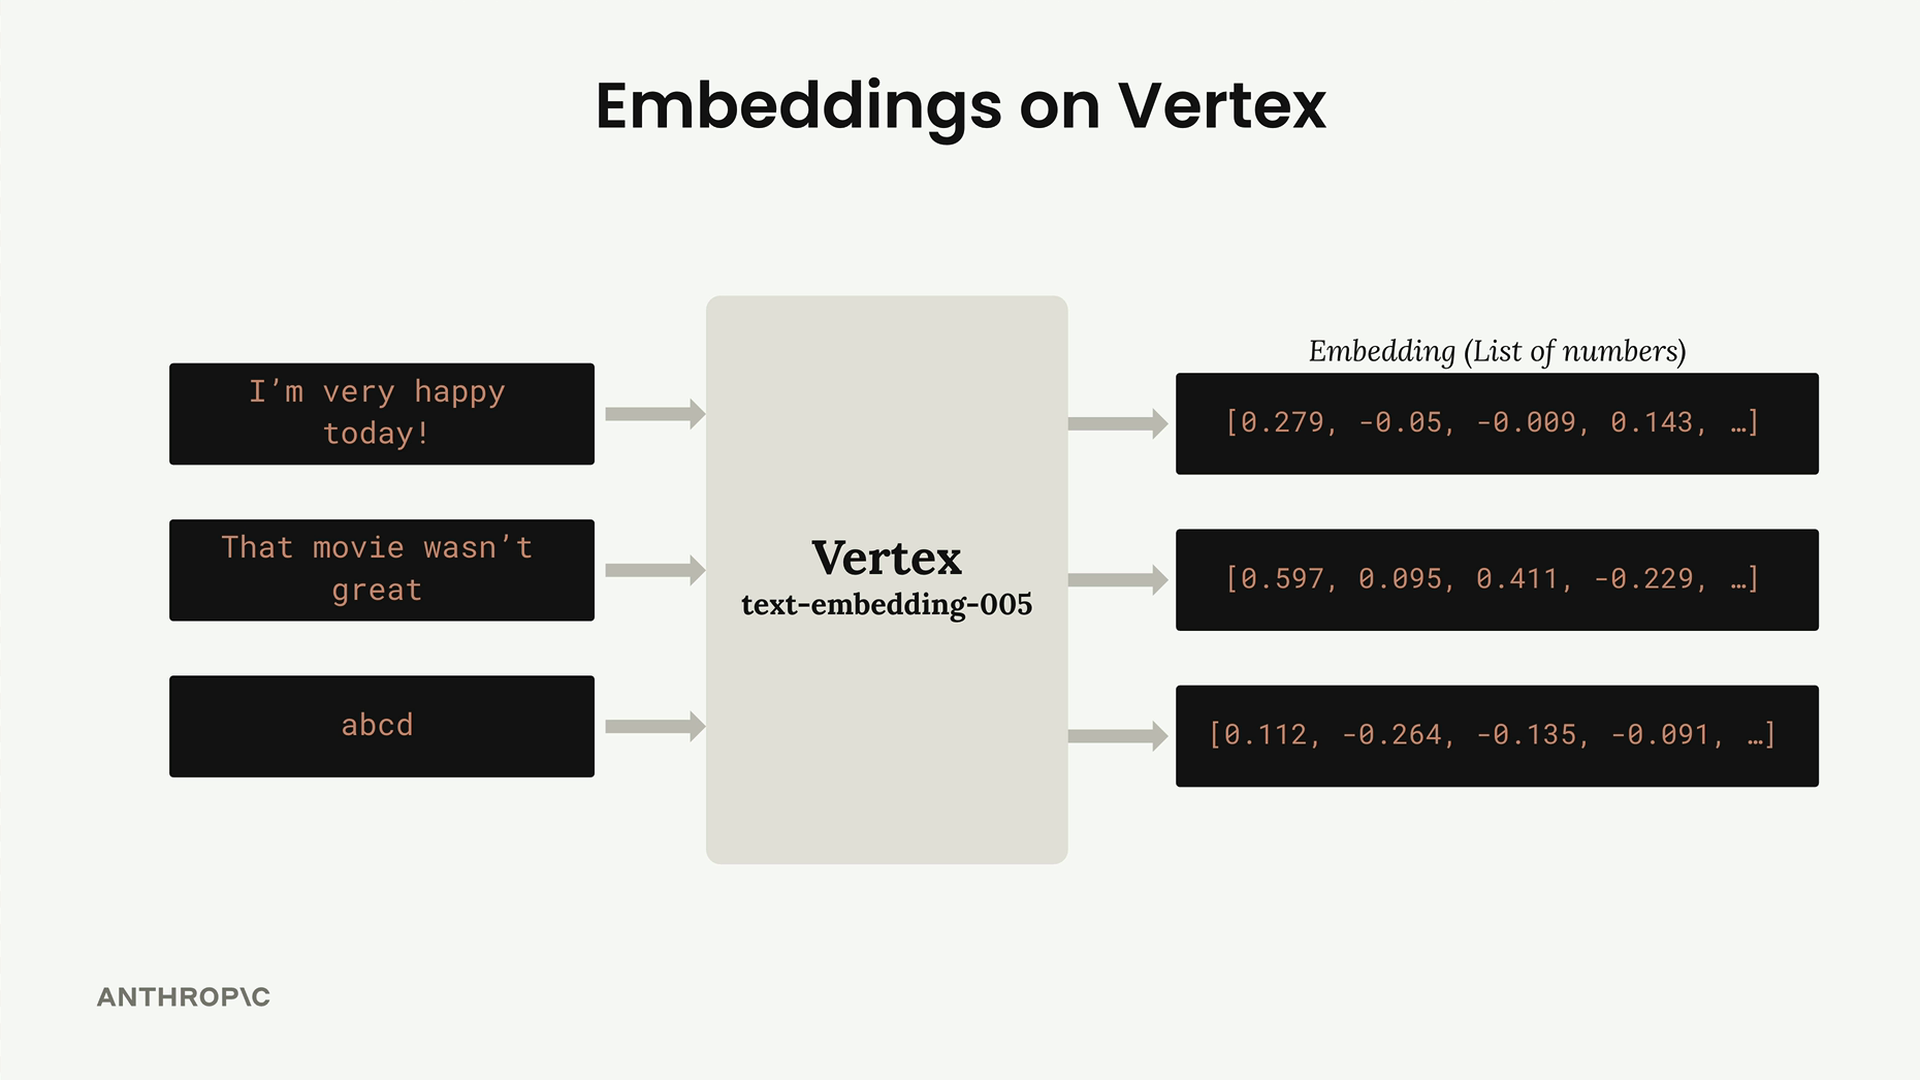
Voici comment fonctionne le processus :
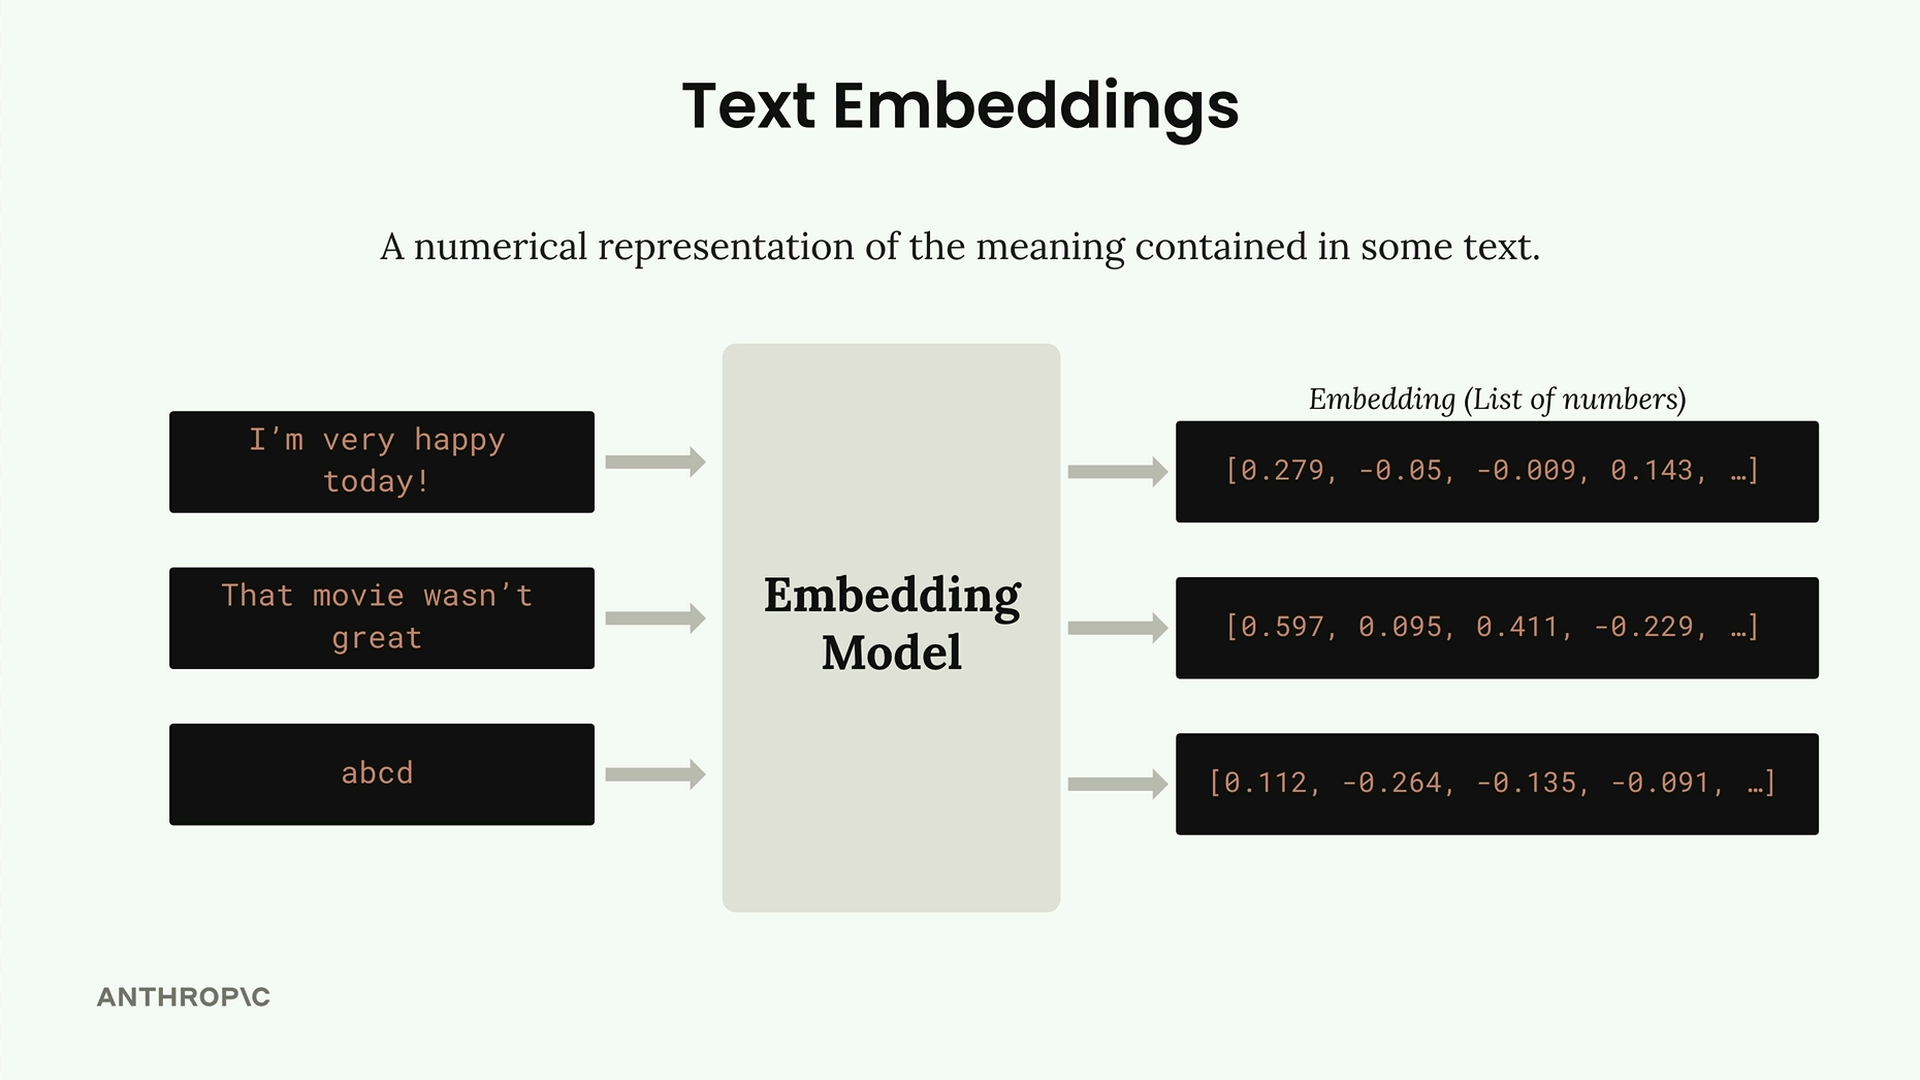
- Vous alimentez un modèle d'embedding avec du texte
- Le modèle produit une longue liste de nombres (l'embedding)
- Chaque nombre varie de -1 à +1
- Ces nombres représentent différentes qualités ou caractéristiques du texte d'entrée
Comprendre les nombres
Chaque nombre dans un embedding est essentiellement un « score » pour une certaine qualité du texte d'entrée. Cependant, voici la mise en garde importante : nous ne savons pas réellement ce que représente chaque nombre spécifique.
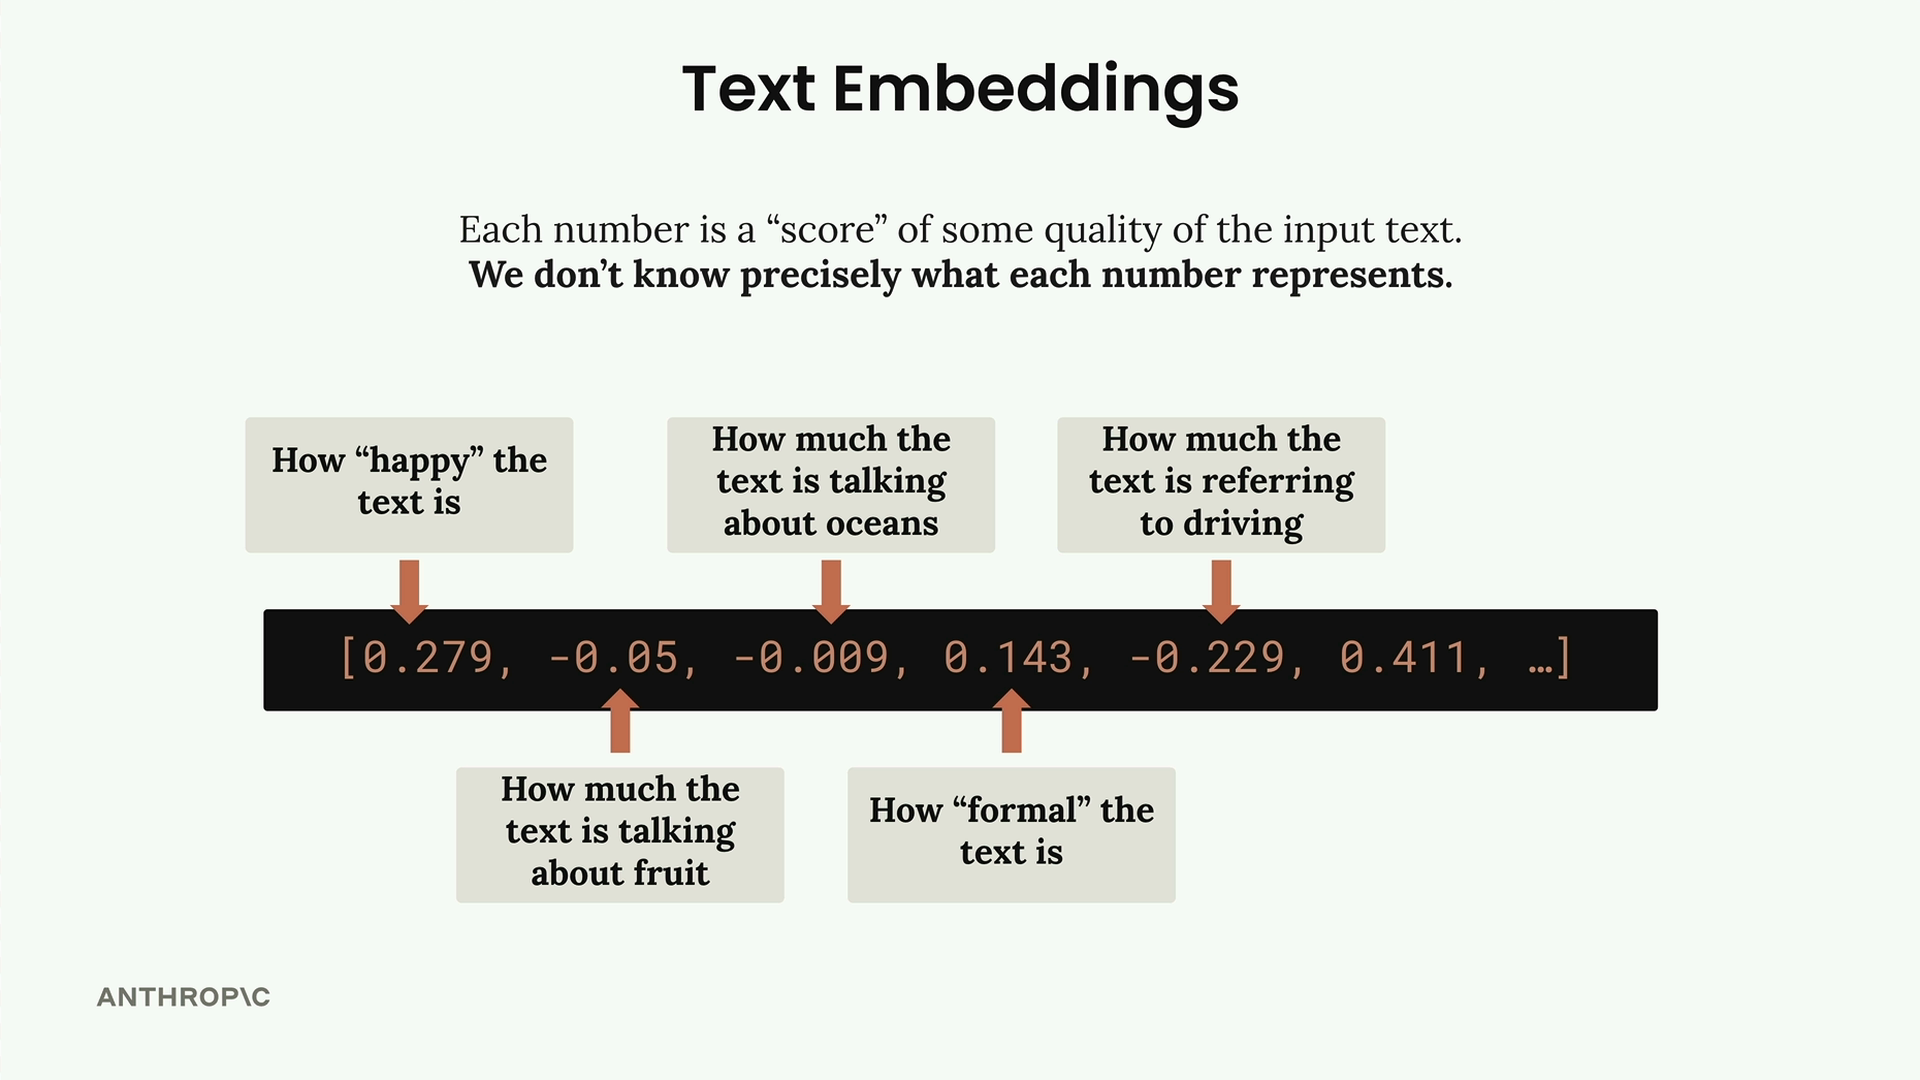
Bien qu'il soit utile d'imaginer qu'un nombre pourrait représenter « à quel point le texte est joyeux » et qu'un autre pourrait représenter « à quel point le texte parle des océans », ce ne sont que des exemples conceptuels. Le modèle d'embedding apprend ces caractéristiques pendant l'entraînement, mais elles ne sont pas explicitement étiquetées ou interprétables pour nous.
Malgré cette opacité, les embeddings sont incroyablement puissants car ils capturent le sens sémantique d'une manière qui permet une comparaison mathématique entre différents morceaux de texte.
Embeddings sur Vertex AI
Claude ne peut pas générer d'embeddings directement. Au lieu de cela, vous devez utiliser un modèle d'embedding spécialisé. Sur Vertex AI, le modèle que nous utiliserons s'appelle text-embedding-005.
Implémentation
Pour travailler avec des embeddings sur Vertex AI, vous devrez installer le SDK Google GenAI :
pip install google-genaiVoici la configuration de base pour générer des embeddings :
from google import genai

client = genai.Client(
    project="YOUR_PROJECT_ID",
    location="global",
    vertexai=True
)

def generate_embedding(text):
    response = client.models.embed_content(
        model="text-embedding-005",
        contents=text
    )

    if not response.embeddings:
        return []

    return [e.values for e in response.embeddings]
Lorsque vous exécutez cette fonction avec un fragment de texte, vous obtiendrez en retour une liste de nombres à virgule flottante représentant le sens sémantique de ce texte. Ces embeddings constituent le fondement de la mise en œuvre de la recherche sémantique dans votre système RAG.
L'étape suivante consiste à comprendre comment utiliser ces embeddings pour trouver réellement les fragments les plus pertinents pour la question d'un utilisateur, ce qui implique de comparer mathématiquement les embeddings pour déterminer leur similarité.