Lors de la création de workflows d'évaluation d'invites, les systèmes de notation fournissent des signaux objectifs sur la qualité des sorties. Un évaluateur prend la sortie du modèle et renvoie une forme de retour mesurable - généralement un nombre entre 1 et 10, où 10 représente une haute qualité et 1 représente une qualité médiocre.
Types d'évaluateurs
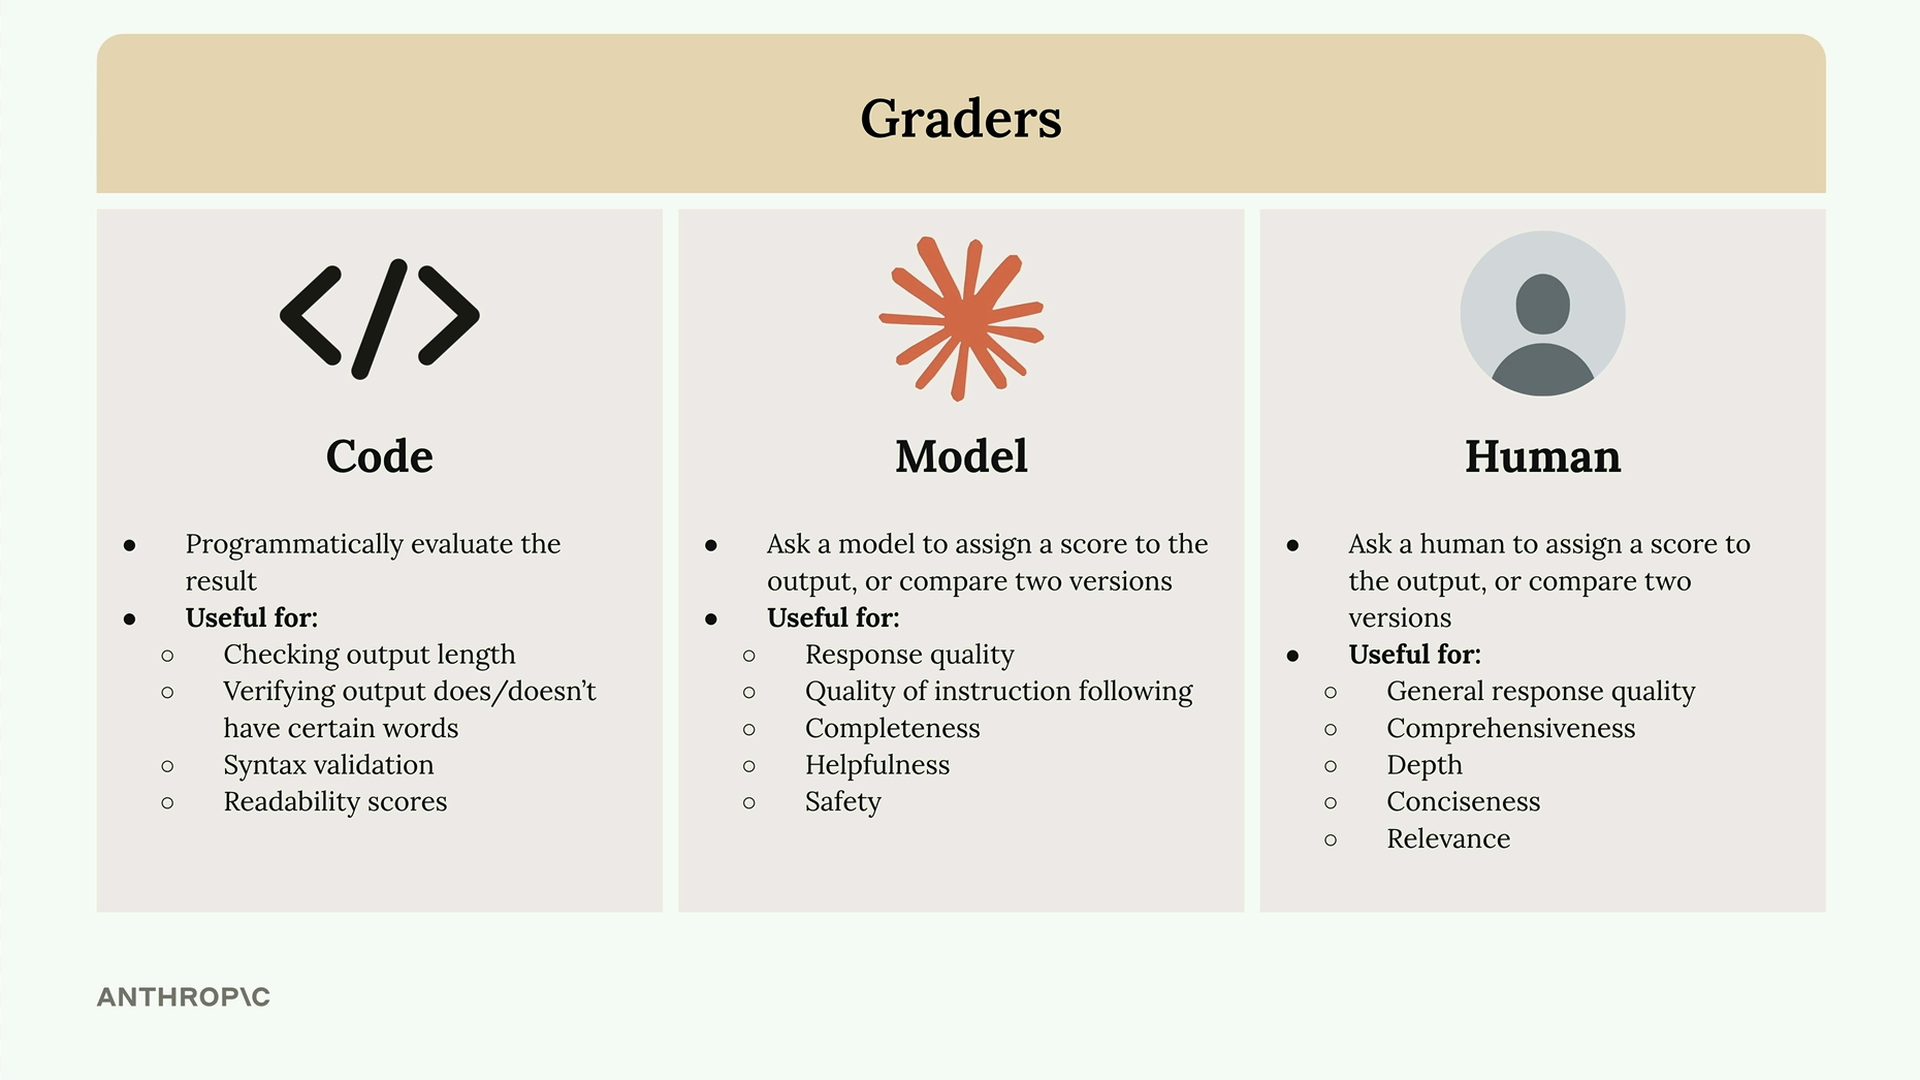
Il existe trois approches principales pour évaluer les sorties des modèles :
- Évaluateurs par code - Évaluent les sorties de manière programmatique à l'aide de code personnalisé
- Évaluateurs par modèle - Utilisent un autre modèle d'IA pour évaluer la qualité
- Évaluateurs humains - Font appel à des personnes pour examiner et noter manuellement les sorties
Évaluateurs par code
Les évaluateurs par code vous permettent d'implémenter n'importe quelle vérification programmatique imaginable. Les usages courants incluent :
- Vérifier la longueur de la sortie
- Vérifier que la sortie contient ou ne contient pas certains mots
- Validation de la syntaxe pour JSON, Python ou les expressions régulières
- Scores de lisibilité pour garantir des niveaux de lecture appropriés
Évaluateurs par modèle
Les évaluateurs par modèle offrent une flexibilité considérable en utilisant un appel API supplémentaire pour évaluer les sorties. Ils sont utiles pour évaluer :
- La qualité de la réponse
- La qualité du respect des instructions
- L'exhaustivité
- L'utilité
- La sécurité
Évaluateurs humains
Les évaluateurs humains offrent la plus grande flexibilité mais présentent des inconvénients importants. Bien que les humains puissent évaluer les réponses selon n'importe quel critère imaginable, le processus est chronophage et fastidieux.
Définir les critères d'évaluation
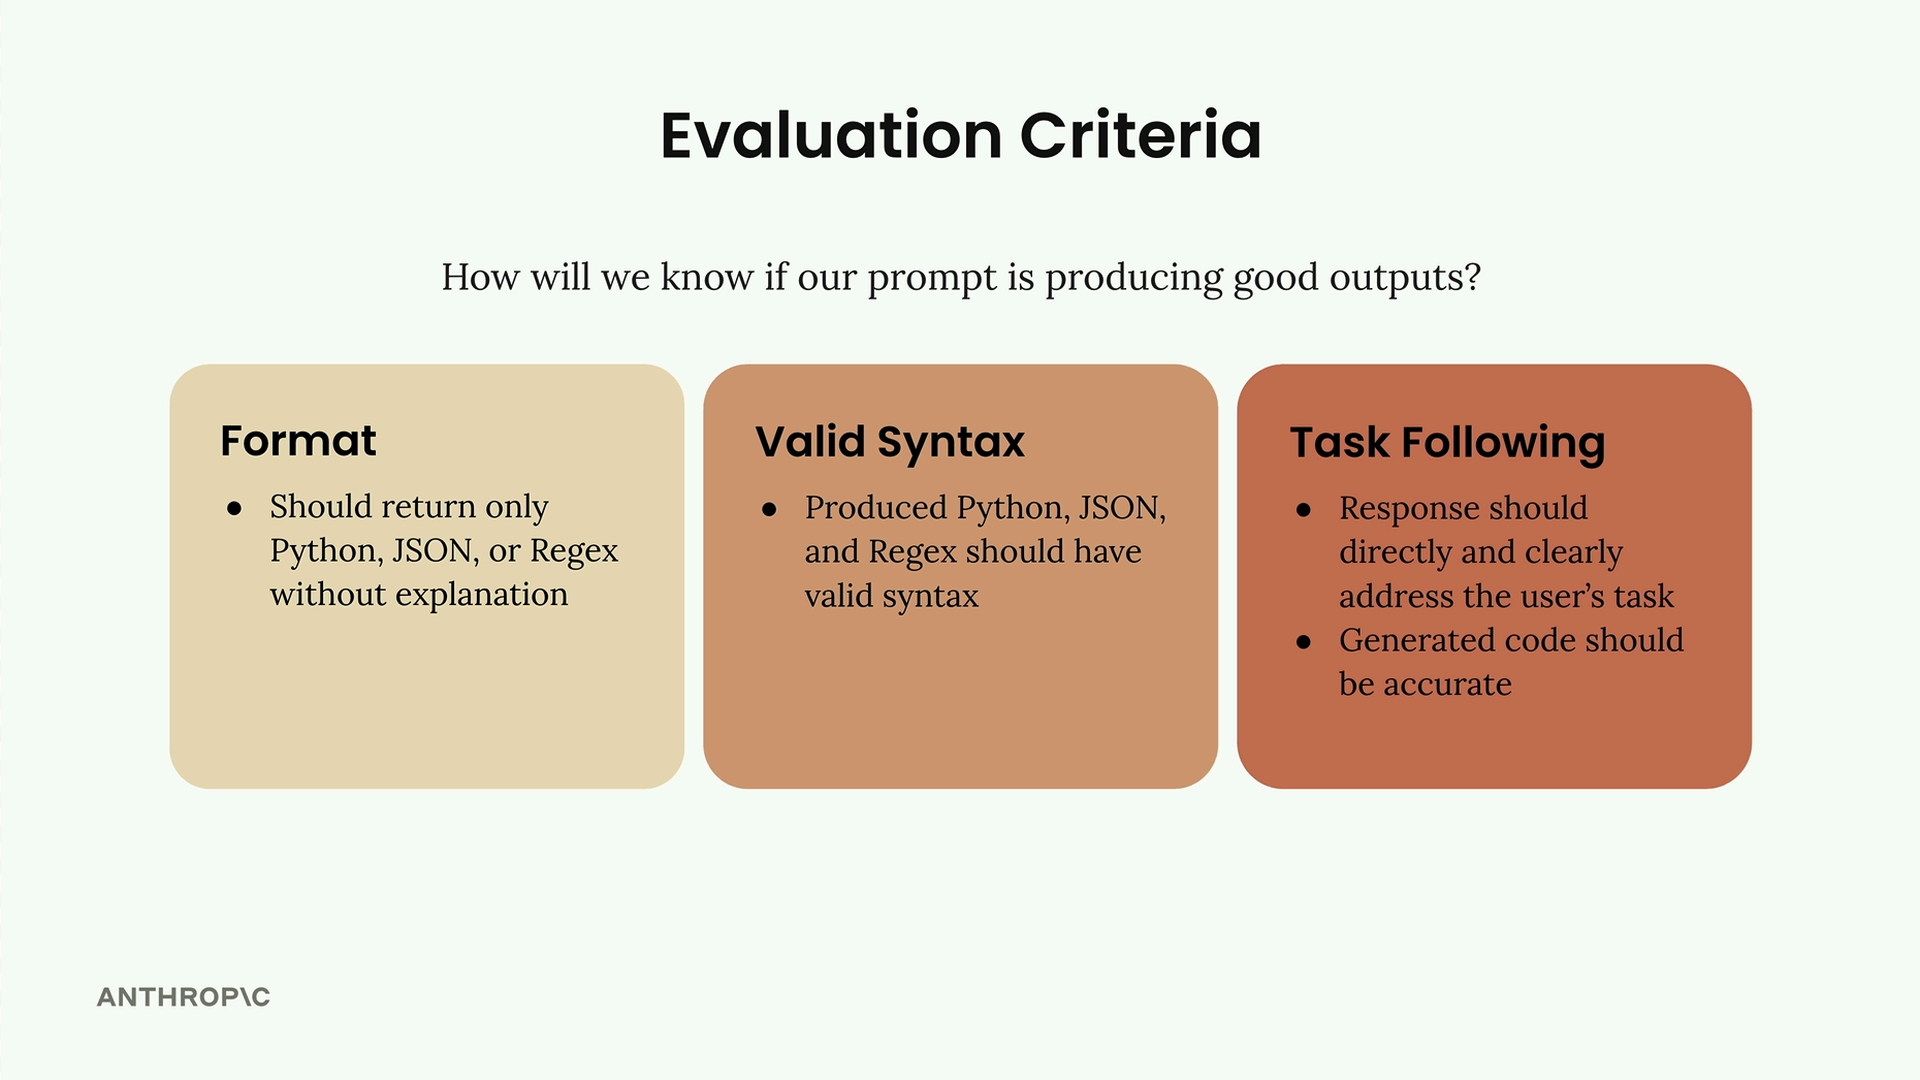
Avant d'implémenter un évaluateur, vous devez disposer de critères d'évaluation clairs. Pour une invite de génération de code, vous pourriez vous concentrer sur :
- Format - Ne devrait renvoyer que du Python, du JSON ou une expression régulière sans explication
- Syntaxe valide - Le code produit doit avoir une syntaxe valide
- Respect de la tâche - La réponse doit répondre directement à la tâche de l'utilisateur avec un code précis
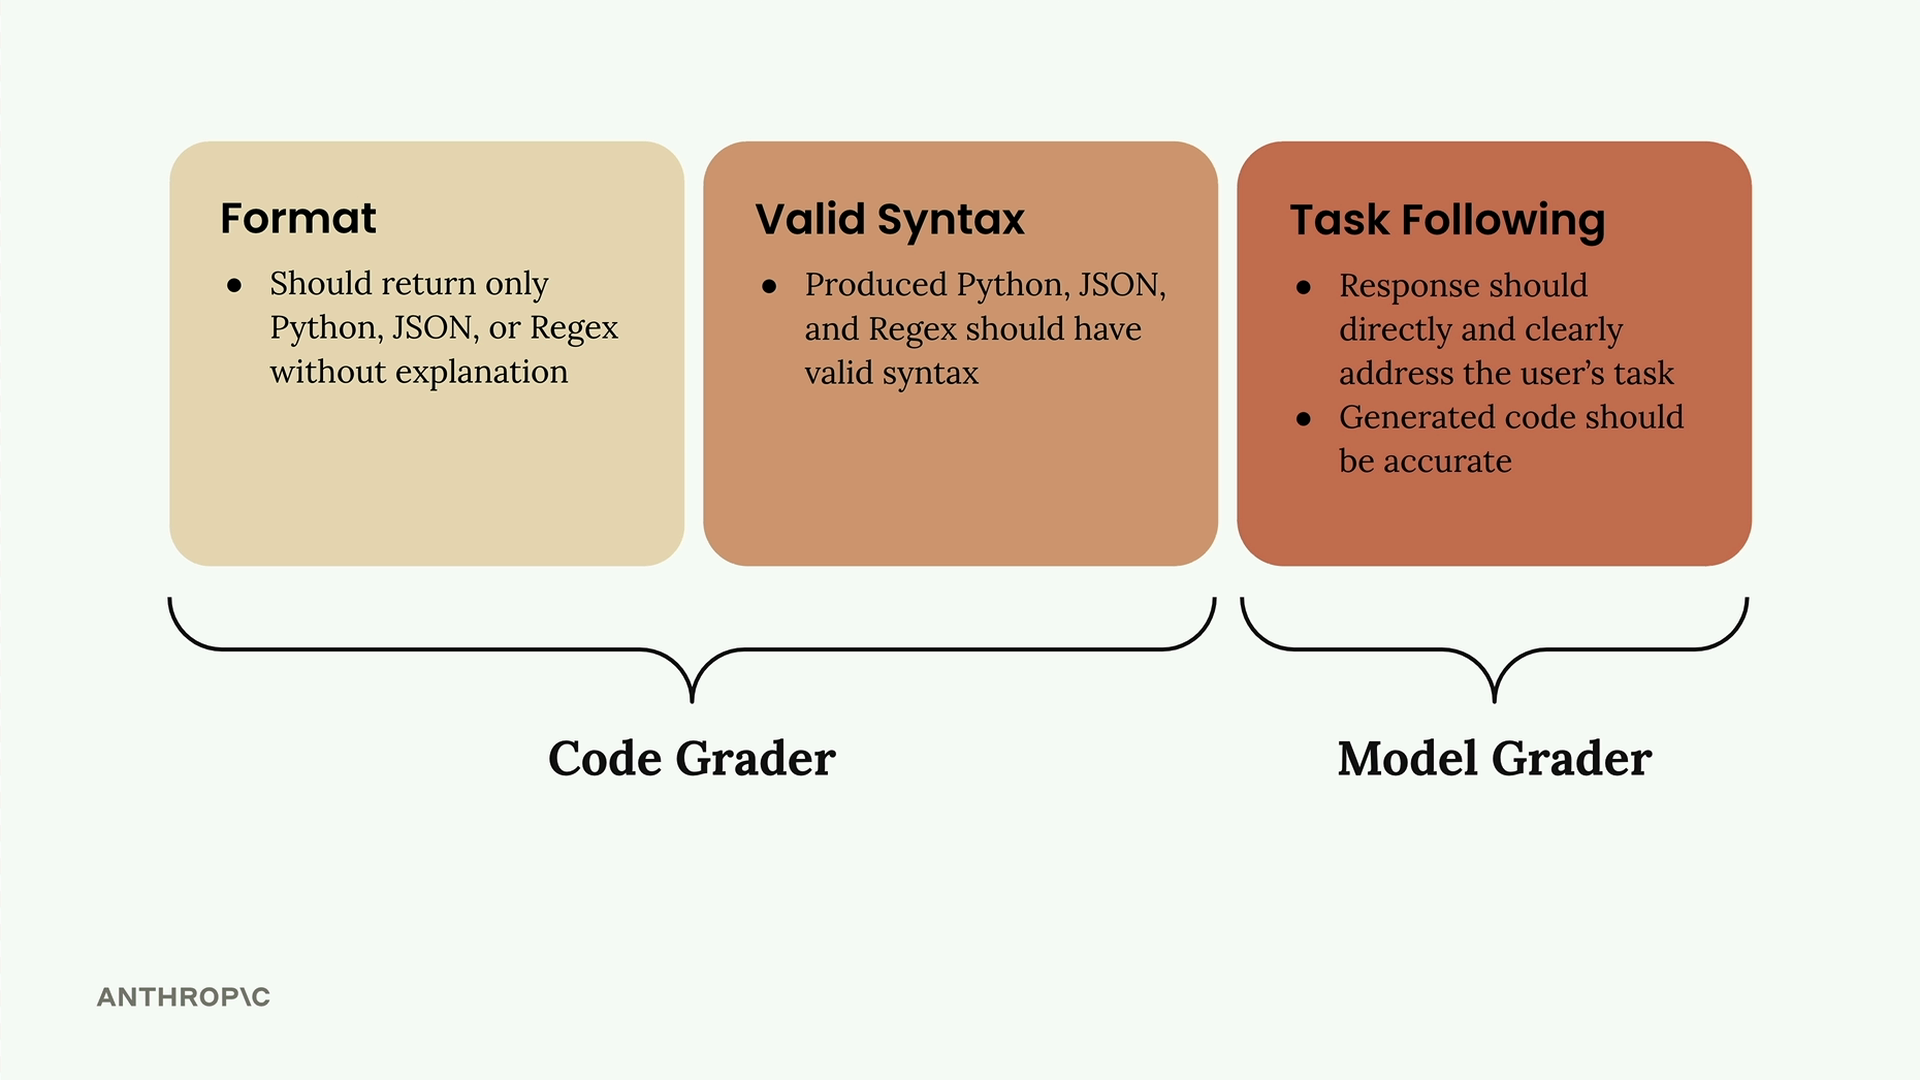
Les deux premiers critères fonctionnent bien avec les évaluateurs par code, tandis que le respect de la tâche est mieux adapté aux évaluateurs par modèle en raison de leur flexibilité.
Implémenter un évaluateur par modèle
Les évaluateurs par modèle sont souvent les plus faciles à implémenter. Voici une structure de base :
def grade_by_model(test_case, output):
    messages = []
    add_user_message(messages, eval_prompt)
    add_assistant_message(messages, "```json")
    eval_text = chat(messages, stop_sequences=["```"])
    return json.loads(eval_text)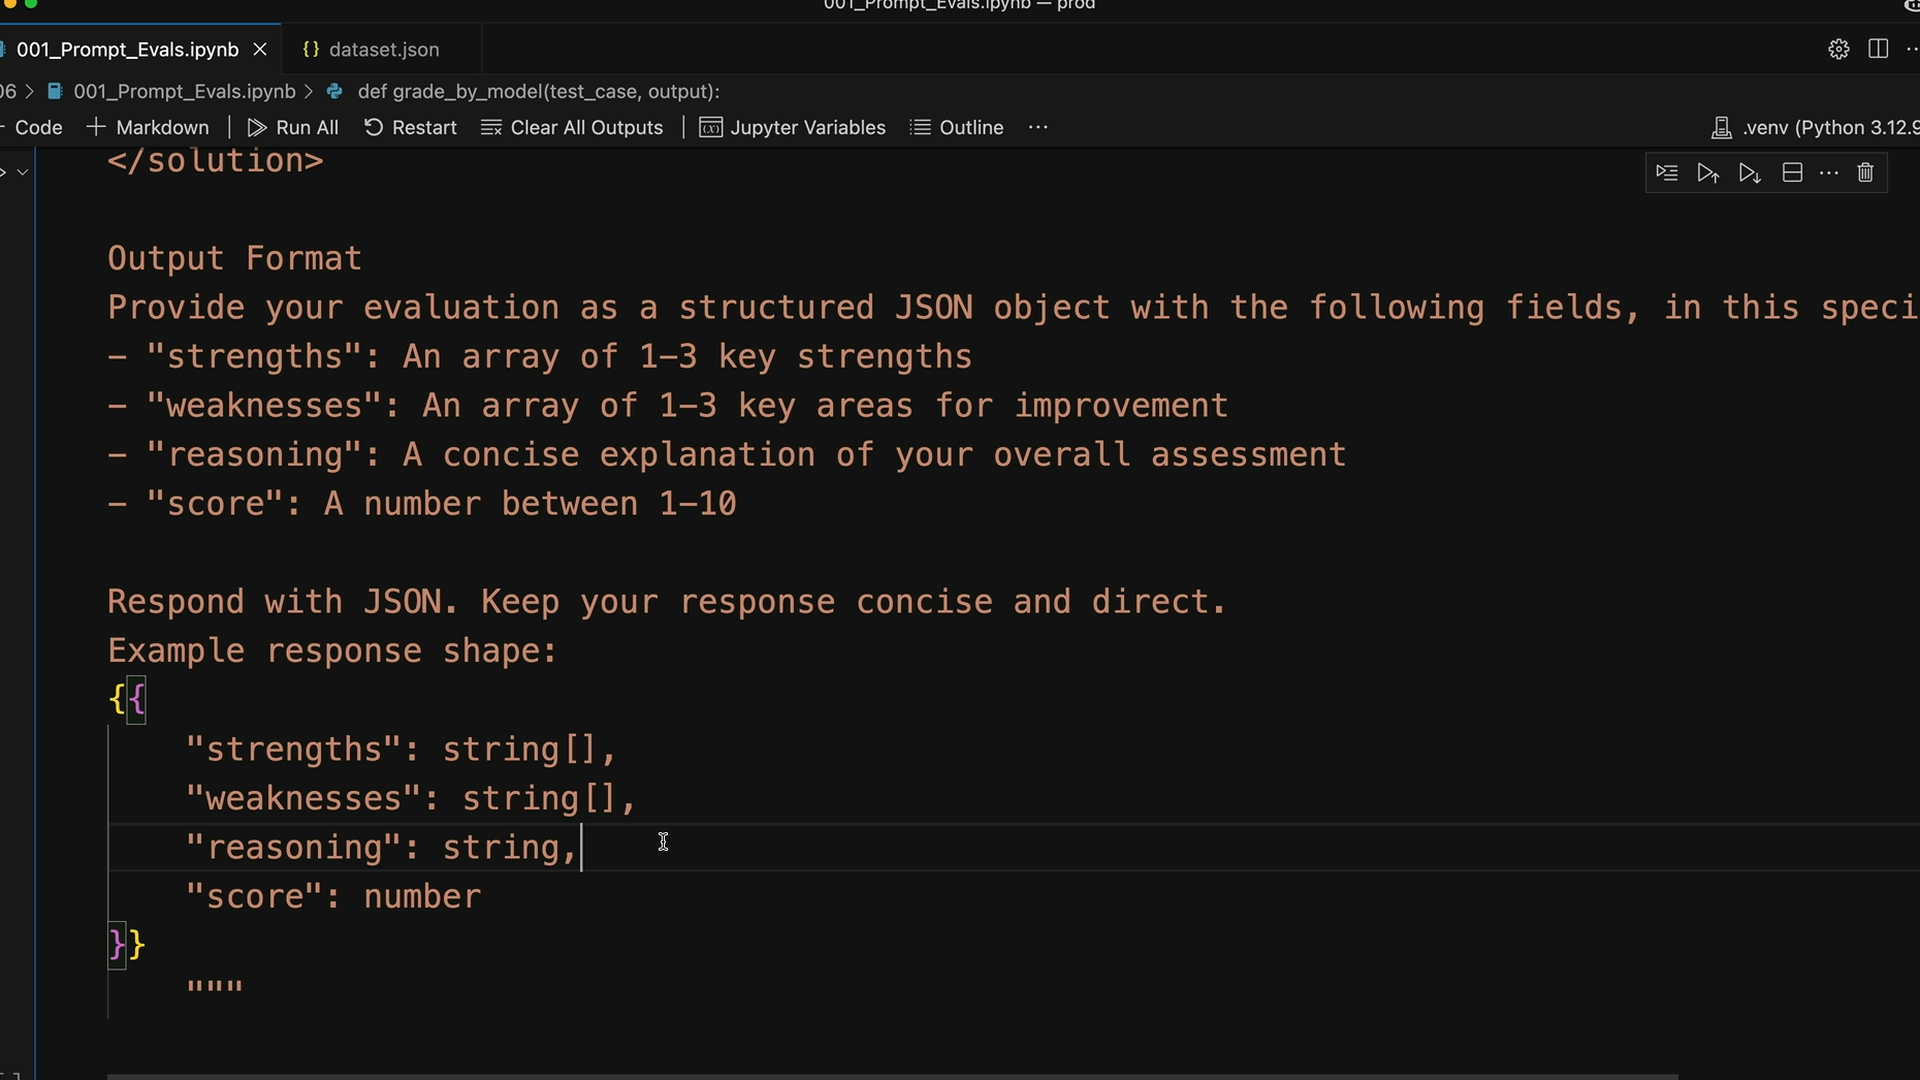
L'invite d'évaluation doit être complète et inclure :
- Une définition claire du rôle de l'évaluateur
- La tâche originale
- La solution générée par l'IA à évaluer
- Des exigences spécifiques de format de sortie
Demandez plus qu'un simple score. Demandez les points forts, les points faibles et le raisonnement en plus du score numérique. Cela empêche le modèle de se contenter de scores médiocres comme 6 et force une évaluation plus réfléchie.
Intégrer les évaluateurs dans votre workflow
Une fois que vous disposez d'une fonction d'évaluation, intégrez-la dans votre exécuteur de cas de test :
def run_test_case(test_case):
    output = run_prompt(test_case)

    # Appeler l'évaluateur du modèle
    model_grade = grade_by_model(test_case, output)
    score = model_grade["score"]
    reasoning = model_grade["reasoning"]

    return {
        "output": output,
        "test_case": test_case,
        "score": score,
        "reasoning": reasoning
    }
Après avoir exécuté tous les cas de test, calculez un score moyen pour obtenir une métrique objective de la performance de votre invite :
from statistics import mean

def run_eval(dataset):
    results = []
    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    average_score = mean([result["score"] for result in results])
    print(f"Average score: {average_score}")

    return results
Cela vous donne un chiffre concret sur lequel vous concentrer pour l'amélioration. Bien que les évaluateurs par modèle puissent être quelque peu capricieux et pourraient bénéficier de meilleures directives, ils offrent un point de départ pour une évaluation objective que vous pouvez itérer et améliorer.