Lorsque vous disposez à la fois d'une recherche sémantique (embeddings vectoriels) et d'une recherche lexicale (BM25) fonctionnant indépendamment, l'étape suivante consiste à les combiner en un pipeline de recherche unifié. Cette approche hybride exploite les forces des deux méthodes pour fournir des résultats plus précis.
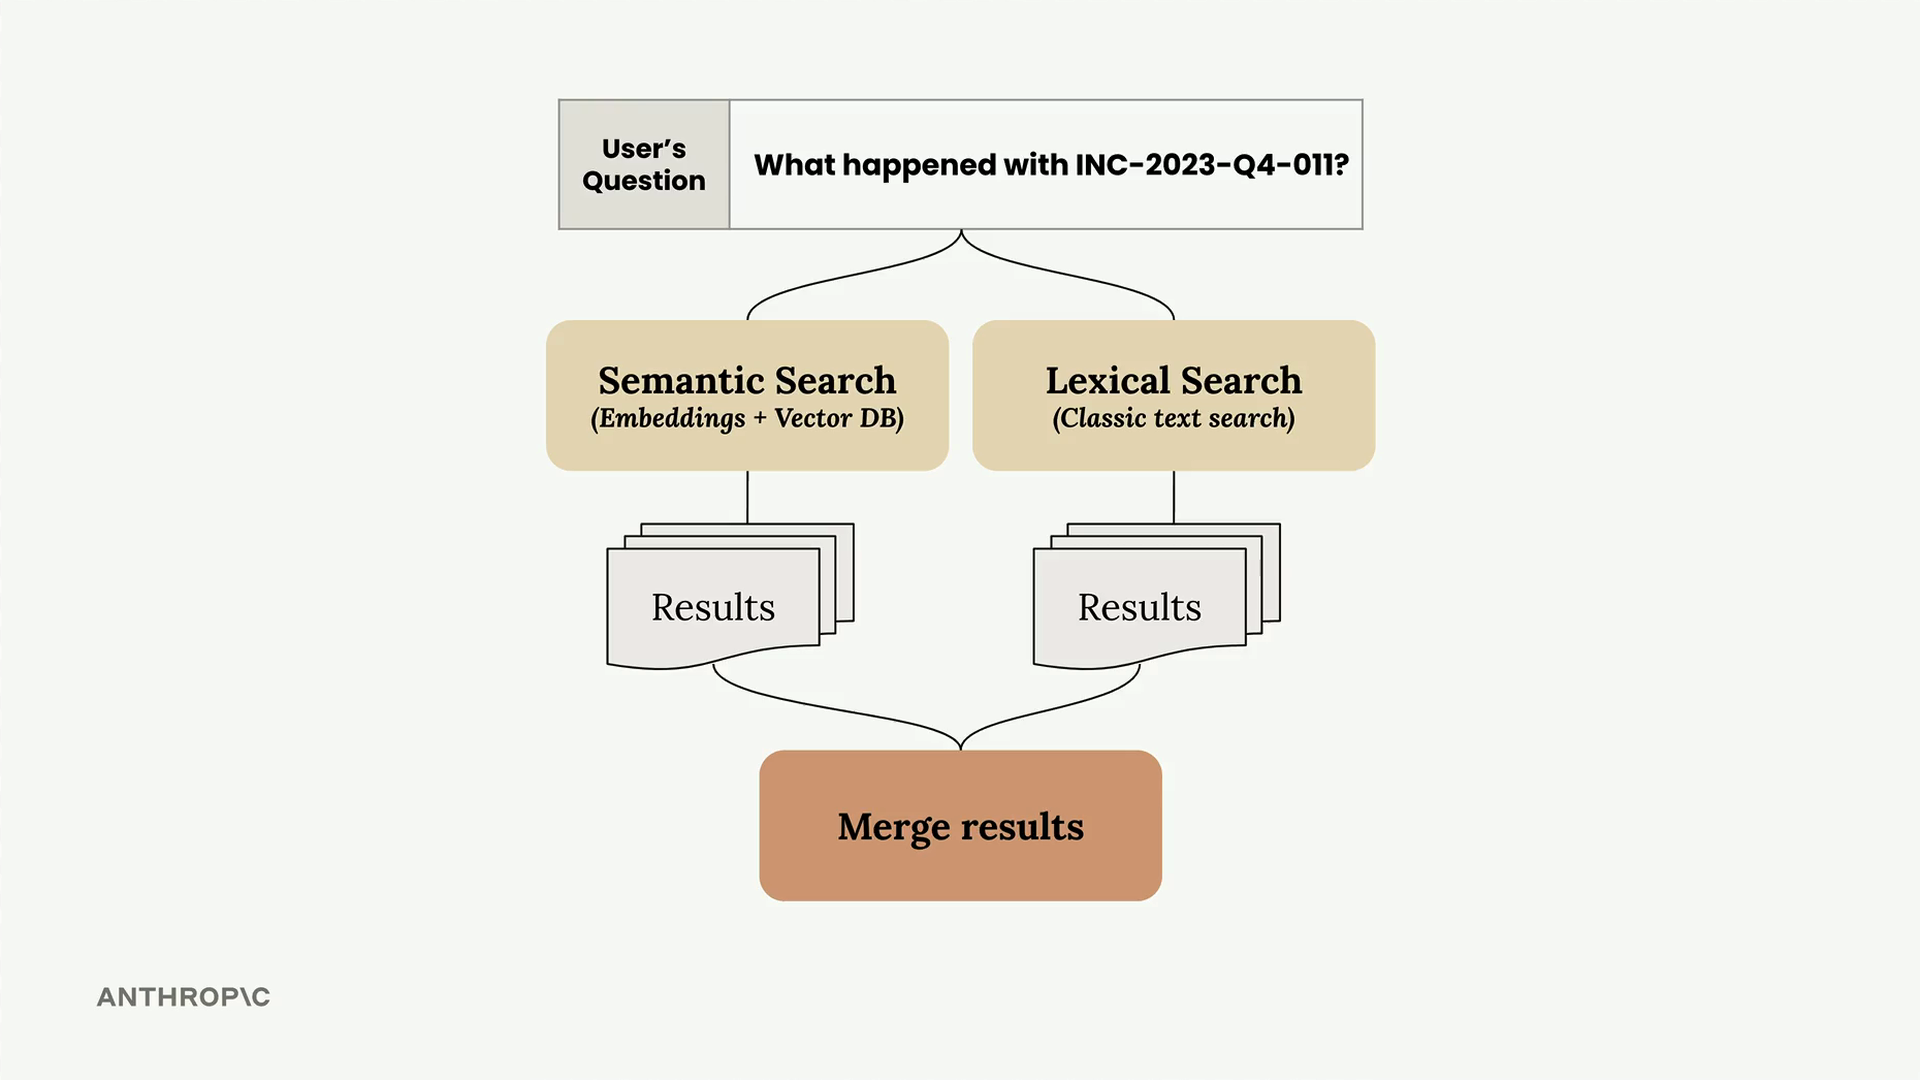
Création d'une interface unifiée
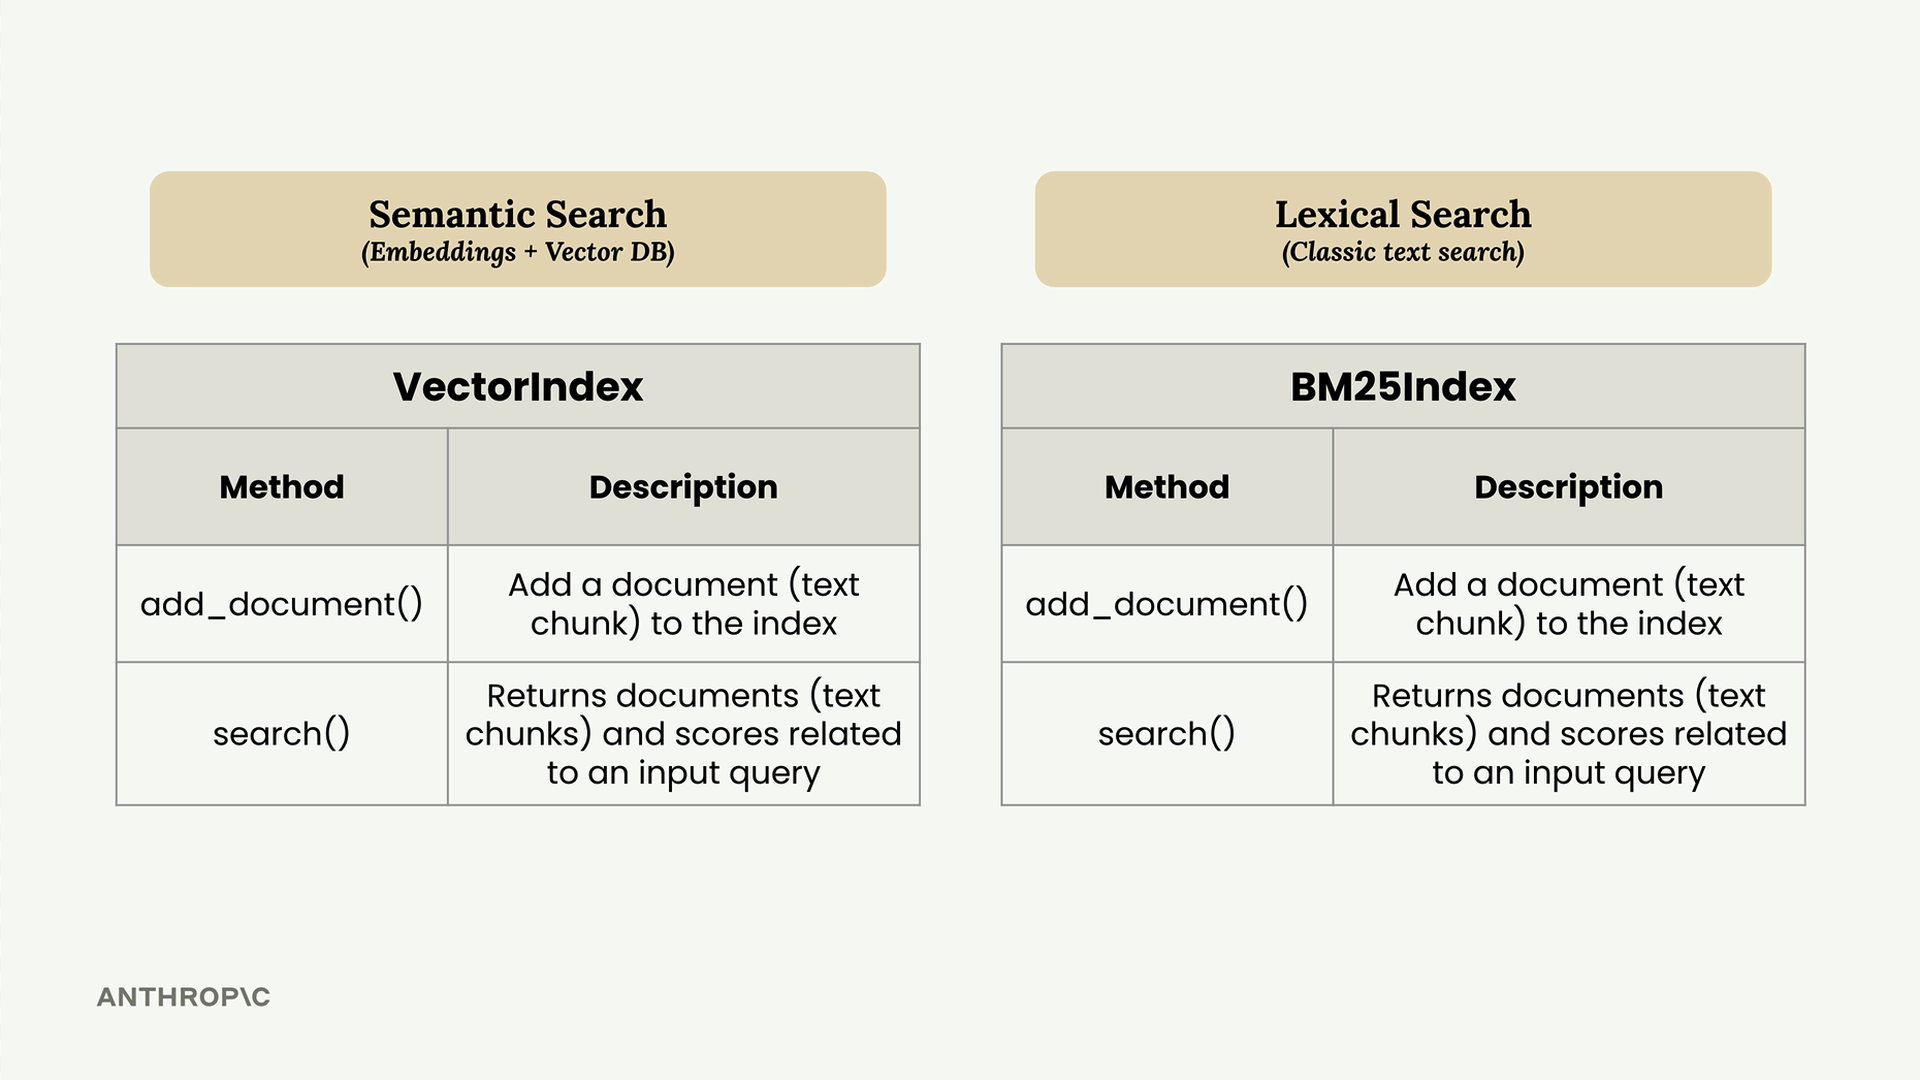
Les deux implémentations de recherche partagent des API presque identiques - elles disposent toutes deux de méthodes add_document() et search() qui fonctionnent de la même manière. Cette cohérence facilite leur encapsulation dans une seule classe Retriever.
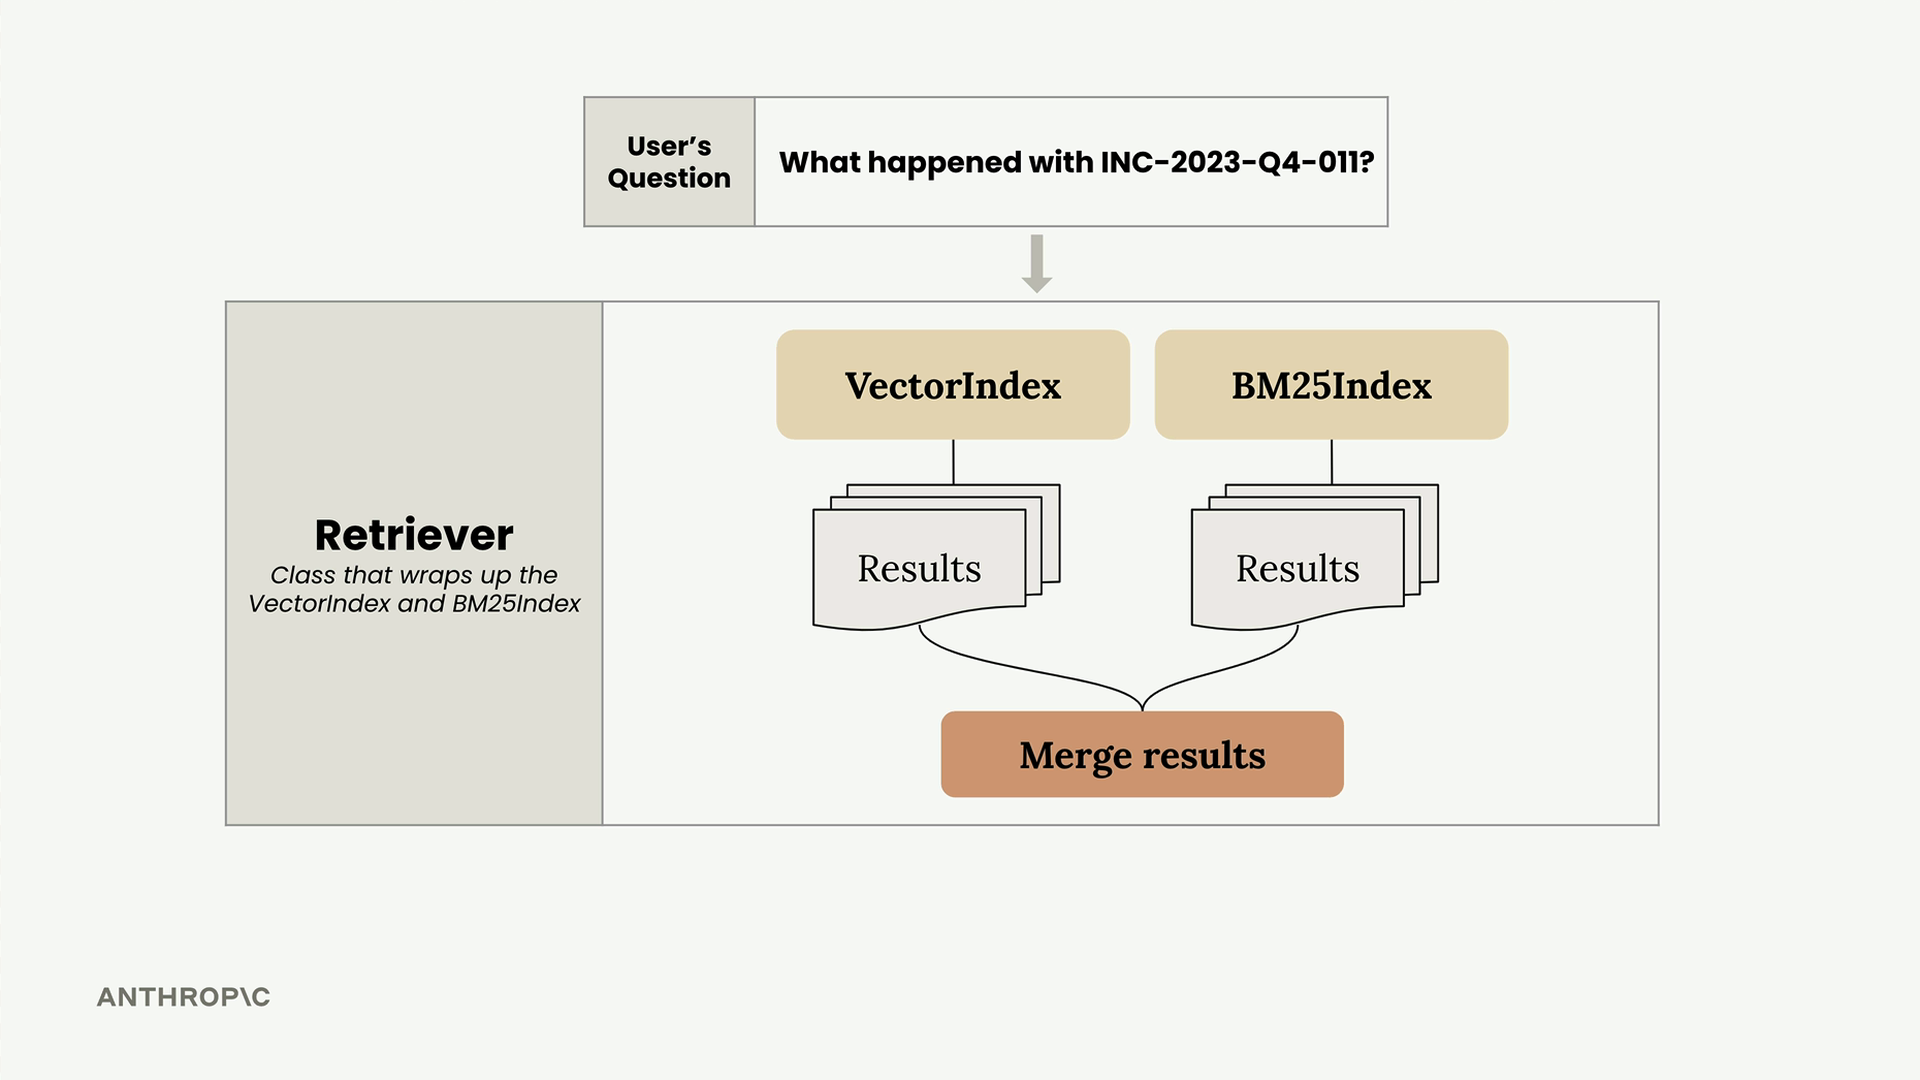
Le Retriever agit comme un coordinateur qui transmet les requêtes des utilisateurs aux deux index, collecte leurs résultats, et les fusionne en une seule liste classée.
Reciprocal Rank Fusion
Le défi consiste à fusionner des résultats provenant de différentes méthodes de recherche qui utilisent des systèmes de notation différents. La recherche vectorielle renvoie des scores de similarité cosinus, tandis que BM25 renvoie des scores de pertinence - vous ne pouvez pas simplement combiner ces chiffres directement.
À la place, nous utilisons une technique appelée Reciprocal Rank Fusion (RRF). Cette méthode se concentre sur la position de rang des résultats plutôt que sur leurs scores bruts.
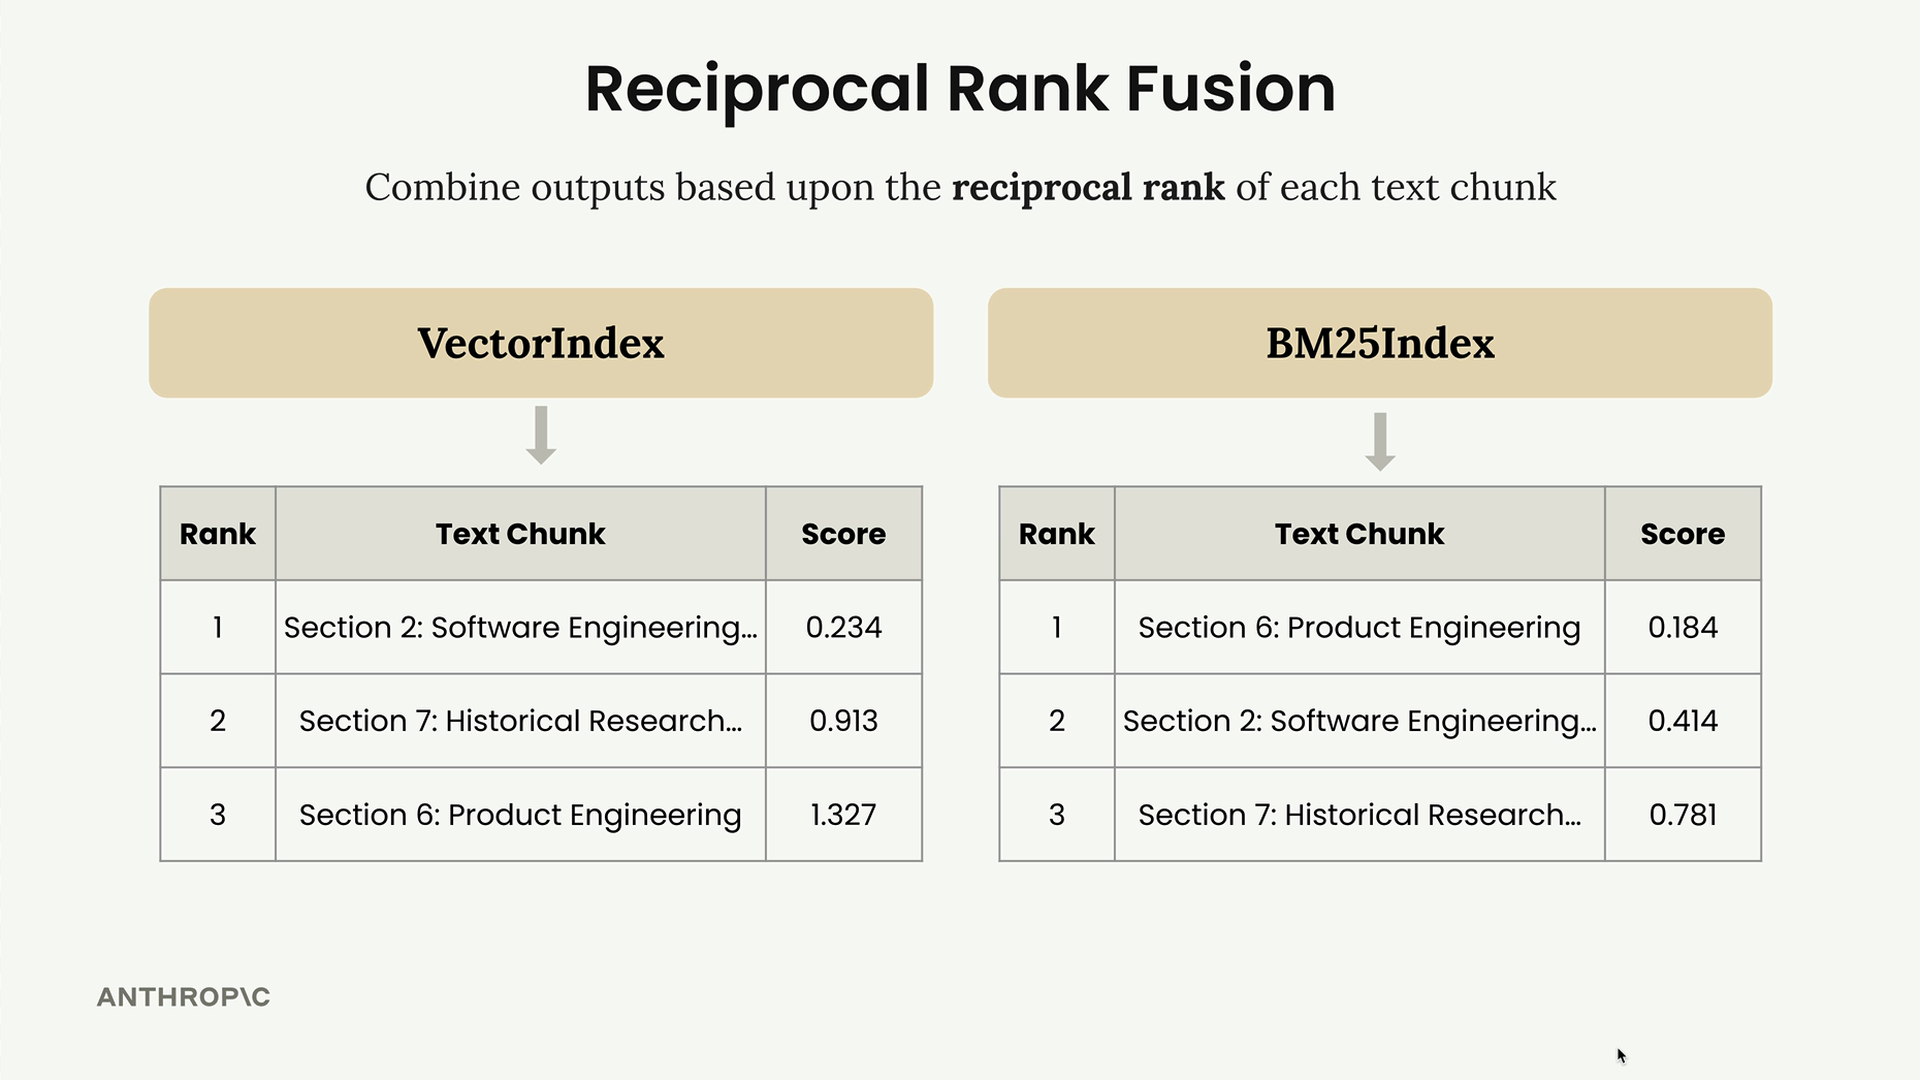
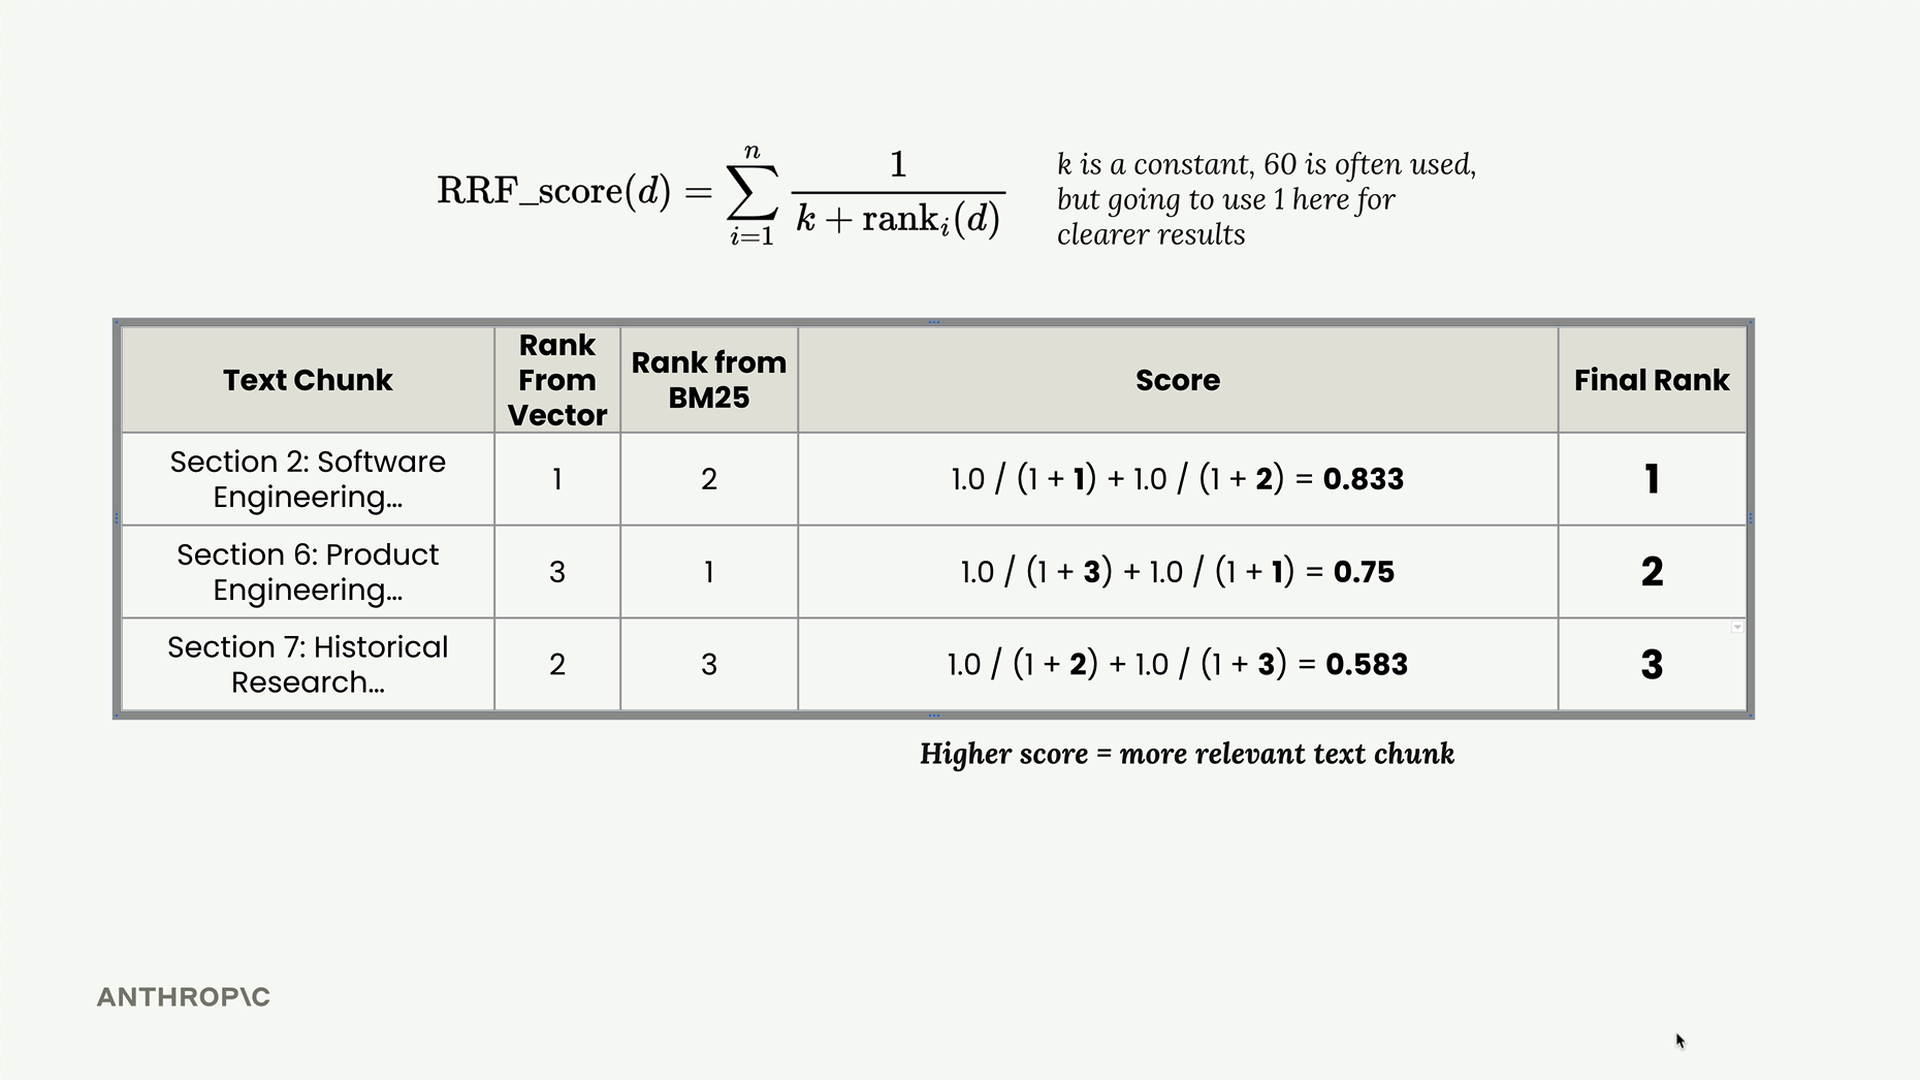
Voici comment cela fonctionne avec un exemple. Supposons que votre recherche vectorielle renvoie les sections 2, 7 et 6 dans cet ordre, tandis que BM25 renvoie les sections 6, 2 et 7. Pour fusionner ces résultats :
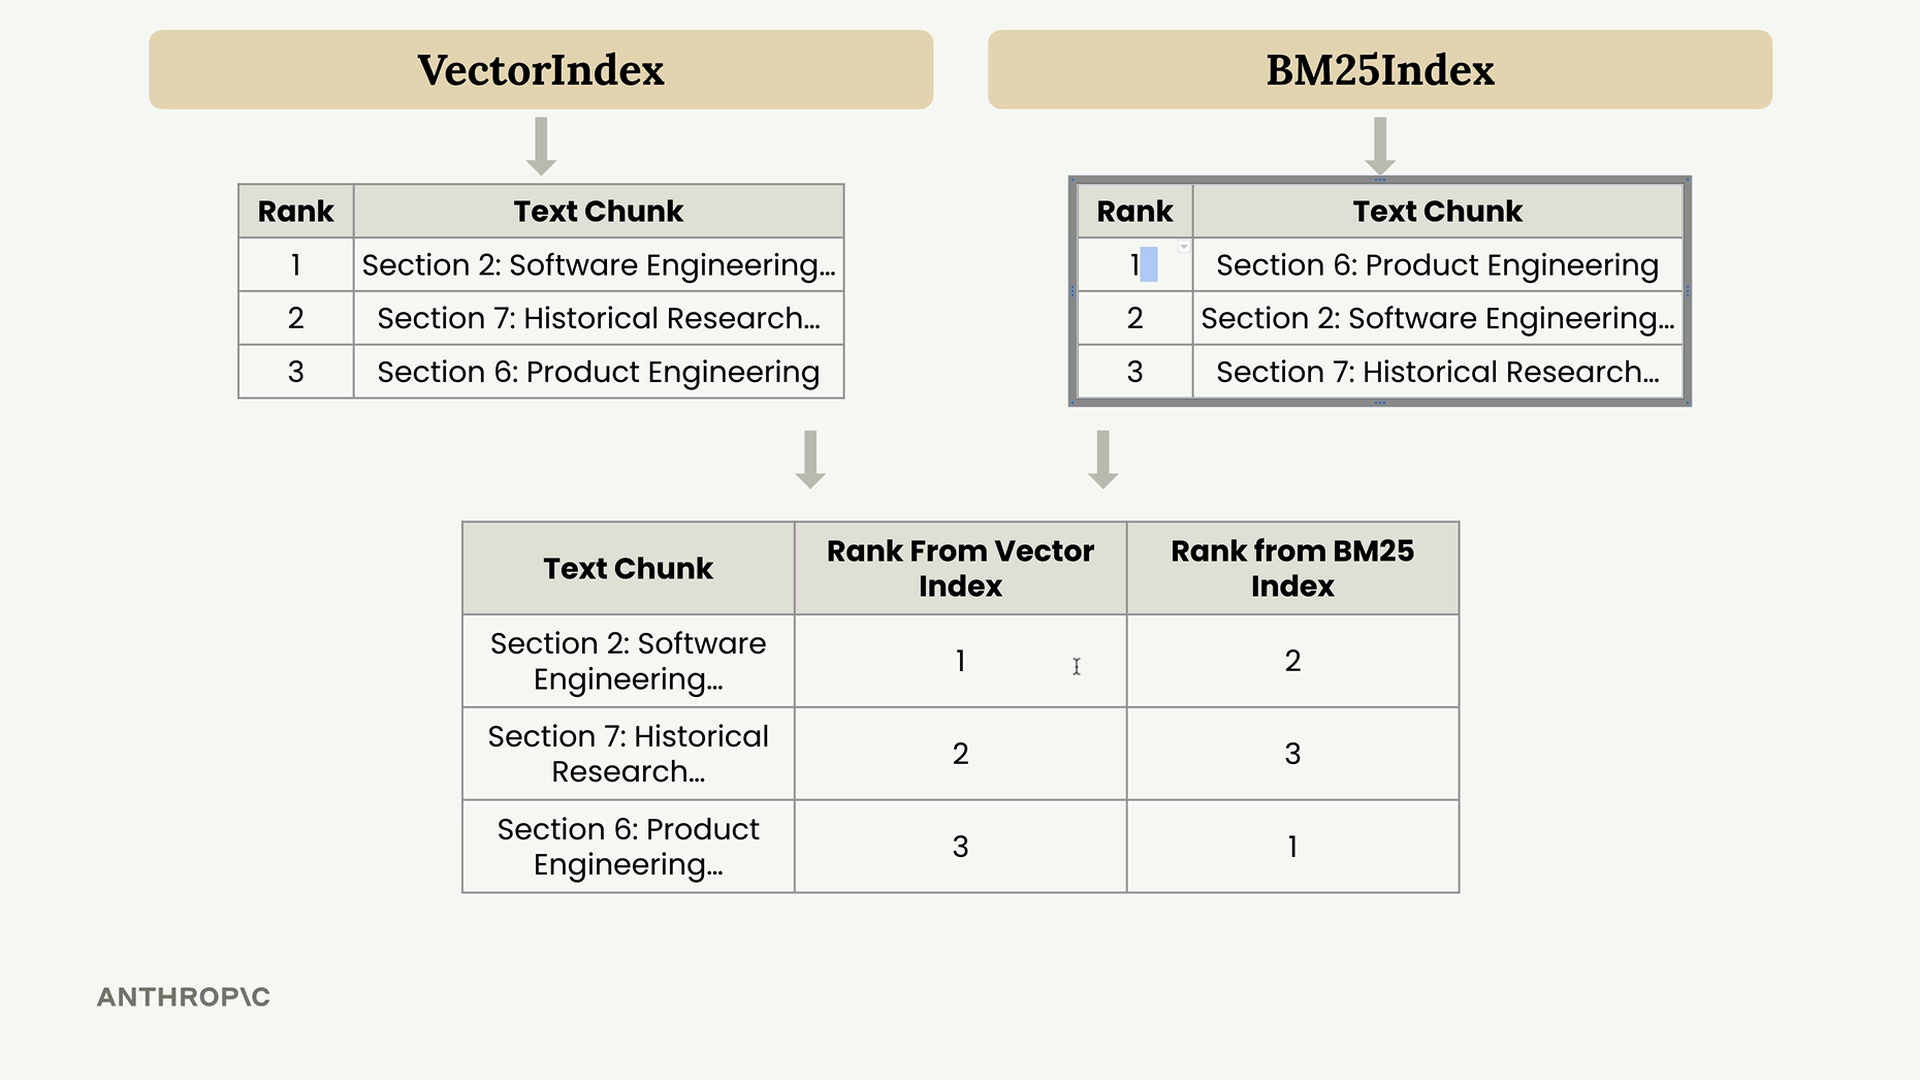
D'abord, créez un tableau montrant chaque fragment de texte et son rang selon les deux méthodes de recherche :
- Section 2 : Rang 1 depuis le vecteur, rang 2 depuis BM25
- Section 7 : Rang 2 depuis le vecteur, rang 3 depuis BM25
- Section 6 : Rang 3 depuis le vecteur, rang 1 depuis BM25
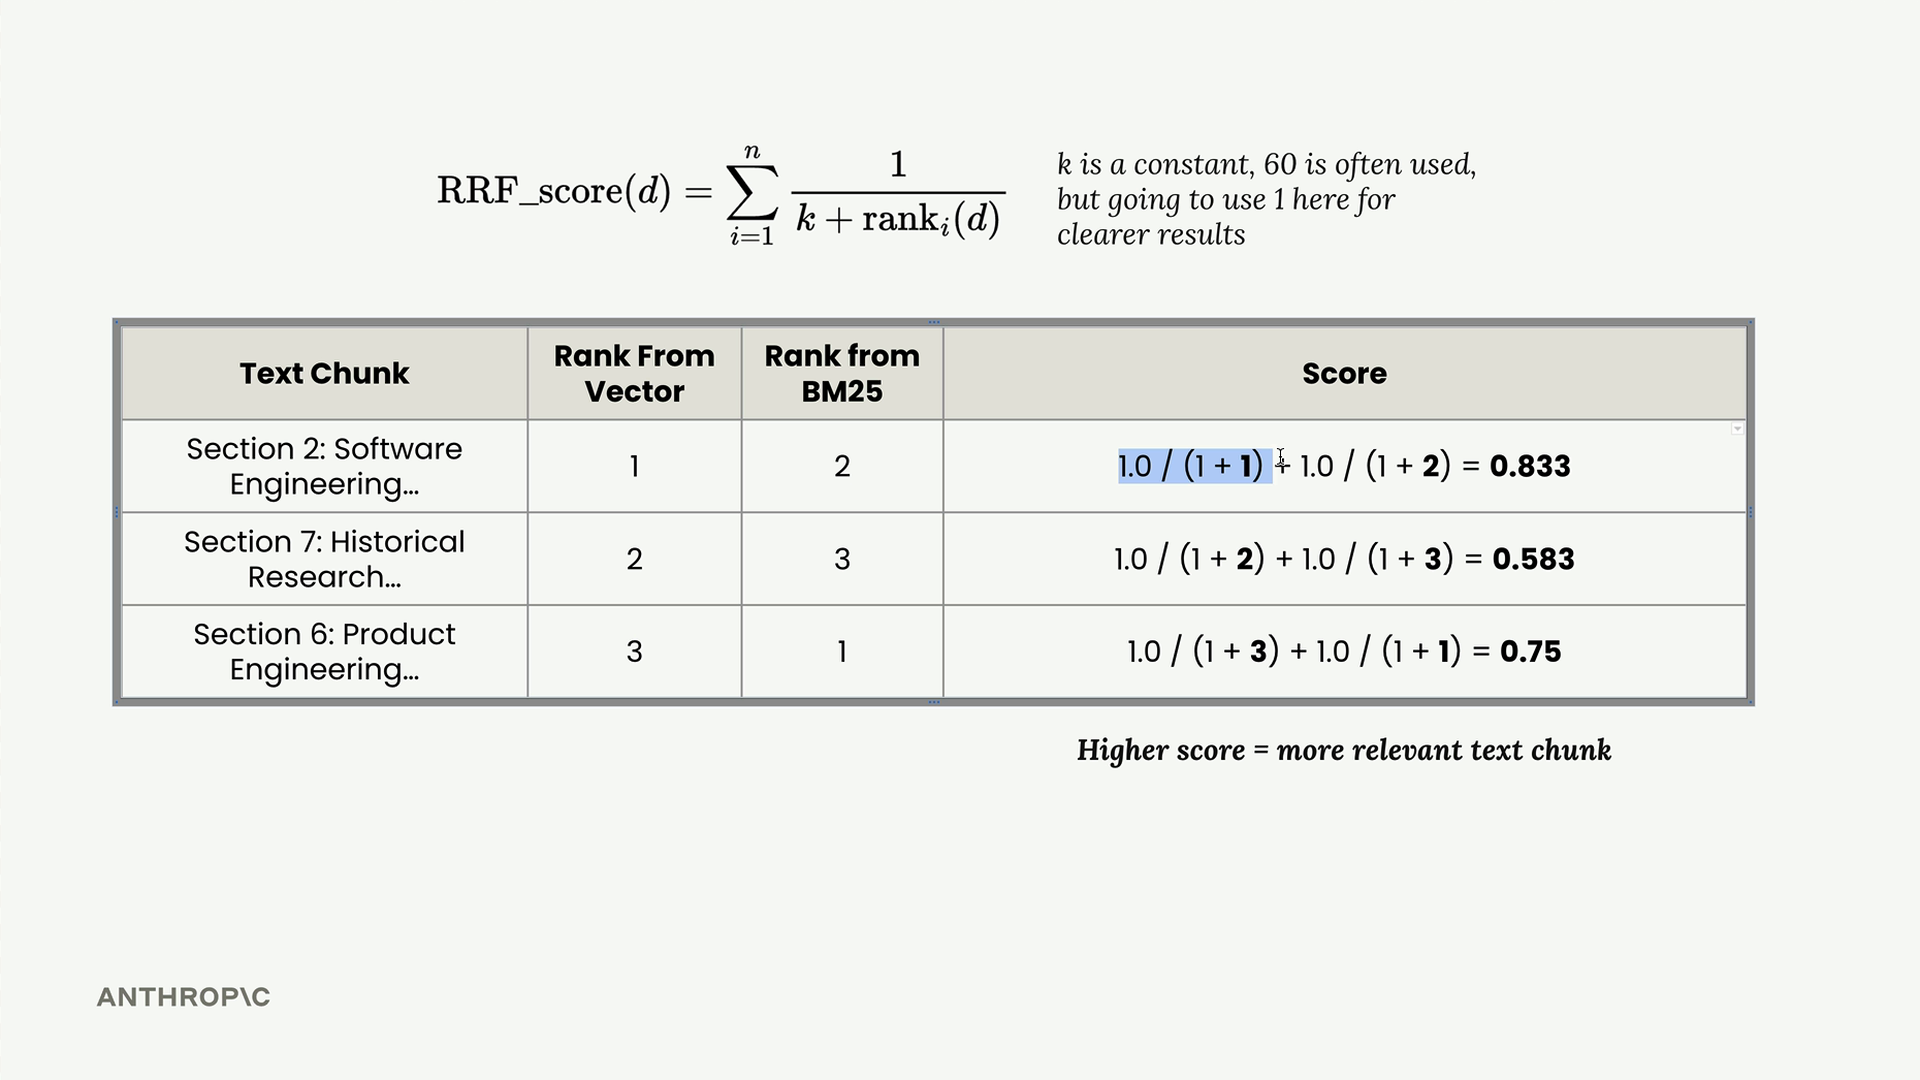
Ensuite, appliquez la formule RRF pour calculer un score combiné pour chaque fragment :
RRF_score(d) = Σ(1 / (k + rank_i(d)))Où k est une constante (généralement 60, mais nous utiliserons 1 pour des résultats plus clairs) et rank_i(d) est le rang du document d dans le i-ème résultat de recherche.
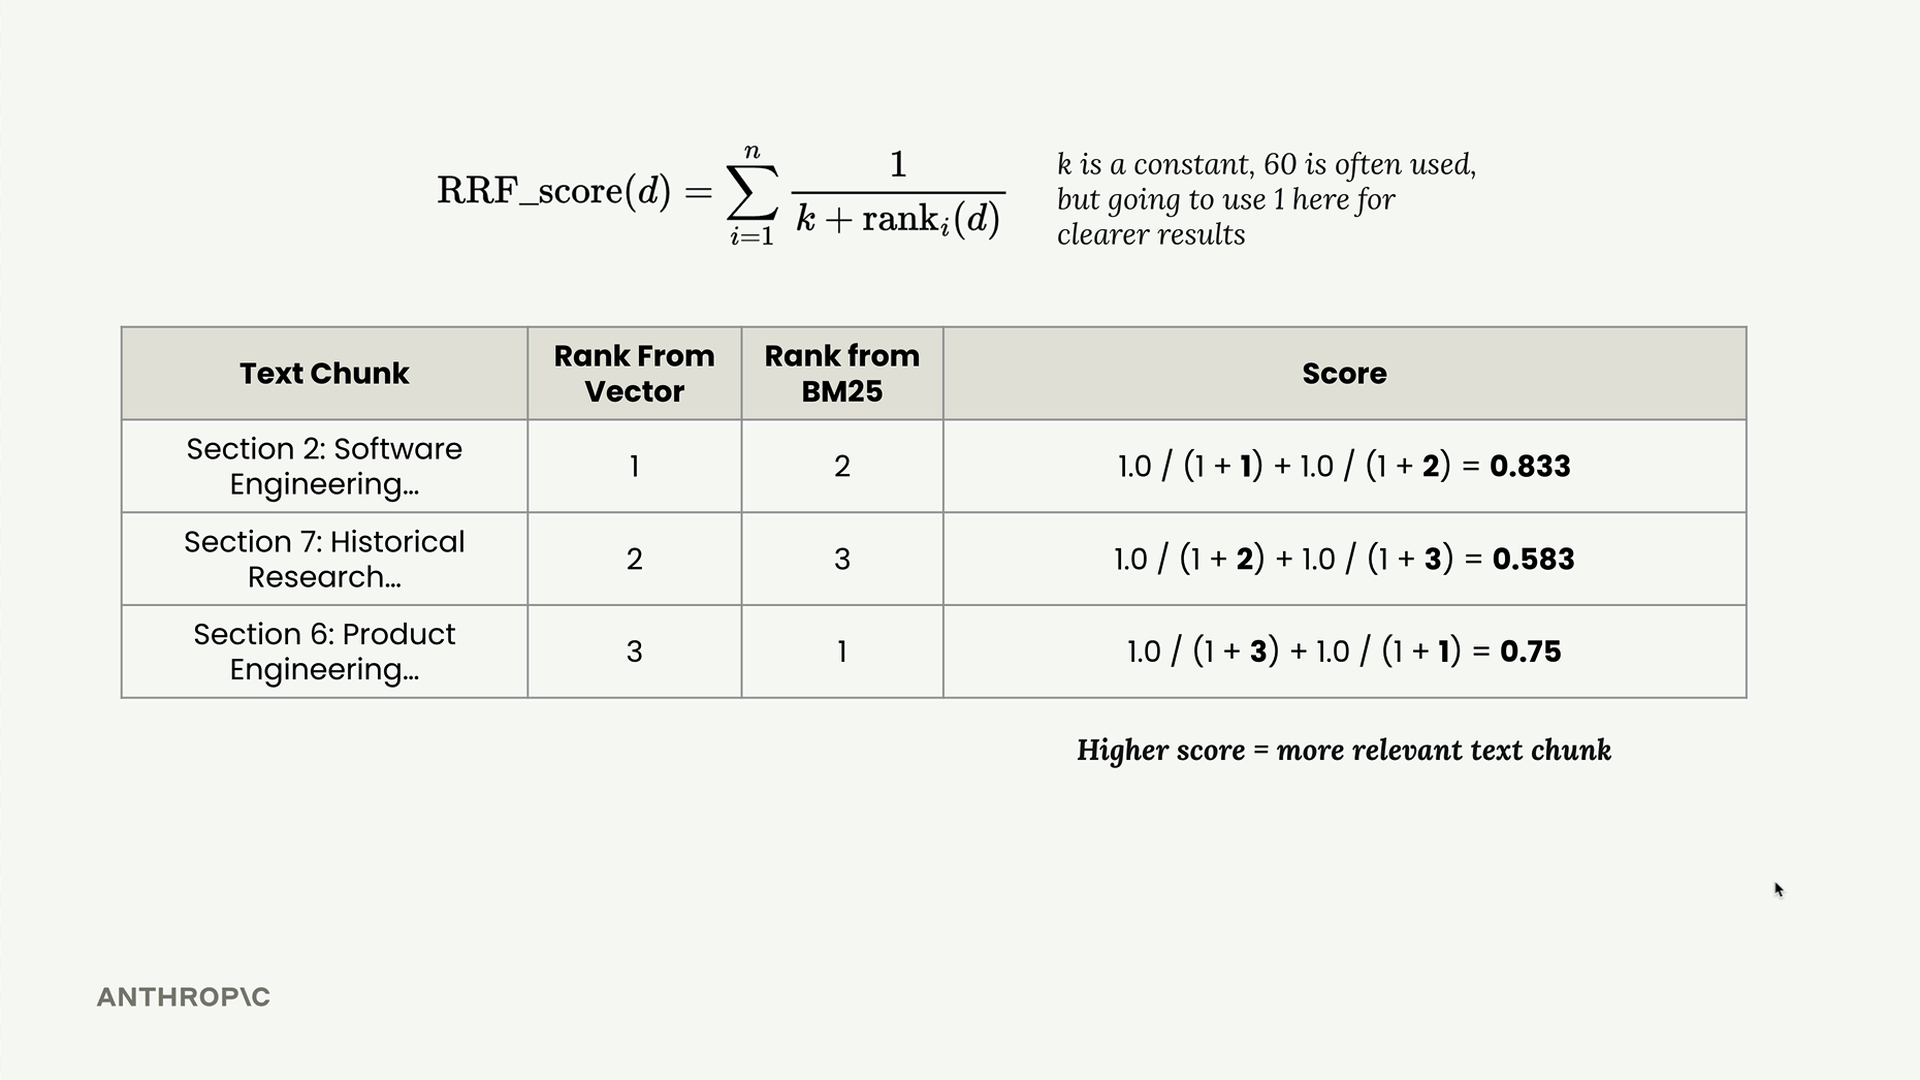
Pour notre exemple :
- Section 2 : 1.0/(1+1) + 1.0/(1+2) = 0.833
- Section 7 : 1.0/(1+2) + 1.0/(1+3) = 0.583
- Section 6 : 1.0/(1+3) + 1.0/(1+1) = 0.75
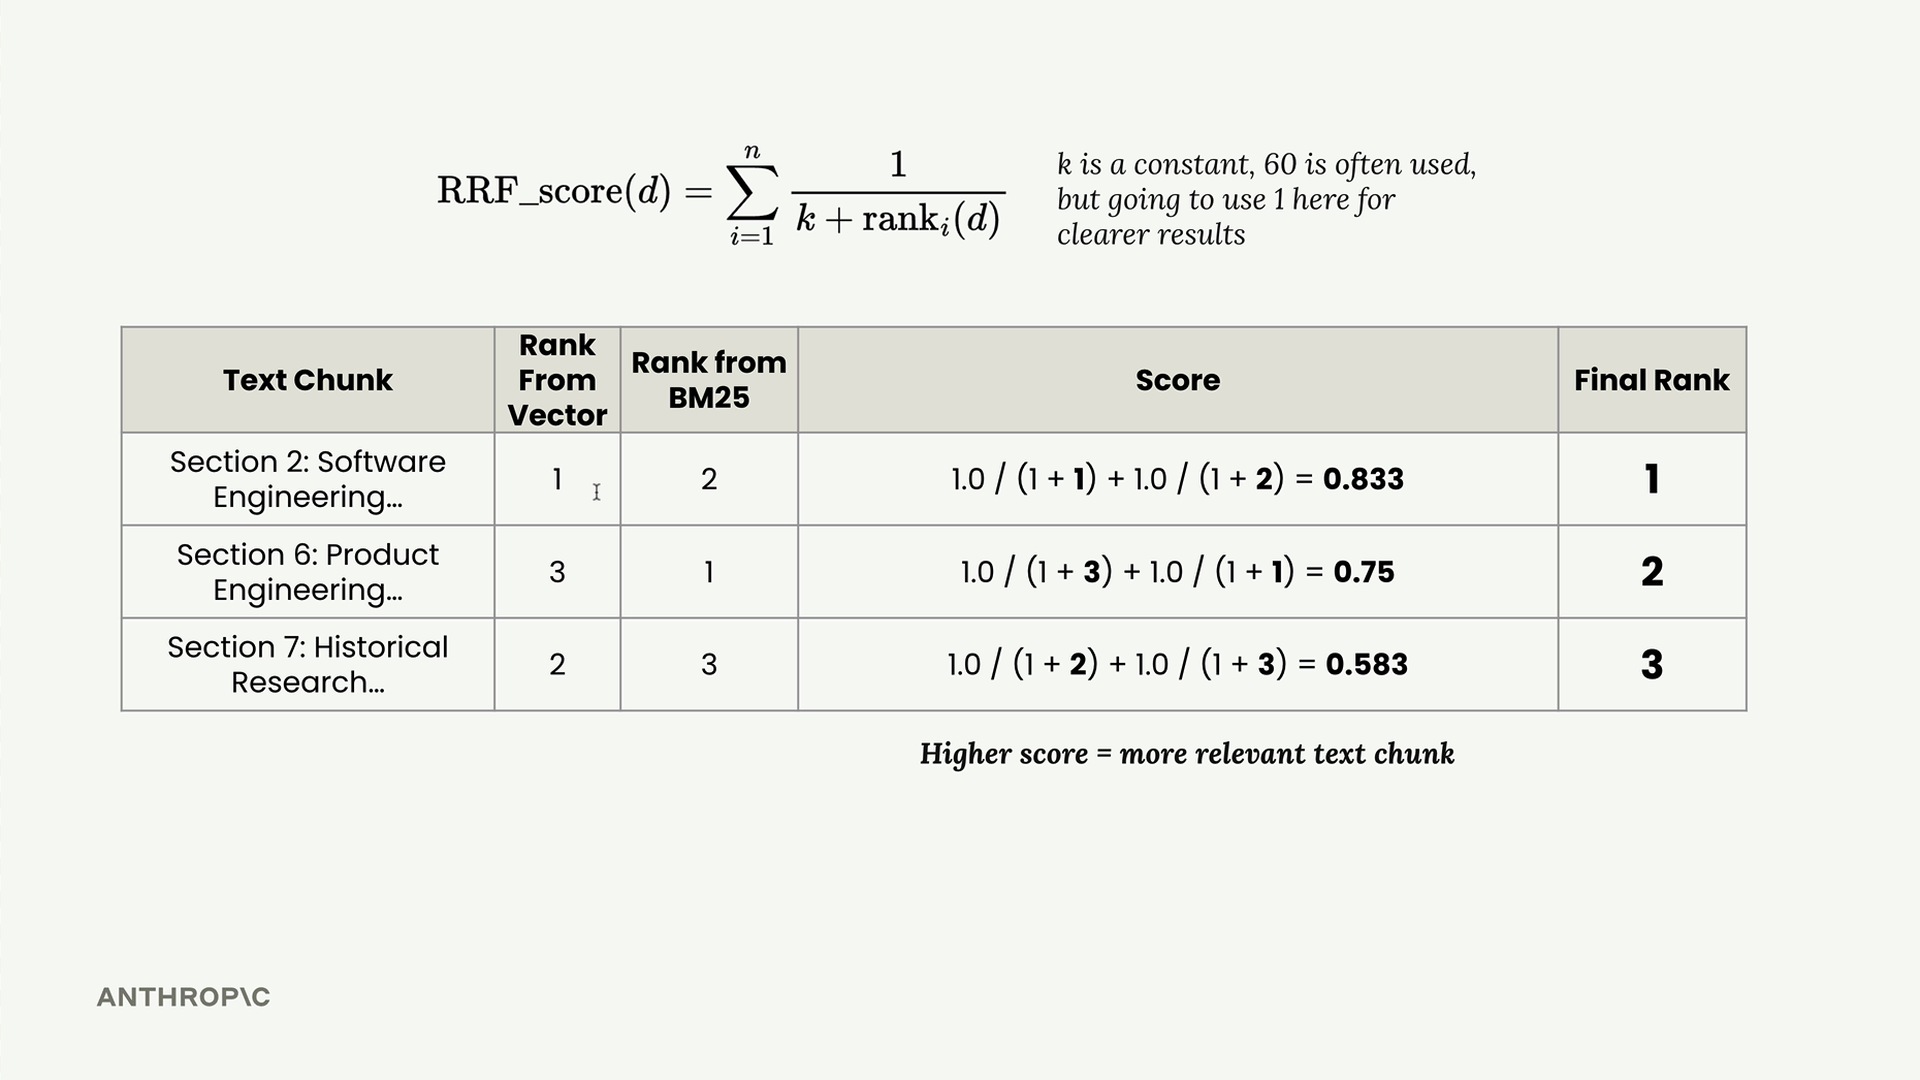
Le classement final devient : Section 2 (0.833), Section 6 (0.75), Section 7 (0.583). Cela a un sens intuitif - la Section 2 a bien performé dans les deux recherches, la Section 6 a obtenu des résultats mitigés, et la Section 7 s'est classée plus bas globalement.
Implémentation
L'implémentation de la classe Retriever est simple :
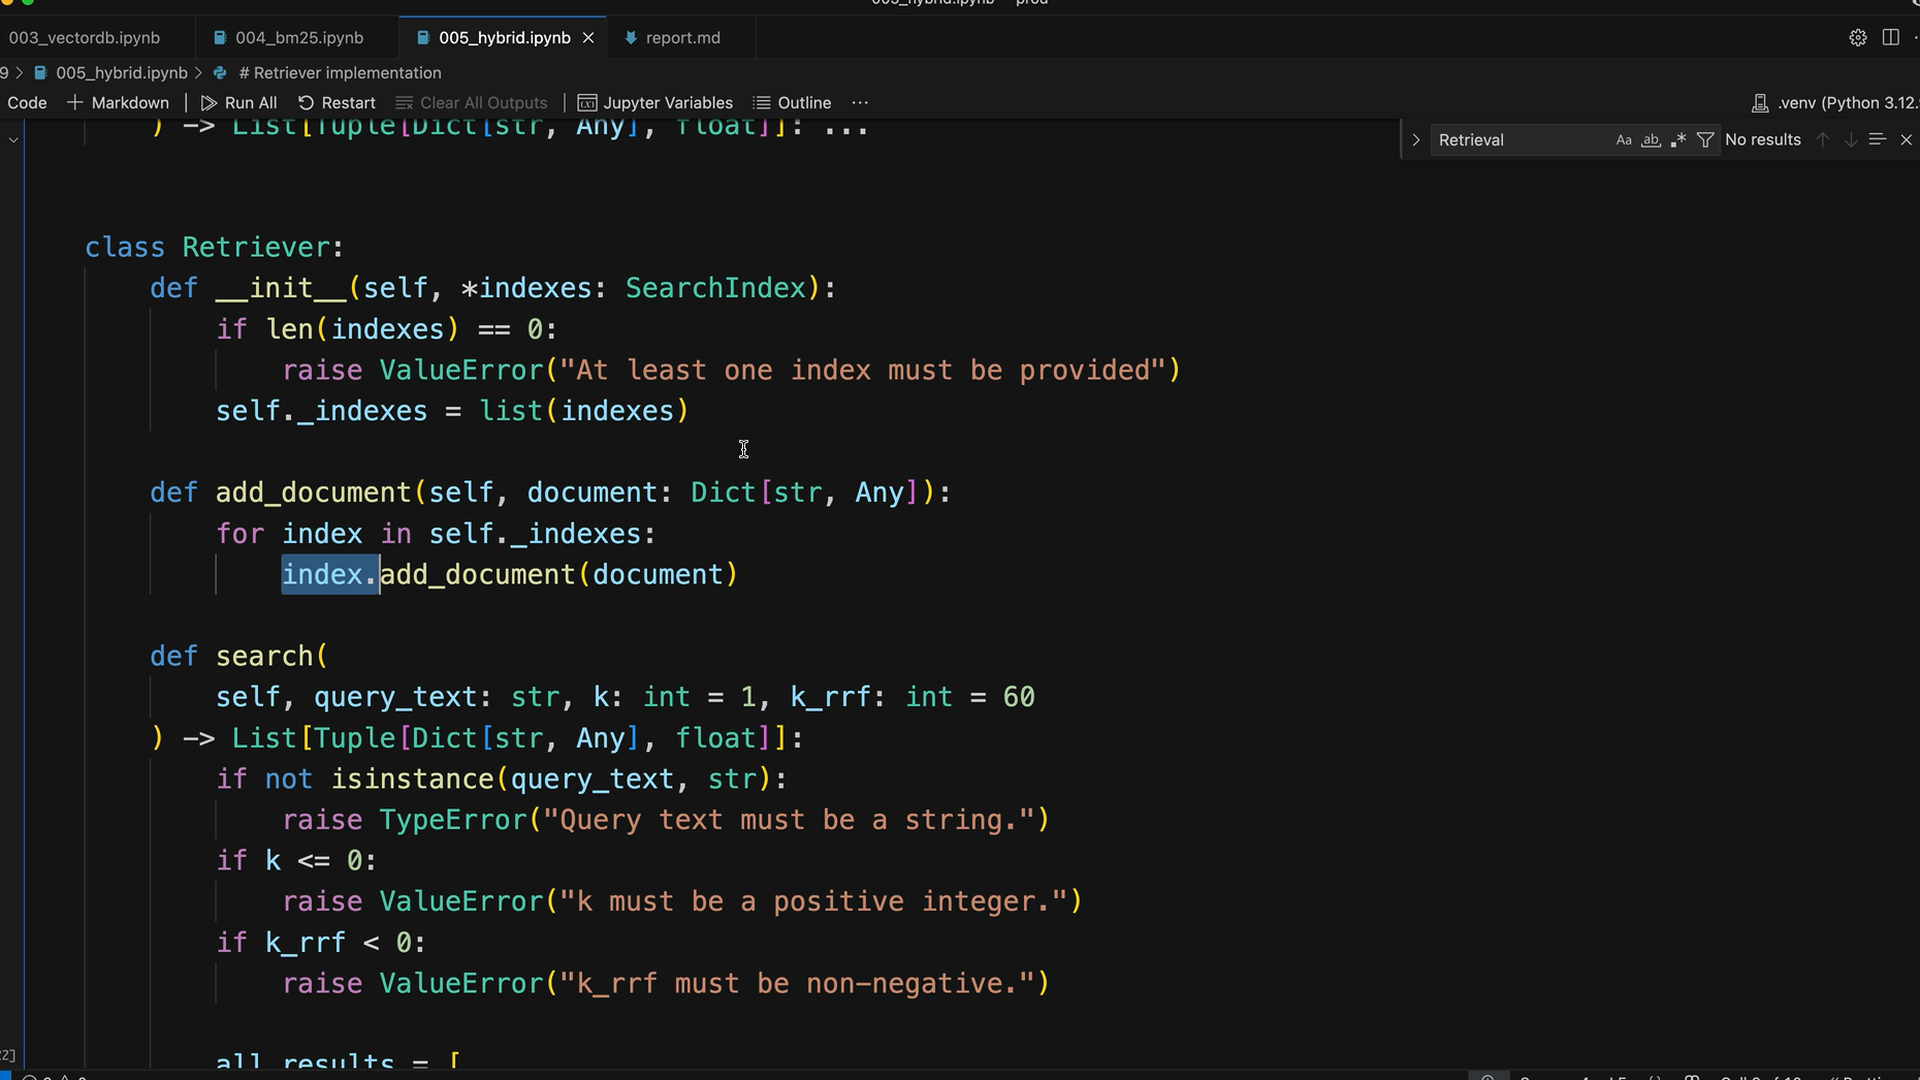
class Retriever:
    def __init__(self, *indexes):
        self._indexes = list(indexes)

    def add_document(self, document):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text, k=1, k_rrf=60):
        # Obtenir les résultats de tous les index
        all_results = [index.search(query_text, k) for index in self._indexes]

        # Appliquer la fusion de rang réciproque
        # ... logique de fusion ici ...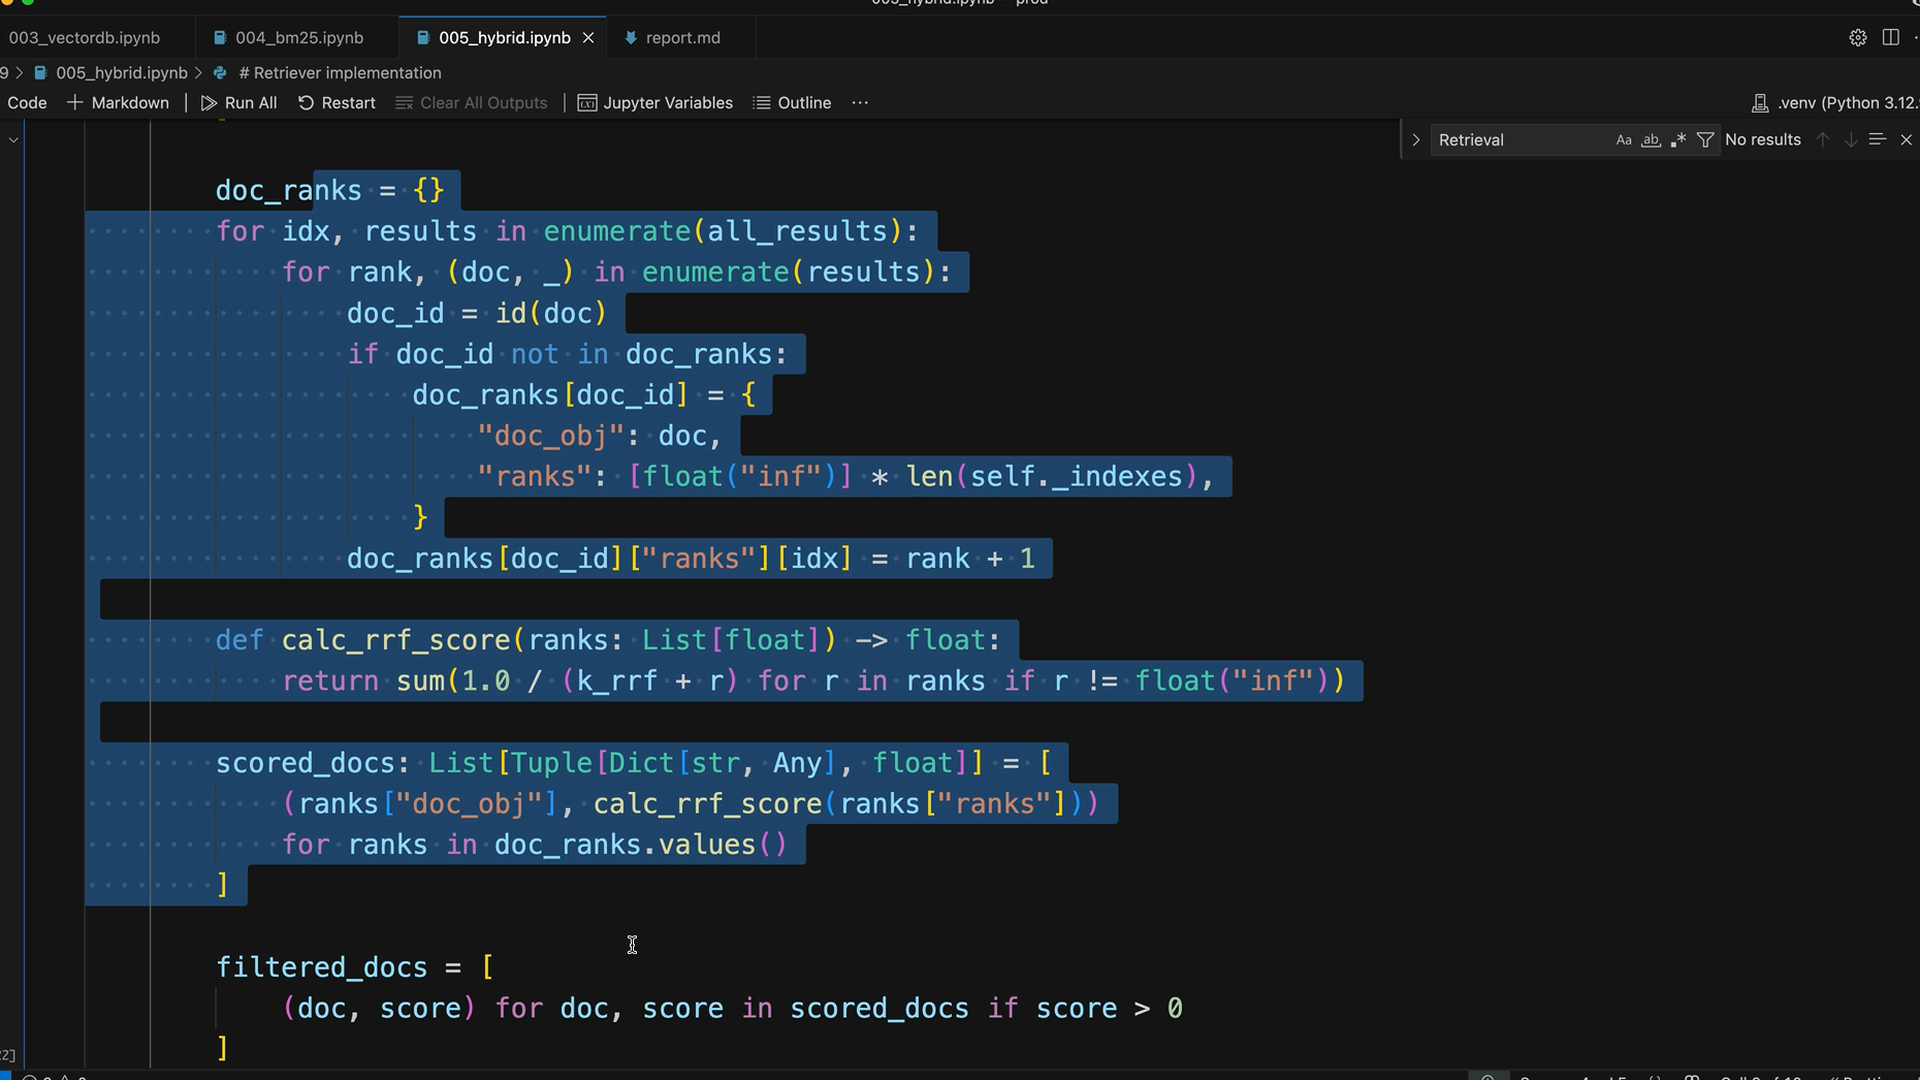
La logique de fusion suit les rangs des documents à travers tous les résultats de recherche, calcule les scores RRF, et renvoie les k meilleurs documents triés selon leurs scores combinés.
Test de l'approche hybride
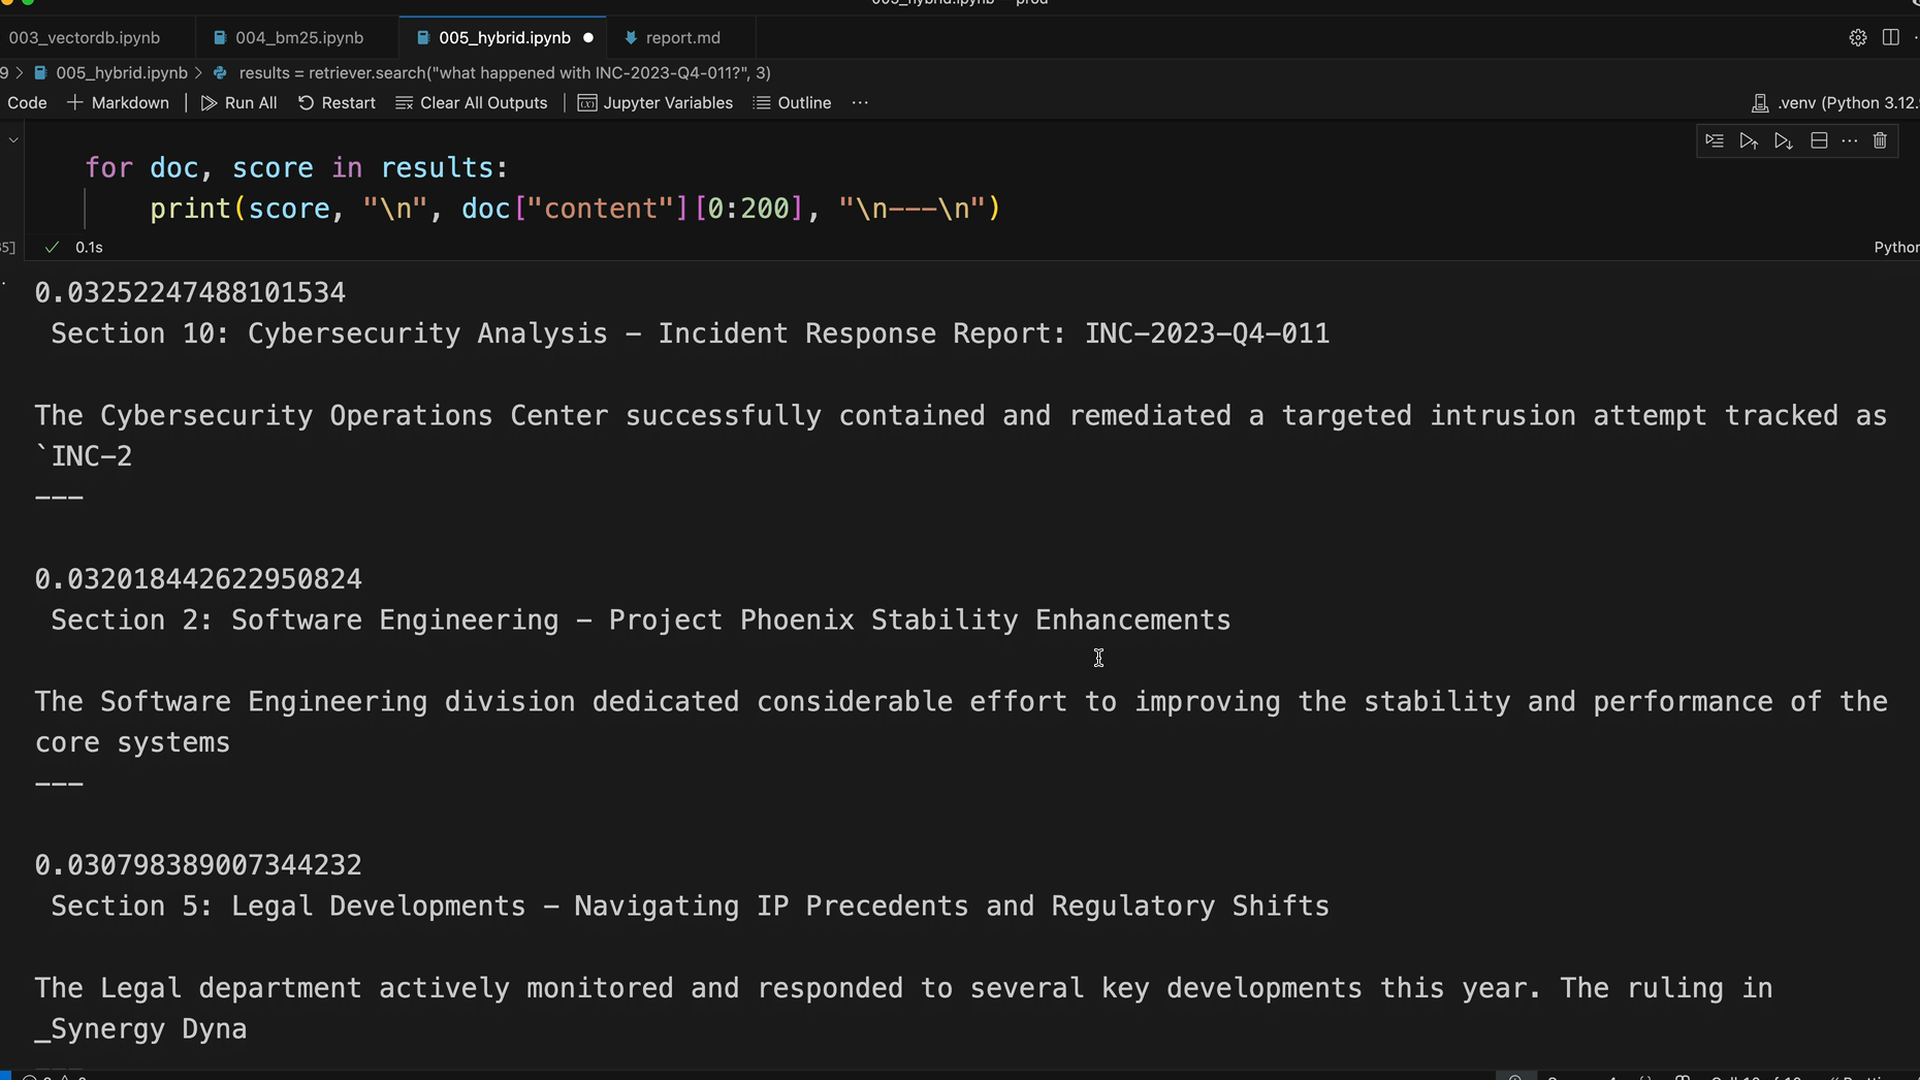
Lors des tests avec la requête « what happened with INC-2023-Q4-011? », l'approche hybride fournit des résultats bien meilleurs que la recherche vectorielle seule :
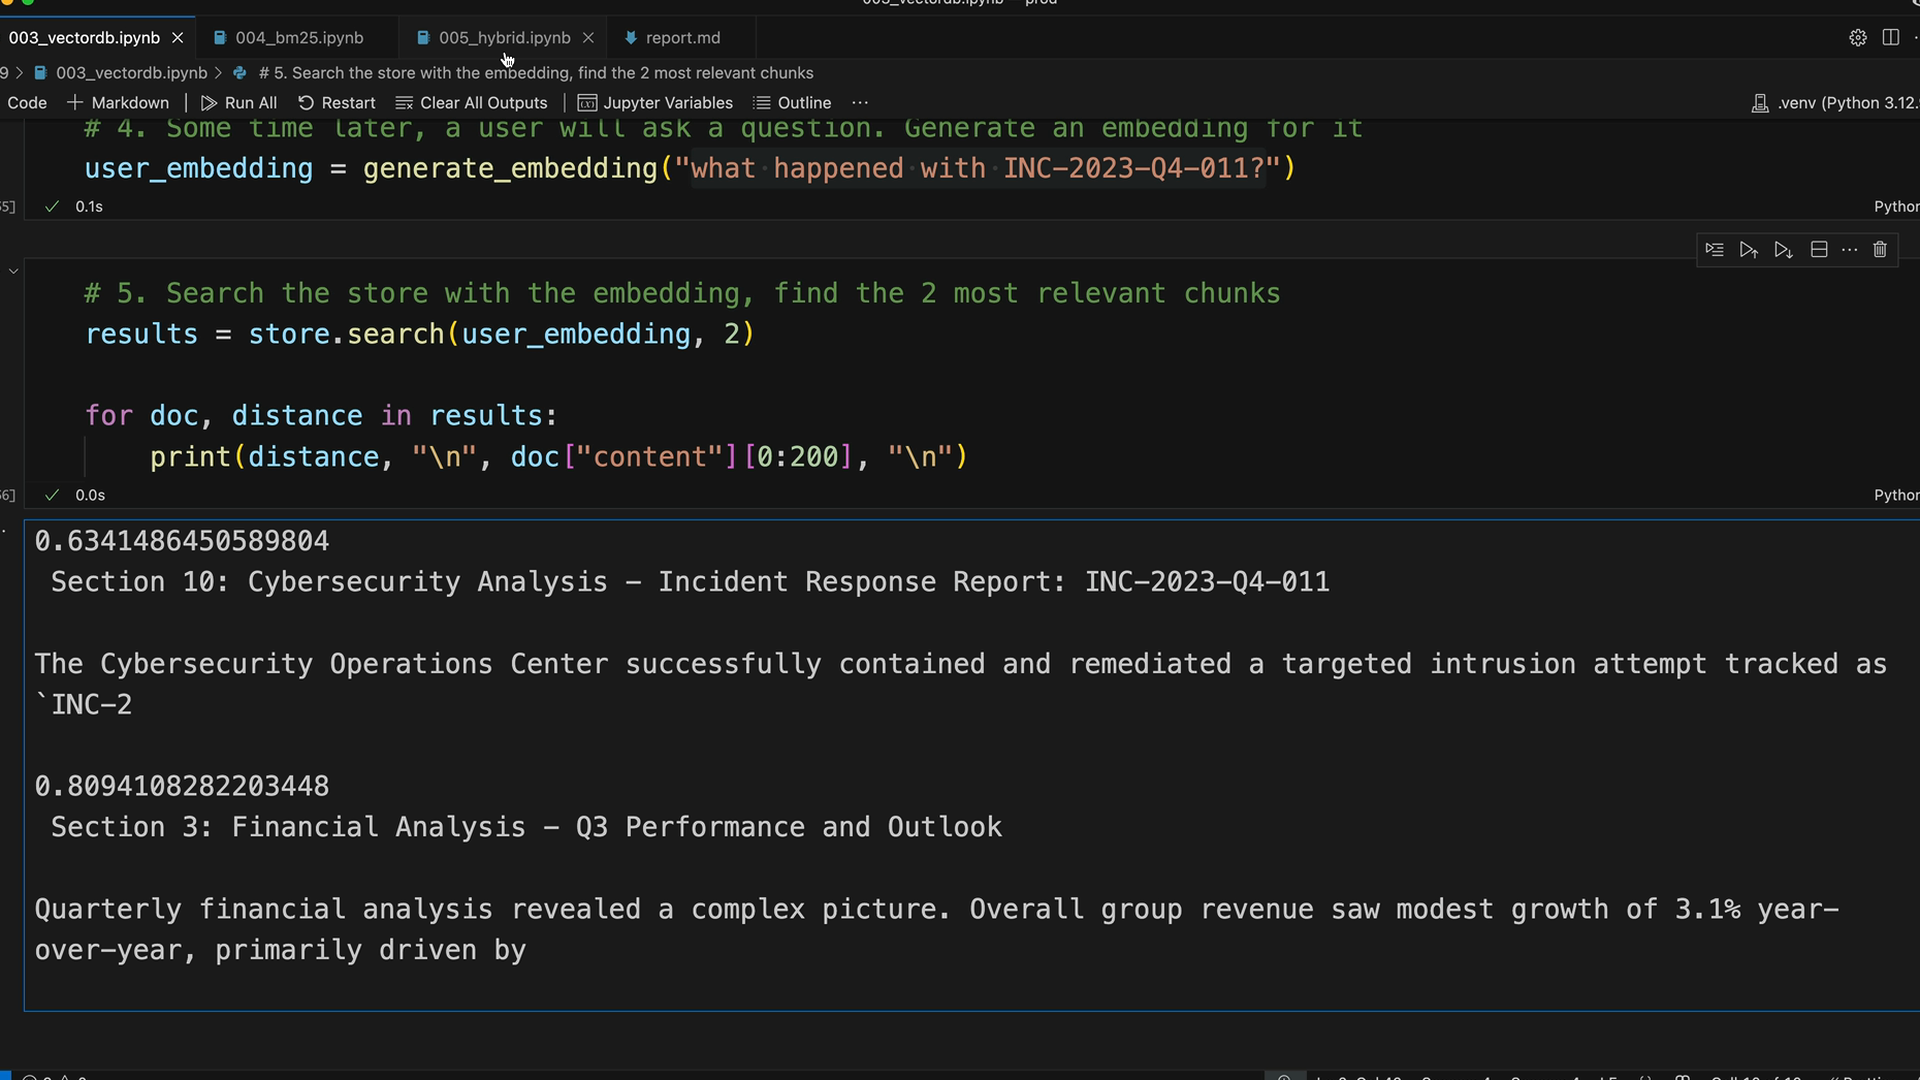
Les résultats priorisent désormais correctement :
- Section 10 : Analyse de cybersécurité (le rapport d'incident réel)
- Section 2 : Ingénierie logicielle (contexte pertinent)
- Section 5 : Développements juridiques (moins pertinent mais toujours lié)
Avantages de l'architecture hybride
Cette conception offre plusieurs avantages :
- Conception modulaire : Chaque index de recherche est implémenté indépendamment avec la même API
- Extensibilité facile : Vous pouvez ajouter de nouvelles méthodes de recherche en implémentant la même interface
search()etadd_document() - Meilleure précision : Combine la compréhension sémantique avec la correspondance exacte de mots-clés
- Fusion flexible : L'algorithme RRF fonctionne indépendamment du nombre d'index de recherche que vous combinez
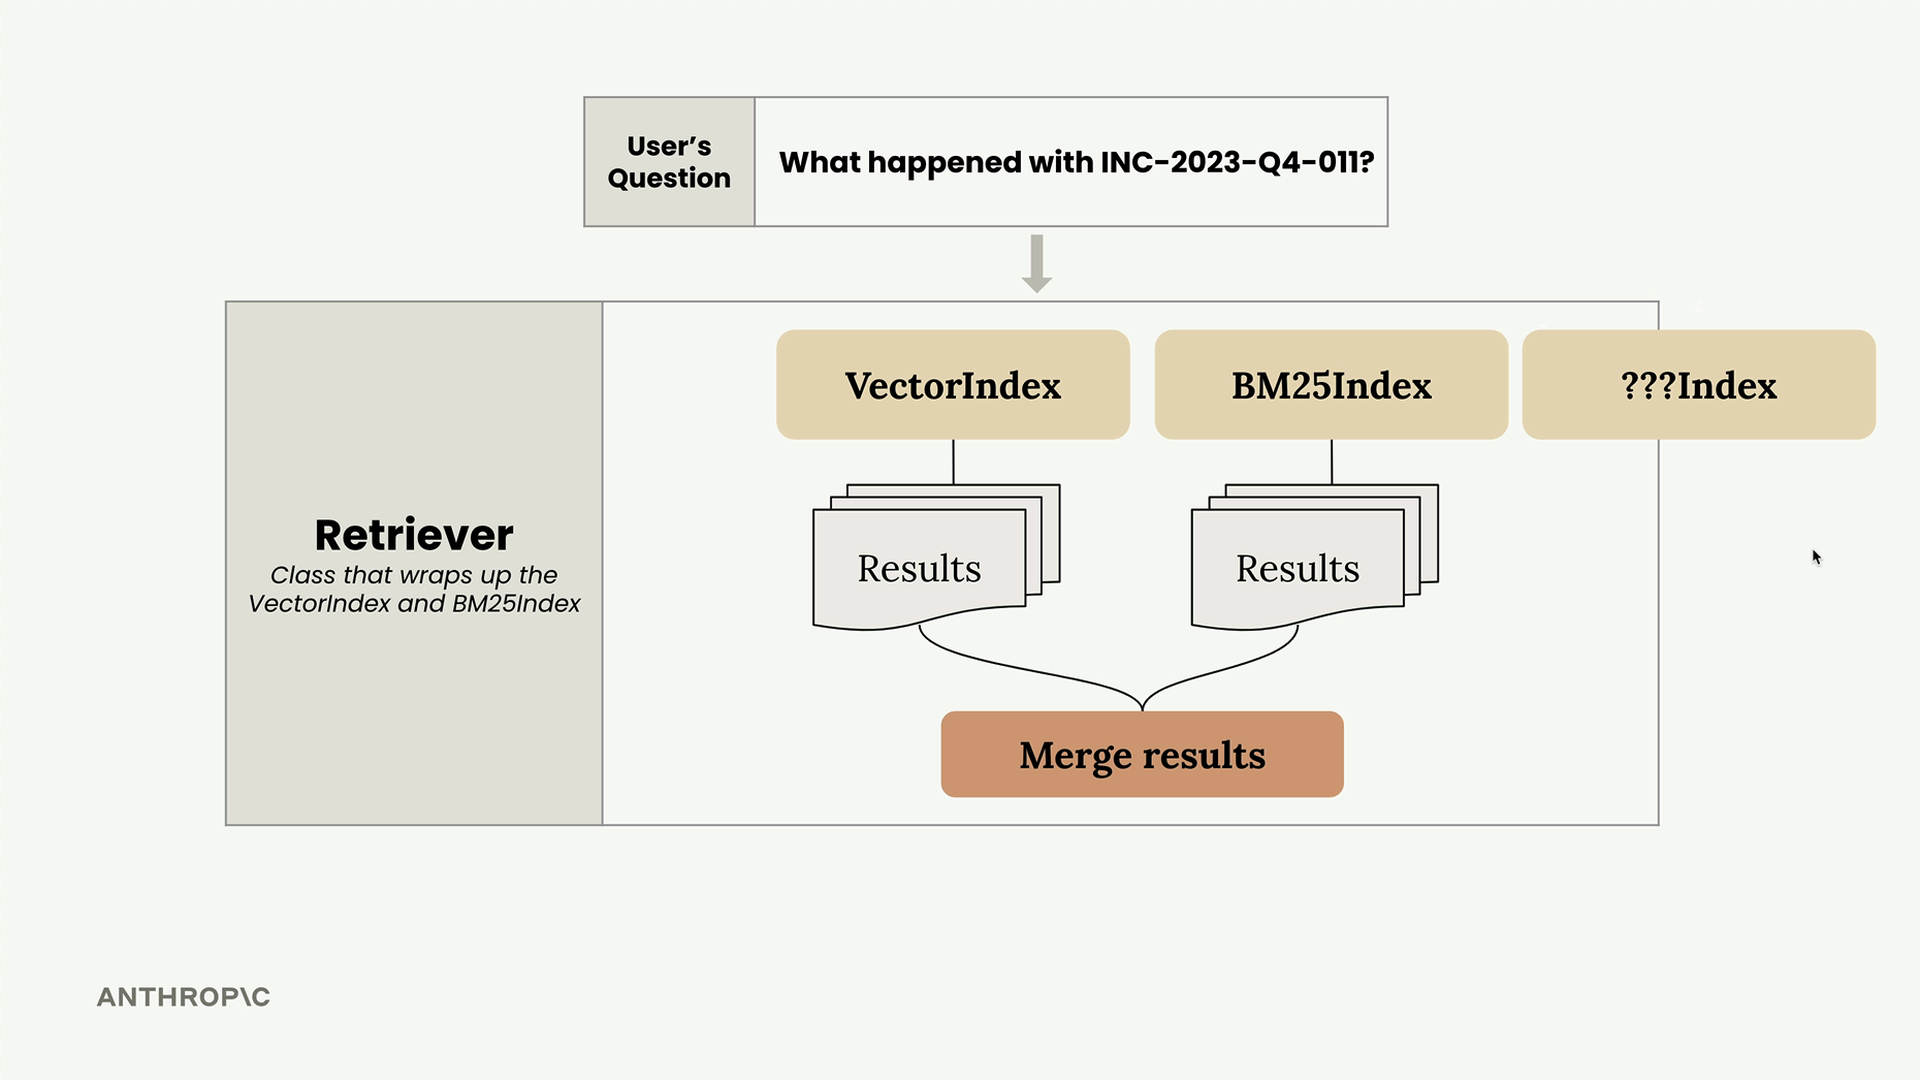
L'API cohérente signifie que vous pourriez facilement ajouter un troisième index de recherche - peut-être un qui se spécialise dans la reconnaissance d'entités nommées ou qui gère des types de documents spécifiques - et le Retriever incorporerait automatiquement ses résultats dans le classement final.
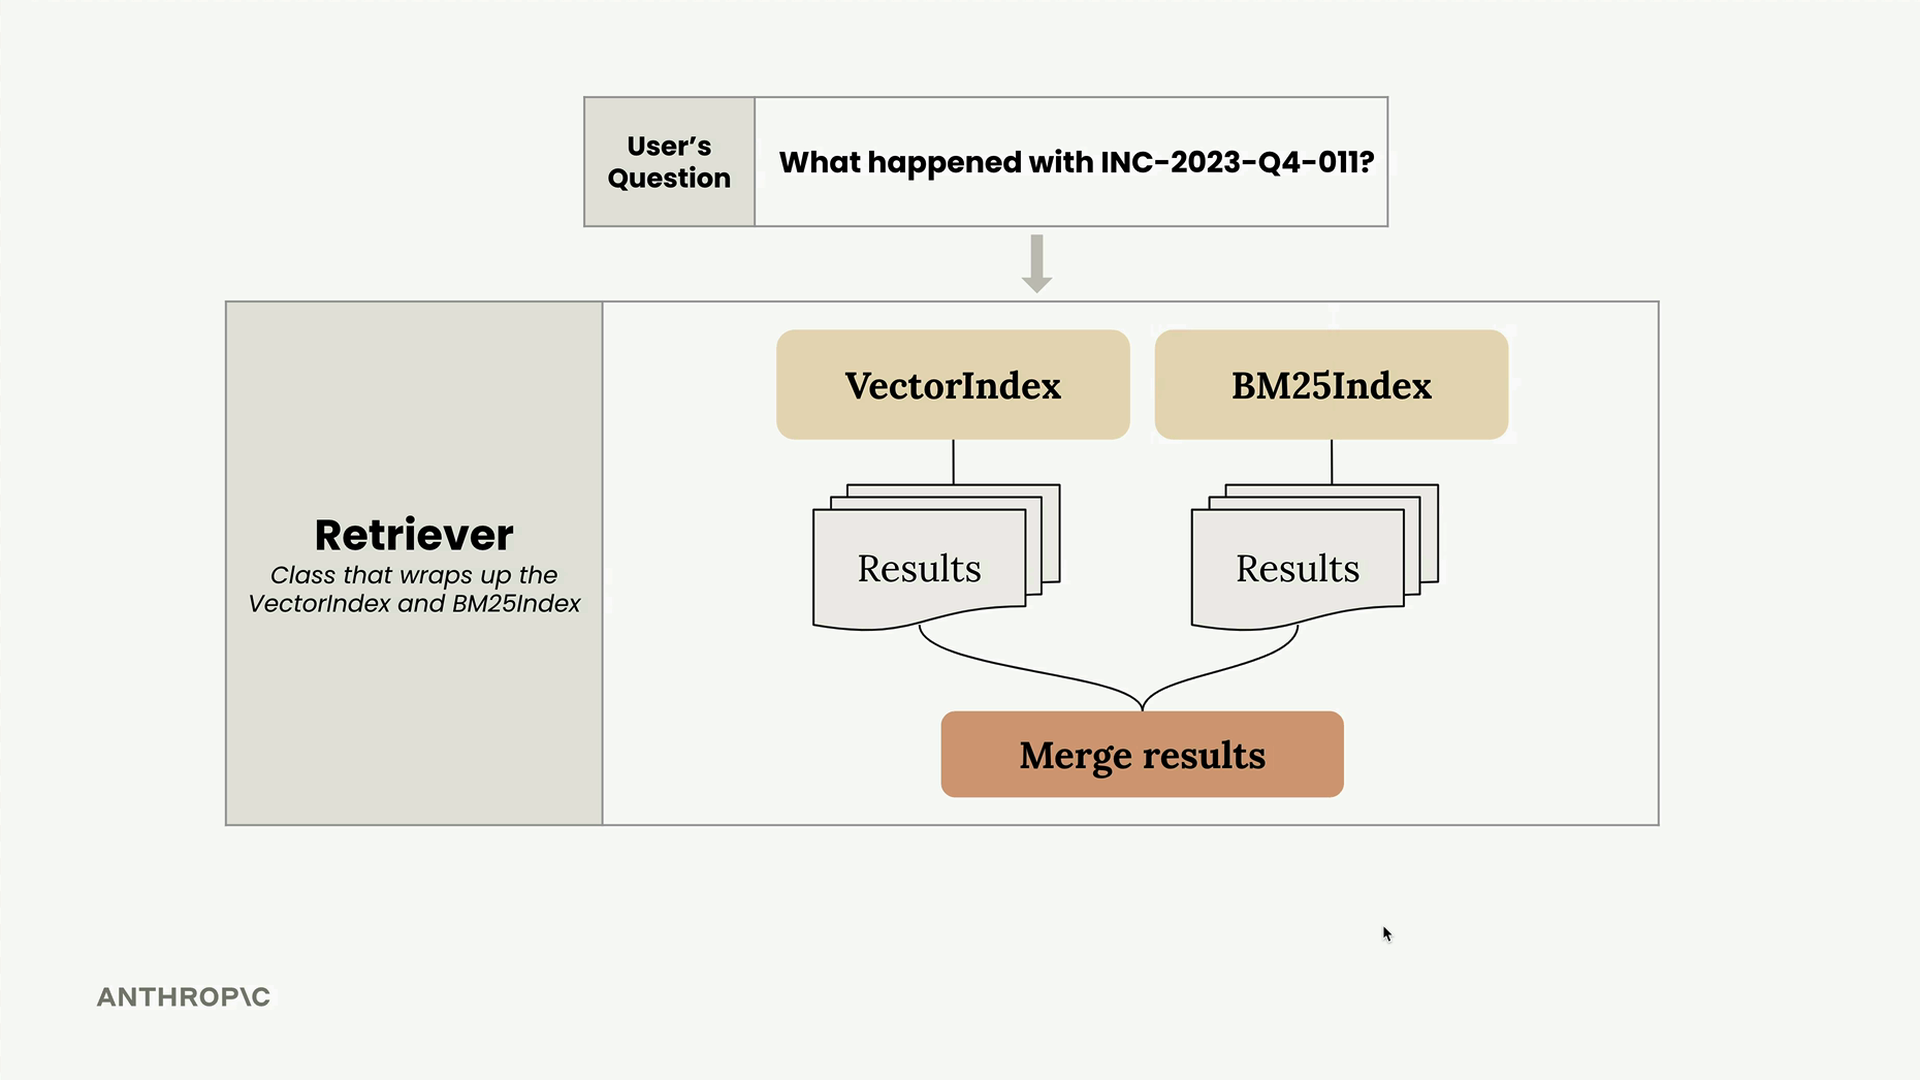
Cette base de recherche hybride offre une récupération significativement plus robuste que l'une ou l'autre méthode seule, préparant votre pipeline RAG pour de meilleures performances sur un éventail plus large de types de requêtes.