Maintenant que nous comprenons le flux RAG sur le plan conceptuel, mettons-le en œuvre étape par étape à l'aide d'un exemple pratique. Nous allons parcourir les cinq étapes du processus RAG, du découpage du texte jusqu'à la recherche de documents pertinents pour les requêtes des utilisateurs.
Configuration de la base de données vectorielle
Pour cette mise en œuvre, nous allons utiliser une classe personnalisée VectorIndex qui fournit les fonctionnalités de base dont nous avons besoin pour stocker et rechercher des embeddings. Cette classe gère le stockage des vecteurs, les calculs de distance (en utilisant la similarité cosinus) et la récupération de documents.
La mise en œuvre du RAG en cinq étapes
Parcourons chaque étape du processus RAG :
Étape 1 : Découper le texte par section
Tout d'abord, nous devons diviser notre document source en morceaux gérables. Nous allons utiliser la même approche de découpage basée sur les sections que précédemment :
chunks = chunk_by_section(text)Cela divise notre fichier report.md en sections logiques que nous pouvons traiter individuellement.
Étape 2 : Générer des embeddings pour chaque morceau
Ensuite, nous convertissons chaque morceau de texte en un embedding numérique qui capture sa signification sémantique :
embeddings = generate_embedding(chunks)Ces embeddings nous permettent d'effectuer des comparaisons mathématiques entre différents morceaux de texte.
Étape 3 : Stocker les embeddings dans la base de données vectorielle
Maintenant, nous créons notre magasin de vecteurs et le remplissons avec nos embeddings et leur texte associé :
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
Remarquez que nous stockons à la fois l'embedding et le contenu textuel original. Ceci est crucial car, lorsque nous récupérons des embeddings similaires plus tard, nous avons besoin d'accéder au texte réel, et pas seulement aux vecteurs numériques. L'embedding seul ne nous est pas utile en tant que développeurs - nous avons besoin du contenu lisible par un humain qu'il représente.
Étape 4 : Générer un embedding pour la requête de l'utilisateur
Lorsqu'un utilisateur pose une question, nous devons convertir sa requête dans le même espace d'embedding que nos documents stockés :
user_embedding = generate_embedding("What did the software engineering dept do last year?")Étape 5 : Rechercher des documents pertinents
Enfin, nous recherchons dans notre magasin de vecteurs pour trouver les morceaux les plus pertinents :
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
Cela renvoie les deux morceaux les plus similaires ainsi que leurs scores de distance cosinus.
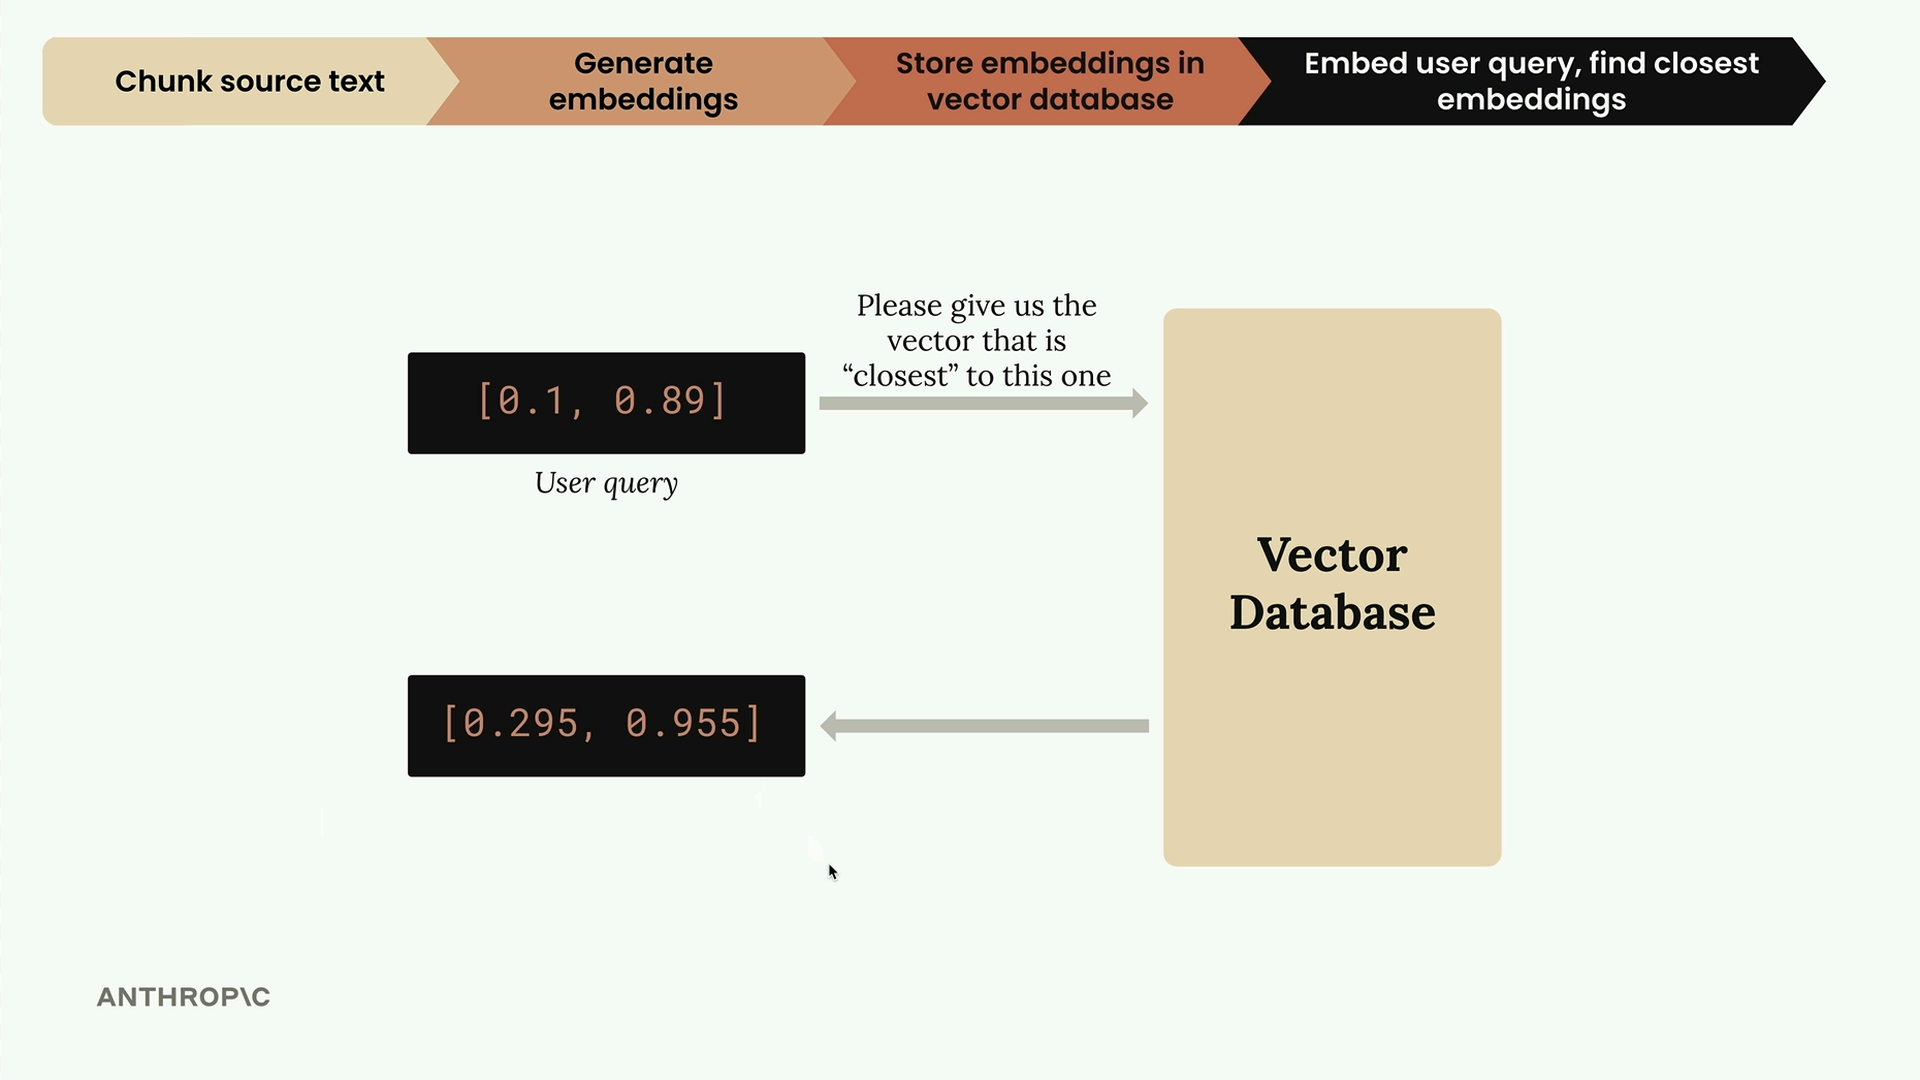
Le diagramme ci-dessus illustre comment la base de données vectorielle traite une requête utilisateur. Lorsque nous posons une question, celle-ci est convertie en un vecteur d'embedding, et la base de données trouve les vecteurs stockés qui sont les plus « proches » de celui-ci dans l'espace à haute dimension.
Comprendre les résultats
Lorsque nous exécutons cet exemple avec la requête concernant le département d'ingénierie logicielle, nous obtenons deux sections pertinentes :
- Section 2 : Ingénierie logicielle - Améliorations de la stabilité du projet Phoenix (distance : 0,71)
- Section Méthodologie (distance : 0,72)
Plus le score de distance est faible, plus le contenu est similaire à notre requête. Les deux résultats sont pertinents par rapport à notre question sur ce que le département d'ingénierie logicielle a accompli.
Pourquoi stocker le contenu avec les embeddings
Vous vous demandez peut-être pourquoi nous stockons le texte original en plus de chaque embedding. La raison est pratique : les embeddings ne sont que des tableaux de nombres qui n'ont aucune signification directe pour les humains. Lorsque notre recherche renvoie les embeddings les plus similaires, nous avons besoin du contenu textuel réel pour comprendre ce qui a été trouvé et pour l'utiliser dans la génération des réponses.
Certaines mises en œuvre stockent simplement un identifiant qui renvoie au texte original, mais par souci de simplicité, nous stockons le contenu directement avec chaque vecteur.
Et ensuite
Cette mise en œuvre couvre le flux de travail RAG de base, mais il reste encore des améliorations possibles. Dans des applications réelles, vous pourriez rencontrer des scénarios où cette approche de base ne fonctionne pas comme prévu, et nous explorerons ces améliorations dans les sections à venir.