Nachdem wir nun die Grundlagen von RAG, Text-Chunking und Embeddings behandelt haben, gehen wir Schritt für Schritt die vollständige RAG-Pipeline durch. Dieses detaillierte Beispiel zeigt dir genau, wie alle Teile in einer echten Implementierung zusammenpassen.
Schritt 1: Zerlege deinen Quelltext in Chunks
Zuerst nehmen wir unser Quelldokument und zerlegen es in überschaubare Chunks. Für dieses Beispiel verwenden wir zwei einfache Textabschnitte:
- Abschnitt 1: Medizinische Forschung – „Dieses Jahr gab es bedeutende Fortschritte in unserem Verständnis von XDR-47, einem ‚Bug‘, den wir zuvor noch nicht gesehen haben."
- Abschnitt 2: Softwareentwicklung – „Diese Abteilung widmete sich intensiv der Untersuchung verschiedener Infektionsvektoren in unseren verteilten Systemen"
Schritt 2: Embeddings generieren
Als Nächstes wandeln wir jeden Text-Chunk in numerische Embeddings um. Um dies leichter verständlich zu machen, stellen wir uns vor, wir hätten ein perfektes Embedding-Modell, das immer genau zwei Zahlen zurückgibt, und wir wissen, was jede Zahl repräsentiert:
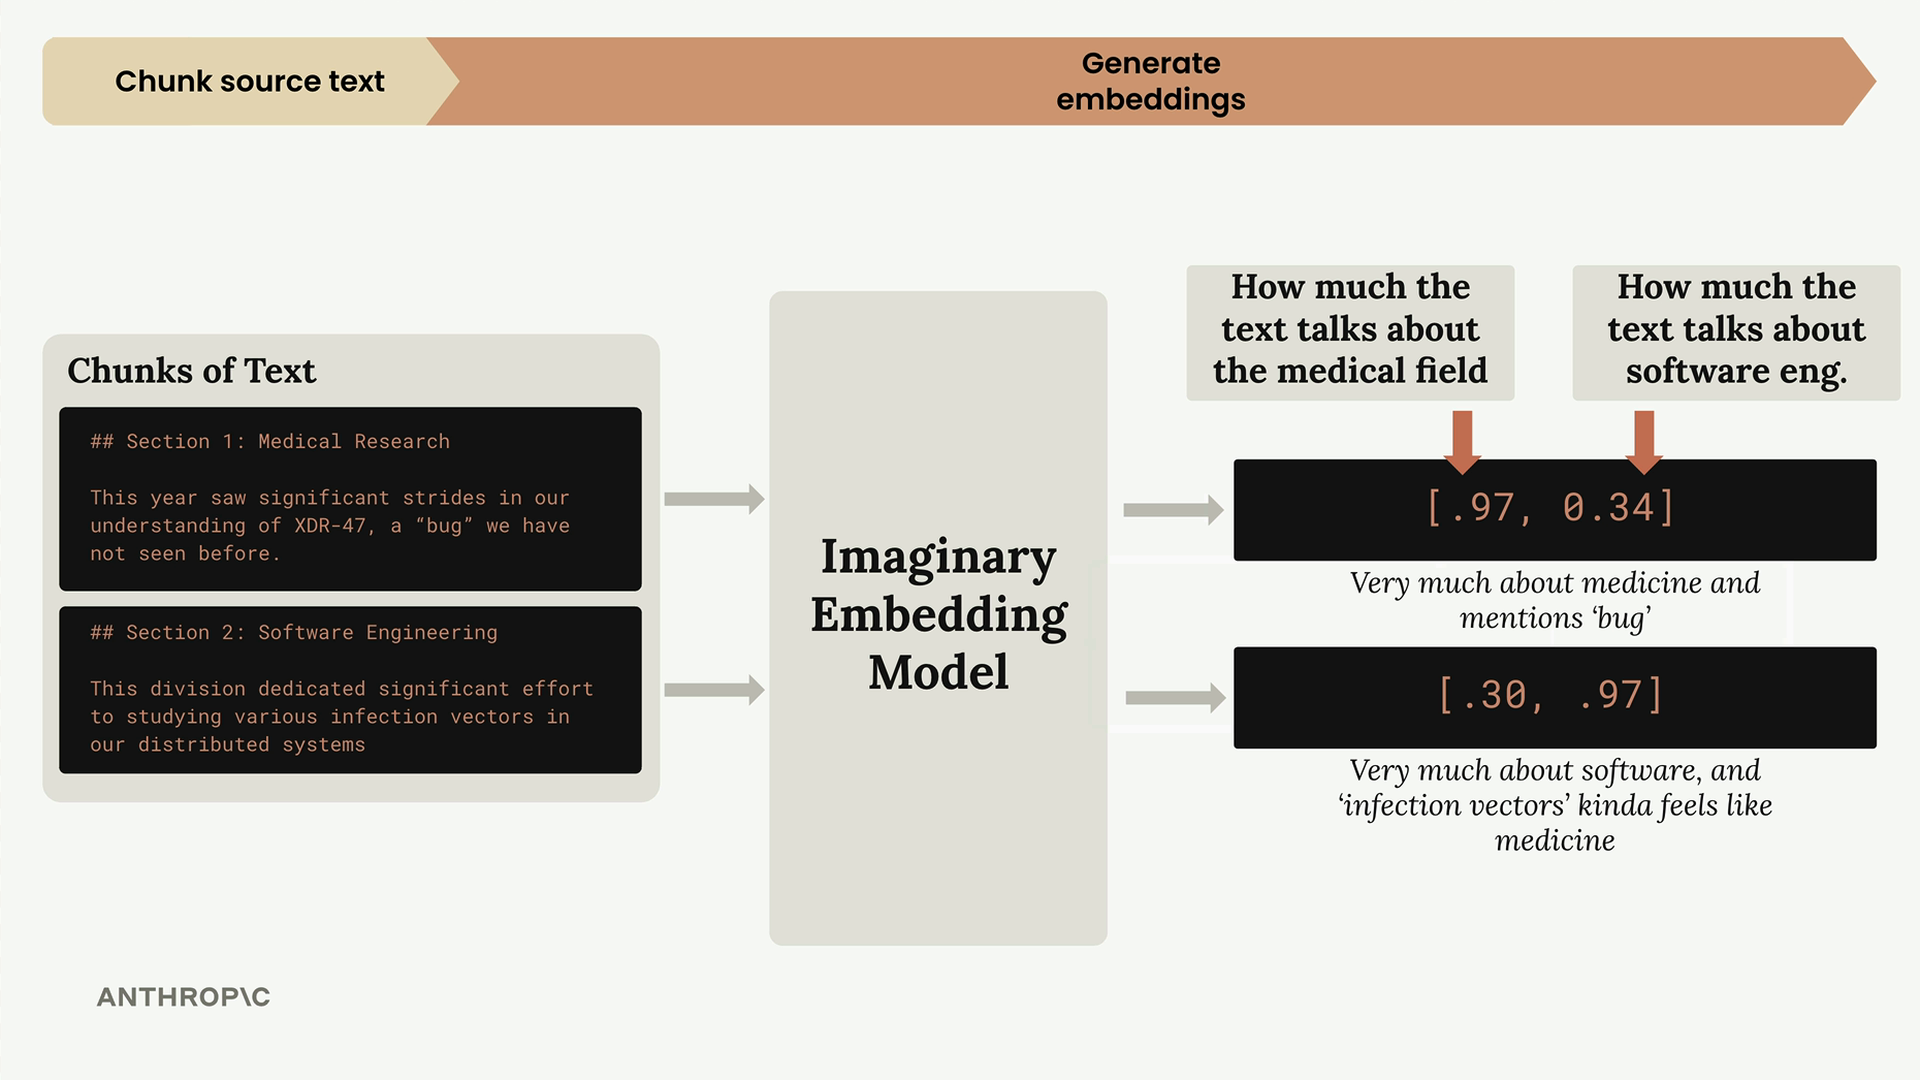
In unserem imaginären Modell:
- Erste Zahl: Wie stark der Text von Medizin handelt
- Zweite Zahl: Wie stark der Text von Softwareentwicklung handelt
Unser Abschnitt zur medizinischen Forschung erhält also [0.97, 0.34] – sehr medizinisch, aufgrund des Wortes „Bug" etwas softwarebezogen. Der Abschnitt zur Softwareentwicklung erhält [0.30, 0.97] – sehr softwarefokussiert, aber „Infektionsvektoren" hat medizinische Konnotationen.
Normalisierung
Bevor diese Embeddings gespeichert werden, durchlaufen sie einen Normalisierungsprozess, der jeden Vektor so skaliert, dass er eine Magnitude von 1,0 hat. Dies wird in der Regel automatisch von deiner Embedding-API übernommen, aber es ist wichtig zu verstehen, dass dies geschieht.
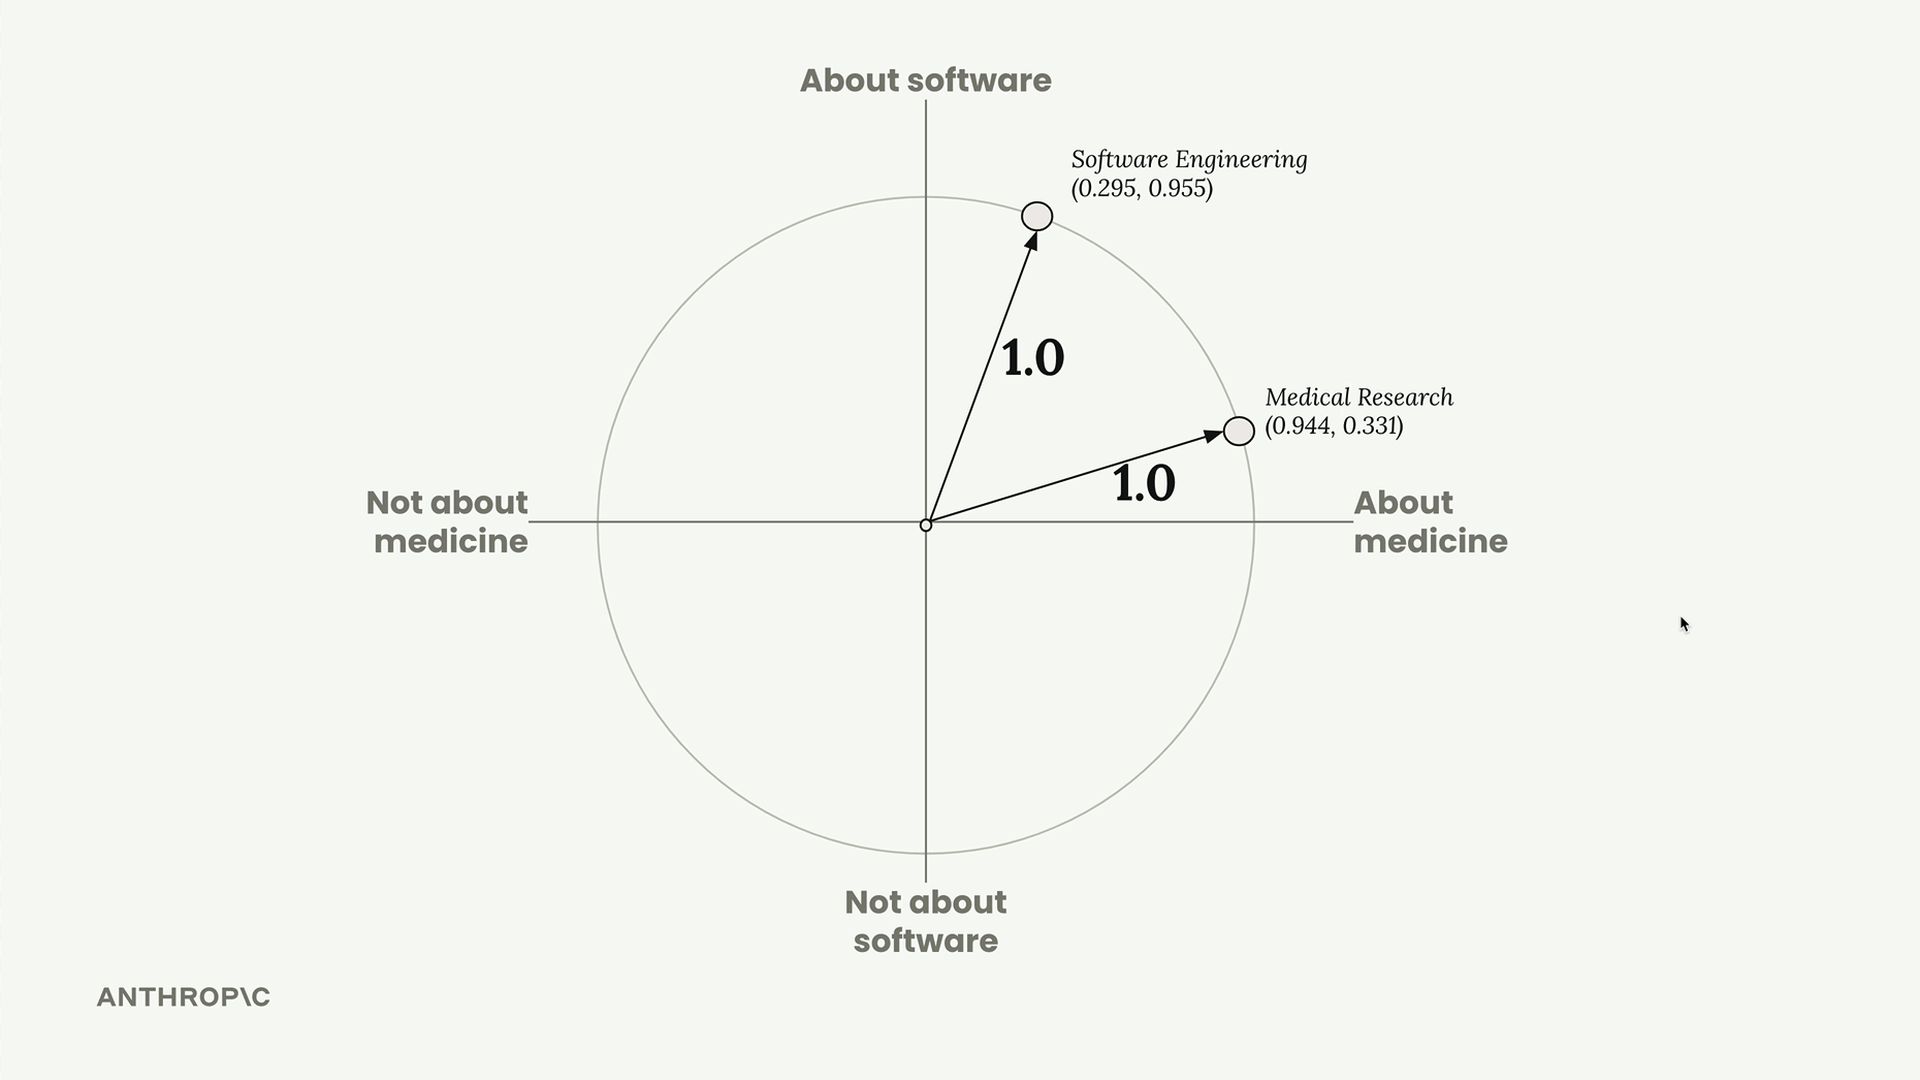
Nach der Normalisierung werden unsere Embeddings zu [0.944, 0.331] und [0.295, 0.955]. Wir können diese auf einem Einheitskreis visualisieren, auf dem beide Punkte genau auf dem Rand des Kreises liegen.
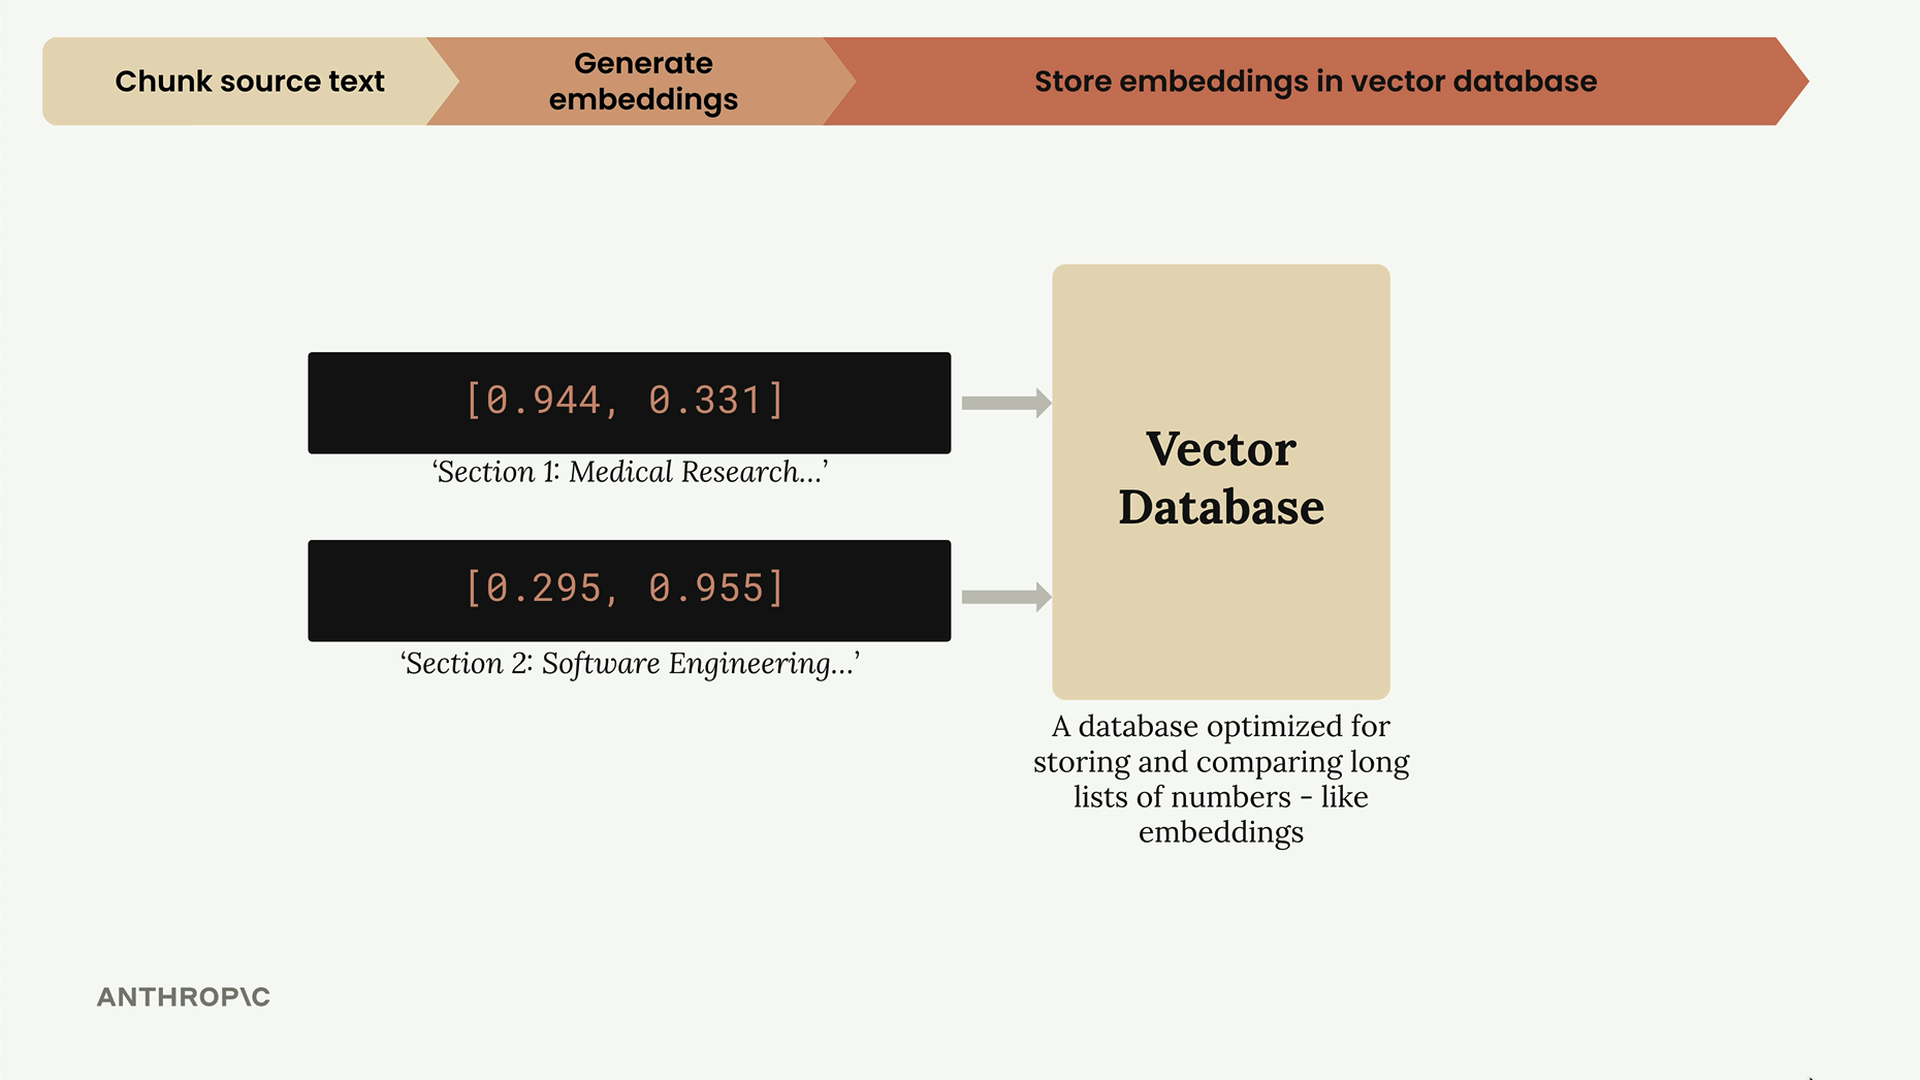
Schritt 3: In der Vektordatenbank speichern
Die normalisierten Embeddings werden in einer Vektordatenbank gespeichert – einer spezialisierten Datenbank, die für das Speichern, Vergleichen und Durchsuchen langer Zahlenlisten wie unserer Embeddings optimiert ist.
An diesem Punkt pausieren wir. Die gesamte bisherige Arbeit war Vorverarbeitung, die im Voraus geschieht. Jetzt warten wir darauf, dass ein Nutzer eine Anfrage stellt.
Schritt 4: Nutzeranfrage verarbeiten
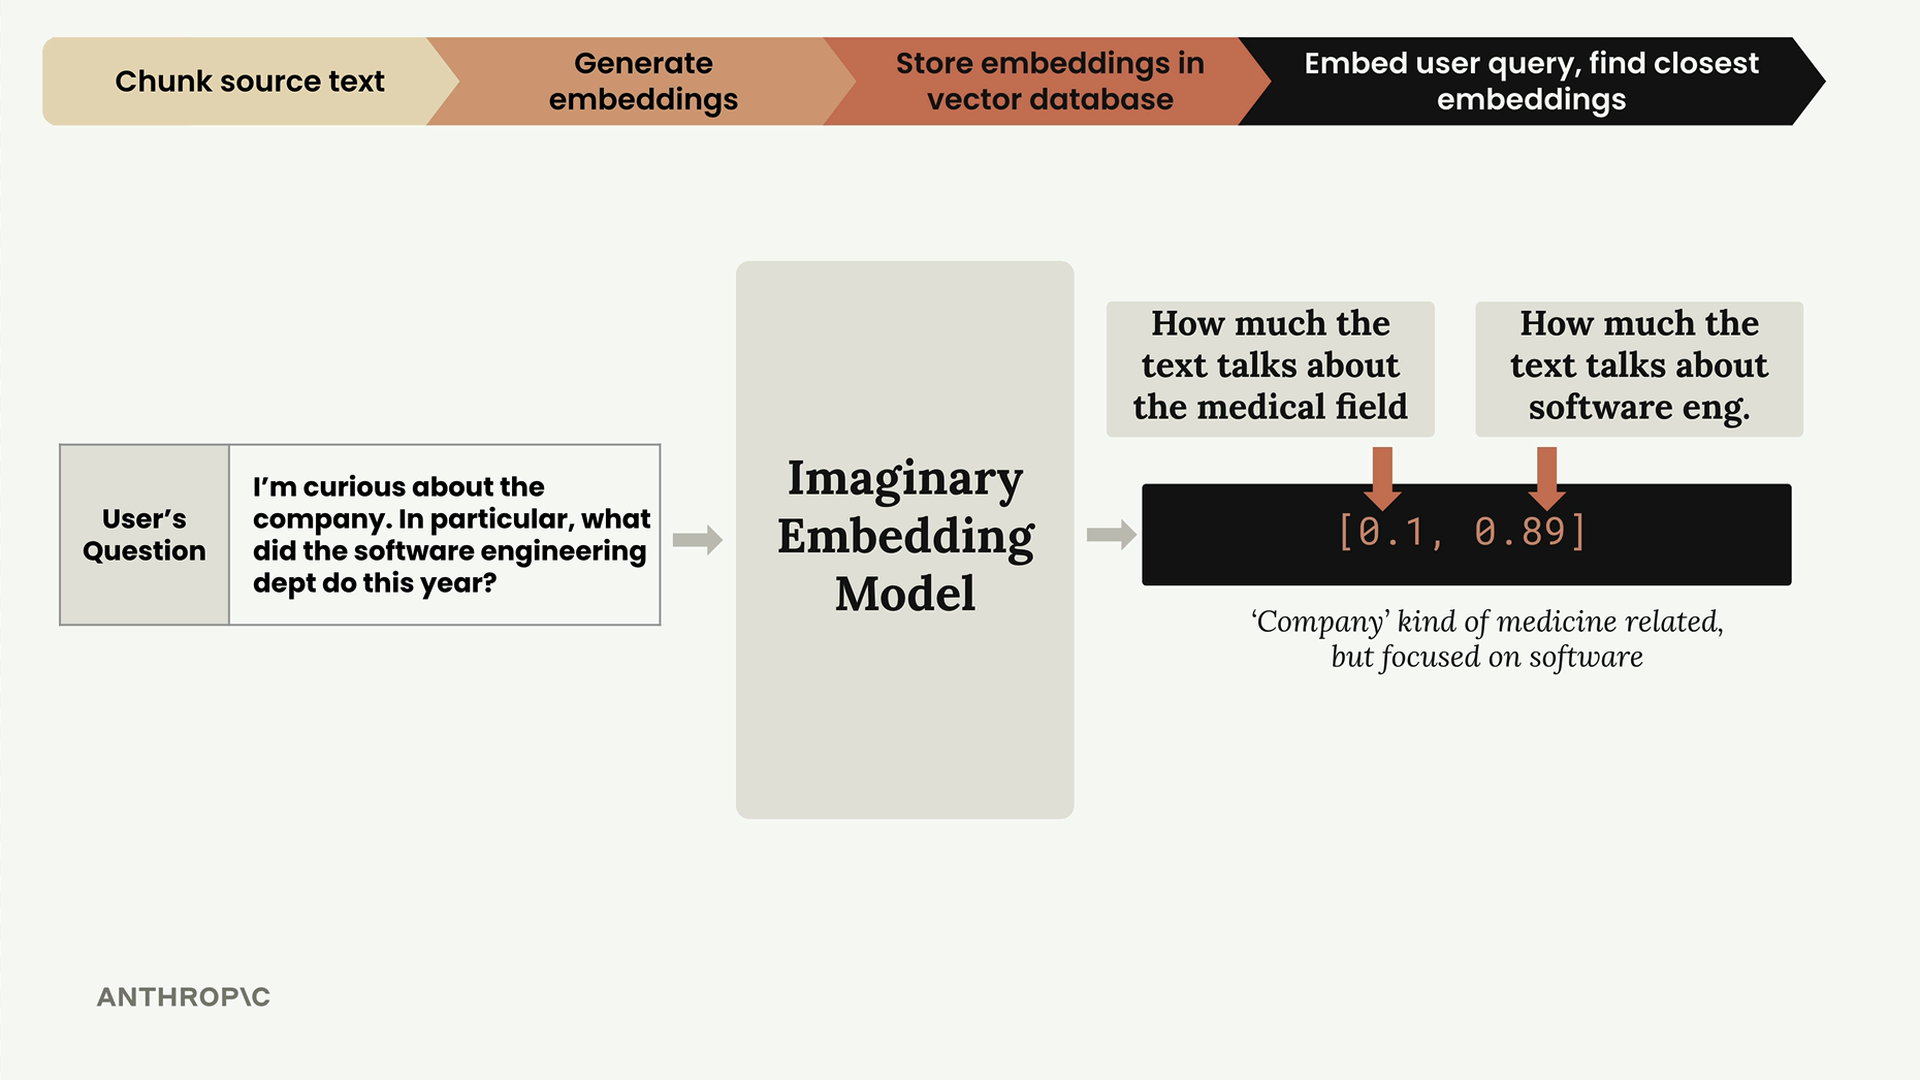
Wenn ein Nutzer eine Frage stellt wie „Ich interessiere mich für das Unternehmen. Was genau hat die Softwareentwicklungsabteilung dieses Jahr gemacht?", führen wir seine Anfrage durch dasselbe Embedding-Modell.
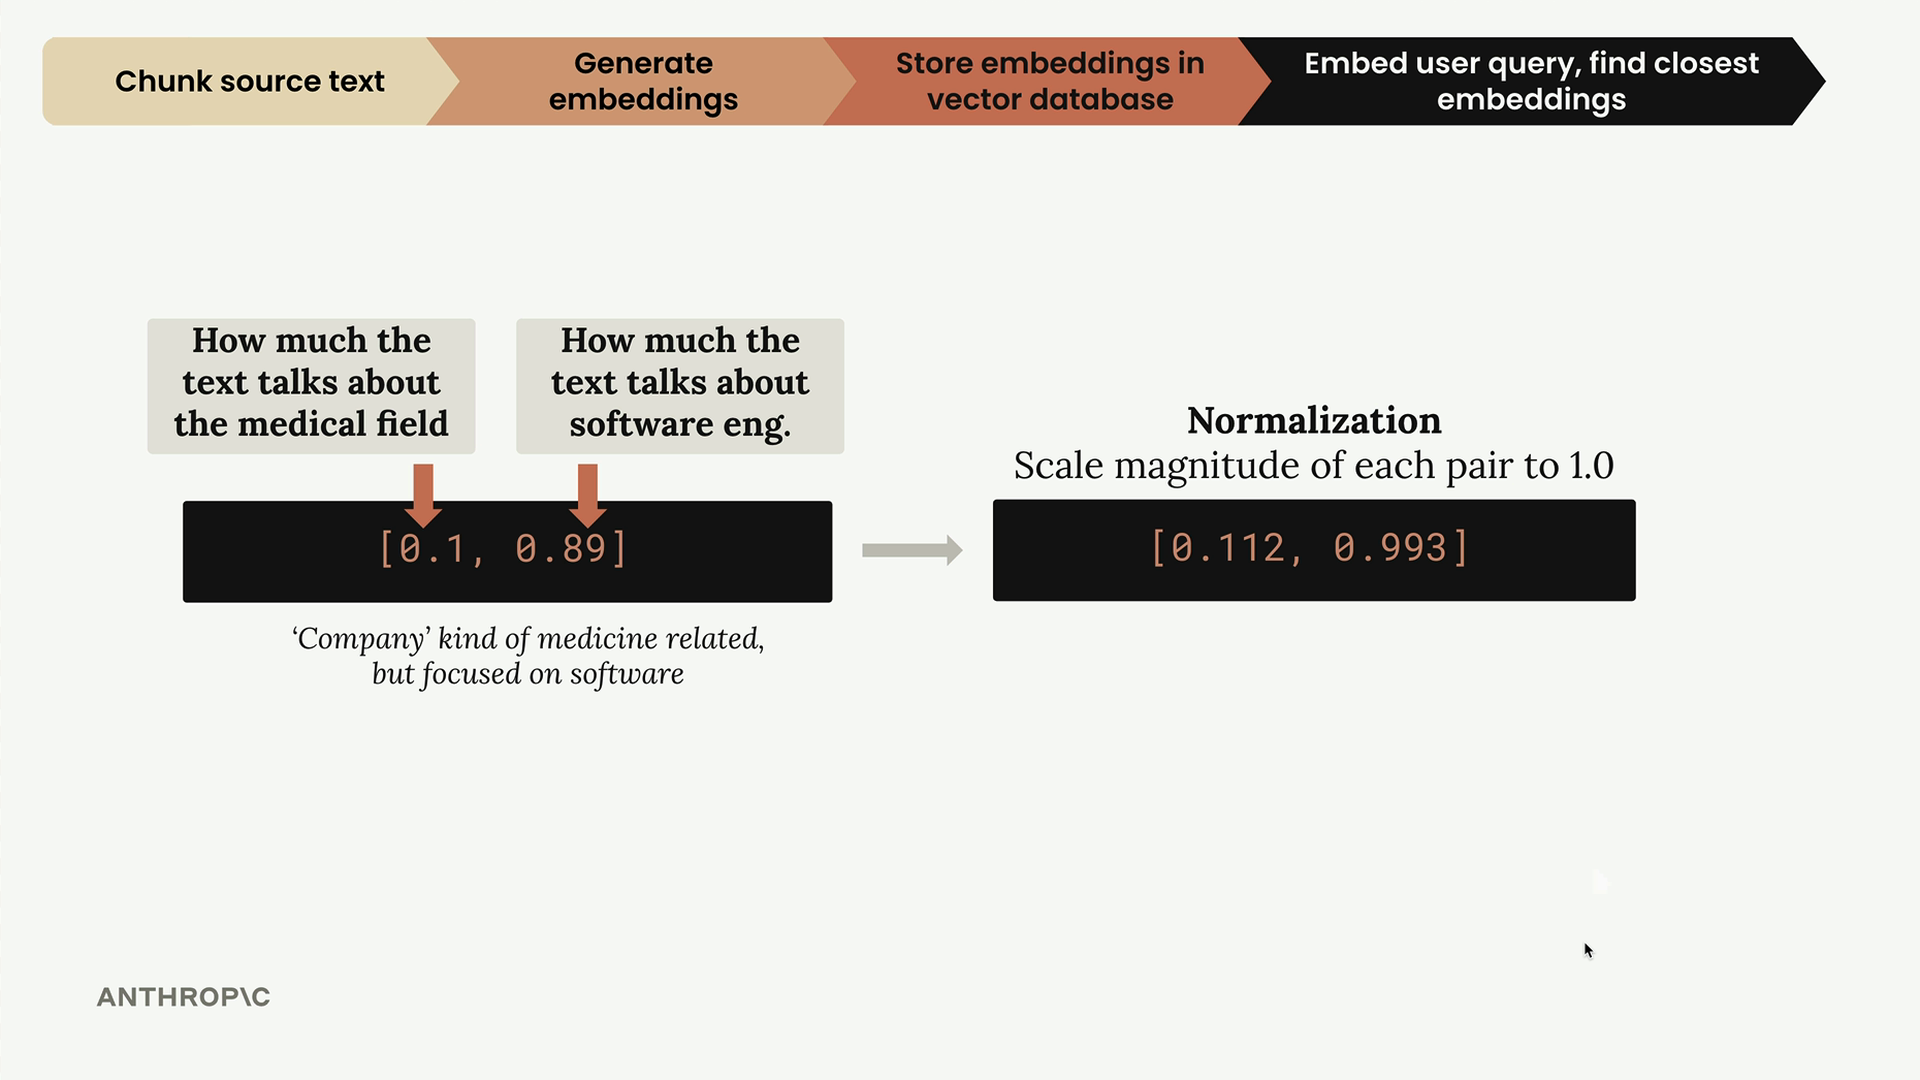
Diese Anfrage wird als [0.1, 0.89] eingebettet – niedriger medizinischer Wert, hoher Softwareentwicklungswert. Nach der Normalisierung wird sie zu [0.112, 0.993].
Schritt 5: Ähnliche Embeddings finden
Jetzt fragen wir die Vektordatenbank: „Finde das gespeicherte Embedding, das diesem Nutzeranfrage-Embedding am nächsten ist." Die Datenbank gibt den Abschnitt zur Softwareentwicklung zurück, da er am ähnlichsten ist.
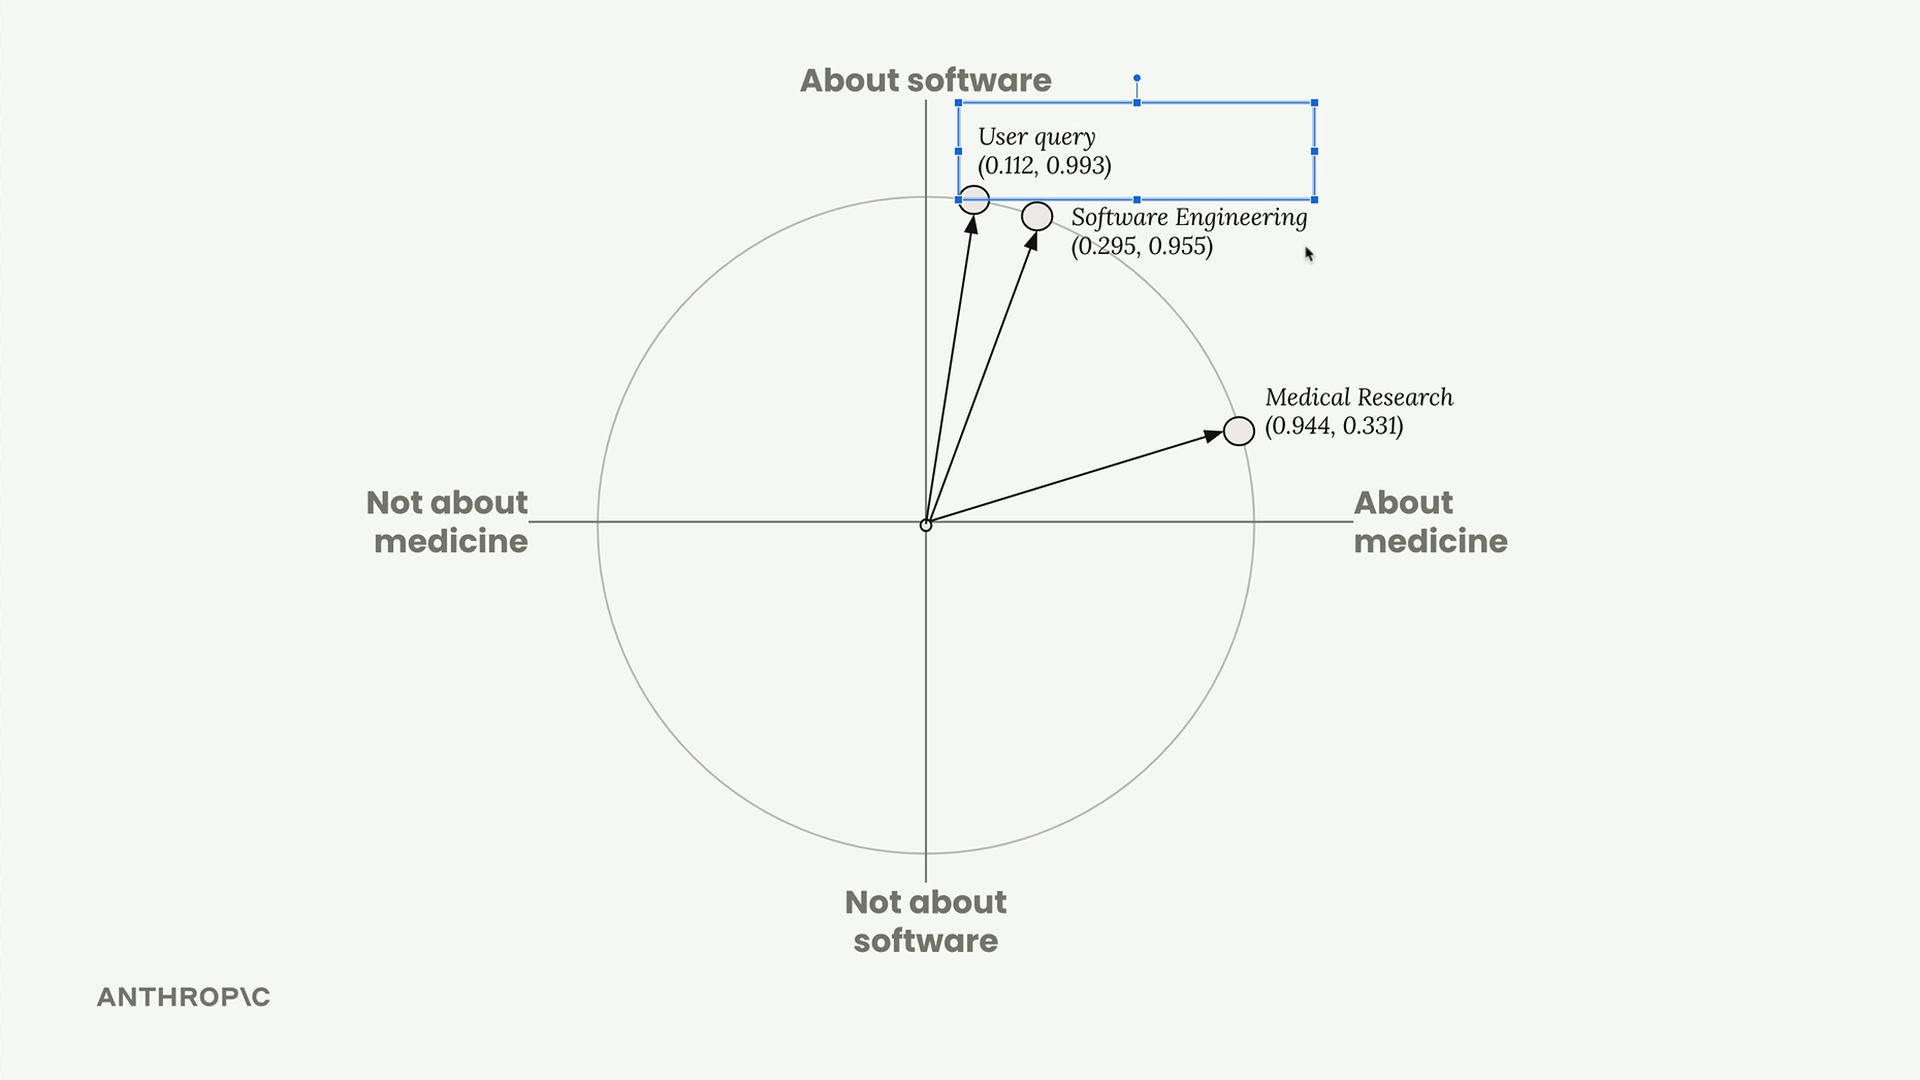
Aber wie bestimmt die Datenbank „am nächsten"? Sie verwendet Kosinus-Ähnlichkeit.
Kosinus-Ähnlichkeit
Die Vektordatenbank berechnet den Kosinus des Winkels zwischen Vektoren, um die Ähnlichkeit zu messen. Dies ergibt eine Zahl zwischen -1 und 1:
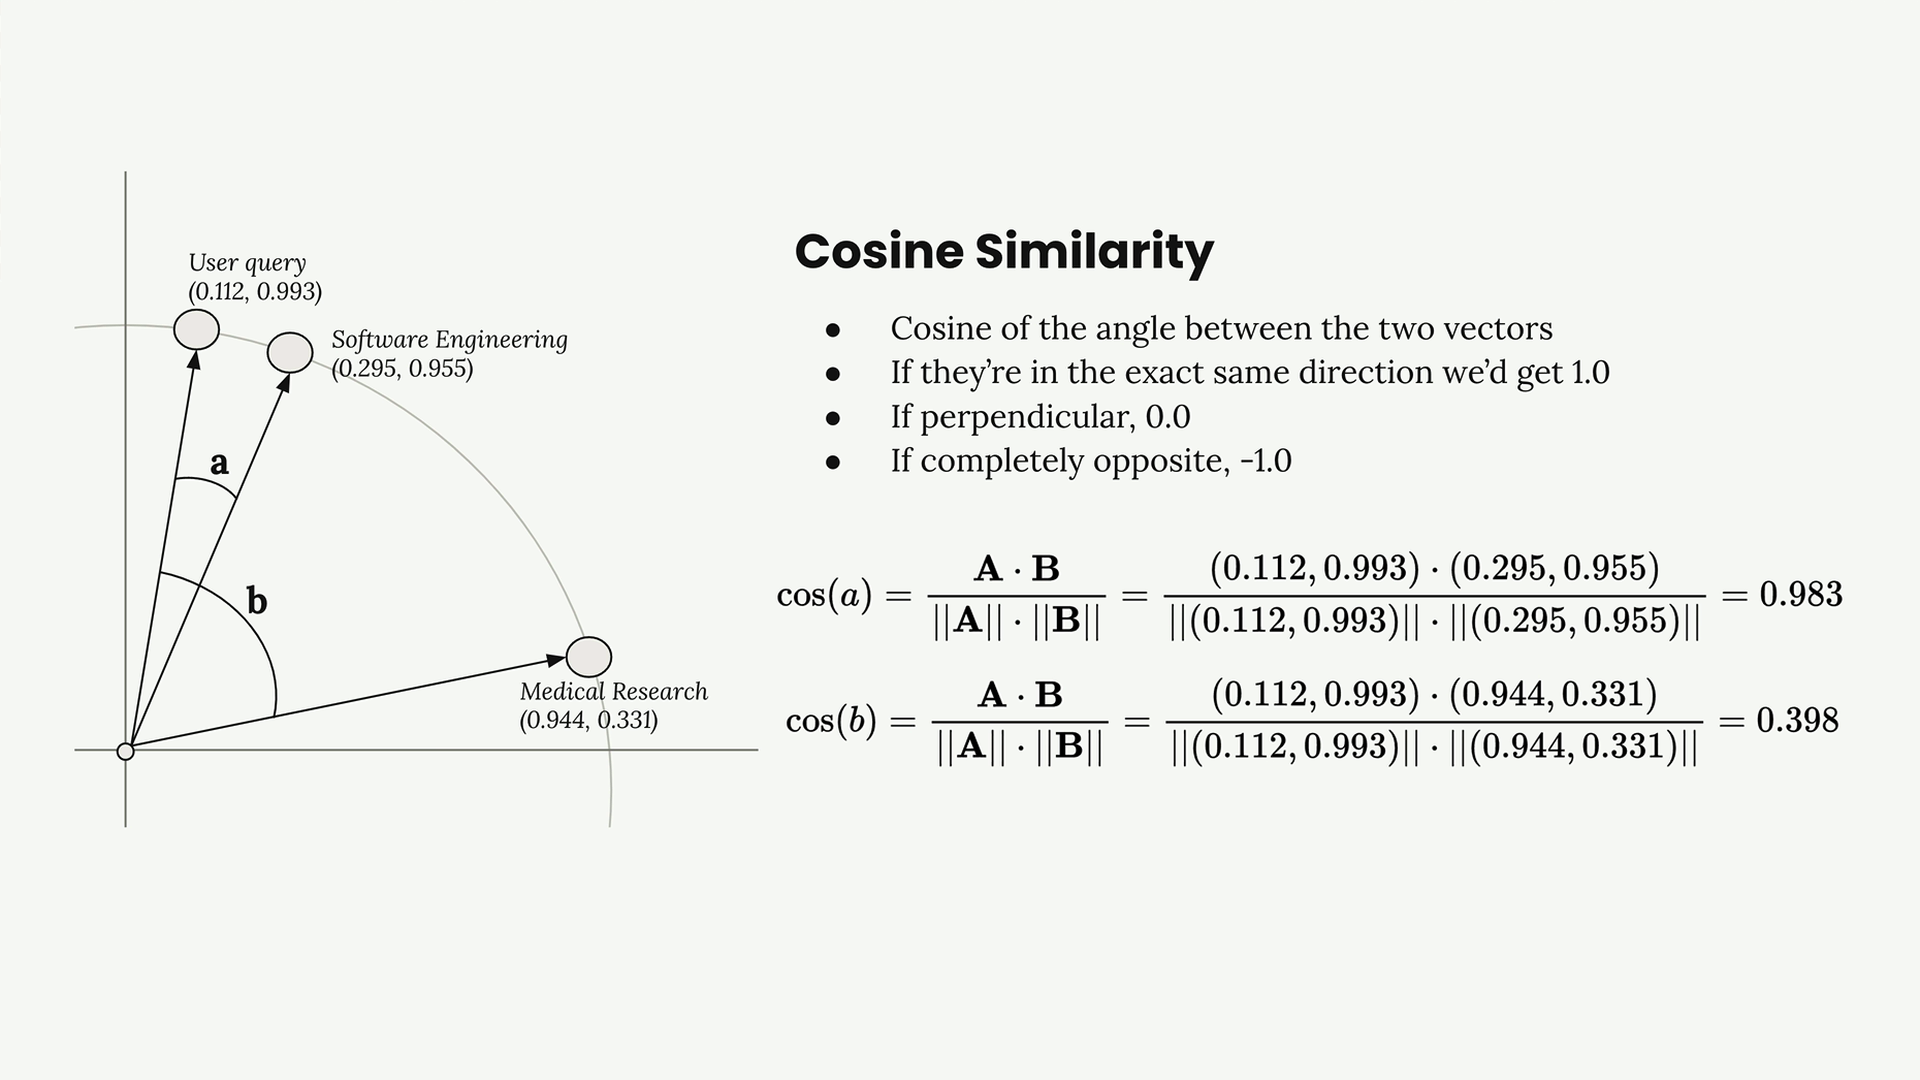
- 1,0 = Vektoren zeigen in genau dieselbe Richtung (sehr ähnlich)
- 0,0 = Vektoren stehen senkrecht zueinander (nicht verwandt)
- -1,0 = Vektoren zeigen in entgegengesetzte Richtungen (sehr unterschiedlich)
In unserem Beispiel:
- Nutzeranfrage vs. Softwareentwicklung: Kosinus-Ähnlichkeit = 0,983 (sehr ähnlich!)
- Nutzeranfrage vs. medizinische Forschung: Kosinus-Ähnlichkeit = 0,398 (weniger ähnlich)
Kosinus-Distanz
Du wirst in der Dokumentation von Vektordatenbanken häufig auf „Kosinus-Distanz" stoßen. Dies ist einfach 1 - Kosinus-Ähnlichkeit, was die Skala umkehrt, sodass kleinere Zahlen ähnlicher bedeuten:
- 0,0 = sehr ähnlich
- 1,0 = senkrecht
- 2,0 = vollständig entgegengesetzt
Schritt 6: Den finalen Prompt erstellen
Schließlich nehmen wir die Frage des Nutzers und den relevantesten Text-Chunk (den Abschnitt zur Softwareentwicklung) und kombinieren sie zu einem Prompt für Claude:
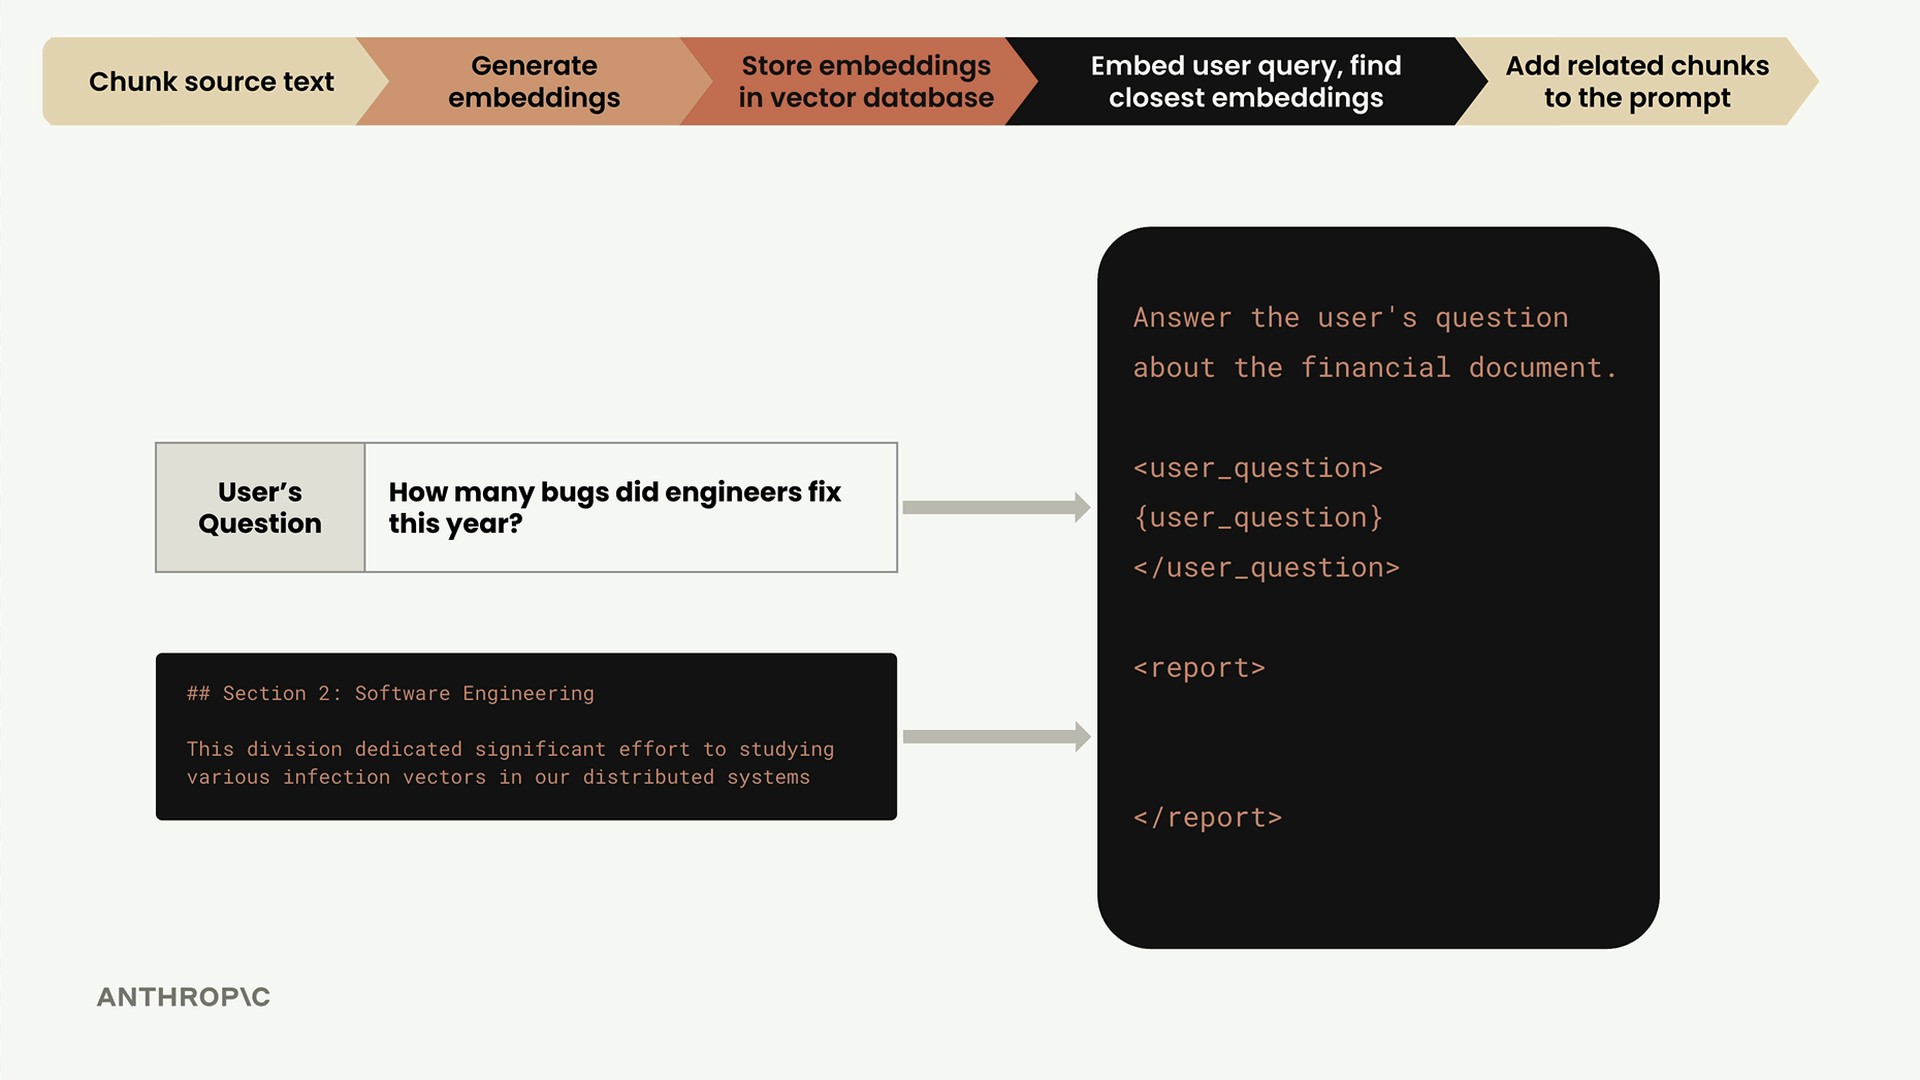
Answer the user's question about the financial document.

<user_question>
How many bugs did engineers fix this year?
</user_question>

<report>
## Section 2: Software Engineering
This division dedicated significant effort to studying various infection vectors in our distributed systems
</report>Und das ist die vollständige RAG-Pipeline! Das System hat erfolgreich den relevantesten Kontext für die Softwareentwicklungsfrage des Nutzers gefunden und ihn Claude zur Generierung einer fundierten Antwort bereitgestellt.
Dieser Prozess läuft automatisch jedes Mal ab, wenn ein Nutzer eine Anfrage stellt, und ermöglicht es Claude, Fragen basierend auf deinen spezifischen Dokumenten zu beantworten, anstatt sich nur auf sein allgemeines Trainingswissen zu stützen.