Wenn du sowohl semantische Suche (Vektor-Embeddings) als auch lexikalische Suche (BM25) unabhängig voneinander am Laufen hast, besteht der nächste Schritt darin, sie in einer einheitlichen Such-Pipeline zu kombinieren. Dieser hybride Ansatz nutzt die Stärken beider Methoden, um genauere Ergebnisse zu liefern.
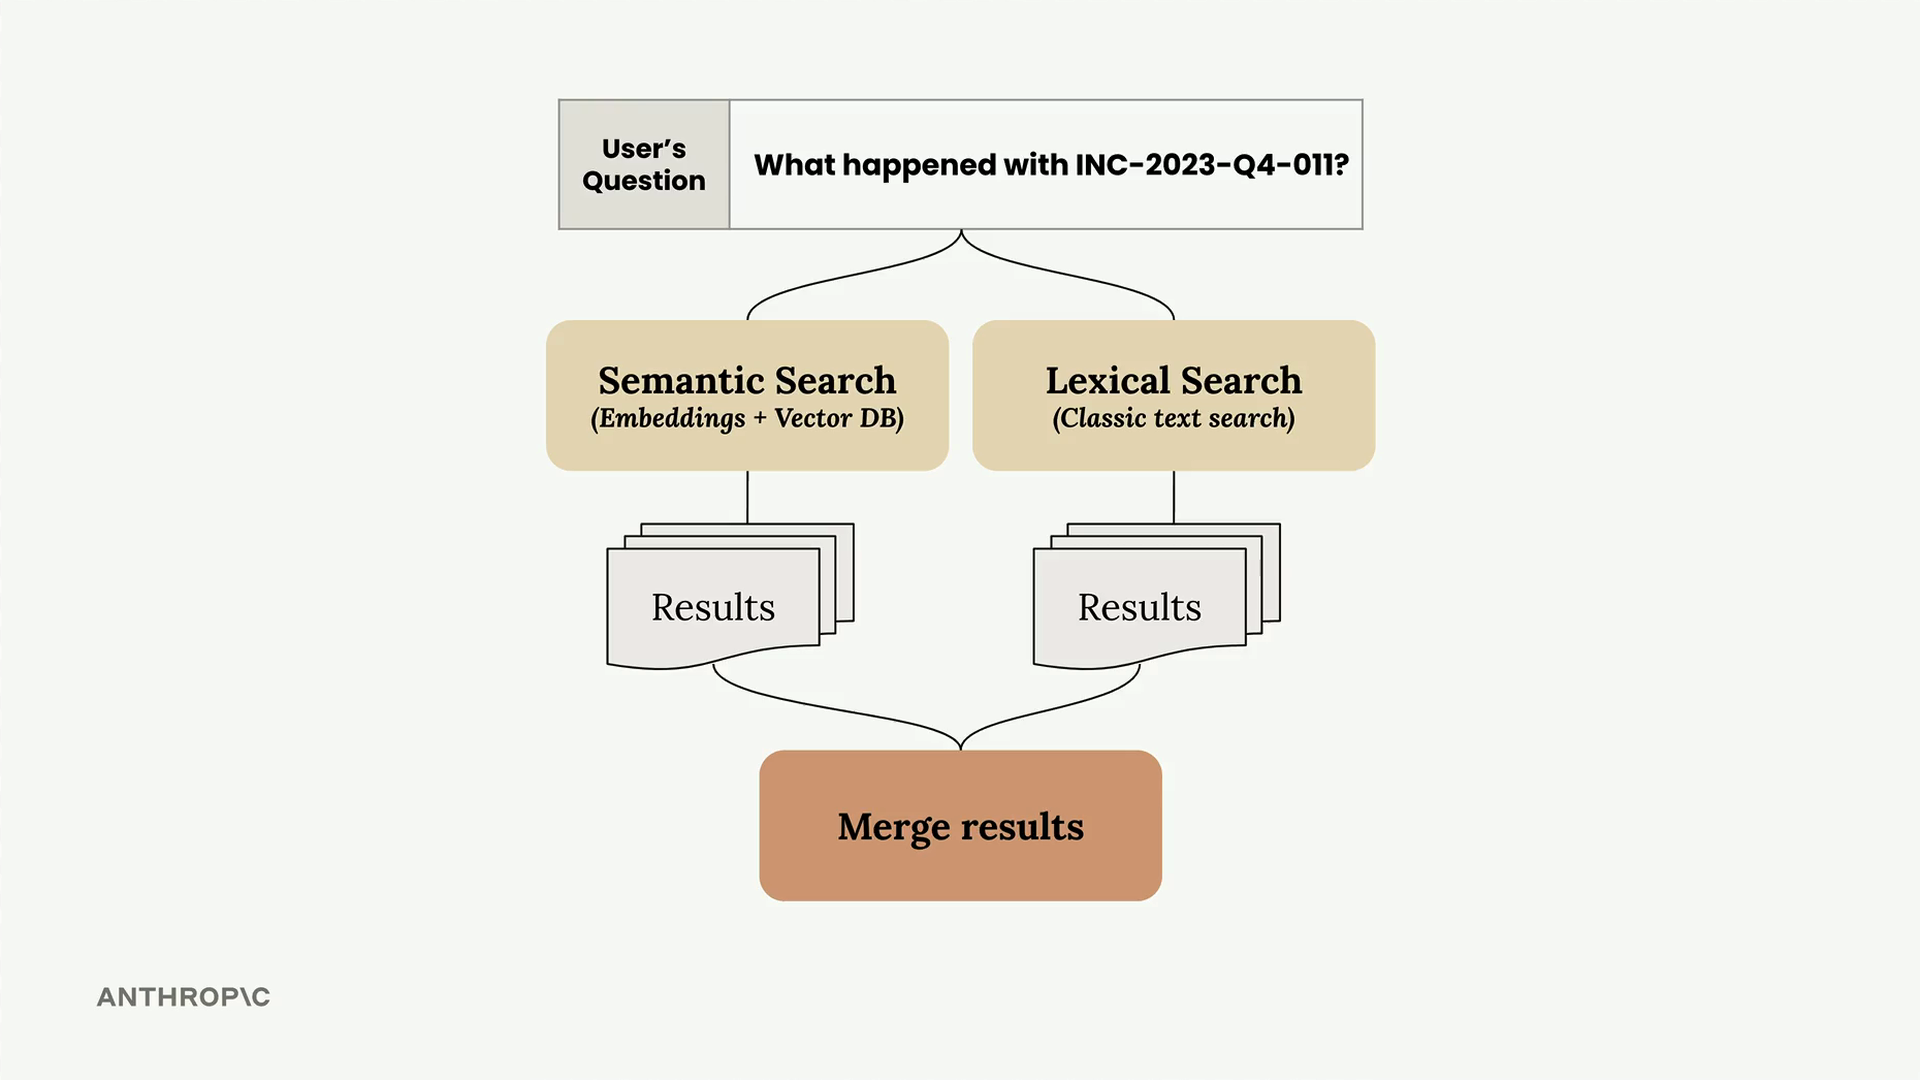
Erstellen einer einheitlichen Schnittstelle
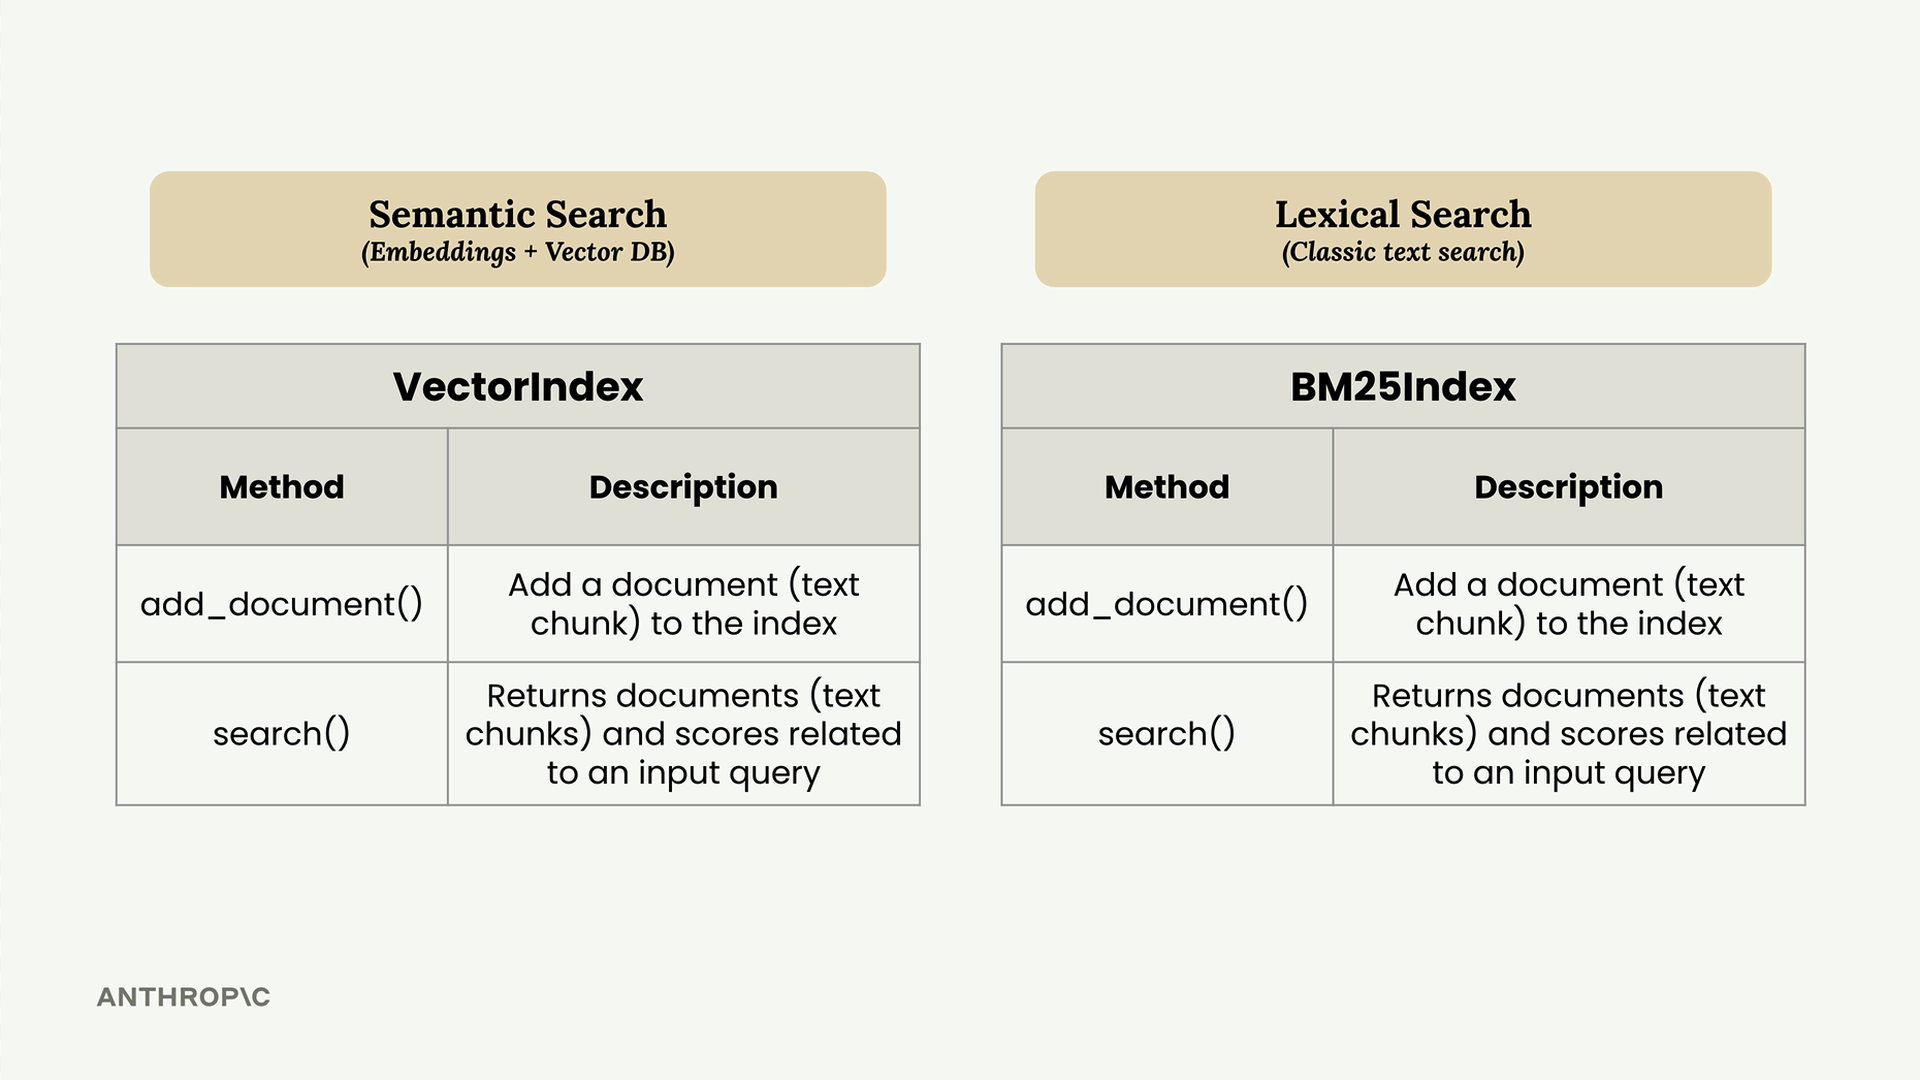
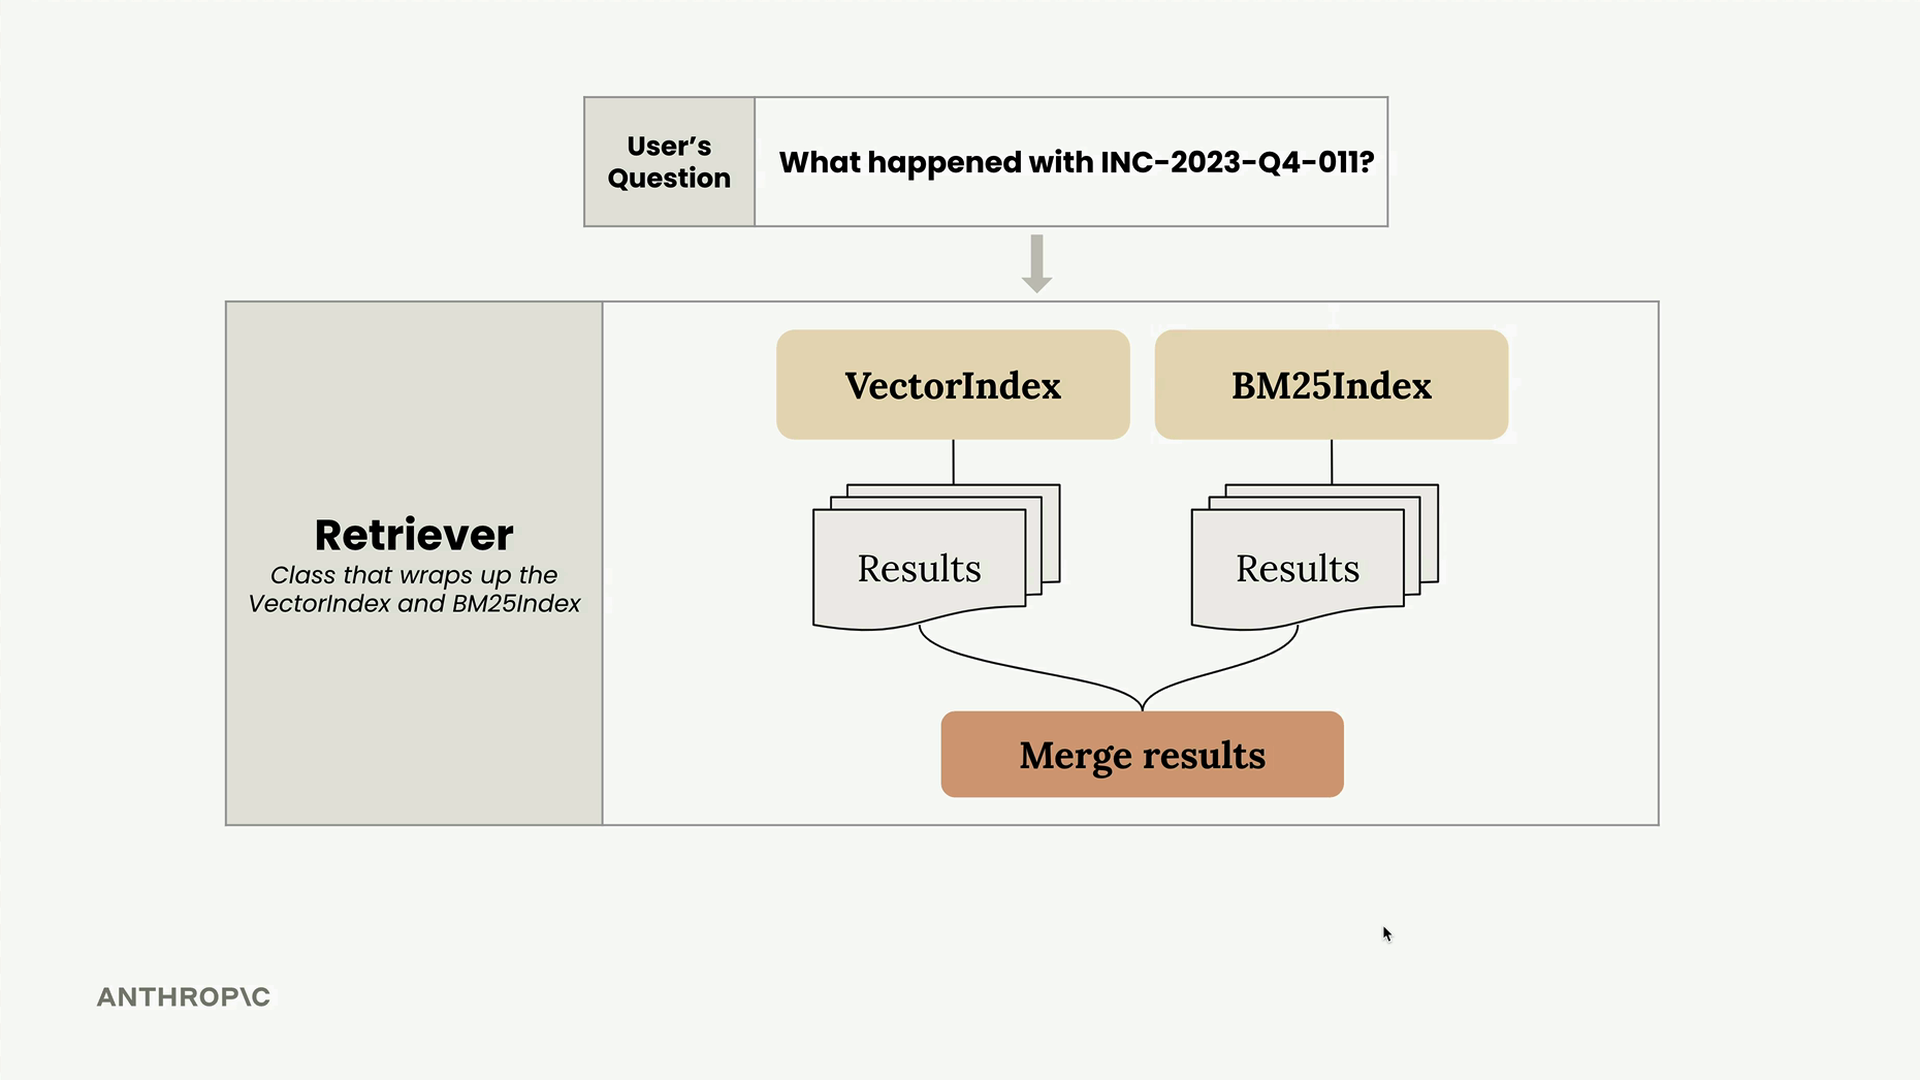
Beide Suchimplementierungen teilen sich nahezu identische APIs - beide verfügen über add_document()- und search()-Methoden, die auf die gleiche Weise funktionieren. Diese Konsistenz macht es einfach, sie in einer einzigen Retriever-Klasse zu kapseln.
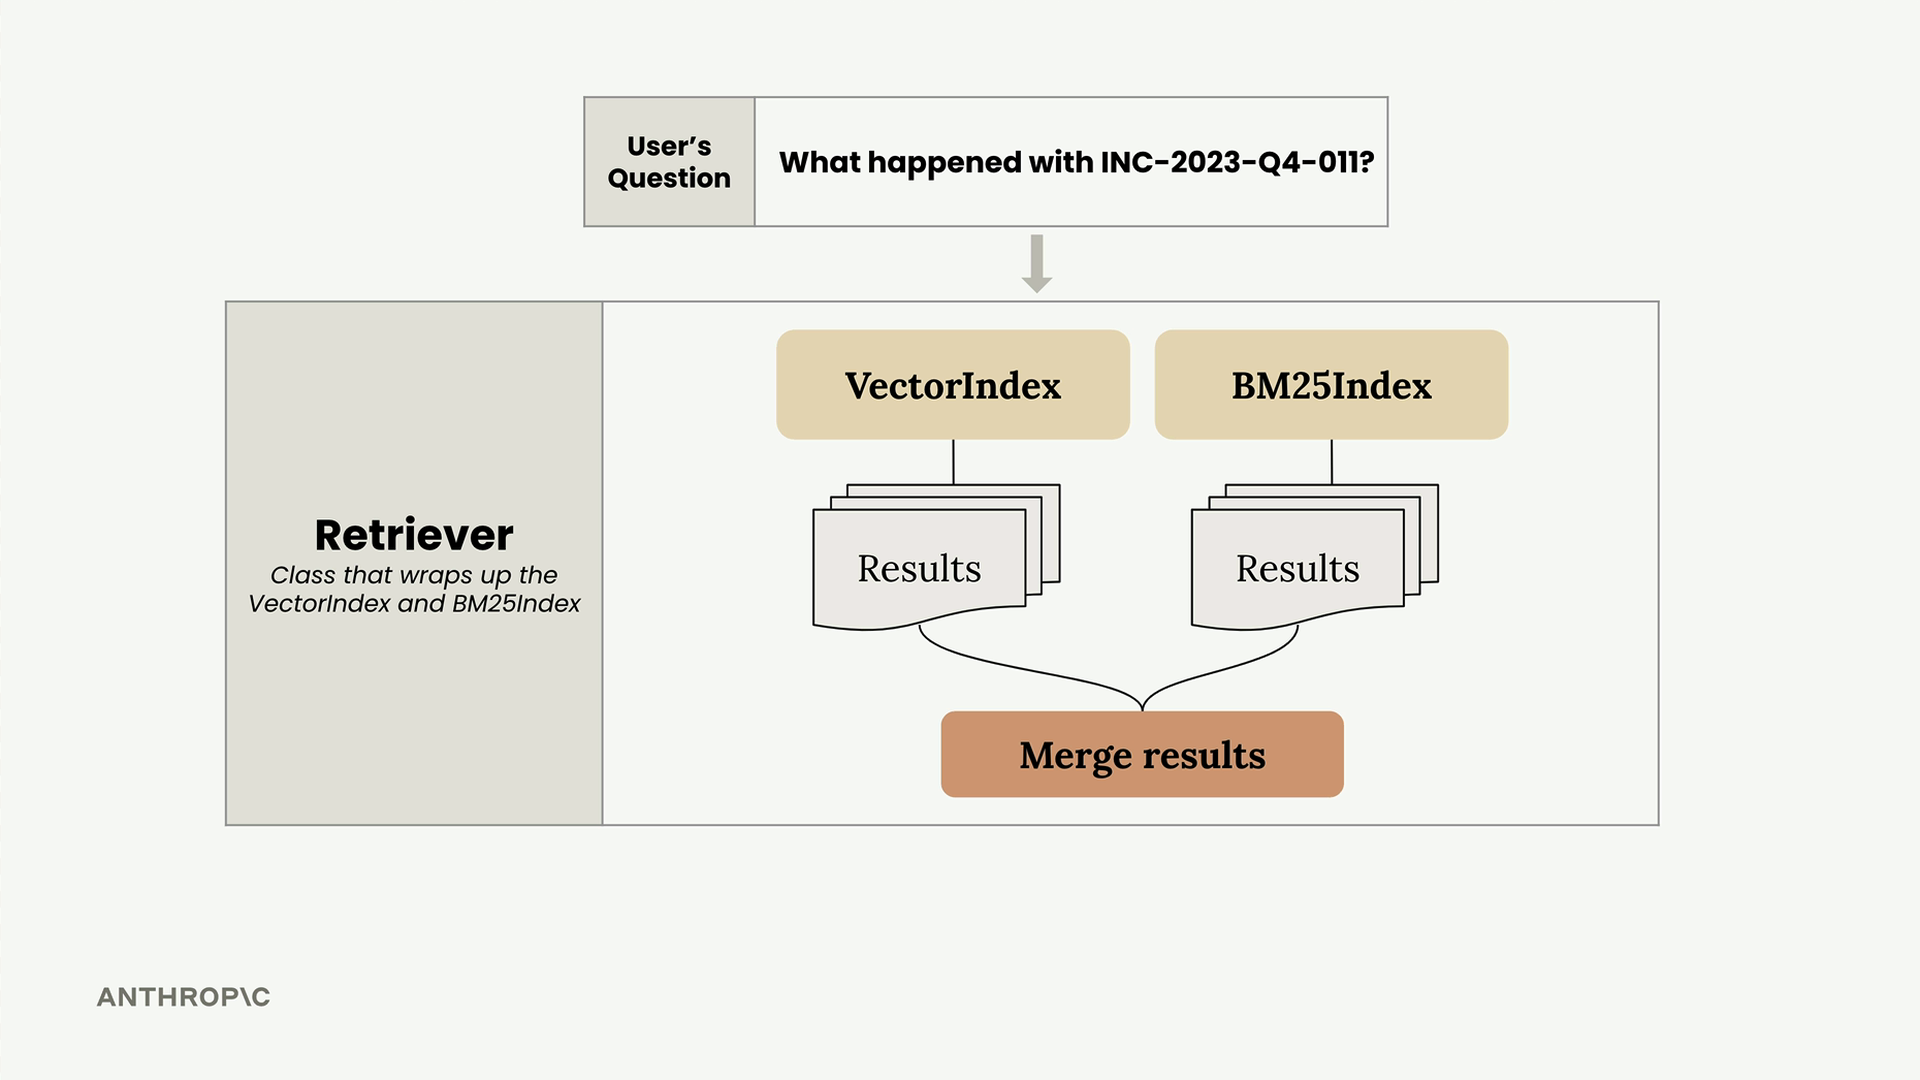
Der Retriever fungiert als Koordinator, der Benutzeranfragen an beide Indizes weiterleitet, deren Ergebnisse sammelt und sie zu einer einzigen, geordneten Liste zusammenführt.
Reciprocal Rank Fusion
Die Herausforderung besteht darin, Ergebnisse aus verschiedenen Suchmethoden zusammenzuführen, die unterschiedliche Bewertungssysteme verwenden. Die Vektorsuche liefert Kosinus-Ähnlichkeitswerte, während BM25 Relevanzwerte liefert - du kannst diese Zahlen nicht einfach direkt kombinieren.
Stattdessen verwenden wir eine Technik namens Reciprocal Rank Fusion (RRF). Diese Methode konzentriert sich auf die Rangposition der Ergebnisse und nicht auf ihre Rohwerte.
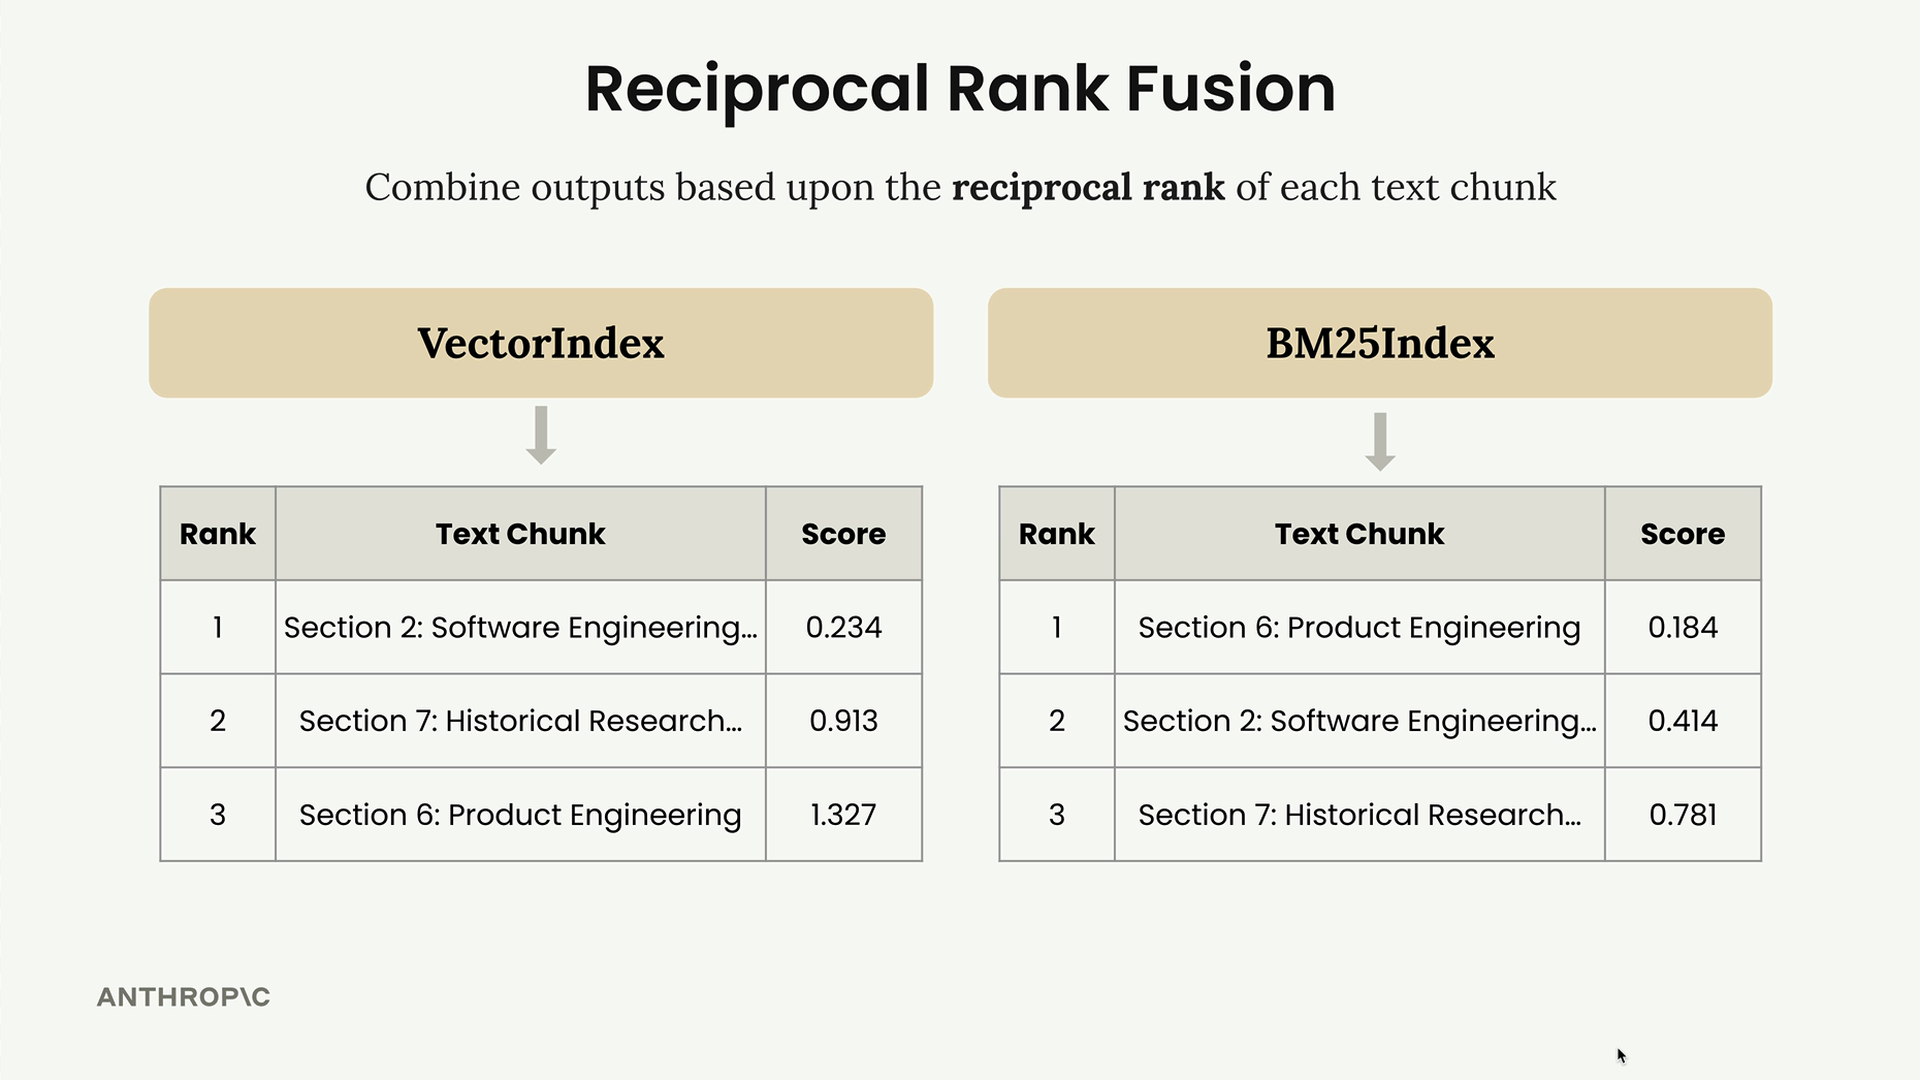
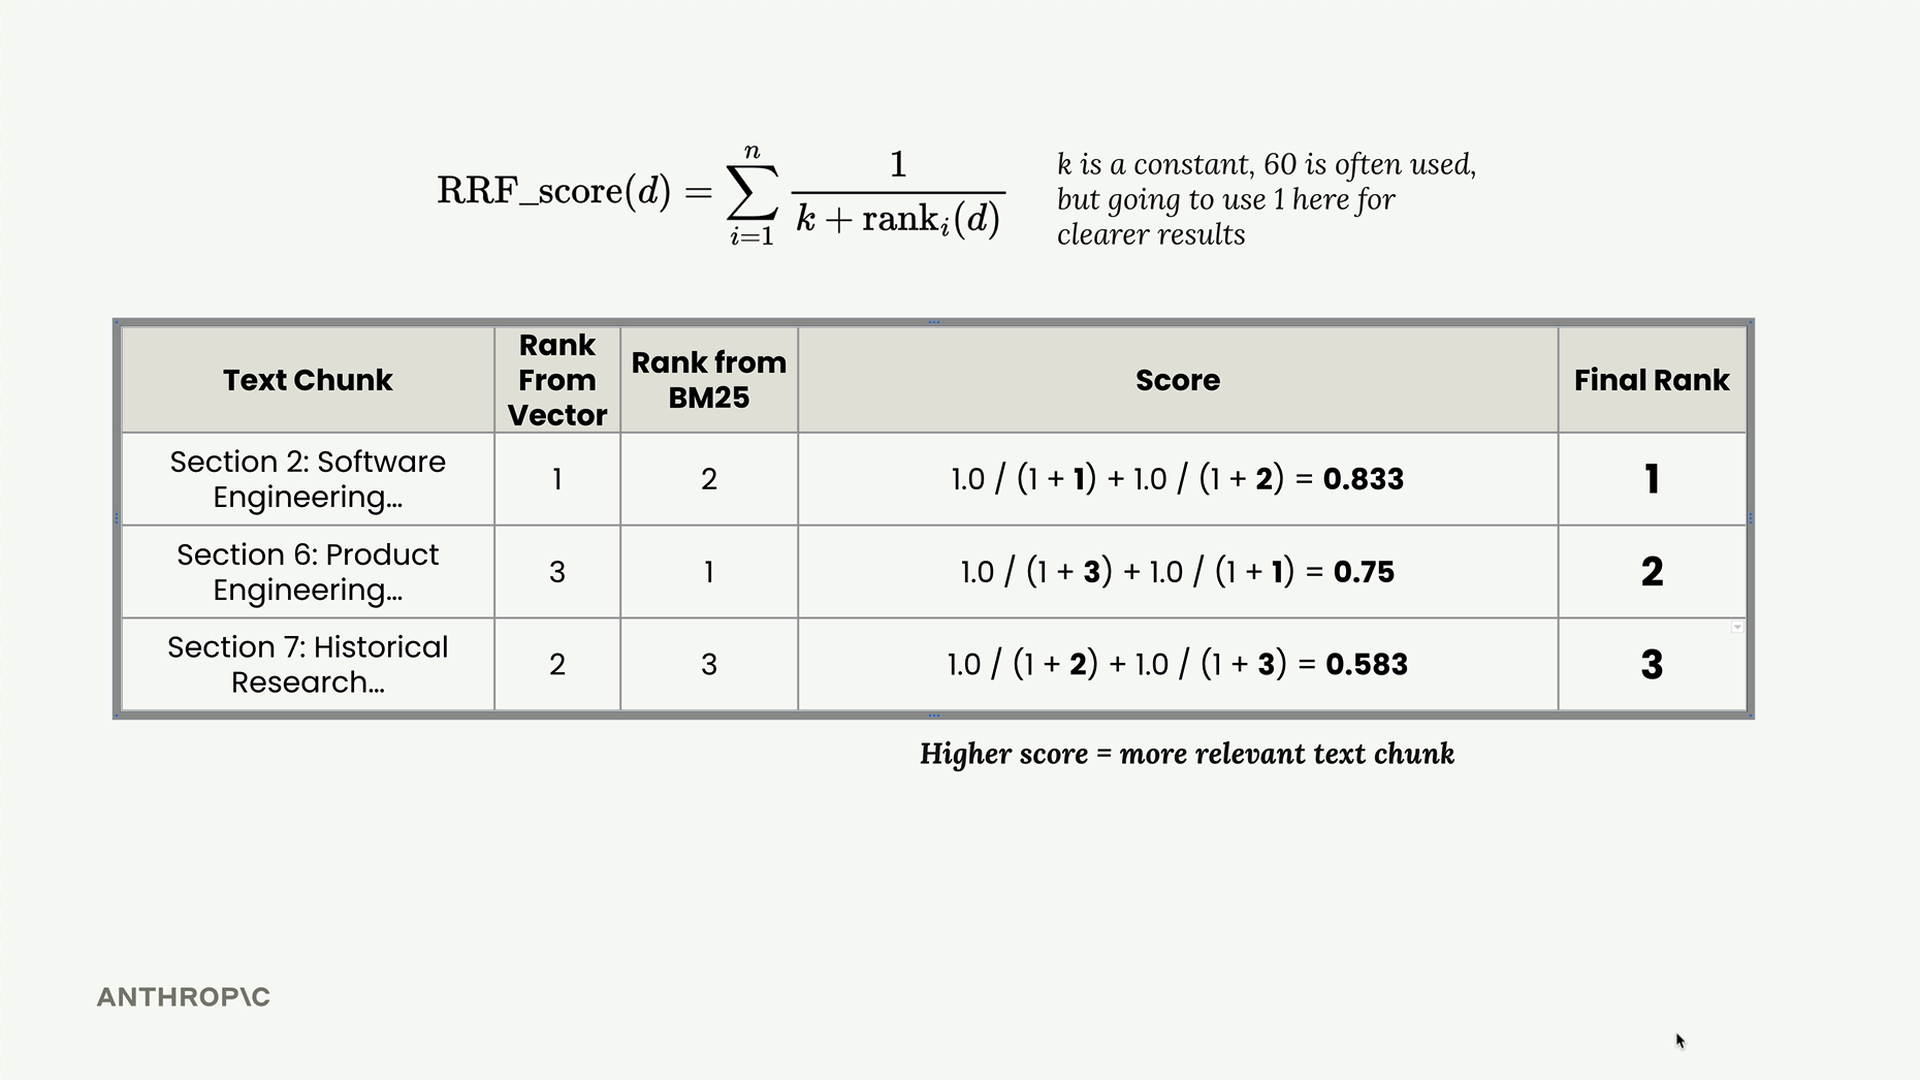
So funktioniert es an einem Beispiel. Angenommen, deine Vektorsuche liefert die Abschnitte 2, 7 und 6 in dieser Reihenfolge, während BM25 die Abschnitte 6, 2 und 7 liefert. Um diese zusammenzuführen:
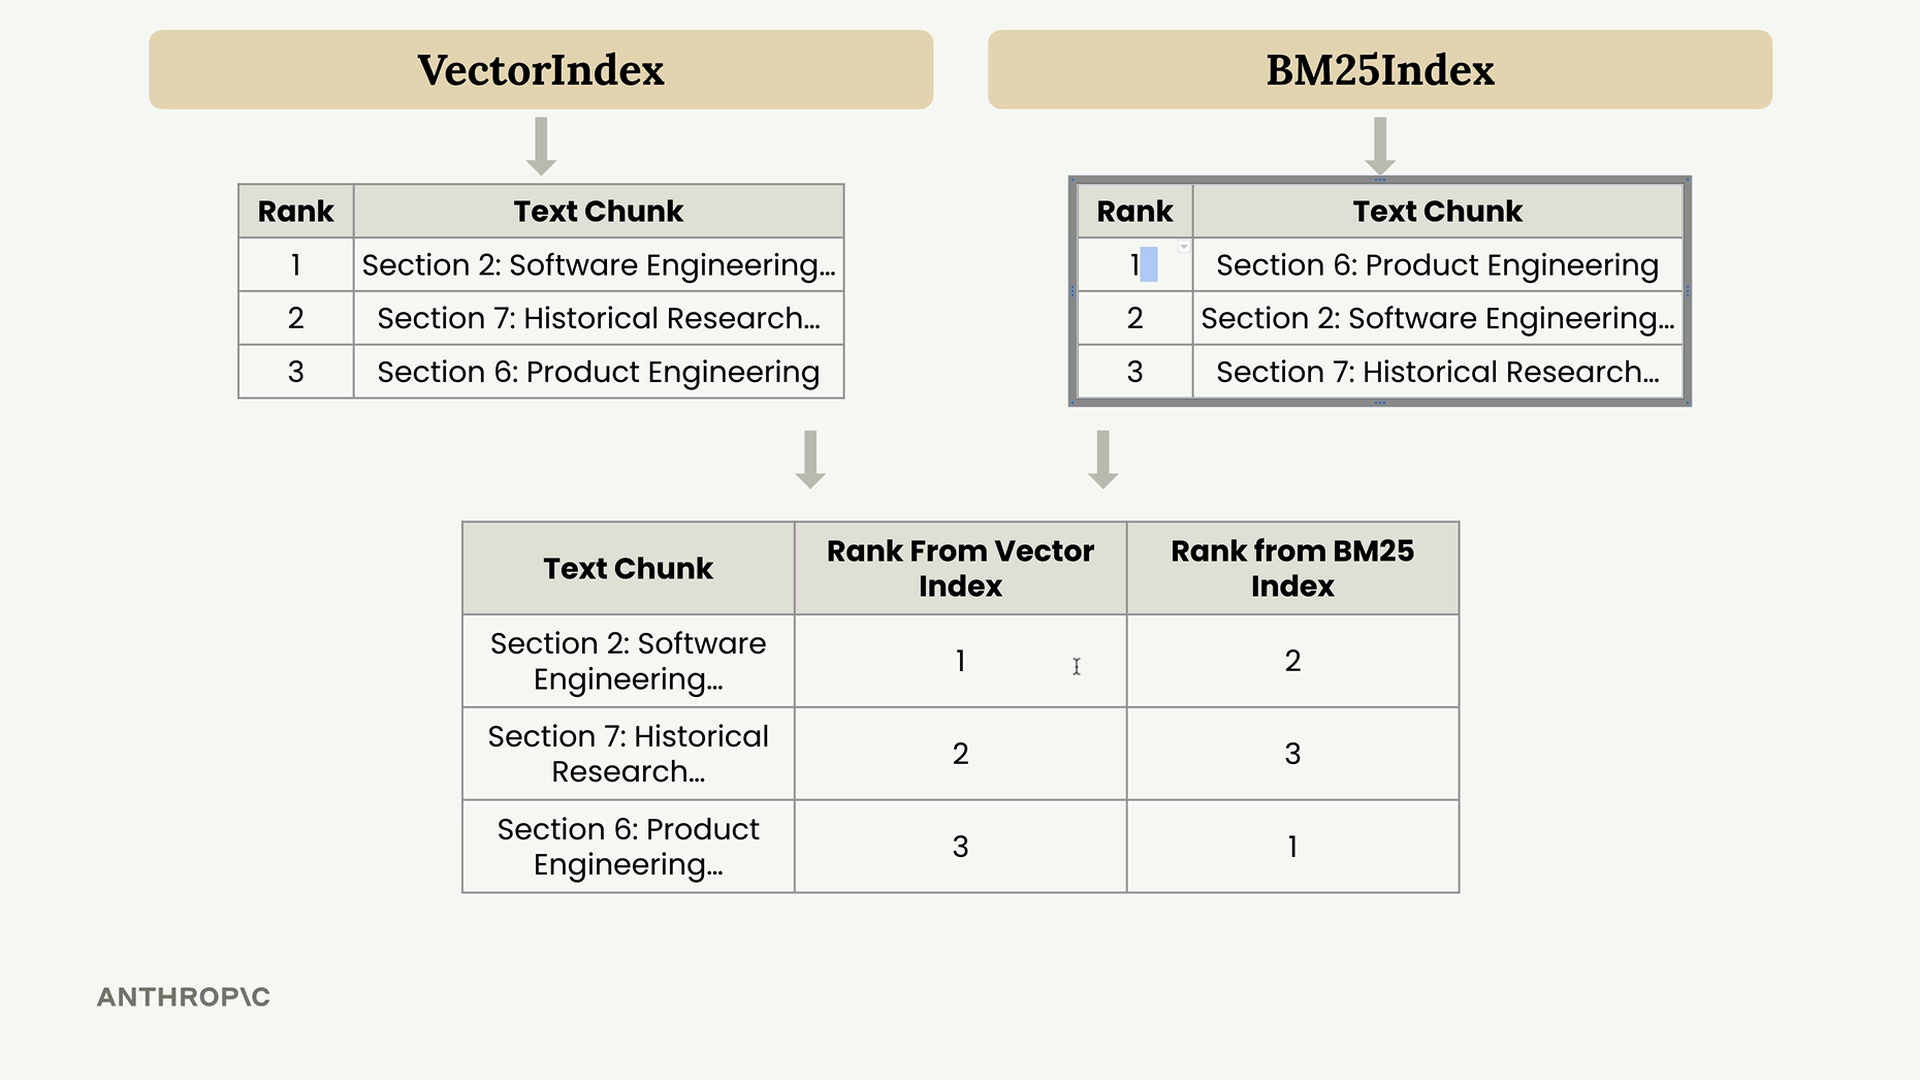
Erstelle zunächst eine Tabelle, die jeden Textabschnitt und seinen Rang aus beiden Suchmethoden zeigt:
- Abschnitt 2: Rang 1 von Vektor, Rang 2 von BM25
- Abschnitt 7: Rang 2 von Vektor, Rang 3 von BM25
- Abschnitt 6: Rang 3 von Vektor, Rang 1 von BM25
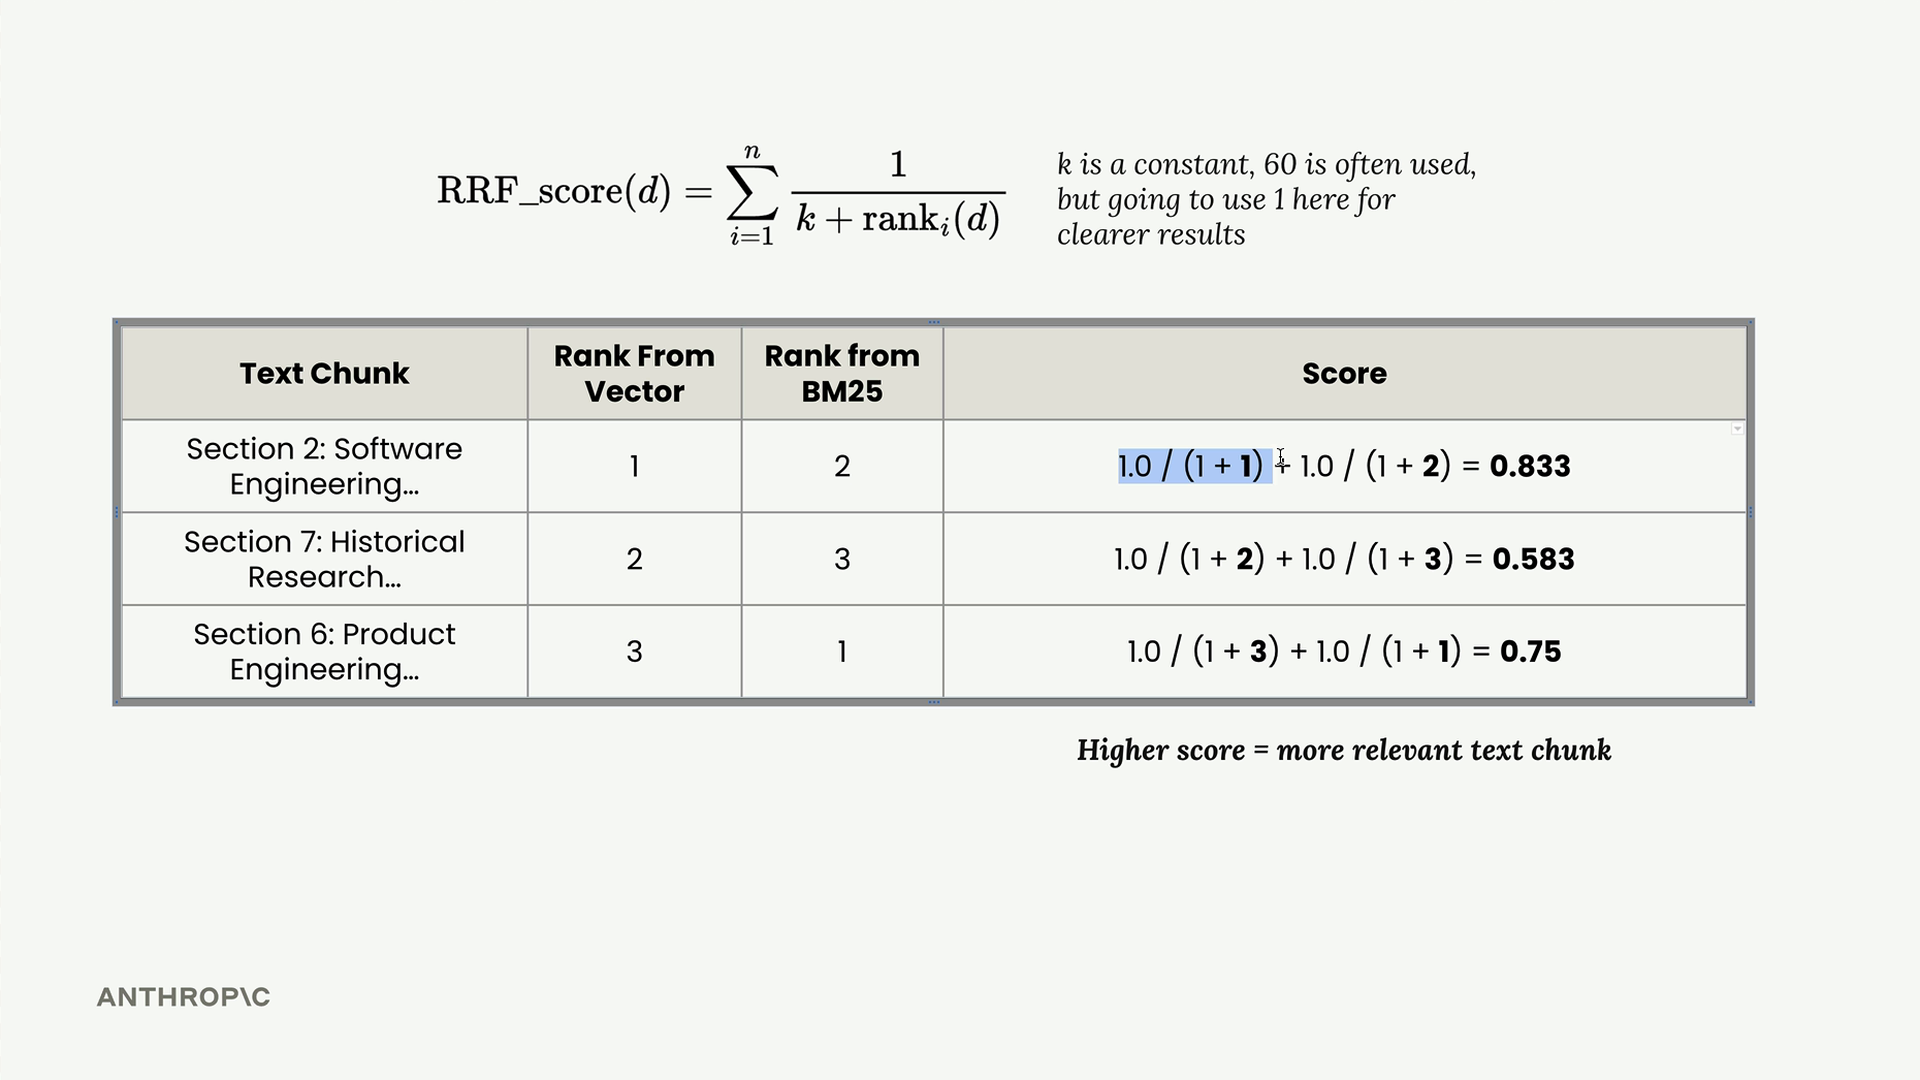
Wende dann die RRF-Formel an, um einen kombinierten Score für jeden Abschnitt zu berechnen:
RRF_score(d) = Σ(1 / (k + rank_i(d)))Dabei ist k eine Konstante (typischerweise 60, aber wir verwenden 1 für klarere Ergebnisse) und rank_i(d) ist der Rang des Dokuments d im i-ten Suchergebnis.
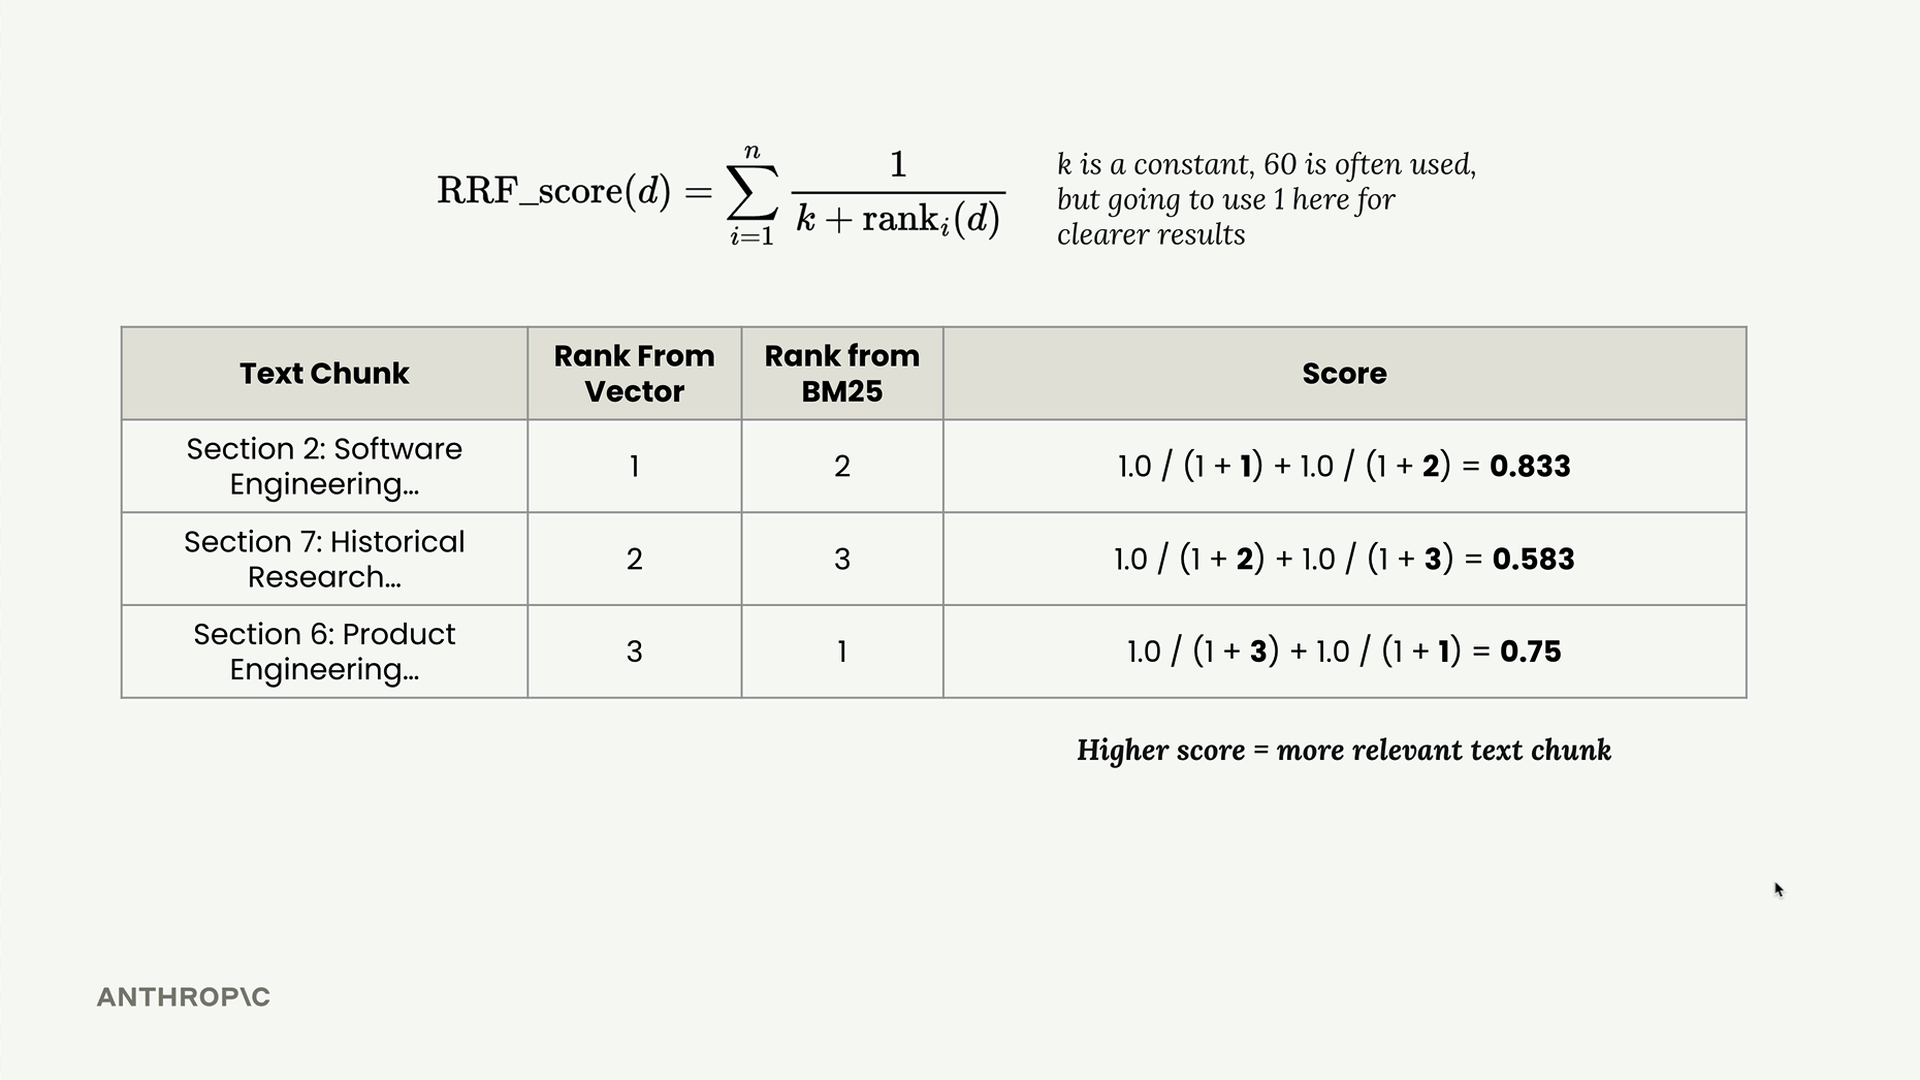
Für unser Beispiel:
- Abschnitt 2: 1,0/(1+1) + 1,0/(1+2) = 0,833
- Abschnitt 7: 1,0/(1+2) + 1,0/(1+3) = 0,583
- Abschnitt 6: 1,0/(1+3) + 1,0/(1+1) = 0,75
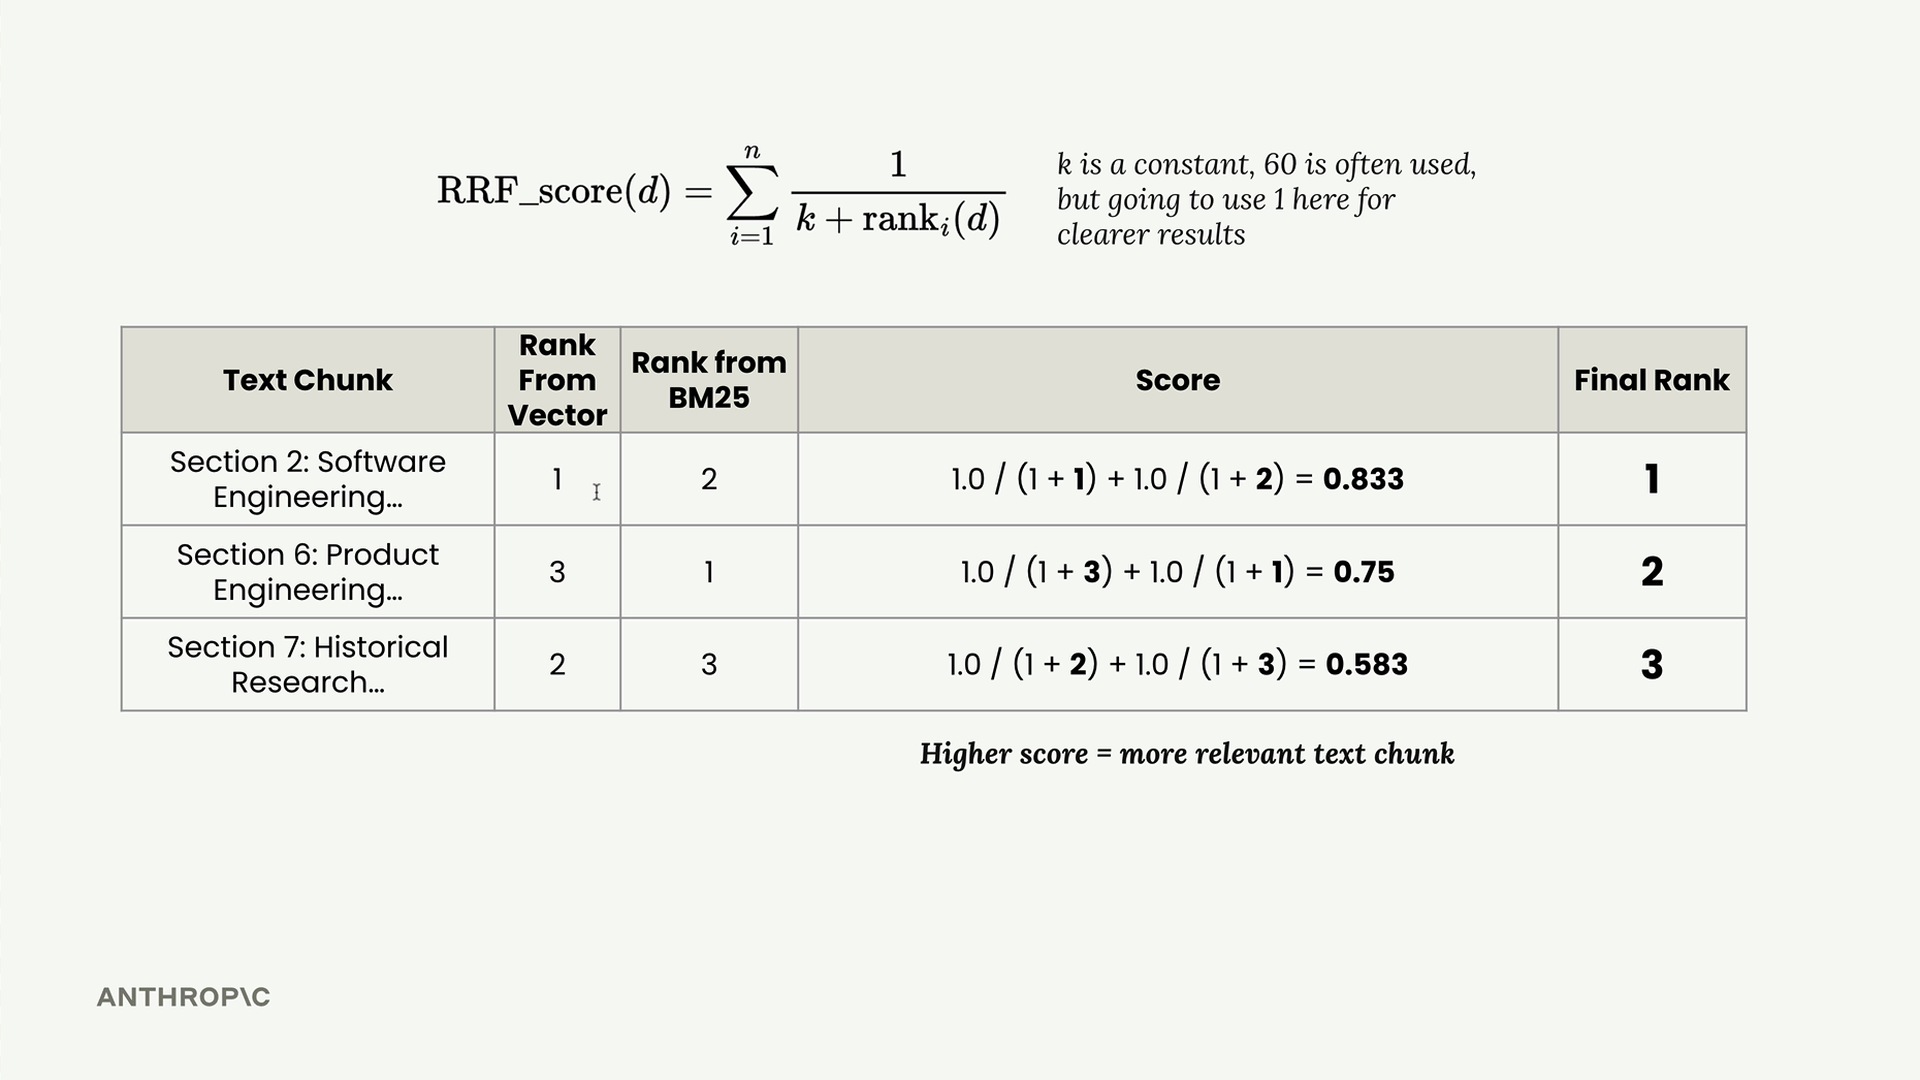
Die endgültige Rangfolge lautet: Abschnitt 2 (0,833), Abschnitt 6 (0,75), Abschnitt 7 (0,583). Das ergibt intuitiv Sinn - Abschnitt 2 hat in beiden Suchen gut abgeschnitten, Abschnitt 6 hatte gemischte Ergebnisse, und Abschnitt 7 lag insgesamt niedriger.
Implementierung
Die Implementierung der Retriever-Klasse ist unkompliziert:
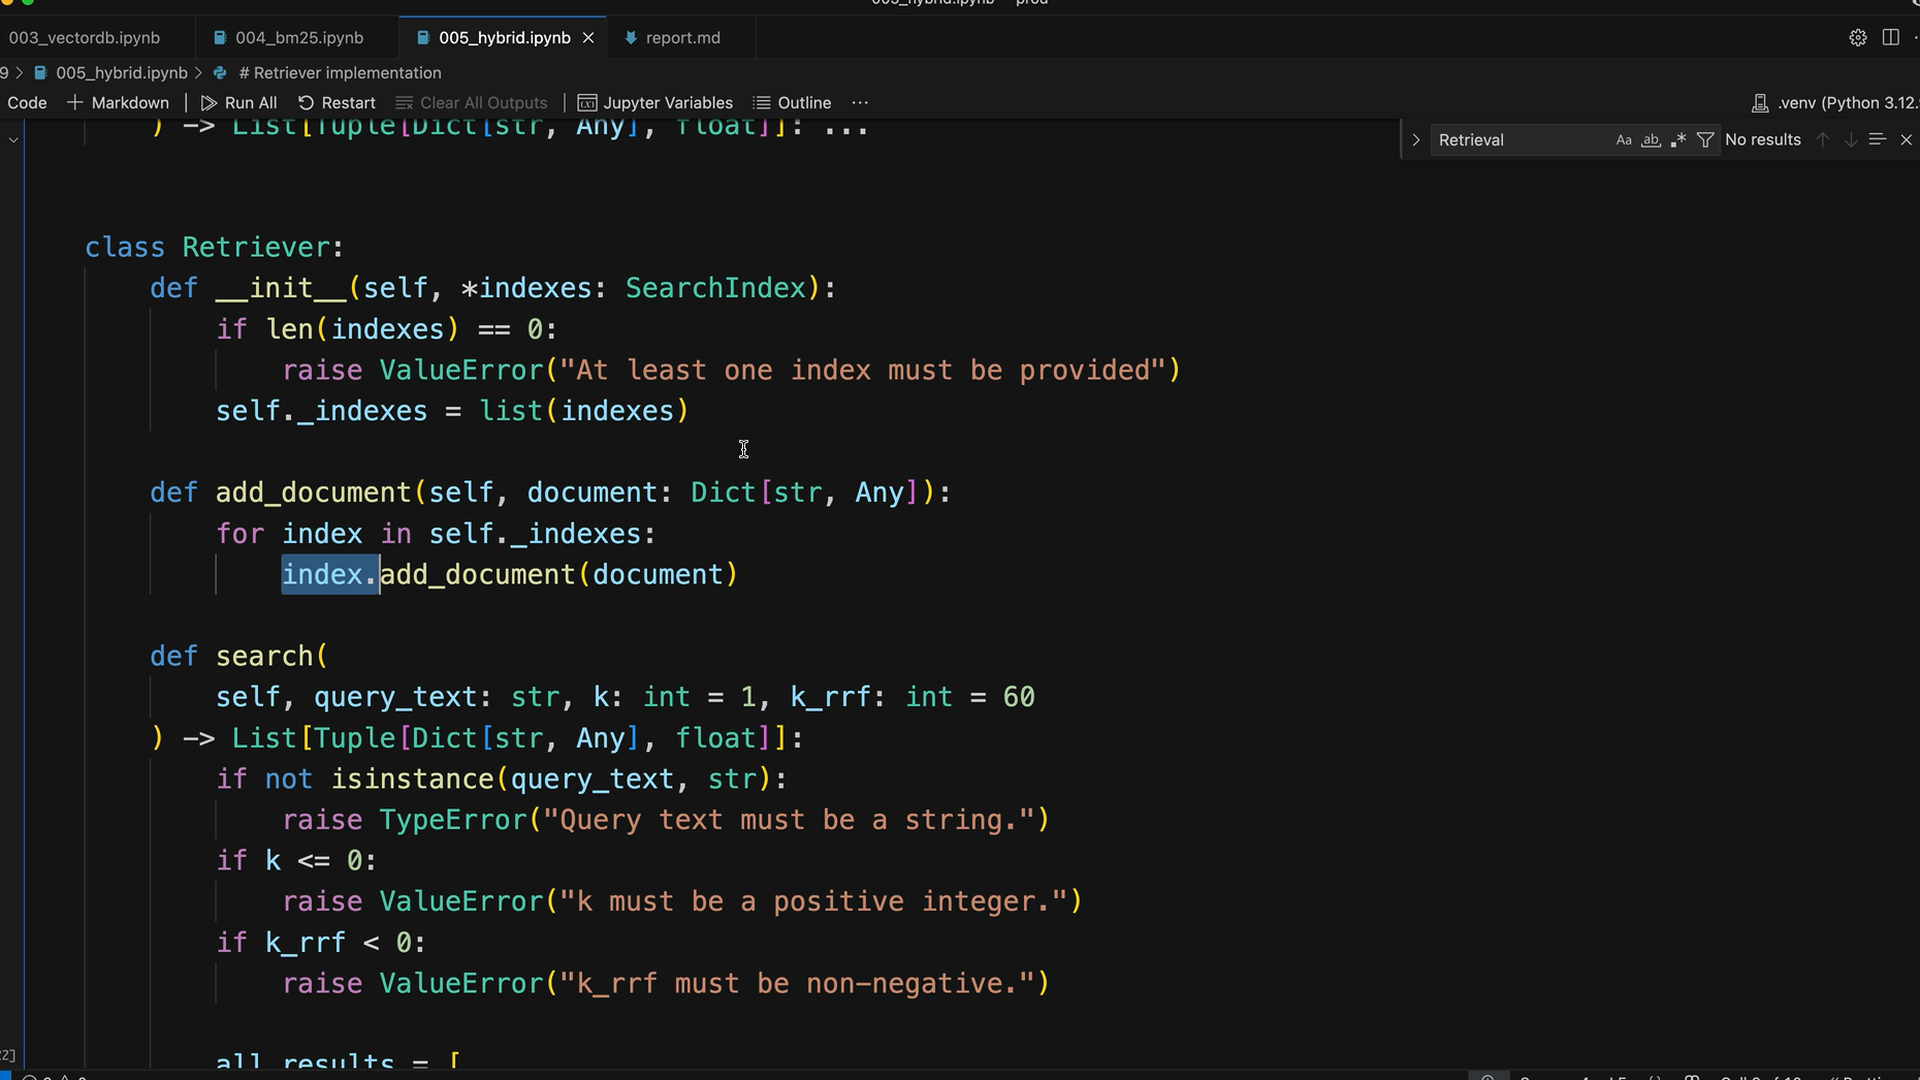
class Retriever:
    def __init__(self, *indexes):
        self._indexes = list(indexes)

    def add_document(self, document):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text, k=1, k_rrf=60):
        # Ergebnisse aus allen Indizes abrufen
        all_results = [index.search(query_text, k) for index in self._indexes]

        # Reciprocal Rank Fusion anwenden
        # ... Merge-Logik hier ...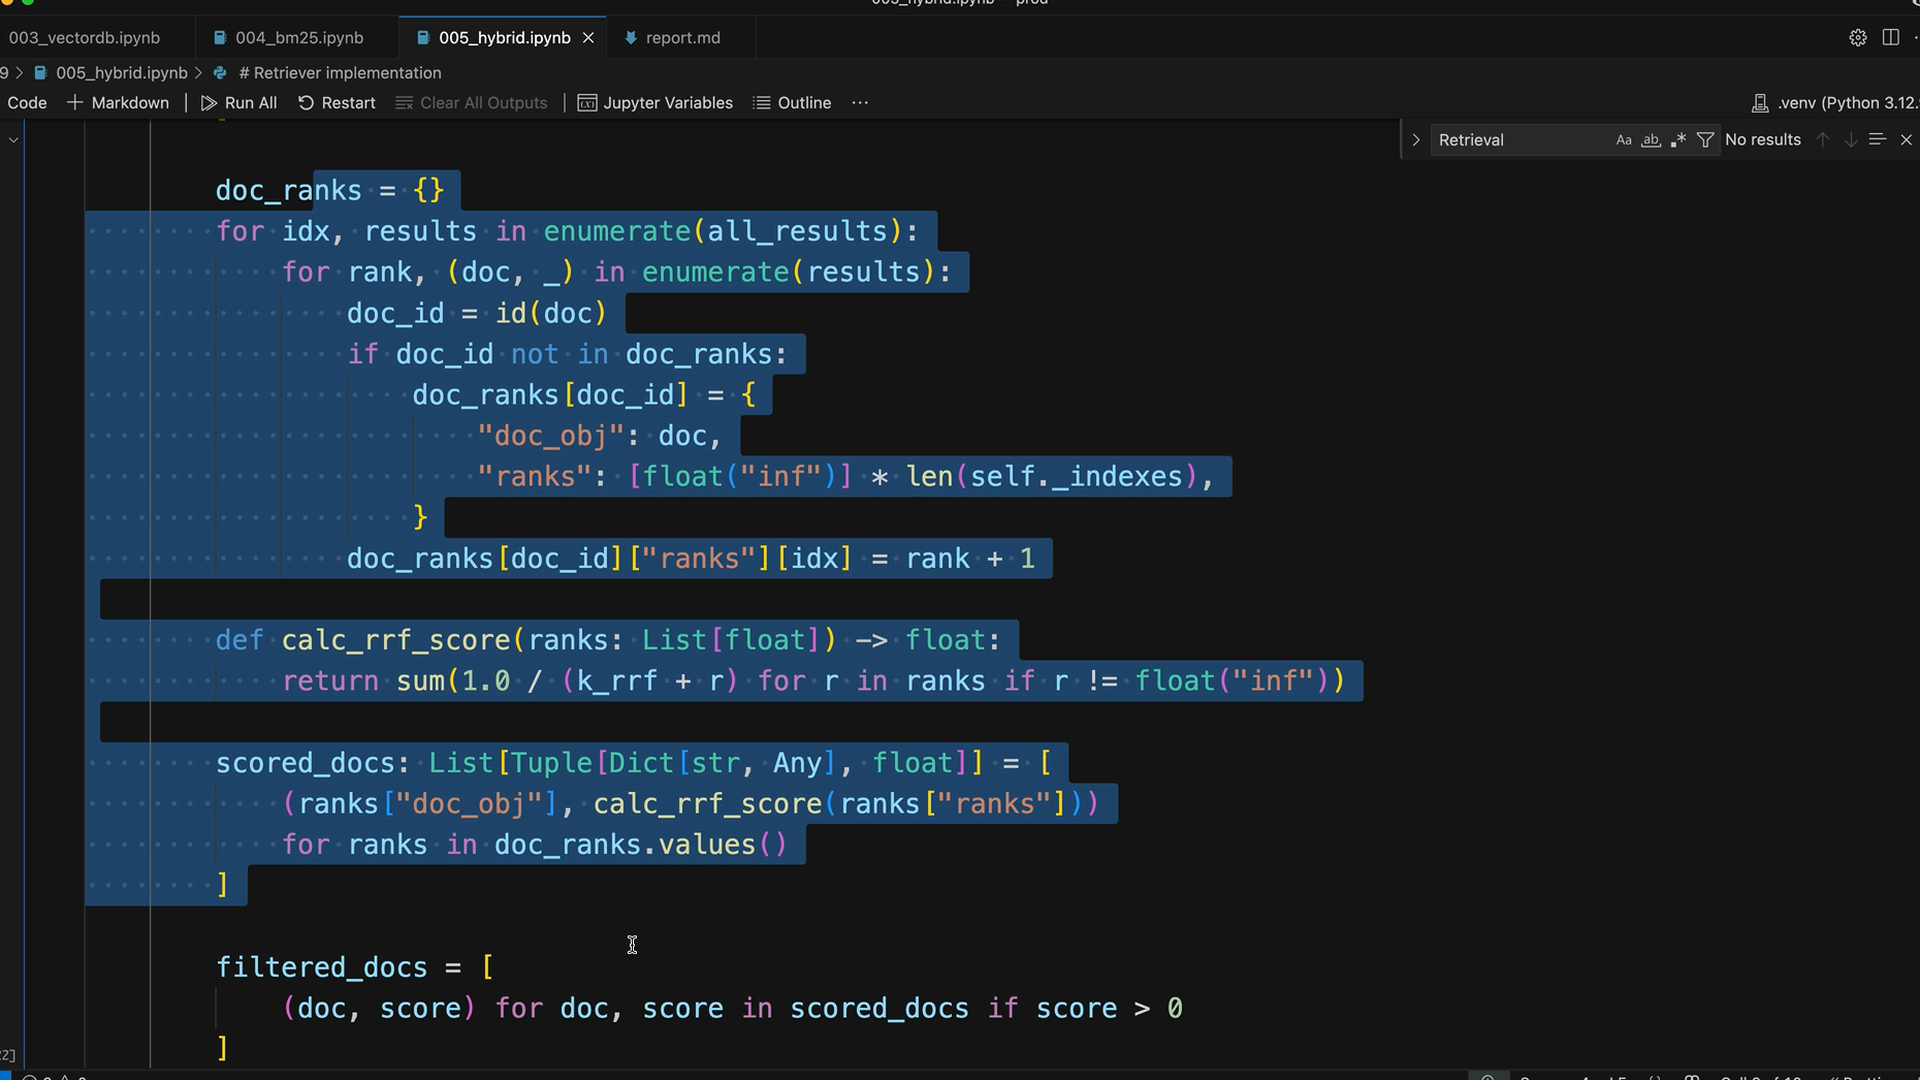
Die Merge-Logik verfolgt die Dokumentränge über alle Suchergebnisse hinweg, berechnet RRF-Scores und gibt die Top-k-Dokumente sortiert nach ihren kombinierten Scores zurück.
Testen des hybriden Ansatzes
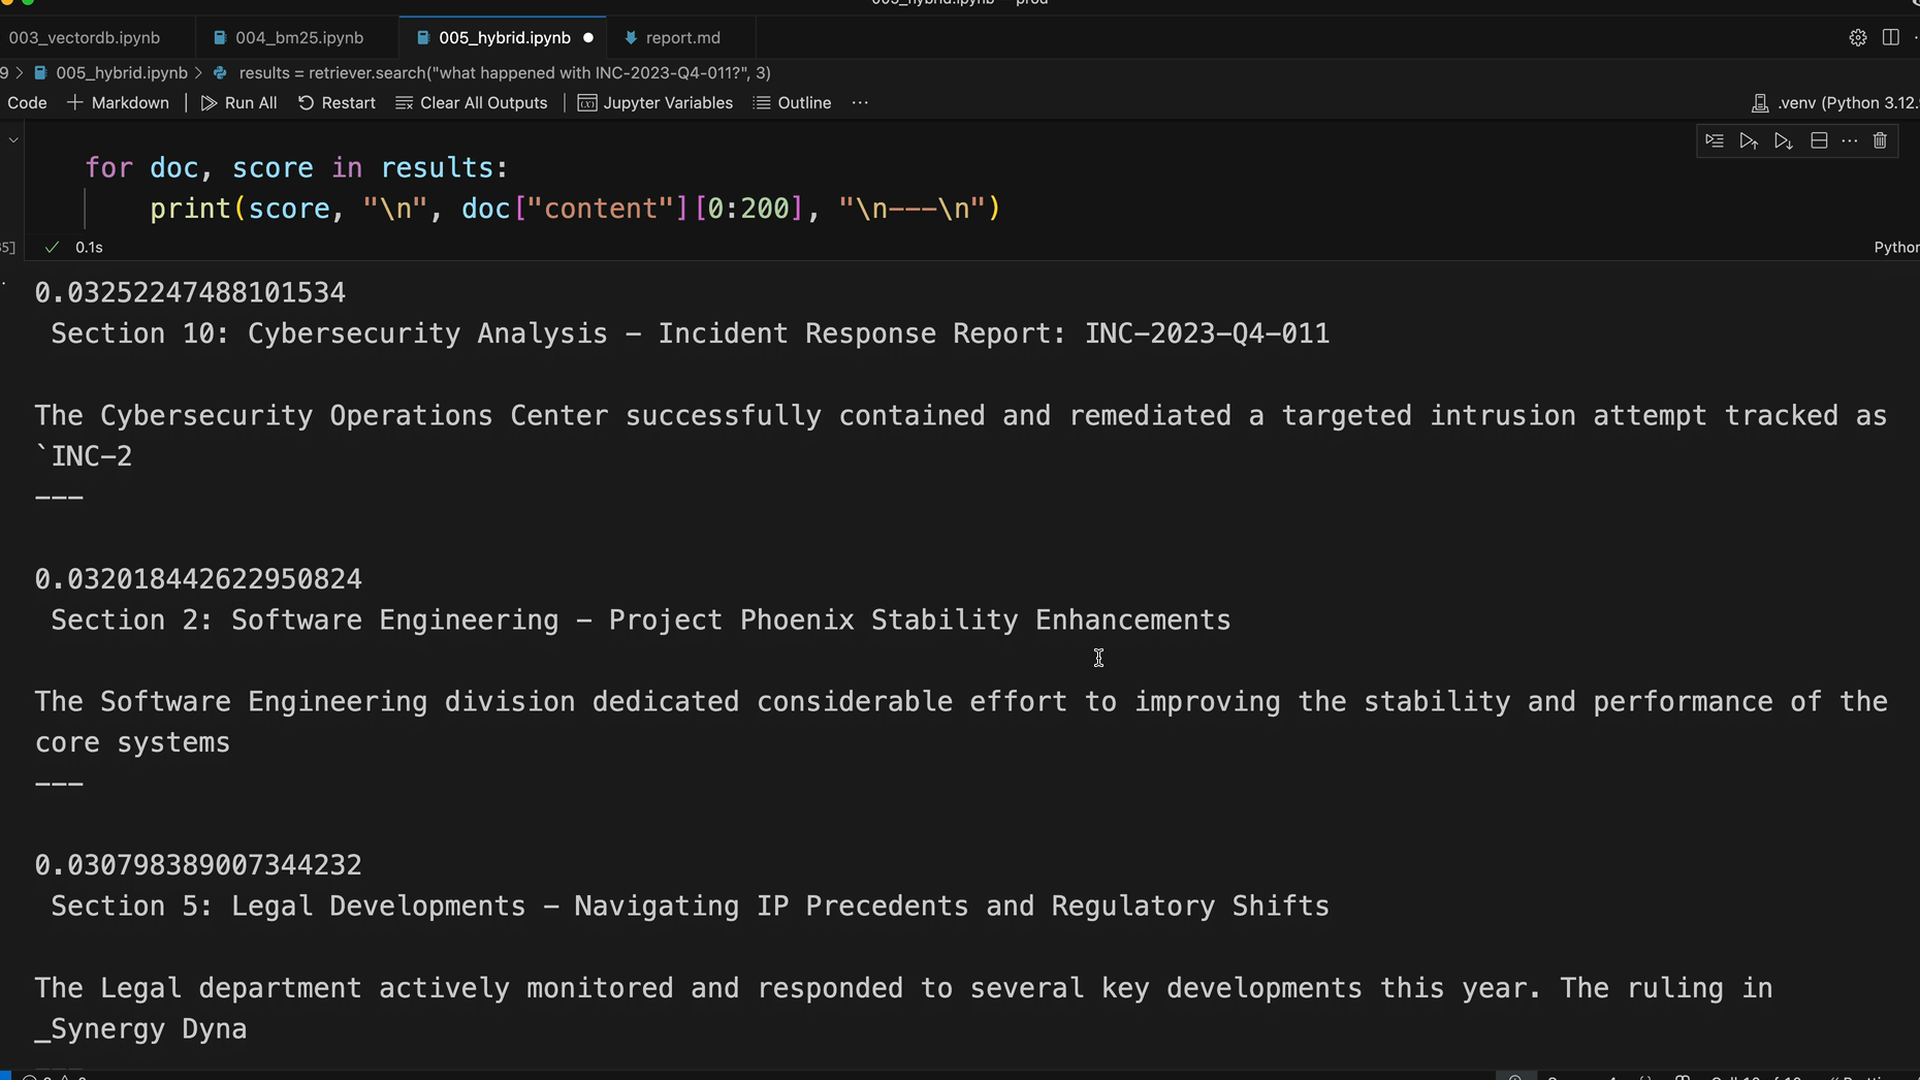
Beim Testen mit der Anfrage „what happened with INC-2023-Q4-011?" liefert der hybride Ansatz deutlich bessere Ergebnisse als die Vektorsuche allein:
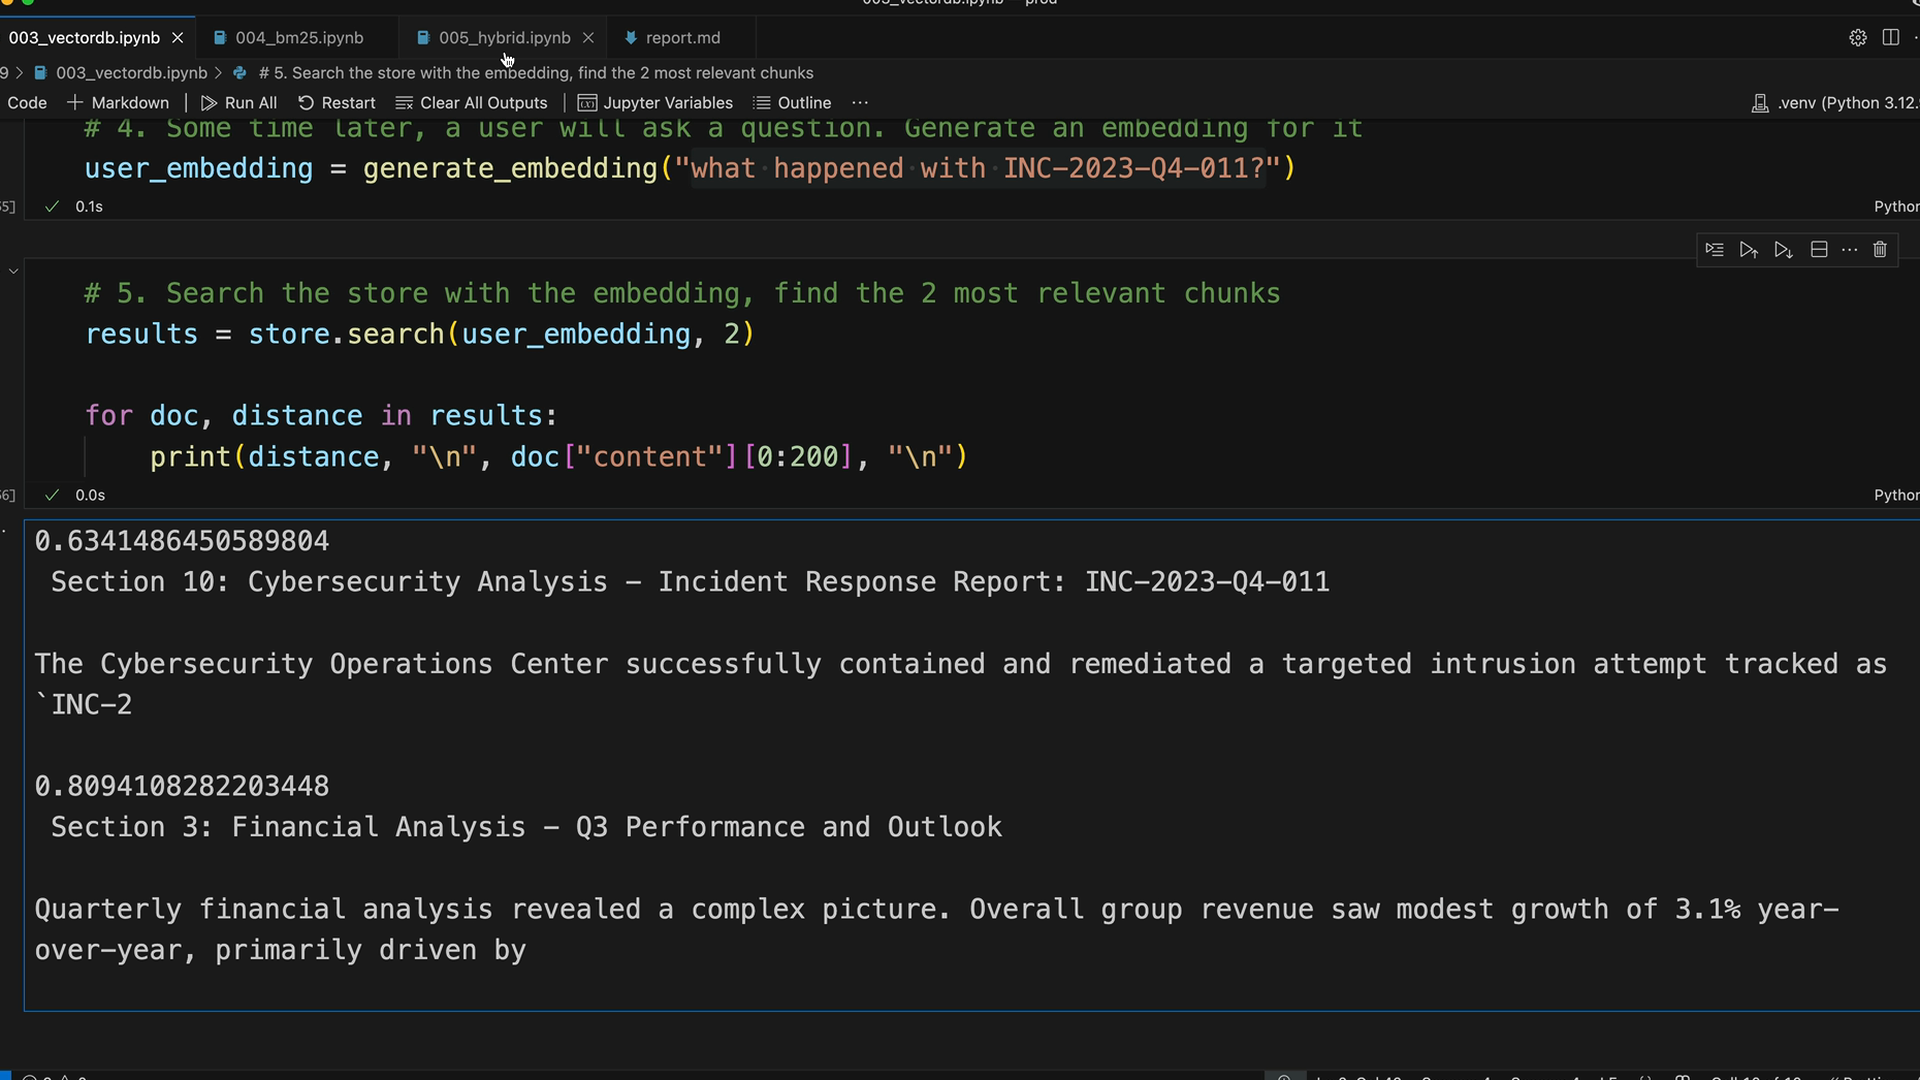
Die Ergebnisse priorisieren nun korrekt:
- Abschnitt 10: Cybersecurity-Analyse (der eigentliche Vorfallsbericht)
- Abschnitt 2: Software-Engineering (relevanter Kontext)
- Abschnitt 5: Rechtliche Entwicklungen (weniger relevant, aber trotzdem verwandt)
Vorteile der hybriden Architektur
Dieses Design bietet mehrere Vorteile:
- Modulares Design: Jeder Suchindex wird unabhängig mit derselben API implementiert
- Einfache Erweiterbarkeit: Du kannst neue Suchmethoden hinzufügen, indem du dieselbe
search()- undadd_document()-Schnittstelle implementierst - Bessere Genauigkeit: Kombiniert semantisches Verständnis mit exaktem Keyword-Matching
- Flexible Fusion: Der RRF-Algorithmus funktioniert unabhängig davon, wie viele Suchindizes du kombinierst
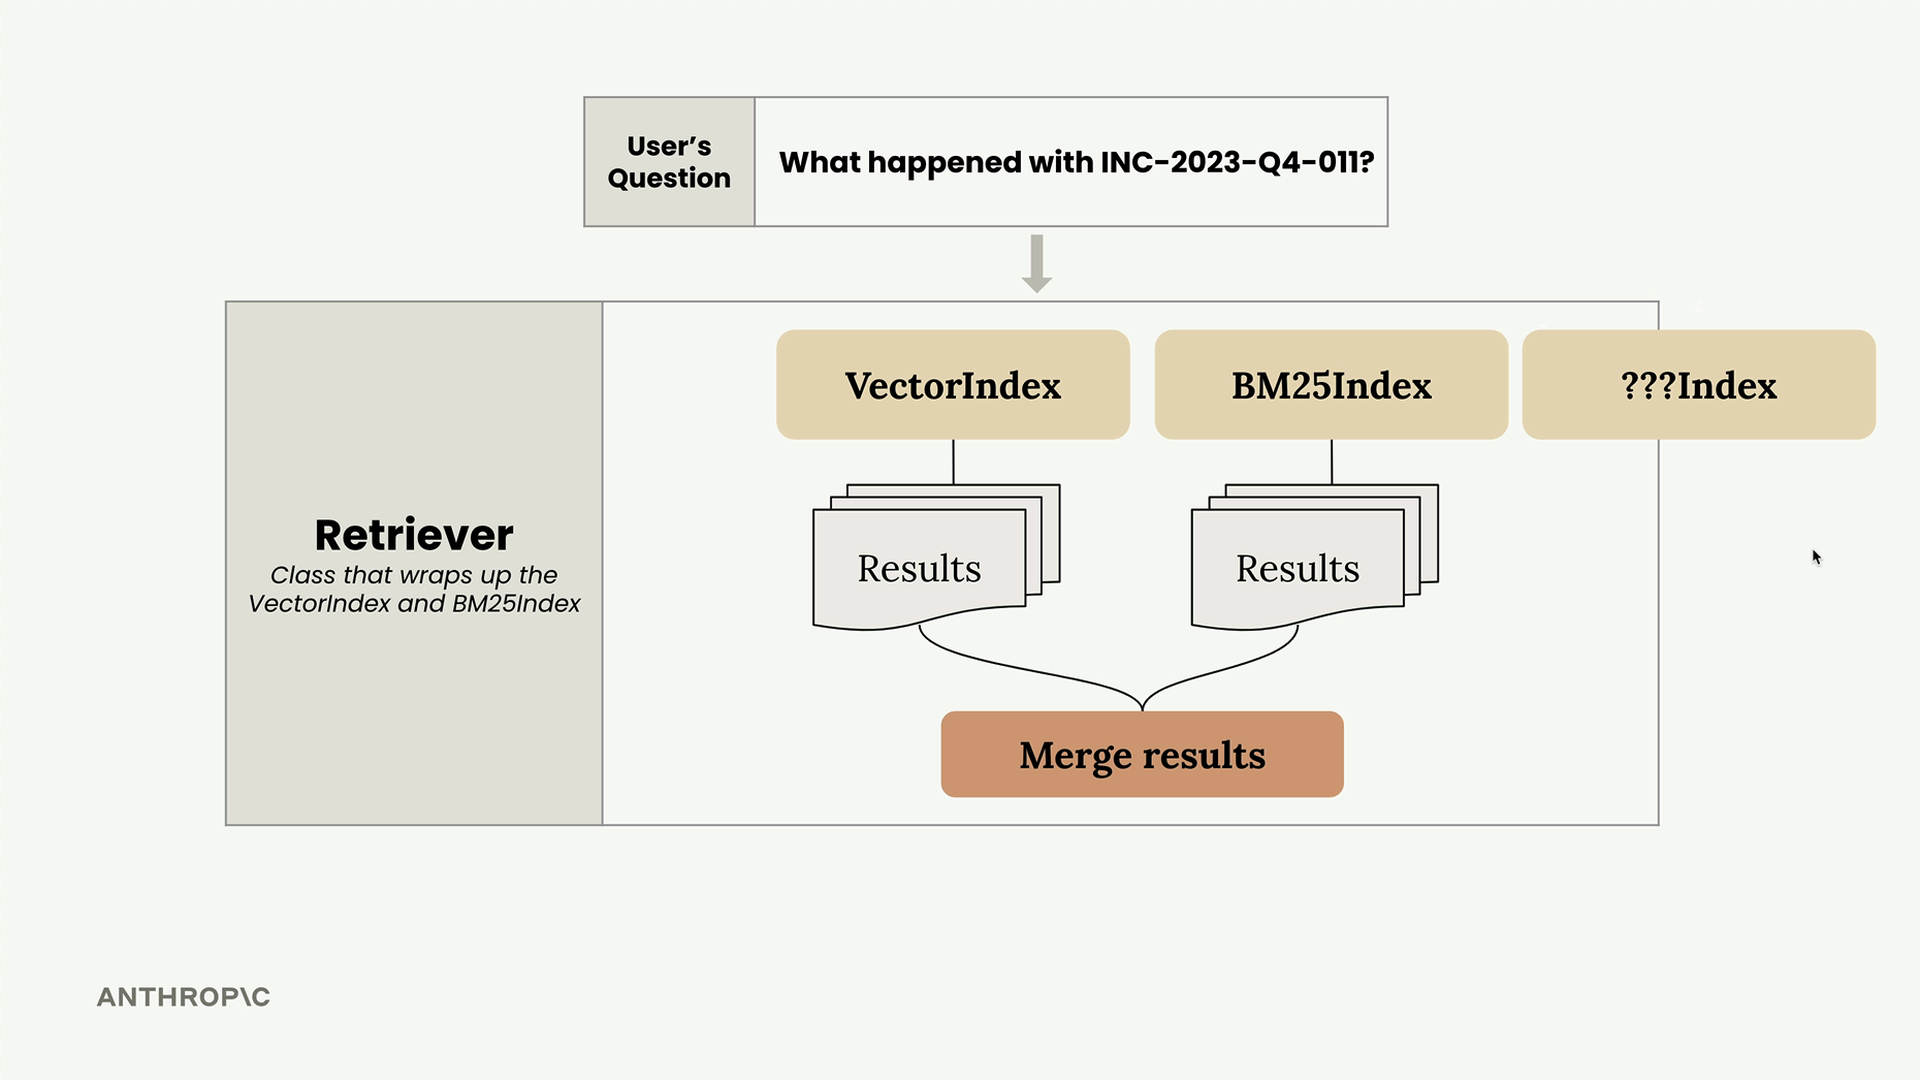
Die konsistente API bedeutet, dass du problemlos einen dritten Suchindex hinzufügen könntest - vielleicht einen, der sich auf die Erkennung benannter Entitäten spezialisiert oder bestimmte Dokumenttypen verarbeitet - und der Retriever würde dessen Ergebnisse automatisch in die endgültige Rangfolge einbeziehen.
Diese hybride Suchgrundlage bietet ein deutlich robusteres Retrieval als jede Methode allein und bereitet deine RAG-Pipeline auf eine bessere Leistung über ein breiteres Spektrum von Anfragetypen vor.