Der Aufbau eines benutzerdefinierten Workflows zur Prompt-Evaluierung beginnt mit der Erstellung eines soliden Prompts und der anschließenden Generierung von Testdaten, um zu sehen, wie gut er funktioniert. Lass uns gemeinsam den Aufbau eines Evaluierungssystems für einen Prompt durchgehen, der Nutzern beim Schreiben von AWS-spezifischem Code hilft.
Das Ziel festlegen
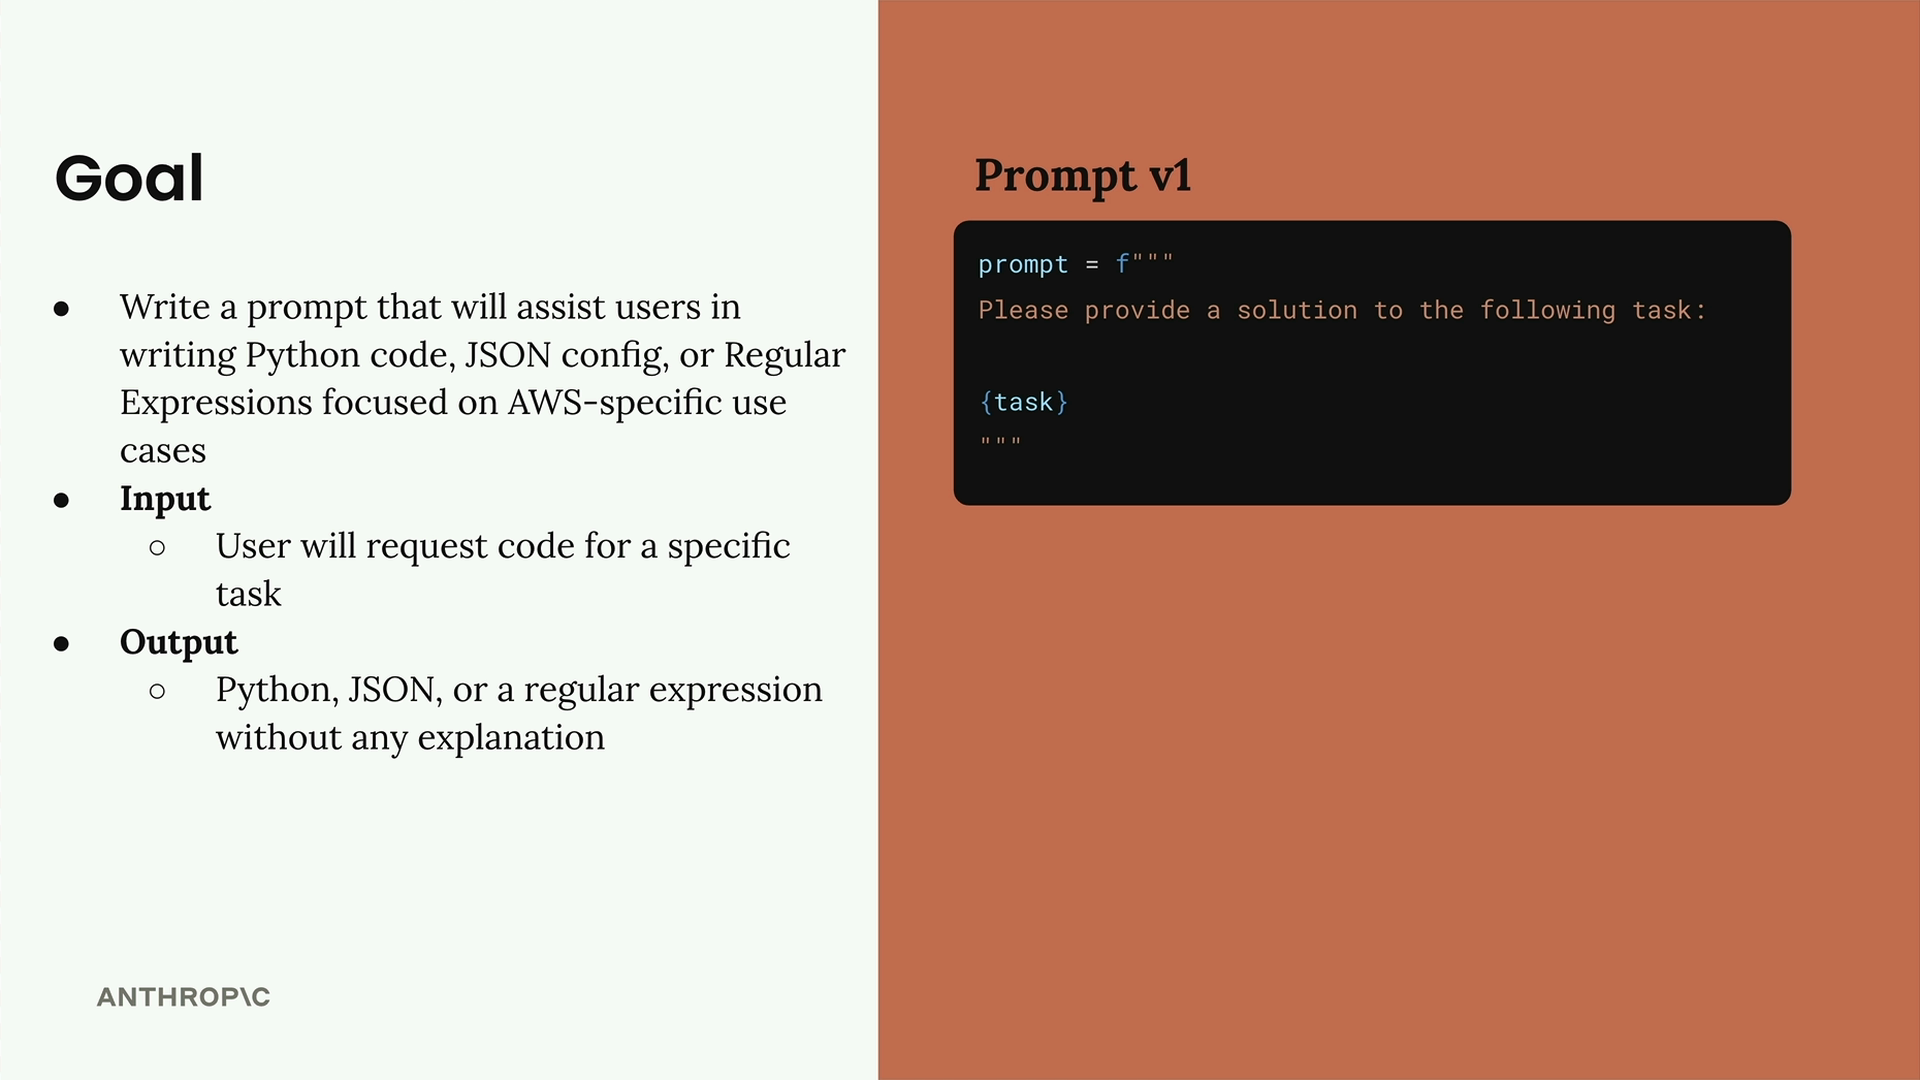
Unser Prompt muss Nutzer beim Schreiben von drei spezifischen Arten von Ausgaben für AWS-Anwendungsfälle unterstützen:
- Python-Code
- JSON-Konfigurationsdateien
- Reguläre Ausdrücke
Die zentrale Anforderung ist, dass wir, wenn ein Nutzer Hilfe bei einer Aufgabe anfordert, eine saubere Ausgabe in einem dieser Formate zurückgeben, ohne zusätzliche Erklärungen, Kopf- oder Fußzeilen.
Hier ist unsere anfängliche Prompt-Vorlage:
prompt = f"""
Please provide a solution to the following task:
{task}
"""
Erstellen eines Evaluierungsdatensatzes
Ein Evaluierungsdatensatz enthält Eingaben, die wir in unseren Prompt einspeisen, um seine Leistung zu testen. In unserem Fall benötigen wir ein Array von JSON-Objekten, wobei jedes Objekt eine „task"-Eigenschaft hat, die beschreibt, was Claude erreichen soll.
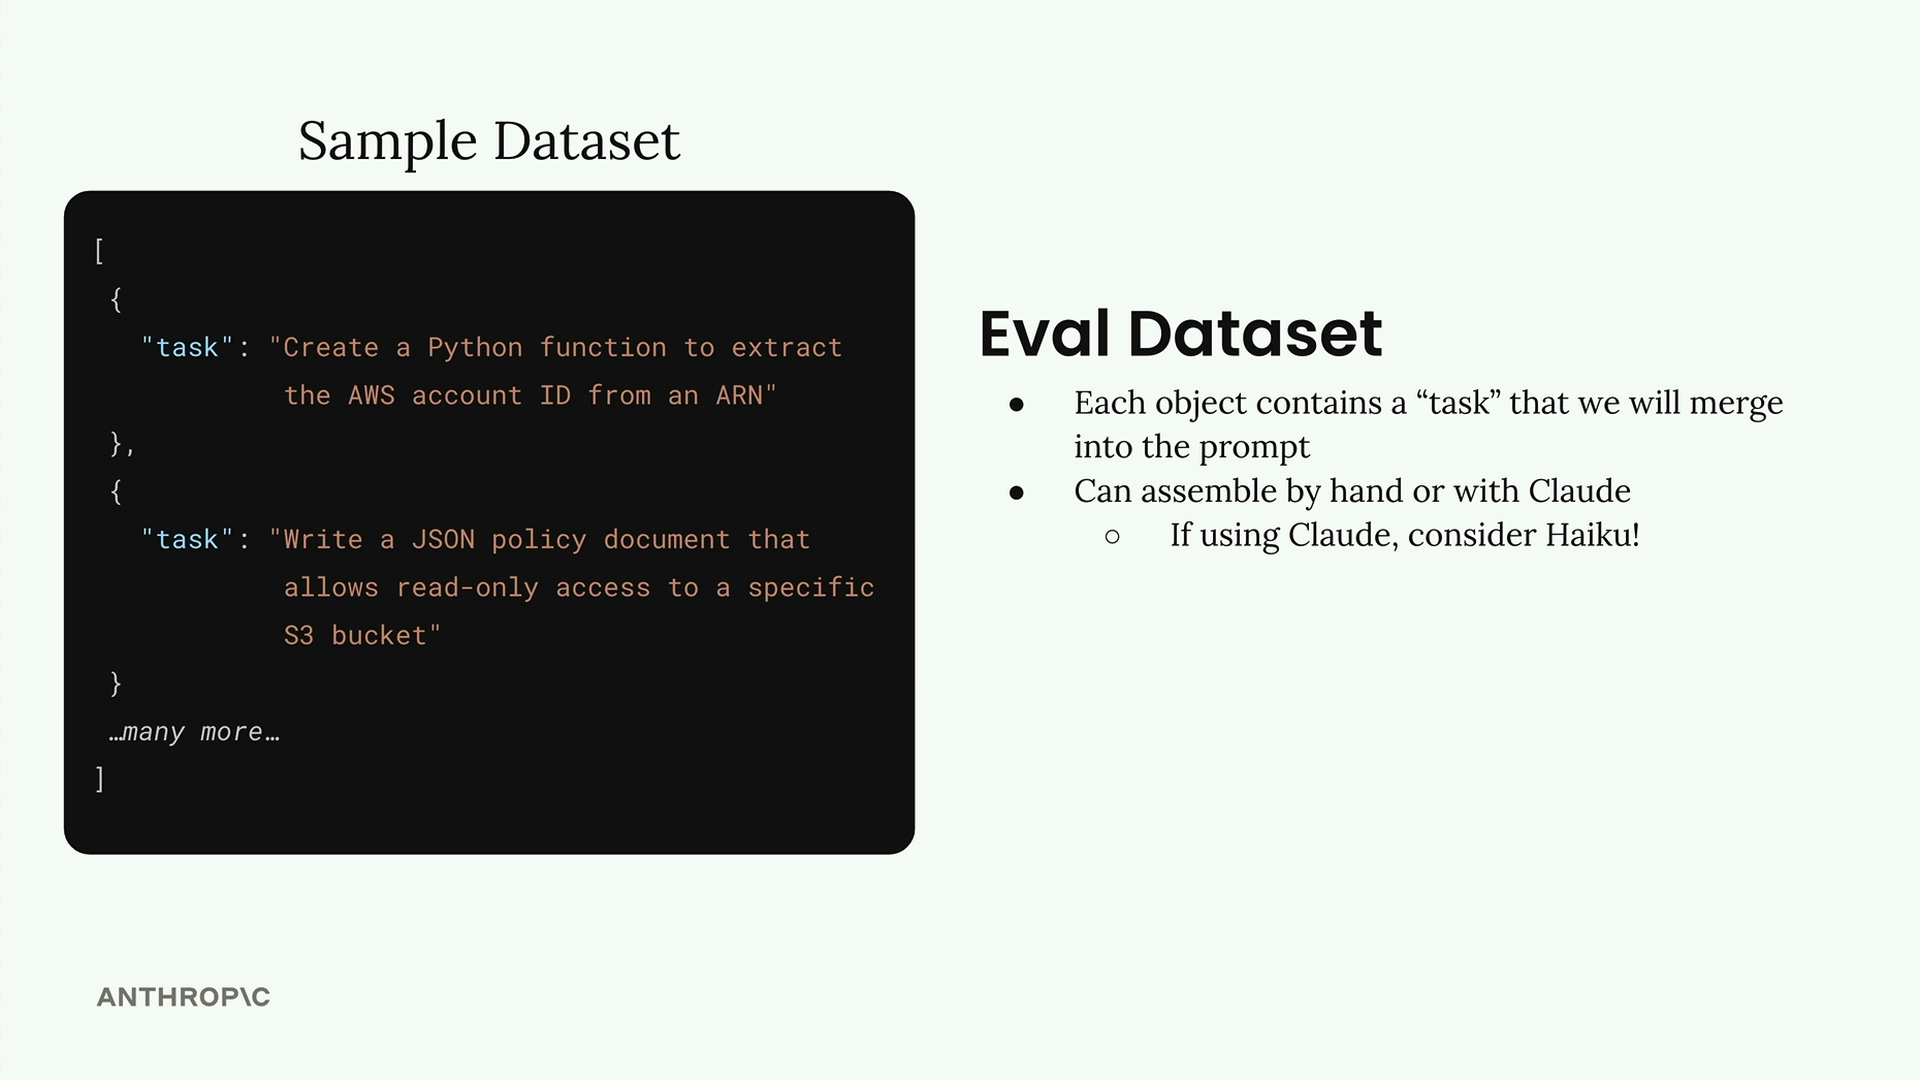
Du kannst Datensätze auf zwei Arten erstellen:
- Manuell zusammenstellen
- Automatisch mit Claude generieren
Für die automatische Generierung ist die Verwendung eines schnelleren Modells wie Haiku sinnvoll, da wir Testdaten und keine Produktionsausgabe generieren.
Generierung von Testdaten mit Code
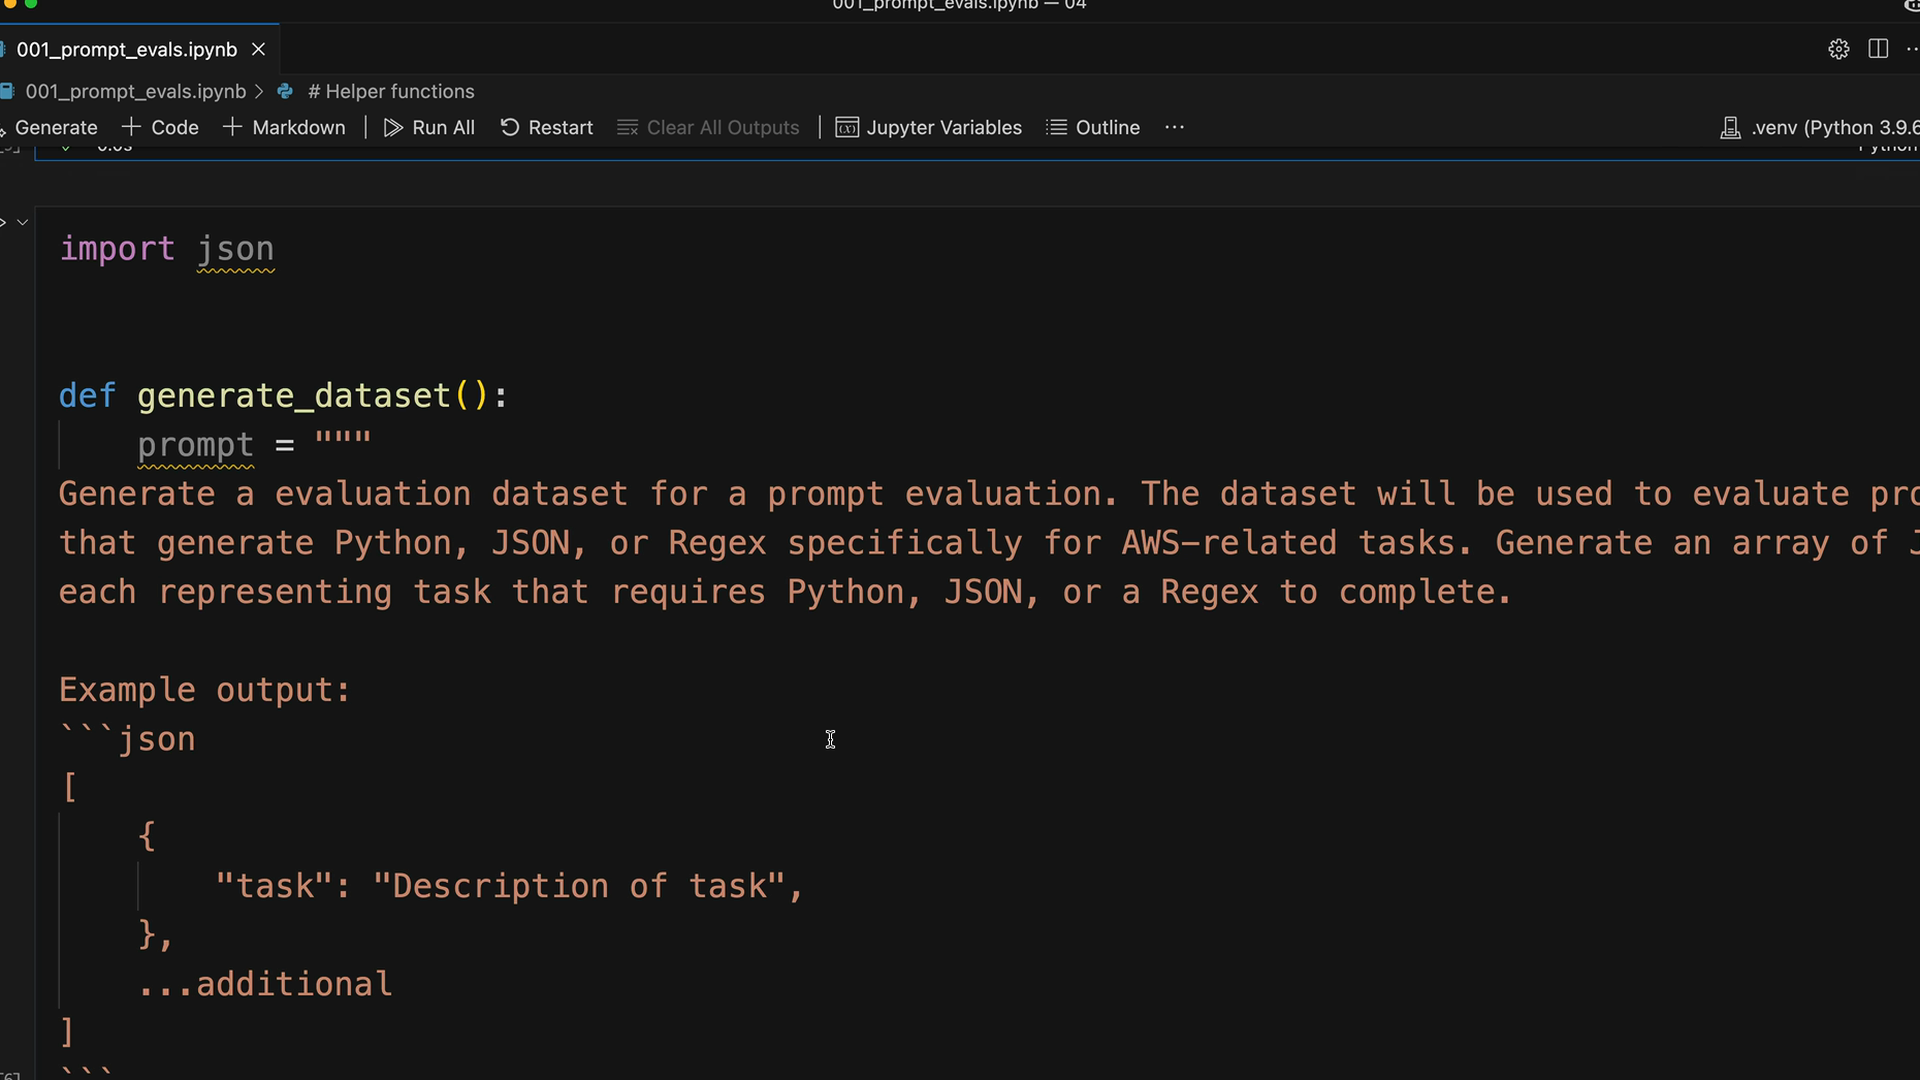
Lass uns eine Funktion erstellen, die Claude bittet, Testfälle für uns zu generieren. Die Funktion erstellt einen umfassenden Prompt, der spezifische Arten von AWS-bezogenen Aufgaben anfordert.
Hier ist die grundlegende Funktionsstruktur:
def generate_dataset():
    prompt = """
    Generate an evaluation dataset for a prompt evaluation. The dataset will be used to evaluate prompts
    that generate Python, JSON, or Regex specifically for AWS-related tasks. Generate an array of objects,
    each representing task that requires Python, JSON, or a Regex to complete.

    Example output:
    ```json
    [
        \{
            "task": "Description of task",
        \},
        ...additional
    ]
    ```

    * Focus on tasks that can be solved by writing a single Python function, a single JSON object, or a single regex
    * Focus on tasks that do not require writing much code

    Please generate 3 objects.
    """
Implementierung der Generierungslogik
Um eine saubere JSON-Ausgabe von Claude zu erhalten, verwenden wir die Pre-Filling-Technik mit Stop-Sequenzen:
messages = []
add_user_message(messages, prompt)
add_assistant_message(messages, "```json")
text = chat(messages, stop_sequences=["```"])
return json.loads(text)
Dieser Ansatz stellt sicher, dass Claude seine Antwort mit korrekt formatiertem JSON beginnt und beim schließenden Markdown-Fence stoppt.
Testen und Speichern des Datensatzes
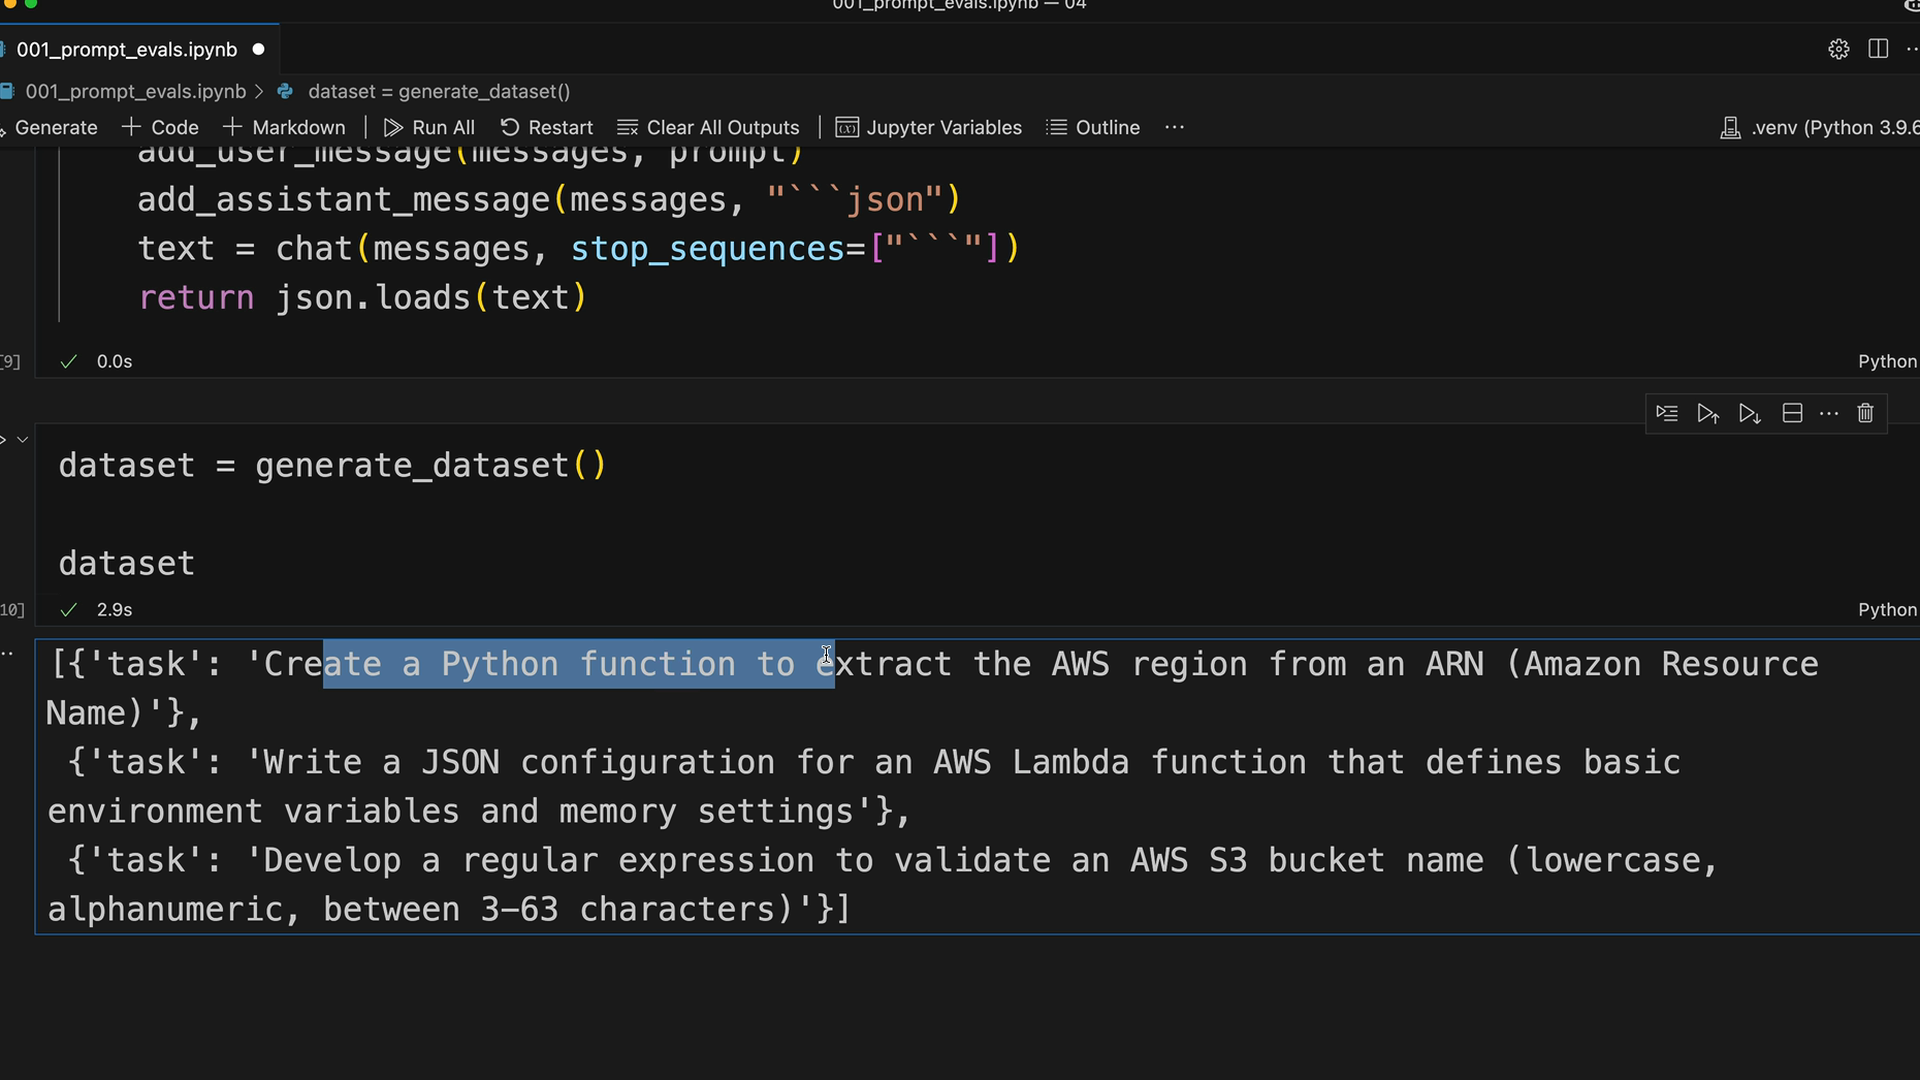
Nachdem du die Generierungsfunktion ausgeführt hast, solltest du realistische Testfälle wie diese zurückbekommen:
- Erstelle eine Python-Funktion, um die AWS-Region aus einem ARN zu extrahieren
- Schreibe eine JSON-Konfiguration für eine AWS-Lambda-Funktion
- Entwickle einen regulären Ausdruck zur Validierung eines AWS-S3-Bucket-Namens
Speichere deinen generierten Datensatz in einer Datei zur einfachen Wiederverwendung:
dataset = generate_dataset()

with open('dataset.json', 'w') as f:
    json.dump(dataset, f, indent=2)
Dadurch wird eine Datei dataset.json in deinem Notebook-Verzeichnis erstellt, die alle deine Testfälle enthält und bereit ist, für die Prompt-Evaluierung in den nächsten Schritten deines Workflows verwendet zu werden.