Wenn du KI-Modelle bewertest, die Code generieren, brauchst du mehr als nur zu prüfen, ob die Antwort sinnvoll ist. Du musst auch verifizieren, dass der generierte Code tatsächlich eine gültige Syntax hat und dem korrekten Format folgt. Hier kommt die codebasierte Bewertung ins Spiel.
Wie die Code-Bewertung funktioniert
Die Code-Bewertung validiert zwei Schlüsselaspekte von KI-generierten Antworten:
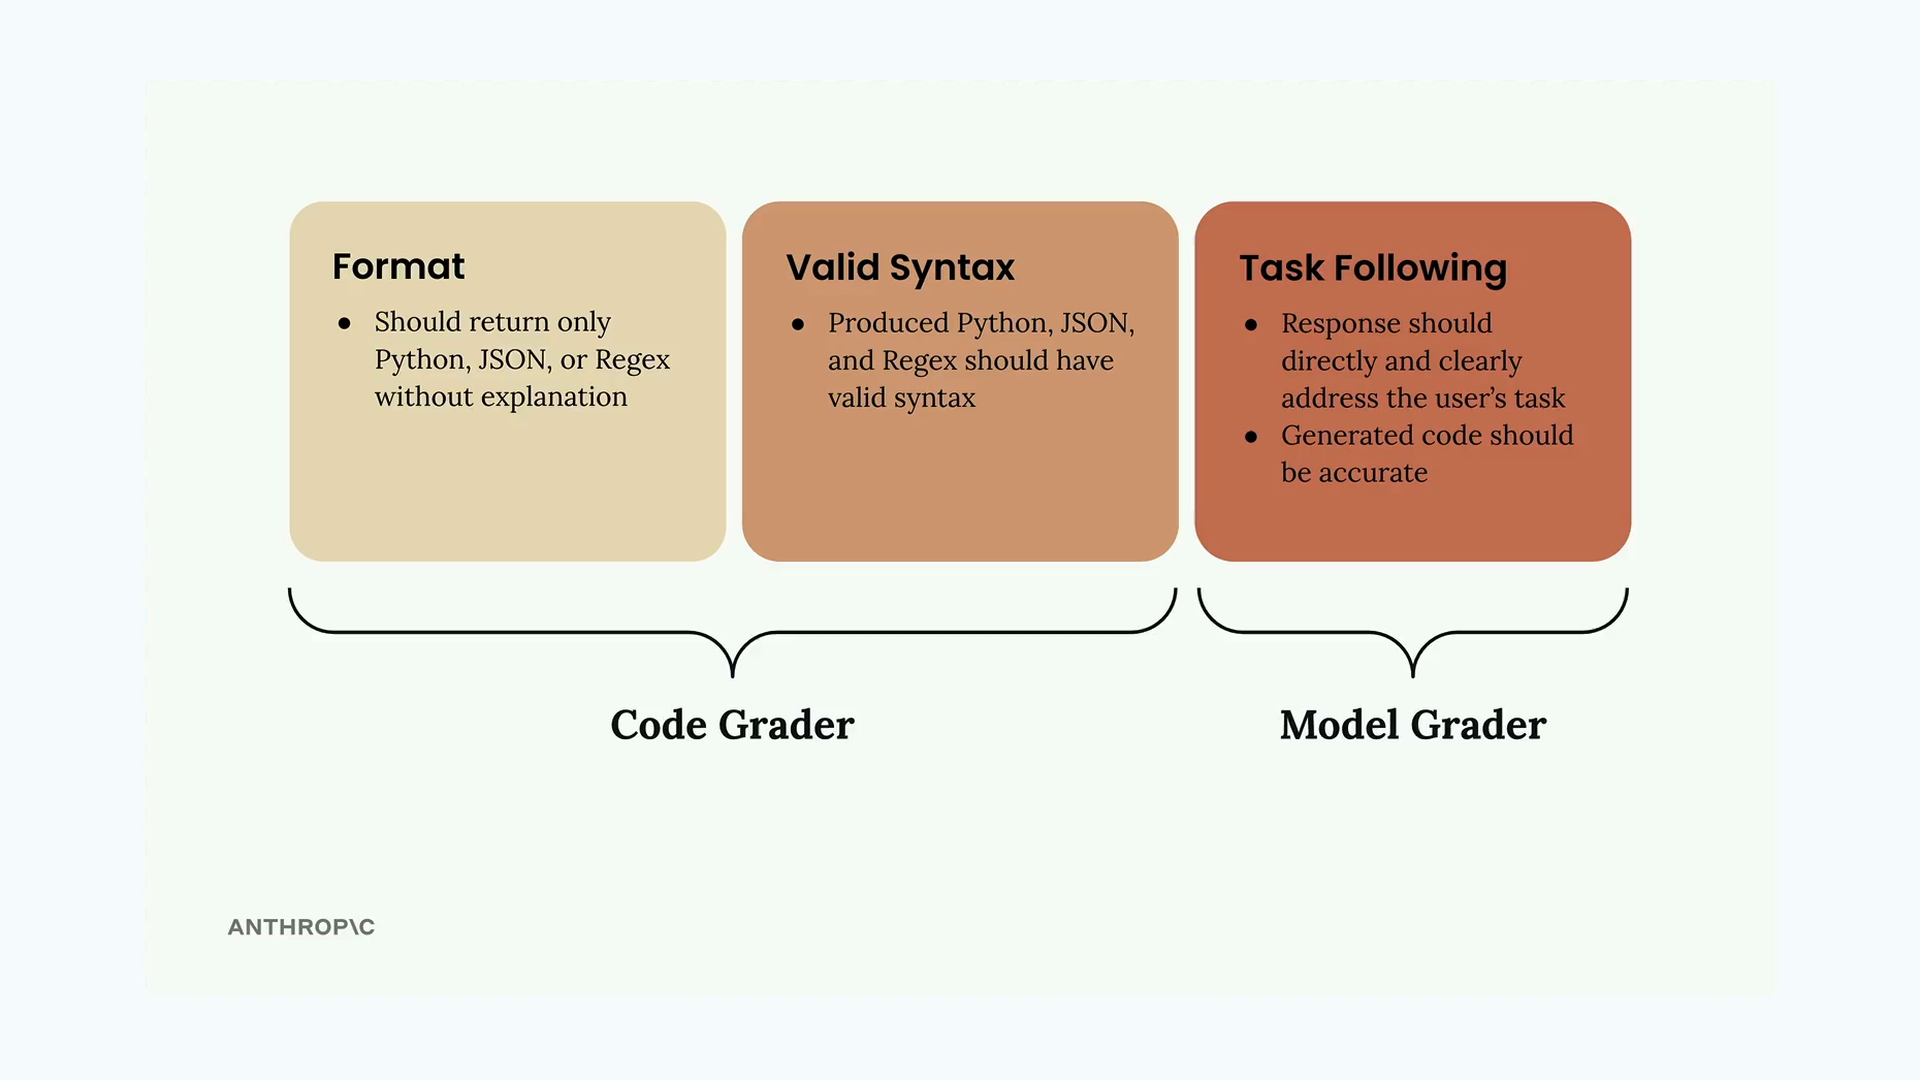
- Format - Die Antwort sollte nur den angeforderten Code-Typ (Python, JSON oder Regex) zurückgeben, ohne Erklärungen
- Gültige Syntax - Der generierte Code sollte tatsächlich korrekt als die vorgesehene Sprache parsen
- Aufgabenerfüllung - Die Antwort sollte direkt auf das Gefragte eingehen und korrekt sein
Die ersten beiden Kriterien werden vom Code-Grader gehandhabt, während die Aufgabenerfüllung vom Modell-Grader bewertet wird. Zusammen bieten sie eine umfassende Bewertung.
Syntaxvalidierungsfunktionen
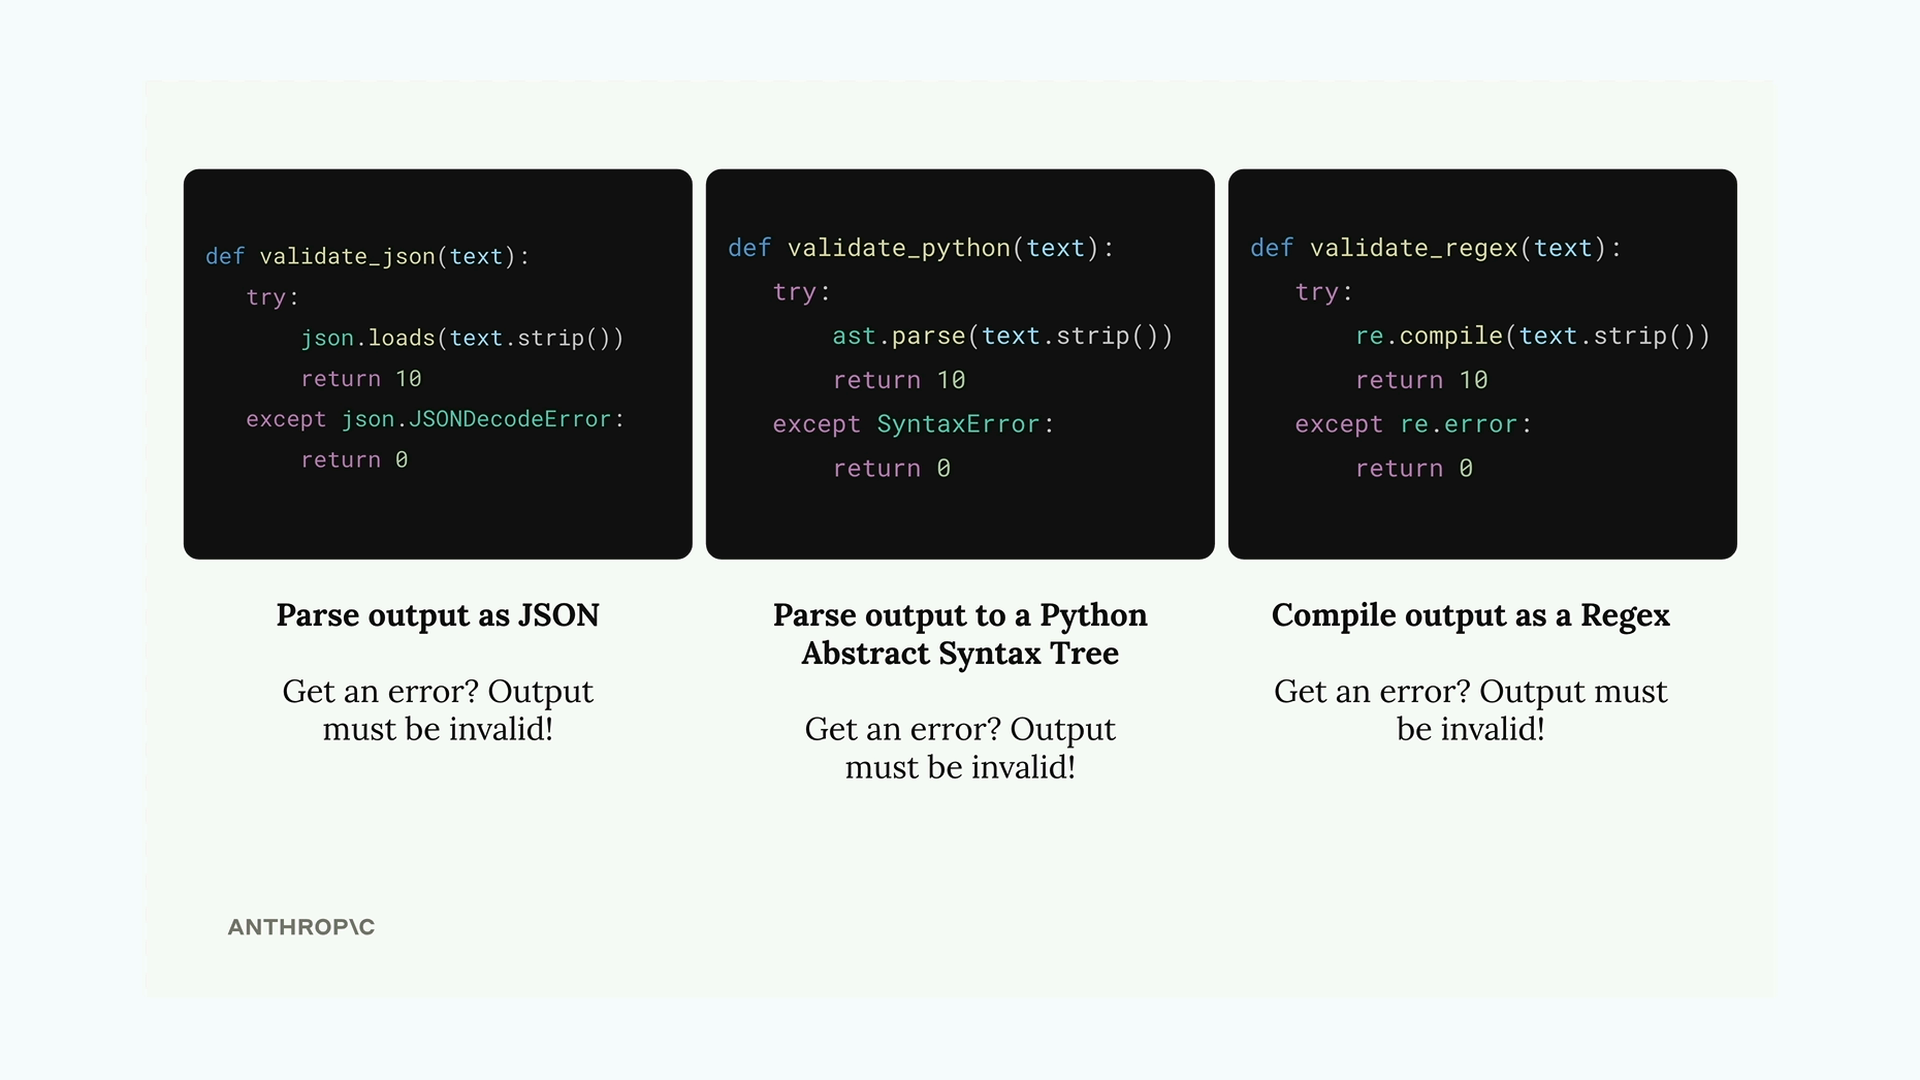
Um zu prüfen, ob generierter Code eine gültige Syntax hat, kannst du drei Hilfsfunktionen erstellen, die versuchen, die Ausgabe zu parsen:
def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
        return 0
Jede Funktion versucht, den Text als ihr jeweiliges Format zu parsen. Wenn das Parsen erfolgreich ist, gibt sie eine perfekte Punktzahl von 10 zurück. Wenn es mit einem Fehler fehlschlägt, ist die Syntax ungültig und es wird 0 zurückgegeben.
Anforderungen an das Datensatzformat
Damit der Code-Grader weiß, welchen Validator er verwenden soll, müssen deine Testfälle das erwartete Ausgabeformat angeben:
{
    "task": "Create a Python function to validate an AWS IAM username",
    "format": "python"
}
Du kannst deinen Prompt zur Datensatzgenerierung aktualisieren, um dieses Format-Feld automatisch einzuschließen, indem du es zur Beispiel-Ausgabestruktur hinzufügst.
Verbesserung der Prompt-Klarheit
Um bessere Ergebnisse von deinem KI-Modell zu erhalten, mache deine Prompt-Anweisungen spezifischer bezüglich des erwarteten Ausgabeformats:
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanationDu kannst auch eine vorausgefüllte Assistant-Nachricht mit Code-Blöcken verwenden, um das Modell zu ermutigen, nur den rohen Code zurückzugeben:
add_assistant_message(messages, "```code")Dies weist Claude an, mit der Generierung von Code-Inhalten zu beginnen, ohne vorher angeben zu müssen, ob es sich um Python, JSON oder Regex handelt.
Kombinieren von Punktzahlen
Der letzte Schritt ist das Zusammenführen der Punktzahl des Modell-Graders mit der Punktzahl des Code-Graders. Ein einfacher Ansatz ist, sie zu mitteln:
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
Dies gibt sowohl der inhaltlichen Qualität als auch der technischen Korrektheit gleiches Gewicht. Du könntest diese Gewichtungen anpassen, basierend darauf, was für deinen spezifischen Anwendungsfall wichtiger ist.
Testen deiner Implementierung
Sobald du die Code-Bewertung implementiert hast, führe deine Evaluierung aus, um eine Basislinien-Punktzahl zu erhalten. Die Punktzahl selbst ist nicht von Natur aus gut oder schlecht - was zählt, ist, ob du sie verbessern kannst, indem du deine Prompts verfeinerst. Dies gibt dir eine quantitative Möglichkeit, den Fortschritt beim Prompt Engineering zu messen, anstatt dich auf subjektive Einschätzungen zu verlassen.