Der hybride Retrieval-Ansatz, den wir aufgebaut haben, funktioniert gut, hat aber noch einige Unschärfen. Wenn wir nach „Was hat das Engineering-Team mit INC-2023-Q4-011 gemacht?" suchen, würden wir erwarten, dass der Abschnitt Software Engineering höher rankt, da er speziell das Engineering-Team und den Vorfall erwähnt. Der Abschnitt Cybersecurity steht jedoch immer noch an erster Stelle.
Hier kommt Re-ranking ins Spiel – eine Nachbearbeitungstechnik, die die Retrieval-Genauigkeit erheblich verbessern kann.
Wie Re-ranking funktioniert
Re-ranking fügt einen zusätzlichen Schritt nach deinem Hybrid-Suchprozess hinzu. Anstatt nur die zusammengeführten Ergebnisse aus deinen Vektor- und BM25-Indizes zurückzugeben, leitest du diese Ergebnisse durch ein LLM zur intelligenten Neuordnung.
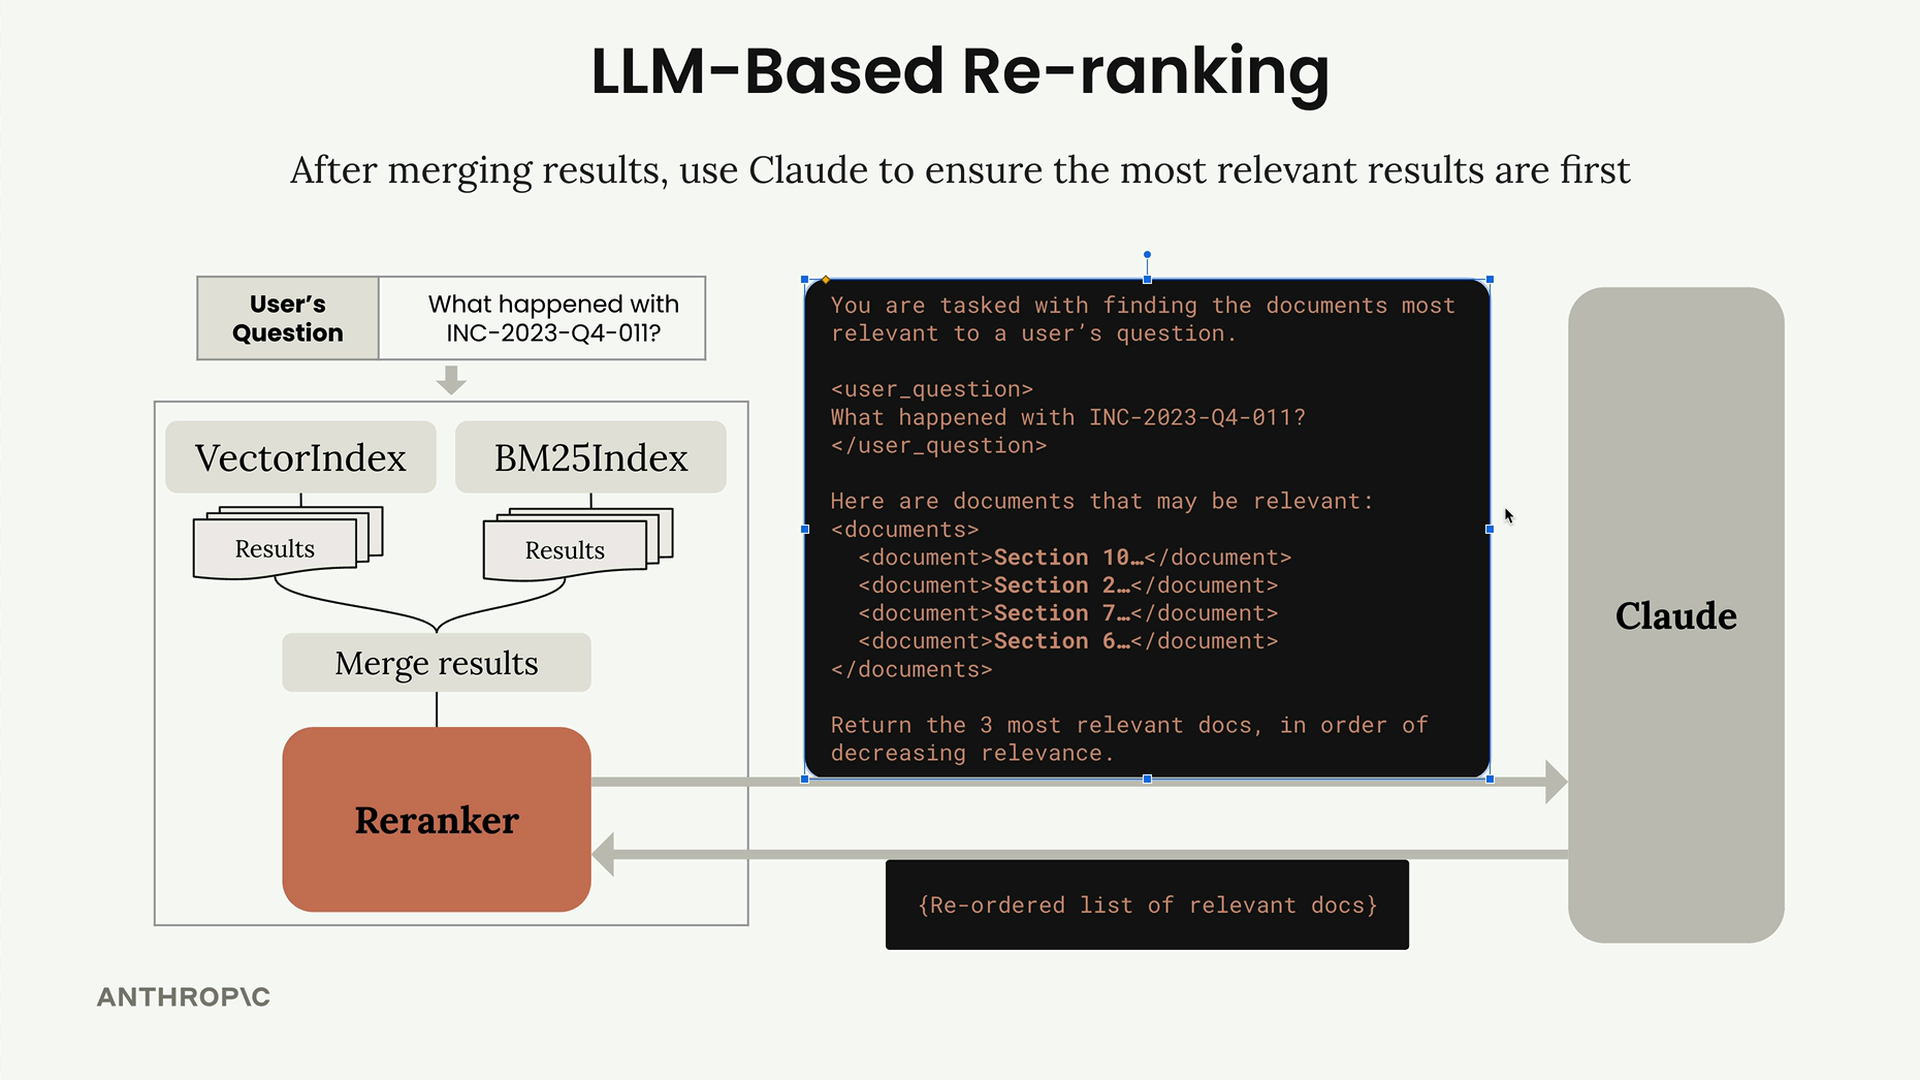
Der Prozess ist unkompliziert:
- Führe deine bestehende Hybrid-Suche aus (Vektor + BM25)
- Führe die Ergebnisse wie zuvor zusammen
- Sende die zusammengeführten Ergebnisse mit einem Re-ranking-Prompt an Claude
- Erhalte eine neu geordnete Liste der relevantesten Dokumente zurück
Der Re-ranking-Prompt
Die Prompt-Struktur ist einfach, aber effektiv. Du gibst Claude die Frage des Nutzers und alle Kandidatendokumente und bittest es dann, die relevantesten in absteigender Reihenfolge der Relevanz zurückzugeben.
You are about to be given a set of documents, along with an id of each.
Your task is to select the {k} most relevant documents to answer the user's question.

Here is the user's question:
<question>
{query_text}
</question>

Here are the documents to select from:
<documents>
{joined_docs}
</documents>

Respond in the following format:
```json
\{
  "document_ids": str[] # List document ids, \{k\} elements long, sorted in order of decreasing relevance
\}
```Effizienzüberlegungen
Eine wichtige Optimierung besteht darin, Dokument-IDs zu verwenden, anstatt Claude zu bitten, vollständige Textabschnitte zurückzugeben. Wenn du Claude bitten würdest, den vollständigen Text jedes relevanten Dokuments zurückzugeben, würdest du Zeit damit verschwenden, darauf zu warten, dass es große Textmengen kopiert.
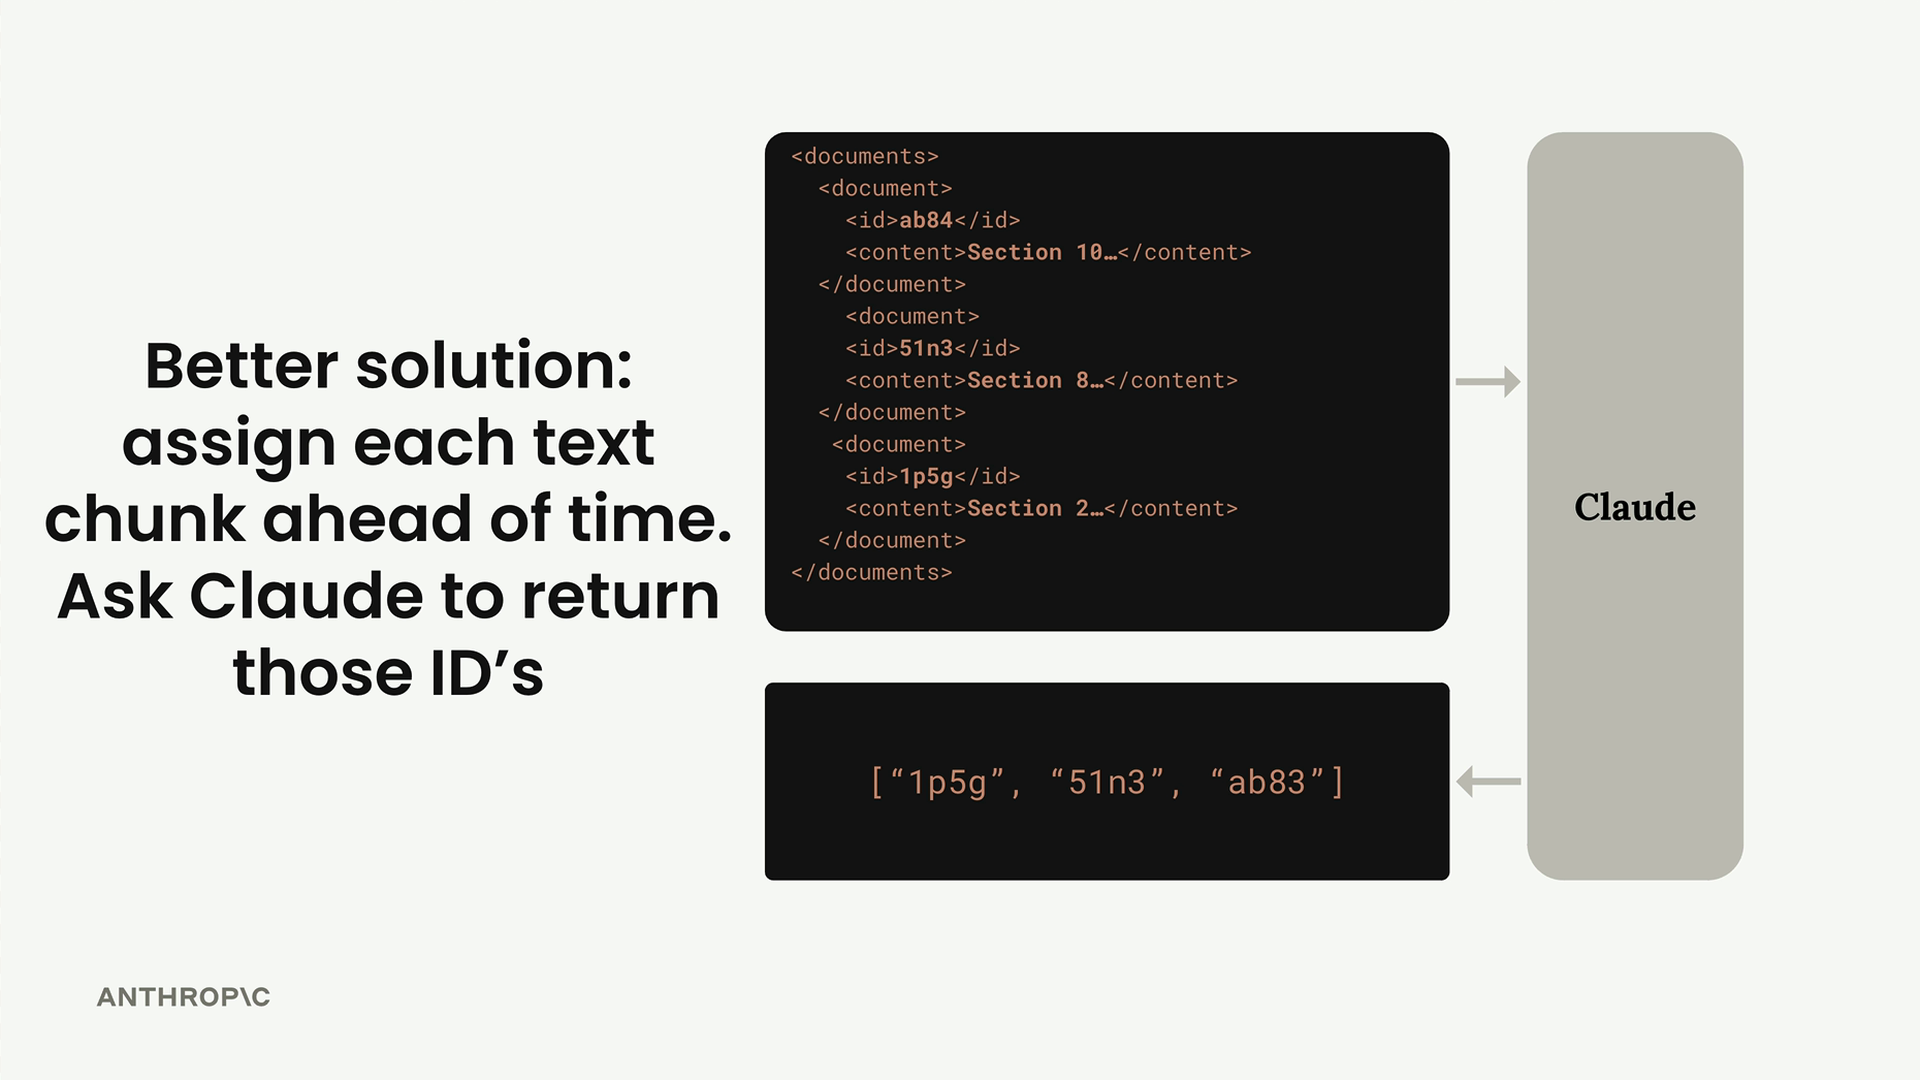
Weise statt dessen jedem Textabschnitt im Voraus eine eindeutige ID zu und bitte Claude dann, nur diese IDs in der bevorzugten Reihenfolge zurückzugeben. Das macht den Re-ranking-Prozess viel schneller, während du trotzdem die neu geordneten Ergebnisse erhältst, die du brauchst.
Implementierung
Die Re-ranker-Funktion wird automatisch aufgerufen, nachdem deine anfängliche Hybrid-Suche abgeschlossen ist. Hier ist die grundlegende Struktur:
def reranker_fn(docs, query_text, k):
    joined_docs = "\n".join([
        f"""
        <document>
        <document_id>{doc["id"]}</document_id>
        <document_content>{doc["content"]}</document_content>
        </document>
        """
        for doc in docs
    ])

    # Prompt mit Nutzerfrage und Dokumenten erstellen
    # An Claude mit JSON-Antwortformat senden
    # Neu geordnete Dokument-IDs parsen und zurückgeben
Du kannst dies in deinen Retriever integrieren, indem du die Re-ranker-Funktion als Parameter übergibst:
retriever = Retriever(bm25_index, vector_index, reranker_fn=reranker_fn)Ergebnisse
Der Re-ranking-Ansatz zeigt deutliche Verbesserungen. Beim Testen der Anfrage „Was hat das Engineering-Team mit INC-2023-Q4-011 gemacht?" erscheint der Abschnitt Software Engineering jetzt korrekt an erster Stelle, vor dem Abschnitt Cybersecurity. Claude hat erfolgreich erkannt, dass der Nutzer speziell nach der Beteiligung des Engineering-Teams an dem Vorfall gefragt hat.
Kompromisse
Re-ranking bringt Kompromisse mit sich, die zu berücksichtigen sind:
- Erhöhte Latenz: Du musst jetzt auf einen zusätzlichen LLM-Aufruf warten, bis dieser abgeschlossen ist
- Verbesserte Genauigkeit: Das LLM kann Kontext und Absicht besser verstehen als reine Ähnlichkeitswerte
- Kostenüberlegungen: Jede Suche erfordert jetzt einen LLM-API-Aufruf
Für viele Anwendungen rechtfertigt die Verbesserung der Genauigkeit die zusätzliche Latenz und die Kosten, insbesondere wenn präzises Retrieval für deinen Anwendungsfall entscheidend ist.