Beim Aufbau von Prompt-Evaluierungs-Workflows liefern Bewertungssysteme objektive Signale über die Ausgabequalität. Ein Grader nimmt eine Modellausgabe entgegen und gibt eine Art messbares Feedback zurück – typischerweise eine Zahl zwischen 1 und 10, wobei 10 hohe Qualität und 1 schlechte Qualität darstellt.
Arten von Gradern
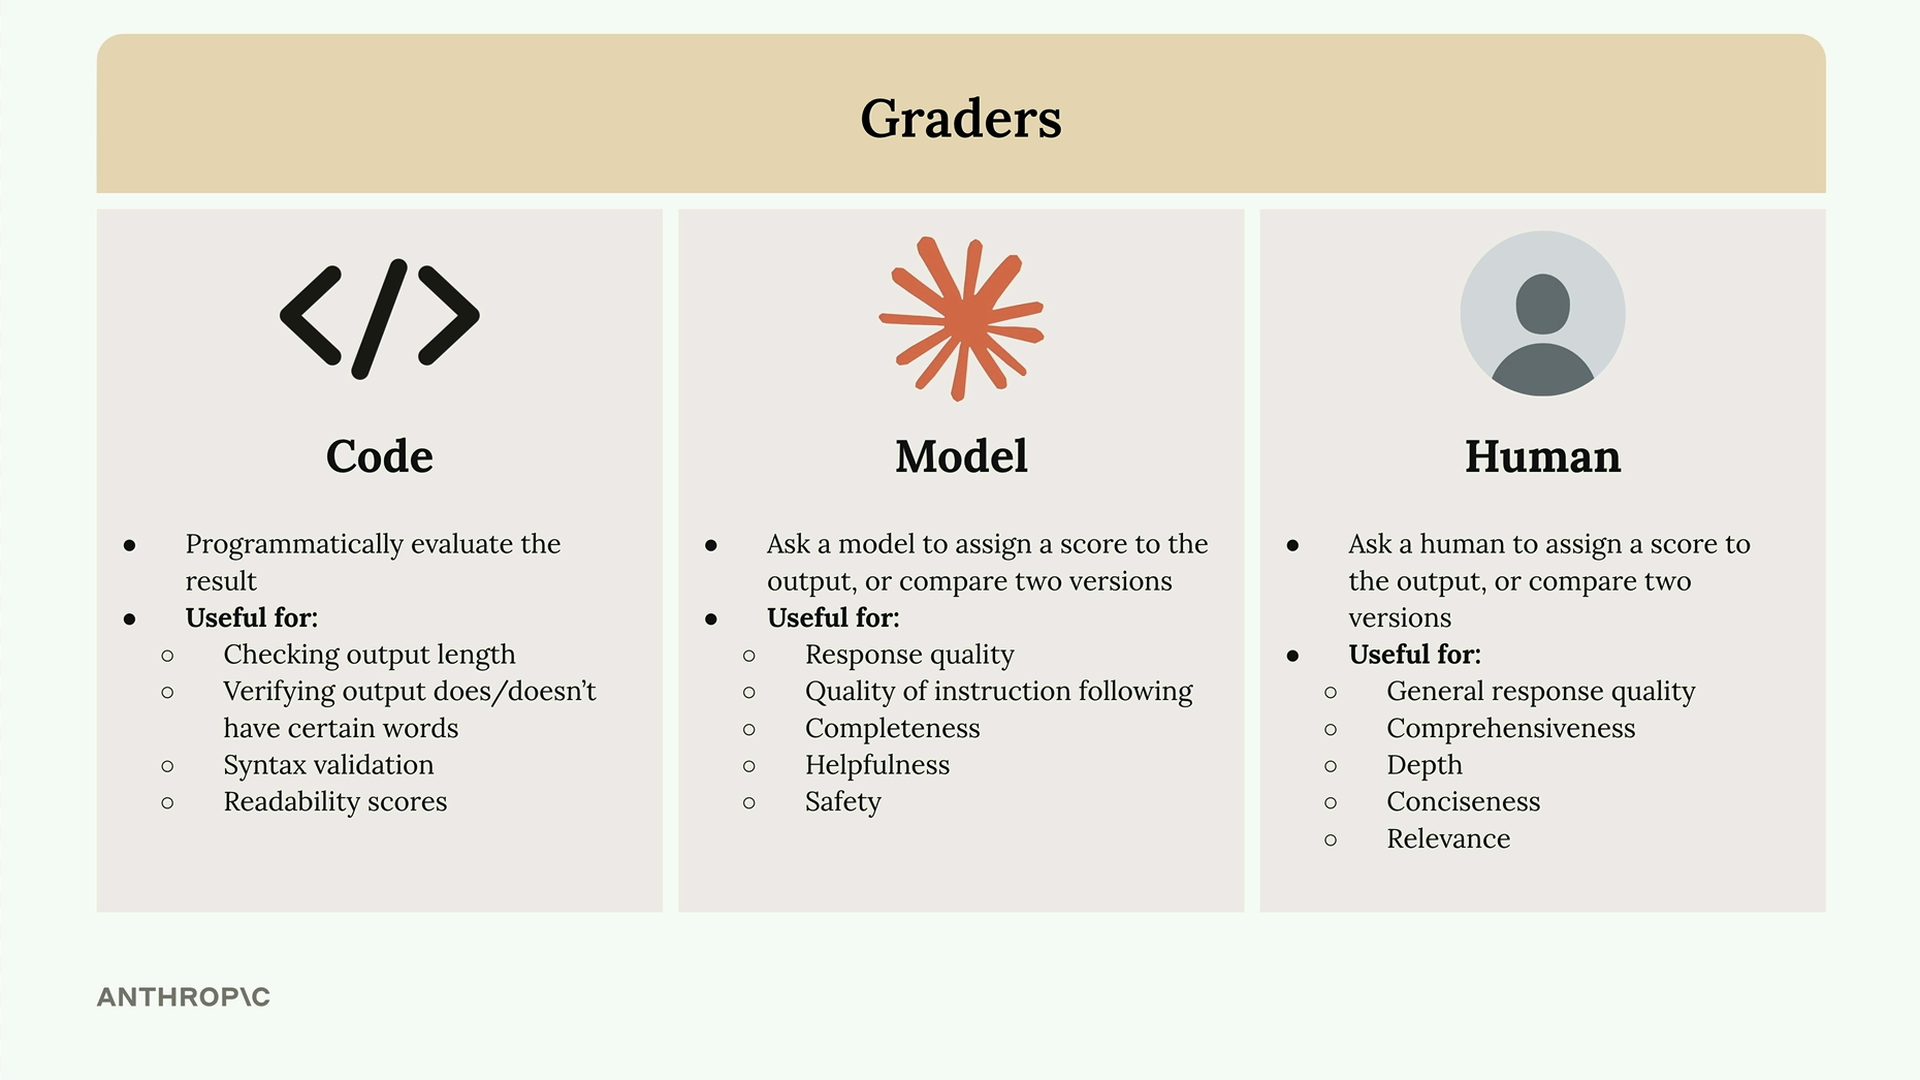
Es gibt drei Hauptansätze zur Bewertung von Modellausgaben:
- Code-Grader – Bewerten Ausgaben programmatisch mithilfe von benutzerdefiniertem Code
- Modell-Grader – Verwenden ein weiteres KI-Modell zur Qualitätsbeurteilung
- Menschliche Grader – Lassen Menschen Ausgaben manuell überprüfen und bewerten
Code-Grader
Code-Grader ermöglichen es dir, jede programmatische Prüfung zu implementieren, die du dir vorstellen kannst. Häufige Anwendungen umfassen:
- Überprüfung der Ausgabelänge
- Verifizierung, ob die Ausgabe bestimmte Wörter enthält oder nicht
- Syntaxvalidierung für JSON, Python oder Regex
- Lesbarkeitswerte, um angemessene Leseniveaus sicherzustellen
Modell-Grader
Modell-Grader bieten enorme Flexibilität, indem sie einen zusätzlichen API-Aufruf zur Bewertung von Ausgaben verwenden. Sie sind nützlich zur Beurteilung von:
- Antwortqualität
- Qualität der Befolgung von Anweisungen
- Vollständigkeit
- Hilfsbereitschaft
- Sicherheit
Menschliche Grader
Menschliche Grader bieten die größte Flexibilität, bringen aber erhebliche Nachteile mit sich. Während Menschen Antworten nach jedem denkbaren Kriterium bewerten können, ist der Prozess zeitaufwändig und mühsam.
Definition von Bewertungskriterien
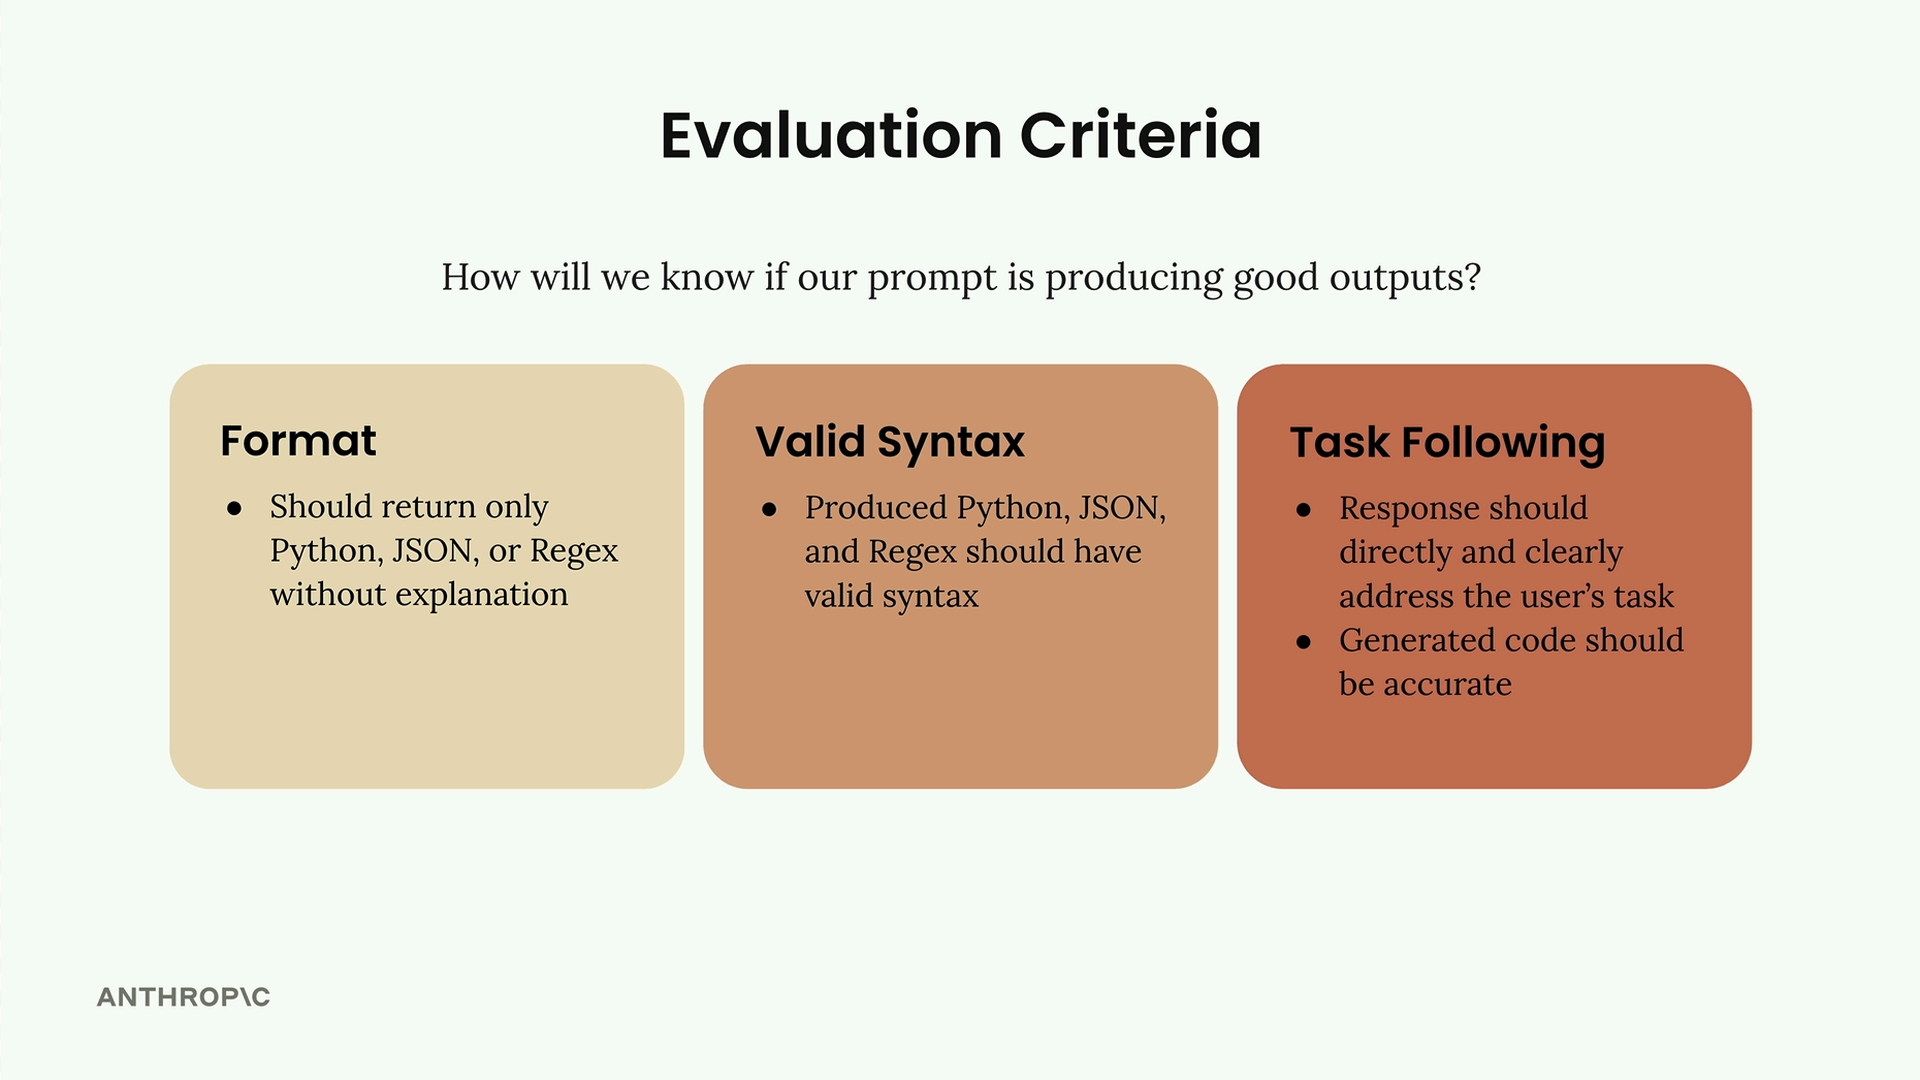
Bevor du einen Grader implementierst, benötigst du klare Bewertungskriterien. Bei einem Code-Generierungs-Prompt könntest du dich auf Folgendes konzentrieren:
- Format – Sollte nur Python, JSON oder Regex ohne Erklärung zurückgeben
- Gültige Syntax – Der erzeugte Code sollte gültige Syntax aufweisen
- Aufgabenbefolgung – Die Antwort sollte die Aufgabe des Nutzers direkt mit korrektem Code adressieren
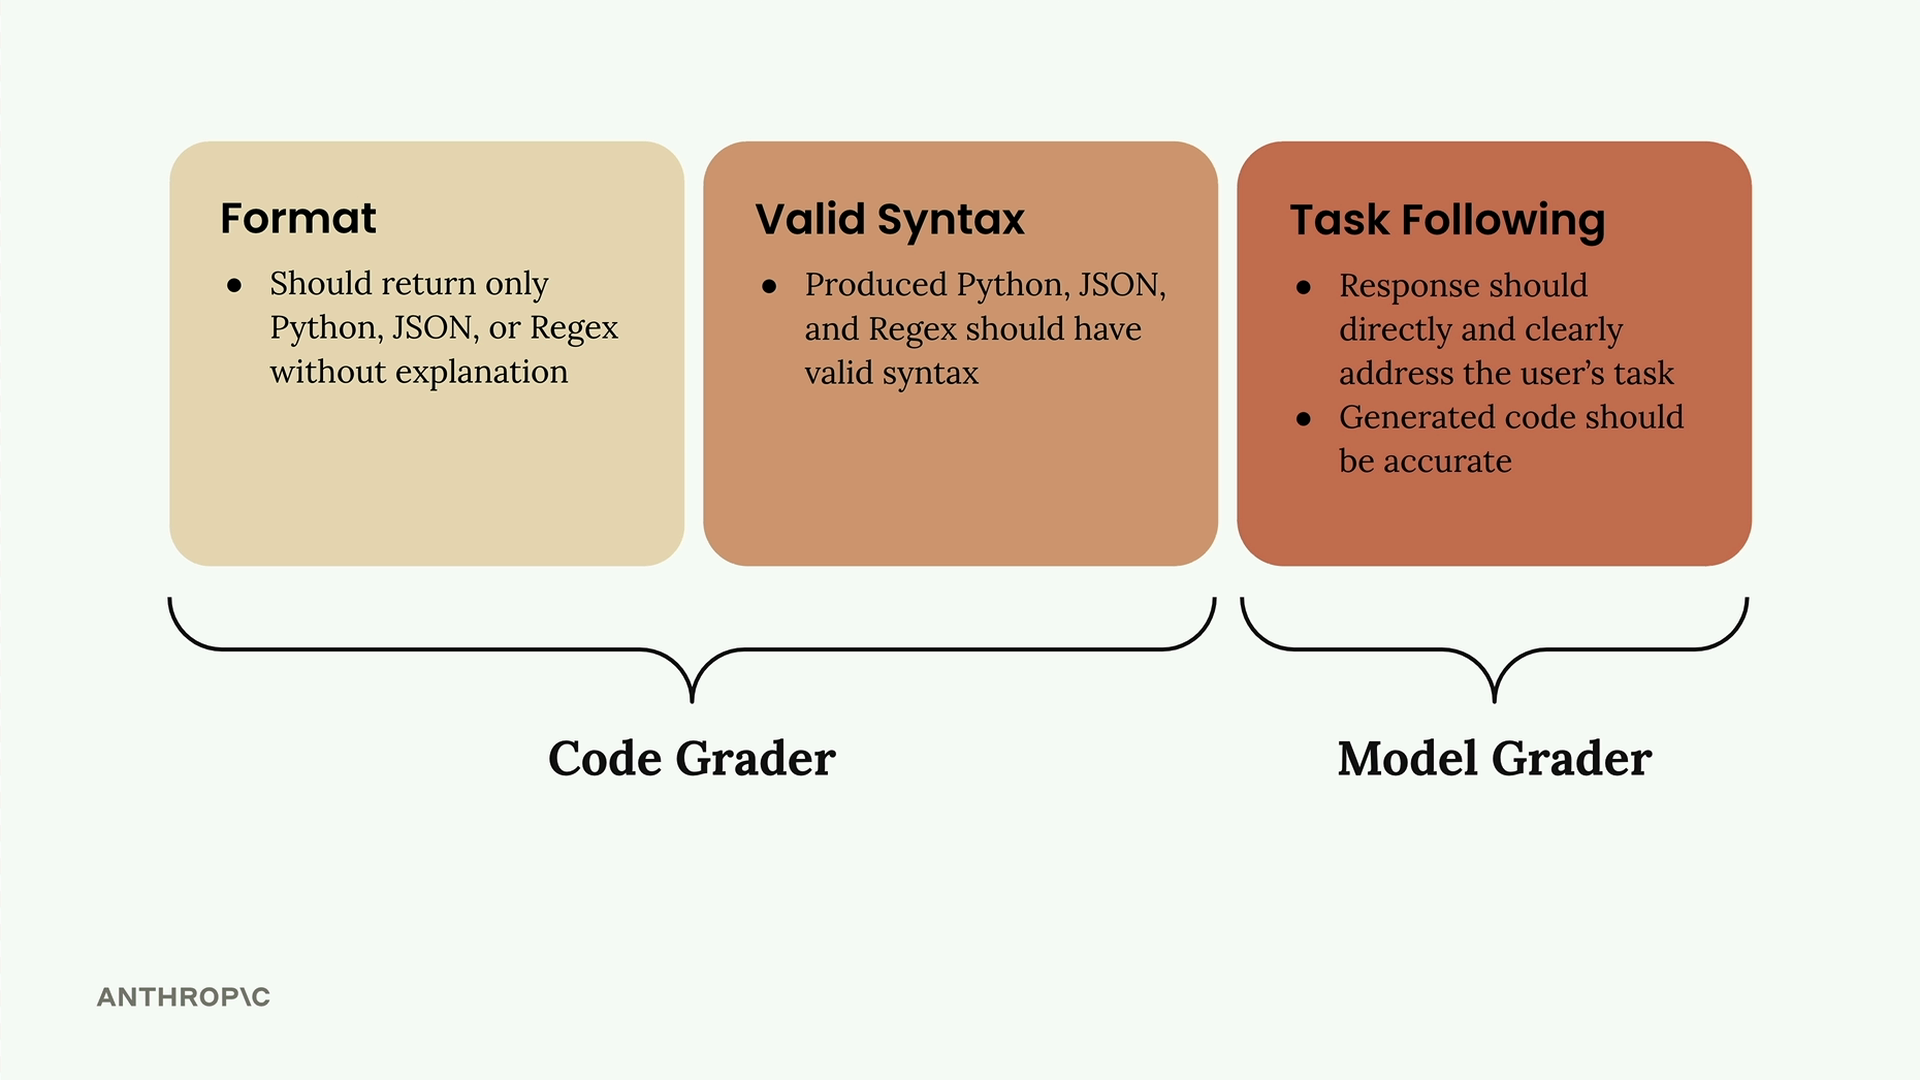
Die ersten beiden Kriterien funktionieren gut mit Code-Gradern, während die Aufgabenbefolgung aufgrund ihrer Flexibilität besser für Modell-Grader geeignet ist.
Implementierung eines Modell-Graders
Modell-Grader sind oft am einfachsten zu implementieren. Hier ist eine grundlegende Struktur:
def grade_by_model(test_case, output):
    messages = []
    add_user_message(messages, eval_prompt)
    add_assistant_message(messages, "```json")
    eval_text = chat(messages, stop_sequences=["```"])
    return json.loads(eval_text)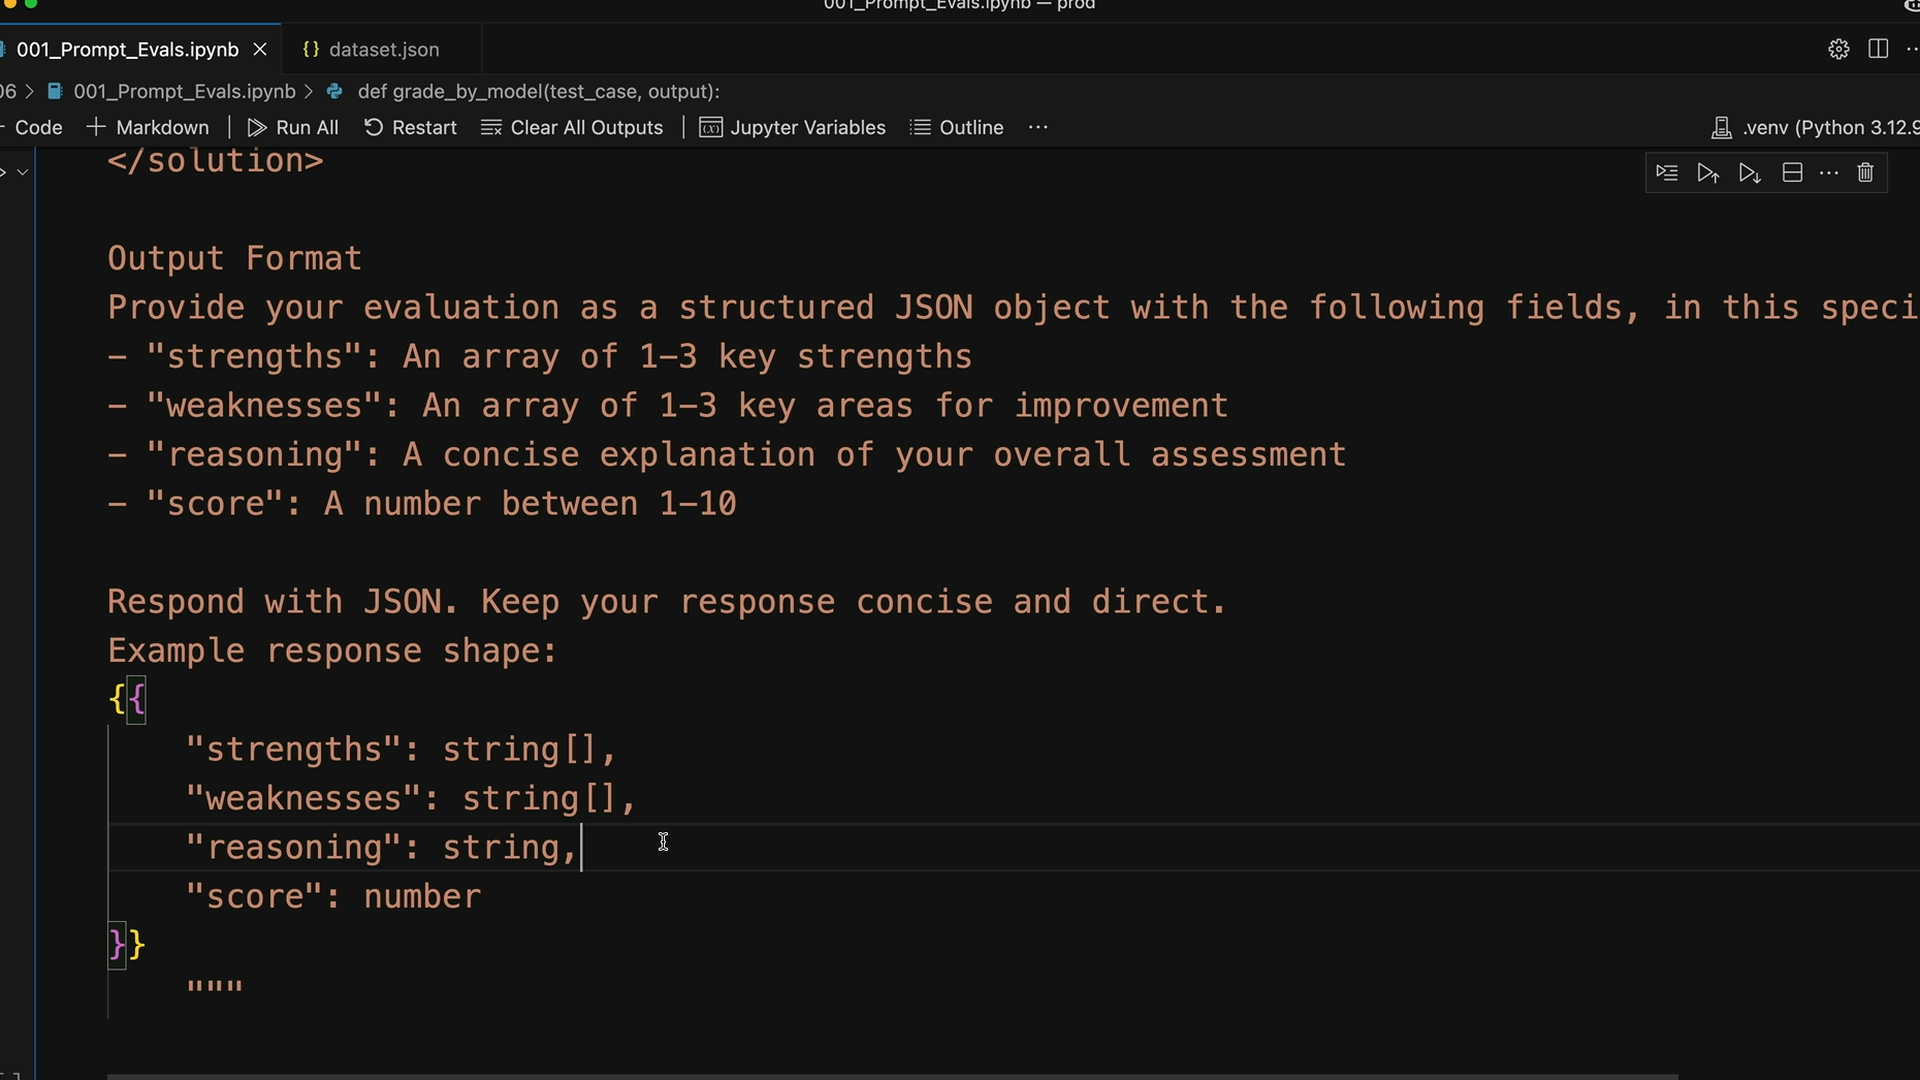
Der Bewertungs-Prompt sollte umfassend sein und Folgendes enthalten:
- Klare Rollendefinition für den Grader
- Die ursprüngliche Aufgabe
- Die zu bewertende KI-generierte Lösung
- Spezifische Anforderungen an das Ausgabeformat
Fordere mehr als nur eine Punktzahl an. Verlange Stärken, Schwächen und Begründungen zusammen mit der numerischen Bewertung. Dies verhindert, dass das Modell standardmäßig auf mittelmäßige Werte wie 6 zurückgreift, und erzwingt eine durchdachtere Bewertung.
Integration von Gradern in deinen Workflow
Sobald du eine Grader-Funktion hast, integriere sie in deinen Testfall-Runner:
def run_test_case(test_case):
    output = run_prompt(test_case)

    # Call the model grader
    model_grade = grade_by_model(test_case, output)
    score = model_grade["score"]
    reasoning = model_grade["reasoning"]

    return {
        "output": output,
        "test_case": test_case,
        "score": score,
        "reasoning": reasoning
    }
Nachdem du alle Testfälle ausgeführt hast, berechne einen Durchschnittswert, um eine objektive Kennzahl für die Leistung deines Prompts zu erhalten:
from statistics import mean

def run_eval(dataset):
    results = []
    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    average_score = mean([result["score"] for result in results])
    print(f"Average score: {average_score}")

    return results
Dies gibt dir eine konkrete Zahl, auf deren Verbesserung du dich konzentrieren kannst. Während Modell-Grader etwas unberechenbar sein können und von besserer Anleitung profitieren könnten, bieten sie einen Ausgangspunkt für eine objektive Bewertung, die du iterieren und verbessern kannst.