Wenn du mit Claude arbeitest, ist das Schreiben eines guten Prompts nur der Anfang. Um zuverlässige KI-Anwendungen zu entwickeln, musst du zwei entscheidende Konzepte verstehen: Prompt Engineering und Prompt-Evaluierung. Prompt Engineering gibt dir Techniken, um bessere Prompts zu schreiben, während Prompt-Evaluierung dir hilft zu messen, wie gut diese Prompts tatsächlich funktionieren.
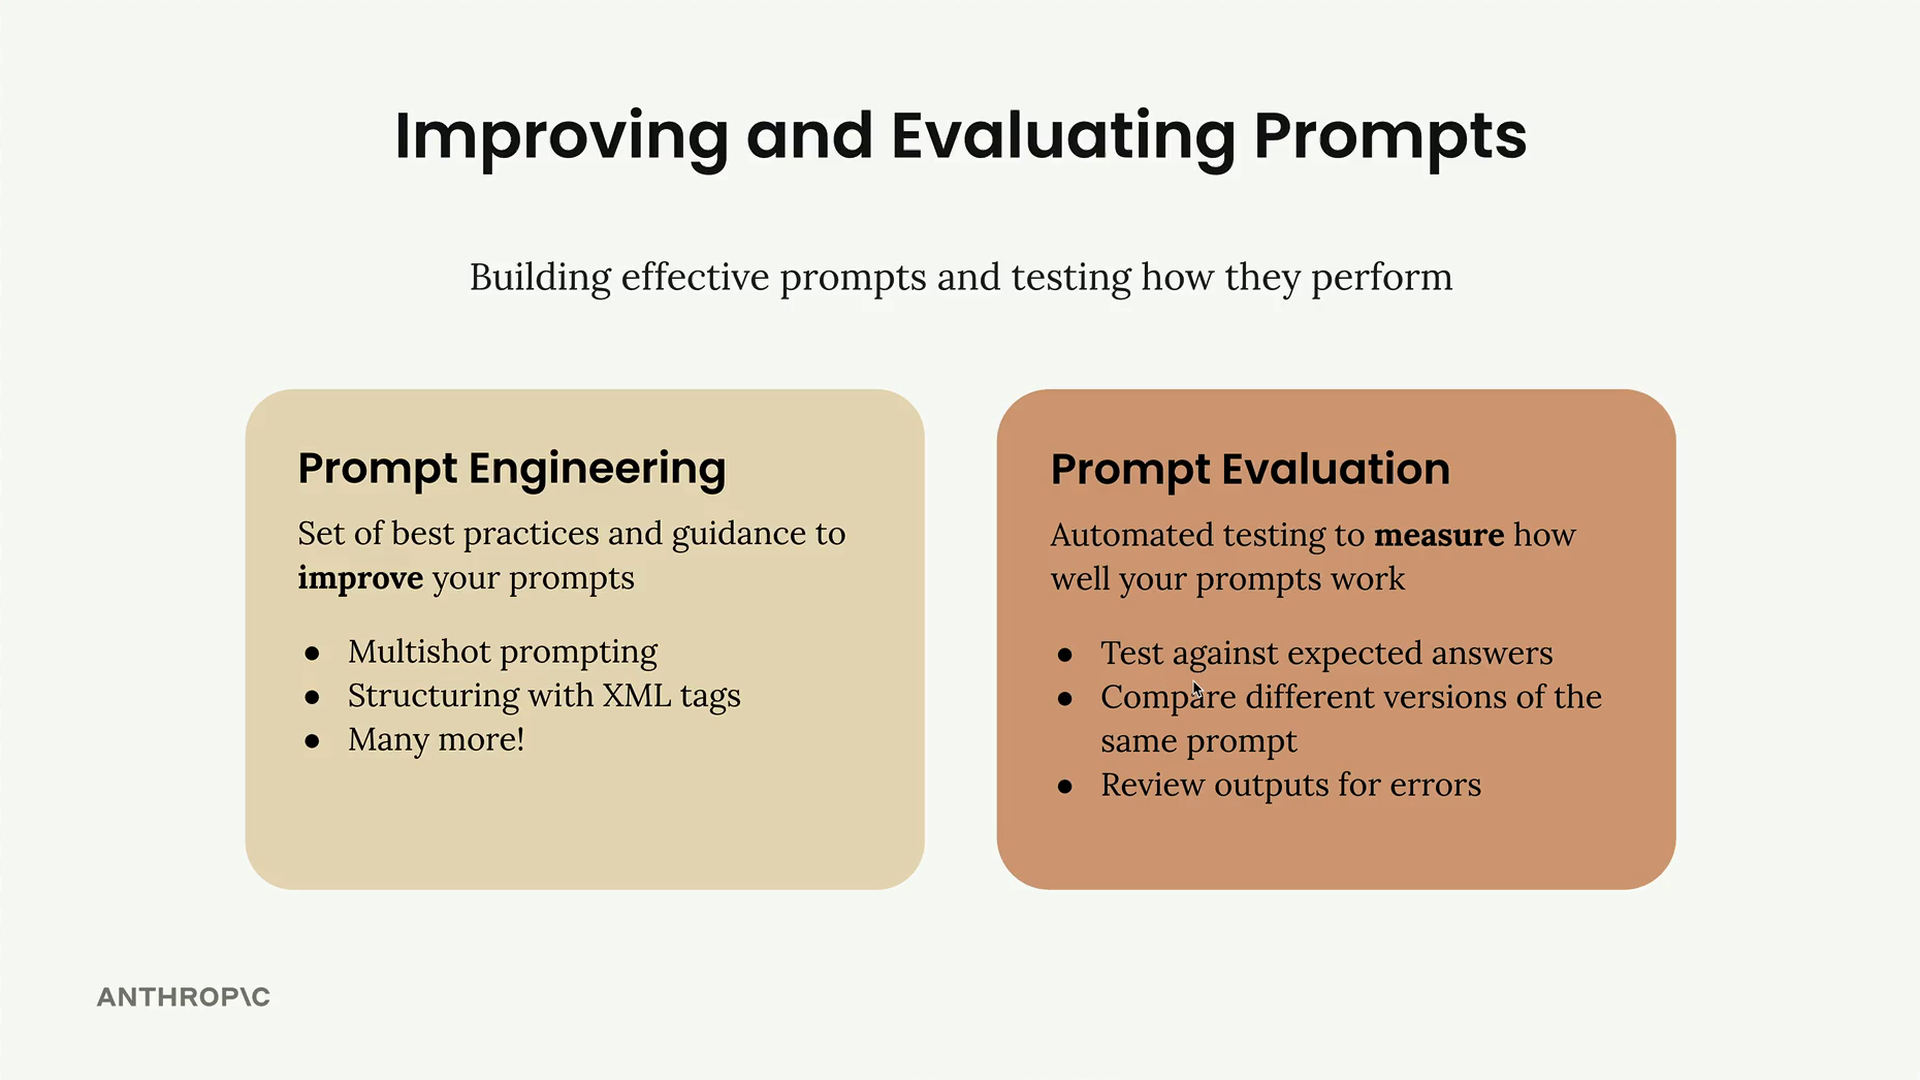
Prompt Engineering vs. Prompt-Evaluierung
Prompt Engineering ist dein Werkzeugkasten zum Schreiben und Verbessern von Prompts. Es ist eine Sammlung von Best Practices, die Claude helfen, genau zu verstehen, was du fragst und wie du möchtest, dass es antwortet. Betrachte es als das Handwerk des Prompt-Schreibens - Techniken wie Multishot-Prompting, Strukturierung mit XML-Tags und viele weitere Ansätze, die wir erkunden werden.
Prompt-Evaluierung hingegen dreht sich um Messung. Es handelt sich um automatisiertes Testen, das dir objektive Metriken darüber liefert, ob deine Prompts tatsächlich effektiv sind. Anstatt zu raten, ob dein Prompt gut funktioniert, ermöglicht dir die Evaluierung:
- Gegen erwartete Antworten zu testen
- Verschiedene Versionen desselben Prompts zu vergleichen
- Ausgaben auf Fehler zu überprüfen
Die drei Wege nach dem Schreiben eines Prompts
Sobald du einen Prompt entworfen hast, stehst du typischerweise vor drei Optionen für die nächsten Schritte:
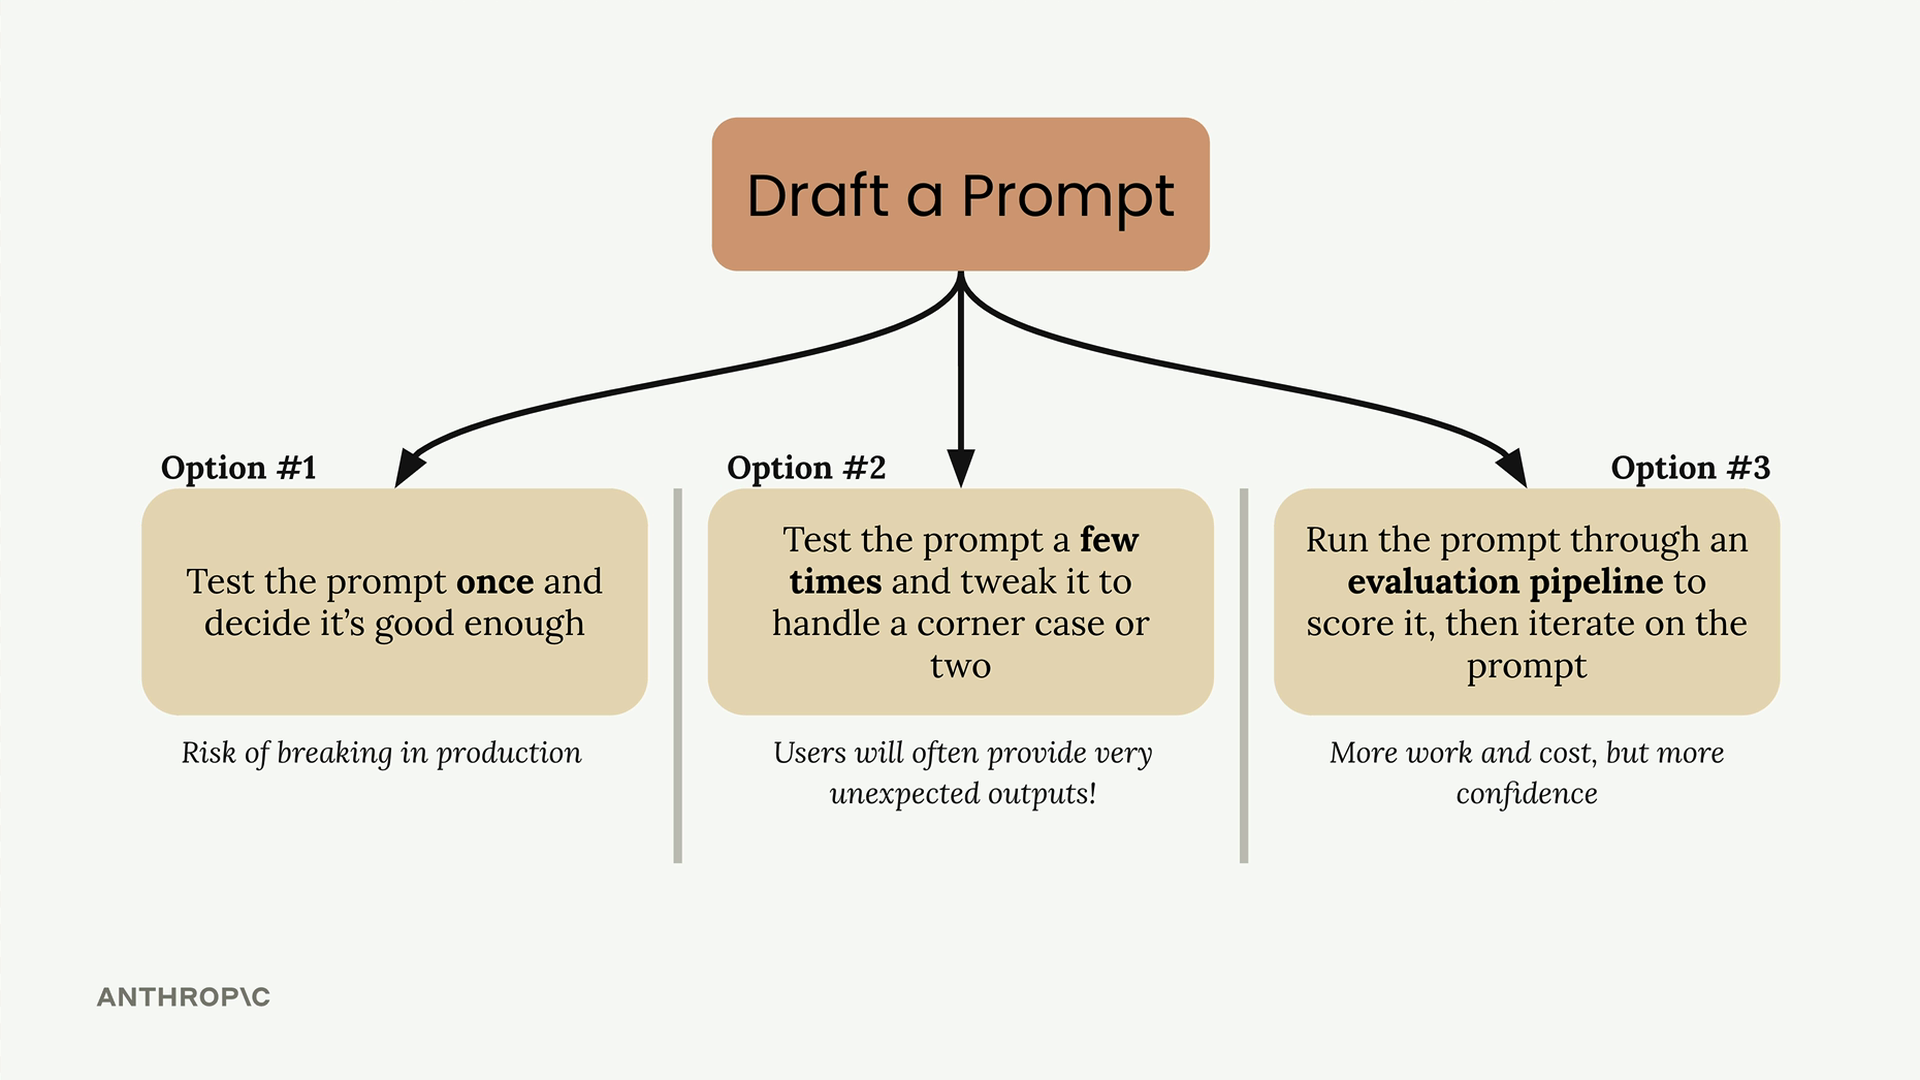
Option 1: Den Prompt einmal testen und entscheiden, dass er gut genug ist. Dies birgt ein erhebliches Risiko, in der Produktion zu versagen, wenn Nutzer unerwartete Eingaben machen.
Option 2: Den Prompt ein paar Mal testen und ihn anpassen, um einen oder zwei Sonderfälle zu behandeln. Obwohl besser als Option 1, werden Nutzer oft sehr unerwartete Ausgaben liefern, die du nicht berücksichtigt hast.
Option 3: Den Prompt durch eine Evaluierungspipeline laufen lassen, um ihn zu bewerten, und dann den Prompt basierend auf objektiven Daten iterieren. Dies erfordert mehr Arbeit und Kosten im Voraus, gibt dir aber viel mehr Vertrauen in die Zuverlässigkeit deines Prompts.
Warum die meisten Entwickler in Testfallen tappen
Optionen 1 und 2 sind Fallen, in die alle Entwickler tappen - mich eingeschlossen. Es ist natürlich, einen Prompt zu schreiben, ihn ein paar Mal mit eigenen Eingaben zu testen und zu denken „das sieht gut genug aus". Aber wenn du ernsthafte Anwendungen entwickelst, führt dieser Ansatz oft zu Problemen in der Produktion.
Das Problem ist, dass du nicht alle Arten vorhersagen kannst, wie Nutzer mit deinem Prompt interagieren werden. Was in deinen begrenzten Tests perfekt zu funktionieren scheint, kann bei realen Nutzungsmustern völlig versagen.
Der Wert systematischer Evaluierung
Option 3 - das Durchlaufen deines Prompts durch eine Evaluierungspipeline - liefert dir objektive Daten über die Leistung. Anstatt dich auf Bauchgefühle oder begrenzte manuelle Tests zu verlassen, erhältst du messbare Werte, die dir zeigen, wie gut dein Prompt mit einer Vielzahl von Eingaben umgeht.
Dieser Ansatz ermöglicht es dir, selbstbewusst zu iterieren. Du kannst Änderungen an deinem Prompt vornehmen und sofort sehen, ob diese Änderungen die Leistung verbessern oder verschlechtern. Es ist der Unterschied zwischen Raten und Wissen, ob deine Prompt-Verbesserungen tatsächlich funktionieren.
Während Evaluierung eine größere Vorabinvestition an Zeit und Ressourcen erfordert, zahlt sie sich aus, wenn du zuverlässige, produktionsreife Prompts benötigst, die konsistent über vielfältige Nutzereingaben hinweg funktionieren.