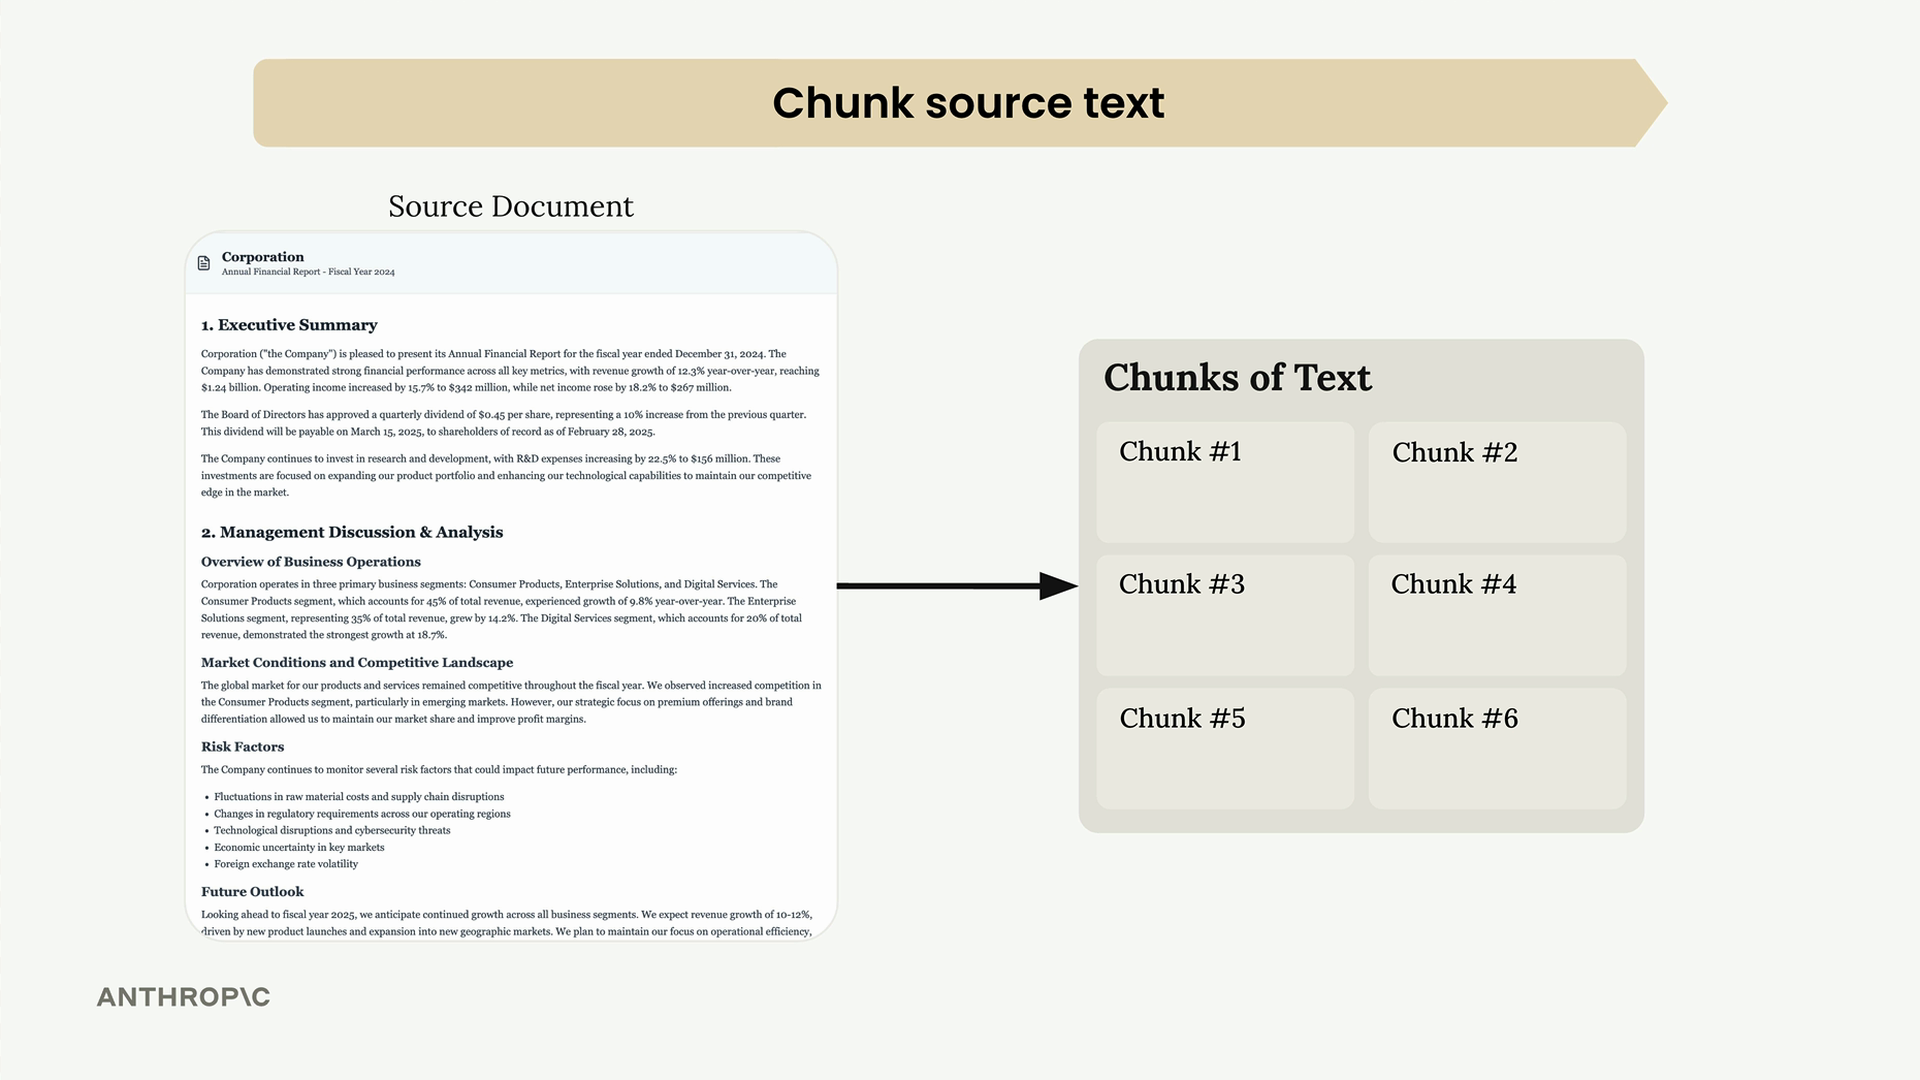
Text-Chunking ist einer der kritischsten Schritte beim Aufbau einer RAG-Pipeline (Retrieval Augmented Generation). Wie du deine Dokumente aufteilst, wirkt sich direkt auf die Qualität deines gesamten Systems aus. Eine schlechte Chunking-Strategie kann dazu führen, dass irrelevanter Kontext in deine Prompts eingefügt wird, was dazu führt, dass deine KI völlig falsche Antworten gibt.
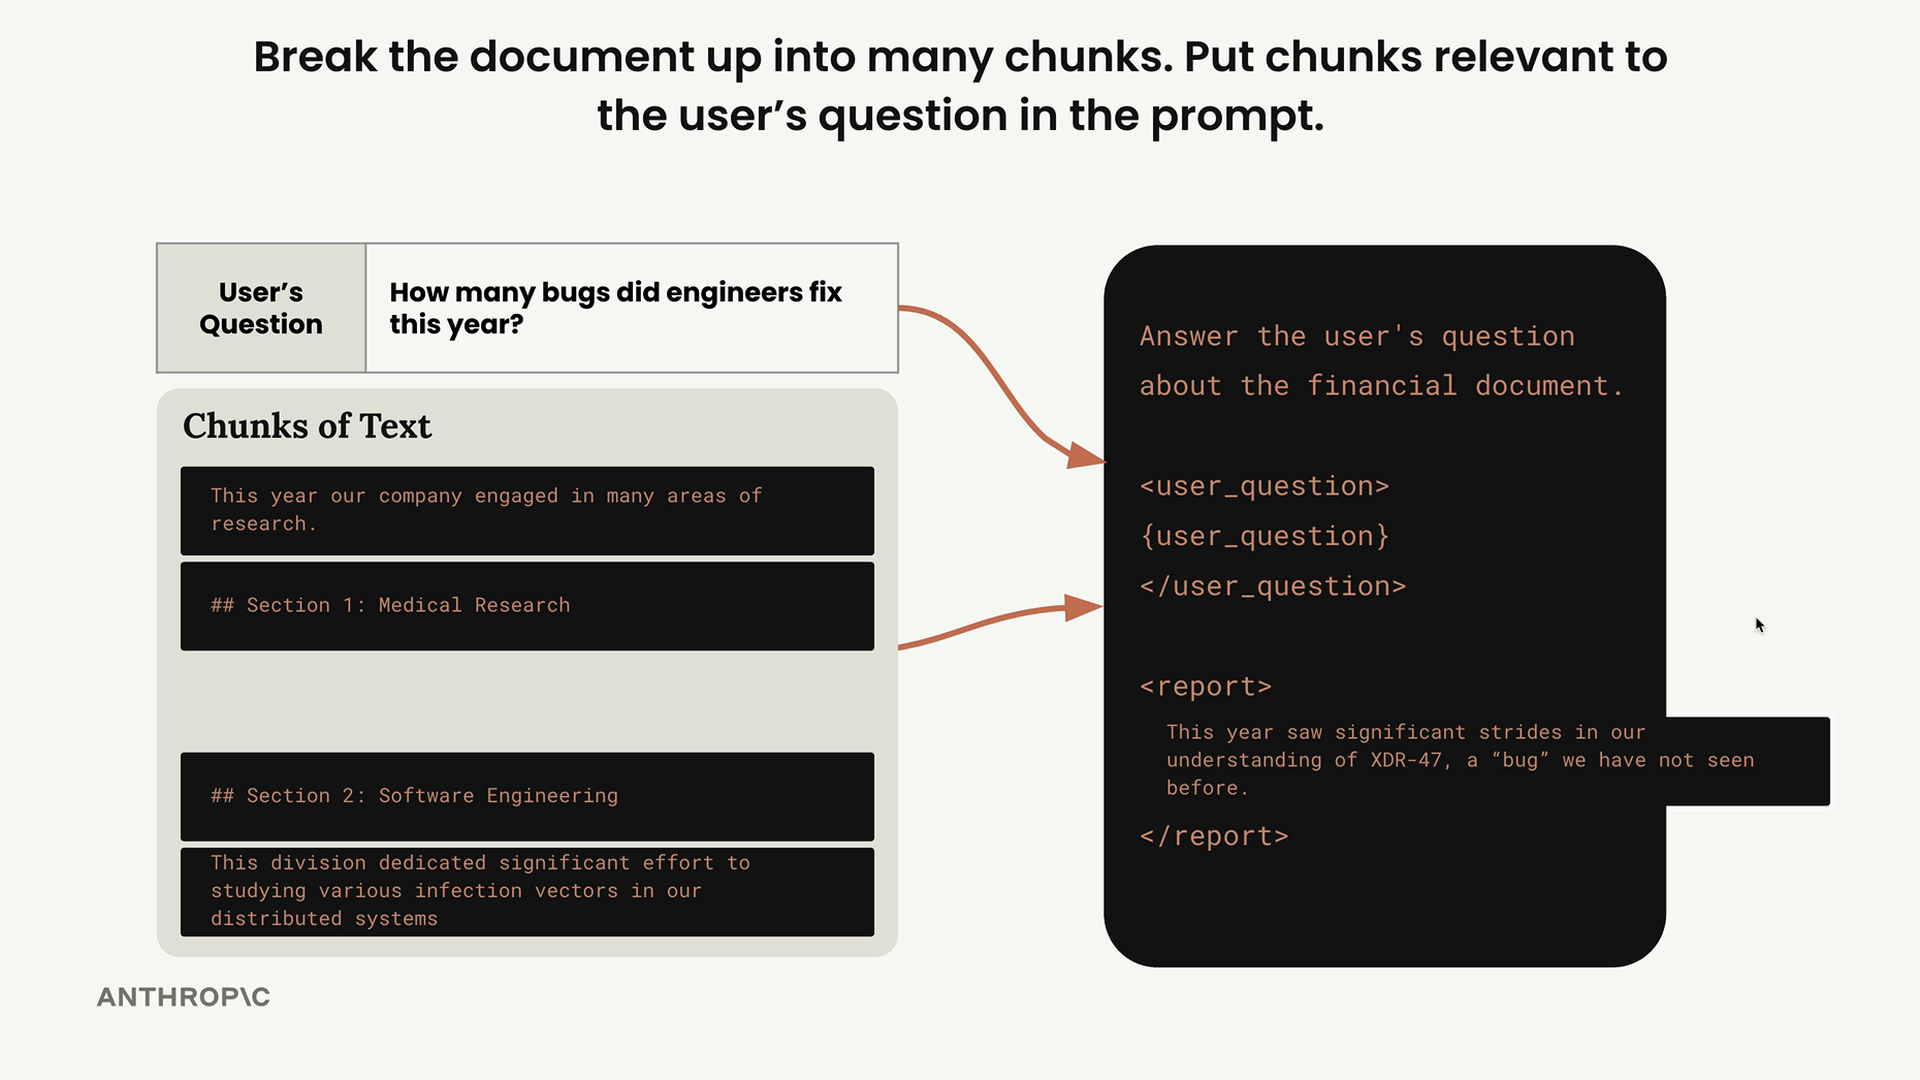
Betrachte dieses Beispiel: Du hast ein Dokument mit Abschnitten zu medizinischer Forschung und Softwareentwicklung. Wenn du schlecht chunkst, könnte ein Nutzer, der fragt „Wie viele Bugs haben die Ingenieure dieses Jahr behoben?", Informationen über medizinische Forschung anstatt über Softwareentwicklung erhalten, einfach weil der medizinische Abschnitt das Wort „Bug" in einem anderen Kontext enthielt.
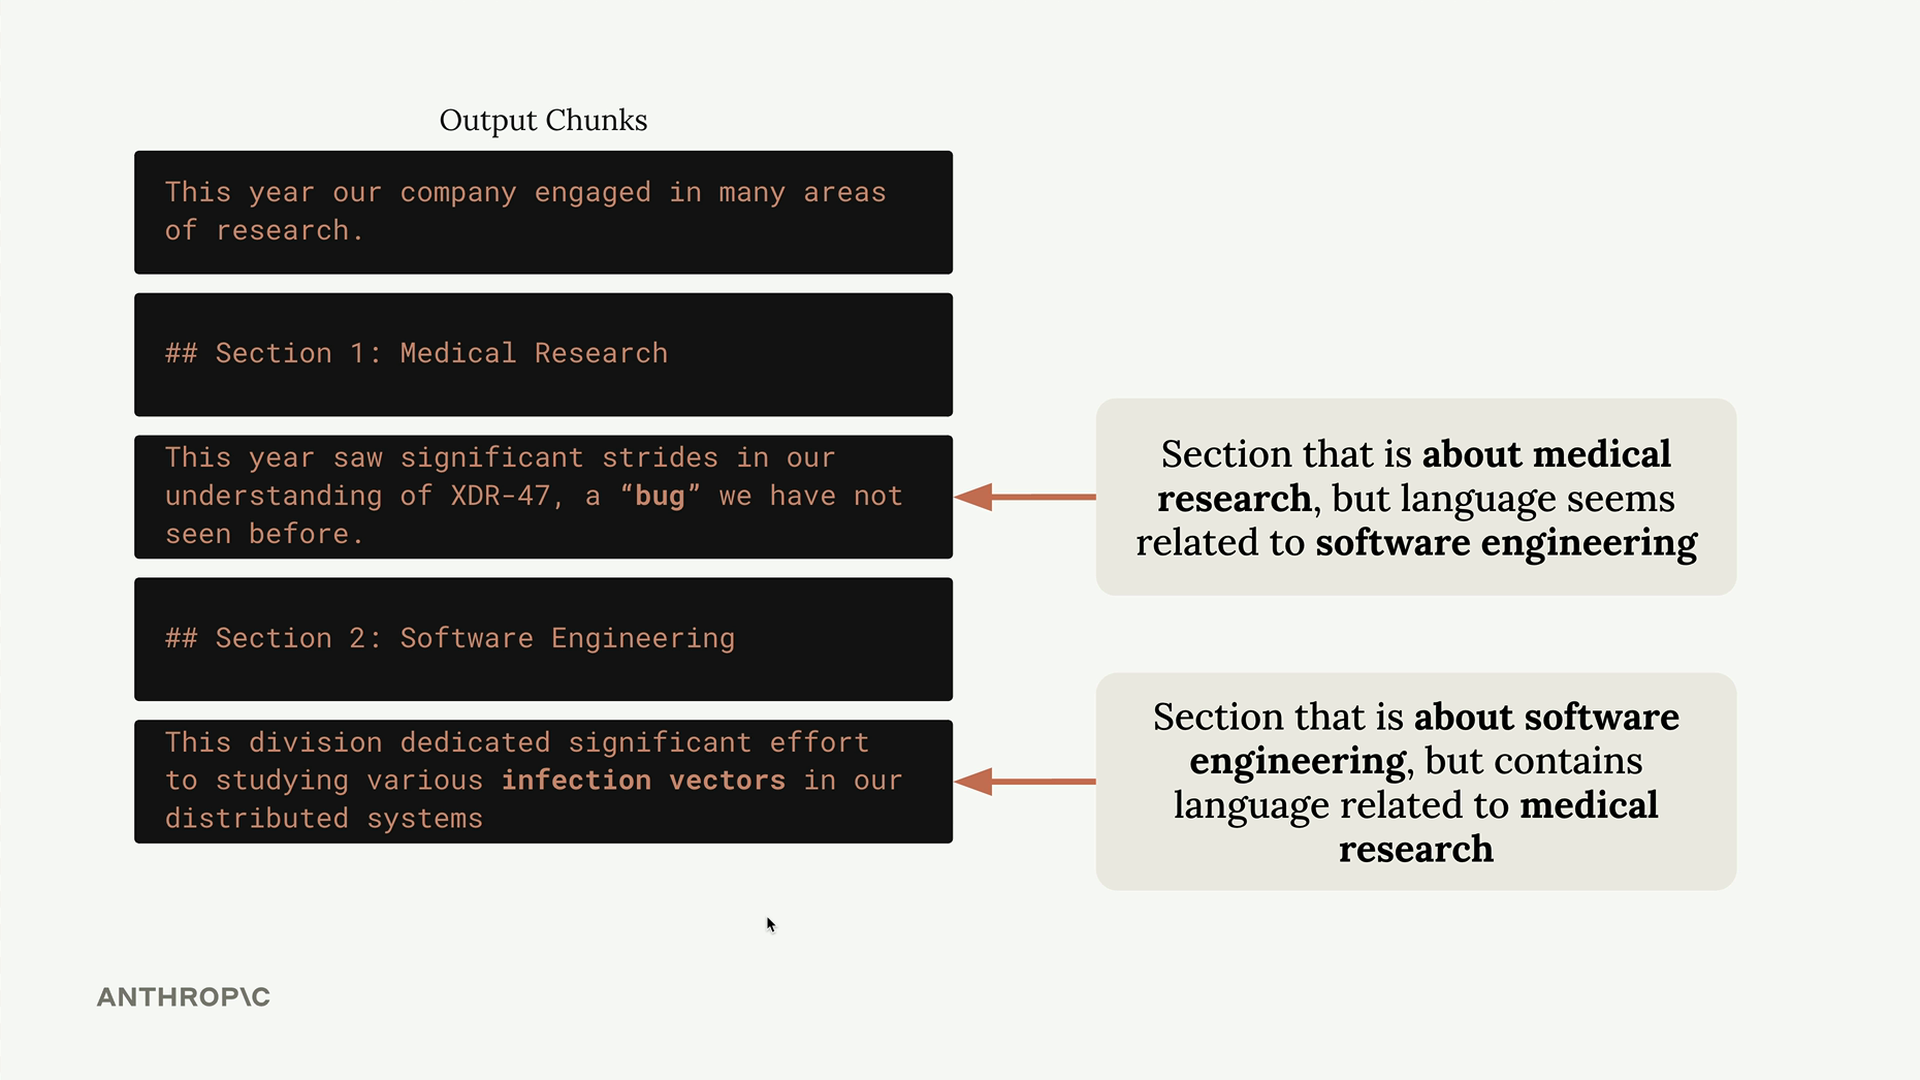
Dies zeigt, warum die Chunking-Strategie so wichtig ist. Das Ziel ist es, Chunks zu erstellen, die semantische Kohärenz bewahren und bei der Abfrage sinnvollen Kontext liefern.
Drei Haupt-Chunking-Strategien
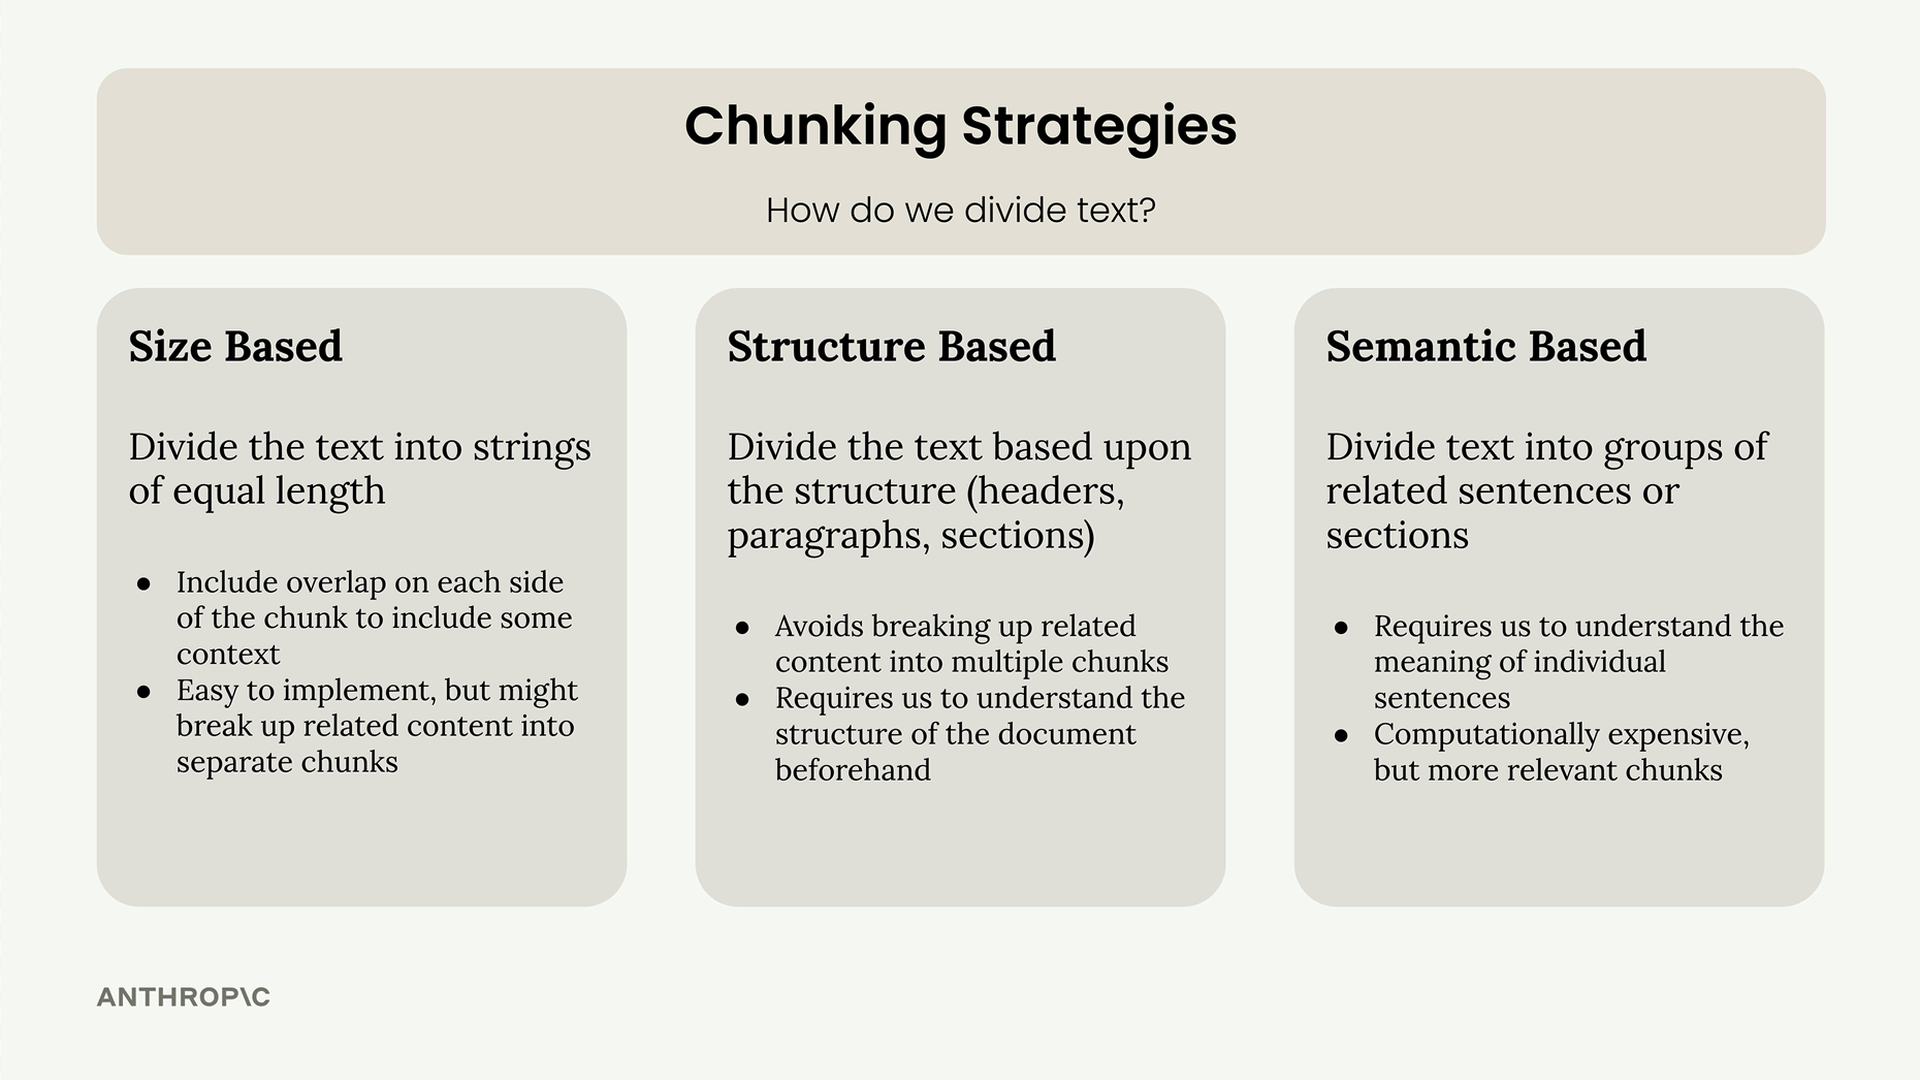
Es gibt drei primäre Ansätze zum Chunking von Text, jeder mit unterschiedlichen Vorteilen und Kompromissen:
- Größenbasiert: Teile den Text in Strings gleicher Länge auf
- Strukturbasiert: Teile basierend auf der Dokumentstruktur (Überschriften, Absätze, Abschnitte)
- Semantisch-basiert: Gruppiere verwandte Sätze oder Abschnitte mithilfe von NLP-Techniken
Größenbasiertes Chunking
Größenbasiertes Chunking ist der unkomplizierteste Ansatz. Du teilst dein Dokument einfach in Chunks mit ungefähr gleicher Zeichen- oder Wortanzahl auf. Es ist einfach zu implementieren und funktioniert zuverlässig über verschiedene Dokumenttypen hinweg.
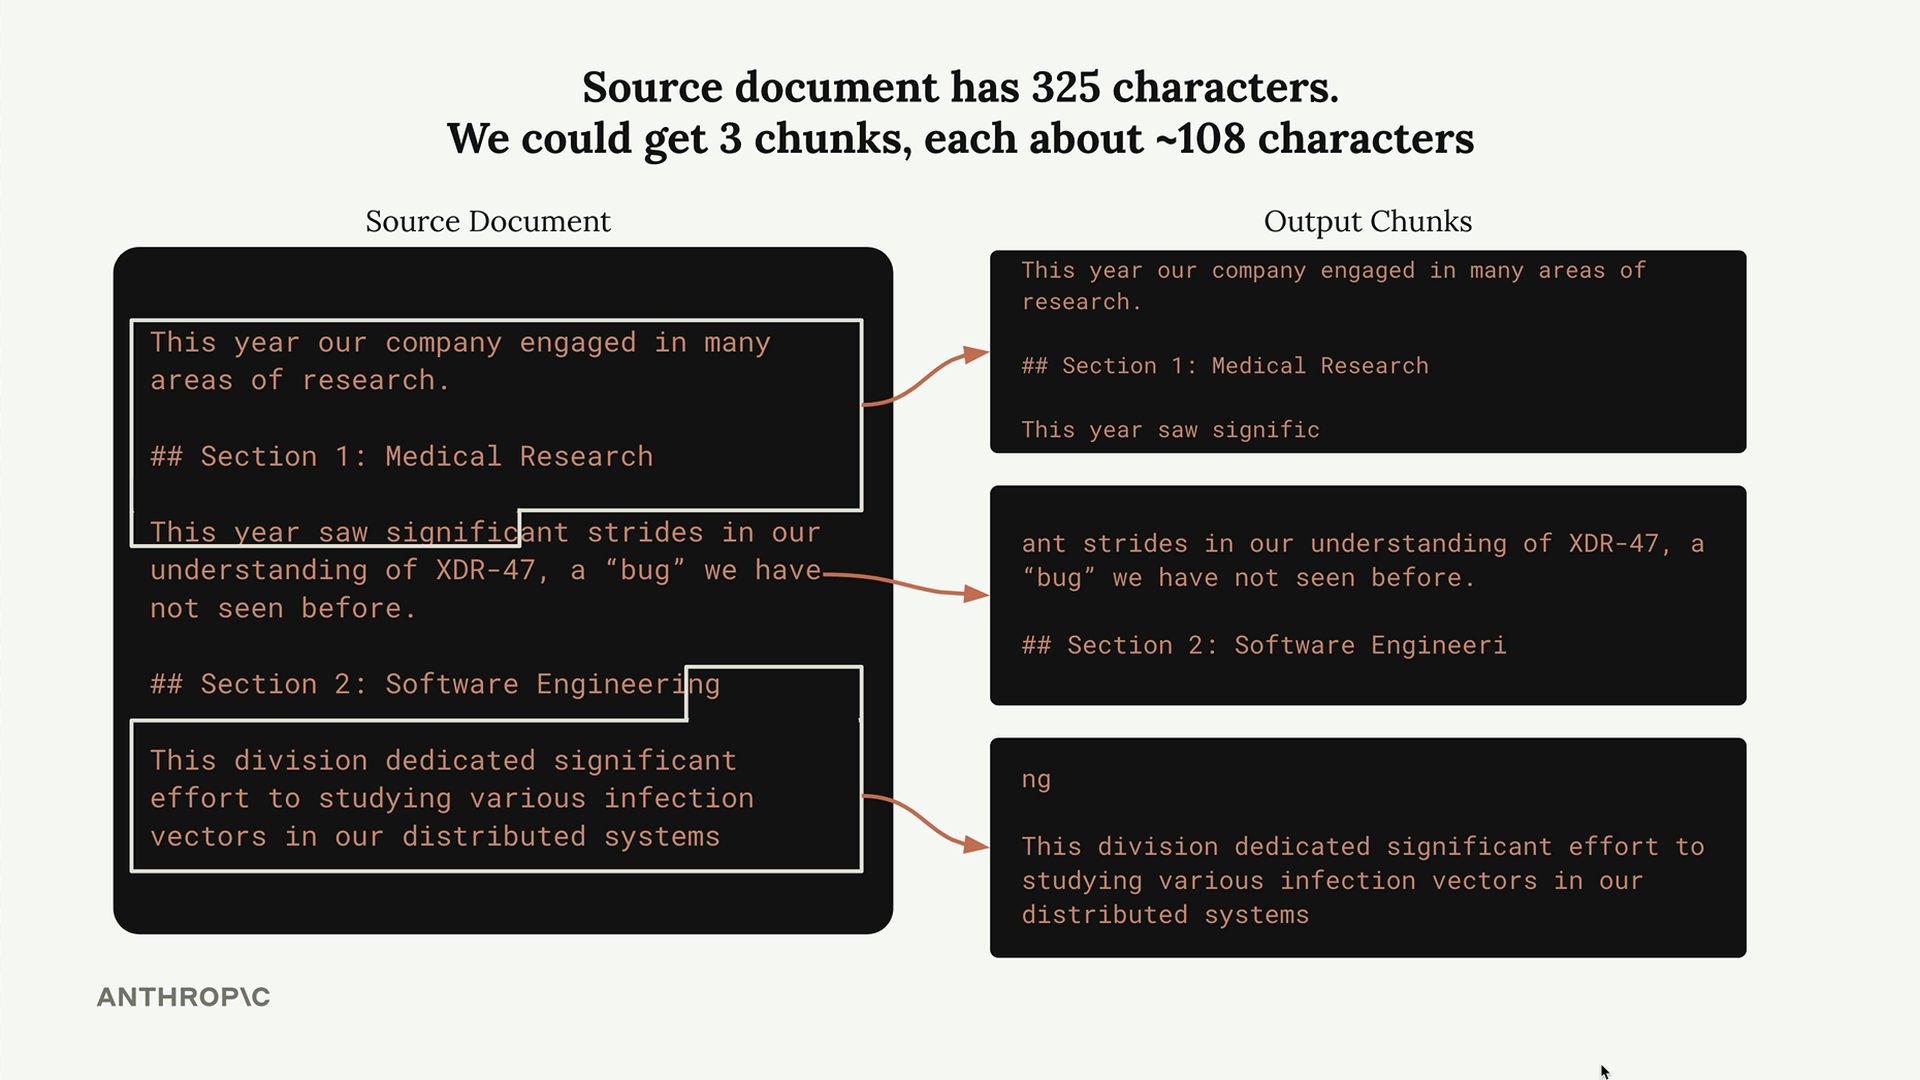
Dieser Ansatz hat jedoch klare Nachteile. Wörter werden mitten im Satz abgeschnitten, und Chunks verlieren wichtigen Kontext. Zum Beispiel könnte ein Chunk die Abschnittsüberschrift nicht enthalten, die erklären würde, worum es im Inhalt tatsächlich geht.
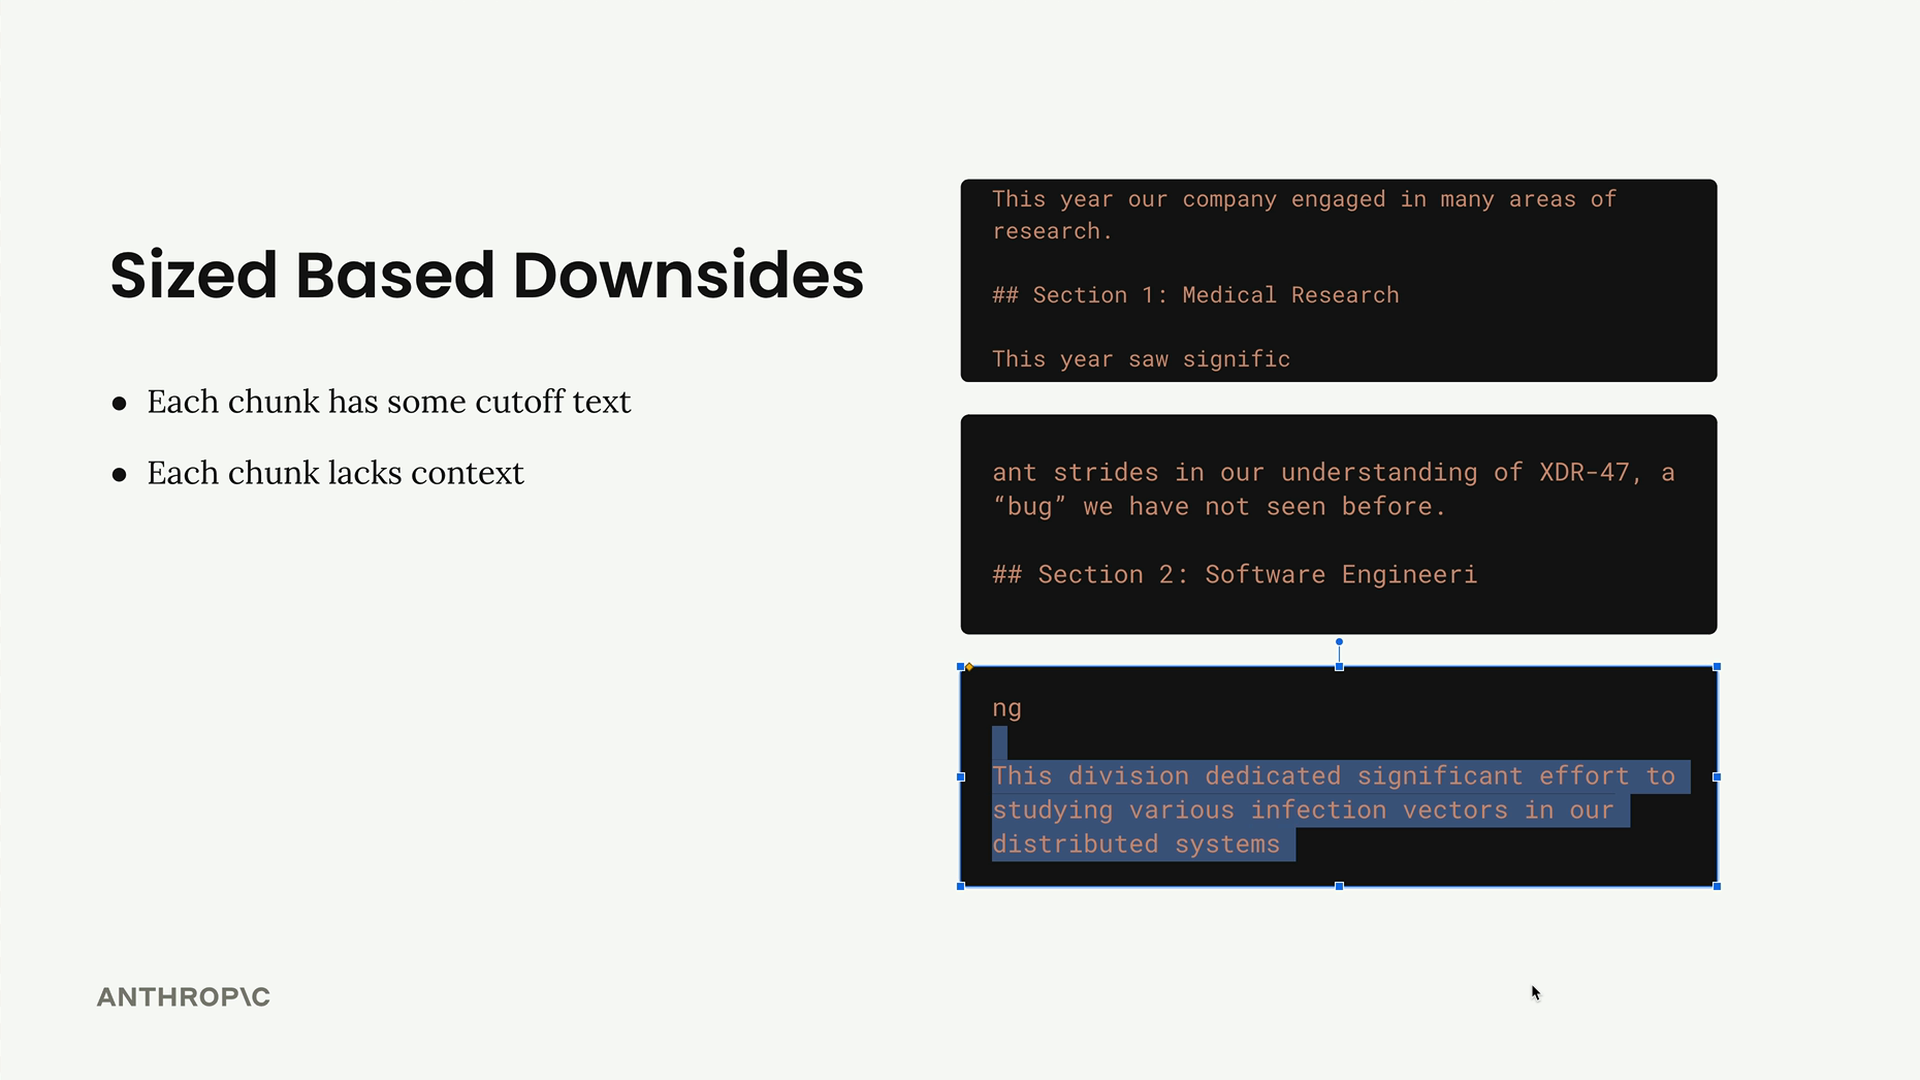
Die Lösung besteht darin, eine Überlappung zwischen den Chunks hinzuzufügen. Jeder Chunk enthält einige Zeichen aus benachbarten Chunks, was eine bessere Kontexterhaltung gewährleistet und abrupte Abschnitte vermeidet.
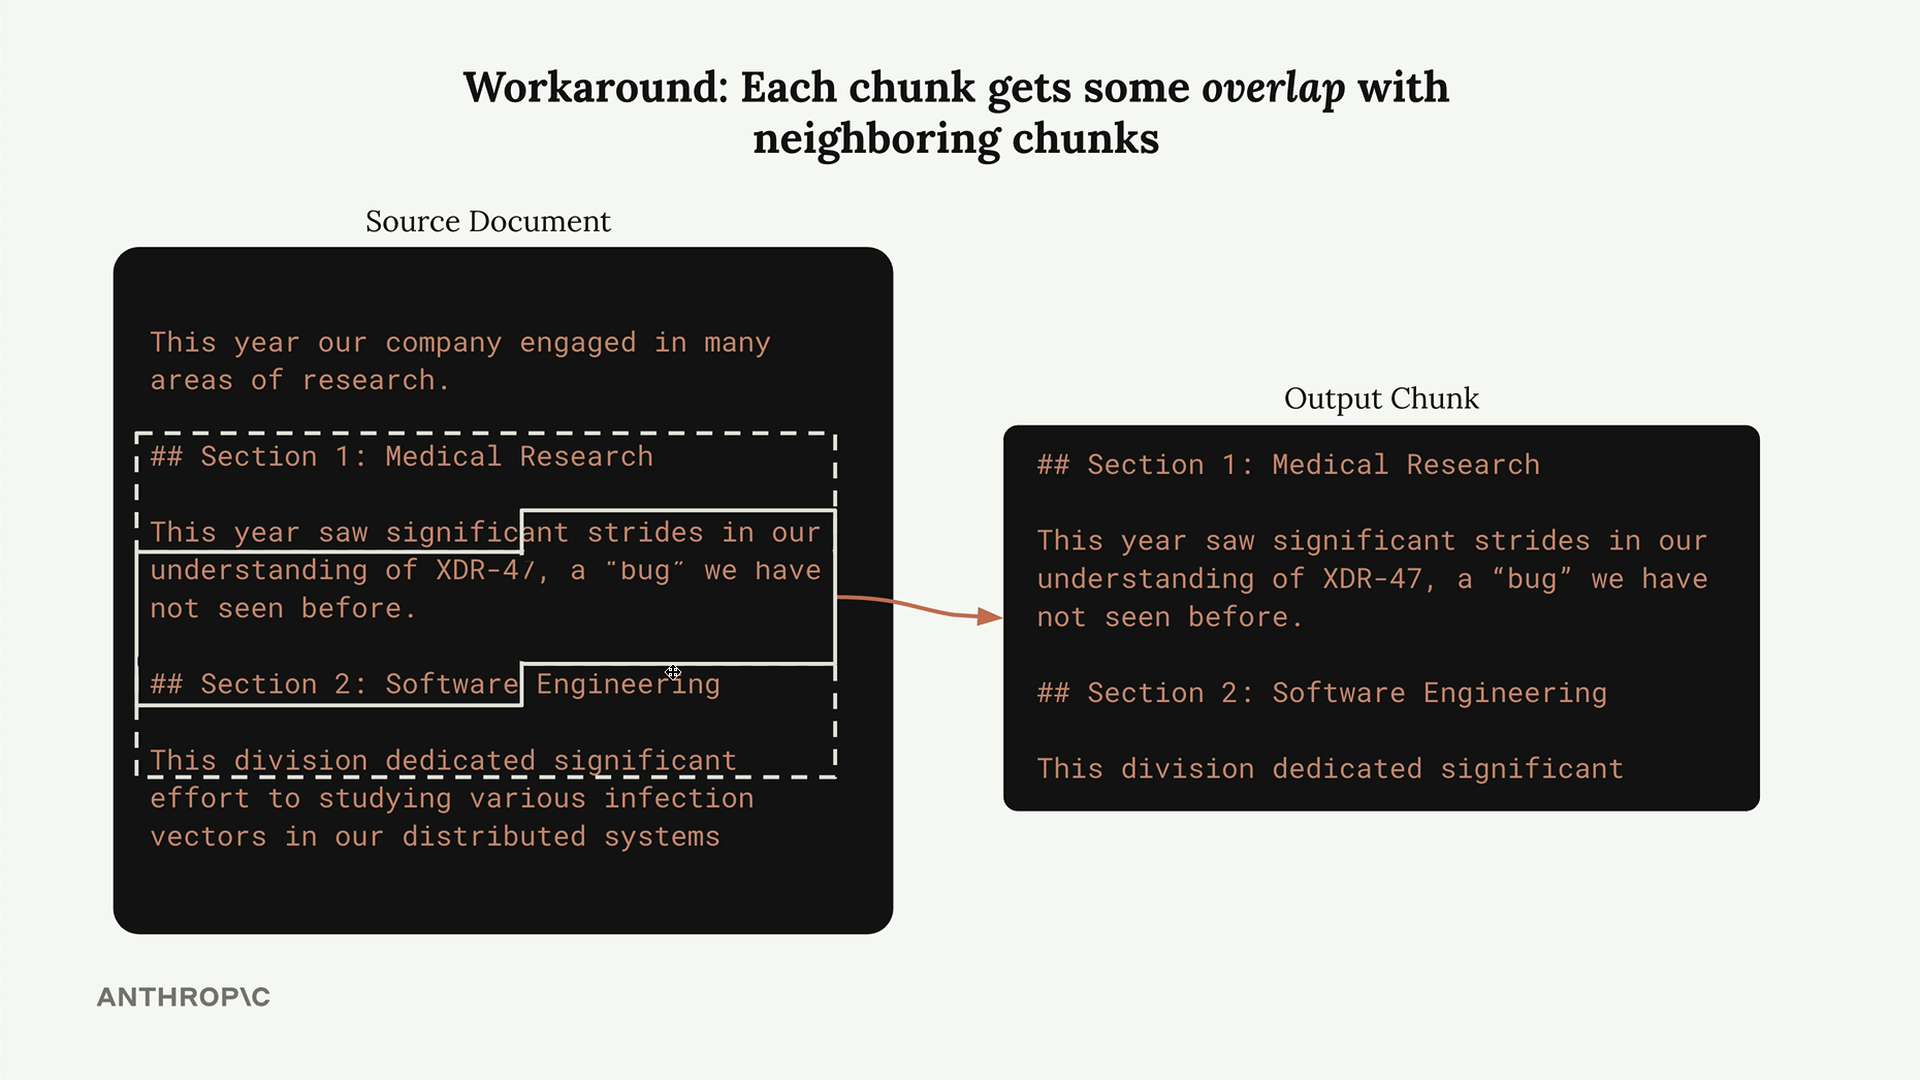
Hier ist eine grundlegende Implementierung von zeichenbasiertem Chunking mit Überlappung:
def chunk_by_char(text, chunk_size=150, chunk_overlap=20):
    chunks = []
    start_idx = 0

    while start_idx < len(text):
        end_idx = min(start_idx + chunk_size, len(text))
        chunk_text = text[start_idx:end_idx]
        chunks.append(chunk_text)

        start_idx = (
            end_idx - chunk_overlap if end_idx < len(text) else len(text)
        )

    return chunks
Strukturbasiertes Chunking
Strukturbasiertes Chunking nutzt die natürliche Organisation deiner Dokumente. Wenn du mit Markdown-Dateien arbeitest, kannst du anhand von Überschriften aufteilen. Bei anderen Formaten könntest du anhand von Absätzen oder anderen strukturellen Elementen aufteilen.
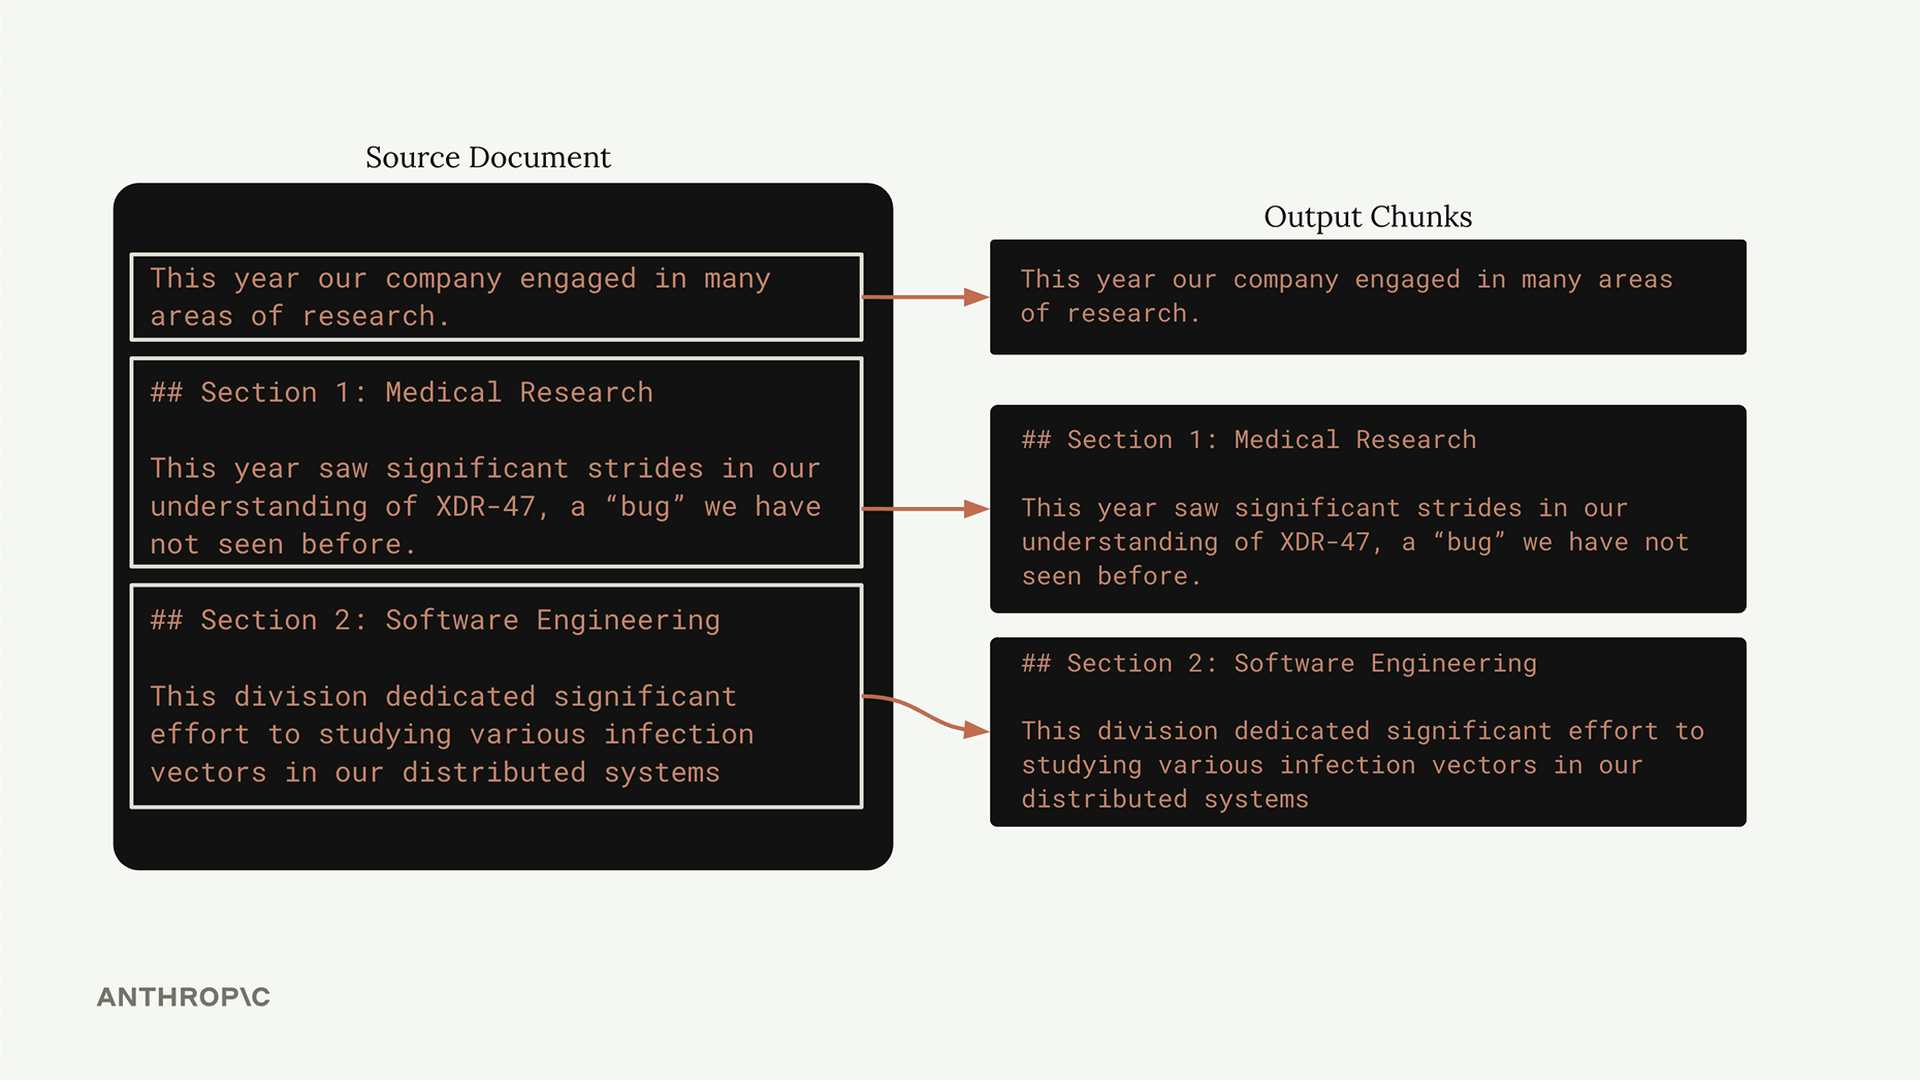
Dieser Ansatz funktioniert hervorragend, wenn du Garantien über die Dokumentstruktur hast. Bei Markdown-Dokumenten kannst du anhand von Abschnittsüberschriften aufteilen:
def chunk_by_section(document_text):
    pattern = r'\n## '
    return re.split(pattern, document_text)
Die größte Einschränkung ist, dass viele Dokumente keine konsistente Struktur haben. Reine Textdateien, PDFs oder von Nutzern hochgeladene Dokumente haben möglicherweise keine klaren strukturellen Markierungen, anhand derer man aufteilen könnte.
Semantisch-basiertes Chunking
Semantisch-basiertes Chunking ist der ausgefeilteste Ansatz. Er analysiert die Bedeutung und die Beziehungen zwischen Sätzen, um verwandte Inhalte zusammenzufassen. Dies umfasst typischerweise:
- Aufteilen des Textes in Sätze
- Verwendung von NLP-Techniken zur Messung semantischer Ähnlichkeit
- Gruppierung verwandter Sätze in kohärente Chunks
Obwohl dies die qualitativ hochwertigsten Chunks erzeugen kann, ist es rechenintensiv und komplexer zu implementieren. Für die meisten Anwendungen funktionieren die einfacheren Ansätze gut genug.
Praktische Implementierung
Hier ist eine satzbasierte Chunking-Funktion, die einen guten Mittelweg bietet:
def chunk_by_sentence(text, max_sentences_per_chunk=5, overlap_sentences=1):
    sentences = re.split(r'(?<=[.!?])\s+', text)
    chunks = []
    start_idx = 0

    while start_idx < len(sentences):
        end_idx = min(start_idx + max_sentences_per_chunk, len(sentences))
        current_chunk = sentences[start_idx:end_idx]
        chunks.append(' '.join(current_chunk))

        start_idx += max_sentences_per_chunk - overlap_sentences

        if start_idx < 0:
            start_idx = 0

    return chunks
Die richtige Strategie wählen
Deine Wahl der Chunking-Strategie hängt vollständig von deinem spezifischen Anwendungsfall ab:
- Konsistente Dokumentstruktur: Verwende strukturbasiertes Chunking für die saubersten Ergebnisse
- Gemischte Dokumenttypen: Satzbasiertes Chunking funktioniert oft gut
- Code oder technische Inhalte: Zeichenbasiertes Chunking ist am zuverlässigsten
- Unbekannte Dokumentformate: Zeichenbasiertes Chunking ist deine sicherste Wahl
Denke daran, dass Chunking oft ein iterativer Prozess ist. Beginne mit einem einfachen Ansatz, teste ihn mit deinen spezifischen Dokumenten und Anwendungsfällen und verfeinere ihn dann basierend auf den Ergebnissen. Die „beste" Chunking-Strategie ist diejenige, die für deine speziellen Daten und Anforderungen zuverlässig funktioniert.