Le découpage de texte est l'une des étapes les plus critiques dans la construction d'un pipeline RAG (Retrieval Augmented Generation). La façon dont vous découpez vos documents a un impact direct sur la qualité de l'ensemble de votre système. Une mauvaise stratégie de découpage peut conduire à l'insertion de contexte non pertinent dans vos invites, amenant votre IA à donner des réponses complètement erronées.
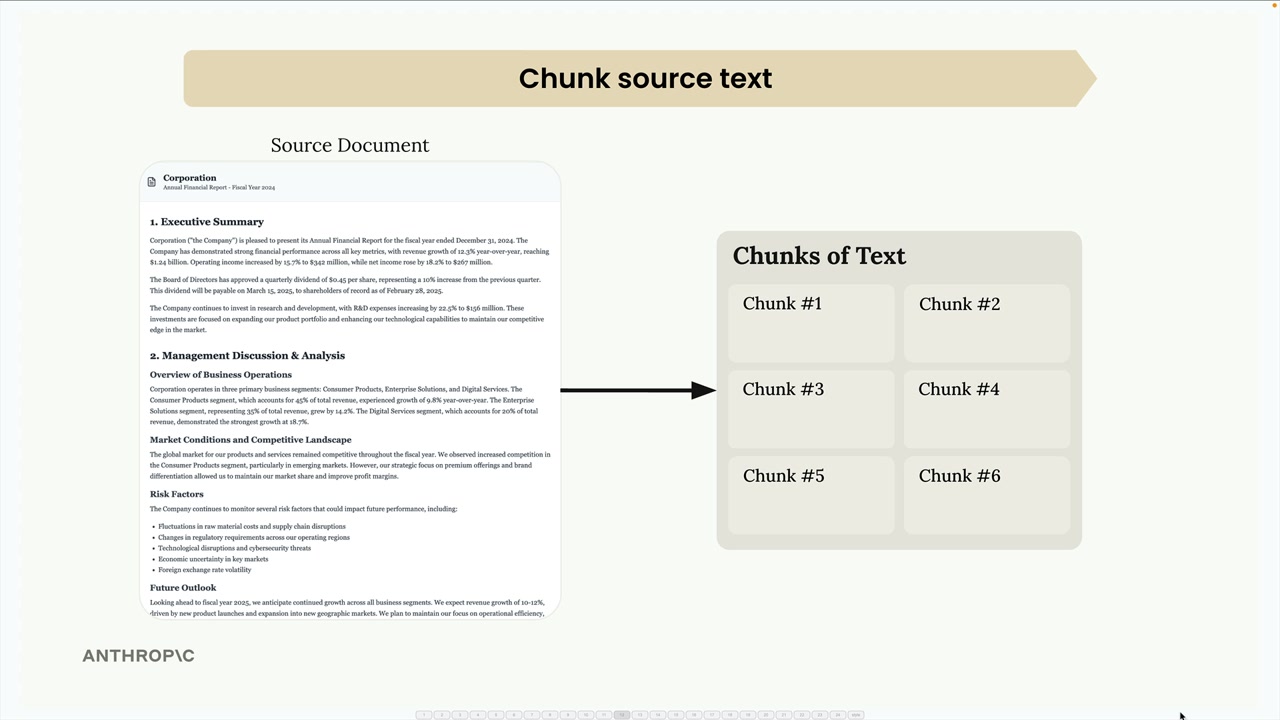
Considérez cet exemple : vous avez un document avec des sections sur la recherche médicale et l'ingénierie logicielle. Si vous découpez mal, un utilisateur demandant « Combien de bugs les ingénieurs ont-ils corrigés cette année ? » pourrait obtenir des informations sur la recherche médicale au lieu de l'ingénierie logicielle, simplement parce que la section médicale contenait le mot « bug » dans un contexte différent.
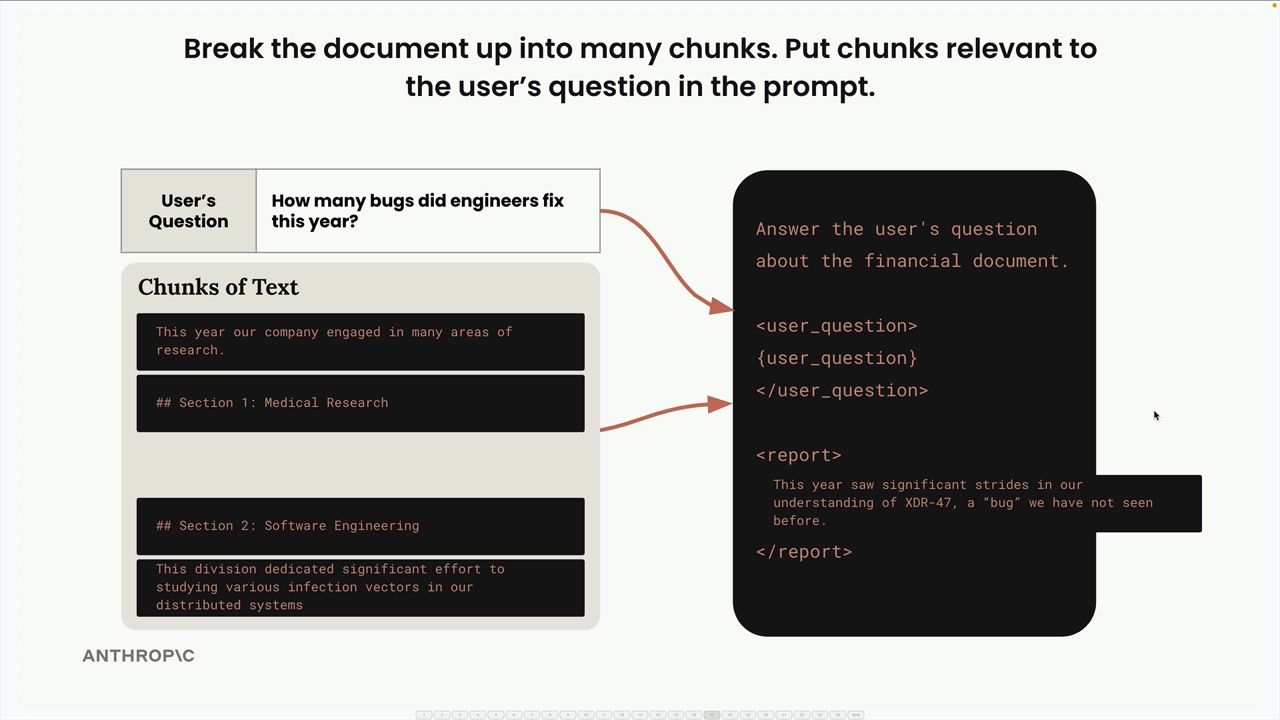
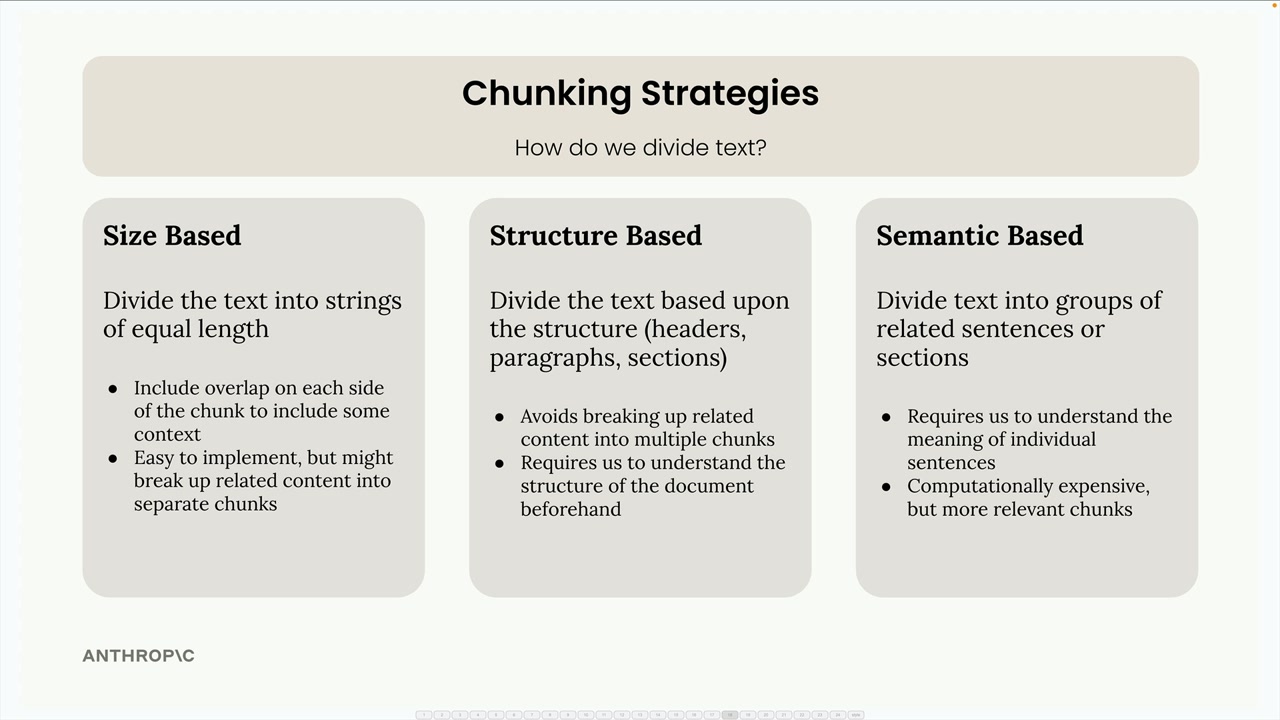
C'est pourquoi le choix de la bonne stratégie de découpage est si important. Explorons trois approches principales.
Découpage basé sur la taille
Le découpage basé sur la taille est l'approche la plus simple - vous divisez votre texte en chaînes de longueur égale. Si vous avez un document de 325 caractères, vous pourriez le diviser en trois morceaux d'environ 108 caractères chacun.
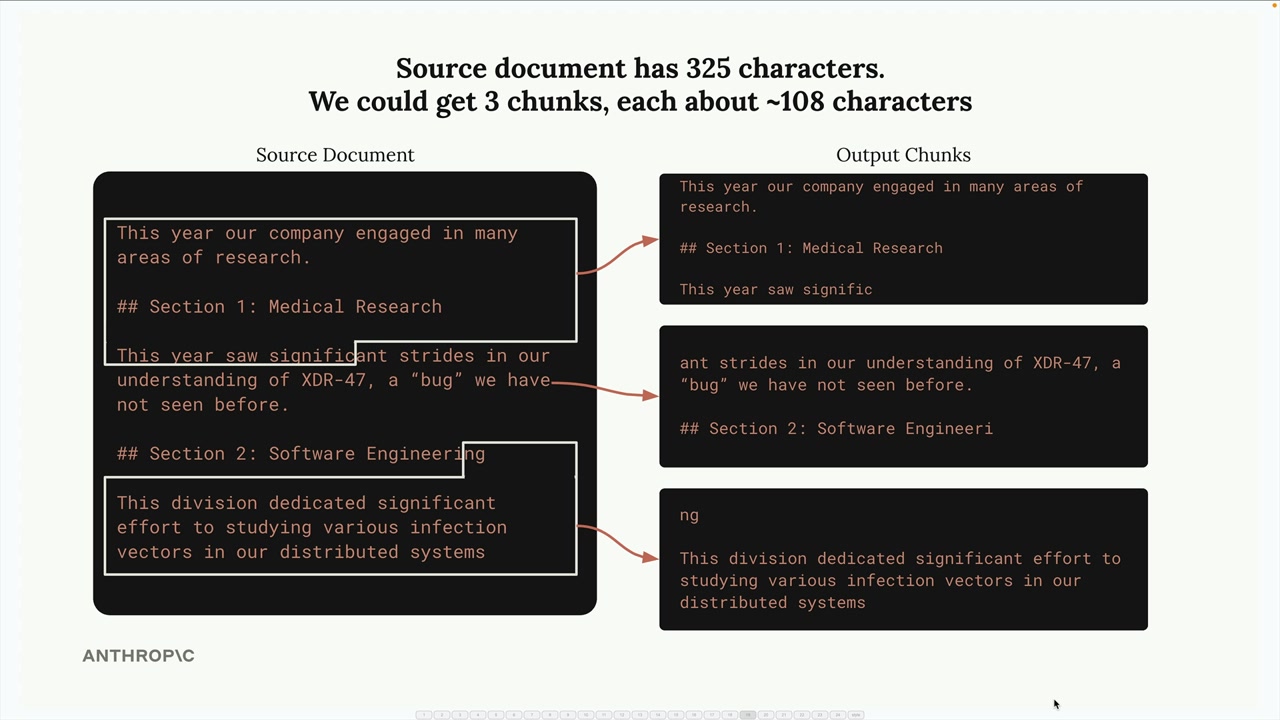
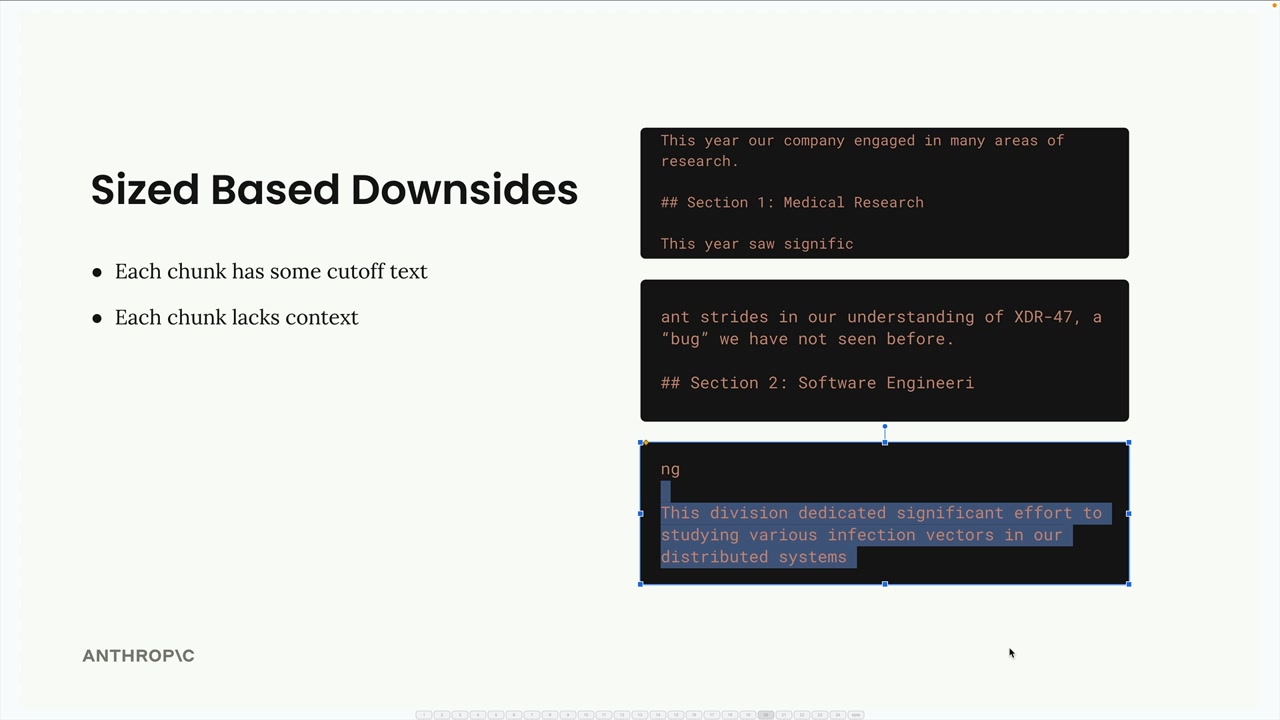
Cette méthode est facile à mettre en œuvre et fonctionne avec tout type de document, mais elle présente des inconvénients évidents :
- Les mots sont coupés en plein milieu d'une phrase
- Les morceaux perdent un contexte important provenant du texte environnant
- Les en-têtes de section peuvent être séparés de leur contenu
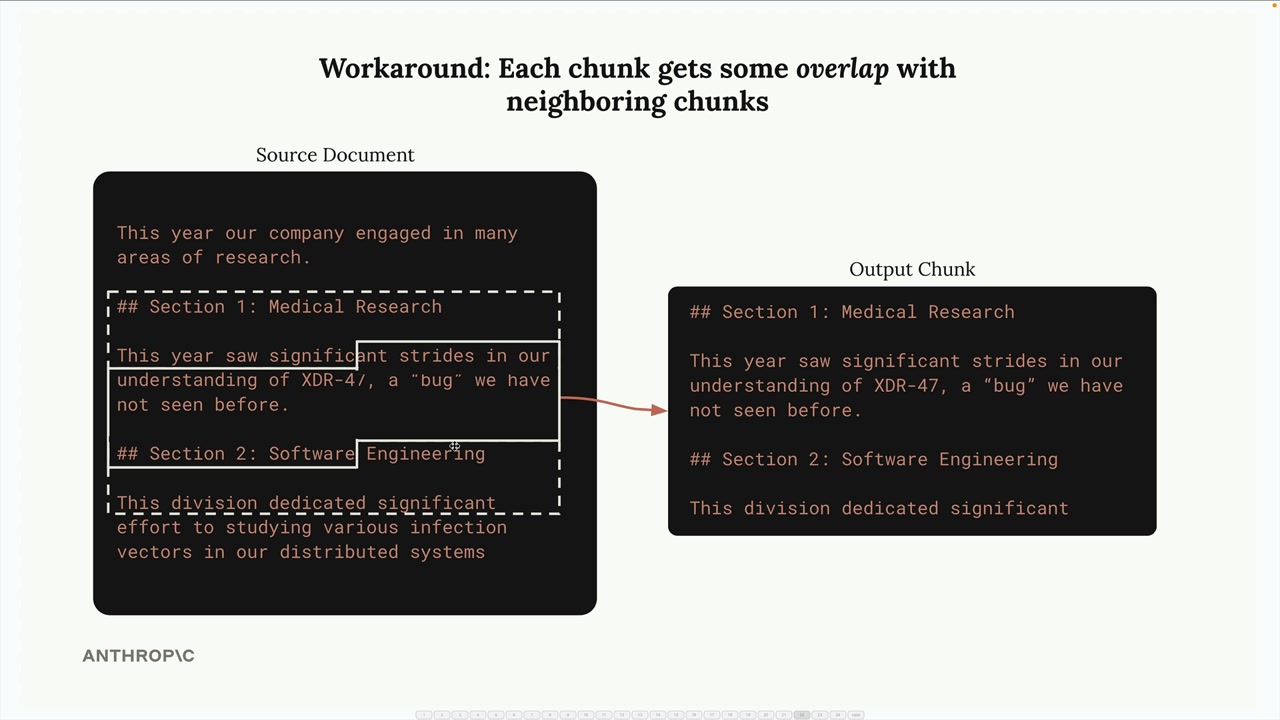
Pour résoudre ces problèmes, vous pouvez ajouter un chevauchement entre les morceaux. Cela signifie que chaque morceau inclut certains caractères des morceaux voisins, offrant un meilleur contexte et garantissant des mots et des phrases complets.
Voici une implémentation de base :
def chunk_by_char(text, chunk_size=150, chunk_overlap=20):
    chunks = []
    start_idx = 0

    while start_idx < len(text):
        end_idx = min(start_idx + chunk_size, len(text))
        chunk_text = text[start_idx:end_idx]
        chunks.append(chunk_text)

        start_idx = (
            end_idx - chunk_overlap if end_idx < len(text) else len(text)
        )

    return chunks
Découpage basé sur la structure
Le découpage basé sur la structure divise le texte en fonction de la structure naturelle du document - en-têtes, paragraphes et sections. Cela fonctionne très bien lorsque vous avez des documents bien formatés comme des fichiers Markdown.
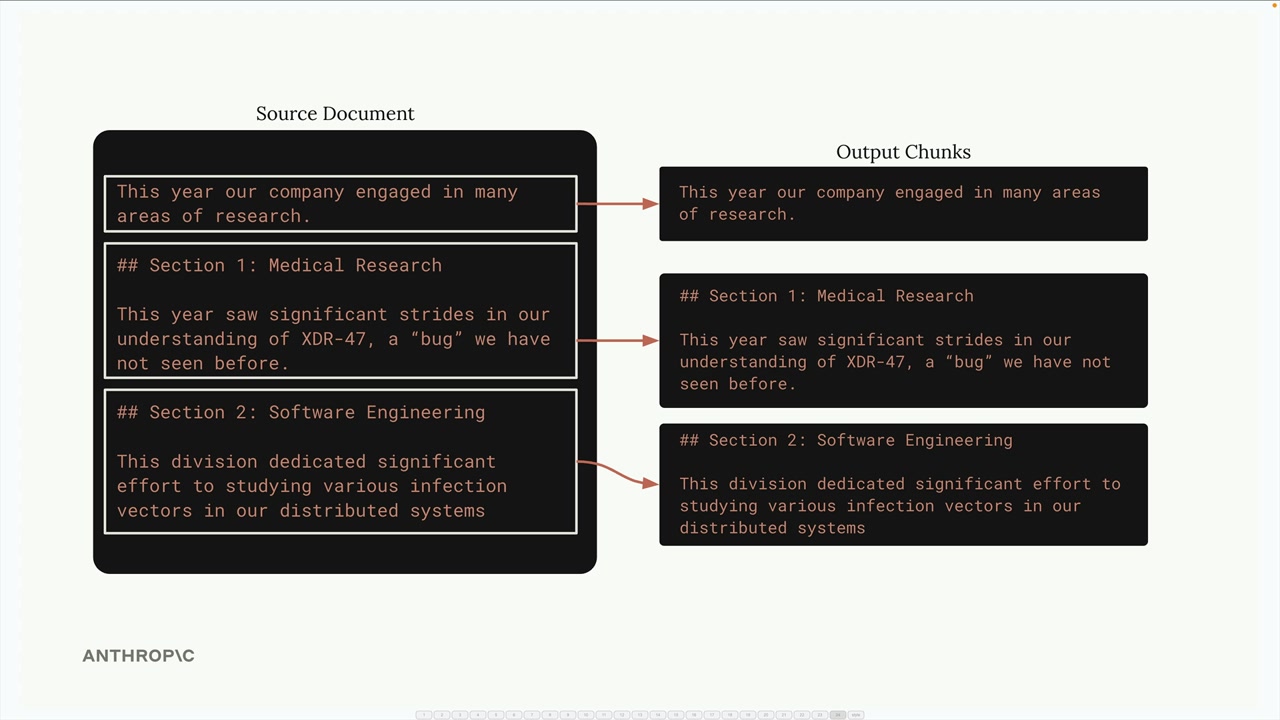
Pour un document Markdown, vous pouvez découper sur les marqueurs d'en-tête :
def chunk_by_section(document_text):
    pattern = r"\n## "
    return re.split(pattern, document_text)
Cette approche vous donne les morceaux les plus propres et les plus significatifs, car chacun représente une section complète. Cependant, elle ne fonctionne que lorsque vous avez des garanties sur la structure de votre document. De nombreux documents du monde réel sont du texte brut ou des PDF sans marqueurs structurels clairs.
Découpage basé sur la sémantique
Le découpage basé sur la sémantique est l'approche la plus sophistiquée. Vous divisez le texte en phrases, puis vous utilisez le traitement du langage naturel pour déterminer à quel point les phrases consécutives sont liées. Vous construisez des morceaux à partir de groupes de phrases liées.
Cette méthode est coûteuse en calcul mais produit les morceaux les plus pertinents. Elle nécessite de comprendre le sens des phrases individuelles et est plus complexe à mettre en œuvre que les autres stratégies.
Découpage basé sur les phrases
Un compromis pratique consiste à découper par phrases. Vous divisez le texte en phrases individuelles à l'aide d'expressions régulières, puis vous les regroupez en morceaux avec un chevauchement optionnel :
def chunk_by_sentence(text, max_sentences_per_chunk=5, overlap_sentences=1):
    sentences = re.split(r"(?<=[.!?])\s+", text)

    chunks = []
    start_idx = 0

    while start_idx < len(sentences):
        end_idx = min(start_idx + max_sentences_per_chunk, len(sentences))
        current_chunk = sentences[start_idx:end_idx]
        chunks.append(" ".join(current_chunk))

        start_idx += max_sentences_per_chunk - overlap_sentences

        if start_idx < 0:
            start_idx = 0

    return chunks
Choisir votre stratégie
Votre choix dépend entièrement de votre cas d'usage et des garanties sur vos documents :
- Basé sur la structure : Meilleurs résultats lorsque vous contrôlez le formatage du document (comme les rapports internes d'entreprise)
- Basé sur les phrases : Bon compromis pour la plupart des documents texte
- Basé sur la taille : Solution de repli la plus fiable qui fonctionne avec tout type de contenu, y compris le code
Le découpage basé sur la taille avec chevauchement est souvent le choix privilégié en production car il est simple, fiable et fonctionne avec tout type de document. Bien qu'il ne donne pas des résultats parfaits, il produit systématiquement des morceaux raisonnables qui ne casseront pas votre pipeline.
Rappelez-vous : il n'existe pas de « meilleure » stratégie de découpage unique. La bonne approche dépend de vos documents spécifiques, de vos cas d'usage, et des compromis que vous êtes prêt à faire entre la complexité de mise en œuvre et la qualité des morceaux.