Lors de la création d'applications de chat avec Claude, il existe un défi important en matière d'expérience utilisateur : les réponses peuvent prendre de 10 à 30 secondes à générer, laissant les utilisateurs fixer un indicateur de chargement. La solution est le streaming des réponses, qui permet aux utilisateurs de voir le texte apparaître morceau par morceau au fur et à mesure que Claude le génère, créant ainsi une sensation beaucoup plus réactive.
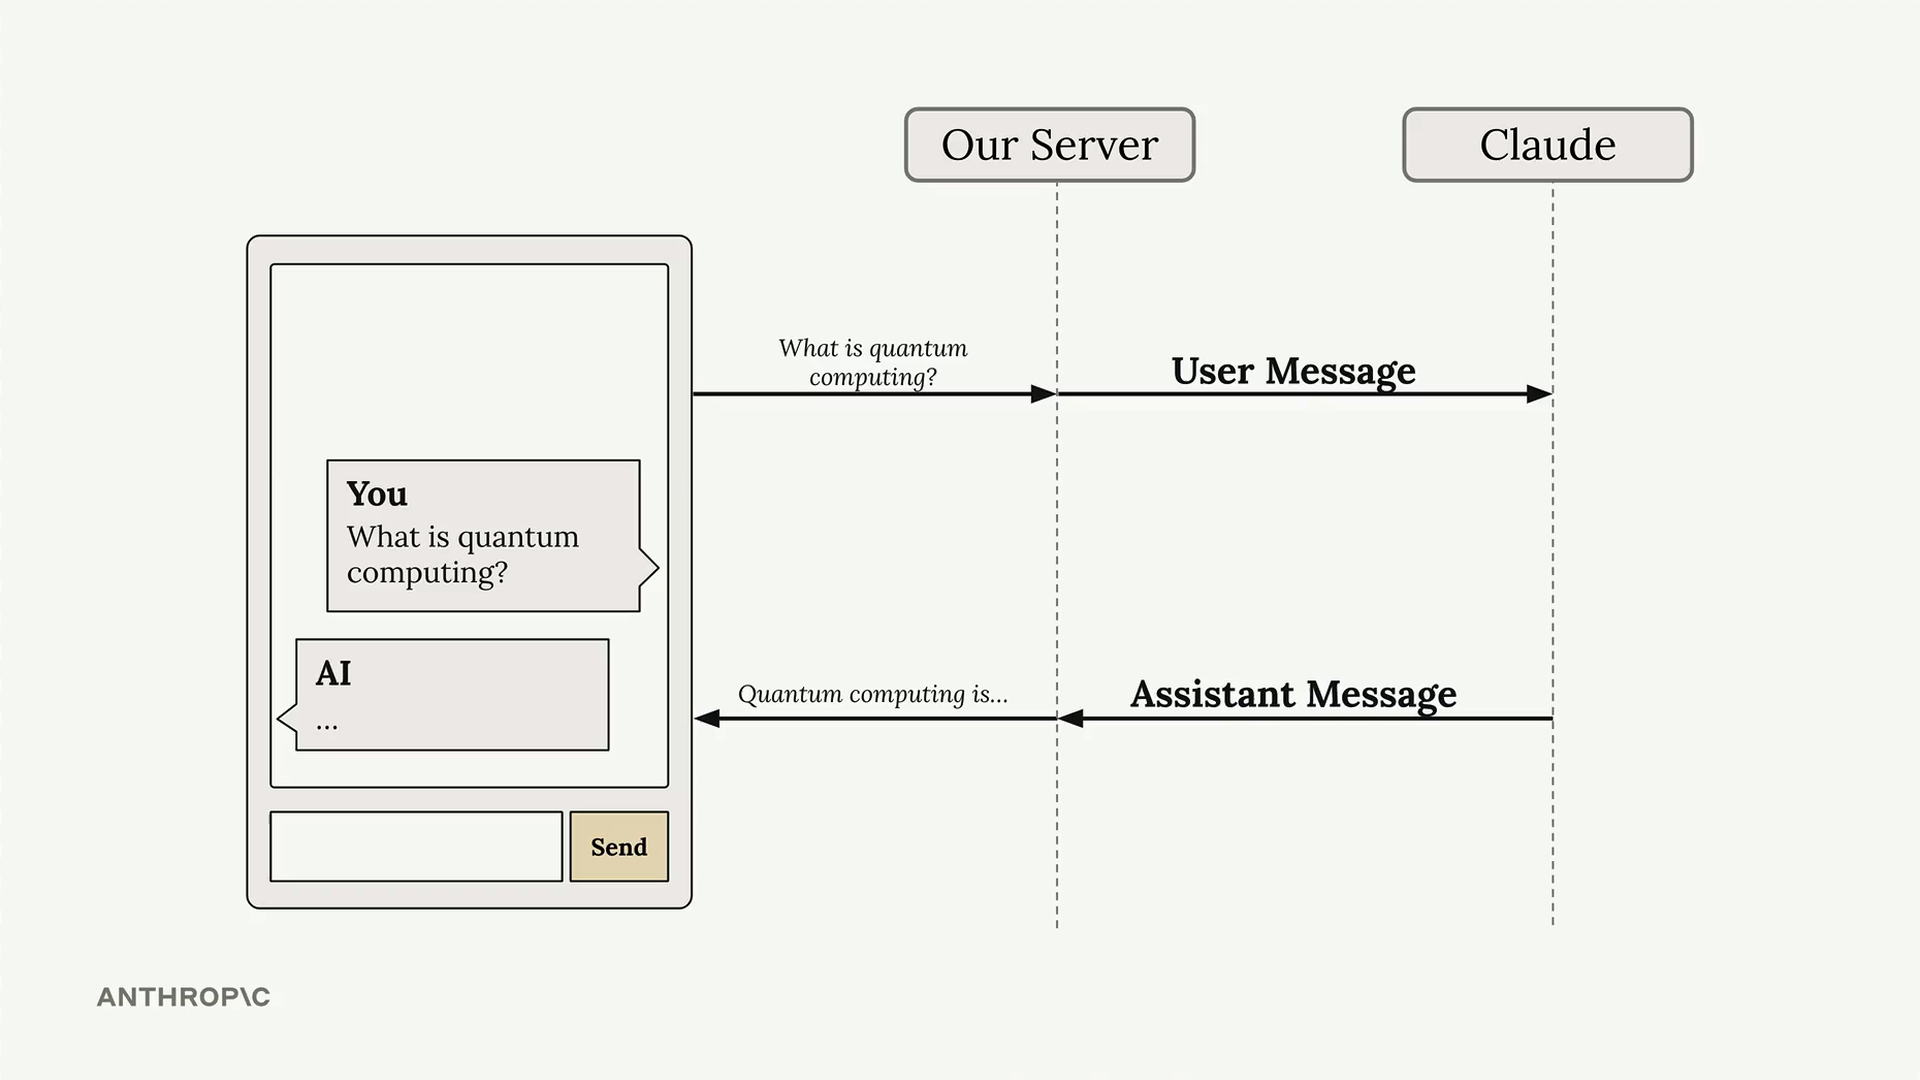
Le problème avec les réponses standard
Dans une configuration de chat typique, votre serveur envoie un message utilisateur à Claude et attend la réponse complète avant d'envoyer quoi que ce soit au client. Cela crée un délai gênant pendant lequel les utilisateurs n'ont aucun retour indiquant que quelque chose se passe.
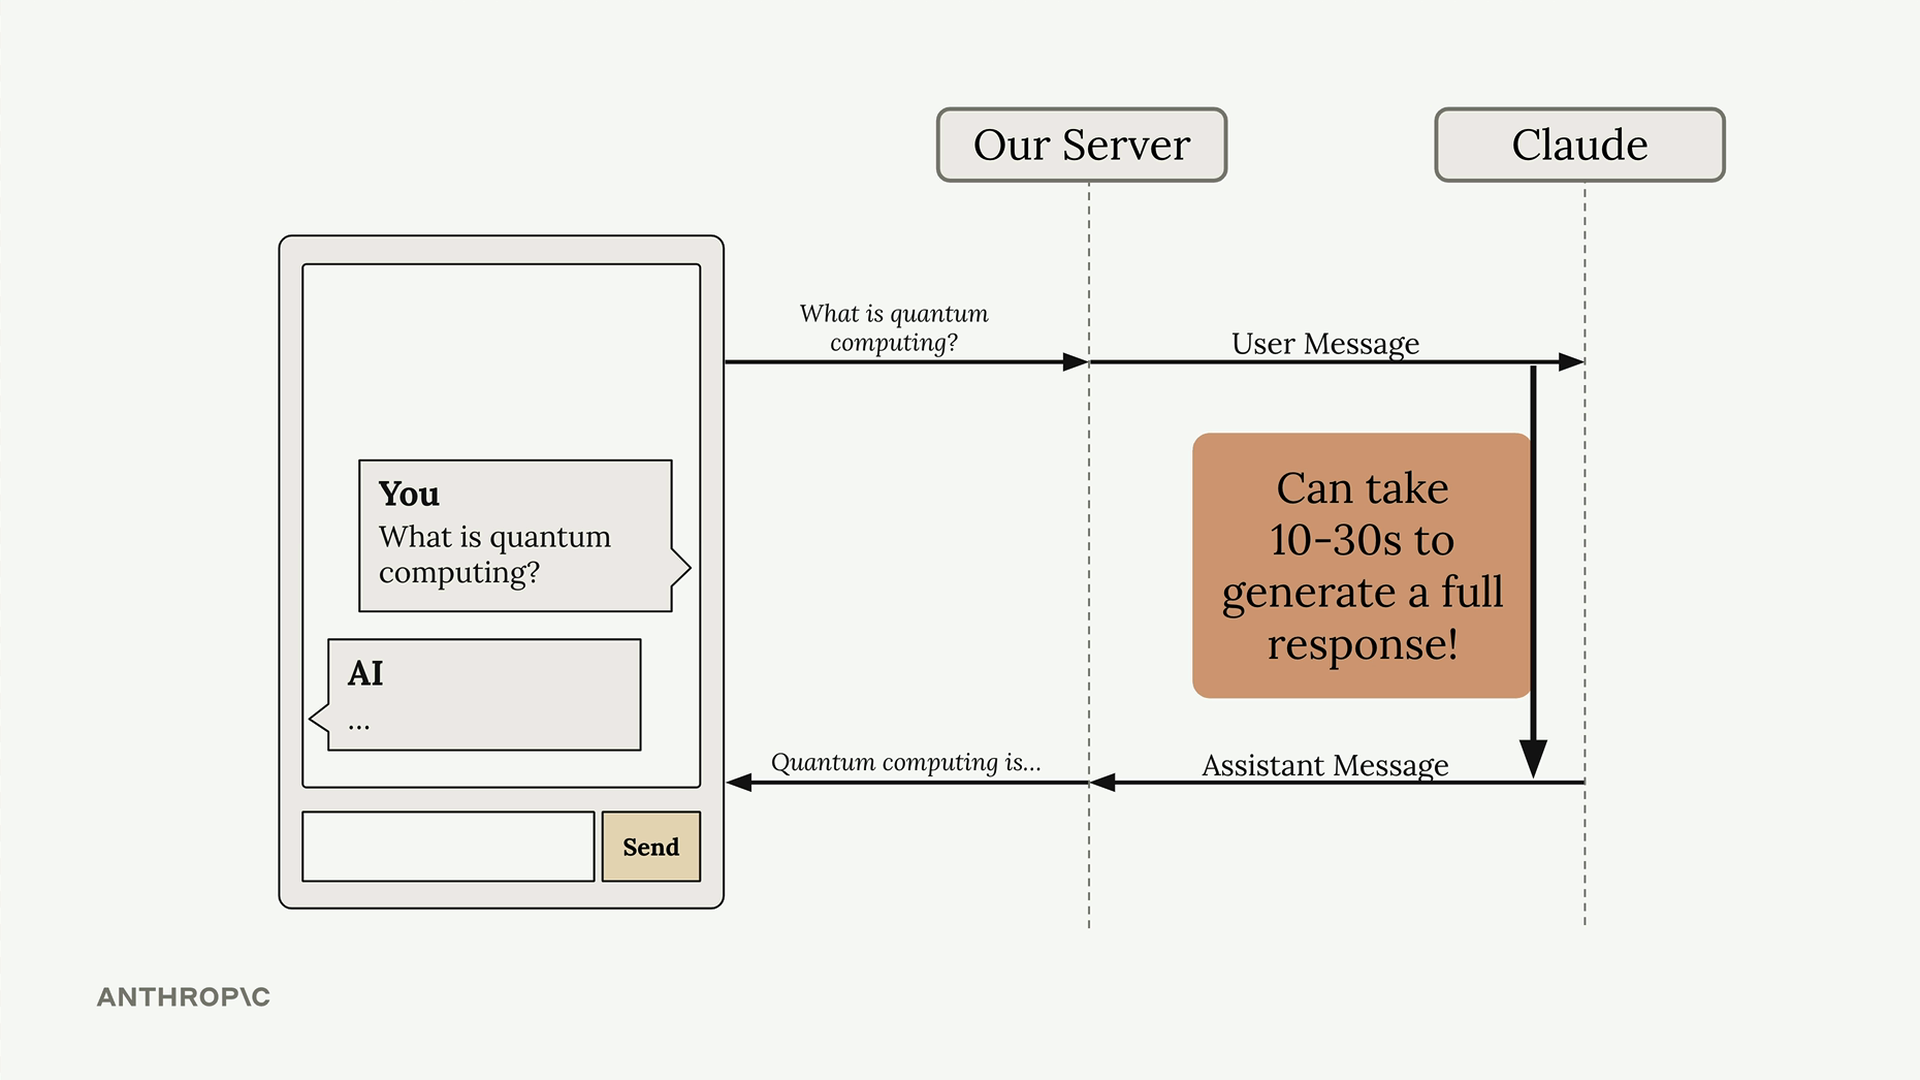
Comment fonctionne le streaming
Avec le streaming activé, Claude renvoie immédiatement une réponse initiale indiquant qu'il a reçu votre requête et qu'il commence à générer du texte. Vous recevez ensuite une série d'événements, chacun contenant une petite partie de la réponse globale.
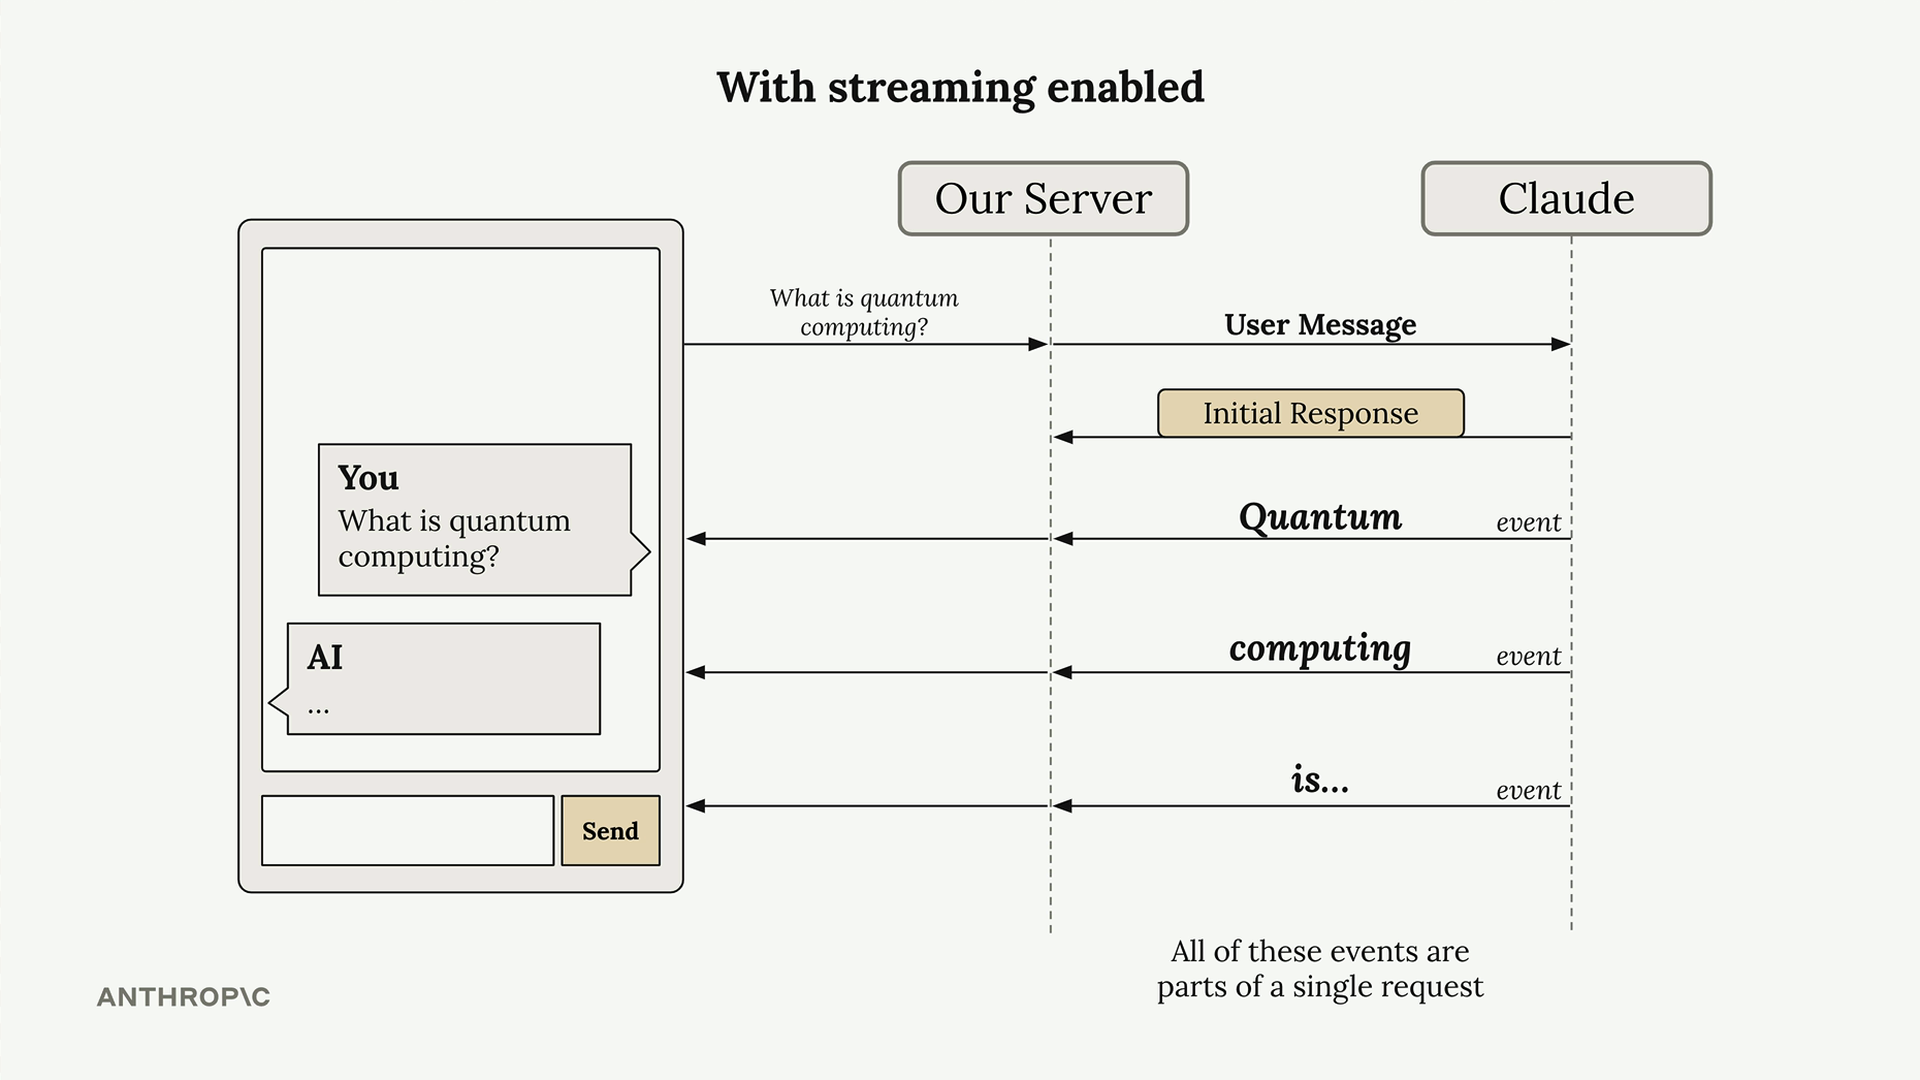
Votre serveur peut transmettre ces morceaux de texte à votre application client au fur et à mesure qu'ils arrivent, permettant aux utilisateurs de voir la réponse se construire mot par mot. Tous ces événements font partie d'une seule requête à Claude.
Comprendre les événements de streaming
Lorsque vous activez le streaming, Claude renvoie plusieurs types d'événements :
- MessageStart - Un nouveau message est en cours d'envoi
- ContentBlockStart - Début d'un nouveau bloc contenant du texte, de l'utilisation d'outils ou d'autre contenu
- ContentBlockDelta - Morceaux du texte réellement généré
- ContentBlockStop - Le bloc de contenu actuel a été complété
- MessageDelta - Le message actuel est complet
- MessageStop - Fin des informations concernant le message actuel
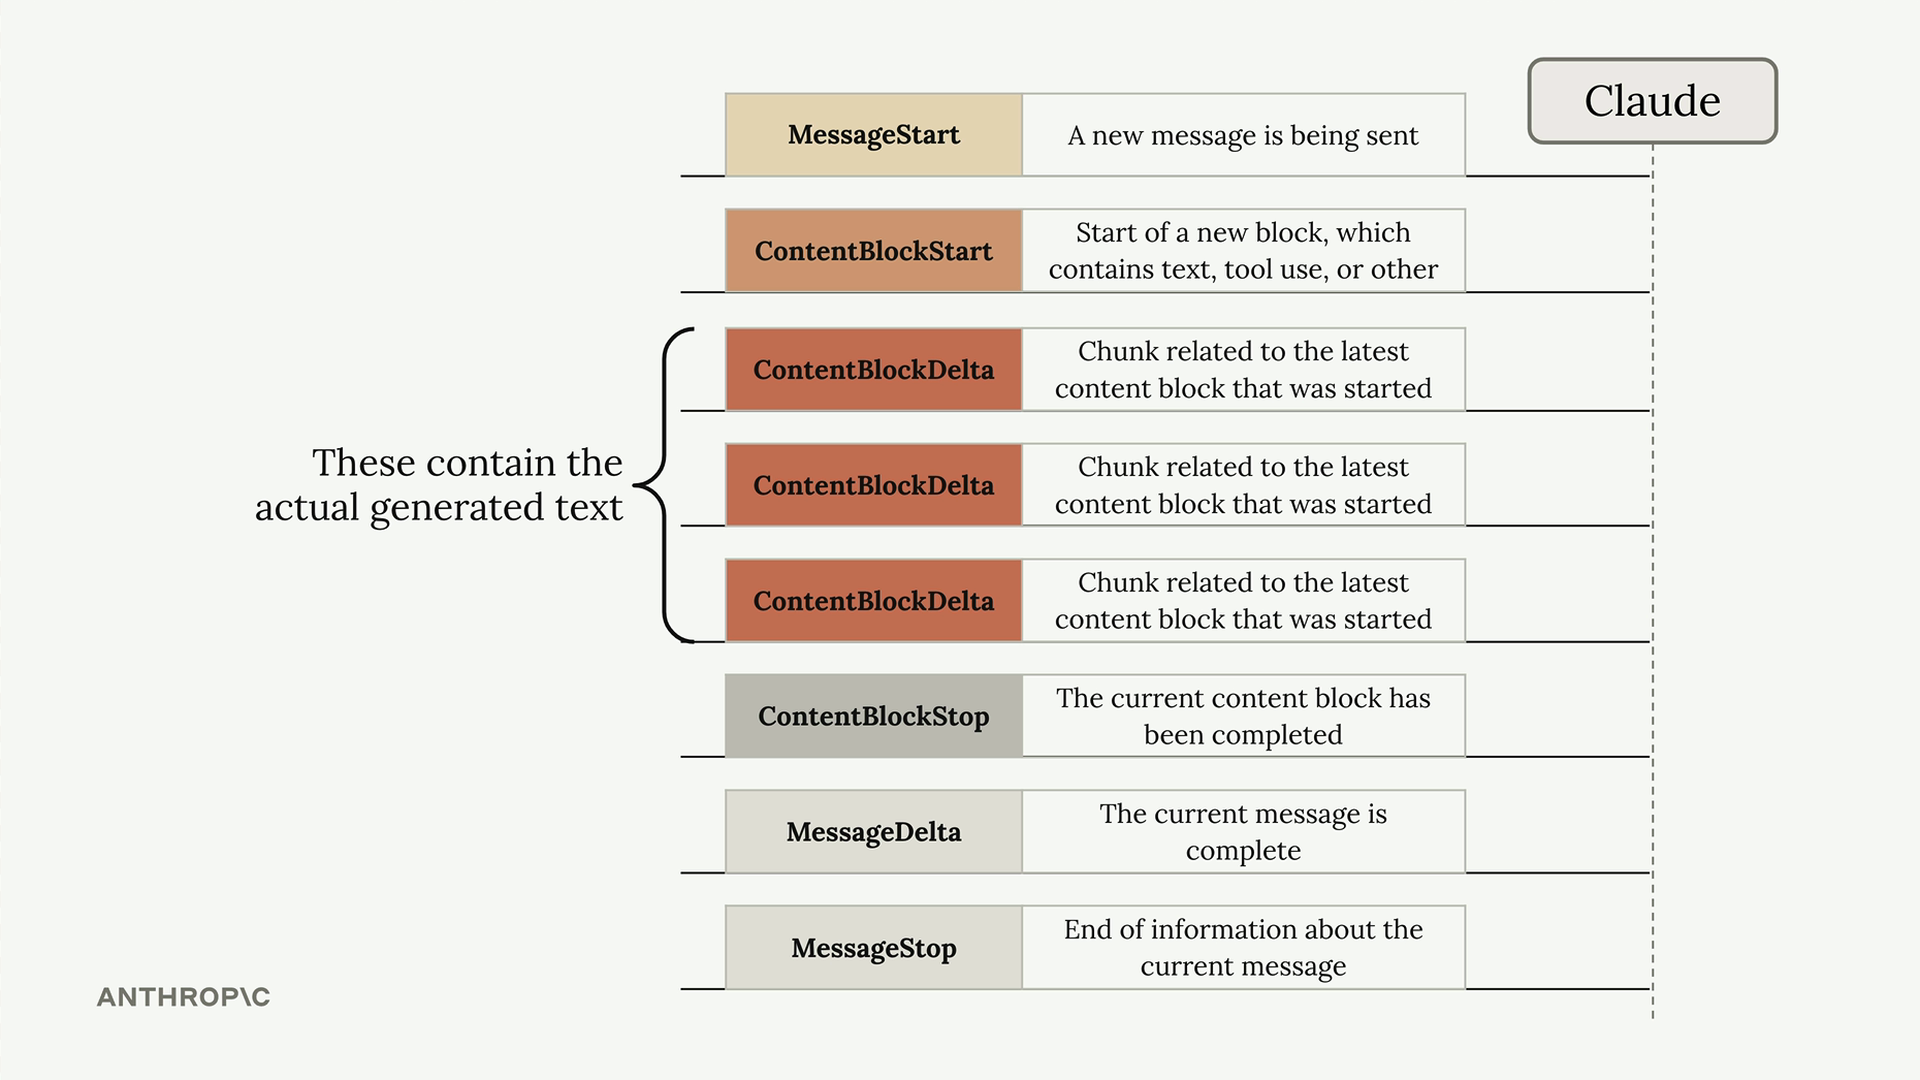
Les événements ContentBlockDelta contiennent le texte réellement généré que vous souhaiterez afficher aux utilisateurs.
Implémentation de base du streaming
Pour activer le streaming, ajoutez stream=True à votre appel messages.create :
messages = []
add_user_message(messages, "Write a 1 sentence description of a fake database")

stream = client.messages.create(
    model=model,
    max_tokens=1000,
    messages=messages,
    stream=True
)

for event in stream:
    print(event)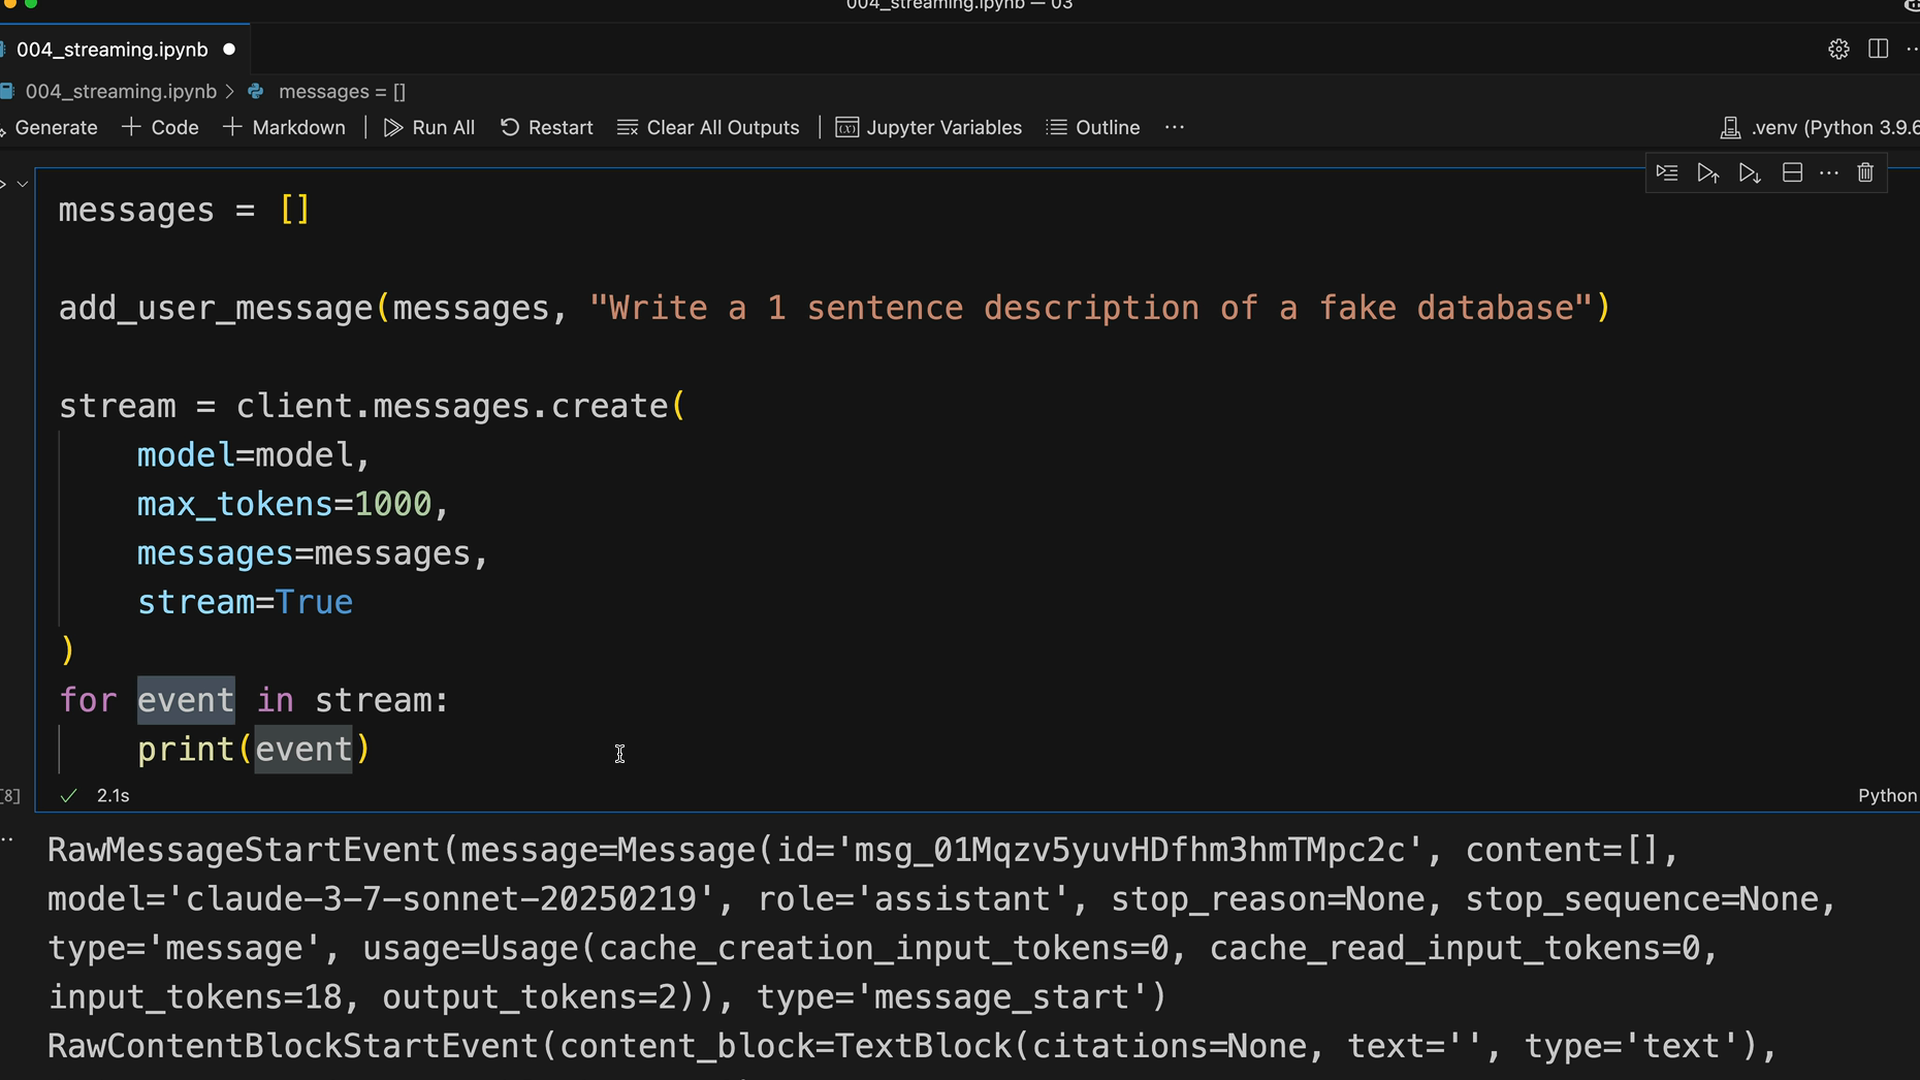
Streaming de texte simplifié
Plutôt que d'analyser manuellement les événements, vous pouvez utiliser l'interface de streaming simplifiée du SDK qui extrait uniquement le contenu textuel :
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        print(text, end="")
Cette approche filtre automatiquement tout sauf le contenu textuel réel, ce qui est généralement ce dont vous avez besoin pour afficher les réponses aux utilisateurs.
Obtenir le message complet
Bien que le streaming de morceaux individuels soit excellent pour l'expérience utilisateur, vous avez souvent besoin du message complet pour le stockage ou un traitement ultérieur. Une fois le streaming terminé, vous pouvez obtenir le message final assemblé :
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        # Envoyer chaque extrait de code à votre client
        pass

    # Obtenir le message complet pour le stockage en base de données
    final_message = stream.get_final_message()
Cela vous offre le meilleur des deux mondes : le streaming en temps réel pour les utilisateurs et un objet message complet pour la logique de votre application.