Remarque importante : la réflexion étendue n'est pas compatible avec certaines autres fonctionnalités, notamment le pré-remplissage des messages, et elle restreint la manière dont vous pouvez utiliser la température. Consultez la liste complète des restrictions ici : https://platform.claude.com/docs/en/build-with-claude/thinking#limits-and-feature-compatibility(s’ouvre dans un nouvel onglet)
La réflexion étendue est la fonctionnalité de raisonnement avancée de Claude qui donne au modèle le temps de travailler sur des problèmes complexes avant de générer une réponse finale. Considérez-la comme le « brouillon » de Claude : vous pouvez voir le processus de raisonnement qui mène à la réponse, ce qui favorise la transparence et se traduit souvent par des réponses de meilleure qualité.
Comment fonctionne la réflexion étendue
Lorsque la réflexion étendue est activée, la réponse de Claude passe d'un simple bloc de texte à une réponse structurée contenant deux parties :
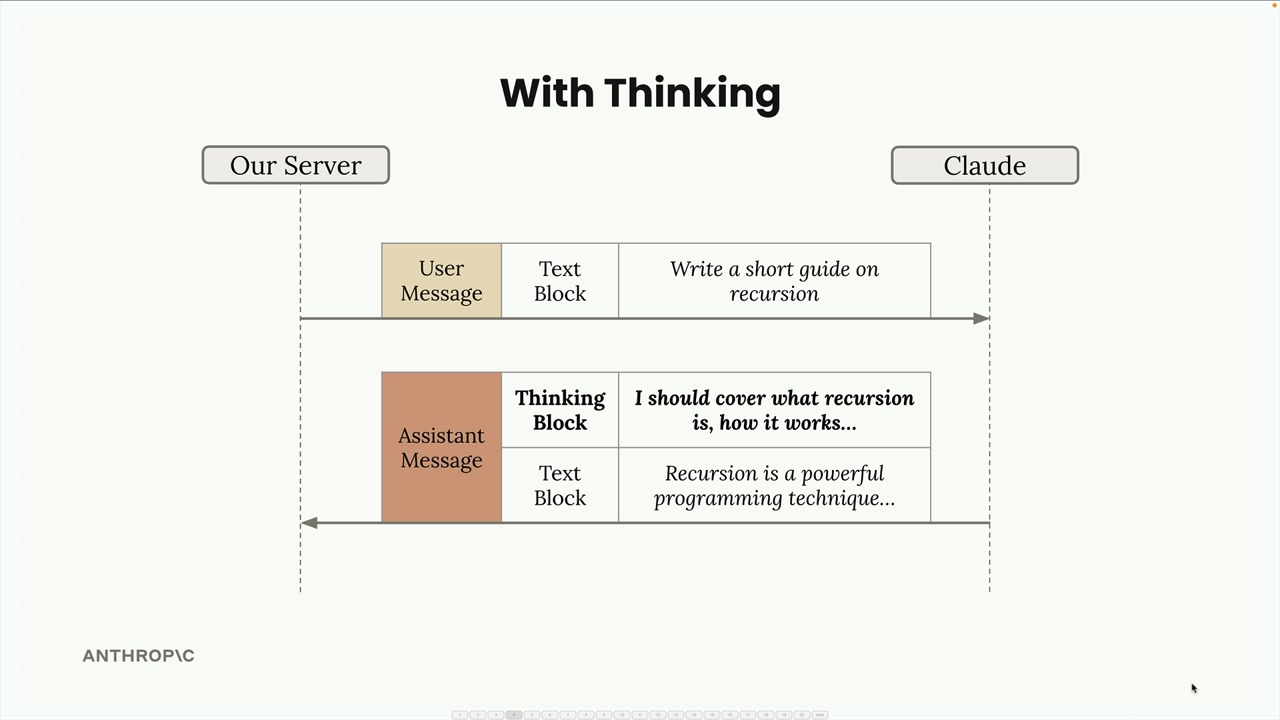
Avec la réflexion activée, vous obtenez à la fois le processus de raisonnement et la réponse finale :
Les principaux avantages incluent :
- De meilleures capacités de raisonnement pour les tâches complexes
- Une précision accrue sur les problèmes difficiles
- Une transparence sur le processus de pensée de Claude
Cependant, il existe des compromis importants :
- Des coûts plus élevés (vous payez pour les tokens de réflexion)
- Une latence accrue (la réflexion prend du temps)
- Une gestion plus complexe des réponses dans votre code
Quand utiliser la réflexion étendue
La décision est simple : utilisez vos évaluations de prompts. Exécutez d'abord vos prompts sans réflexion, et si la précision ne répond pas à vos exigences après avoir déjà optimisé votre prompt, envisagez alors d'activer la réflexion étendue. C'est un outil à utiliser lorsque le prompting standard ne vous permet pas tout à fait d'y arriver.
Structure de la réponse et sécurité
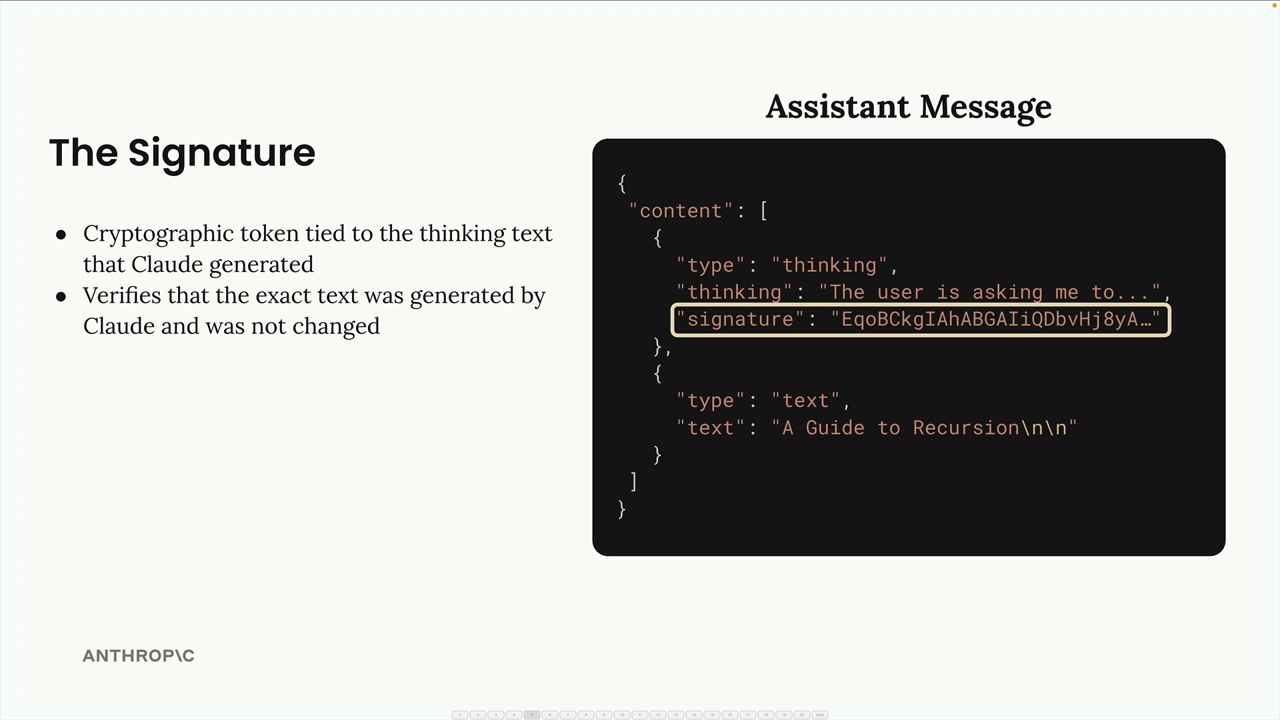
Les réponses en réflexion étendue incluent un système de signature spécial pour la sécurité :
La signature est un token cryptographique qui garantit que vous n'avez pas modifié le texte de réflexion. Cela empêche les développeurs de falsifier le processus de raisonnement de Claude, ce qui pourrait potentiellement orienter le modèle dans des directions dangereuses.
Réflexion expurgée
Parfois, vous recevrez un bloc de réflexion expurgé au lieu d'un texte de raisonnement lisible :
Cela se produit lorsque le processus de réflexion de Claude est signalé par les systèmes de sécurité internes. Le contenu expurgé contient la réflexion réelle sous forme chiffrée, ce qui vous permet de renvoyer le message complet à Claude lors de conversations futures sans perdre le contexte.
Mise en œuvre
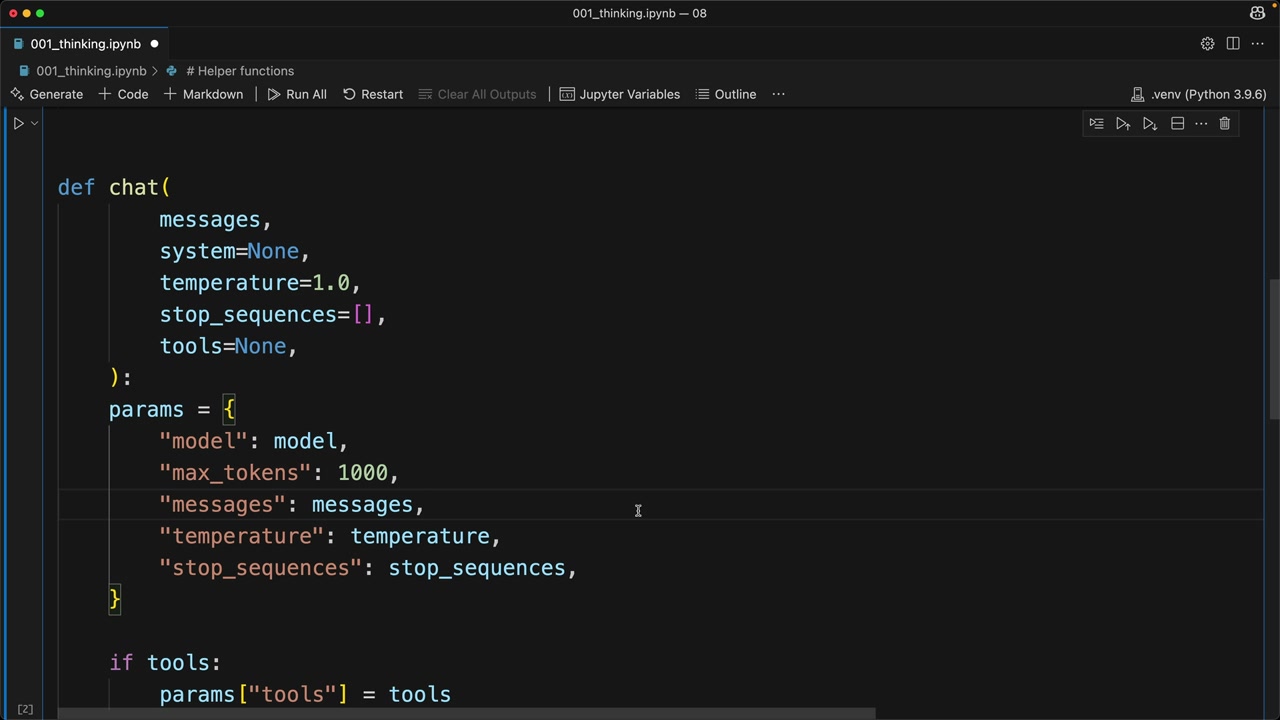
Pour activer la réflexion étendue dans votre code, vous devez ajouter deux paramètres à votre fonction de chat :
def chat(
    messages,
    system=None,
    temperature=1.0,
    stop_sequences=[],
    tools=None,
    thinking=False,
    thinking_budget=1024
):
Le budget de réflexion — budget_tokens dans la requête — définit le nombre maximal de tokens que Claude peut utiliser pour le raisonnement. La valeur minimale de budget_tokens est 1024, et votre paramètre max_tokens doit être supérieur à budget_tokens.
Ajoutez le paramètre thinking à votre requête API — un objet avec type défini sur "enabled" et une valeur budget_tokens — et augmentez max_tokens afin qu'il soit supérieur à budget_tokens :
if thinking:
    params["max_tokens"] = thinking_budget + 1000
    params["thinking"] = {
        "type": "enabled",
        "budget_tokens": thinking_budget
    }
Appelez ensuite votre fonction de chat avec la réflexion activée :
chat(messages, thinking=True)Test des réponses expurgées
À des fins de test, vous pouvez forcer Claude à renvoyer un bloc de réflexion expurgé en envoyant une chaîne de déclenchement spéciale. Cela permet de s'assurer que votre application gère les réponses expurgées avec élégance sans planter.
La réflexion étendue est une fonctionnalité puissante lorsque vous avez besoin que Claude s'attaque à des tâches de raisonnement complexes, mais utilisez-la judicieusement compte tenu des implications en termes de coût et de latence. Commencez par un prompting standard, optimisez-le en profondeur, puis ajoutez la réflexion lorsque vous avez besoin de cette capacité de raisonnement supplémentaire.