Maintenant que nous comprenons le flux RAG de manière conceptuelle, mettons-le en œuvre étape par étape. Nous allons parcourir un exemple complet qui démontre comment découper le texte en segments, générer des embeddings, les stocker dans une base de données vectorielle, et effectuer des recherches de similarité.
L'implémentation RAG en cinq étapes
Notre implémentation suit les mêmes cinq étapes que nous avons abordées précédemment :
- Découper le texte par section
- Générer des embeddings pour chaque segment
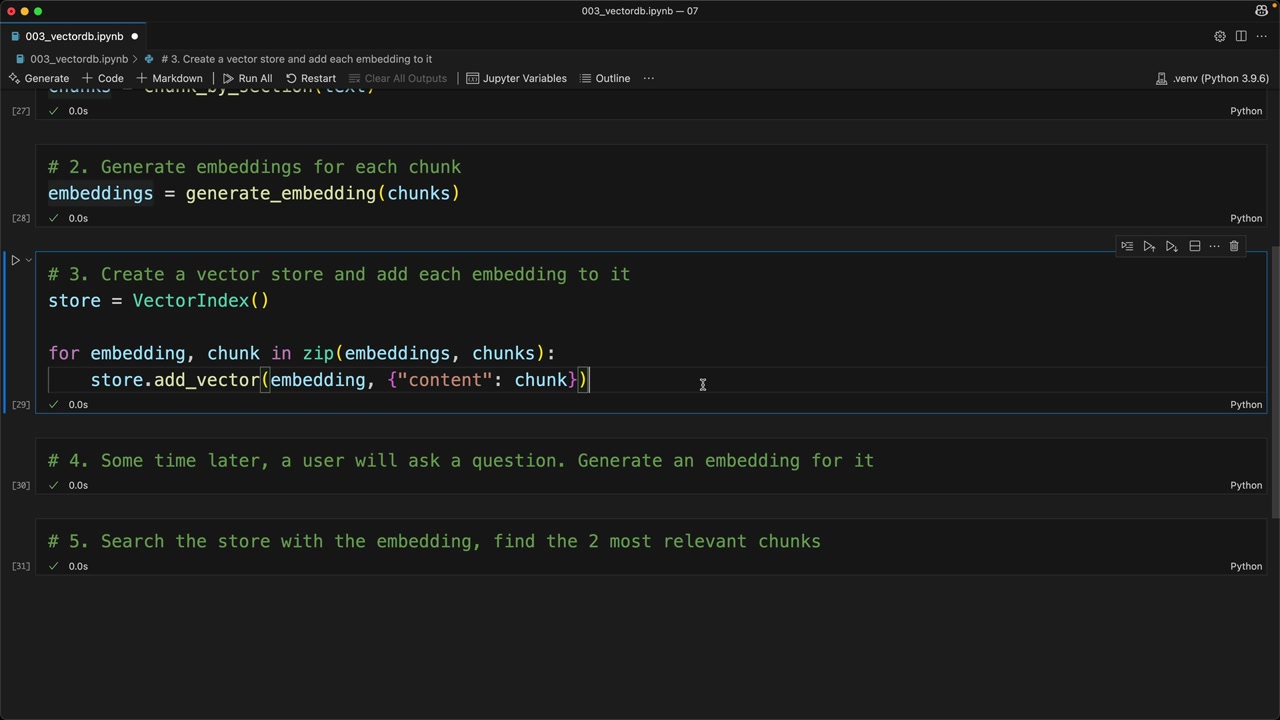
- Créer un magasin vectoriel et y ajouter chaque embedding
- Générer un embedding pour la question de l'utilisateur
- Rechercher dans le magasin pour trouver les segments les plus pertinents
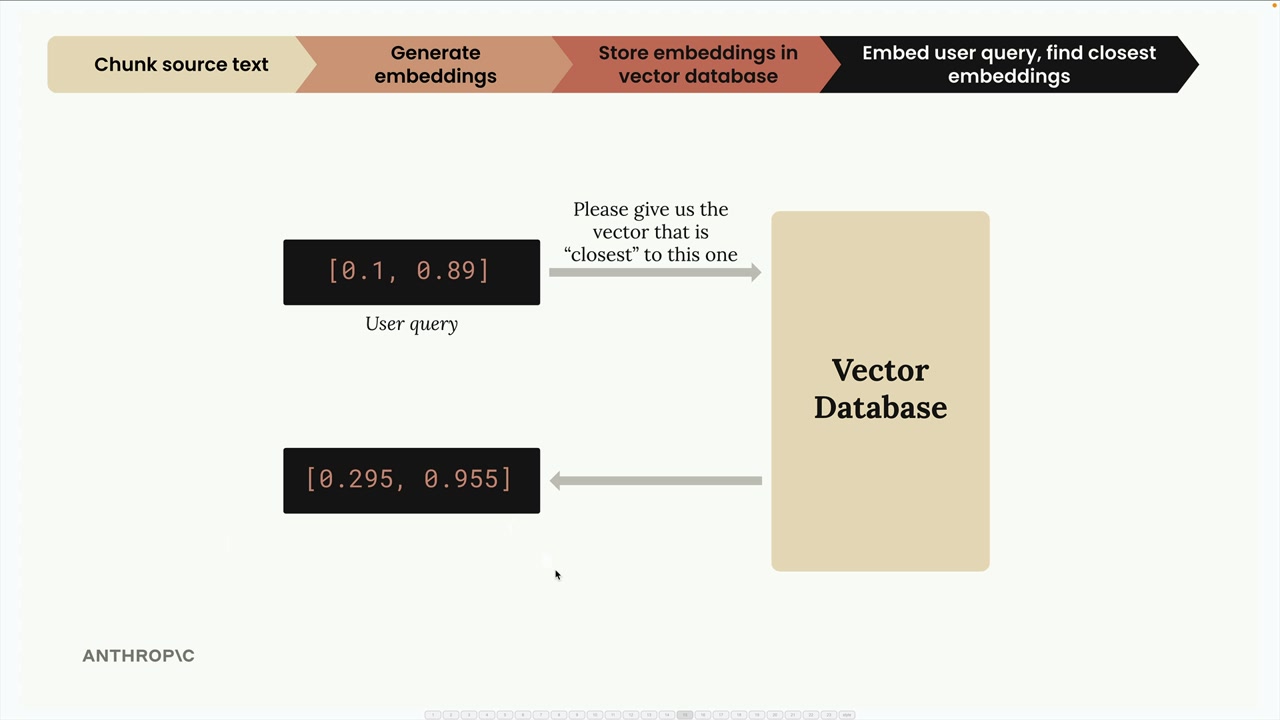
Ce diagramme montre comment nous transformons les requêtes des utilisateurs en embeddings et recherchons dans notre base de données vectorielle pour trouver le contenu le plus pertinent.
Étape 1 : Découpage du texte
Tout d'abord, nous chargeons notre document et le divisons en sections gérables :
with open("./report.md", "r") as f:
    text = f.read()

chunks = chunk_by_section(text)
chunks[2]  # Test to see the table of contents
Nous utilisons la même fonction chunk_by_section que précédemment pour diviser notre document en sections logiques.
Étape 2 : Génération des embeddings
Ensuite, nous créons des embeddings pour tous nos segments en une seule fois :
embeddings = generate_embedding(chunks)La fonction d'embedding a été mise à jour pour gérer à la fois les chaînes uniques et les listes de chaînes, ce qui la rend plus efficace pour le traitement par lots.
Étape 3 : Stockage dans la base de données vectorielle
Maintenant, nous créons notre magasin vectoriel et le remplissons avec les embeddings et leur texte associé :
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
Remarquez que nous stockons à la fois l'embedding et le contenu textuel original. C'est crucial car, lorsque nous effectuons une recherche plus tard, nous devons renvoyer le texte réel, et non simplement les valeurs numériques de l'embedding.
Pourquoi stocker le texte original ?
Lorsque nous interrogeons notre base de données vectorielle, récupérer uniquement les nombres de l'embedding n'est pas utile. Nous avons besoin du texte réel qui a été utilisé pour générer ces embeddings. C'est pourquoi nous incluons le texte du segment original (ou au moins une référence à celui-ci) avec chaque embedding dans notre base de données.
Étape 4 : Traitement des requêtes des utilisateurs
Lorsqu'un utilisateur pose une question, nous générons un embedding pour sa requête :
user_embedding = generate_embedding("What did the software engineering dept do last year?")Étape 5 : Recherche du contenu pertinent
Enfin, nous recherchons dans notre magasin vectoriel pour trouver les segments les plus similaires :
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
Cette recherche renvoie les deux segments les plus pertinents ainsi que leurs scores de similarité (distances cosinus).
Les résultats de la recherche nous montrent quelles sections de notre document sont les plus pertinentes par rapport à la question de l'utilisateur, ainsi que les scores de similarité.
Comprendre les résultats
Lorsque nous exécutons notre exemple de requête concernant le département d'ingénierie logicielle, nous obtenons :
- Section 2 : Ingénierie logicielle avec une distance de 0,71 (correspondance la plus proche)
- Section Méthodologie avec une distance de 0,72 (deuxième plus proche)
Des valeurs de distance plus faibles indiquent une similarité plus élevée, donc la Section 2 est la plus pertinente pour notre requête.
Et ensuite ?
Cette implémentation fonctionne bien pour les cas de base, mais il existe des scénarios où elle ne se comporte pas comme prévu. Dans les sections suivantes, nous explorerons des améliorations pour rendre notre système RAG plus robuste et précis.
Le point clé à retenir est que le RAG consiste fondamentalement à convertir du texte en nombres (embeddings), à stocker ces nombres efficacement, puis à utiliser la similarité mathématique pour trouver du contenu pertinent lorsque les utilisateurs posent des questions.