Les flux de travail de routage résolvent un problème courant dans les applications d'IA : différents types de demandes utilisateur nécessitent différentes approches de traitement. Au lieu d'utiliser une invite universelle, vous pouvez catégoriser les demandes entrantes et les acheminer vers des pipelines de traitement spécialisés.
Le problème des invites génériques
Prenons l'exemple d'un outil de marketing sur les réseaux sociaux qui génère des scripts vidéo à partir de sujets fournis par l'utilisateur. Un utilisateur pourrait saisir « programmation » ou « surf » comme sujet, mais ceux-ci devraient produire des types de contenu très différents :
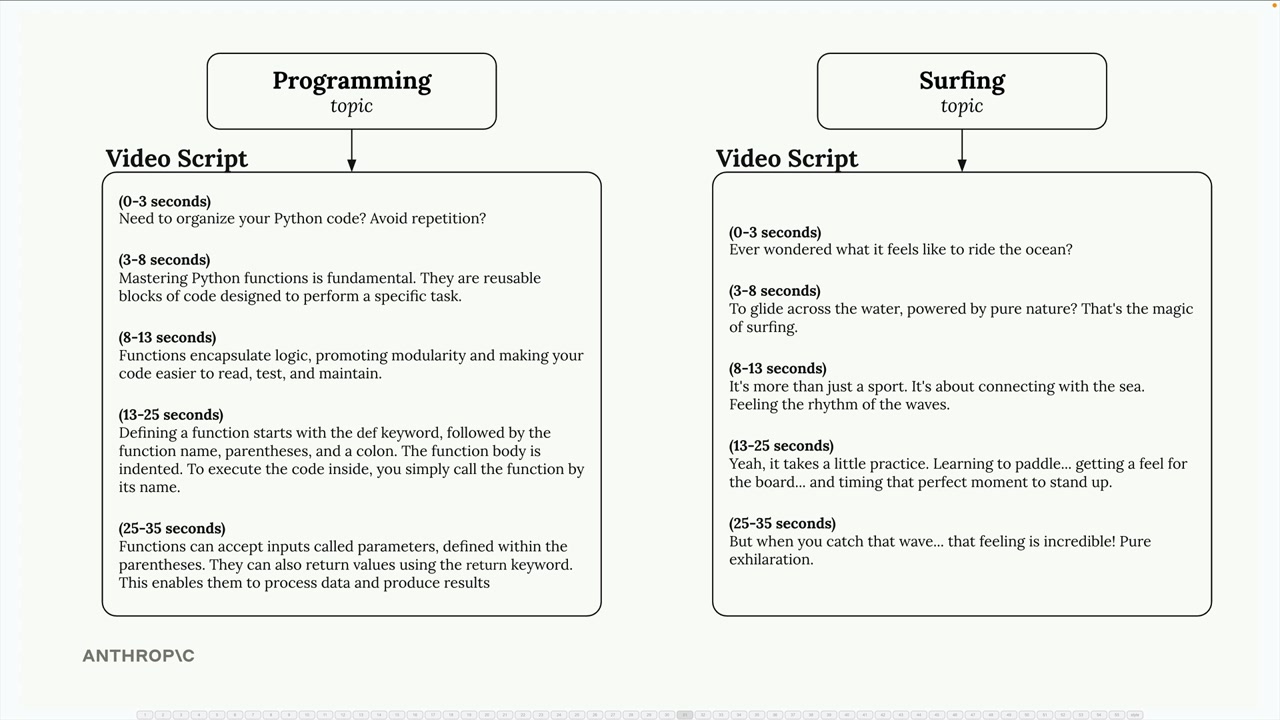
Les sujets de programmation appellent un contenu éducatif avec des explications et des définitions claires. Les sujets de surf fonctionnent mieux avec des scripts axés sur le divertissement qui mettent l'accent sur l'excitation et l'attrait visuel. Une seule invite générique ne peut pas gérer efficacement les deux.
Mise en place des catégories de contenu
La première étape consiste à définir les différents types de contenu que votre application pourrait avoir besoin de générer. Vous pourriez catégoriser les demandes en genres tels que :
- Divertissement - Contenu dynamique et culturellement pertinent avec un langage tendance
- Éducatif - Explications claires et engageantes avec des exemples accessibles
- Comédie - Contenu incisif et inattendu avec des observations astucieuses et un bon timing
- Vlog personnel - Contenu authentique et intime avec une narration conversationnelle
- Avis - Contenu tranché et basé sur l'expérience mettant en avant les forces et les faiblesses
- Narration - Contenu immersif utilisant des détails vivants et une connexion émotionnelle
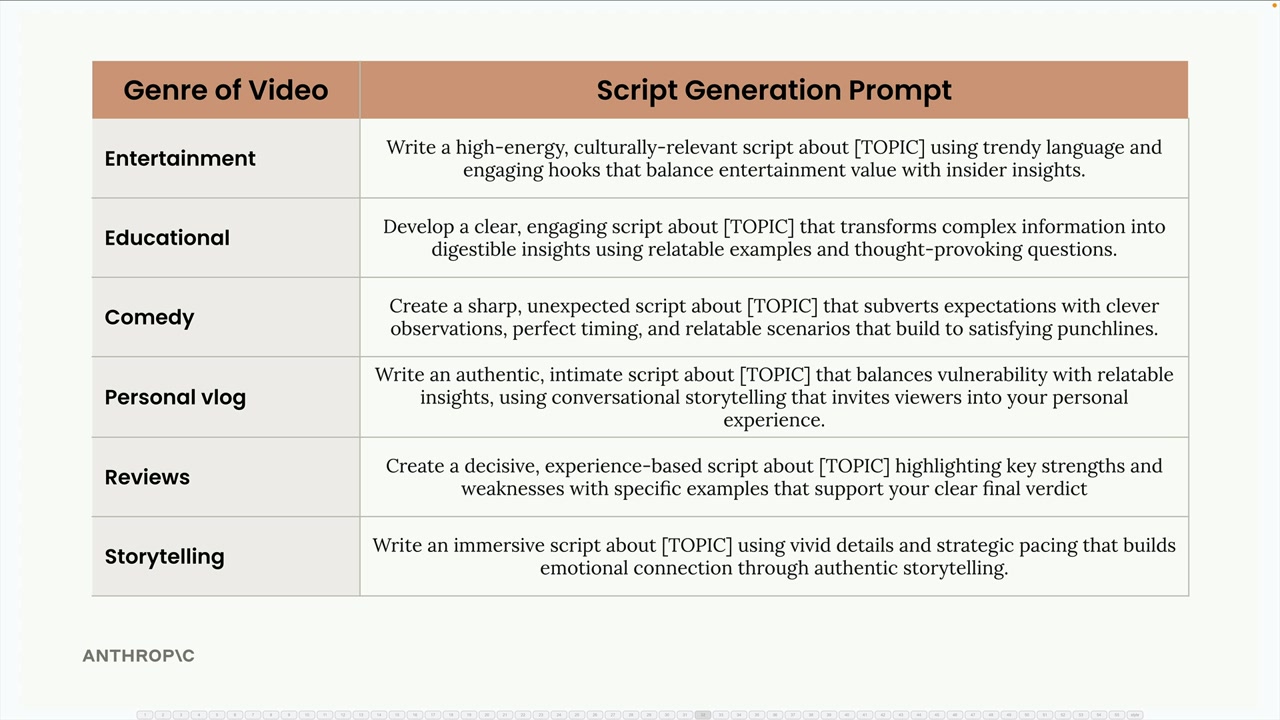
Chaque catégorie dispose de son propre modèle d'invite spécialisé. Par exemple, l'invite éducative pourrait demander à Claude de « développer un script clair et engageant qui transforme des informations complexes en éléments digestes à l'aide d'exemples accessibles et de questions stimulantes ».
Comment le routage fonctionne en pratique
Le processus de routage se déroule en deux étapes :
- Catégorisation - Envoyer le sujet de l'utilisateur à Claude avec une demande de le catégoriser dans un de vos genres prédéfinis
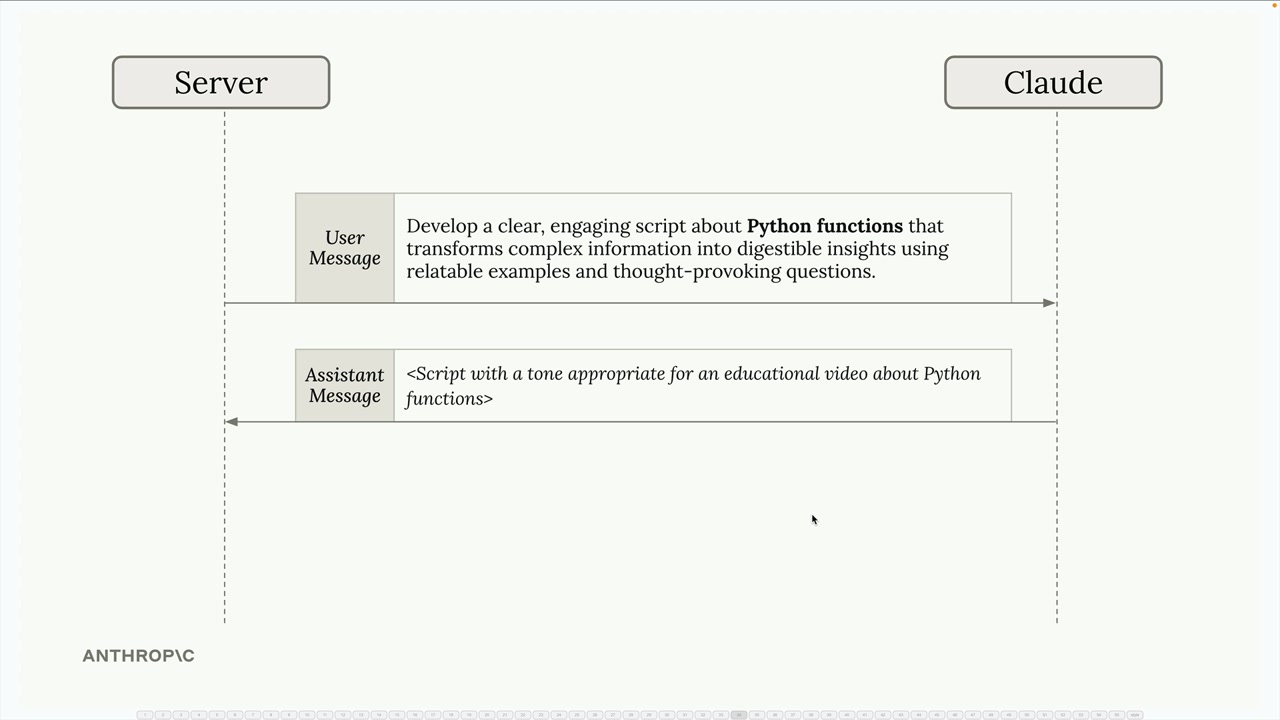
- Traitement spécialisé - Utiliser le résultat de la catégorie pour sélectionner le modèle d'invite approprié et générer le contenu
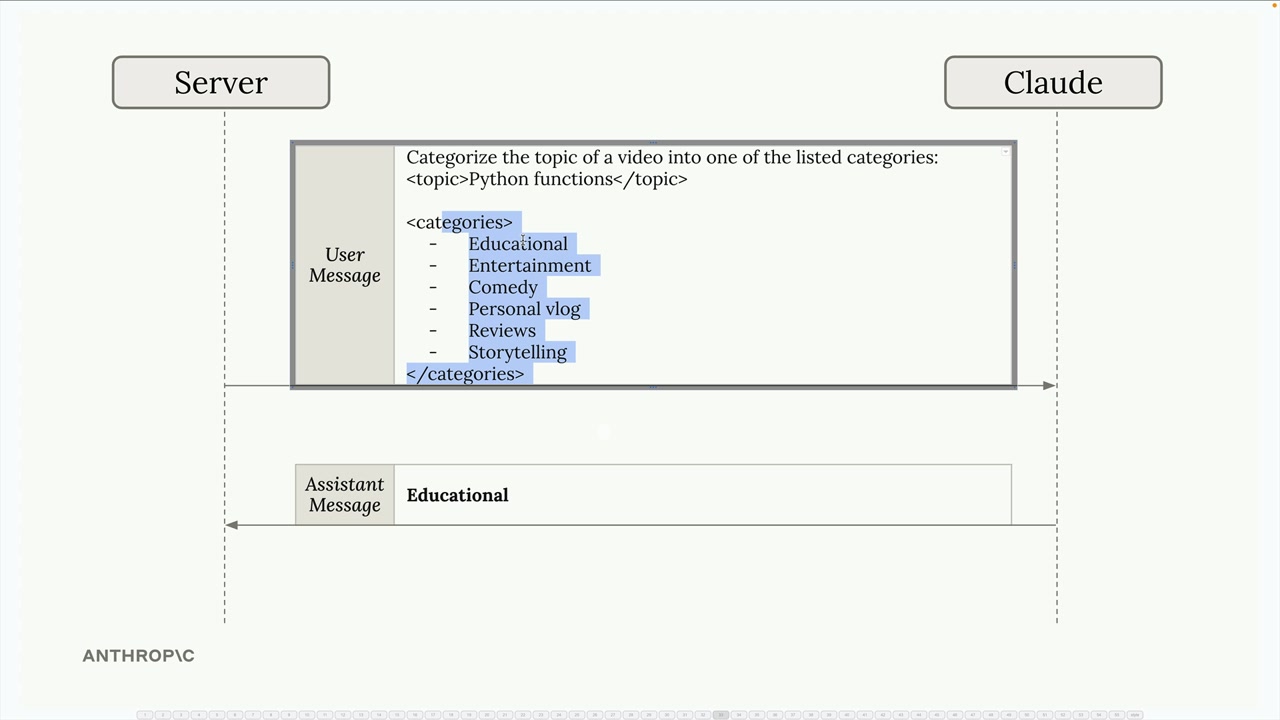
Par exemple, si un utilisateur saisit « fonctions Python » comme sujet, vous demanderiez d'abord à Claude de le catégoriser :
Categorize the topic of a video into one of the listed categories:
<topic>Python functions</topic>

<categories>
- Educational
- Entertainment
- Comedy
- Personal vlog
- Reviews
- Storytelling
</categories>Claude répond avec « Éducatif », vous utilisez alors le modèle d'invite éducatif pour générer le contenu réel du script.
Architecture du flux de travail de routage
Un flux de travail de routage suit ce modèle :
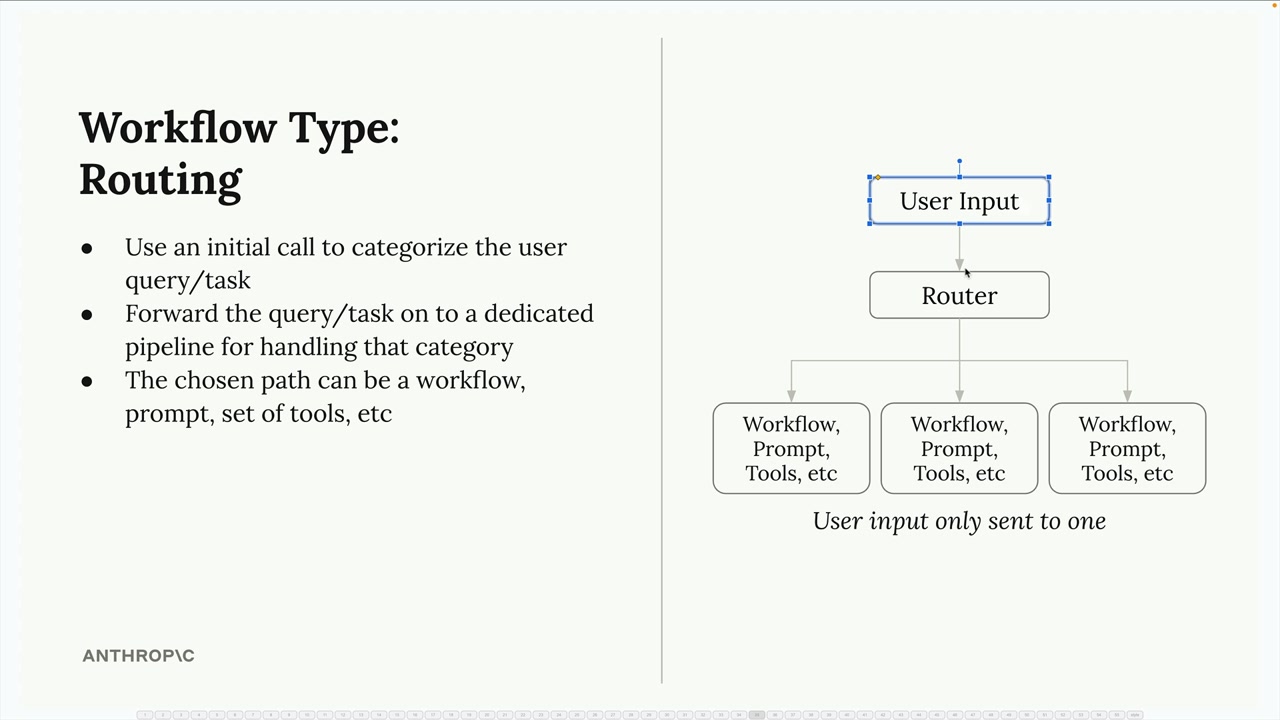
- L'entrée de l'utilisateur passe d'abord par un composant de routage
- Le routeur catégorise la demande à l'aide d'un appel initial à Claude
- En fonction de la catégorie, l'entrée est transmise à un pipeline de traitement spécifique
- Chaque pipeline peut avoir son propre flux de travail, ses propres invites ou outils optimisés pour cette catégorie
L'idée clé est que l'entrée de l'utilisateur ne passe que par un seul pipeline spécialisé, et non par tous. Cela permet à chaque pipeline d'être hautement optimisé pour son cas d'usage spécifique.
Quand utiliser le routage
Les flux de travail de routage fonctionnent bien lorsque :
- Votre application gère divers types de demandes nécessitant des approches différentes
- Vous pouvez définir clairement des catégories qui couvrent vos cas d'usage
- L'étape de catégorisation peut être gérée de manière fiable par Claude
- L'avantage en termes de performance du traitement spécialisé compense le surcoût de l'étape de routage
Ce modèle est particulièrement précieux pour les bots de service client, les outils de génération de contenu, et toute application où la « bonne » réponse dépend fortement de la compréhension du type de demande effectuée.