L'ingénierie des prompts consiste à prendre un prompt que vous avez écrit et à l'améliorer pour obtenir des résultats plus fiables et de meilleure qualité. Ce processus implique un raffinement itératif - en commençant par un prompt basique, en évaluant sa performance, puis en appliquant systématiquement des techniques d'ingénierie pour l'améliorer.
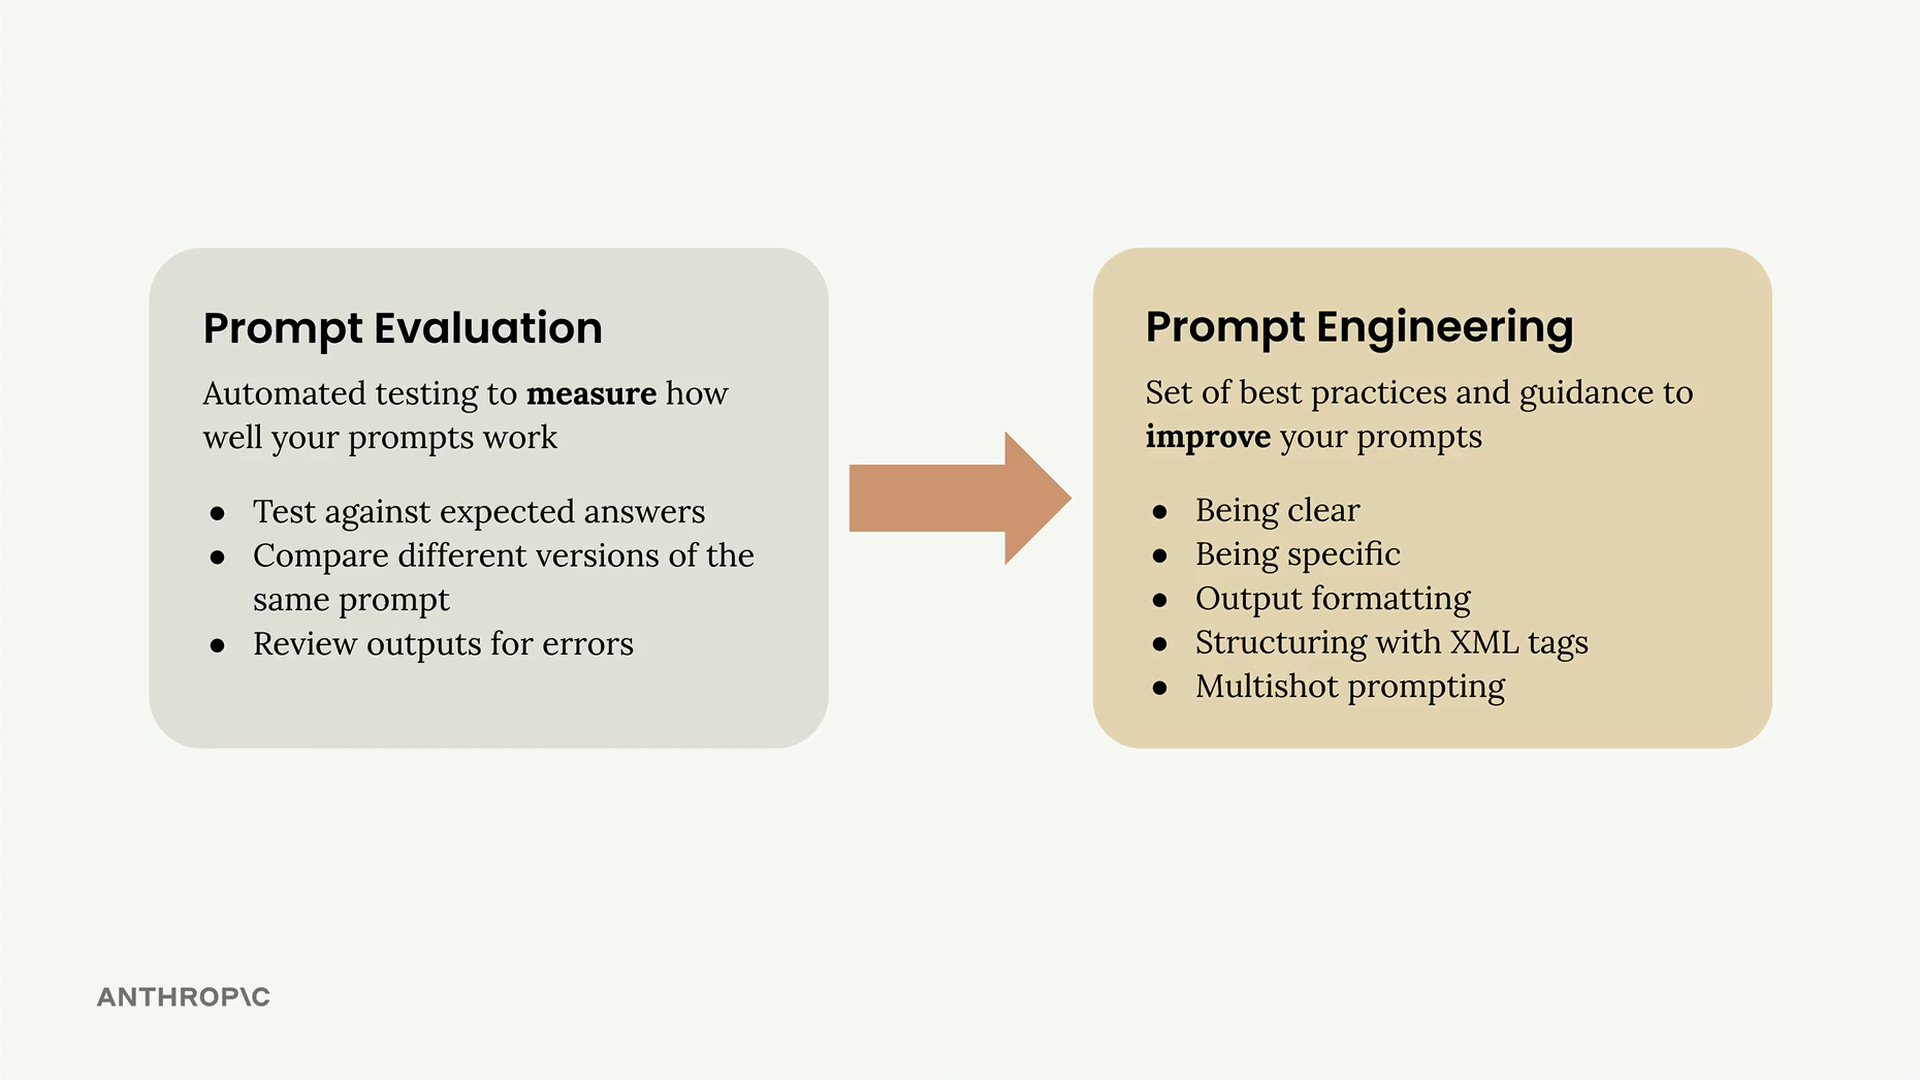
Le processus d'amélioration itérative
L'approche suit un cycle clair que vous pouvez répéter jusqu'à ce que vous obteniez les résultats souhaités :
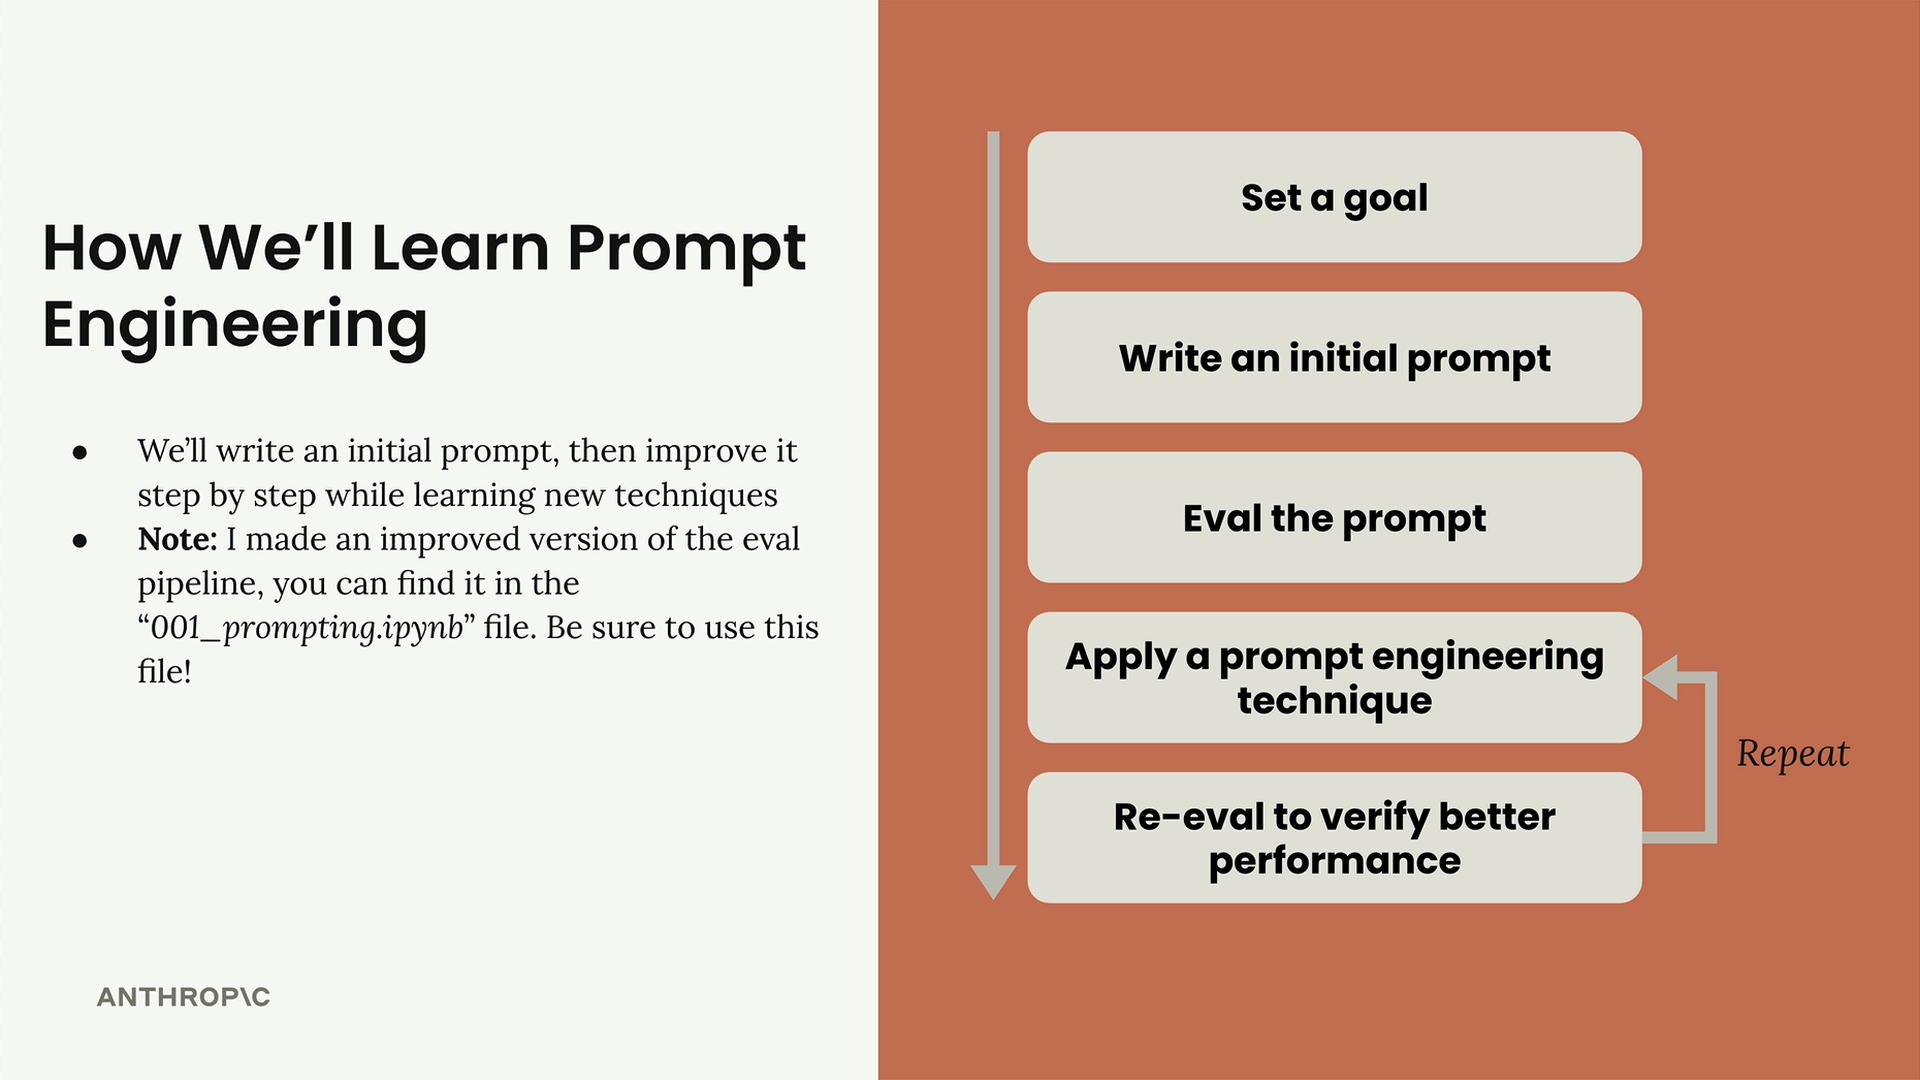
- Définir un objectif - Définissez ce que vous voulez que votre prompt accomplisse
- Écrire un prompt initial - Créez une première tentative basique
- Évaluer le prompt - Testez-le selon vos critères
- Appliquer des techniques d'ingénierie des prompts - Utilisez des méthodes spécifiques pour améliorer la performance
- Réévaluer - Vérifiez que vos modifications ont réellement amélioré les résultats
Vous répétez les deux dernières étapes jusqu'à ce que vous soyez satisfait de la performance. Chaque itération devrait montrer une amélioration mesurable dans vos scores d'évaluation.
Configuration de votre pipeline d'évaluation
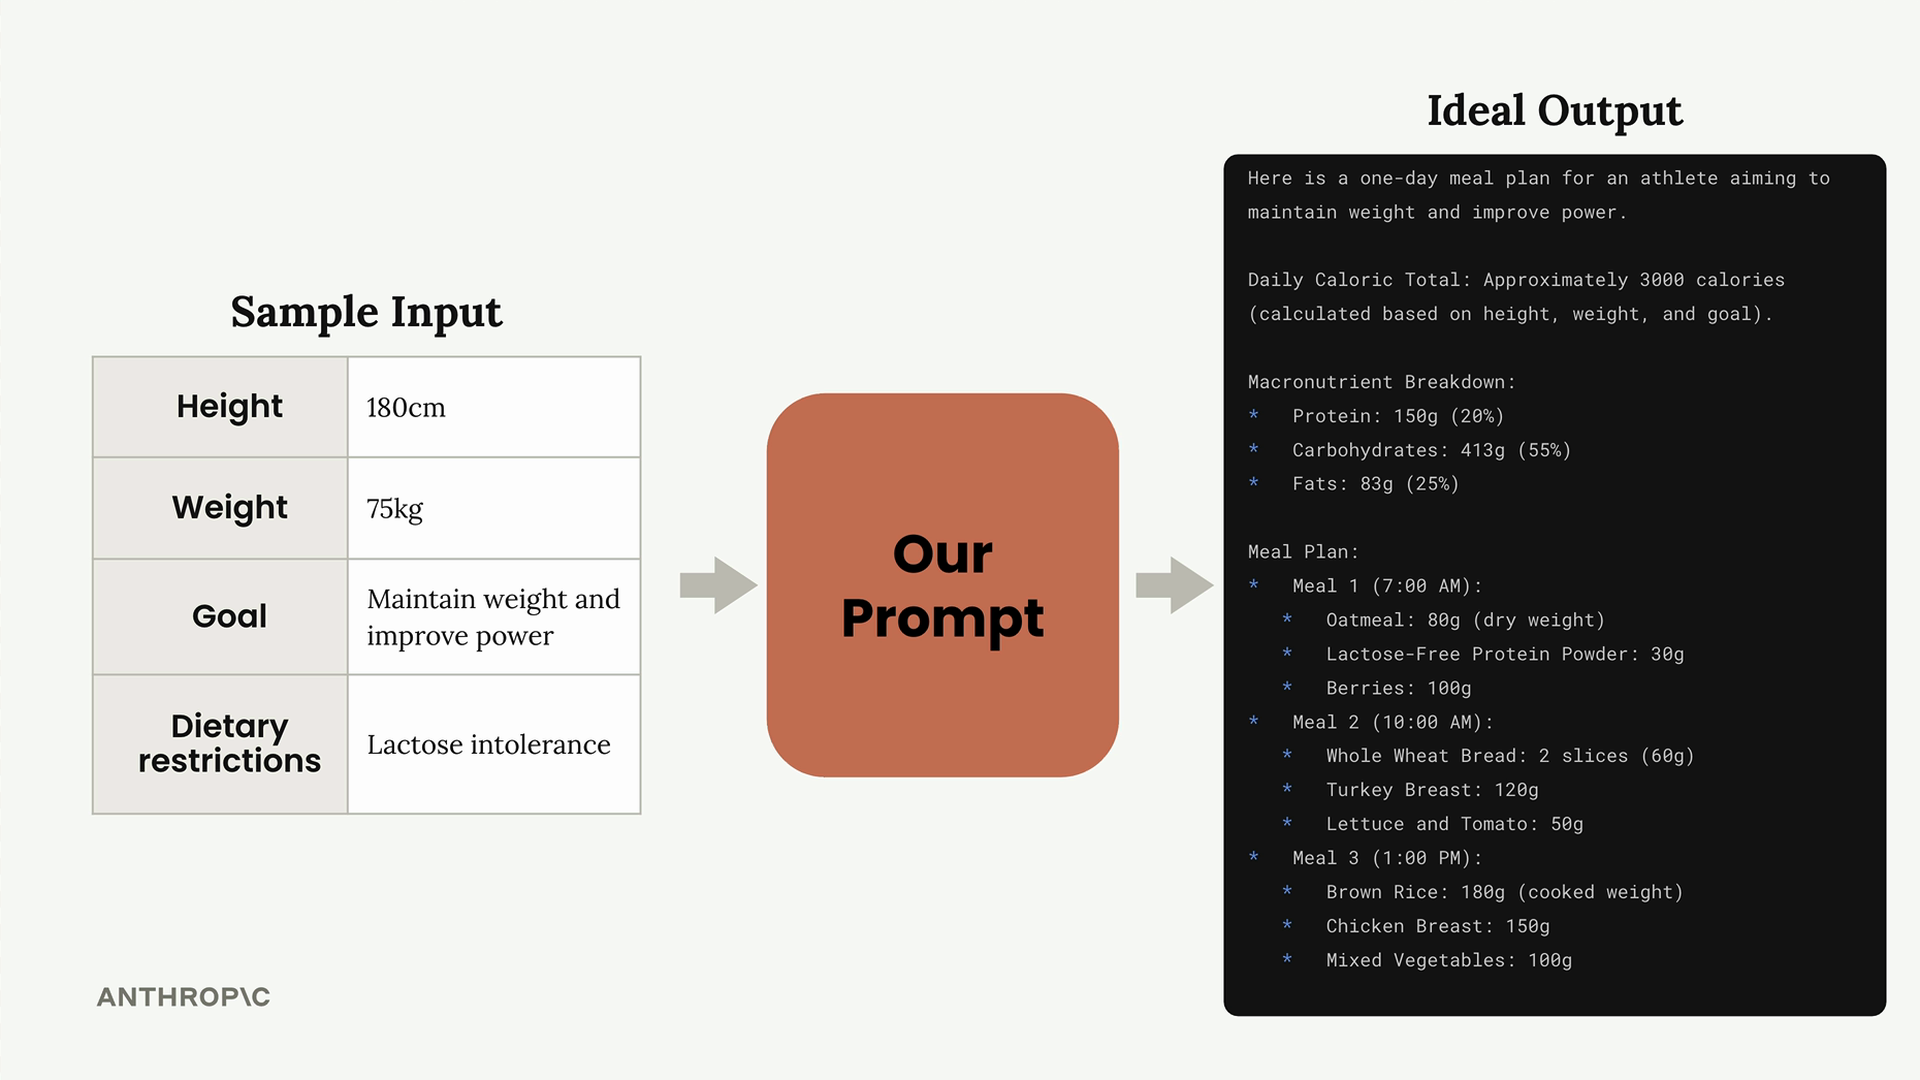
Pour démontrer ce processus, nous allons travailler avec un exemple pratique : créer un prompt qui génère des plans de repas d'une journée pour des athlètes. Le prompt doit prendre en compte la taille, le poids, les objectifs et les restrictions alimentaires d'un athlète, puis produire un plan de repas complet.
La configuration d'évaluation utilise une classe PromptEvaluator qui gère la génération de jeux de données et la notation par le modèle. Lors de la création de votre instance d'évaluateur, vous pouvez contrôler la concurrence avec le paramètre max_concurrent_tasks :
evaluator = PromptEvaluator(max_concurrent_tasks=5)Commencez avec une valeur de concurrence faible (comme 3) pour éviter les erreurs de limite de débit. Vous pouvez l'augmenter si votre quota d'API permet un traitement plus rapide.
Génération de données de test
Le système d'évaluation peut générer automatiquement des cas de test en fonction des exigences de votre prompt. Vous définissez les entrées dont votre prompt a besoin :
dataset = evaluator.generate_dataset(
    task_description="Write a compact, concise 1 day meal plan for a single athlete",
    prompt_inputs_spec={
        "height": "Athlete's height in cm",
        "weight": "Athlete's weight in kg",
        "goal": "Goal of the athlete",
        "restrictions": "Dietary restrictions of the athlete"
    },
    output_file="dataset.json",
    num_cases=3
)
Gardez le nombre de cas de test faible (2-3) pendant le développement pour accélérer votre cycle d'itération. Vous pouvez l'augmenter pour la validation finale.
Écriture de votre prompt initial
Commencez avec un prompt simple et naïf pour établir une référence. Voici un exemple d'une première tentative délibérément basique :
def run_prompt(prompt_inputs):
    prompt = f"""
What should this person eat?

- Height: {prompt_inputs["height"]}
- Weight: {prompt_inputs["weight"]}
- Goal: {prompt_inputs["goal"]}
- Dietary restrictions: {prompt_inputs["restrictions"]}
"""

    messages = []
    add_user_message(messages, prompt)
    return chat(messages)
Ce prompt basique produira probablement de mauvais résultats, mais il vous donne un point de départ pour mesurer l'amélioration.
Ajout de critères d'évaluation
Lors de l'exécution de votre évaluation, vous pouvez spécifier des critères supplémentaires que le modèle de notation devrait prendre en compte :
results = evaluator.run_evaluation(
    run_prompt_function=run_prompt,
    dataset_file="dataset.json",
    extra_criteria="""
The output should include:
- Daily caloric total
- Macronutrient breakdown
- Meals with exact foods, portions, and timing
"""
)
Cela permet de garantir que votre prompt est évalué selon les exigences spécifiques qui comptent pour votre cas d'usage.
Analyse des résultats
Après avoir exécuté une évaluation, vous obtiendrez à la fois un score numérique et un rapport HTML détaillé. Le rapport vous montre exactement comment chaque cas de test s'est comporté, y compris le raisonnement du modèle pour chaque score.
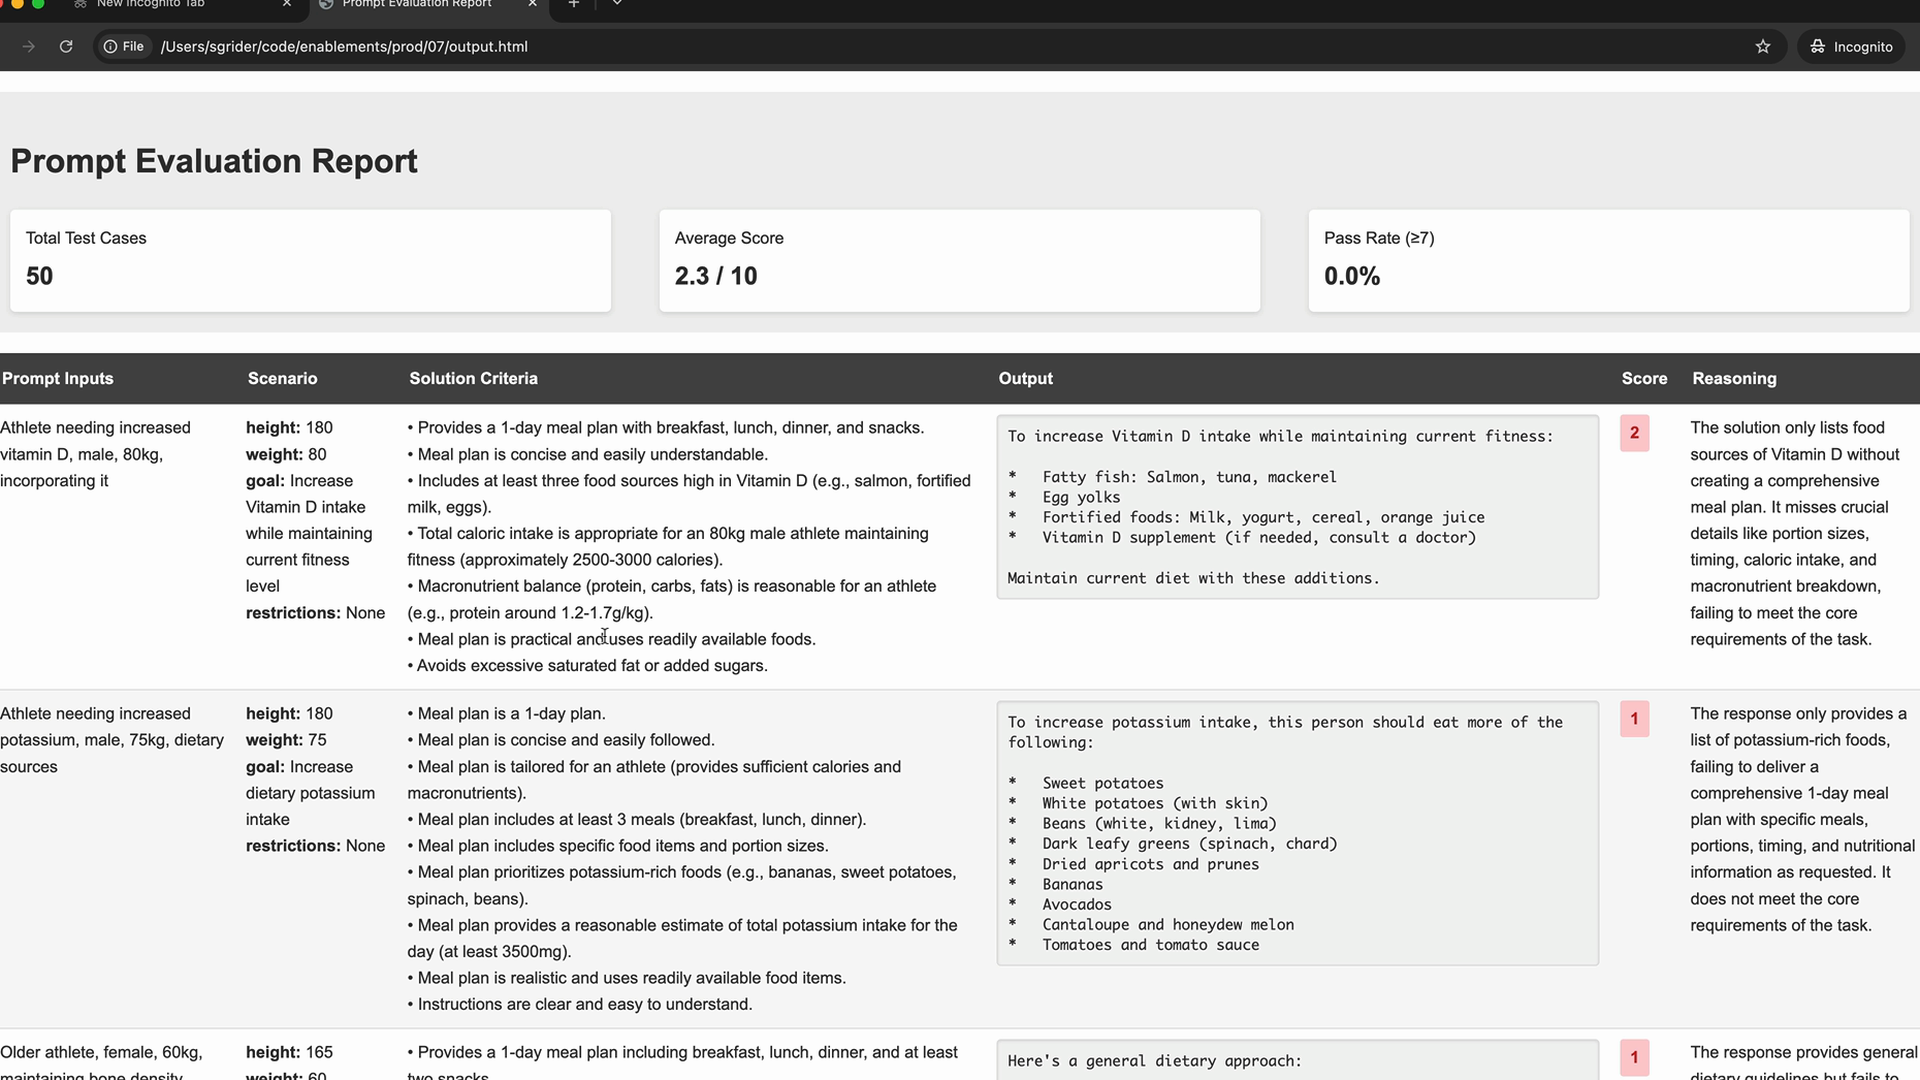
Ne soyez pas découragé par des scores initiaux faibles - un score de 2,3 sur 10 est typique pour une première tentative. L'objectif est de voir une amélioration constante à mesure que vous appliquez des techniques d'ingénierie.
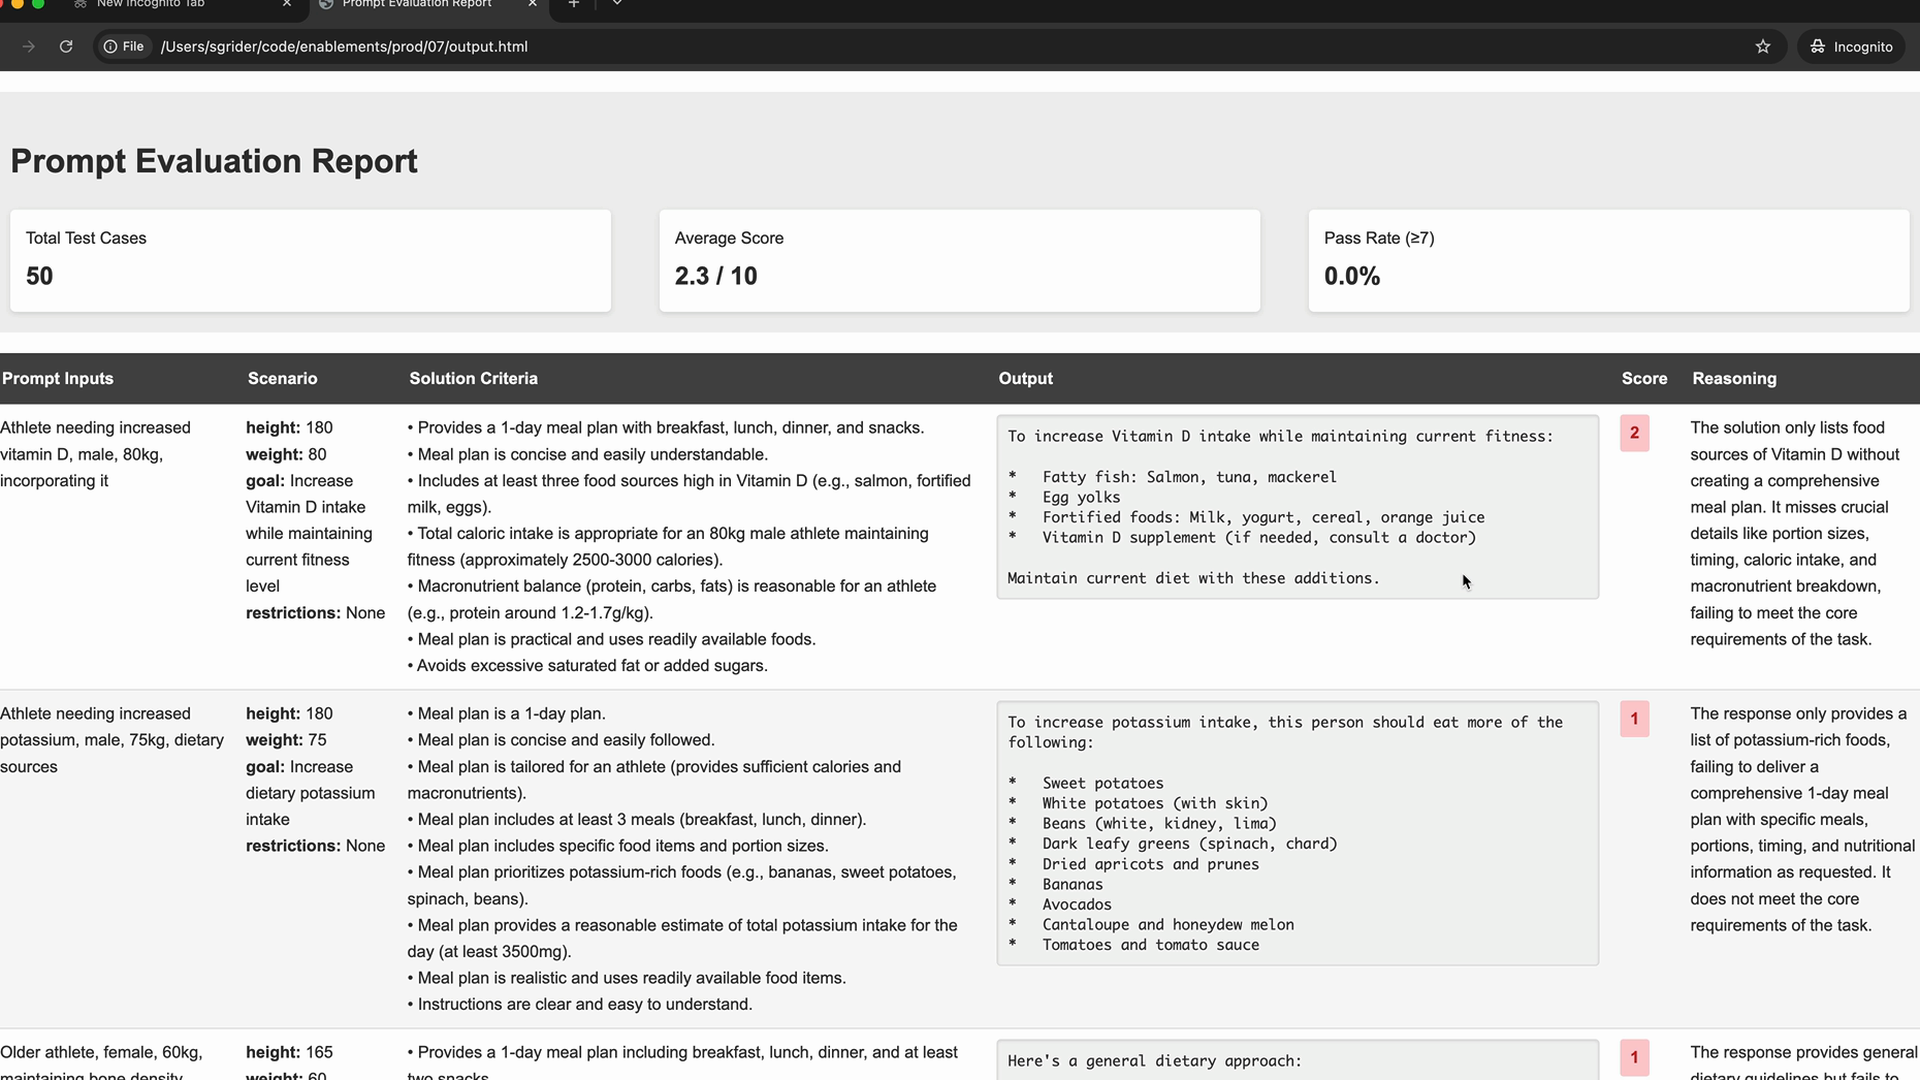
Le rapport d'évaluation détaillé vous aide à comprendre exactement où votre prompt échoue et quelles améliorations sont nécessaires. Utilisez ce retour pour guider votre prochaine itération.
Prochaines étapes
Avec votre référence établie, vous êtes prêt à commencer à appliquer des techniques spécifiques d'ingénierie des prompts. Chaque technique que vous apprenez devrait entraîner une amélioration mesurable dans vos scores d'évaluation, transformant progressivement votre prompt basique en un outil fiable et performant.
Rappelez-vous que l'ingénierie des prompts est un processus itératif. La clé est de faire un changement à la fois, d'évaluer l'impact, et de construire sur ce qui fonctionne. Cette approche systématique vous assure de comprendre quelles techniques apportent le plus de valeur pour votre cas d'usage spécifique.