Lorsque vous créez des applications avec Claude, comprendre le cycle de vie complet d'une requête vous aide à prendre de meilleures décisions architecturales et à déboguer les problèmes plus efficacement. Parcourons ensemble ce qui se passe depuis le moment où un utilisateur clique sur « envoyer » dans votre interface de chat jusqu'à l'apparition de la réponse de Claude sur l'écran.
Le flux de requête en cinq étapes
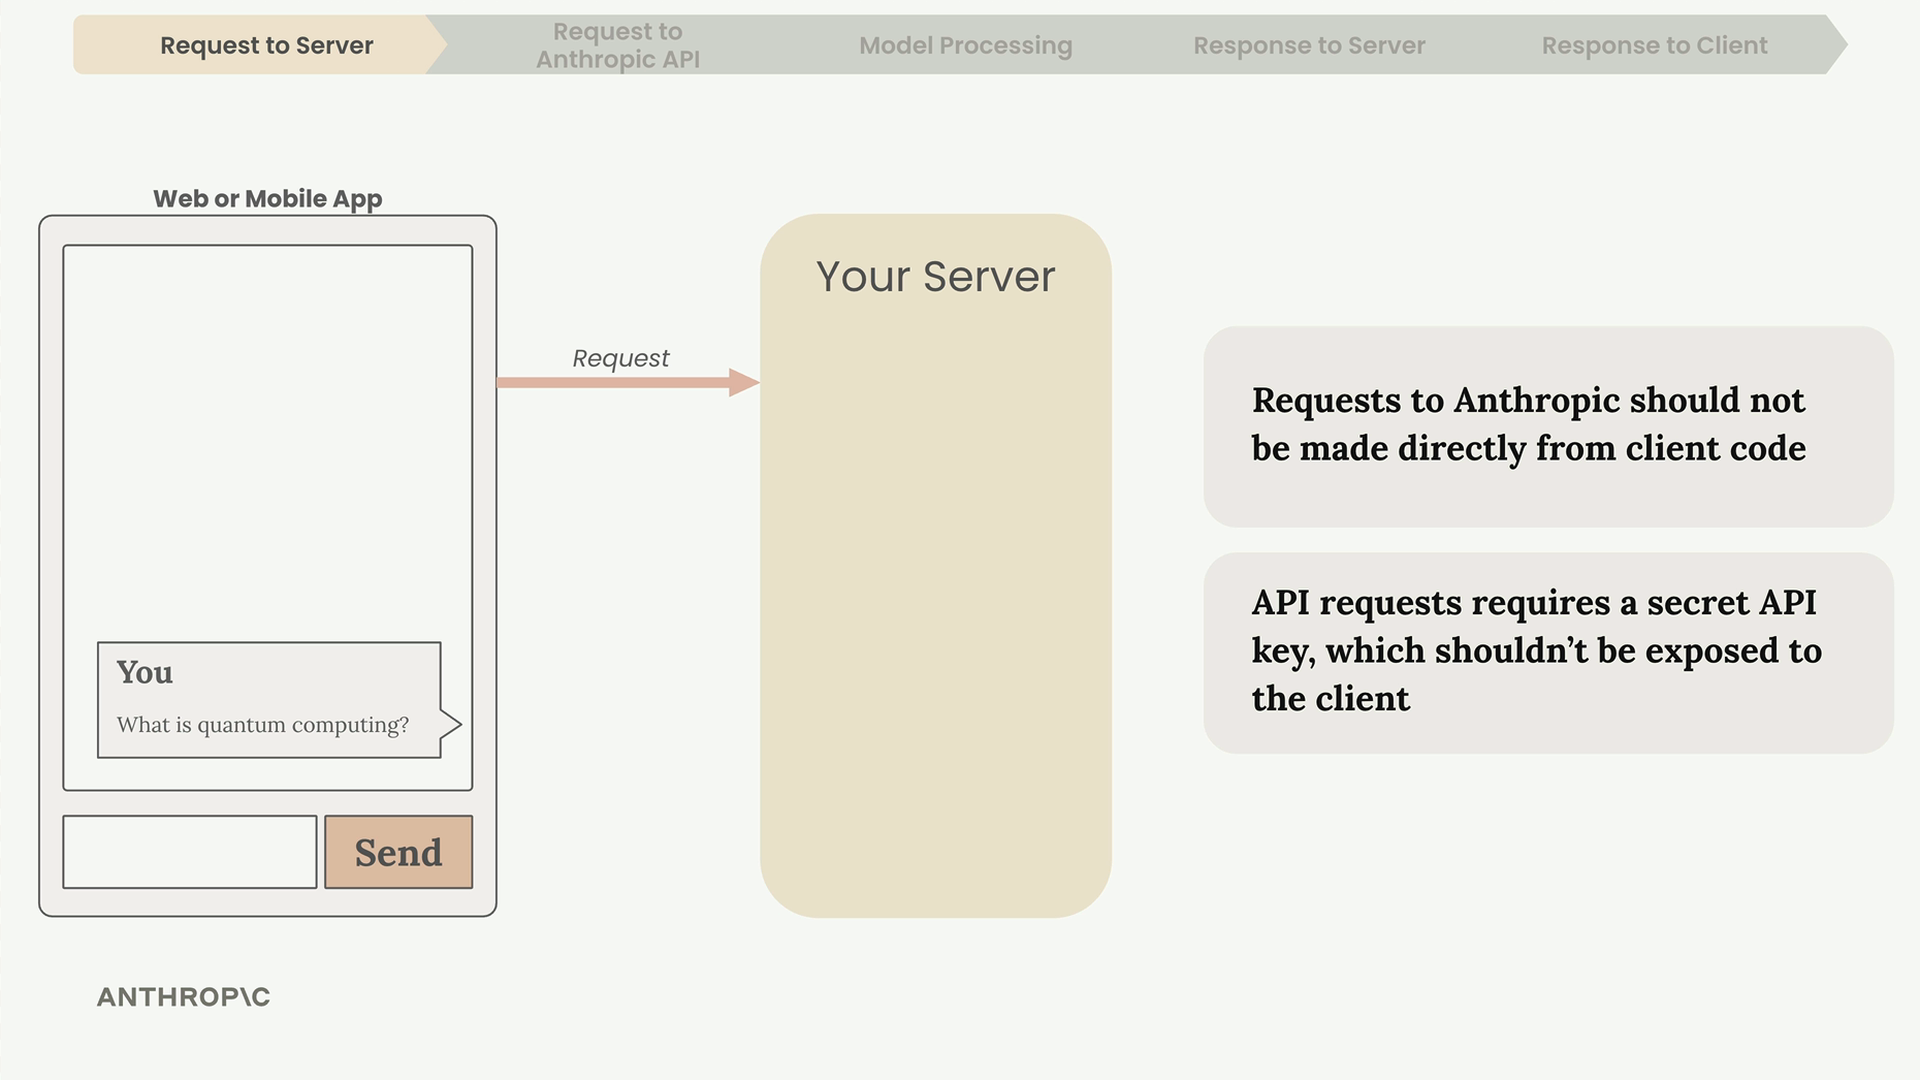
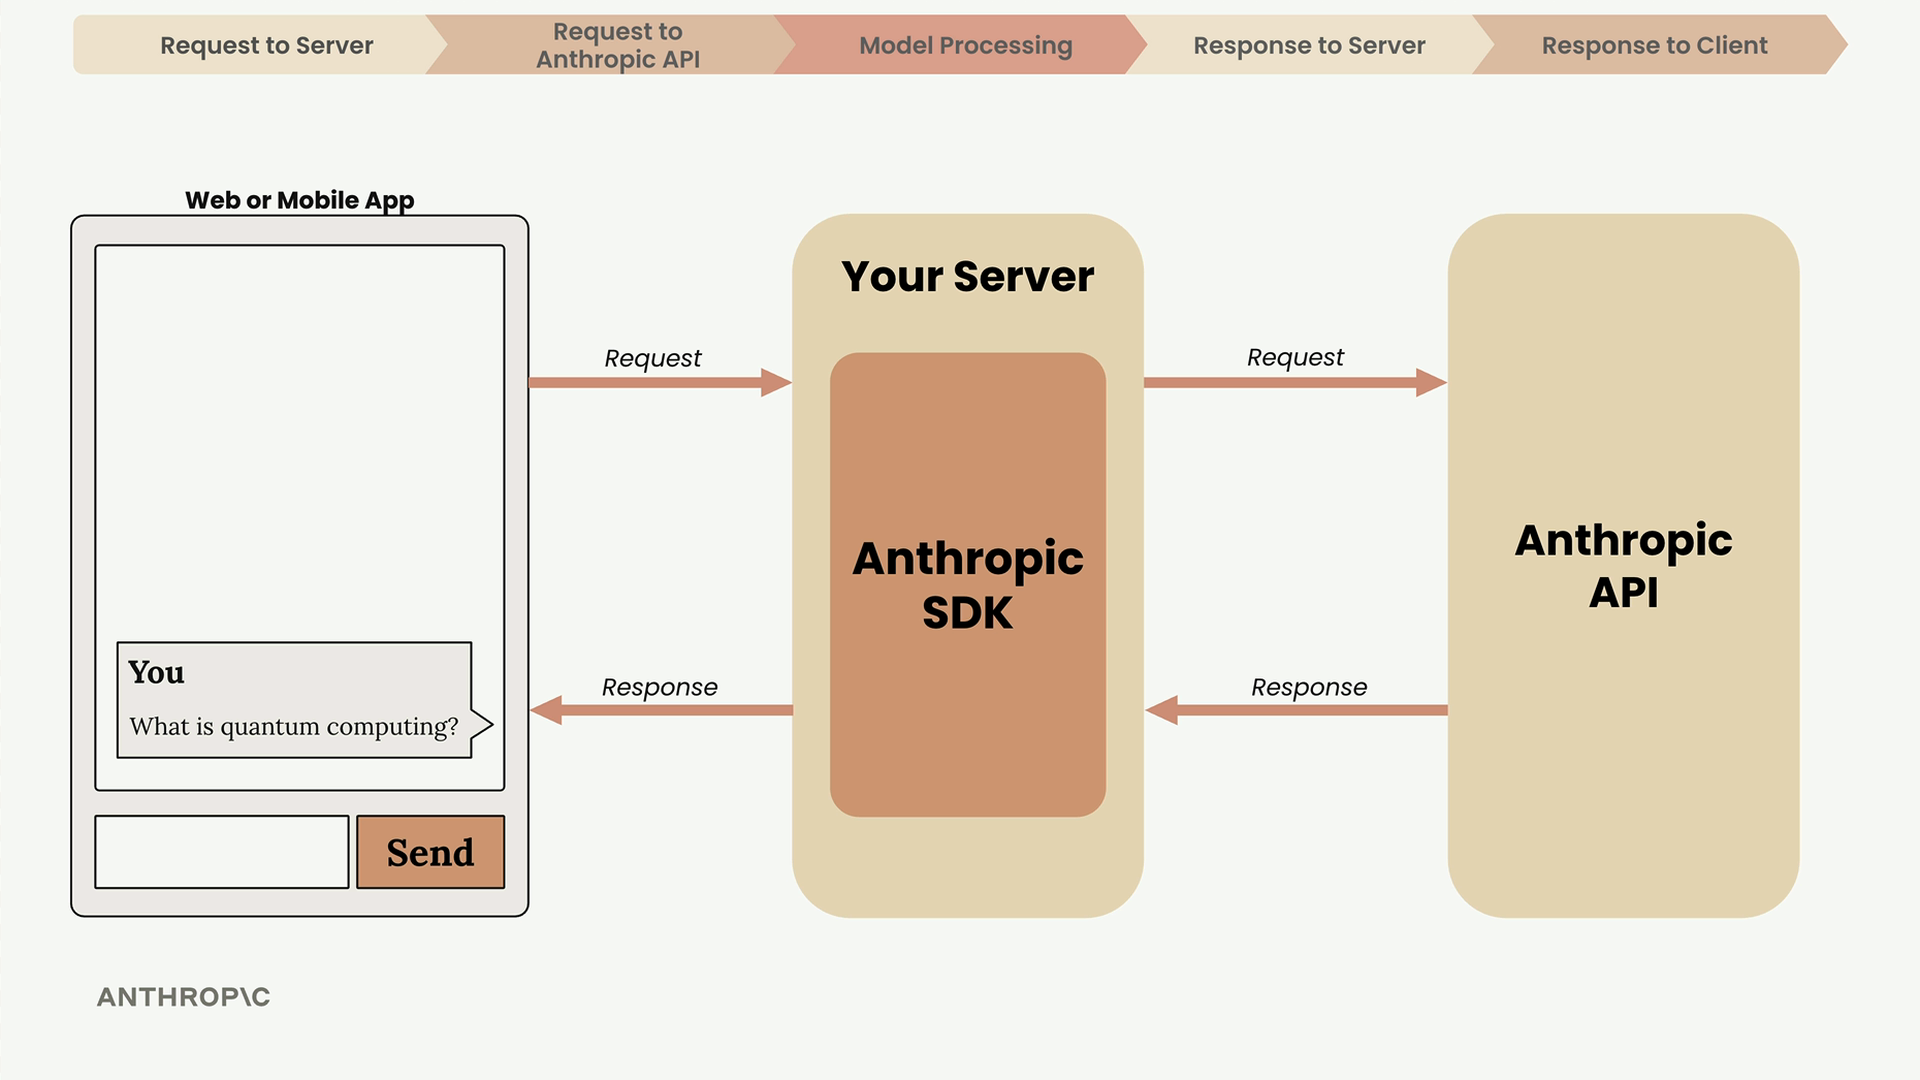
Chaque interaction avec Claude suit un schéma prévisible comportant cinq phases distinctes : requête vers le serveur, requête vers l'API Anthropic, traitement par le modèle, réponse vers le serveur, et réponse vers le client.
Pourquoi vous avez besoin d'un serveur
Vous ne devez jamais effectuer de requêtes directement vers l'API Anthropic depuis du code côté client. Voici pourquoi :
- Les requêtes API nécessitent une clé API secrète pour l'authentification
- Exposer cette clé dans le code client crée une grave vulnérabilité de sécurité
- N'importe qui pourrait extraire la clé et effectuer des requêtes non autorisées
Au lieu de cela, votre application web ou mobile envoie des requêtes à votre propre serveur, qui communique ensuite avec l'API Anthropic en utilisant la clé stockée de manière sécurisée.
Effectuer des requêtes API
Lorsque votre serveur contacte l'API Anthropic, vous pouvez utiliser soit un SDK officiel, soit effectuer des requêtes HTTP simples. Anthropic fournit des SDK pour Python, TypeScript, JavaScript, Go et Ruby.
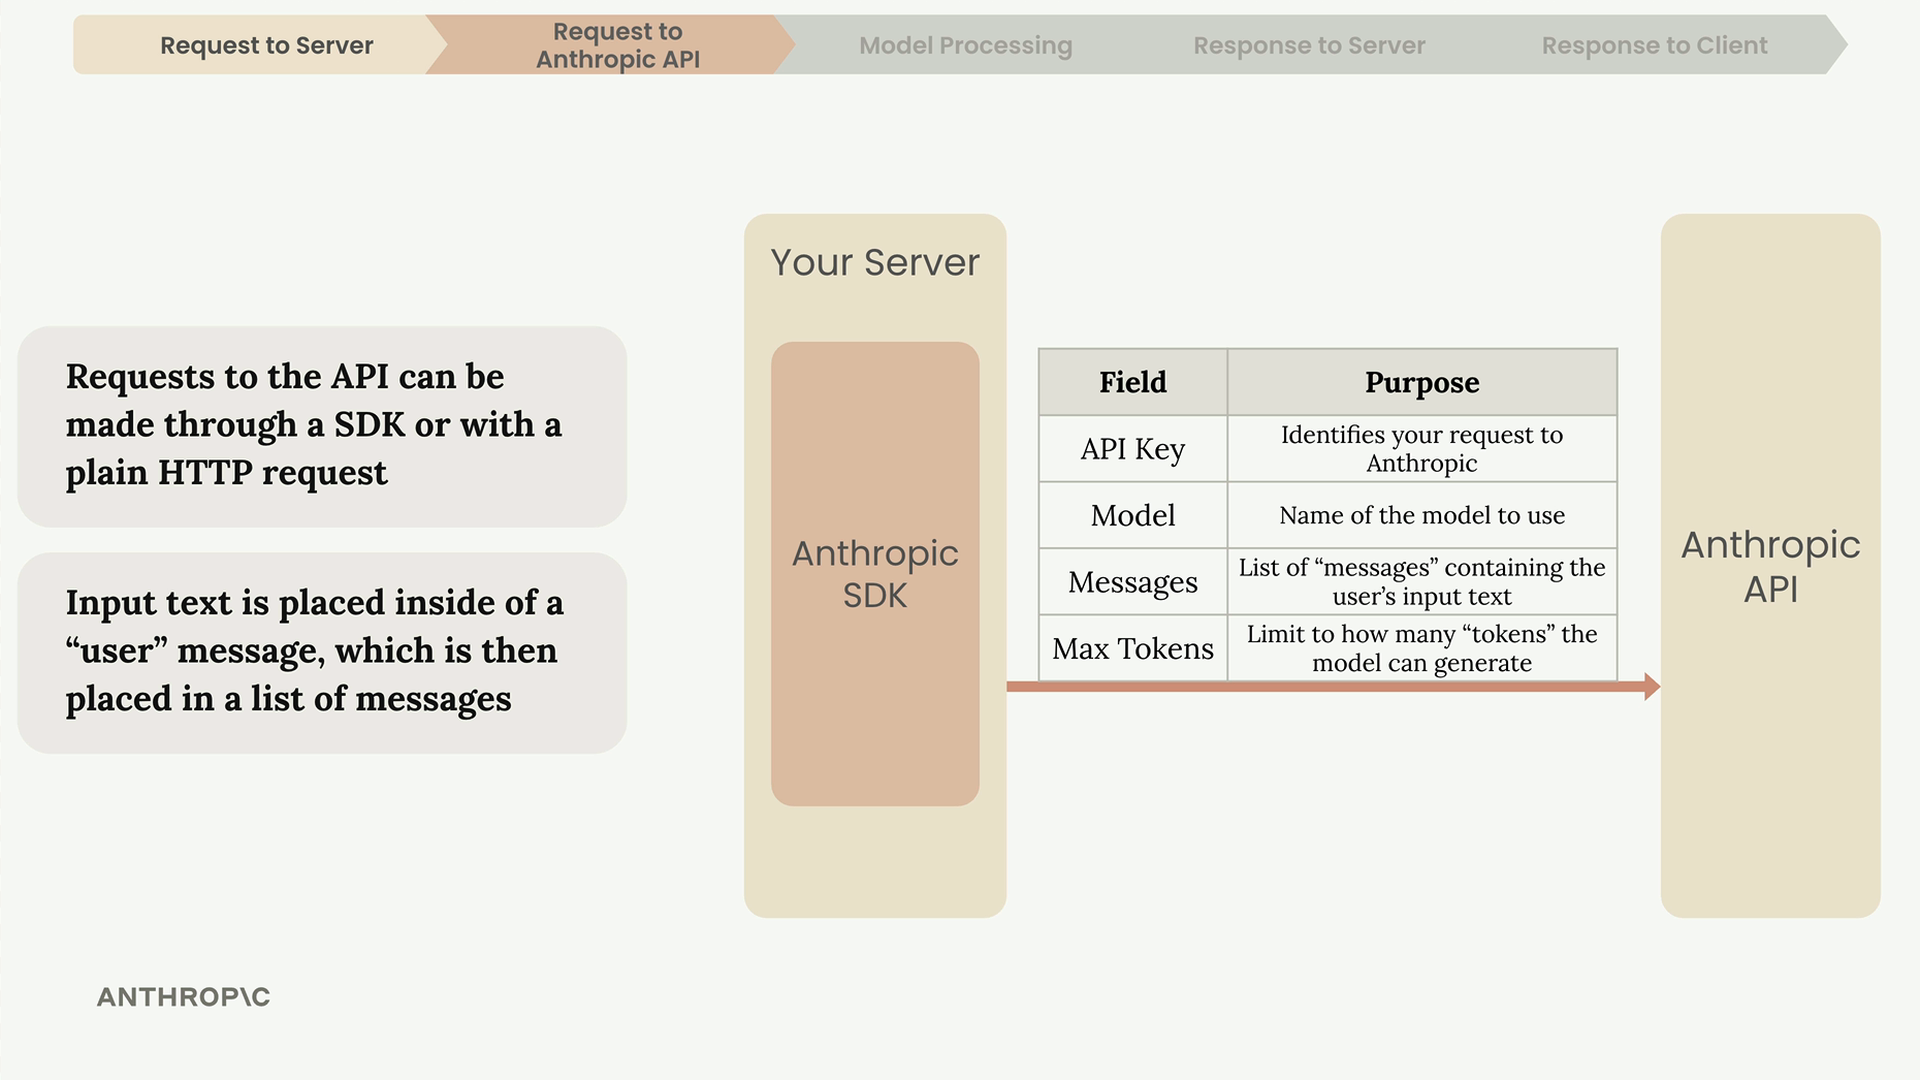
Chaque requête doit inclure ces champs essentiels :
- Clé API - Identifie votre requête auprès d'Anthropic
- Modèle - Nom du modèle à utiliser (comme « claude-sonnet-4-5 »)
- Messages - Liste contenant le texte saisi par l'utilisateur
- Max Tokens - Limite du nombre de tokens que Claude peut générer
À l'intérieur du traitement de Claude
Une fois qu'Anthropic reçoit votre requête, Claude la traite à travers quatre étapes principales : tokenisation, embedding, contextualisation et génération.
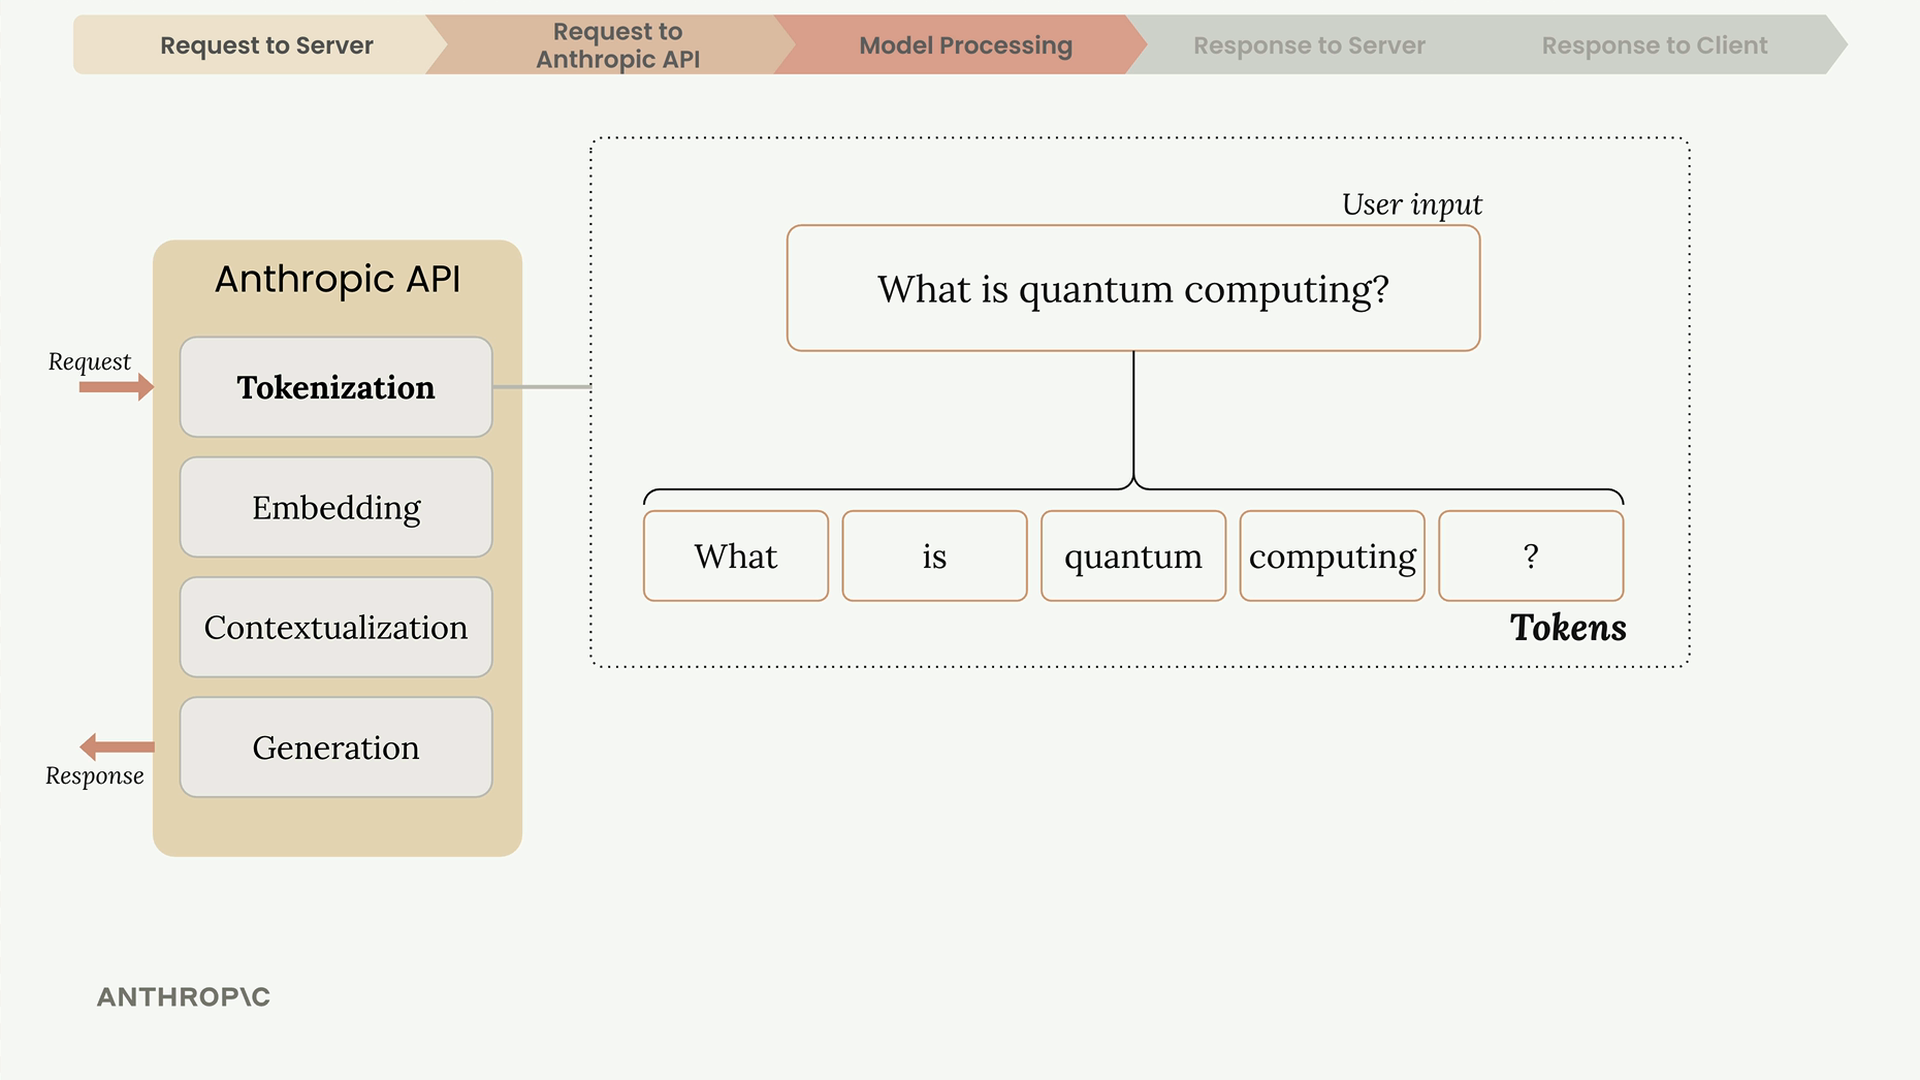
Tokenisation
Claude décompose d'abord votre texte d'entrée en plus petits morceaux appelés tokens. Ceux-ci peuvent être des mots entiers, des parties de mots, des espaces ou des symboles. Pour simplifier, considérez chaque mot comme un token.
Embedding
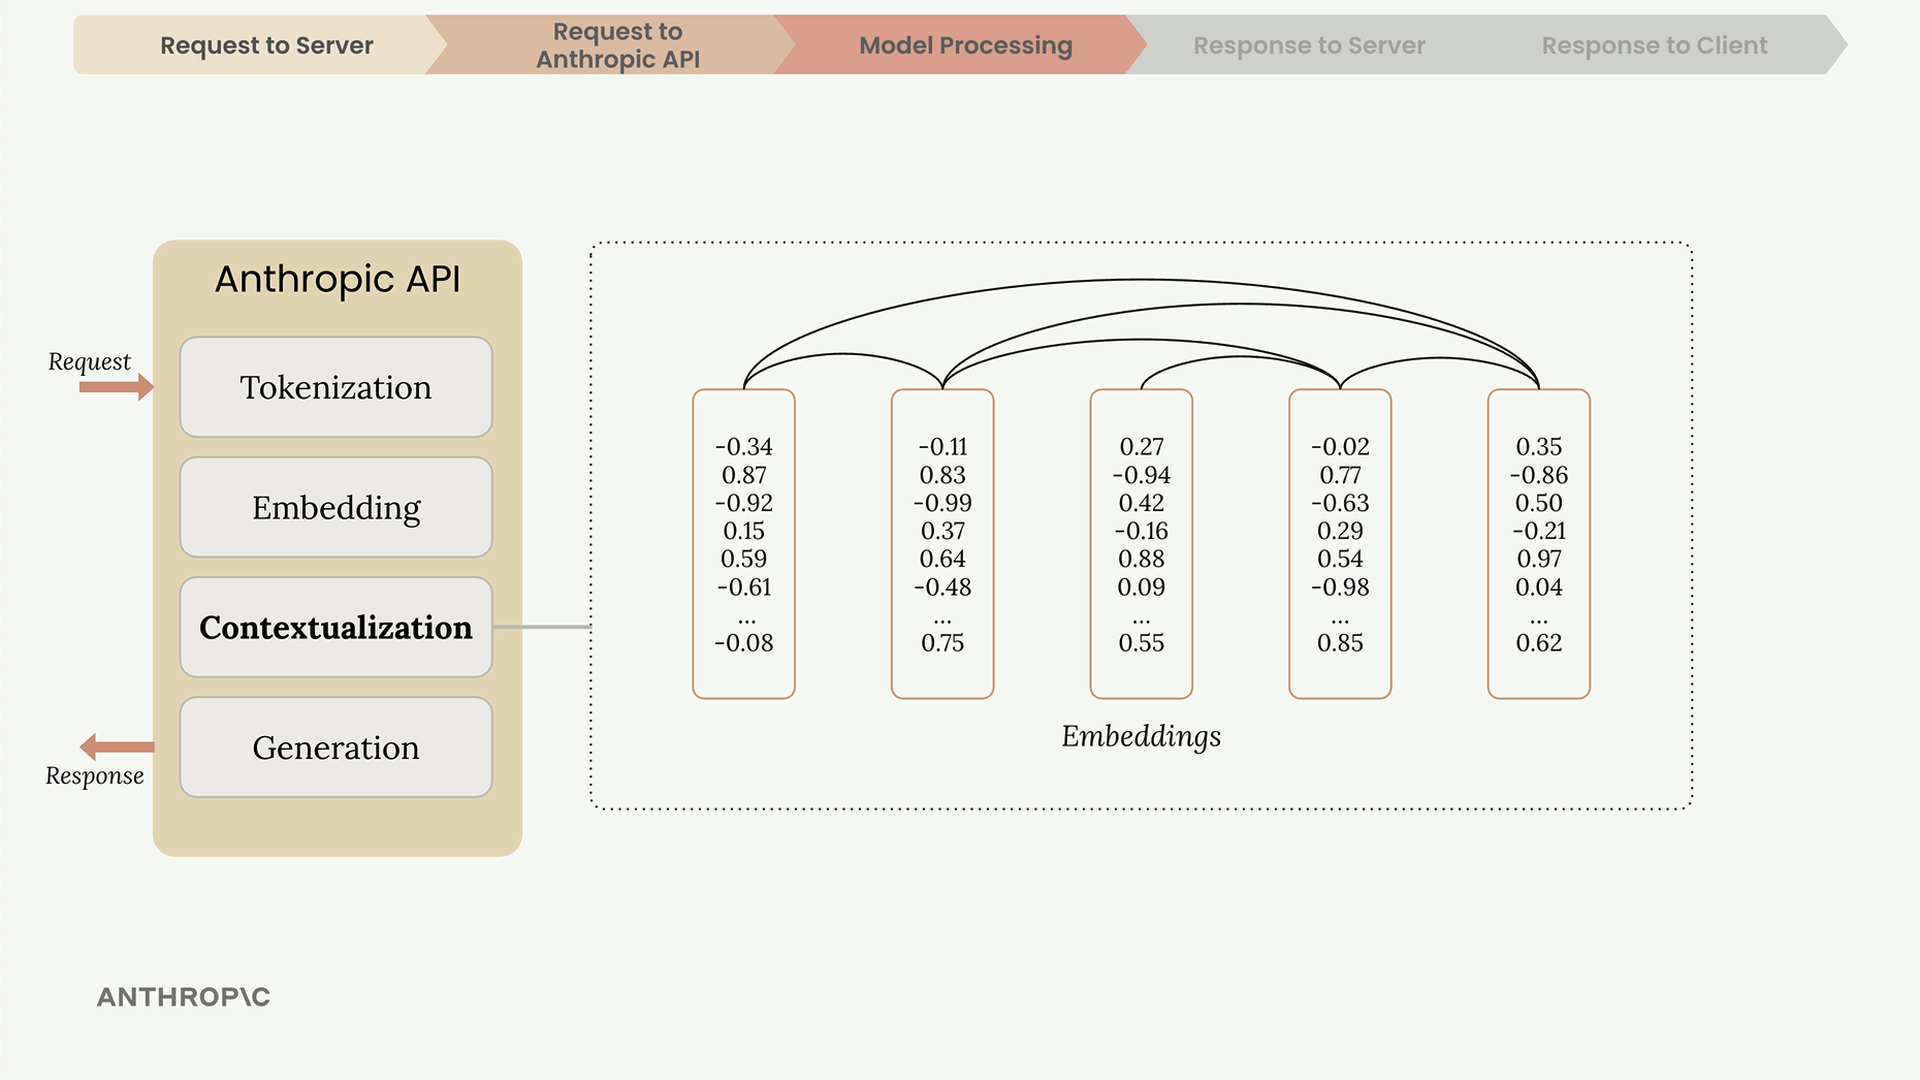
Chaque token est converti en un embedding - une longue liste de nombres qui représente tous les sens possibles de ce mot. Considérez les embeddings comme des définitions numériques qui capturent les relations sémantiques.
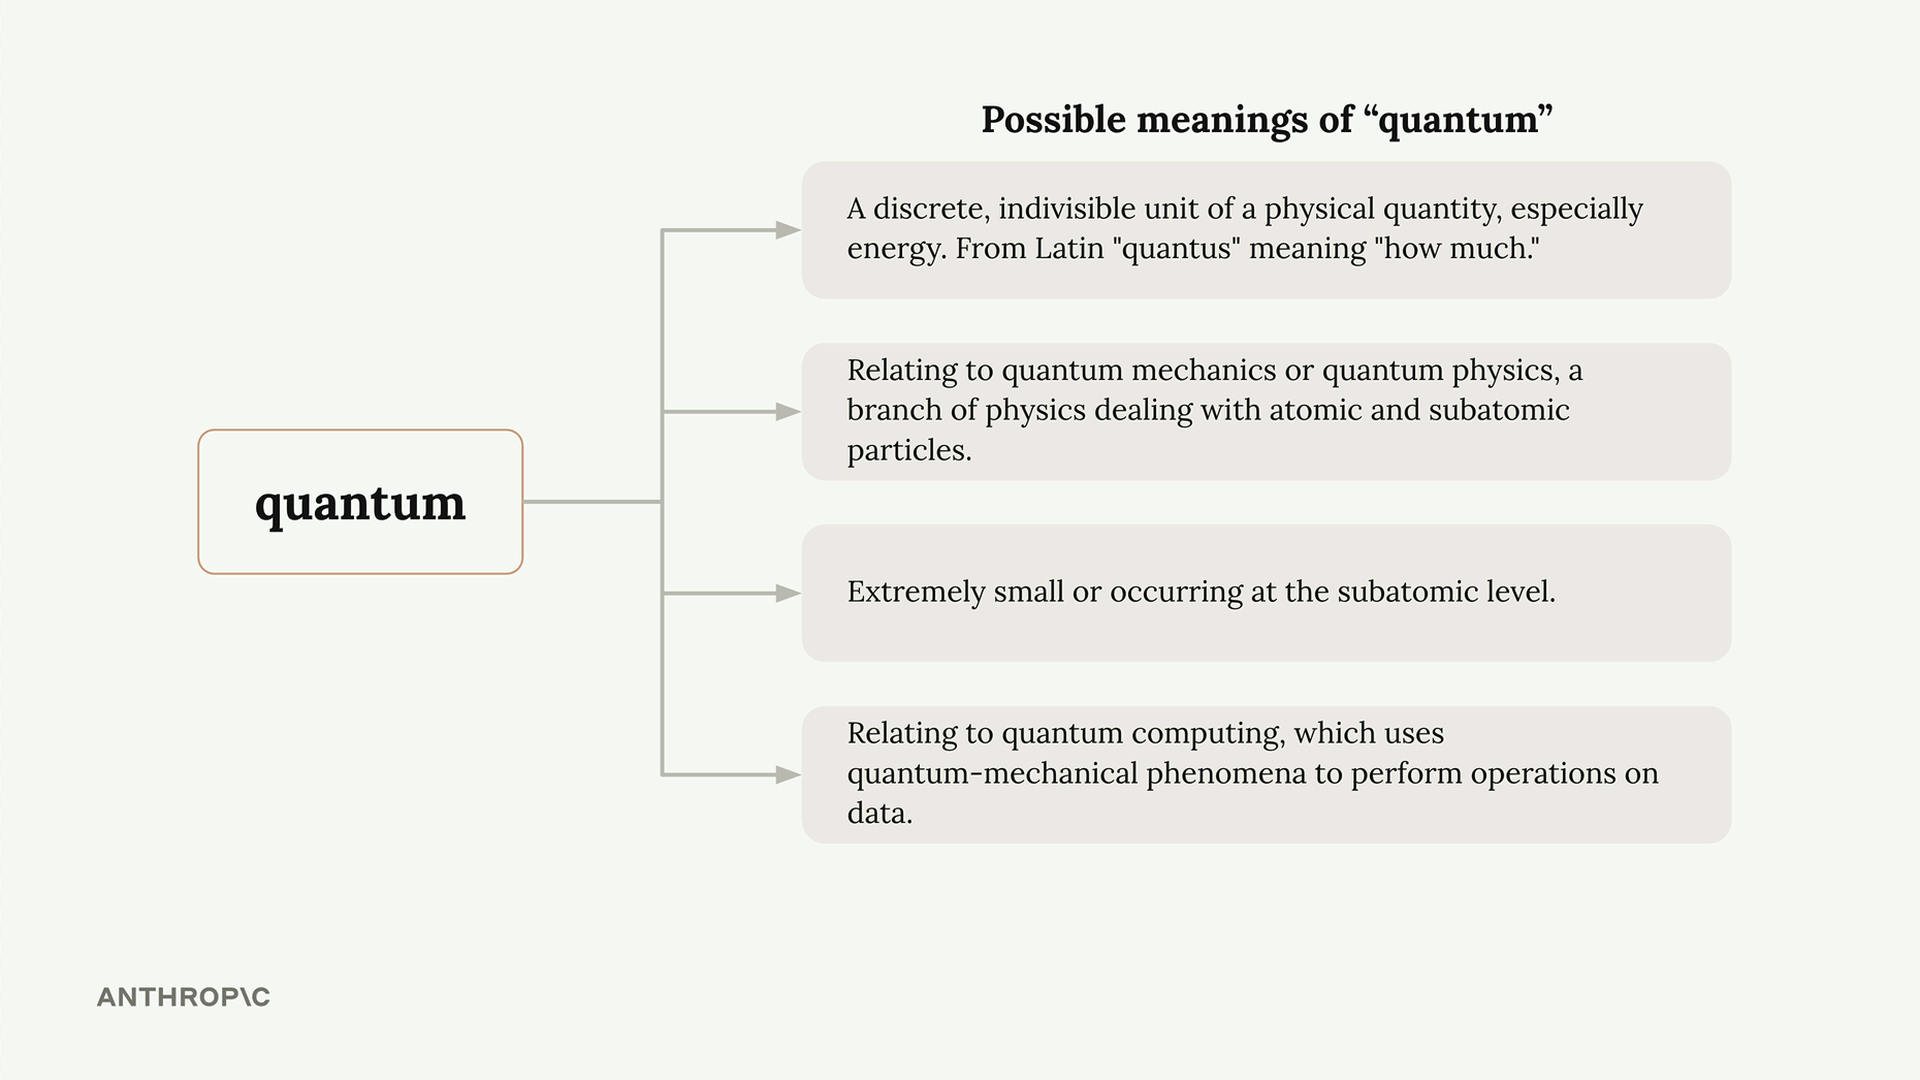
Les mots ont souvent plusieurs sens. Par exemple, « quantum » pourrait faire référence à :
- Une unité discrète de quantité physique (physique)
- La mécanique quantique ou des concepts de physique quantique
- Quelque chose d'extrêmement petit ou subatomique
- Des applications d'informatique quantique
Contextualisation
Claude affine chaque embedding en fonction des mots environnants pour déterminer le sens le plus probable dans le contexte. Ce processus ajuste les représentations numériques pour mettre en évidence la définition appropriée.
Génération
Les embeddings contextualisés passent à travers une couche de sortie qui calcule les probabilités pour chaque mot suivant possible. Claude ne choisit pas toujours le mot ayant la probabilité la plus élevée - il utilise un mélange de probabilité et de hasard contrôlé pour créer des réponses naturelles et variées.
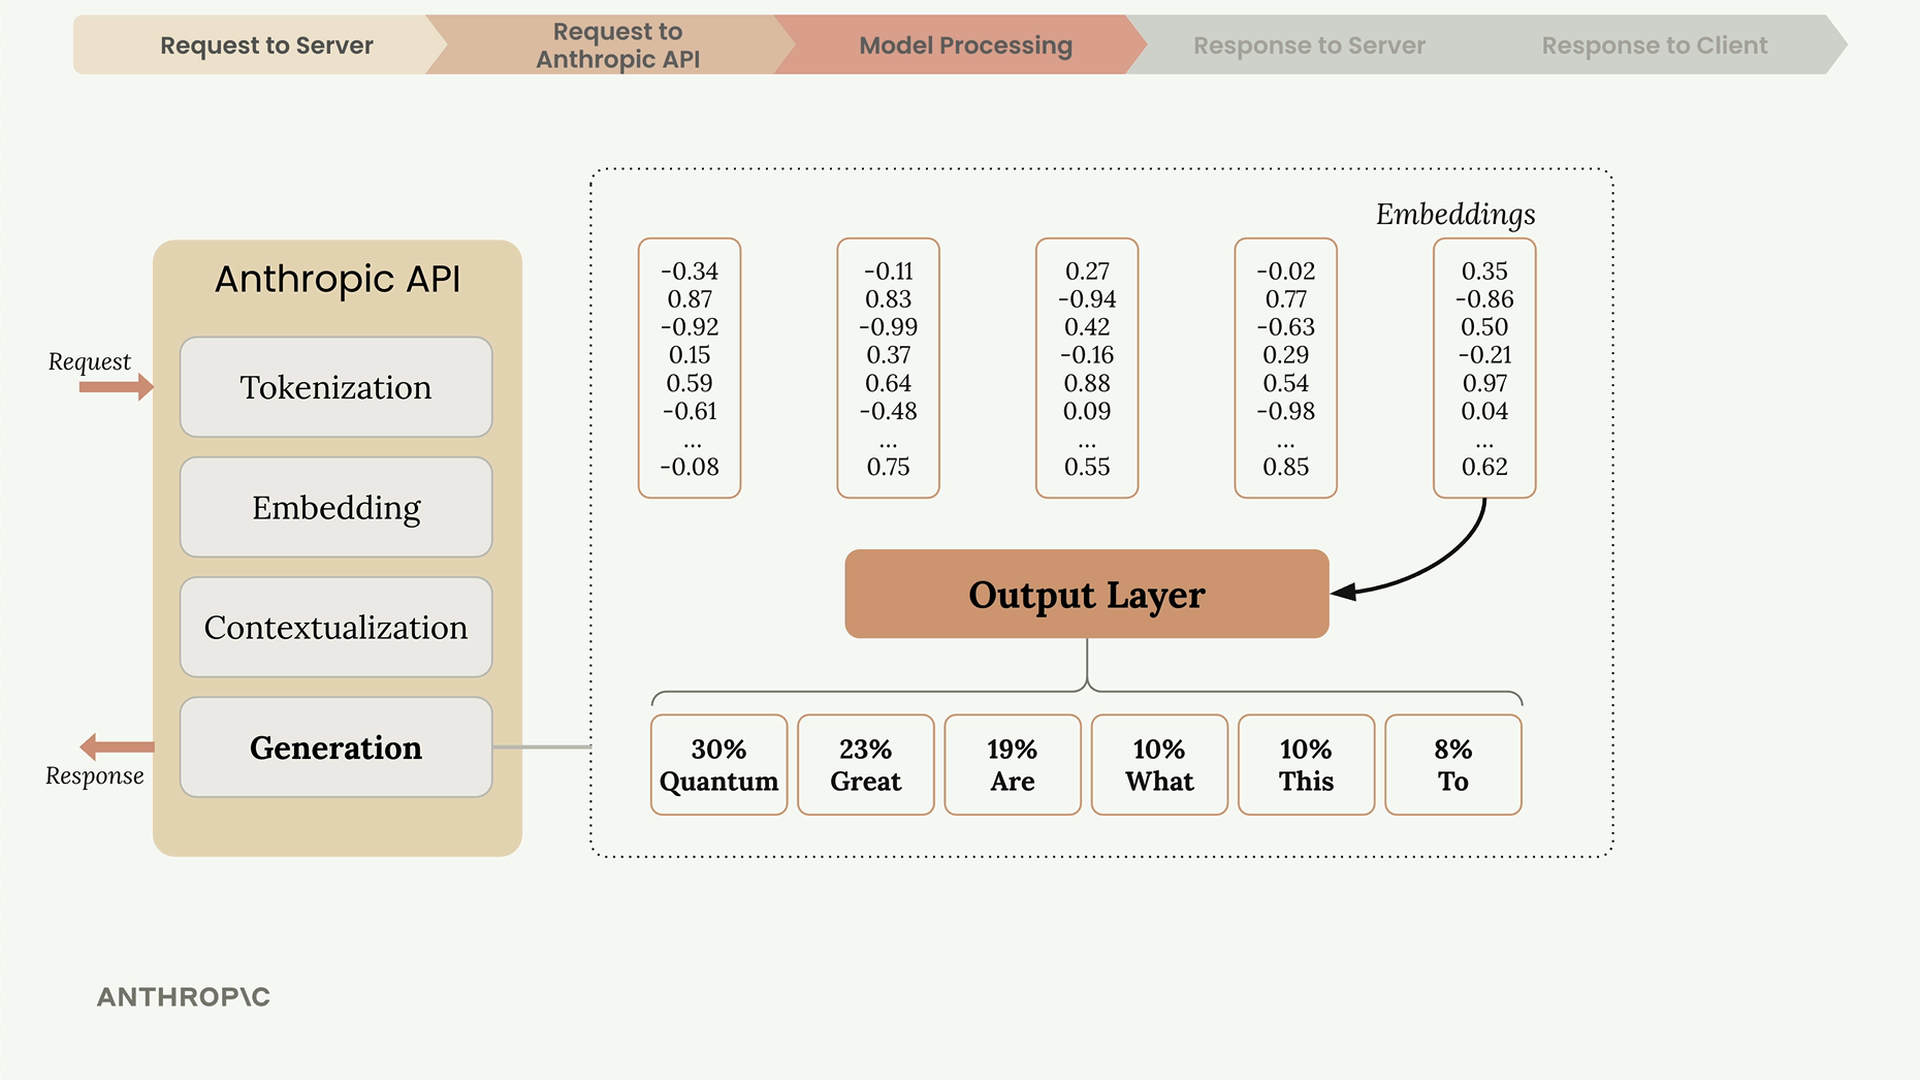
Après avoir sélectionné chaque mot, Claude l'ajoute à la séquence et répète l'ensemble du processus pour le mot suivant.
Quand Claude arrête de générer
Après chaque token, Claude vérifie plusieurs conditions pour décider s'il doit continuer :
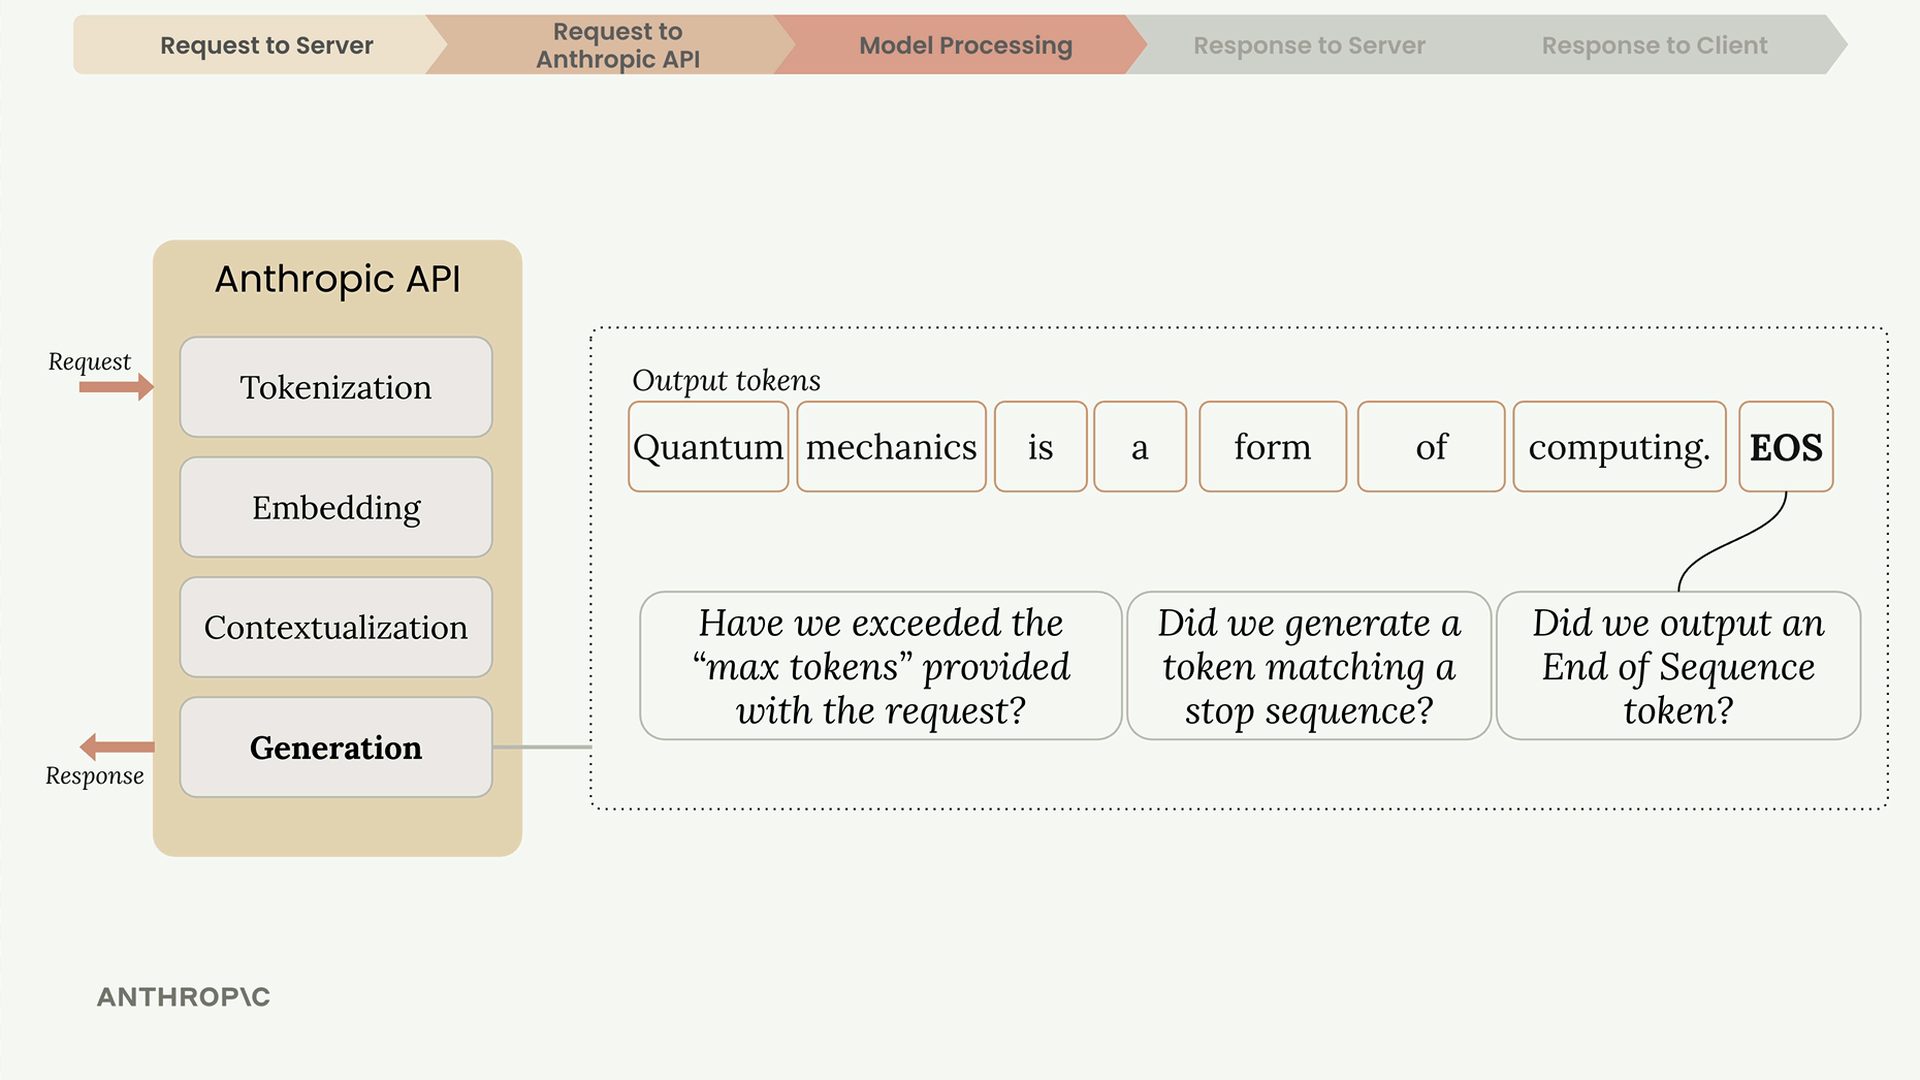
- Max tokens atteint - A-t-il atteint la limite que vous avez spécifiée ?
- Fin naturelle - A-t-il généré un token de fin de séquence ?
- Séquence d'arrêt - A-t-il rencontré une phrase d'arrêt prédéfinie ?
La réponse de l'API
Lorsque la génération est terminée, l'API renvoie une réponse structurée contenant :
- Message - Le texte généré
- Usage - Le nombre de tokens d'entrée et de sortie
- Stop Reason - La raison pour laquelle la génération s'est terminée
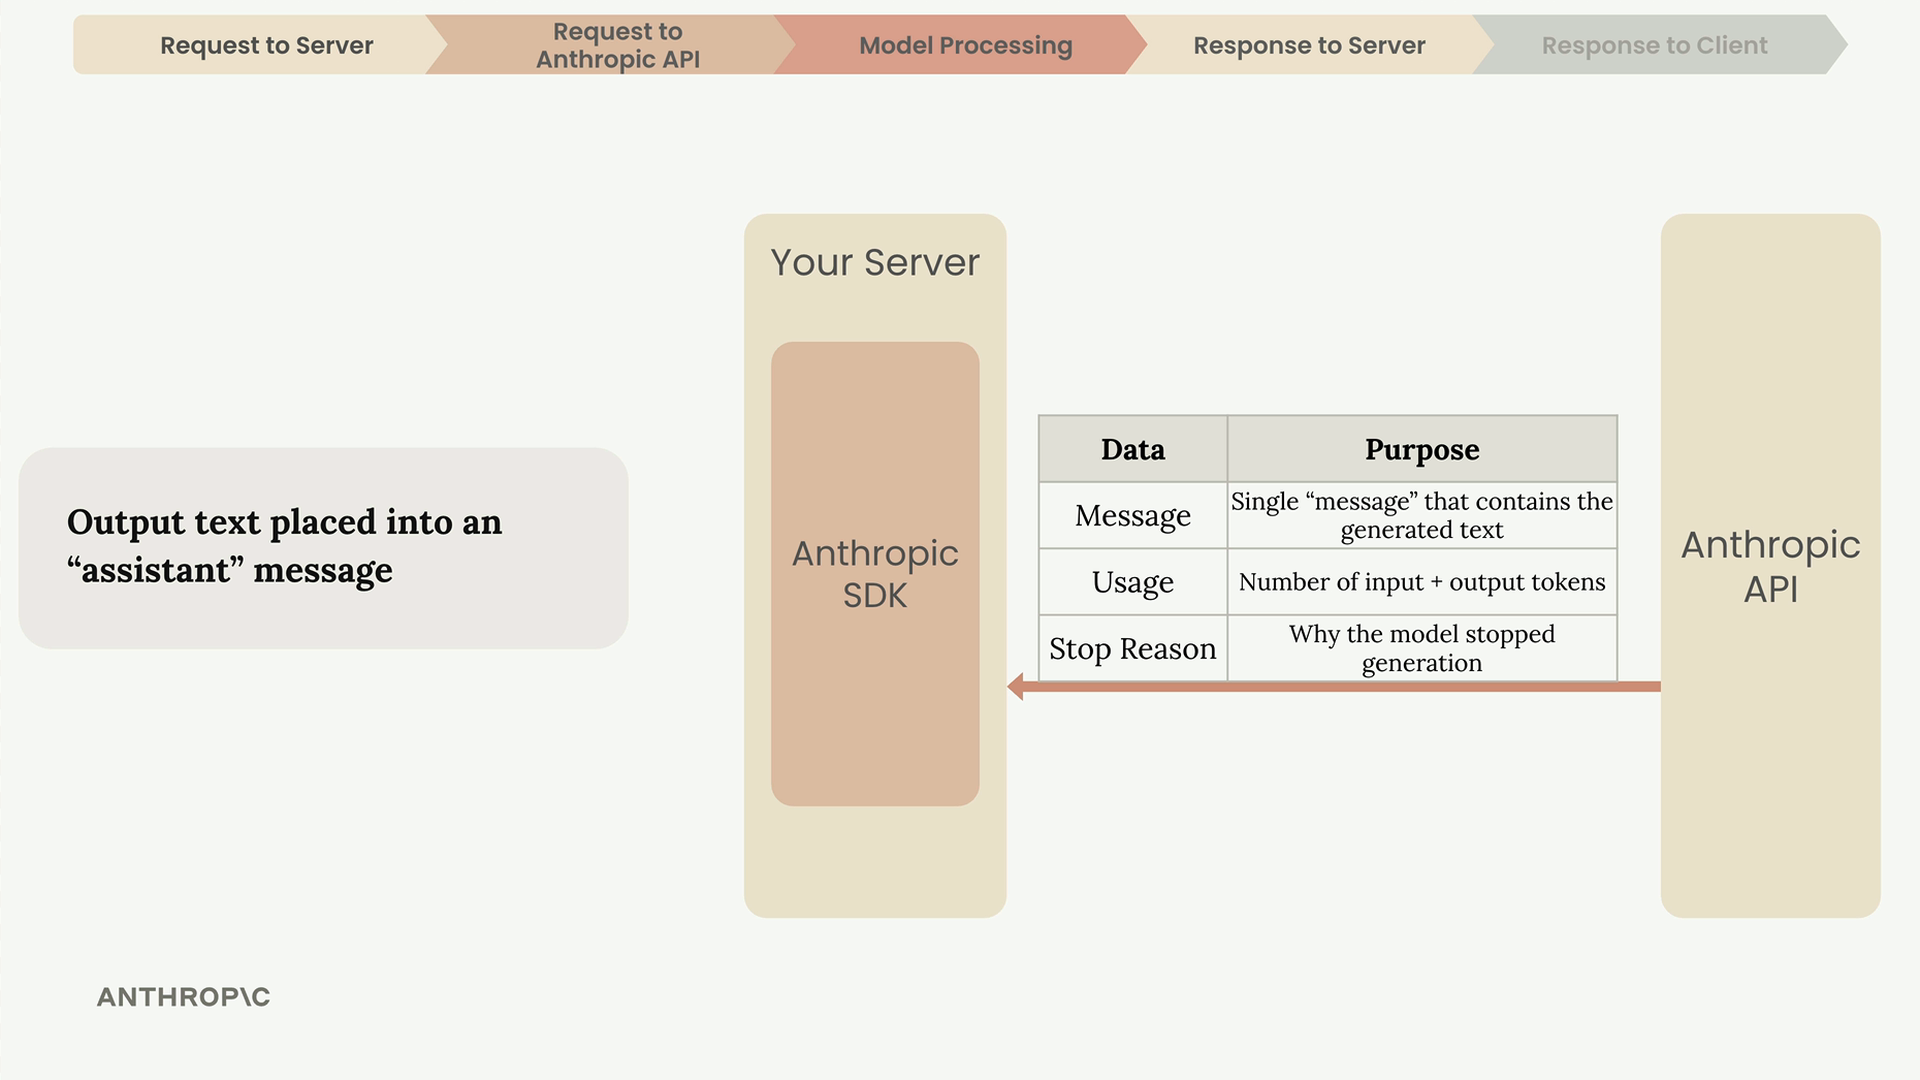
Votre serveur reçoit cette réponse et transmet le texte généré à votre application client, où il apparaît dans l'interface utilisateur.
Points clés à retenir
Comprendre ce flux vous aide à :
- Concevoir des architectures sécurisées qui protègent vos clés API
- Définir des limites de tokens appropriées pour votre cas d'usage
- Gérer différentes raisons d'arrêt dans la logique de votre application
- Déboguer les problèmes en comprenant où ils pourraient survenir dans le pipeline
Ne vous inquiétez pas de mémoriser chaque détail - l'objectif est de vous familiariser avec la terminologie et le processus global que vous rencontrerez en travaillant avec l'API de Claude.