La création d'un flux de travail personnalisé d'évaluation de prompt commence par la création d'un prompt solide, puis par la génération de données de test pour voir à quel point il fonctionne bien. Parcourons ensemble la mise en place d'un système d'évaluation pour un prompt qui aide les utilisateurs à écrire du code spécifique à AWS.
Définir l'objectif
Notre prompt doit aider les utilisateurs à écrire trois types spécifiques de sorties pour des cas d'usage AWS :
- Code Python
- Fichiers de configuration JSON
- Expressions régulières
L'exigence clé est que lorsqu'un utilisateur demande de l'aide pour une tâche, nous renvoyons une sortie propre dans l'un de ces formats, sans explications, en-têtes ou pieds de page supplémentaires.
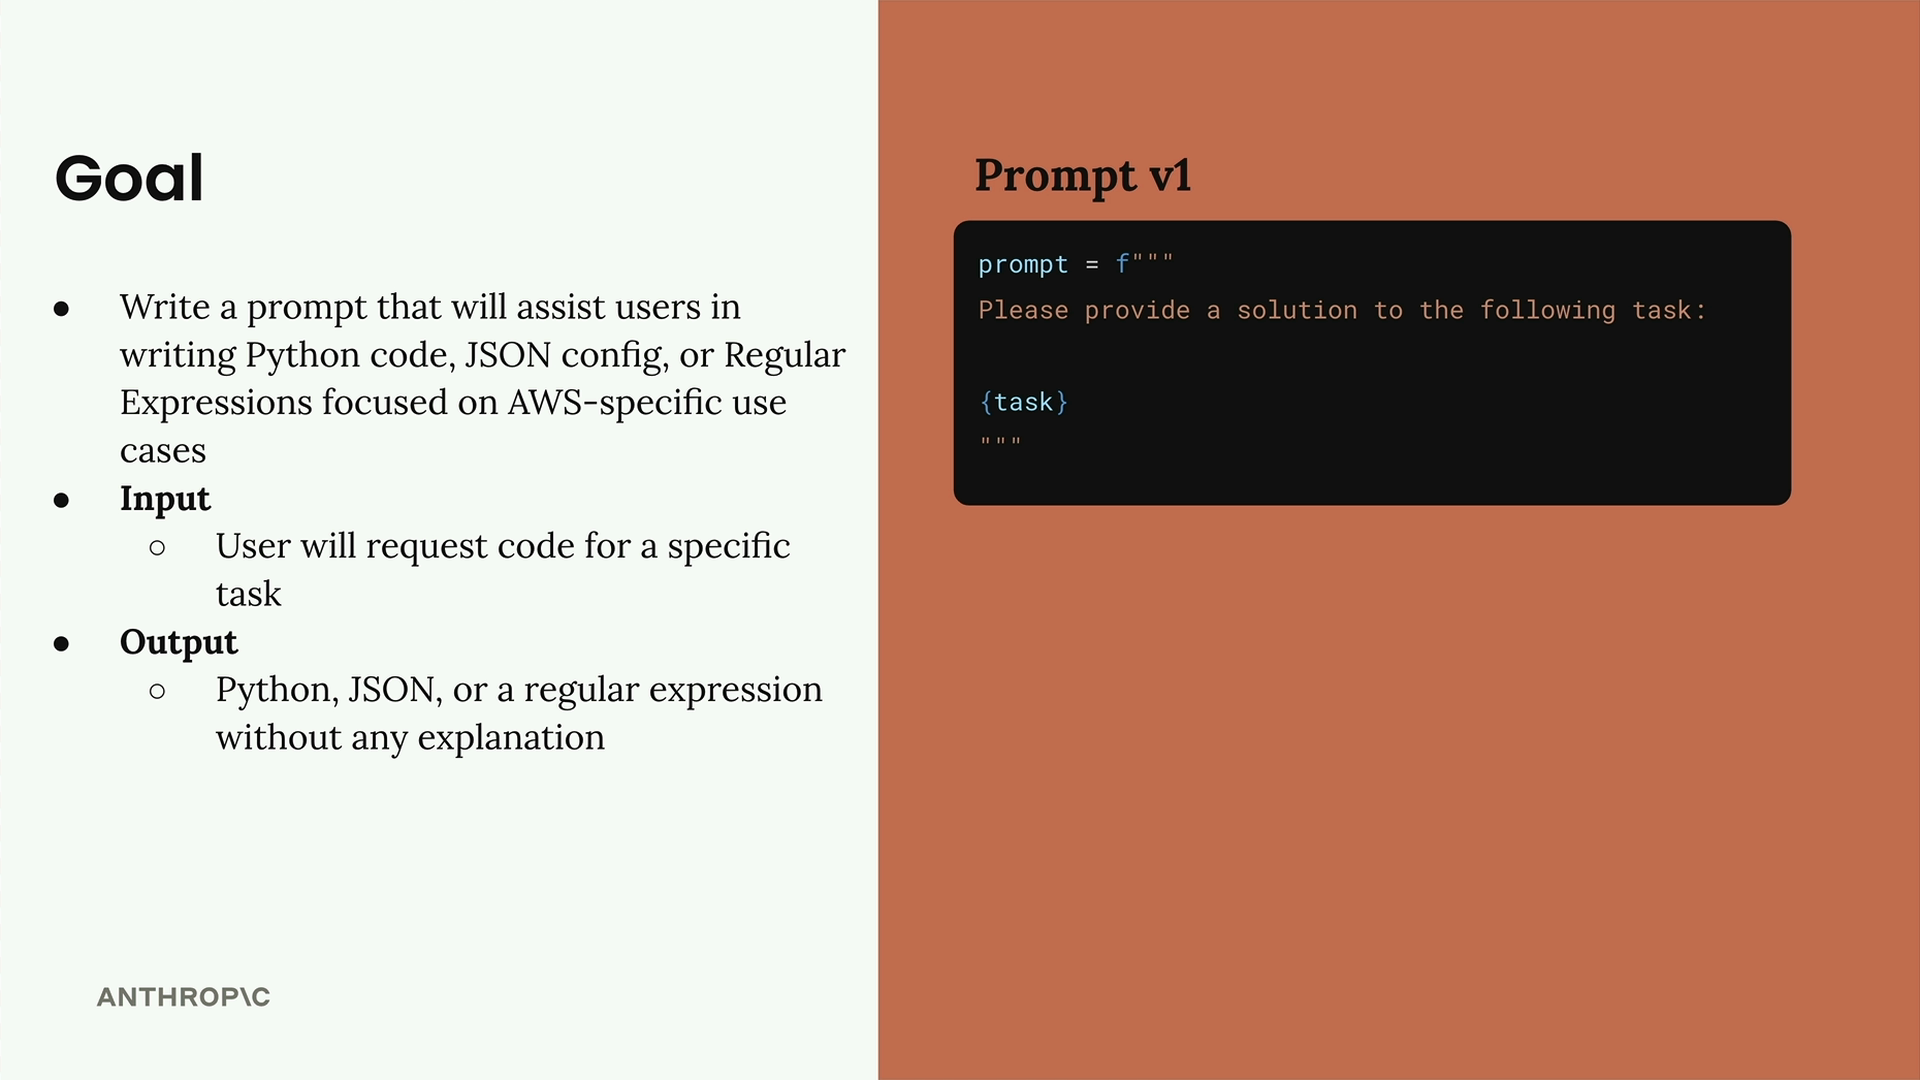
Voici notre prompt de départ (version 1) :
prompt = f"""
Please provide a solution to the following task:
{task}
"""
Créer un jeu de données d'évaluation
Un jeu de données d'évaluation contient des entrées que nous allons fournir à notre prompt. Pour chaque combinaison de prompt et d'entrée, nous exécuterons le prompt et analyserons les résultats.
Notre jeu de données sera un tableau d'objets JSON, où chaque objet contient une propriété « task » décrivant ce que nous voulons que Claude accomplisse. Nous pouvons soit créer ce jeu de données manuellement, soit le générer automatiquement à l'aide de Claude.
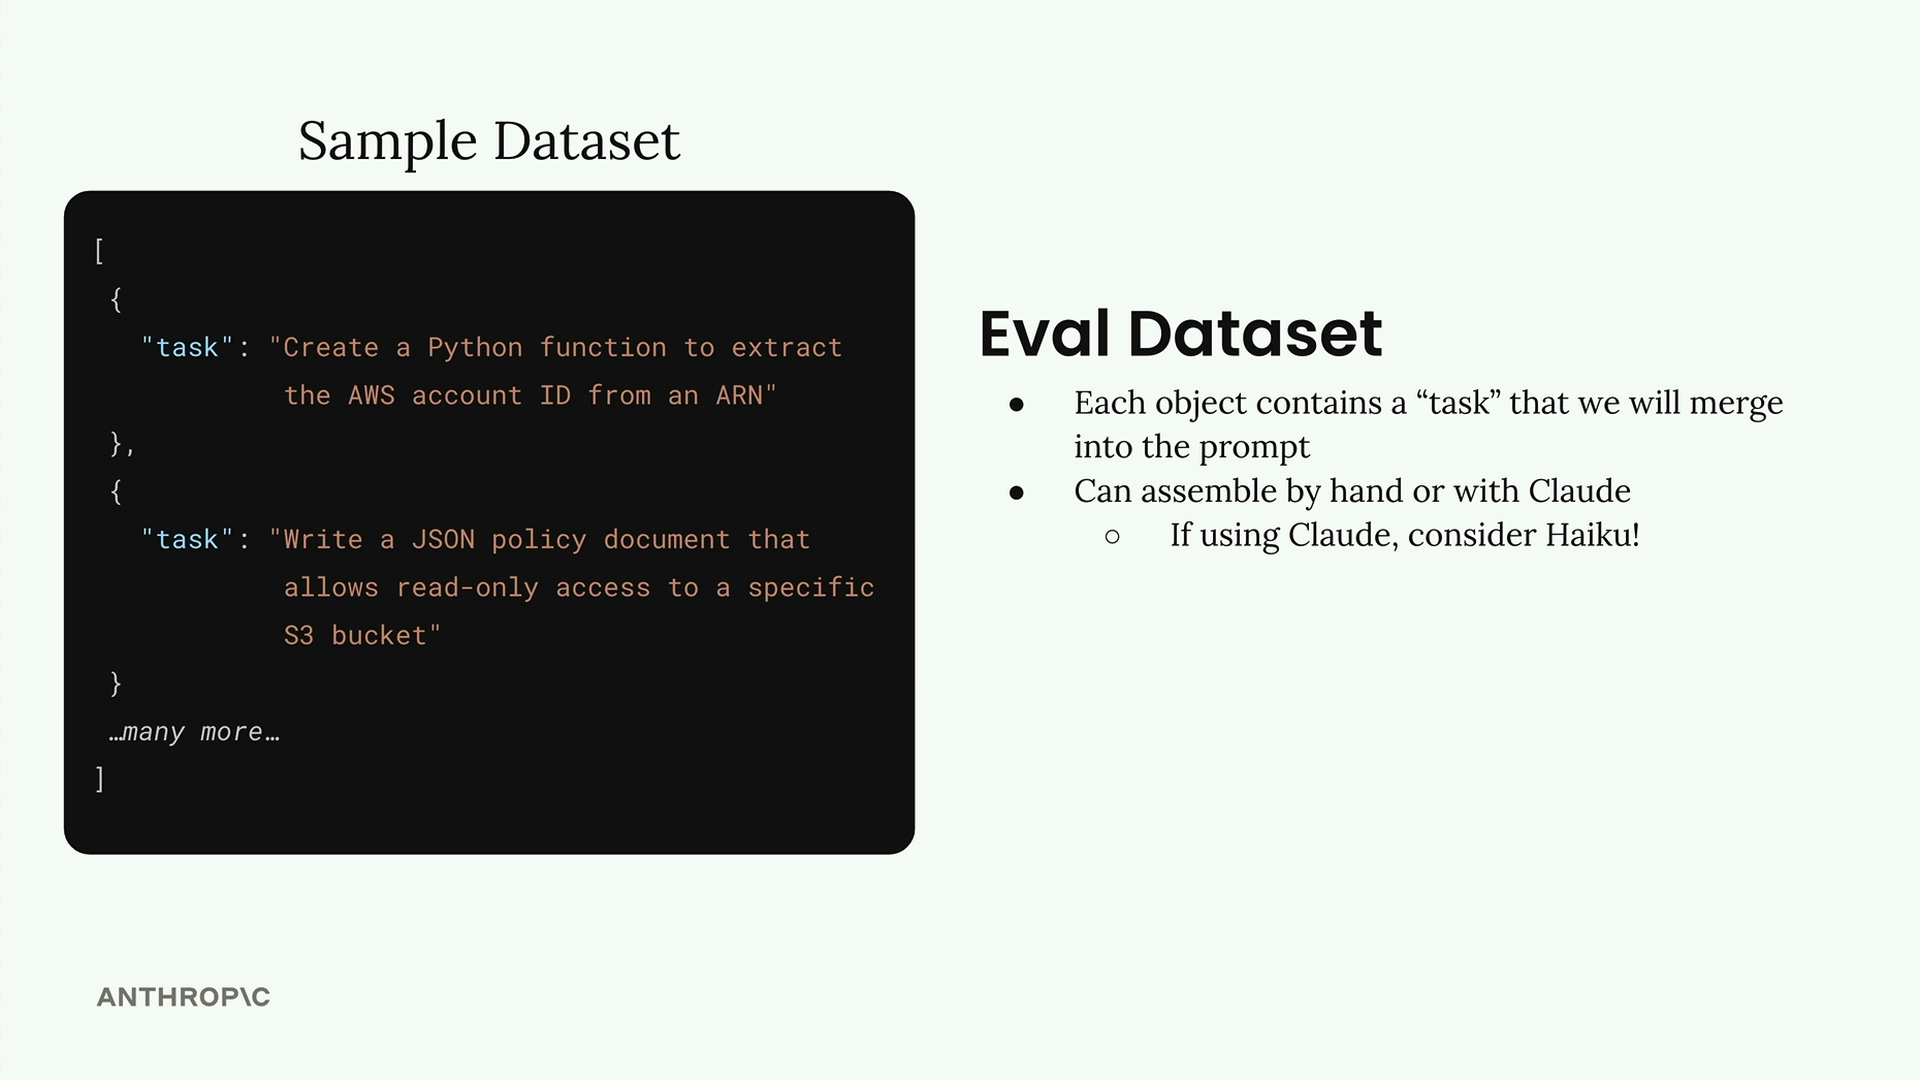
Puisque nous générons des données de test, c'est l'occasion idéale d'utiliser un modèle plus rapide comme Haiku plutôt que le modèle Claude complet.
Générer des données de test avec du code
Créons une fonction qui génère automatiquement notre jeu de données de test. Tout d'abord, nous aurons besoin de nos fonctions d'assistance pour travailler avec Claude :
def add_user_message(messages, text):
    user_message = {"role": "user", "content": text}
    messages.append(user_message)

def add_assistant_message(messages, text):
    assistant_message = {"role": "assistant", "content": text}
    messages.append(assistant_message)

def chat(messages, system=None, temperature=1.0, stop_sequences=[]):
    params = {
        "model": model,
        "max_tokens": 1000,
        "messages": messages,
        "temperature": temperature
    }
    if system:
        params["system"] = system
    if stop_sequences:
        params["stop_sequences"] = stop_sequences

    response = client.messages.create(**params)
    return response.content[0].text
Maintenant, nous allons créer notre fonction de génération de jeu de données :
def generate_dataset():
    prompt = """
Generate an evaluation dataset for a prompt evaluation. The dataset will be used to evaluate prompts that generate Python, JSON, or Regex specifically for AWS-related tasks. Generate an array of JSON objects, each representing task that requires Python, JSON, or a Regex to complete.

Example output:
```json
[
  \{
    "task": "Description of task",
  \},
  ...additional
]
```

* Focus on tasks that can be solved by writing a single Python function, a single JSON object, or a single regex
* Focus on tasks that do not require writing much code

Please generate 3 objects.
"""
Pour analyser correctement la réponse JSON, nous utiliserons le préremplissage et les séquences d'arrêt :
    messages = []
    add_user_message(messages, prompt)
    add_assistant_message(messages, "```json")
    text = chat(messages, stop_sequences=["```"])
    return json.loads(text)
Tester la génération du jeu de données
Exécutons notre fonction et voyons quel type de cas de test nous obtenons :
dataset = generate_dataset()
print(dataset)
Cela devrait renvoyer trois cas de test différents couvrant nos sorties cibles - fonctions Python, configurations JSON et expressions régulières pour des tâches spécifiques à AWS.
Enregistrer le jeu de données
Une fois que nous avons notre jeu de données, nous l'enregistrerons dans un fichier afin de pouvoir le charger facilement plus tard lors de l'évaluation :
with open('dataset.json', 'w') as f:
    json.dump(dataset, f, indent=2)
Cela crée un fichier dataset.json dans le même répertoire que votre notebook, contenant votre liste de tâches prêtes pour l'évaluation de prompt.
Avec cette base en place, vous disposez désormais d'un moyen systématique de générer des données de test pour évaluer la performance de vos prompts sur différents types de tâches de codage liées à AWS.