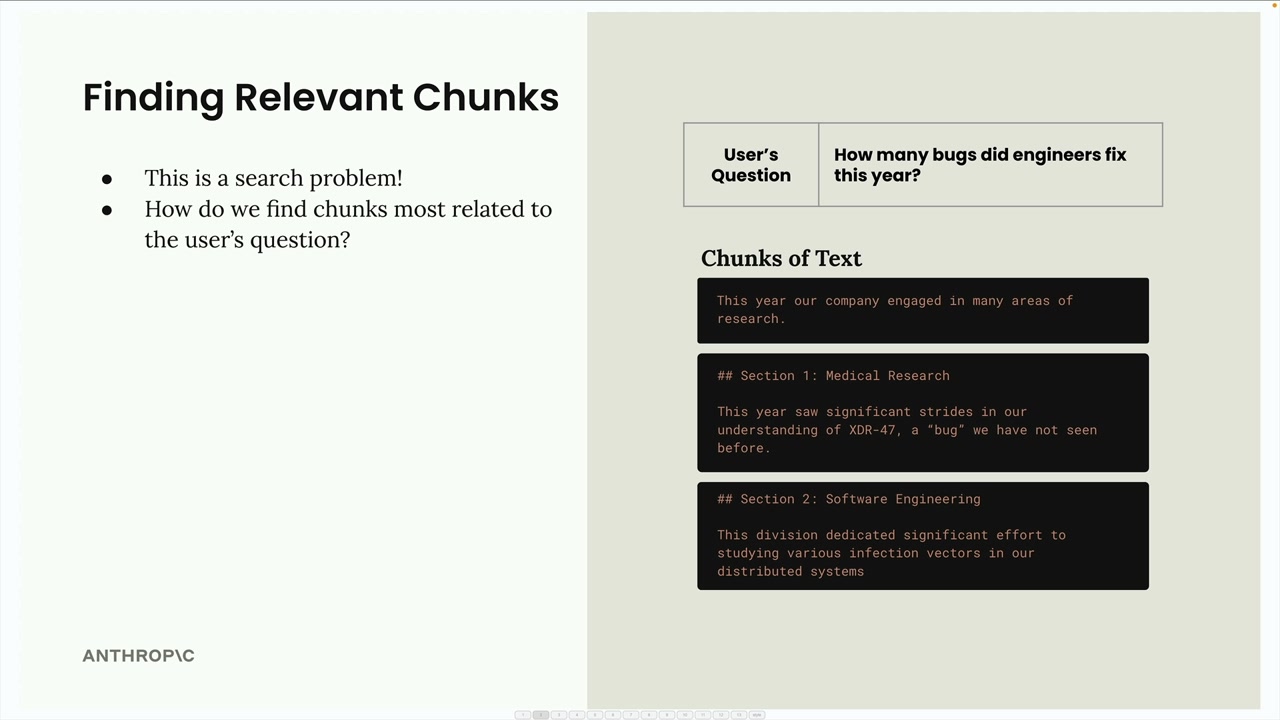
Nachdem ein Dokument in Chunks aufgeteilt wurde, besteht der nächste Schritt in einer RAG-Pipeline darin, herauszufinden, welche Chunks für die Frage eines Nutzers am relevantesten sind. Dies ist im Wesentlichen ein Suchproblem – du musst alle deine Text-Chunks durchsuchen und diejenigen identifizieren, die sich auf das beziehen, wonach der Nutzer fragt.
Semantische Suche
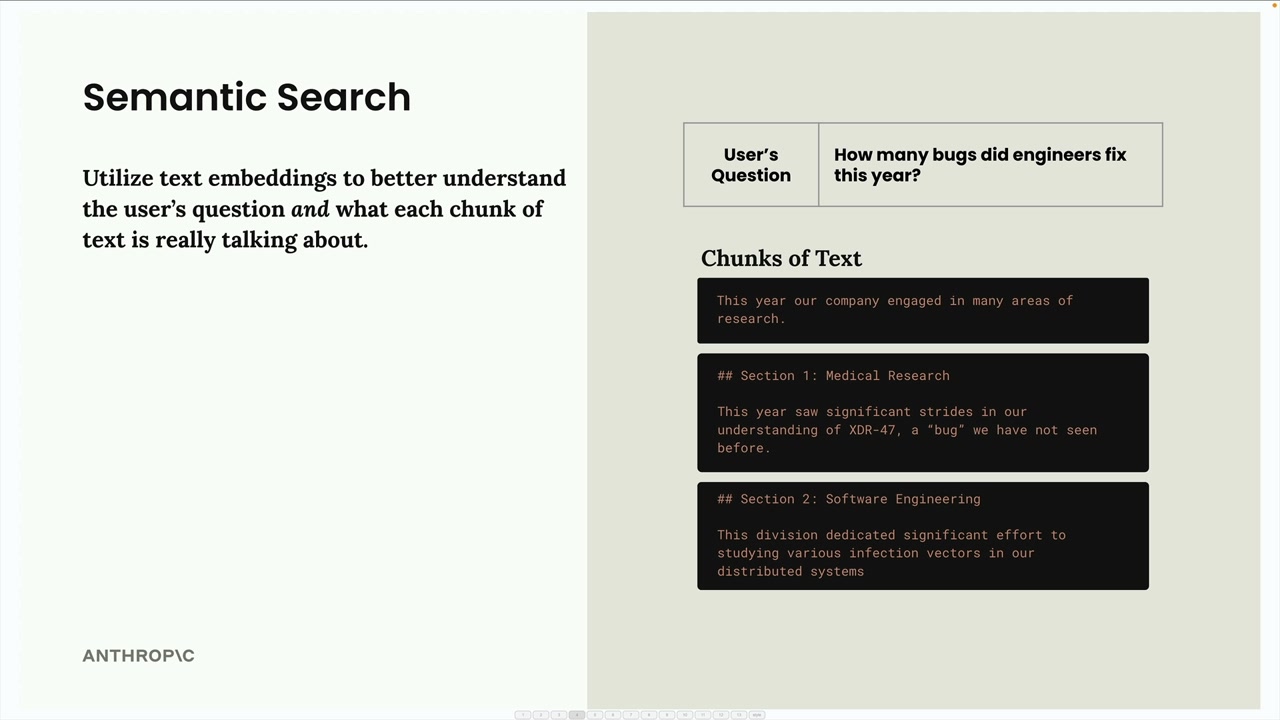
Der gängigste Ansatz zum Finden relevanter Chunks ist die semantische Suche. Im Gegensatz zur schlüsselwortbasierten Suche, die nach exakten Wortübereinstimmungen sucht, verwendet die semantische Suche Text-Embeddings, um die Bedeutung und den Kontext sowohl der Frage des Nutzers als auch jedes Text-Chunks zu verstehen.
Text-Embeddings
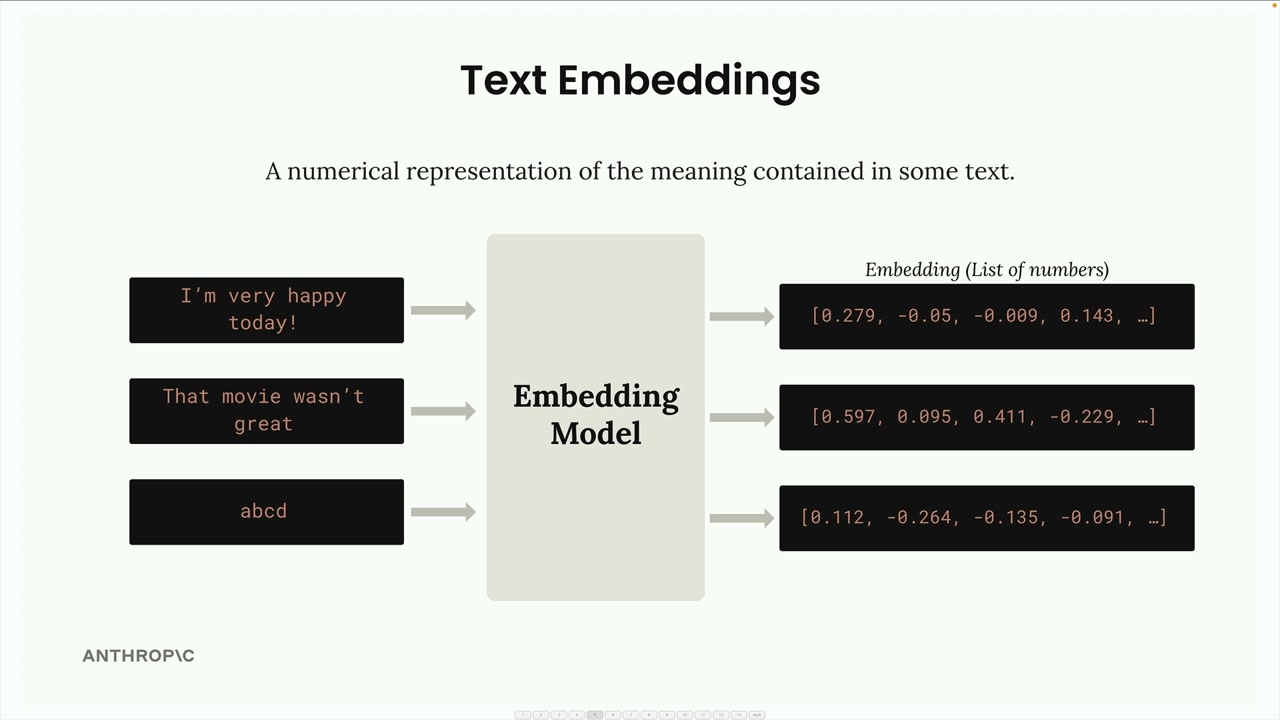
Ein Text-Embedding ist eine numerische Darstellung der Bedeutung, die in einem Text enthalten ist. Stell es dir als Umwandlung von Wörtern und Sätzen in ein Format vor, mit dem Computer mathematisch arbeiten können.
So funktioniert der Prozess:
- Du gibst Text in ein Embedding-Modell ein
- Das Modell gibt eine lange Liste von Zahlen aus (das Embedding)
- Jede Zahl liegt im Bereich von -1 bis +1
- Diese Zahlen repräsentieren verschiedene Eigenschaften oder Merkmale des Eingabetexts
Die Zahlen verstehen
Jede Zahl in einem Embedding ist im Wesentlichen ein „Score" für eine bestimmte Eigenschaft des Eingabetexts. Hier ist jedoch der wichtige Vorbehalt: Wir wissen nicht genau, was jede Zahl repräsentiert.
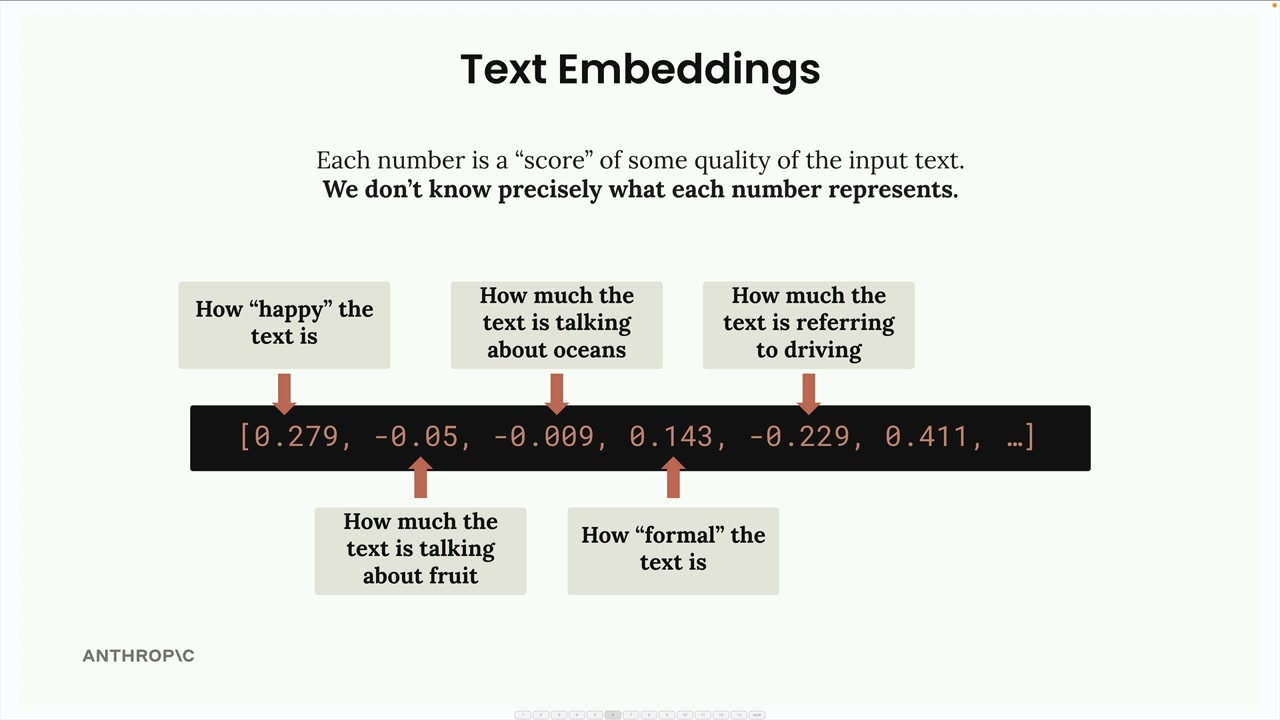
Es ist zwar hilfreich, sich vorzustellen, dass eine Zahl repräsentieren könnte, „wie fröhlich der Text ist" oder „wie viel der Text über Ozeane spricht", aber das sind nur konzeptionelle Beispiele. Die tatsächliche Bedeutung jeder Dimension wird vom Modell während des Trainings erlernt und ist für Menschen nicht direkt interpretierbar.
VoyageAI für Embeddings
Da Anthropic derzeit keine Embedding-Generierung anbietet, ist der empfohlene Anbieter VoyageAI. Du musst:
- Dich für ein separates VoyageAI-Konto anmelden
- Einen API-Key besorgen (kostenloser Einstieg möglich)
- Den Key zu deinen Umgebungsvariablen hinzufügen
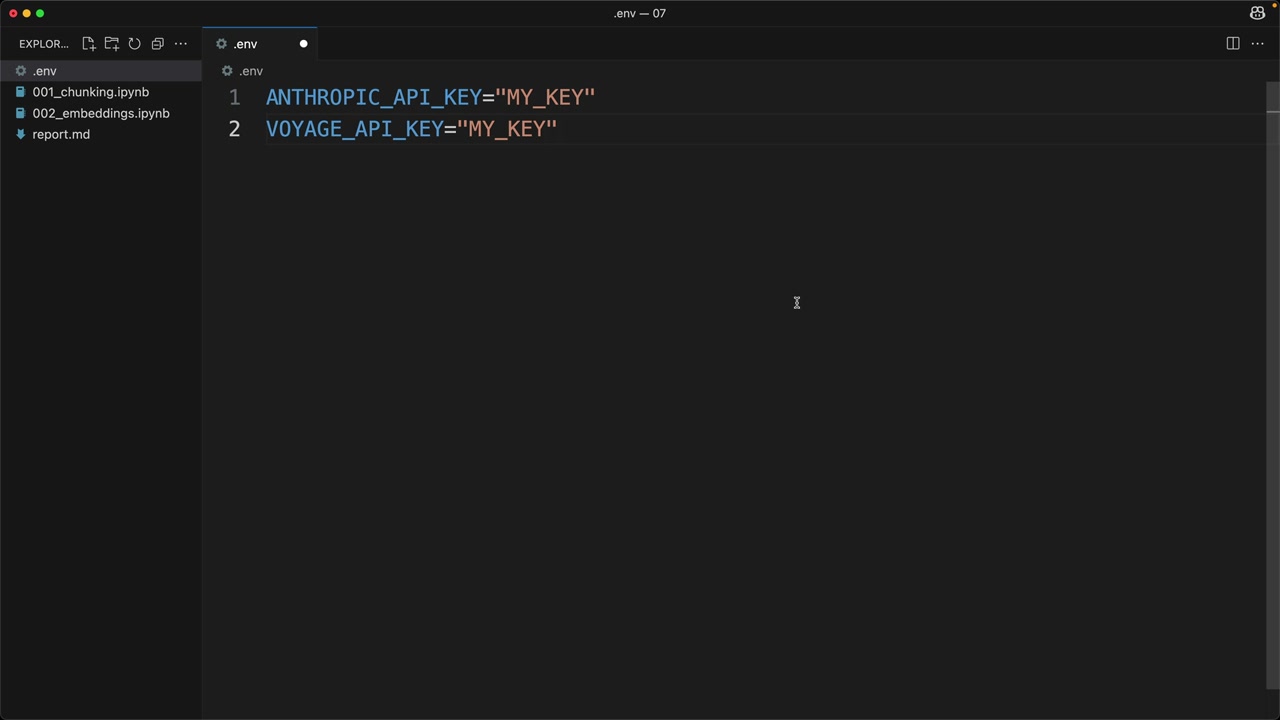
Füge in deiner .env-Datei Folgendes hinzu:
VOYAGE_API_KEY="your_key_here"Implementierung
Installiere zunächst die VoyageAI-Bibliothek:
%pip install voyageaiRichte dann den Client ein und erstelle eine Funktion zum Generieren von Embeddings:
from dotenv import load_dotenv
import voyageai

load_dotenv()
client = voyageai.Client()

def generate_embedding(text, model="voyage-3-large", input_type="query"):
    result = client.embed([text], model=model, input_type=input_type)
    return result.embeddings[0]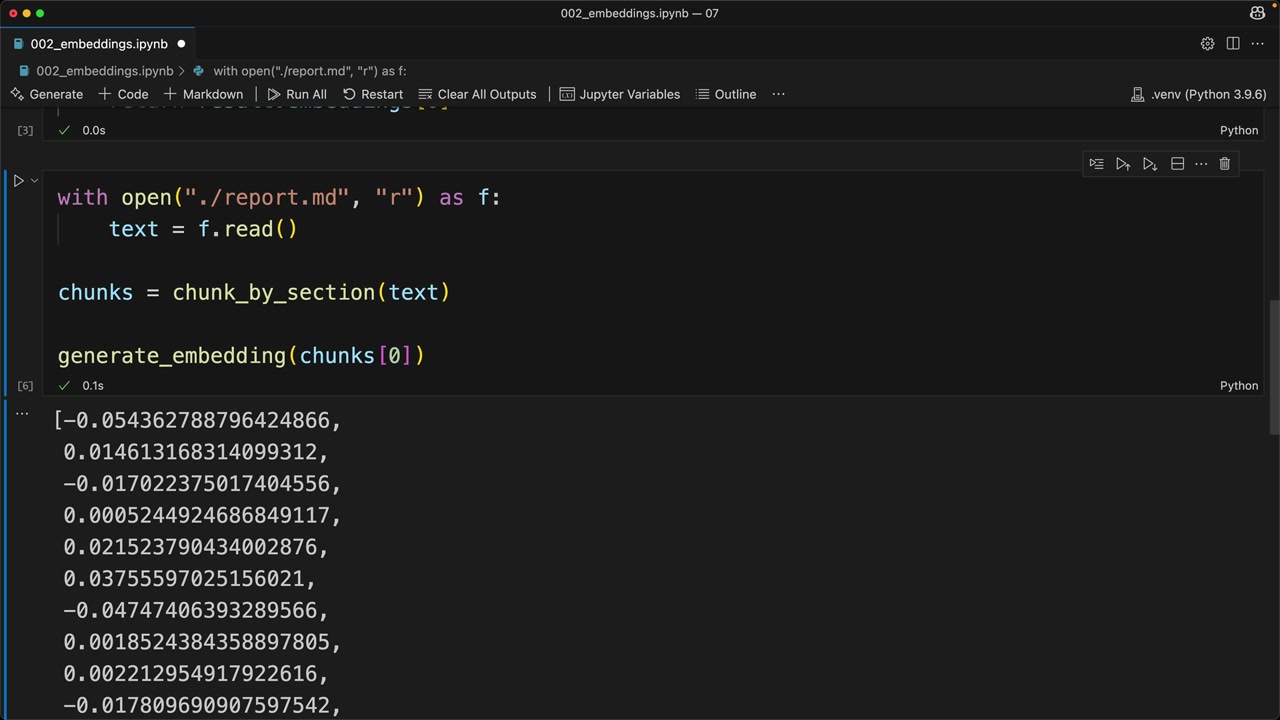
Wenn du diese Funktion auf einen Text-Chunk anwendest, erhältst du eine Liste von Gleitkommazahlen zurück, die das Embedding repräsentieren. Der Prozess ist schnell und unkompliziert – die eigentliche Herausforderung besteht darin zu verstehen, wie man diese Embeddings effektiv in deiner RAG-Pipeline nutzt, um die relevantesten Inhalte zu finden.
Der nächste Schritt besteht darin zu lernen, wie man Embeddings vergleicht, um zu bestimmen, welche Chunks der Frage eines Nutzers am ähnlichsten sind, was den Kern des semantischen Suchprozesses bildet.