Nachdem wir den RAG-Flow nun konzeptionell verstanden haben, lass uns ihn Schritt für Schritt implementieren. Wir gehen ein vollständiges Beispiel durch, das zeigt, wie man Text in Abschnitte unterteilt, Embeddings generiert, sie in einer Vektordatenbank speichert und Ähnlichkeitssuchen durchführt.
Die fünfstufige RAG-Implementierung
Unsere Implementierung folgt denselben fünf Schritten, die wir zuvor besprochen haben:
- Den Text nach Abschnitt in Chunks unterteilen
- Embeddings für jeden Chunk generieren
- Einen Vektorspeicher erstellen und jedes Embedding hinzufügen
- Ein Embedding für die Frage des Nutzers generieren
- Den Speicher durchsuchen, um die relevantesten Chunks zu finden
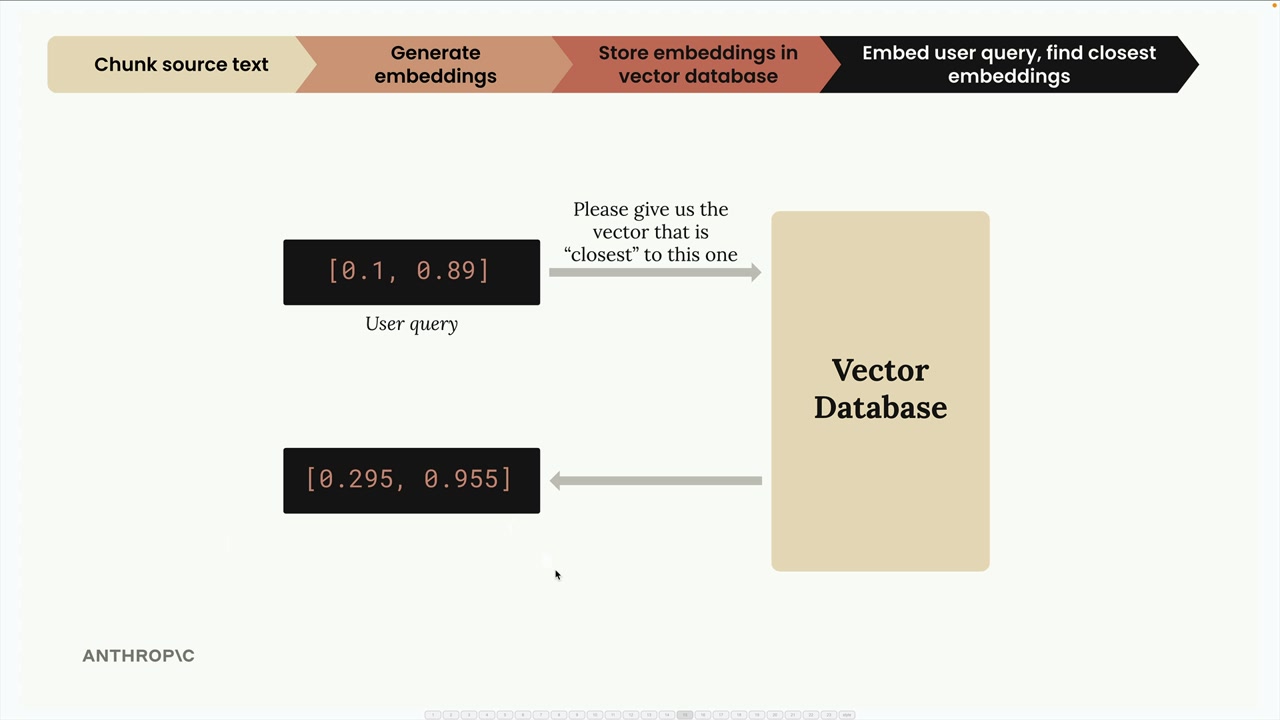
Dieses Diagramm zeigt, wie wir Nutzeranfragen in Embeddings umwandeln und unsere Vektordatenbank durchsuchen, um die relevantesten Inhalte zu finden.
Schritt 1: Den Text in Chunks unterteilen
Zuerst laden wir unser Dokument und teilen es in überschaubare Abschnitte auf:
with open("./report.md", "r") as f:
    text = f.read()

chunks = chunk_by_section(text)
chunks[2]  # Test to see the table of contents
Wir verwenden dieselbe Funktion chunk_by_section wie zuvor, um unser Dokument in logische Abschnitte zu unterteilen.
Schritt 2: Embeddings generieren
Als Nächstes erstellen wir Embeddings für alle unsere Chunks auf einmal:
embeddings = generate_embedding(chunks)Die Embedding-Funktion wurde aktualisiert, um sowohl einzelne Strings als auch Listen von Strings zu verarbeiten, was sie für die Batch-Verarbeitung effizienter macht.
Schritt 3: In der Vektordatenbank speichern
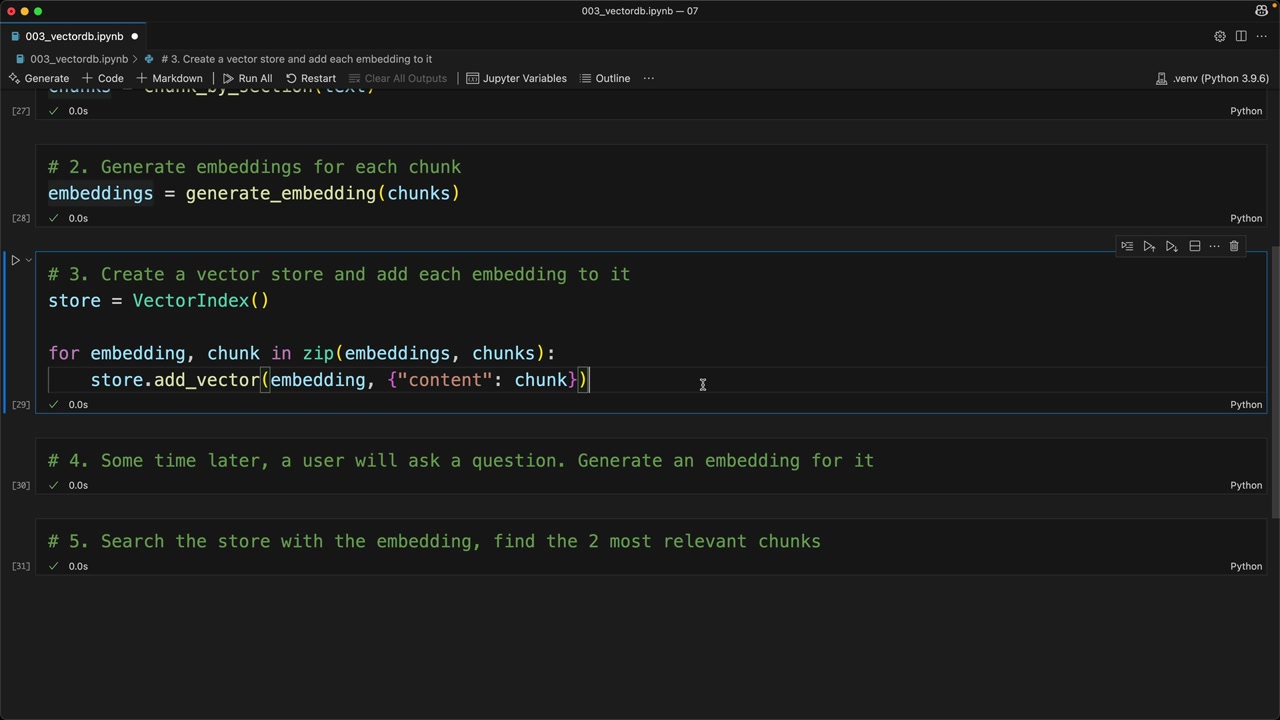
Jetzt erstellen wir unseren Vektorspeicher und befüllen ihn mit Embeddings und dem zugehörigen Text:
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
Beachte, dass wir sowohl das Embedding als auch den ursprünglichen Textinhalt speichern. Das ist entscheidend, denn wenn wir später suchen, müssen wir den tatsächlichen Text zurückgeben, nicht nur die numerischen Embedding-Werte.
Warum den ursprünglichen Text speichern?
Wenn wir unsere Vektordatenbank abfragen, ist es nicht nützlich, nur die Embedding-Zahlen zurückzubekommen. Wir brauchen den tatsächlichen Text, der zur Generierung dieser Embeddings verwendet wurde. Deshalb fügen wir den ursprünglichen Chunk-Text (oder zumindest einen Verweis darauf) zusammen mit jedem Embedding in unserer Datenbank hinzu.
Schritt 4: Nutzeranfragen verarbeiten
Wenn ein Nutzer eine Frage stellt, generieren wir ein Embedding für seine Anfrage:
user_embedding = generate_embedding("What did the software engineering dept do last year?")Schritt 5: Relevante Inhalte finden
Schließlich durchsuchen wir unseren Vektorspeicher, um die ähnlichsten Chunks zu finden:
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
Diese Suche liefert die zwei relevantesten Chunks zusammen mit ihren Ähnlichkeitswerten (Kosinus-Distanzen).
Die Suchergebnisse zeigen uns, welche Abschnitte unseres Dokuments für die Frage des Nutzers am relevantesten sind, zusammen mit Ähnlichkeitswerten.
Die Ergebnisse verstehen
Wenn wir unsere Beispielanfrage zur Softwareentwicklungsabteilung ausführen, erhalten wir:
- Abschnitt 2: Softwareentwicklung mit einer Distanz von 0,71 (engste Übereinstimmung)
- Methodik-Abschnitt mit einer Distanz von 0,72 (zweitengste Übereinstimmung)
Niedrigere Distanzwerte zeigen eine höhere Ähnlichkeit an, daher ist Abschnitt 2 am relevantesten für unsere Anfrage.
Wie geht es weiter?
Diese Implementierung funktioniert gut für grundlegende Fälle, aber es gibt Szenarien, in denen sie nicht wie erwartet funktioniert. In den nächsten Abschnitten werden wir Verbesserungen untersuchen, um unser RAG-System robuster und genauer zu machen.
Die wichtigste Erkenntnis ist, dass es bei RAG grundsätzlich darum geht, Text in Zahlen (Embeddings) umzuwandeln, diese Zahlen effizient zu speichern und dann mathematische Ähnlichkeit zu nutzen, um relevante Inhalte zu finden, wenn Nutzer Fragen stellen.