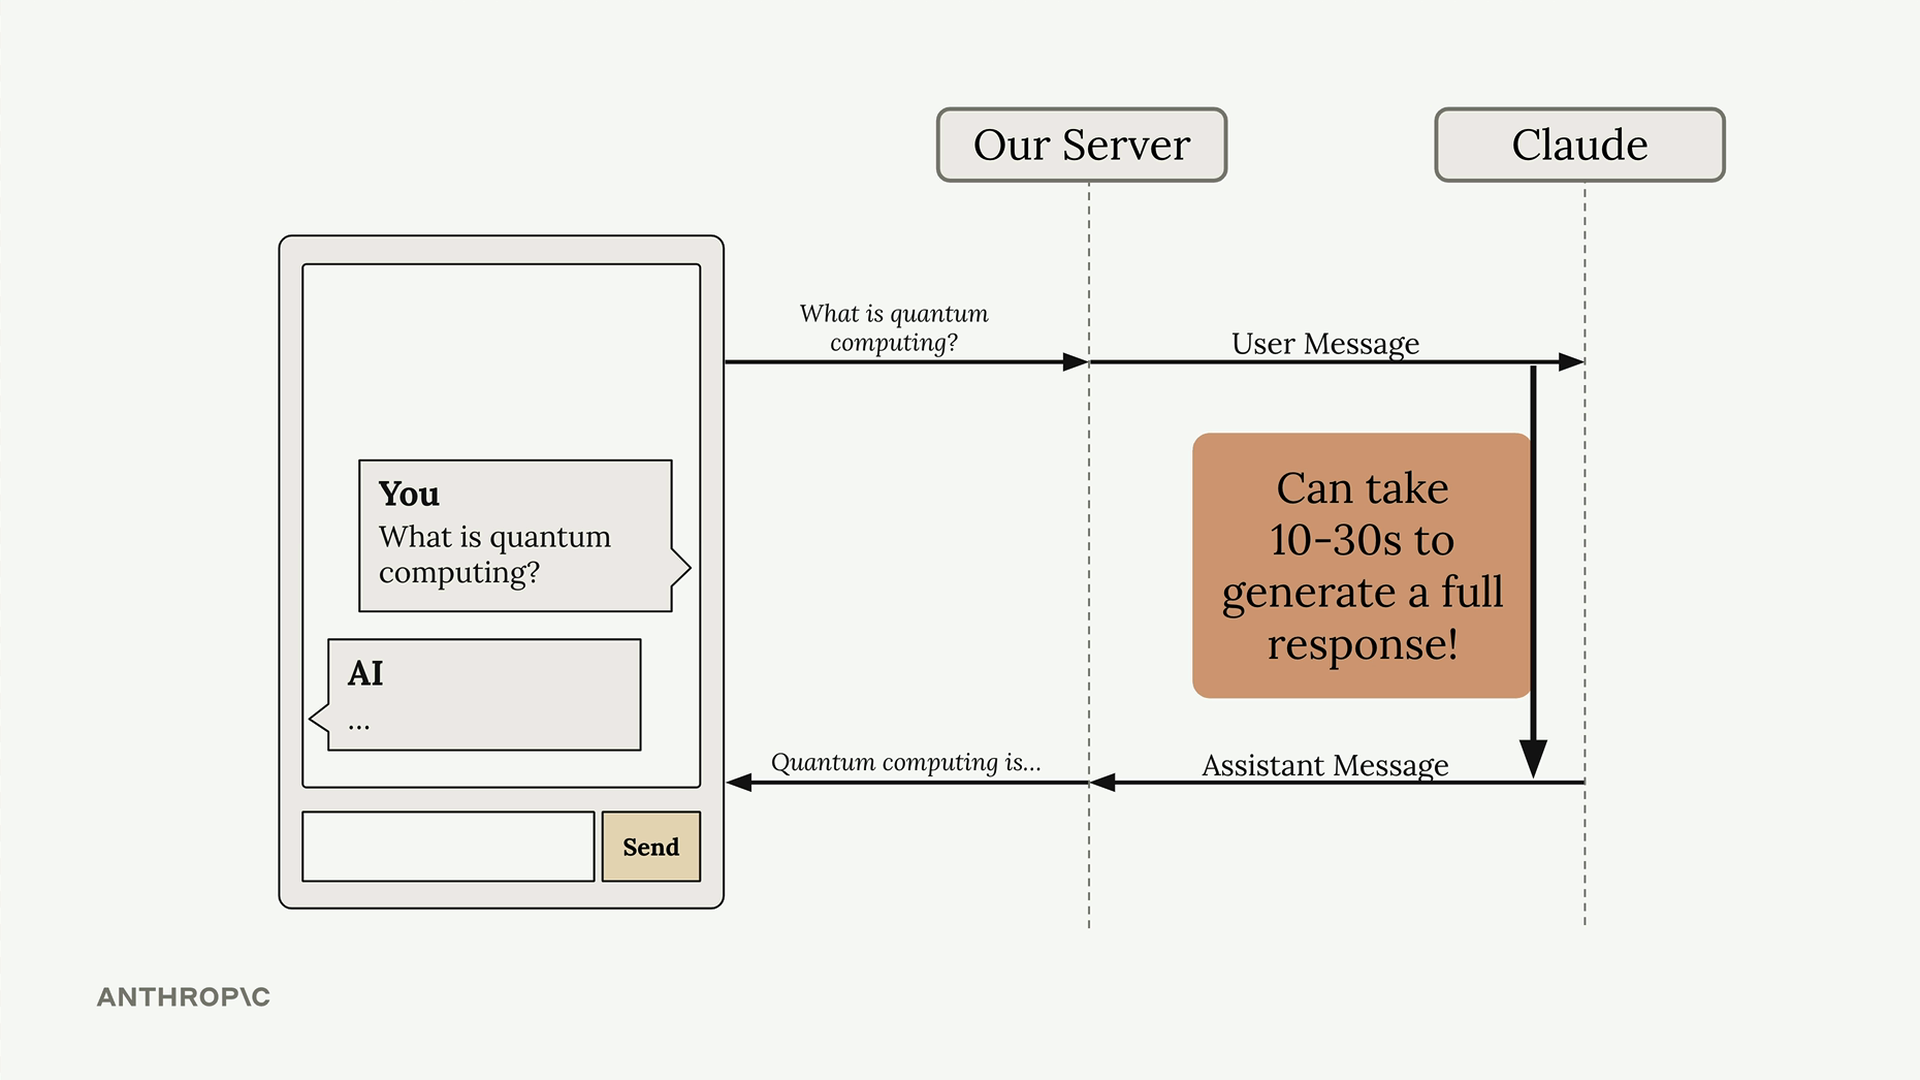
Beim Erstellen von Chat-Anwendungen mit Claude gibt es eine erhebliche Herausforderung für die Nutzererfahrung: Antworten können 10-30 Sekunden zur Generierung benötigen, wodurch Nutzer auf einen Ladekreis starren. Die Lösung ist Response-Streaming, das es Nutzern ermöglicht, Text Stück für Stück zu sehen, während Claude ihn generiert, was ein deutlich reaktionsschnelleres Gefühl erzeugt.
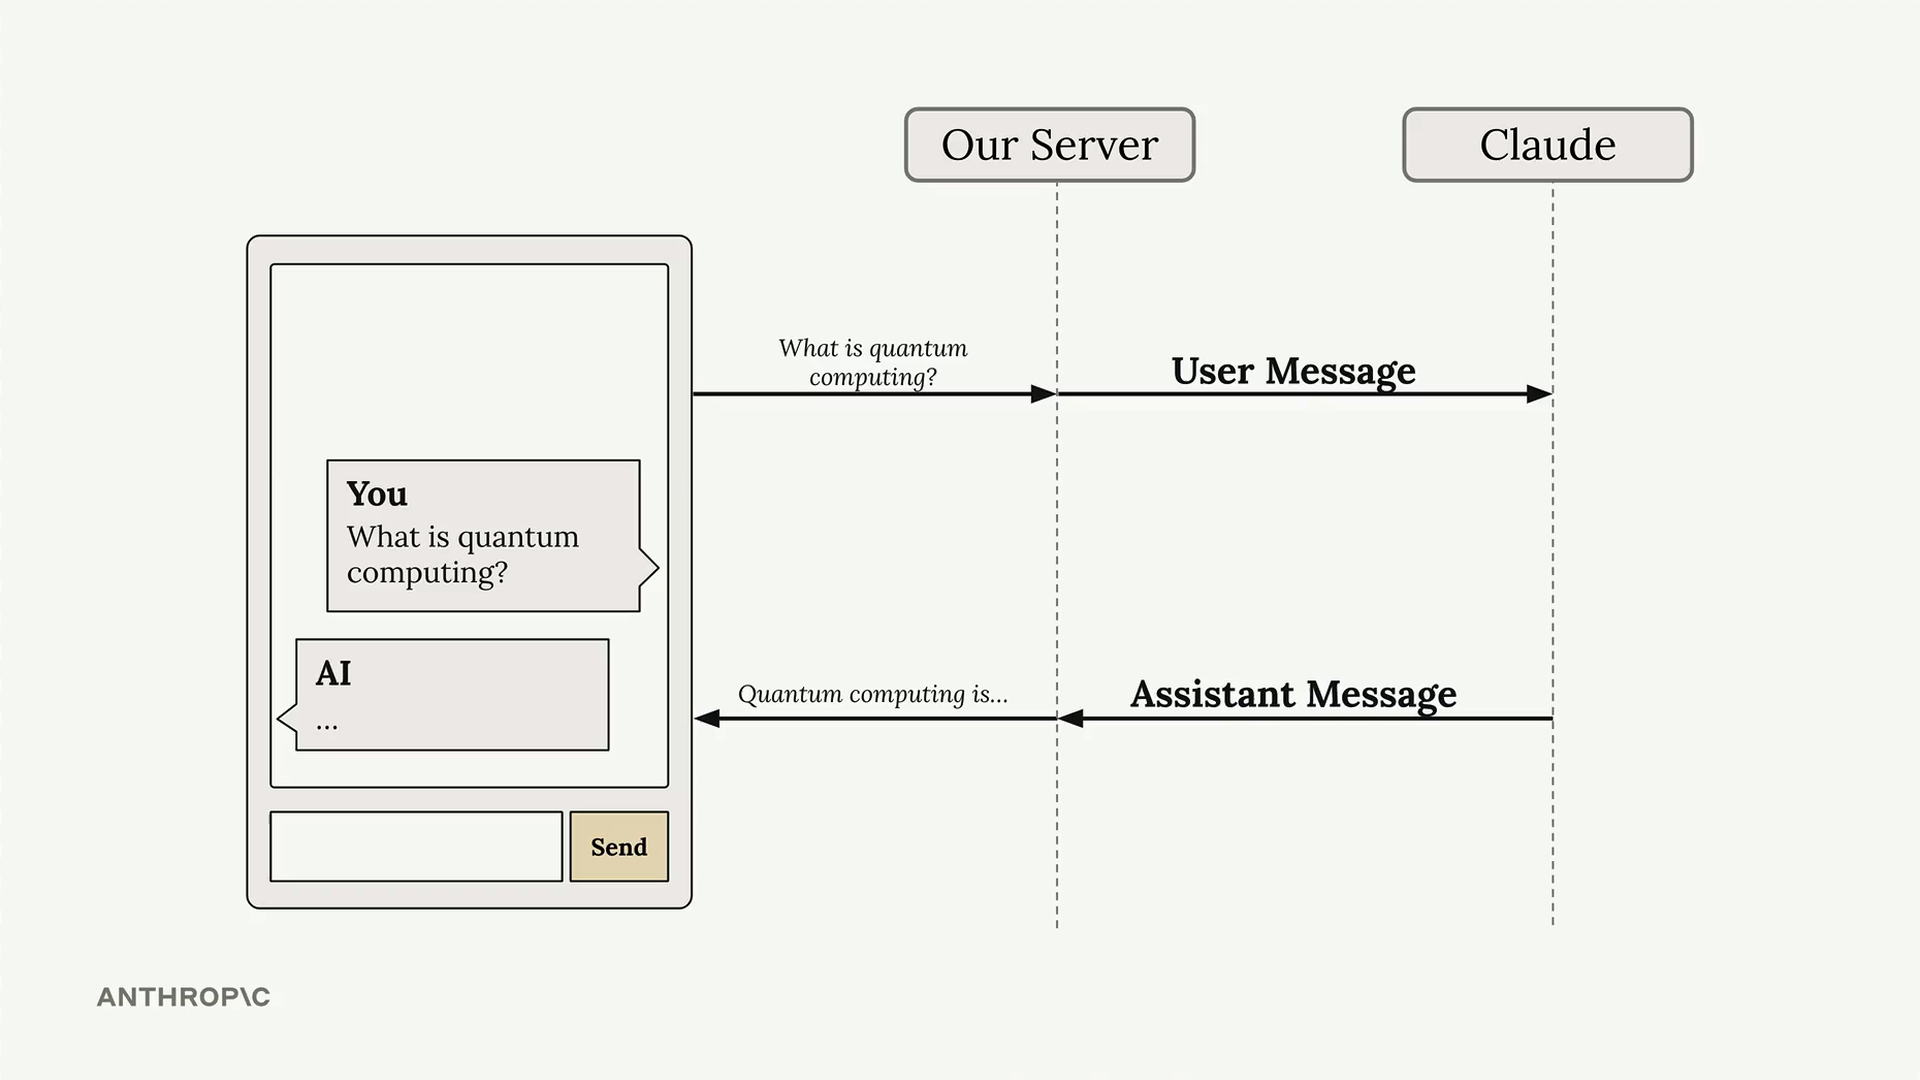
Das Problem mit Standardantworten
In einem typischen Chat-Setup sendet dein Server eine Nutzernachricht an Claude und wartet auf die vollständige Antwort, bevor er etwas an den Client zurücksendet. Dies erzeugt eine unangenehme Verzögerung, bei der Nutzer keine Rückmeldung haben, dass überhaupt etwas passiert.
Wie Streaming funktioniert
Mit aktiviertem Streaming sendet Claude sofort eine erste Antwort zurück, die anzeigt, dass deine Anfrage empfangen wurde und die Textgenerierung beginnt. Anschließend erhältst du eine Reihe von Events, die jeweils ein kleines Stück der Gesamtantwort enthalten.
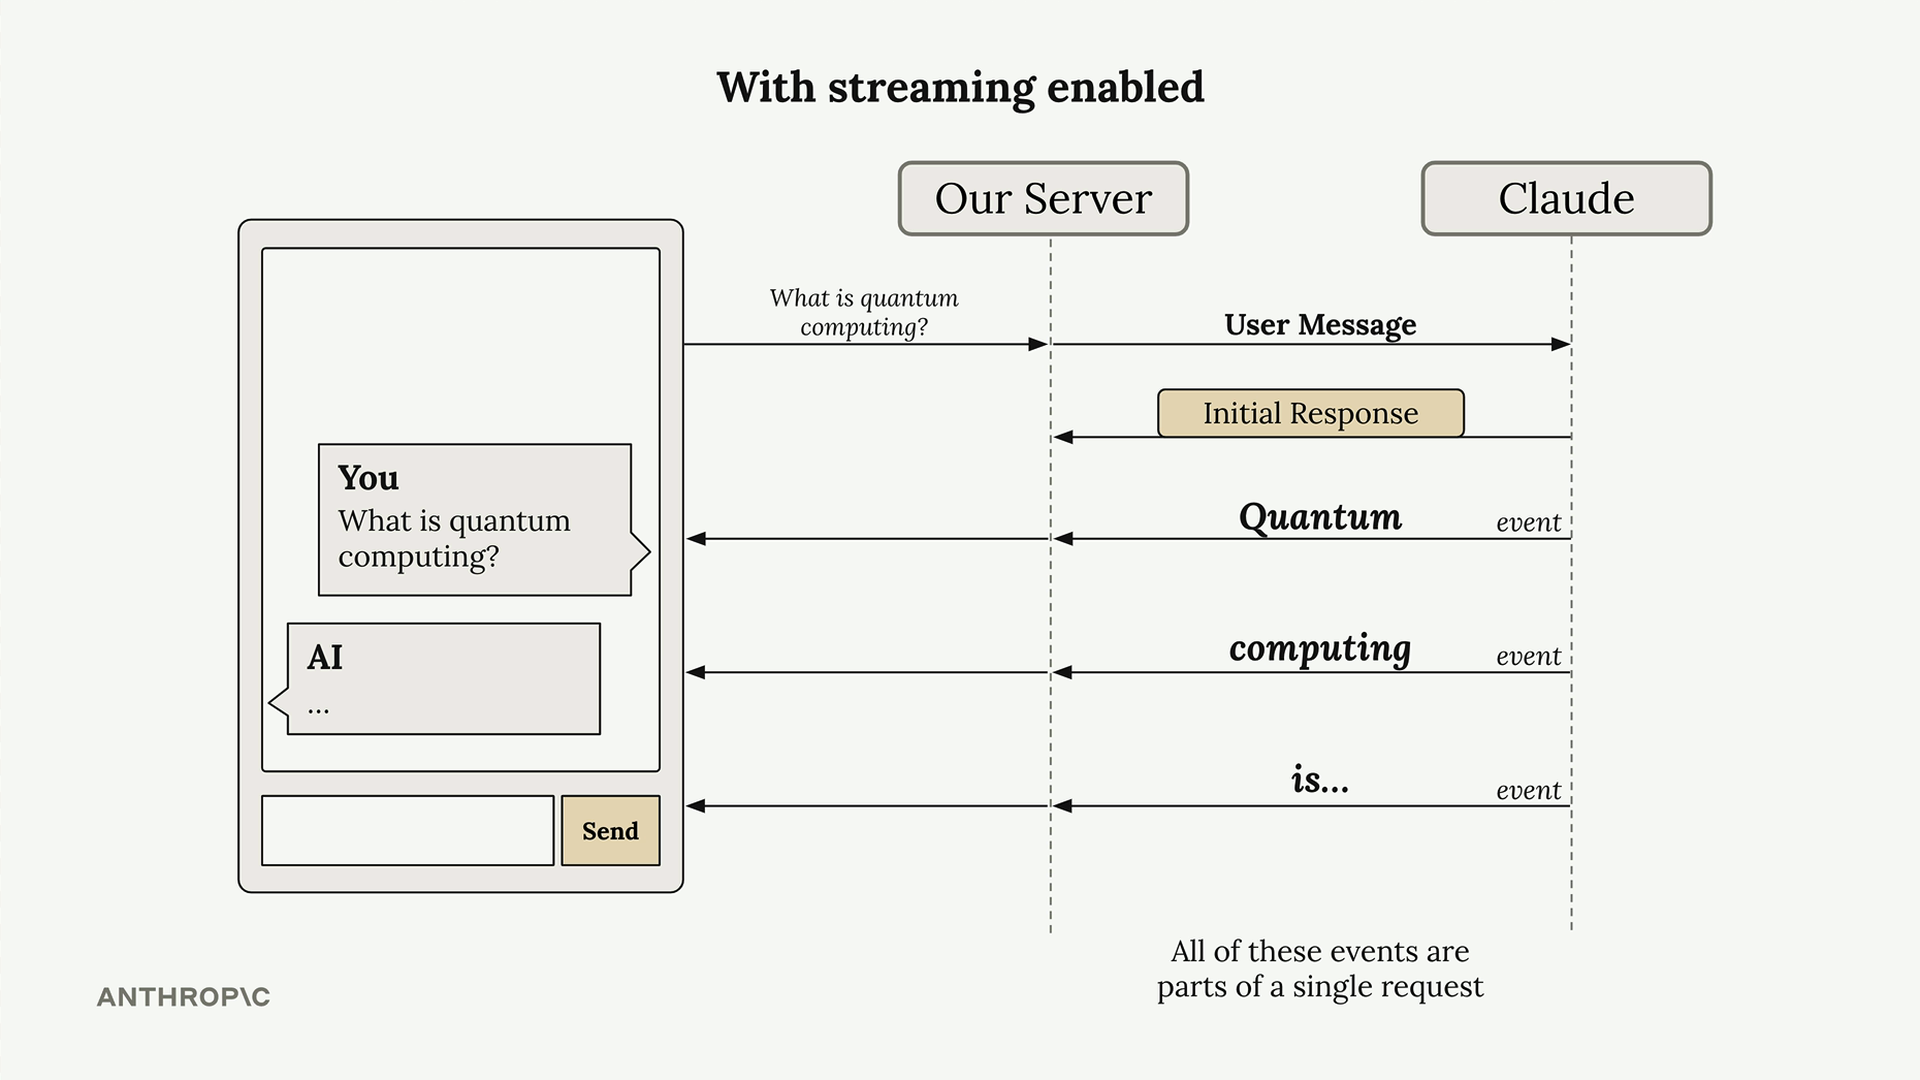
Dein Server kann diese Textstücke an deine Client-Anwendung weiterleiten, sobald sie eintreffen, sodass Nutzer sehen können, wie sich die Antwort Wort für Wort aufbaut. Alle diese Events sind Teil einer einzigen Anfrage an Claude.
Stream-Events verstehen
Wenn du Streaming aktivierst, sendet Claude mehrere Arten von Events zurück:
- MessageStart - Eine neue Nachricht wird gesendet
- ContentBlockStart - Beginn eines neuen Blocks mit Text, Tool-Nutzung oder anderem Inhalt
- ContentBlockDelta - Stücke des tatsächlich generierten Textes
- ContentBlockStop - Der aktuelle Inhaltsblock wurde abgeschlossen
- MessageDelta - Die aktuelle Nachricht ist vollständig
- MessageStop - Ende der Informationen zur aktuellen Nachricht
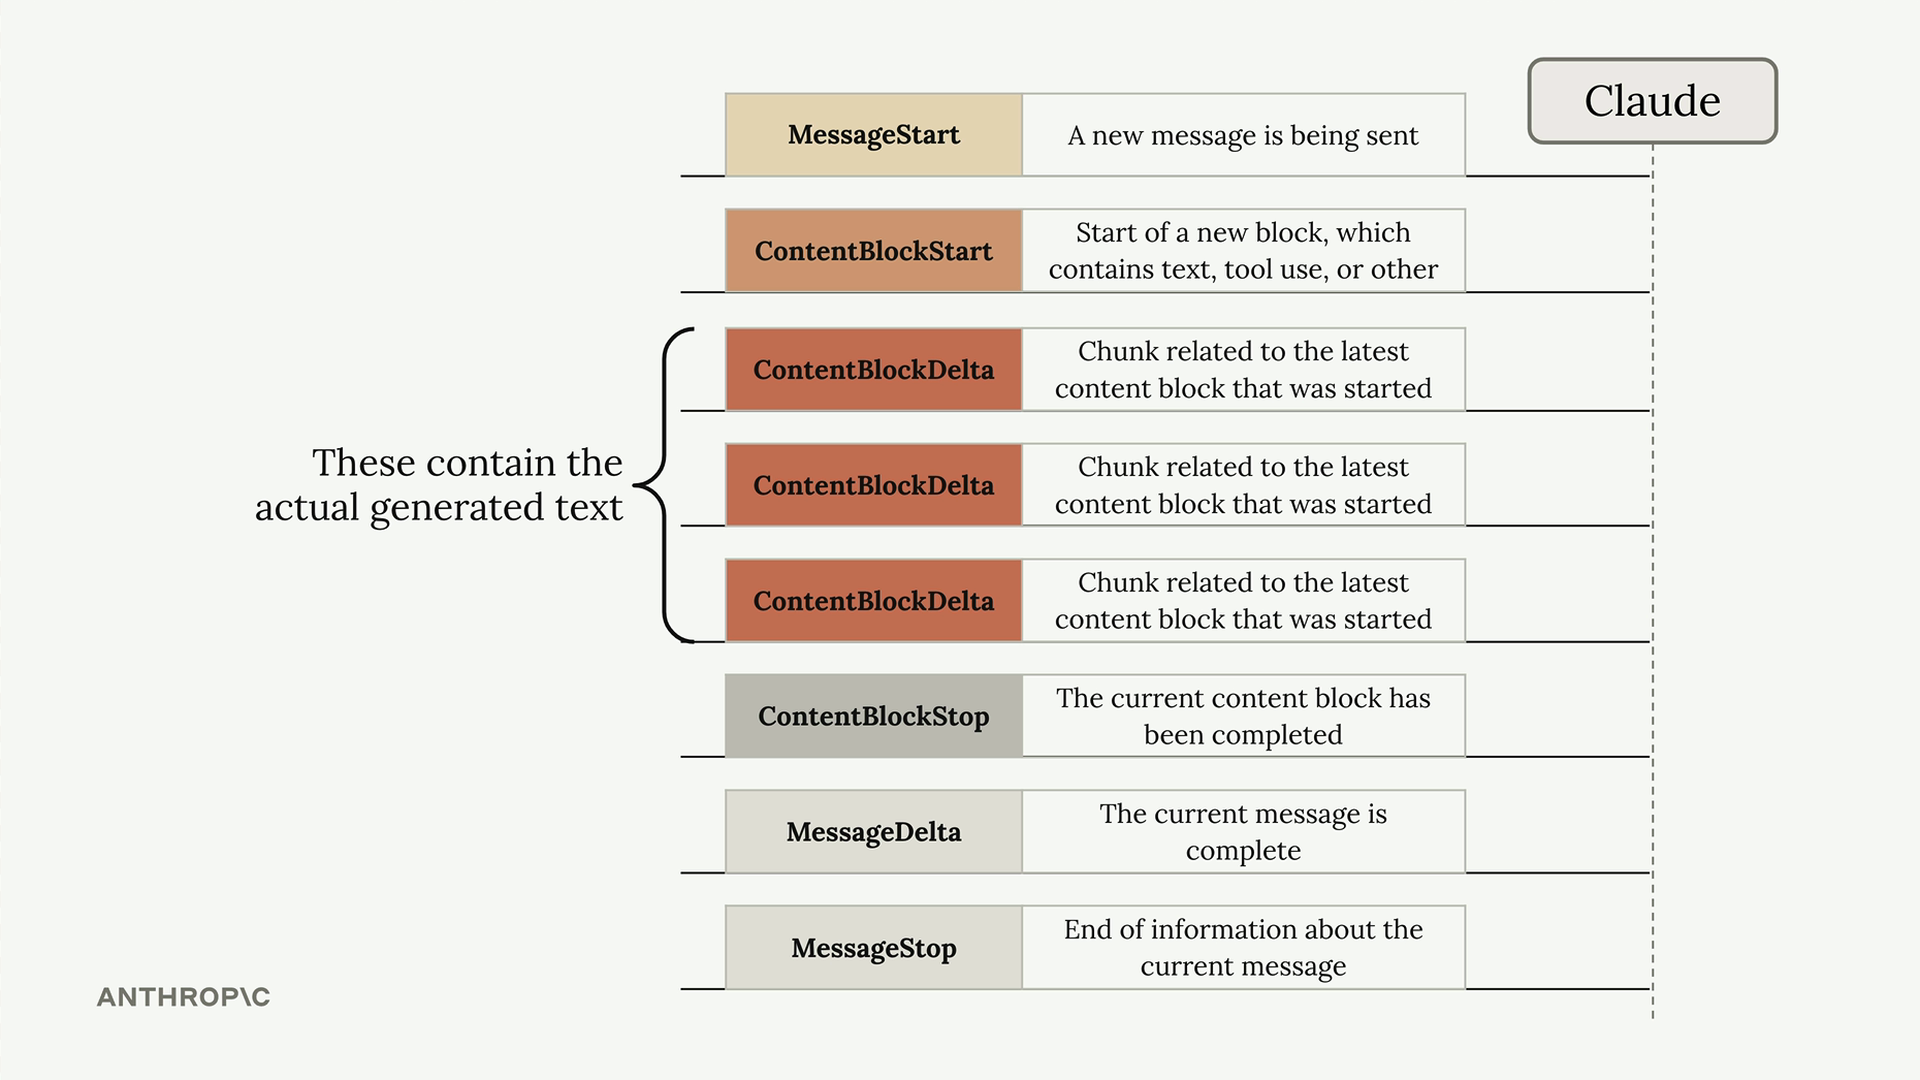
Die ContentBlockDelta-Events enthalten den tatsächlich generierten Text, den du den Nutzern anzeigen möchtest.
Grundlegende Streaming-Implementierung
Um Streaming zu aktivieren, füge stream=True zu deinem messages.create-Aufruf hinzu:
messages = []
add_user_message(messages, "Write a 1 sentence description of a fake database")

stream = client.messages.create(
    model=model,
    max_tokens=1000,
    messages=messages,
    stream=True
)

for event in stream:
    print(event)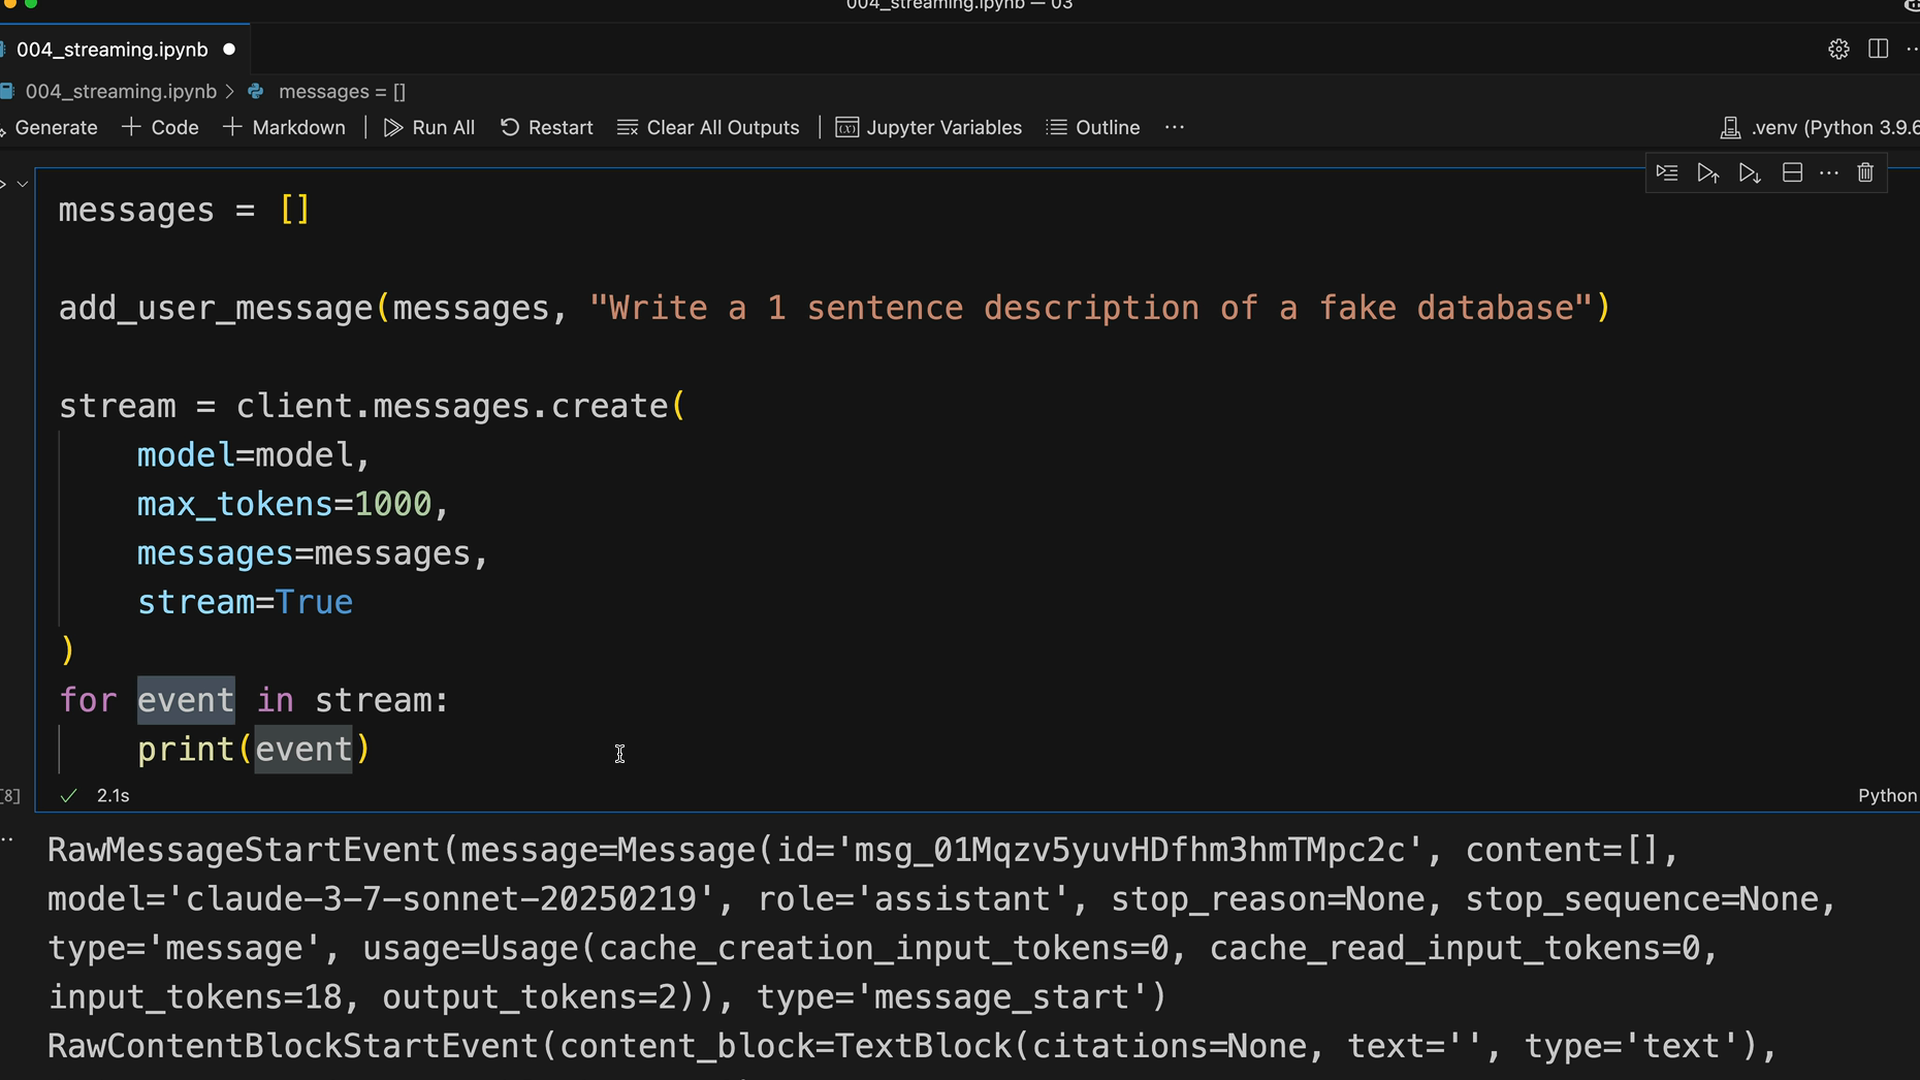
Vereinfachtes Text-Streaming
Anstatt Events manuell zu parsen, kannst du die vereinfachte Streaming-Schnittstelle des SDK verwenden, die nur den Textinhalt extrahiert:
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        print(text, end="")
Dieser Ansatz filtert automatisch alles außer dem tatsächlichen Textinhalt heraus, was in der Regel das ist, was du zur Anzeige von Antworten für Nutzer benötigst.
Die vollständige Nachricht erhalten
Während das Streaming einzelner Stücke großartig für die Nutzererfahrung ist, benötigst du oft die vollständige Nachricht zur Speicherung oder Weiterverarbeitung. Nach Abschluss des Streamings kannst du die zusammengesetzte endgültige Nachricht abrufen:
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        # Sende jeden Chunk an deinen Client
        pass

    # Hole die vollständige Nachricht für die Datenbankspeicherung
    final_message = stream.get_final_message()
Dies gibt dir das Beste aus beiden Welten: Echtzeit-Streaming für Nutzer und ein vollständiges Nachrichtenobjekt für deine Anwendungslogik.