Beim Erstellen von Anwendungen mit Claude hilft dir das Verständnis des vollständigen Request-Lebenszyklus, bessere architektonische Entscheidungen zu treffen und Probleme effektiver zu debuggen. Lass uns durchgehen, was von dem Moment an passiert, in dem ein Nutzer in deiner Chat-Oberfläche auf „Senden" klickt, bis Claudes Antwort auf dem Bildschirm erscheint.
Der fünfstufige Request-Ablauf
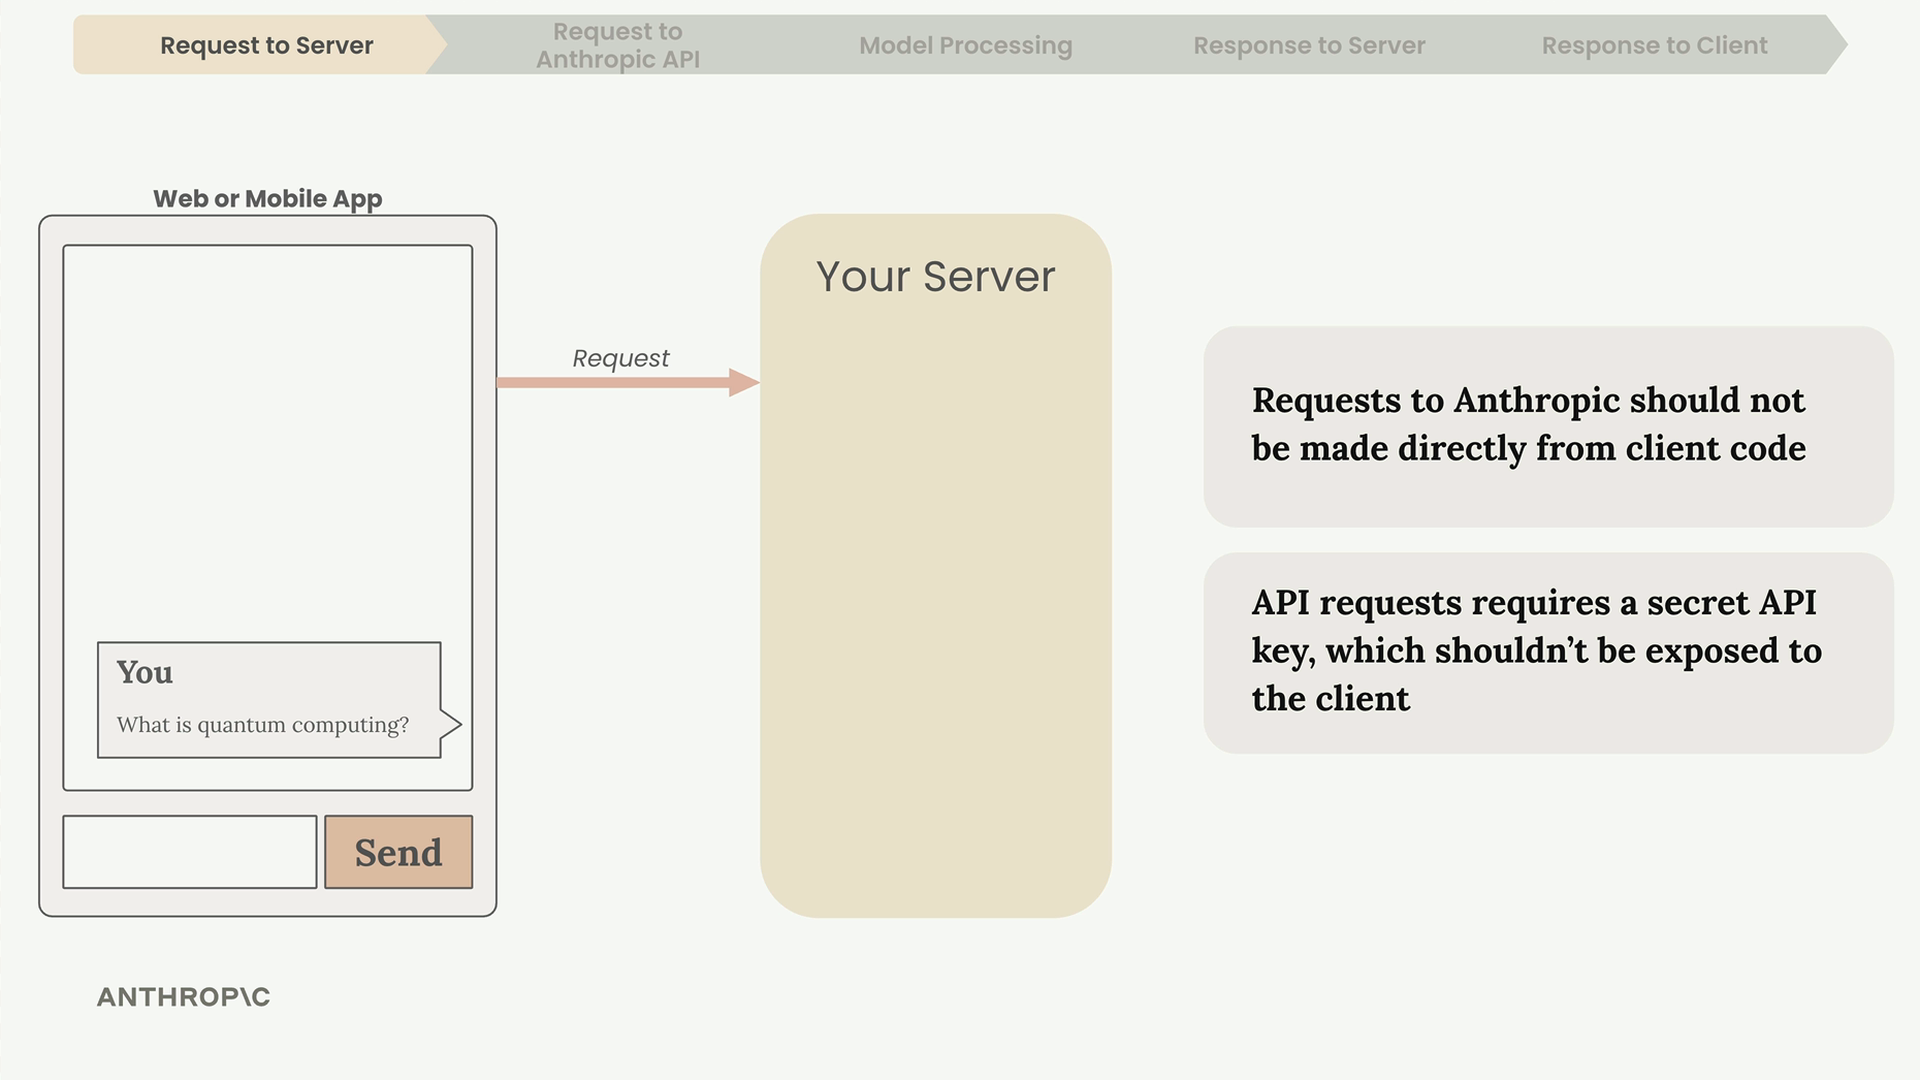
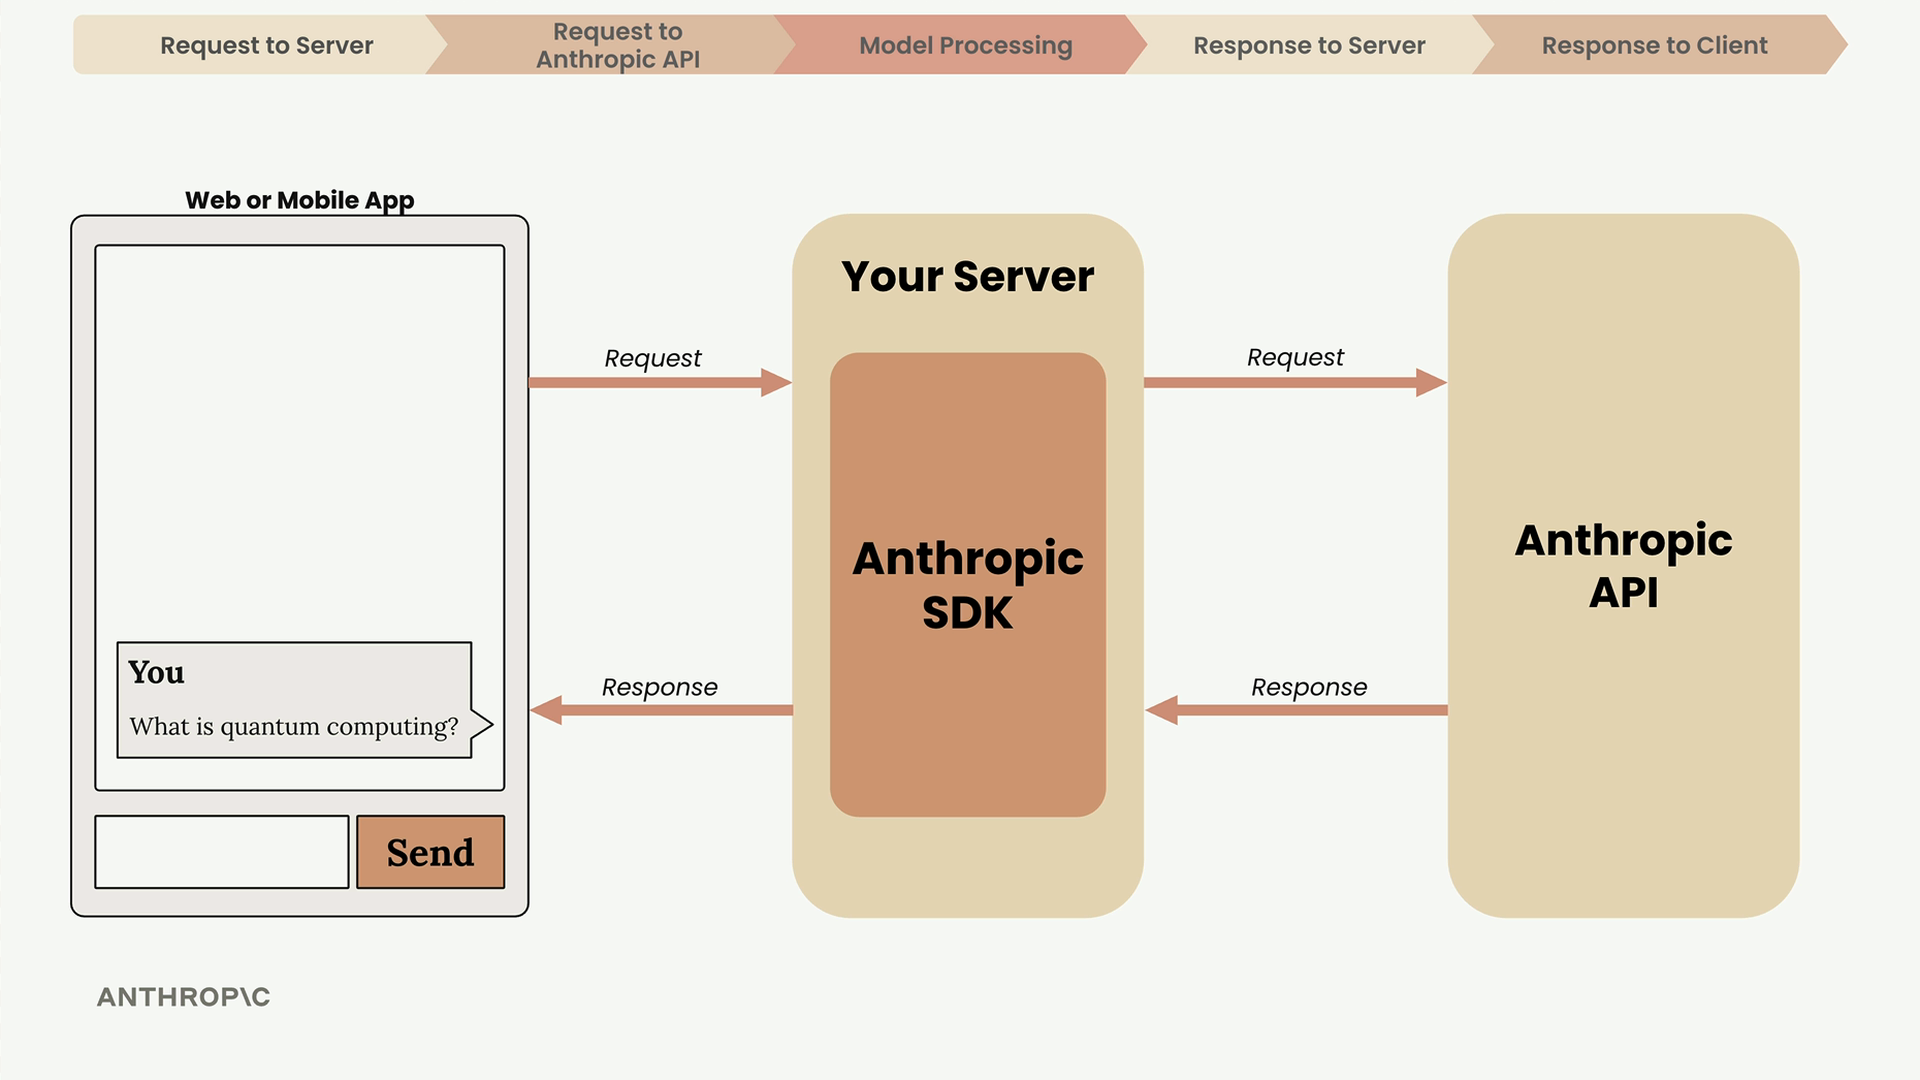
Jede Interaktion mit Claude folgt einem vorhersehbaren Muster mit fünf unterschiedlichen Phasen: Request an den Server, Request an die Anthropic API, Modellverarbeitung, Antwort an den Server und Antwort an den Client.
Warum du einen Server brauchst
Du solltest niemals Requests direkt von Client-seitigem Code an die Anthropic API senden. Hier ist der Grund:
- API-Requests erfordern einen geheimen API-Key zur Authentifizierung
- Das Offenlegen dieses Keys im Client-Code schafft eine ernsthafte Sicherheitslücke
- Jeder könnte den Key extrahieren und unbefugte Requests stellen
Stattdessen sendet deine Web- oder Mobile-App Requests an deinen eigenen Server, der dann mit dem sicher gespeicherten Key mit der Anthropic API kommuniziert.
API-Requests stellen
Wenn dein Server die Anthropic API kontaktiert, kannst du entweder ein offizielles SDK verwenden oder einfache HTTP-Requests stellen. Anthropic bietet SDKs für Python, TypeScript, JavaScript, Go und Ruby an.
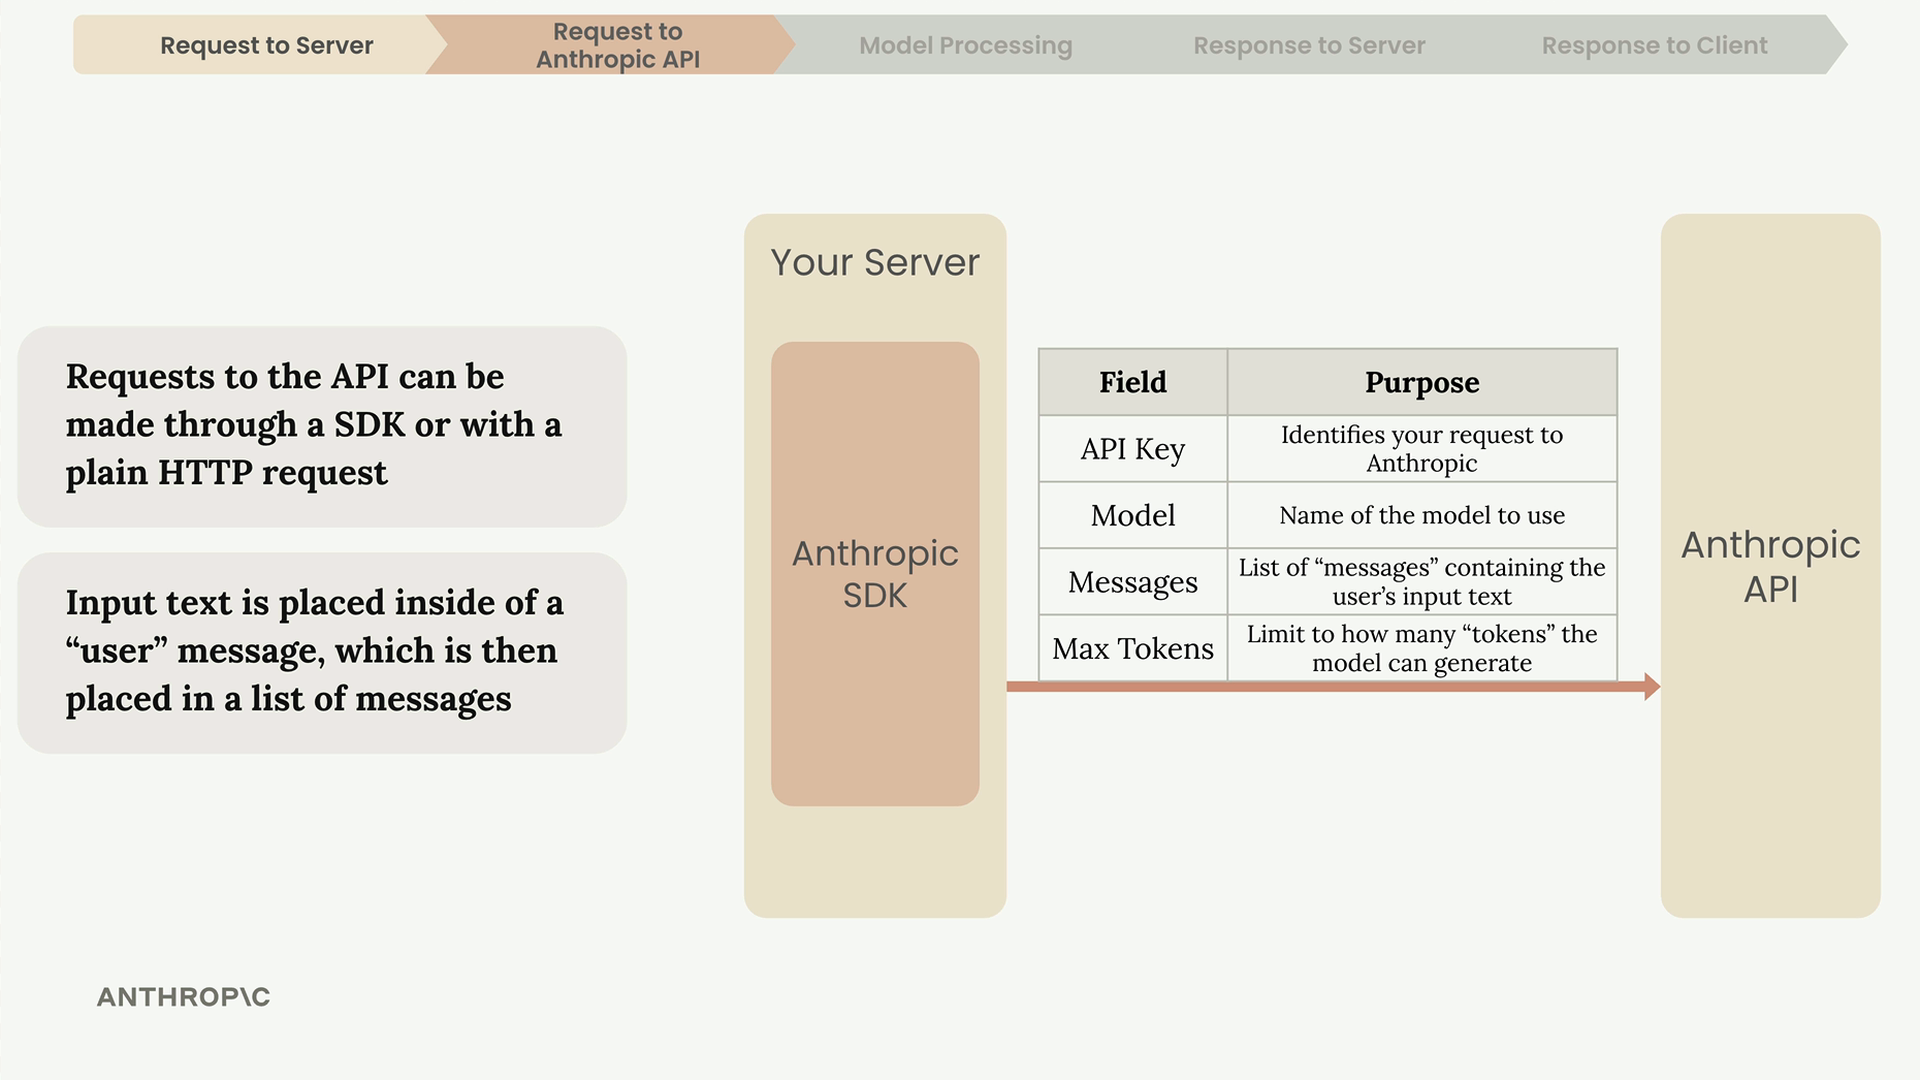
Jeder Request muss diese wesentlichen Felder enthalten:
- API Key - Identifiziert deinen Request gegenüber Anthropic
- Model - Name des zu verwendenden Modells (wie „claude-sonnet-4-5")
- Messages - Liste, die den Eingabetext des Nutzers enthält
- Max Tokens - Limit dafür, wie viele Tokens Claude generieren kann
Innerhalb von Claudes Verarbeitung
Sobald Anthropic deinen Request empfängt, verarbeitet Claude ihn in vier Hauptphasen: Tokenisierung, Embedding, Kontextualisierung und Generierung.
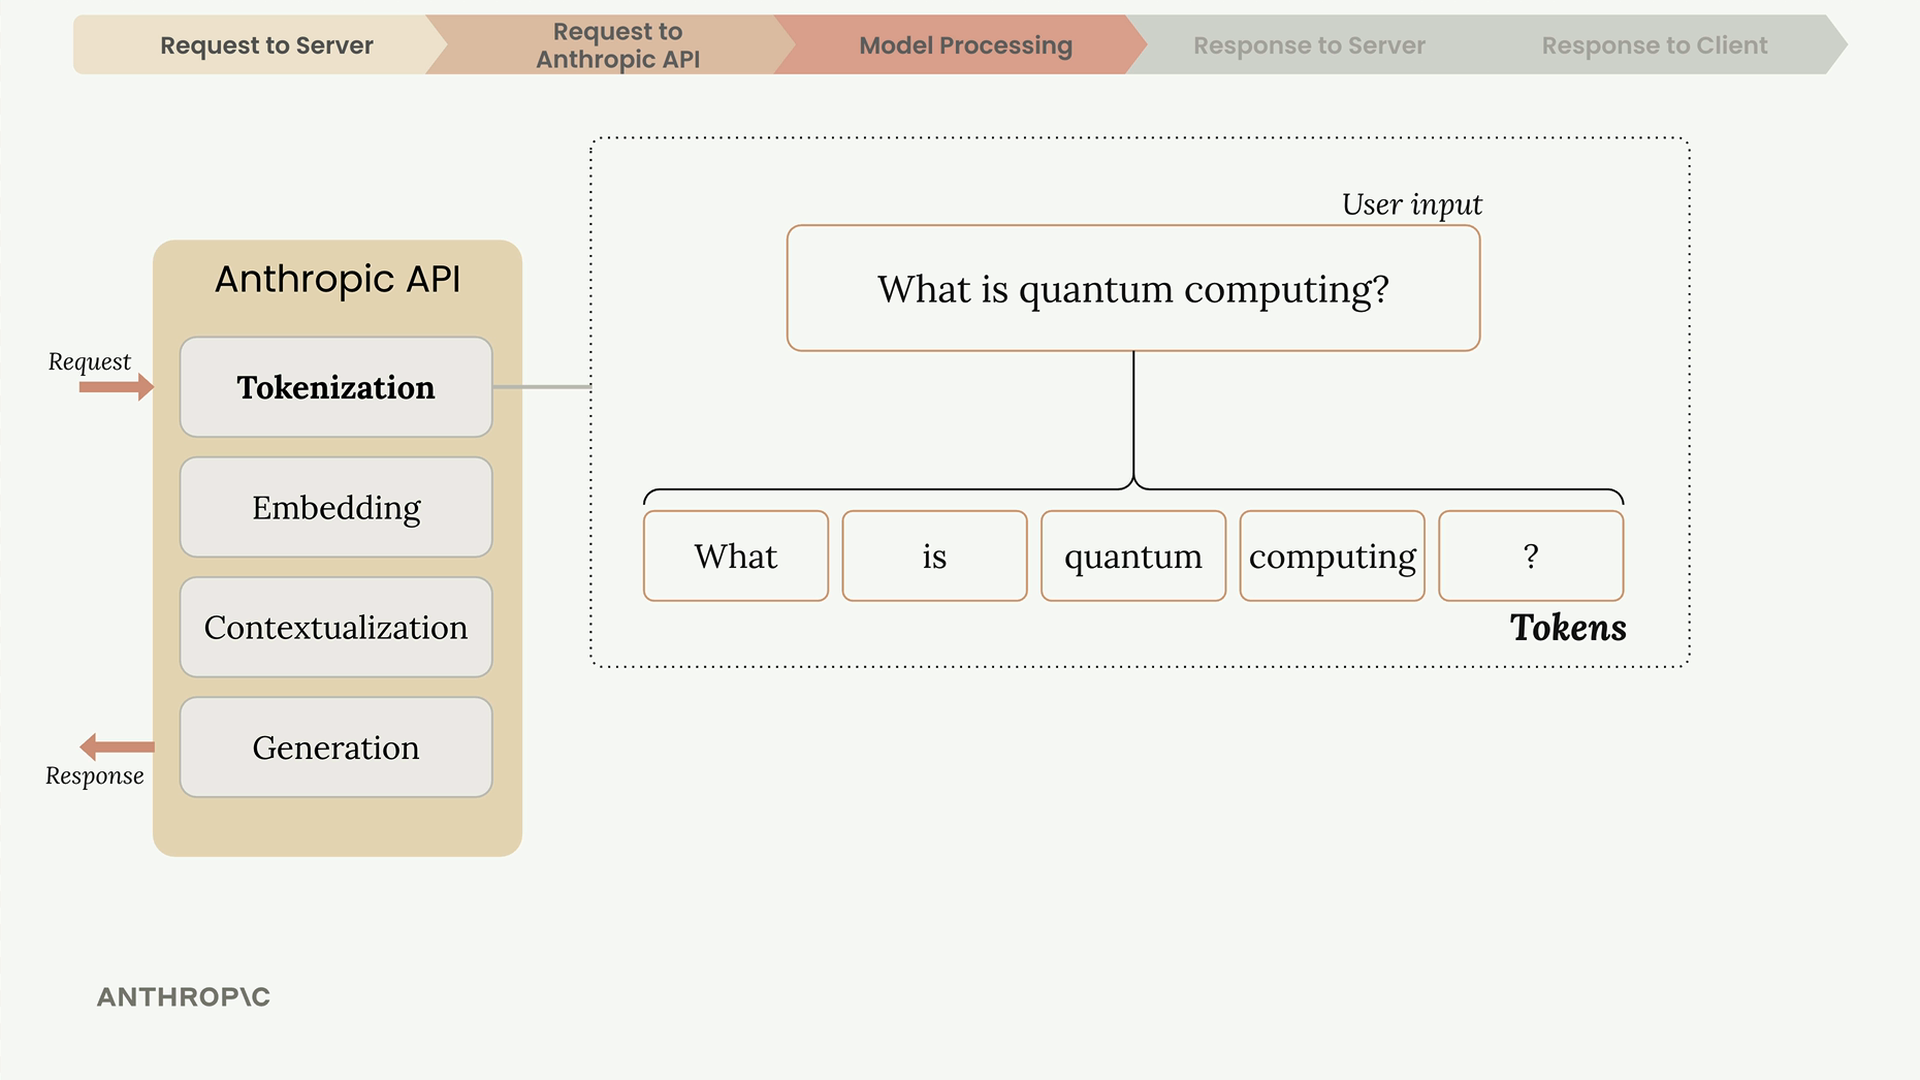
Tokenisierung
Claude zerlegt deinen Eingabetext zunächst in kleinere Teile, die Tokens genannt werden. Diese können ganze Wörter, Wortteile, Leerzeichen oder Symbole sein. Der Einfachheit halber kannst du dir jedes Wort als ein Token vorstellen.
Embedding
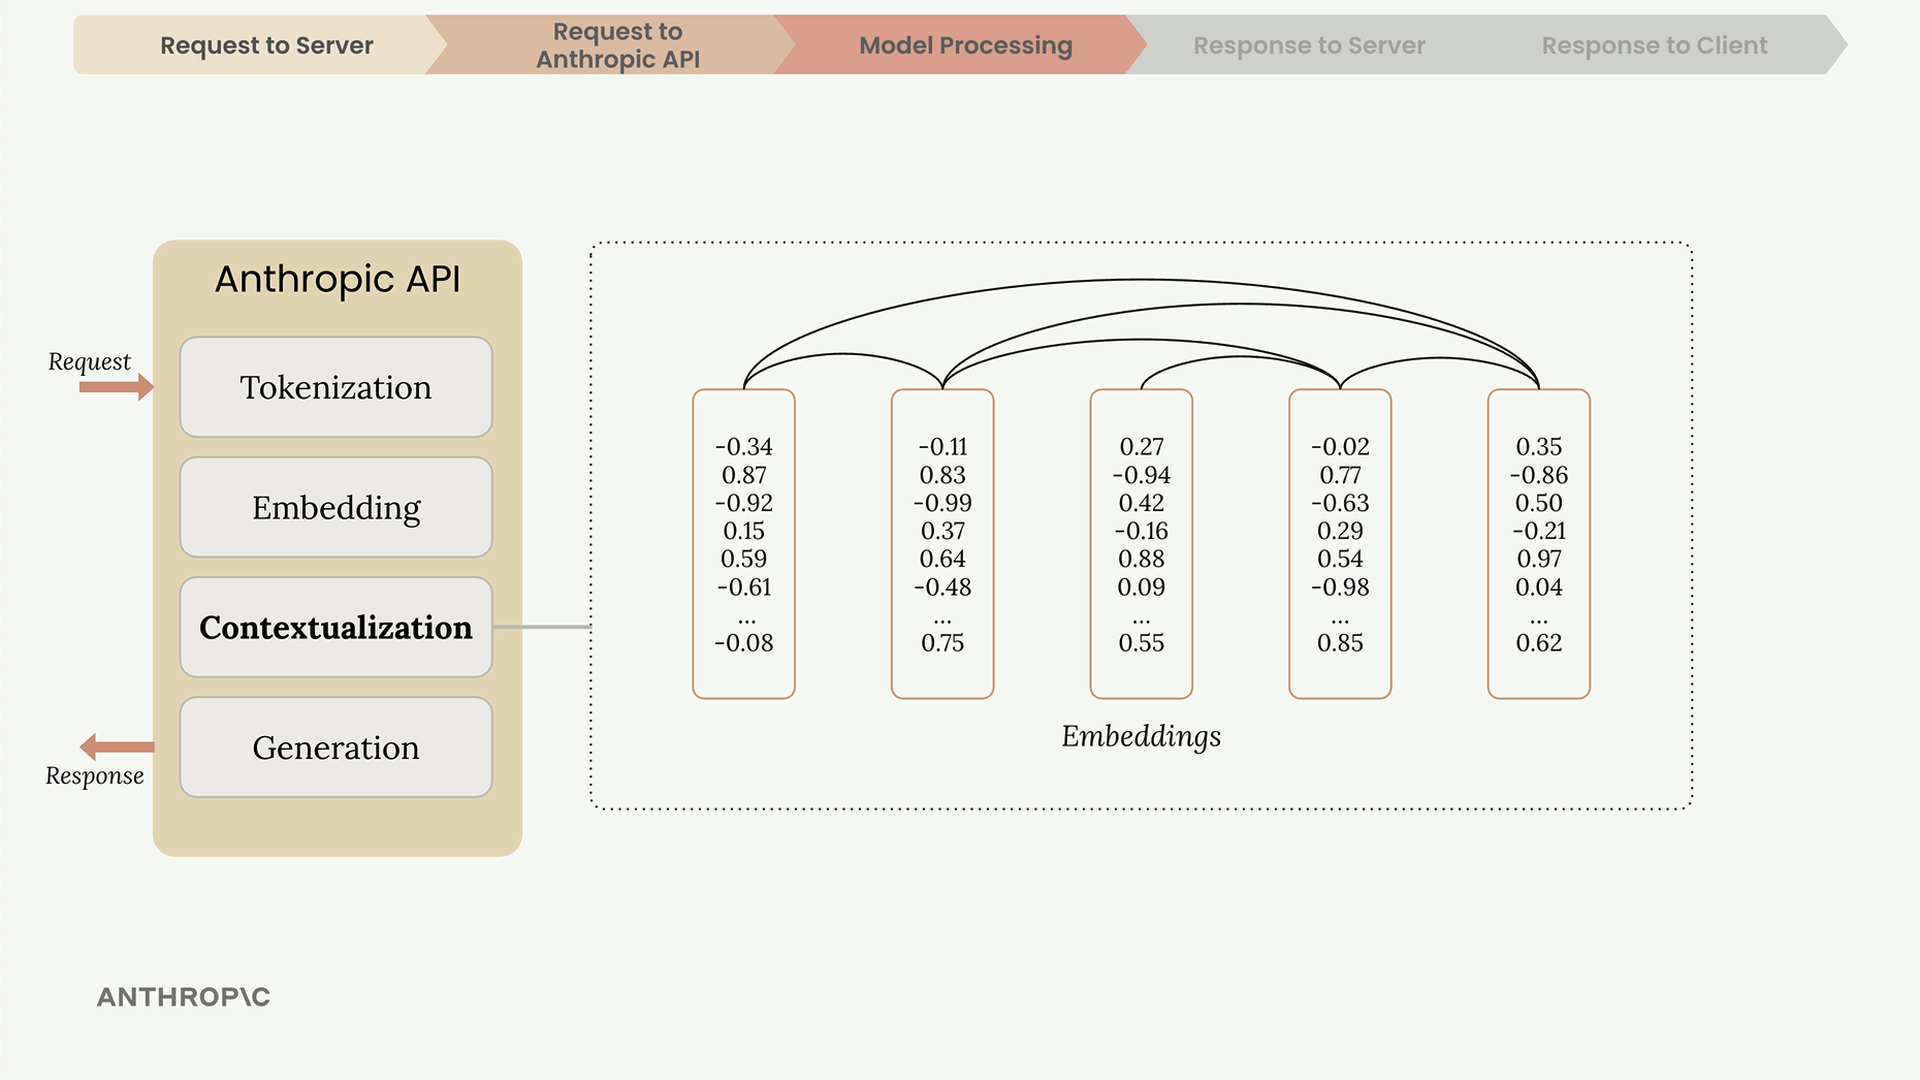
Jedes Token wird in ein Embedding umgewandelt - eine lange Liste von Zahlen, die alle möglichen Bedeutungen dieses Wortes repräsentiert. Stell dir Embeddings als numerische Definitionen vor, die semantische Beziehungen erfassen.
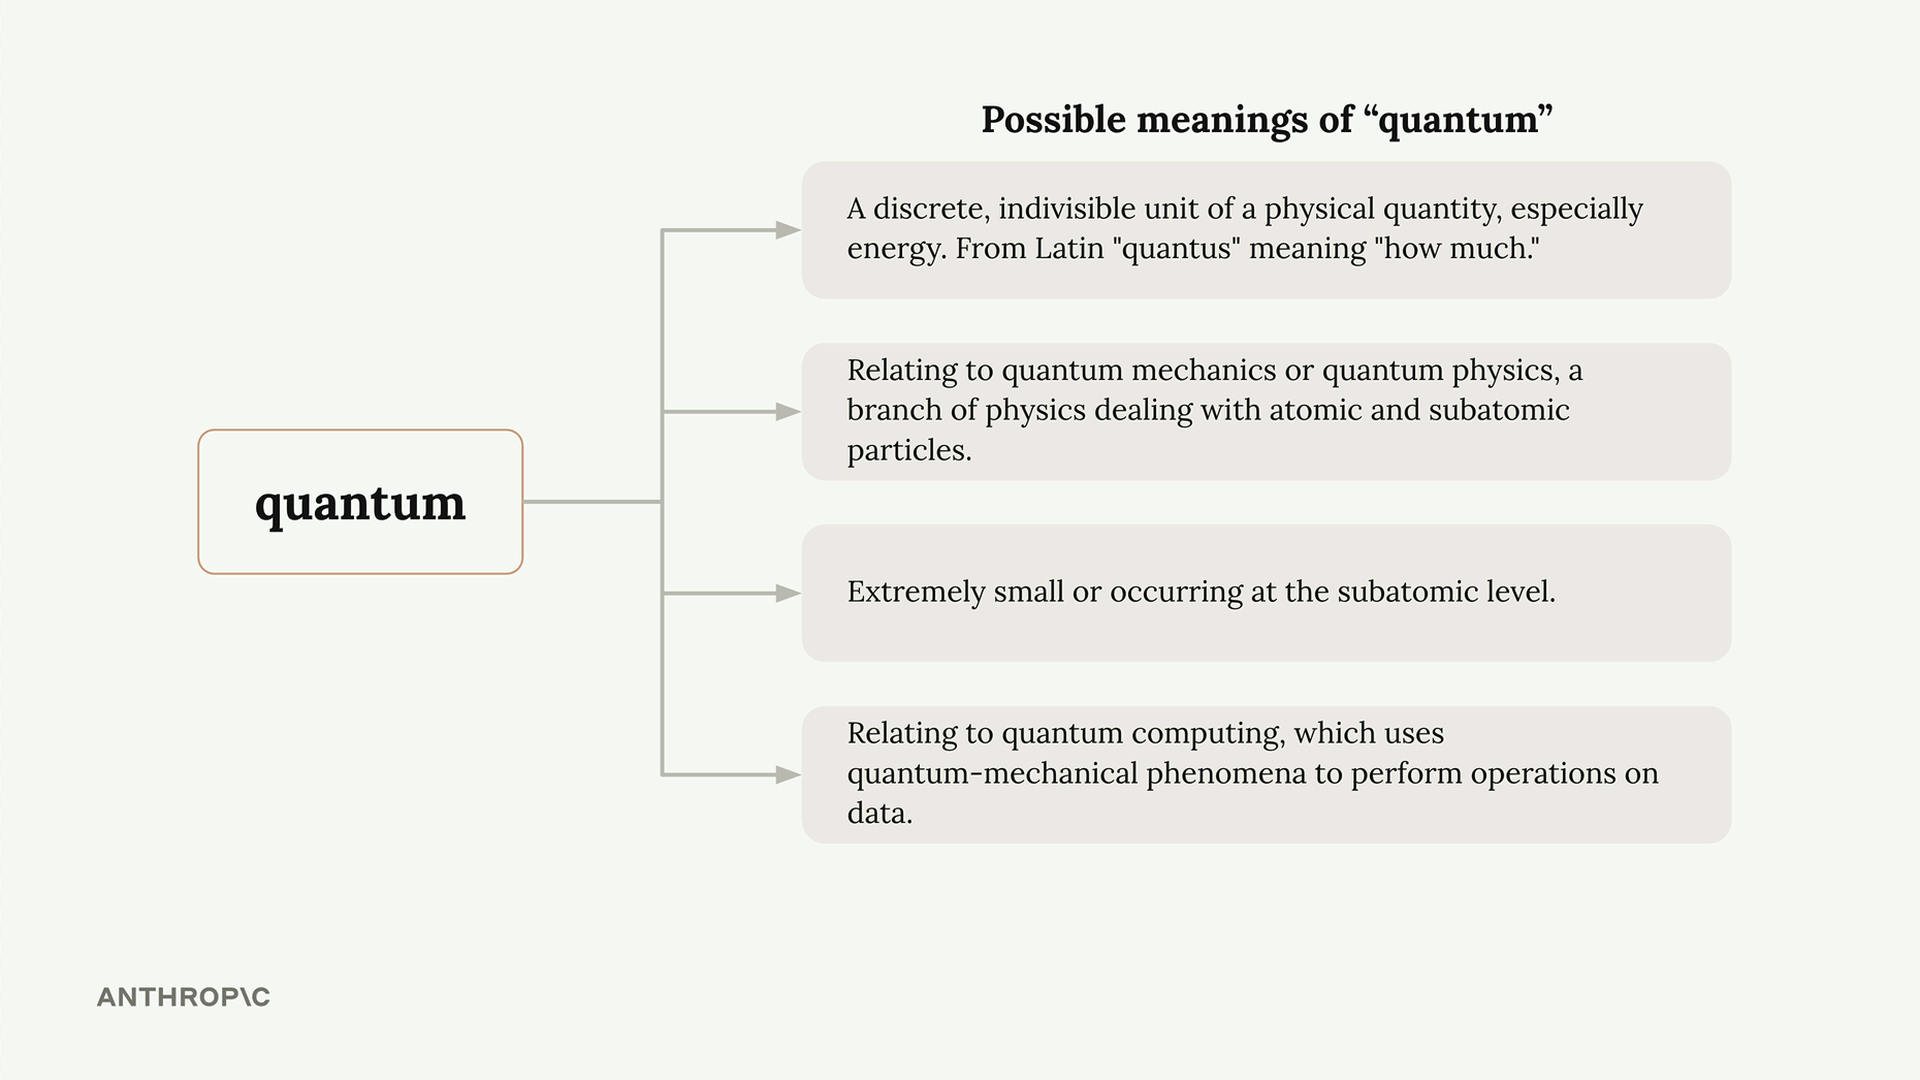
Wörter haben oft mehrere Bedeutungen. Zum Beispiel könnte sich „Quantum" auf Folgendes beziehen:
- Eine diskrete Einheit einer physikalischen Größe (Physik)
- Quantenmechanik oder Quantenphysik-Konzepte
- Etwas extrem Kleines oder Subatomares
- Quantencomputing-Anwendungen
Kontextualisierung
Claude verfeinert jedes Embedding basierend auf den umgebenden Wörtern, um die wahrscheinlichste Bedeutung im Kontext zu bestimmen. Dieser Prozess passt die numerischen Repräsentationen an, um die passende Definition hervorzuheben.
Generierung
Die kontextualisierten Embeddings durchlaufen eine Ausgabeschicht, die Wahrscheinlichkeiten für jedes mögliche nächste Wort berechnet. Claude wählt nicht immer das Wort mit der höchsten Wahrscheinlichkeit - es verwendet eine Mischung aus Wahrscheinlichkeit und kontrollierter Zufälligkeit, um natürliche, abwechslungsreiche Antworten zu erzeugen.
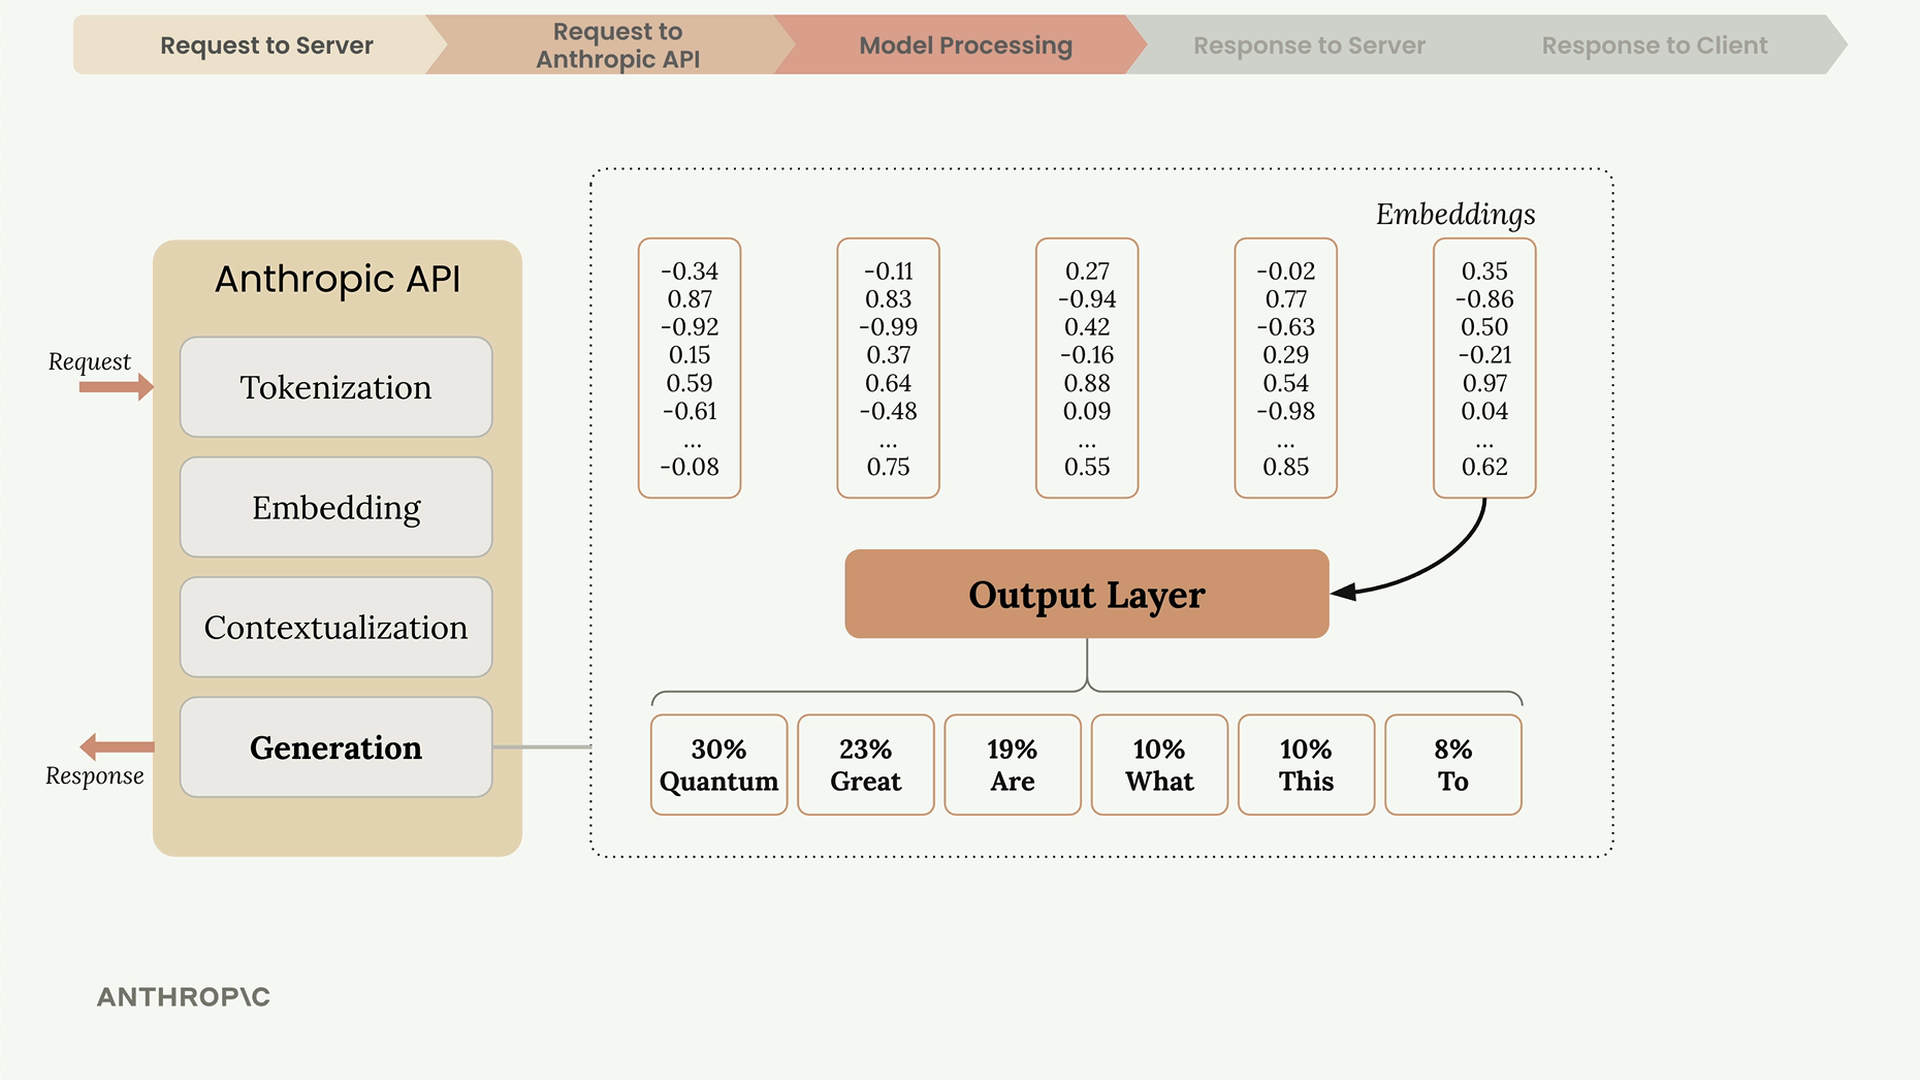
Nach der Auswahl jedes Wortes fügt Claude es der Sequenz hinzu und wiederholt den gesamten Prozess für das nächste Wort.
Wann Claude die Generierung stoppt
Nach jedem Token prüft Claude mehrere Bedingungen, um zu entscheiden, ob fortgefahren werden soll:
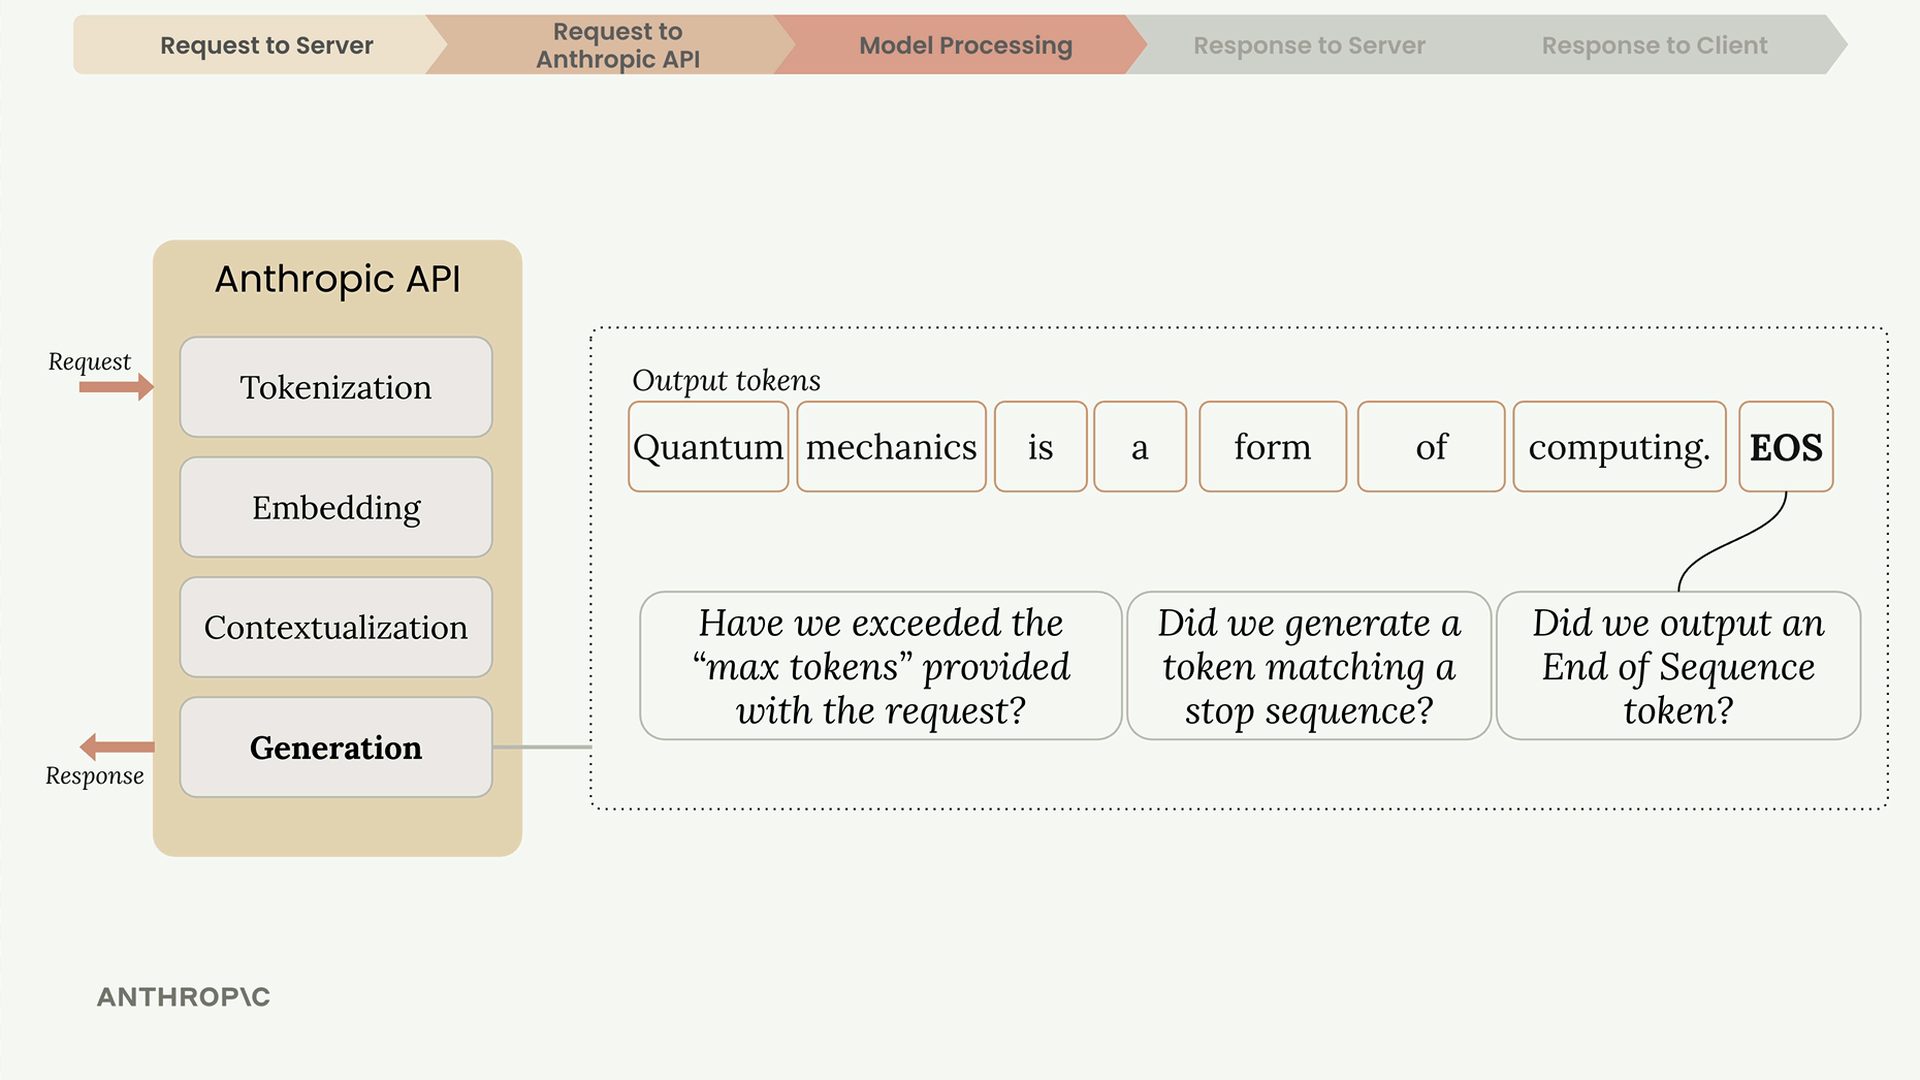
- Max Tokens erreicht - Wurde das von dir angegebene Limit erreicht?
- Natürliches Ende - Wurde ein End-of-Sequence-Token generiert?
- Stop-Sequenz - Ist eine vordefinierte Stopp-Phrase aufgetreten?
Die API-Antwort
Wenn die Generierung abgeschlossen ist, sendet die API eine strukturierte Antwort zurück, die Folgendes enthält:
- Message - Der generierte Text
- Usage - Anzahl der Input- und Output-Tokens
- Stop Reason - Warum die Generierung beendet wurde
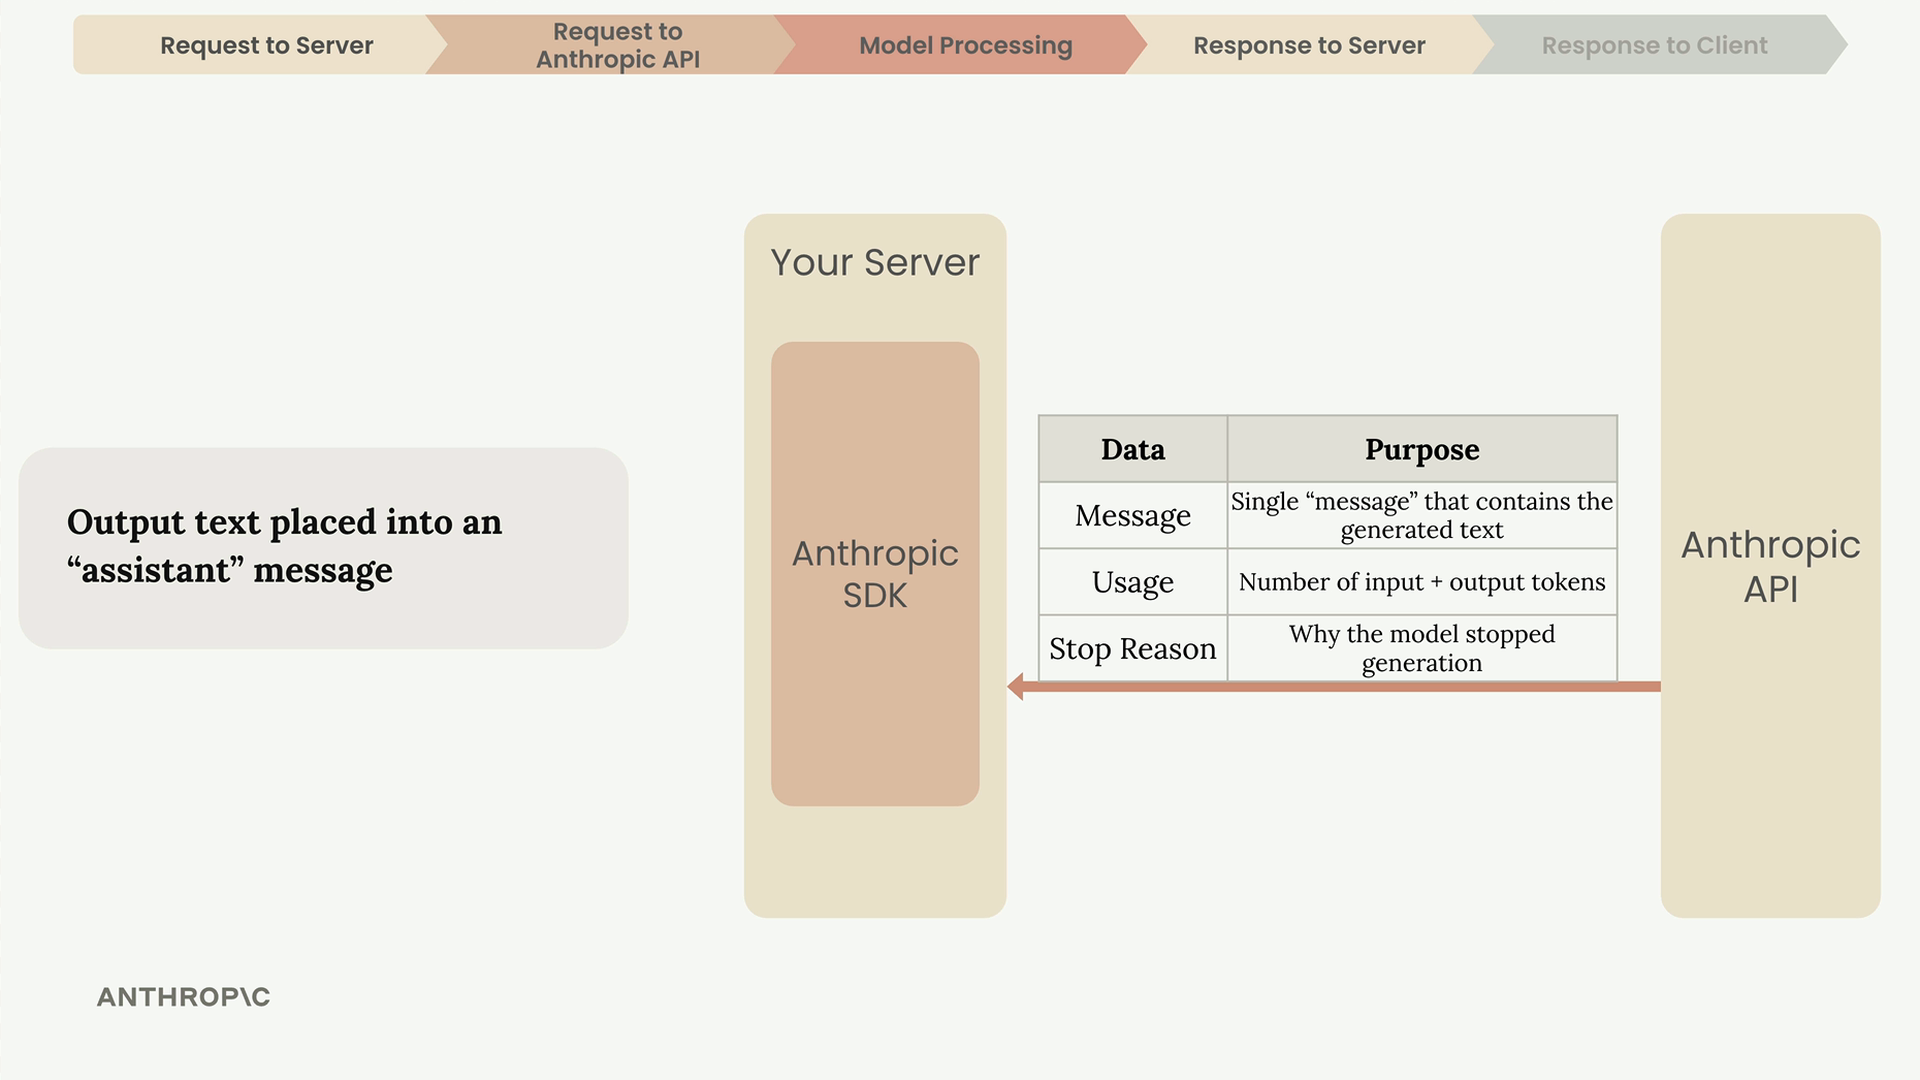
Dein Server empfängt diese Antwort und leitet den generierten Text zurück an deine Client-Anwendung weiter, wo er in der Benutzeroberfläche erscheint.
Wichtige Erkenntnisse
Das Verständnis dieses Ablaufs hilft dir:
- Sichere Architekturen zu entwerfen, die deine API-Keys schützen
- Angemessene Token-Limits für deinen Anwendungsfall festzulegen
- Unterschiedliche Stop-Gründe in deiner Anwendungslogik zu behandeln
- Probleme zu debuggen, indem du verstehst, wo sie in der Pipeline auftreten könnten
Mach dir keine Sorgen darüber, jedes Detail zu memorieren - das Ziel ist es, dich mit der Terminologie und dem Gesamtprozess vertraut zu machen, auf den du bei der Arbeit mit Claudes API stoßen wirst.