Wir haben separate Implementierungen für die semantische Suche (mit Vektor-Embeddings) und die lexikalische Suche (mit BM25) erstellt. Jetzt ist es Zeit, sie in einer einheitlichen Such-Pipeline zu kombinieren, die die Stärken beider Ansätze nutzt.
Die Multi-Index-Architektur
Sowohl unsere VectorIndex- als auch unsere BM25Index-Klasse teilen sich nahezu identische APIs - beide verfügen über die Methoden add_document() und search(). Diese Konsistenz macht es einfach, sie in einer neuen Klasse namens Retriever zusammenzufassen.
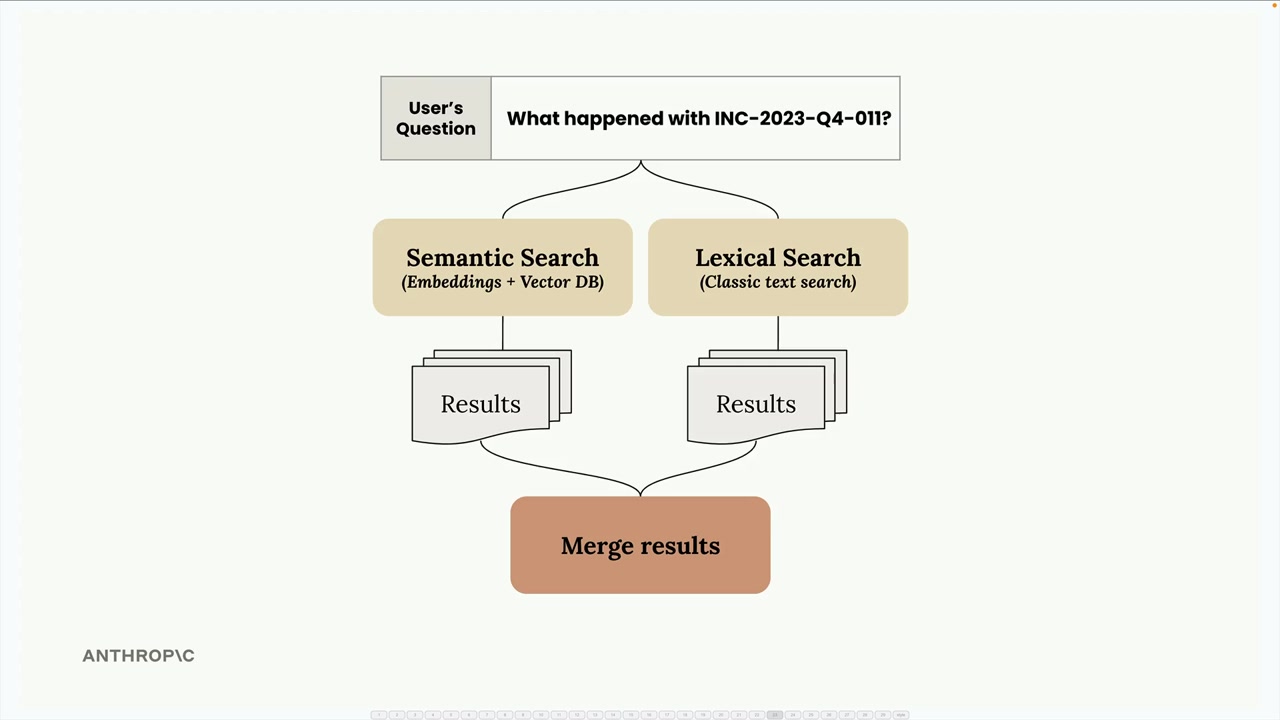
Der Retriever fungiert als Koordinator, der Benutzeranfragen an beide Indizes weiterleitet, deren Ergebnisse sammelt und sie mithilfe einer Technik namens Reciprocal Rank Fusion zusammenführt.
Reciprocal Rank Fusion verstehen
Das Zusammenführen von Ergebnissen aus verschiedenen Suchmethoden ist nicht so einfach wie das bloße Verketten von Listen. Jede Methode verwendet unterschiedliche Bewertungssysteme, daher benötigen wir eine Möglichkeit, ihre Rankings fair zu normalisieren und zu kombinieren.
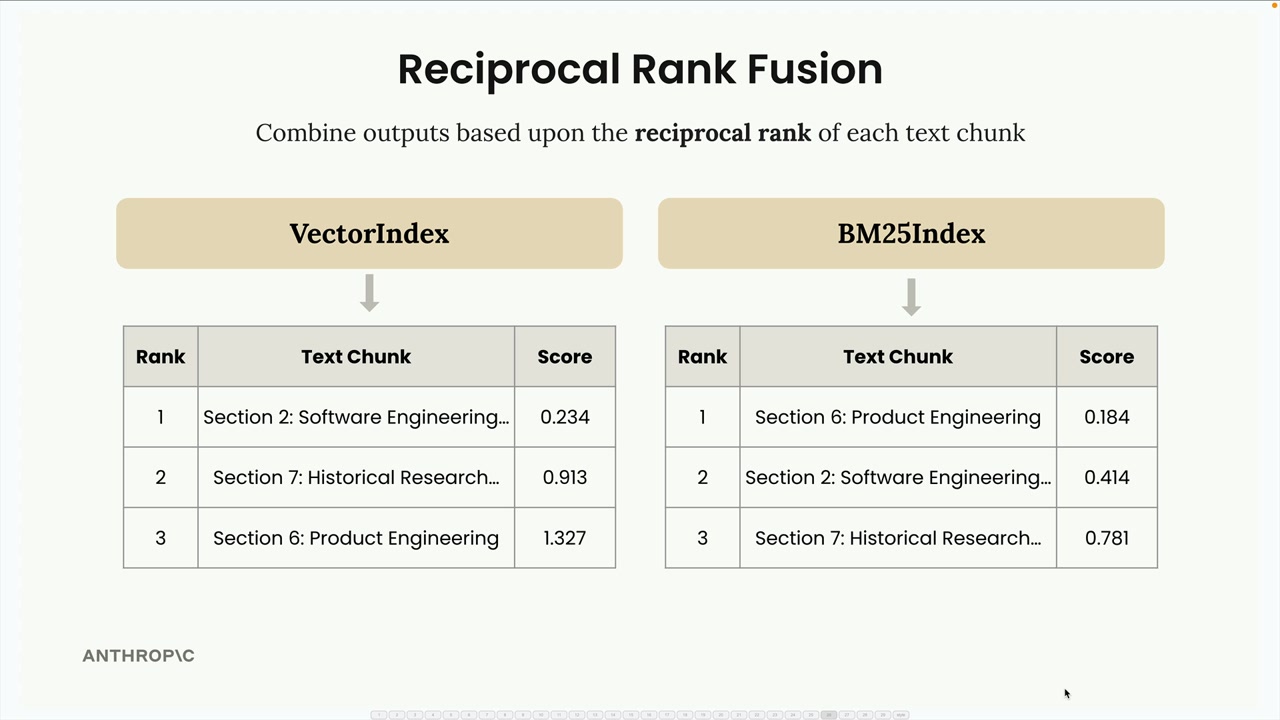
So funktioniert Reciprocal Rank Fusion anhand eines Beispiels. Angenommen, wir suchen nach Informationen zu „INC-2023-Q4-011" und erhalten folgende Ergebnisse:
- VectorIndex liefert: Abschnitt 2 (Rang 1), Abschnitt 7 (Rang 2), Abschnitt 6 (Rang 3)
- BM25Index liefert: Abschnitt 6 (Rang 1), Abschnitt 2 (Rang 2), Abschnitt 7 (Rang 3)
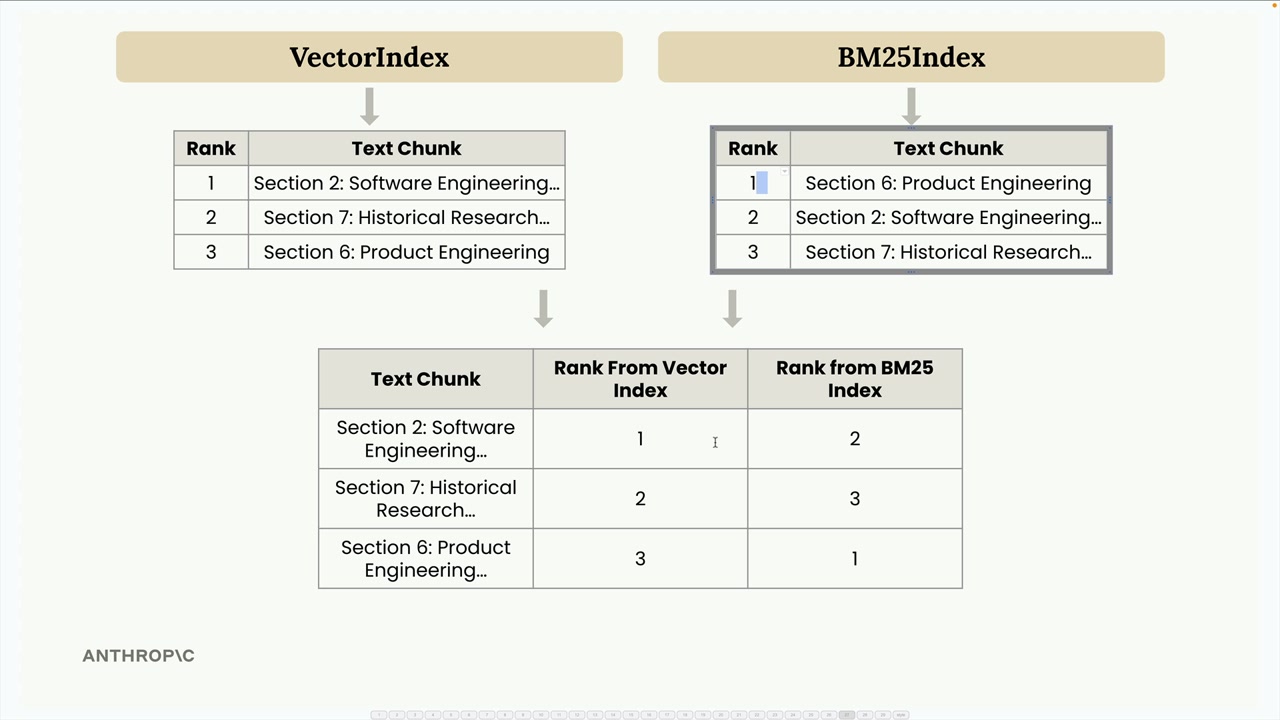
Wir fassen diese in einer einzigen Tabelle zusammen, die den Rang jedes Textabschnitts in beiden Indizes zeigt, und wenden dann die RRF-Formel an:
RRF_score(d) = Σ(1 / (k + rank_i(d)))Dabei ist k eine Konstante (oft 60, aber wir verwenden 1 für klarere Ergebnisse) und rank_i(d) ist der Rang des Dokuments d im i-ten Ranking.
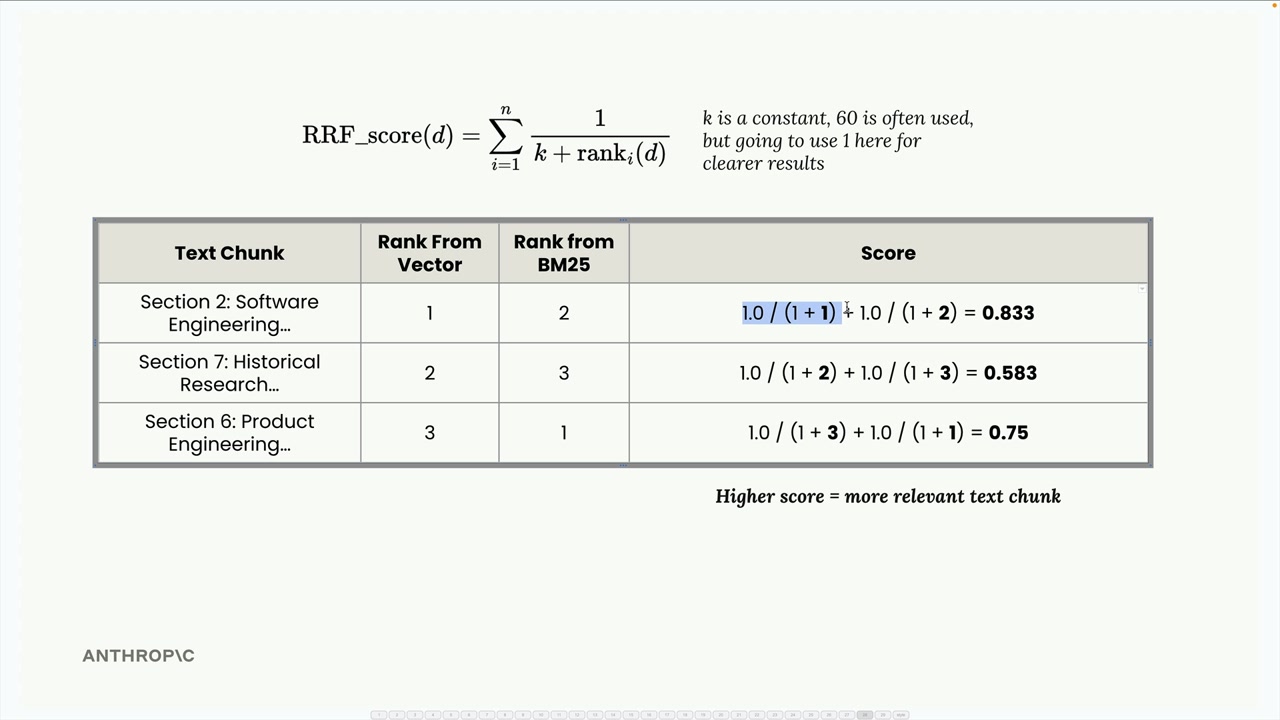
Für unser Beispiel:
- Abschnitt 2: 1,0/(1+1) + 1,0/(1+2) = 0,833
- Abschnitt 7: 1,0/(1+2) + 1,0/(1+3) = 0,583
- Abschnitt 6: 1,0/(1+3) + 1,0/(1+1) = 0,75
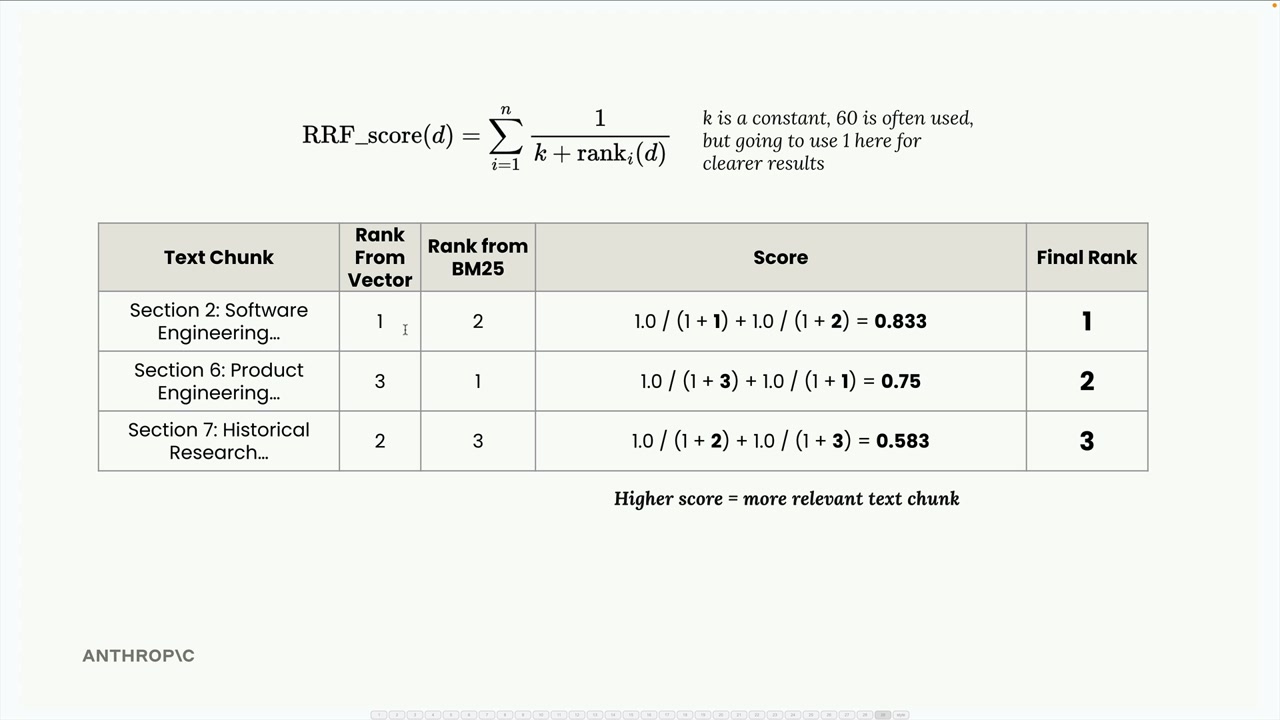
Das endgültige Ranking lautet: Abschnitt 2 (0,833), Abschnitt 6 (0,75), Abschnitt 7 (0,583). Das ergibt intuitiv Sinn - Abschnitt 2 hat in beiden Indizes gut abgeschnitten und steigt daher an die Spitze.
Implementierungsdetails
Die Retriever-Klasse umschließt mehrere Suchindizes und bietet eine einheitliche Schnittstelle:
class Retriever:
    def __init__(self, *indexes: SearchIndex):
        if len(indexes) == 0:
            raise ValueError("At least one index must be provided")
        self._indexes = list(indexes)

    def add_document(self, document: Dict[str, Any]):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text: str, k: int = 1, k_rrf: int = 60):
        # Ergebnisse aus allen Indizes abrufen
        all_results = []
        for idx, results in enumerate(all_results):
            for rank, (doc, _) in enumerate(results):
                # Dokumentrang über Indizes hinweg verfolgen
                # RRF-Scoring-Formel anwenden
        # Zusammengeführte und sortierte Ergebnisse zurückgeben
Die zentrale Erkenntnis ist, dass wir durch die Beibehaltung konsistenter APIs über verschiedene Suchimplementierungen hinweg diese leicht kombinieren können, ohne eine enge Kopplung zu erzeugen.
Testen des hybriden Ansatzes
Erinnerst du dich an unser früheres Problem, bei dem die Suche nach „what happened with INC-2023-Q4-011?" beim rein vektorbasierten Ansatz unerwartete Ergebnisse lieferte? Der Cybersicherheitsvorfall (Abschnitt 10) kam zuerst, aber die Finanzanalyse (Abschnitt 3) kam an zweiter Stelle statt des relevanteren Software-Engineering-Abschnitts.
Mit unserem hybriden Retriever erhalten wir nun deutlich bessere Ergebnisse:
- Abschnitt 10: Cybersicherheitsanalyse - Bericht zur Vorfallsreaktion (am relevantesten)
- Abschnitt 2: Software-Engineering - Stabilitätsverbesserungen für Project Phoenix (zweitrelevantester)
- Abschnitt 5: Rechtliche Entwicklungen (drittrelevantester)
Dies zeigt, wie die Kombination von semantischer und lexikalischer Suche die Einschränkungen überwinden kann, die bei alleiniger Verwendung eines der beiden Ansätze bestehen.
Erweiterbarkeit
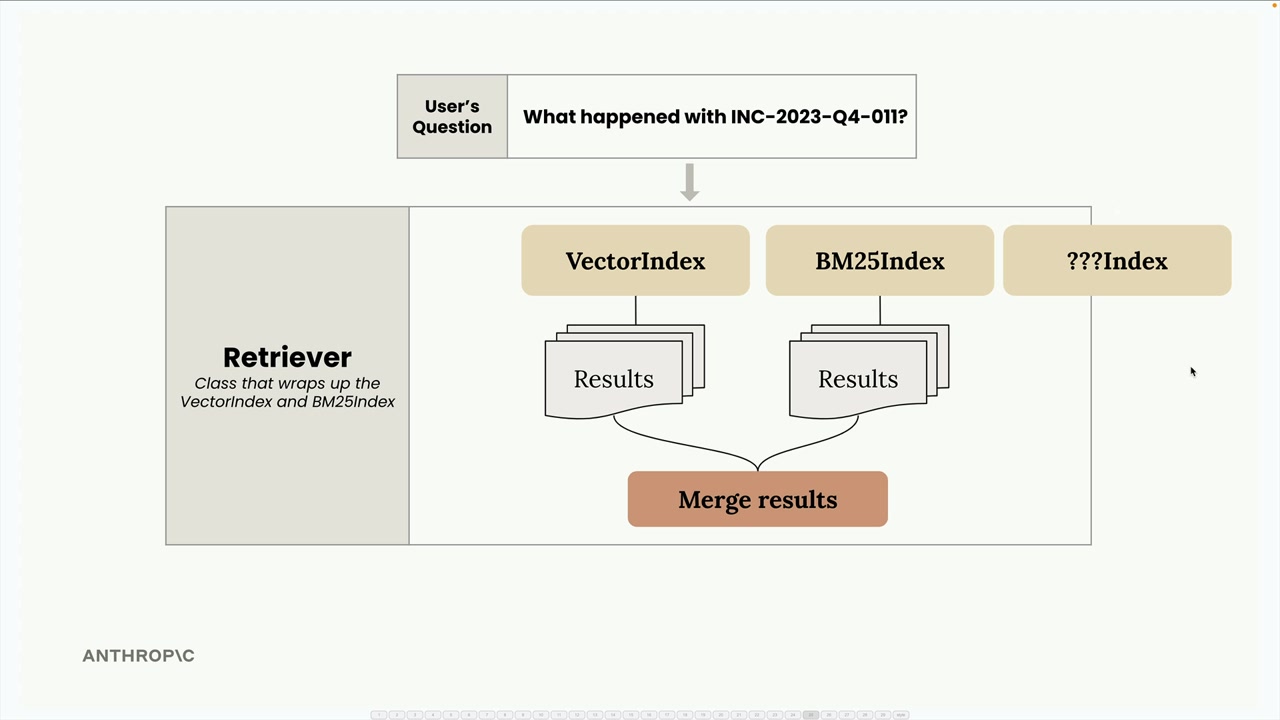
Die Schönheit dieser Architektur liegt in ihrer Erweiterbarkeit. Da alle Indizes dasselbe SearchIndex-Protokoll mit den Methoden add_document() und search() implementieren, kannst du problemlos neue Suchmethoden hinzufügen:
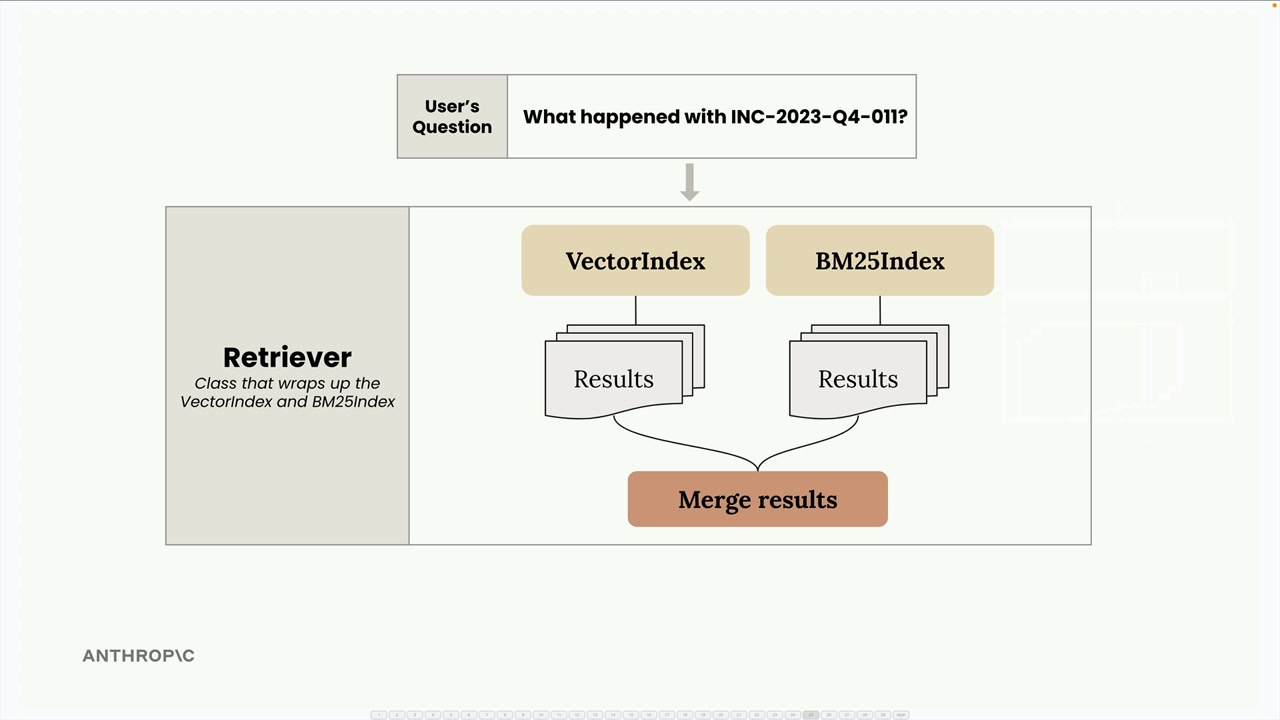
Möchtest du einen schlüsselwortbasierten Index hinzufügen? Eine graphbasierte Suche? Einen spezialisierten Domänenindex? Implementiere einfach dieselbe Schnittstelle, und der Retriever wird ihn automatisch in den Fusionsprozess einbeziehen.
Dieser modulare Ansatz hält jede Suchimplementierung fokussiert und testbar und bietet gleichzeitig eine saubere Möglichkeit, ihre Stärken im endgültigen System zu kombinieren.