现在我们的评估数据集已经准备好了,接下来是构建核心评估流程的时候了。这涉及到获取每个测试用例,将其与我们的提示合并,将其输入给Claude,然后对结果进行评分。
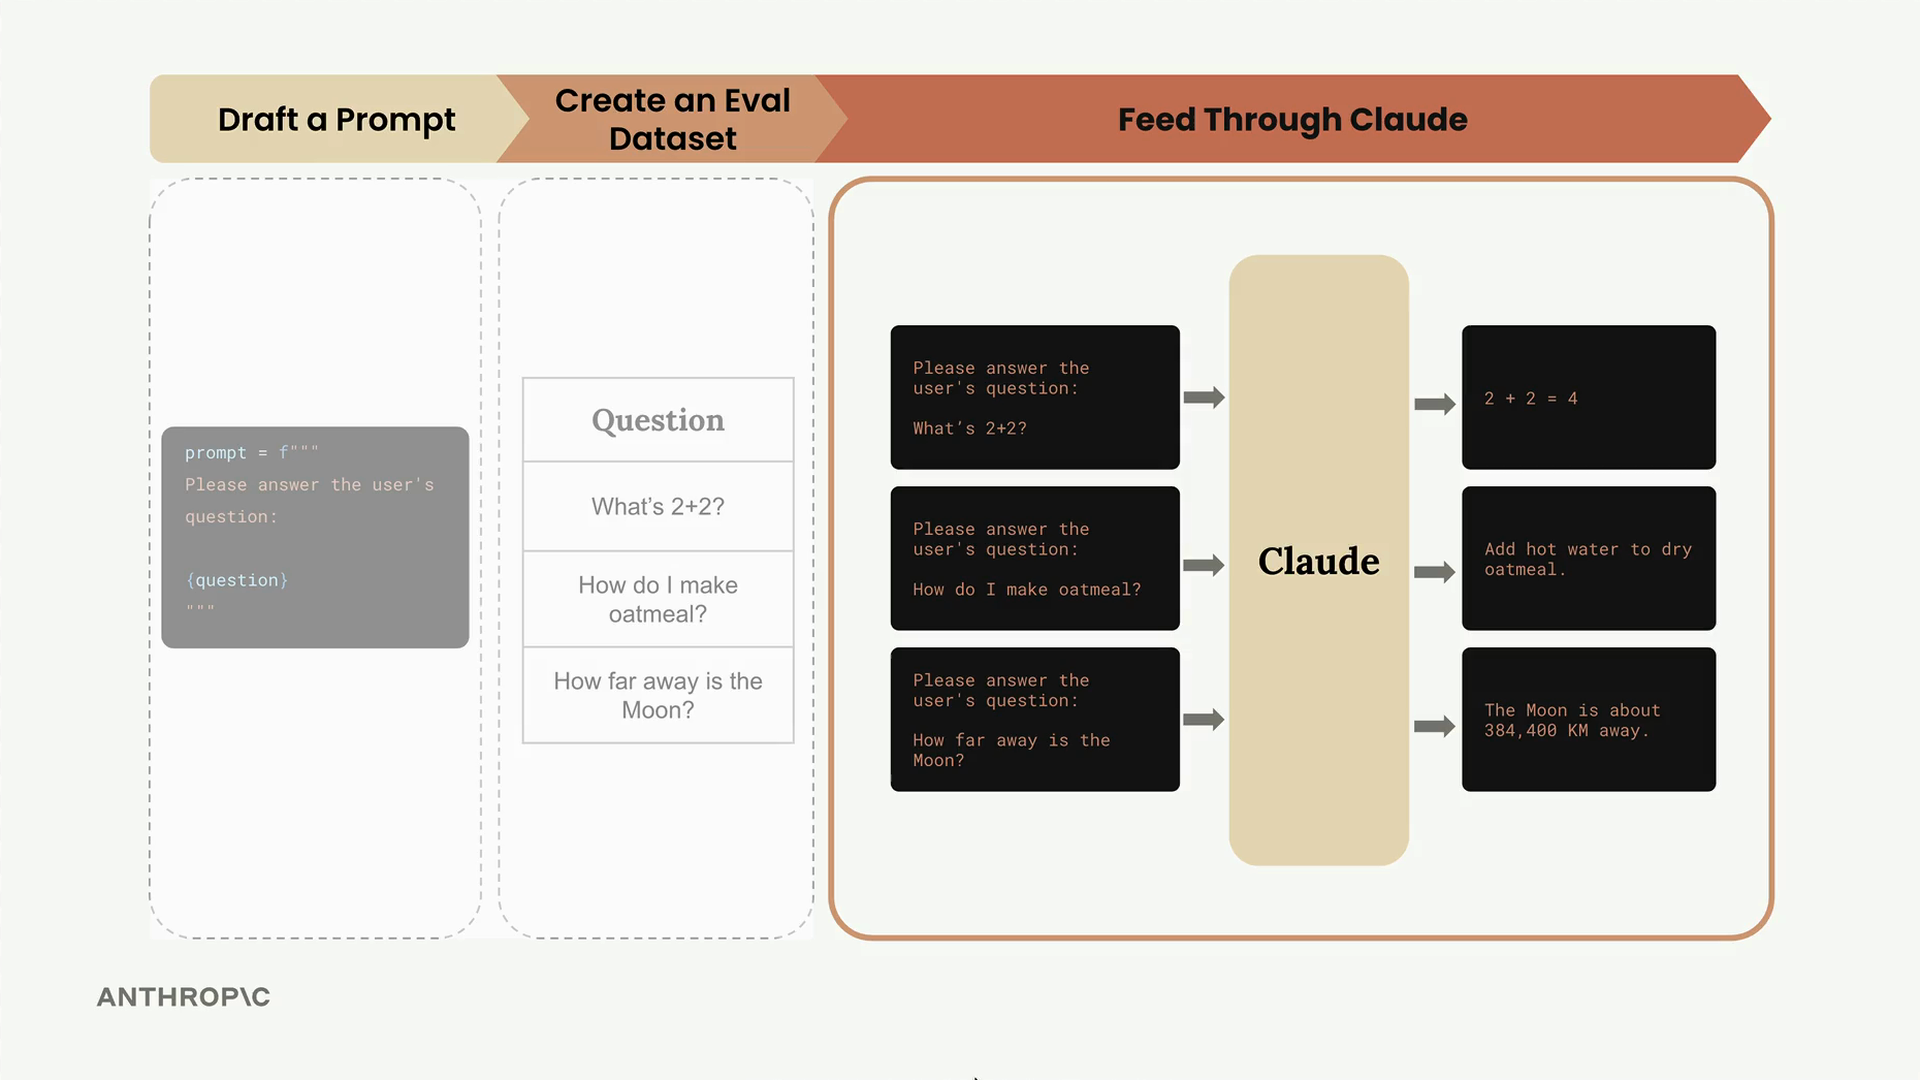
评估过程遵循一个清晰的工作流程:我们获取测试用例数据集,将每个用例与我们的提示模板结合,将其发送给Claude进行处理,然后使用评分系统评估输出结果。
构建核心函数
评估流程由三个主要函数组成,每个函数都有特定的职责。让我们从最简单的函数开始——处理单个提示执行的函数。
run_prompt 函数
这个函数接收一个测试用例,并将其与我们的提示模板合并:
def run_prompt(test_case):
    """Merges the prompt and test case input, then returns the result"""
    prompt = f"""
Please solve the following task:

{test_case["task"]}
"""

    messages = []
    add_user_message(messages, prompt)
    output = chat(messages)
    return output
目前,我们保持提示极其简单。我们没有包含任何格式化指令,这意味着Claude可能会返回比我们需要的更冗长的输出。我们将在迭代评估过程时对此进行改进。
run_test_case 函数
这个函数负责协调运行单个测试用例并对结果进行评分:
def run_test_case(test_case):
    """Calls run_prompt, then grades the result"""
    output = run_prompt(test_case)

    # TODO - 评分
    score = 10

    return {
        "output": output,
        "test_case": test_case,
        "score": score
    }
目前,我们使用的是硬编码的10分。评分逻辑是我们将在接下来的章节中投入大量时间的部分,但这个占位符让我们能够测试整体流程结构。
run_eval 函数
这是处理整个数据集的主要协调器:
def run_eval(dataset):
    """Loads the dataset and calls run_test_case with each case"""
    results = []

    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    return results
这个函数遍历数据集中的每一个测试用例,处理每一个,并将所有结果收集到一个列表中。
运行评估
要执行我们的评估流程,我们加载数据集并调用主函数:
with open("dataset.json", "r") as f:
    dataset = json.load(f)

results = run_eval(dataset)
第一次运行时,预计会花费一些时间——即使使用Claude Haiku,处理完整数据集也可能需要30秒以上。我们稍后会介绍优化技巧,但现在,耐心是关键。
检查结果
评估完成后,您可以通过格式化的JSON输出来检查结果:
print(json.dumps(results, indent=2))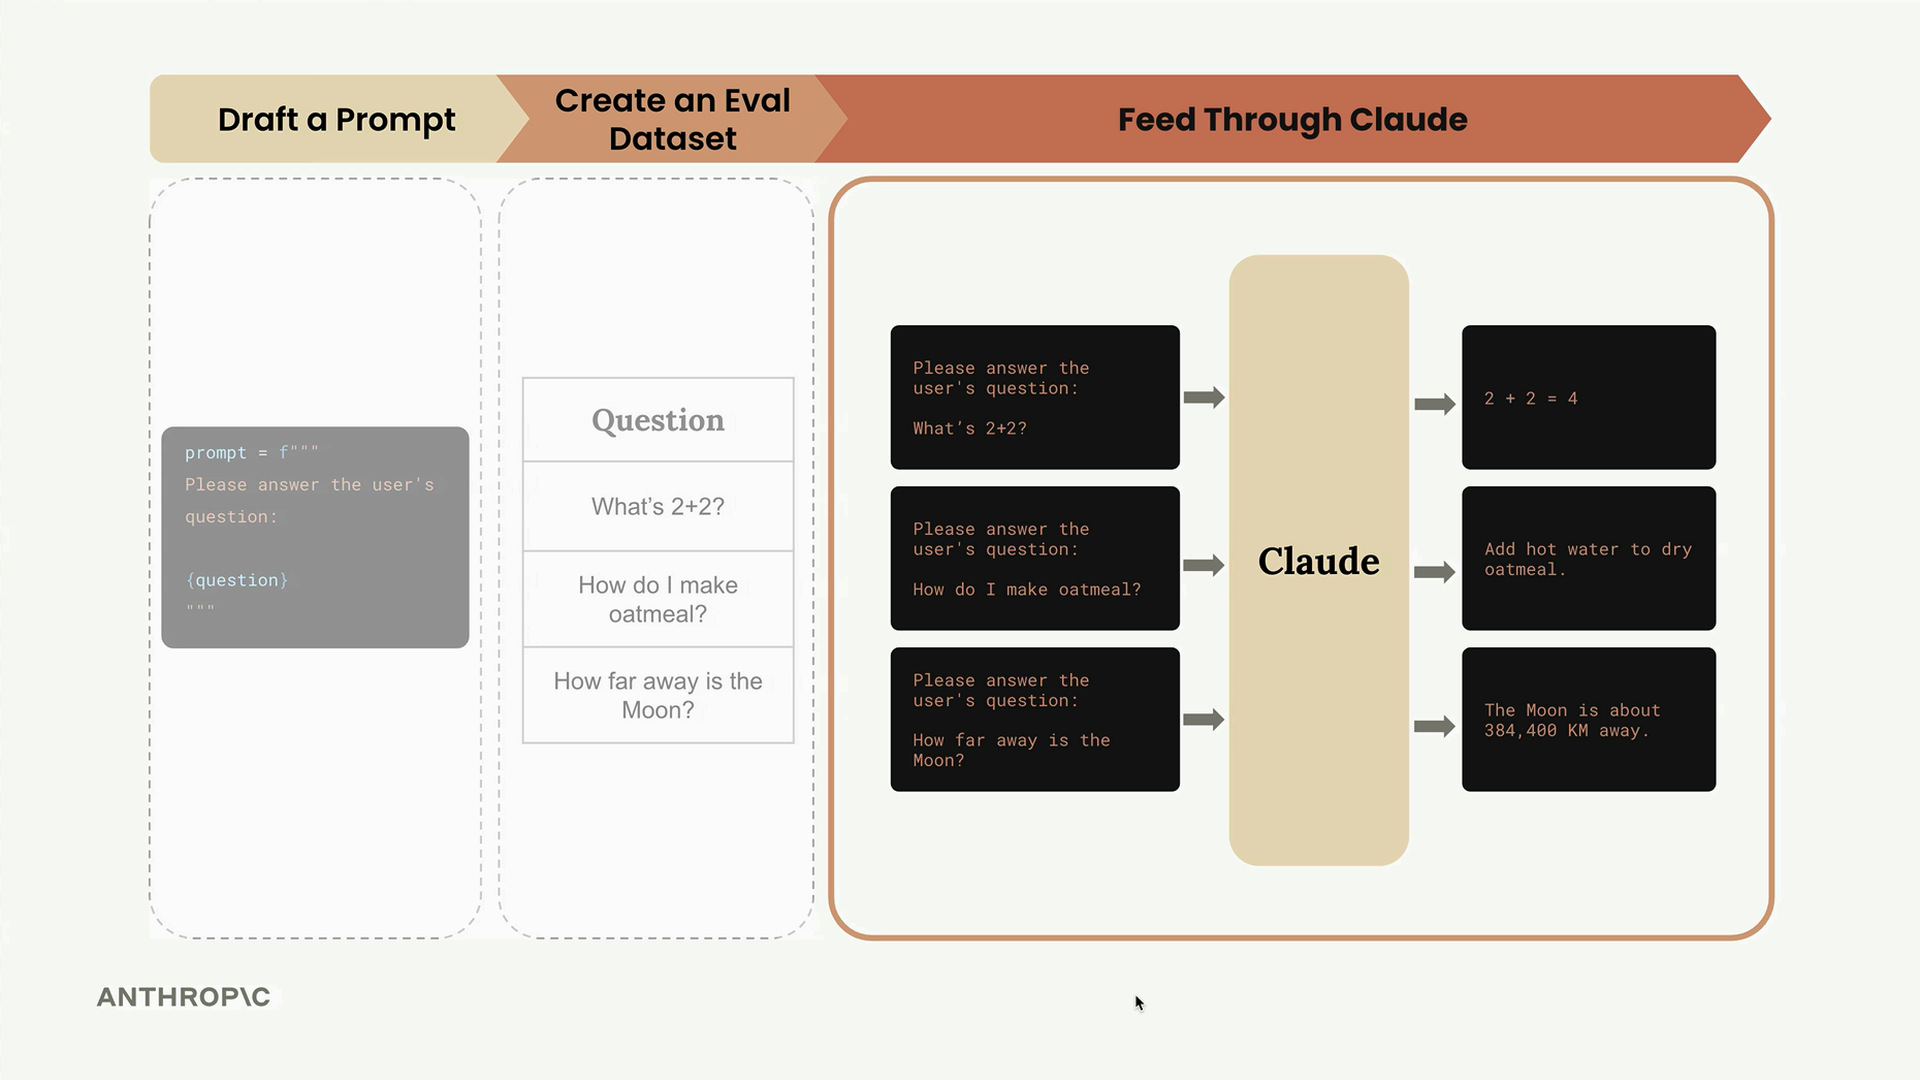
结果结构包含一个对象数组,其中每个对象代表一次测试用例执行。您将看到Claude的输出(在没有格式约束的情况下往往相当冗长)、原始测试用例定义以及分数。
我们已经完成的工作
至此,我们已经成功实现了核心评估流程。我们可以:
- 从数据集中获取测试用例
- 将它们与提示模板合并
- 从Claude获取响应
- 收集并整理所有结果
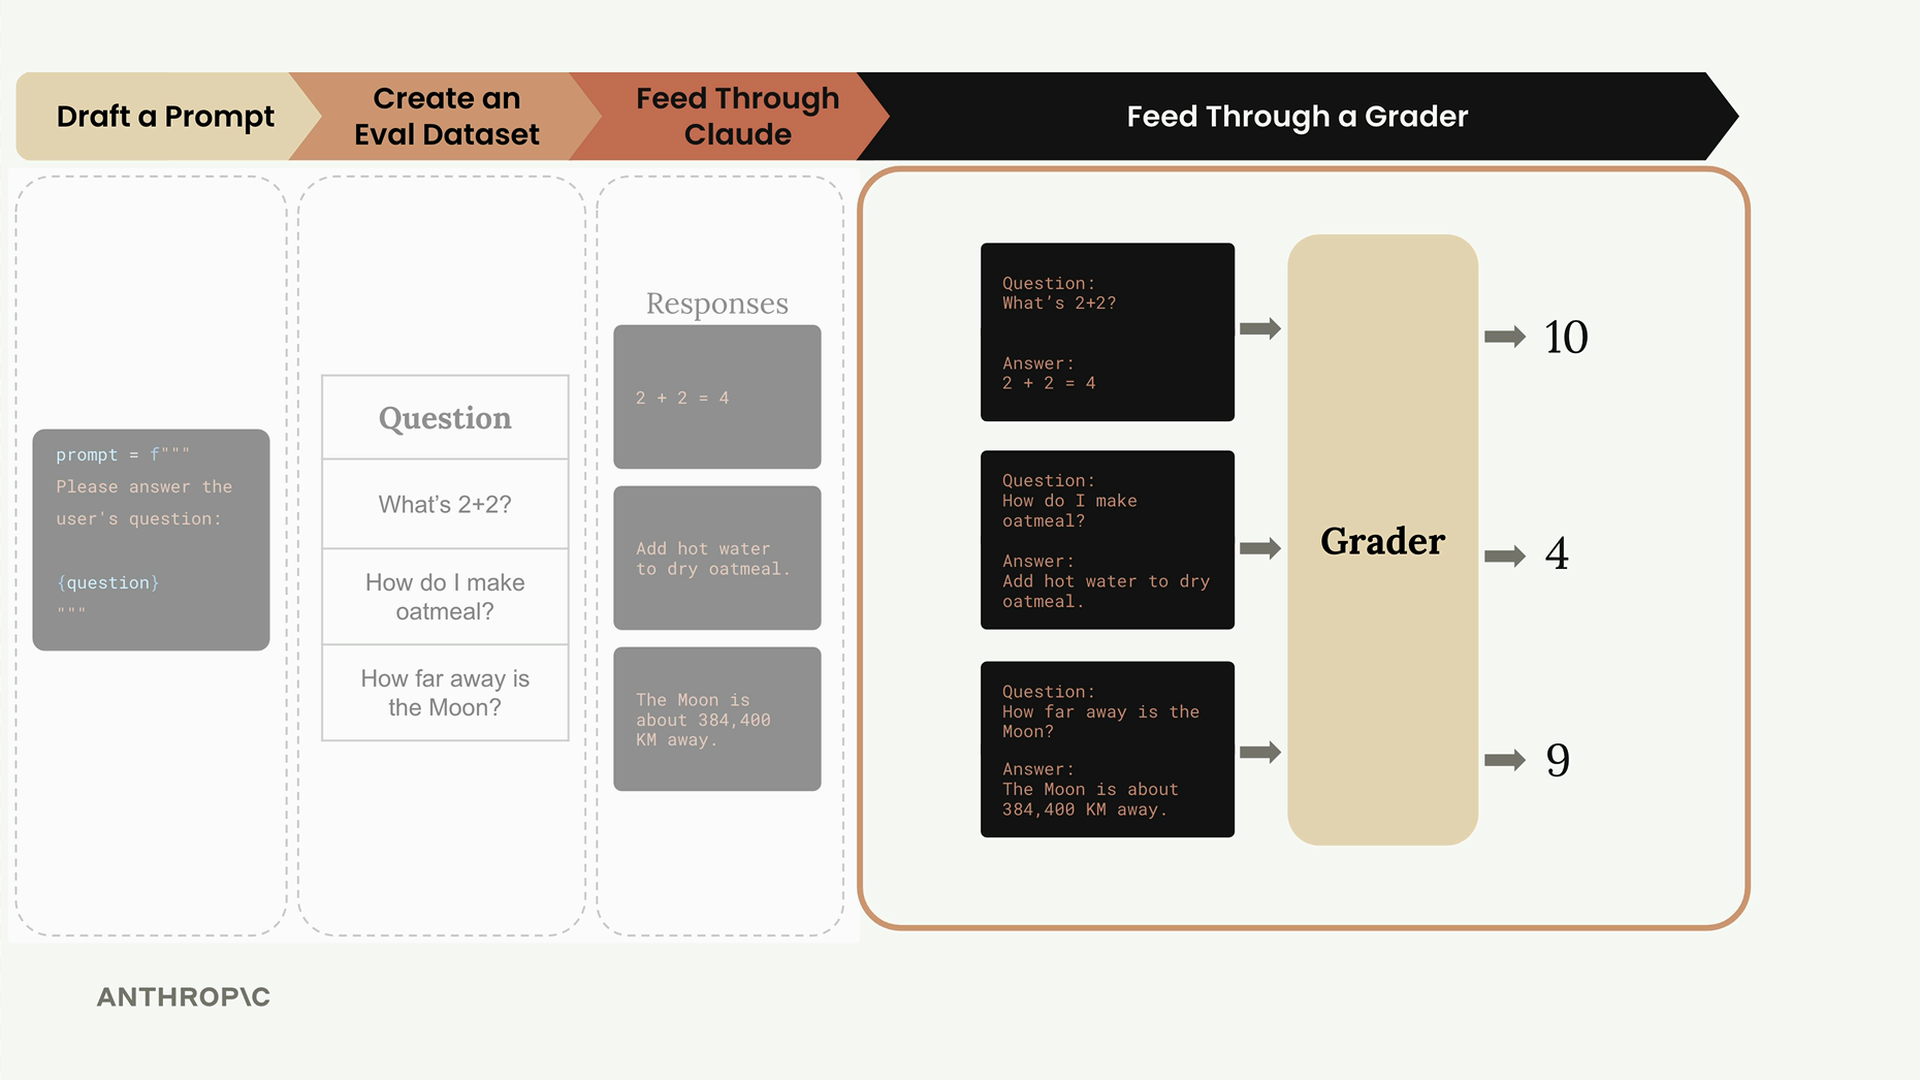
缺失的部分是智能评分——目前我们只是为每个响应分配一个固定分数。下一步是构建能够真正评估Claude输出是否正确的评分器,这正是评估系统真正复杂性所在之处。
这个流程结构可能看起来很简单,但它代表了大多数AI评估系统所建立的基础。复杂性体现在评分逻辑和提示优化上,而不在于运行测试的基本编排上。