我们构建的混合检索方法效果不错,但仍存在一些不完善之处。当您搜索特定术语或使用缩写时,结果可能无法完美排序。例如,询问"工程团队对 INC-2023-Q4-011 做了什么?"可能会首先返回网络安全部分,即使软件工程部分与该特定查询更相关。
基于 LLM 的重新排序
重新排序在合并来自向量索引和 BM25 索引的结果之后,增加了另一个后处理步骤。这个概念很简单:获取您的搜索结果,并要求 Claude 根据与用户问题的相关性对其重新排序。
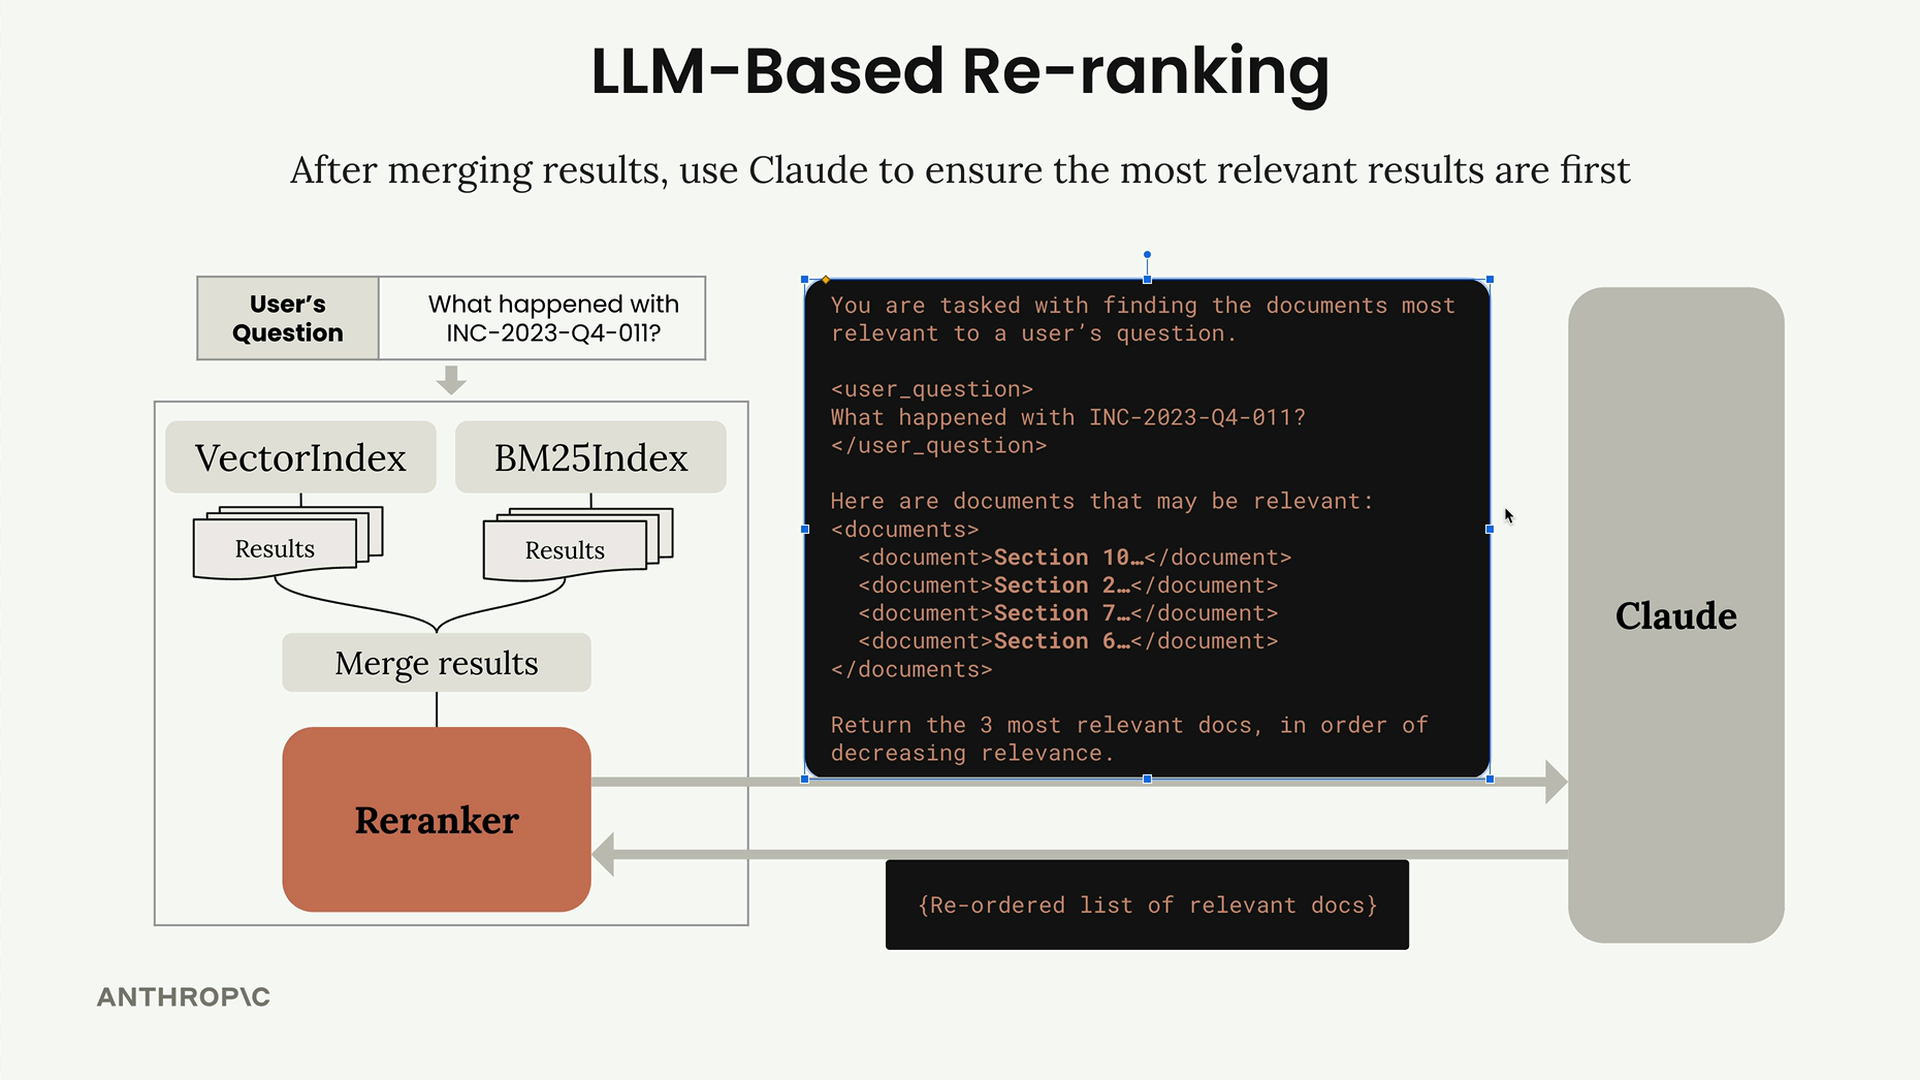
以下是该过程的工作方式:
- 像往常一样运行您的混合搜索(向量 + BM25)
- 像之前一样合并结果
- 将合并后的结果传递给重新排序函数
- 重新排序器将所有内容与特定提示一起发送给 Claude
- Claude 返回一个重新排序的最相关文档列表
系统提示
重新排序提示被设计得清晰而具体。您向 Claude 提供用户的问题以及所有看起来相关的文档,然后要求完成一个简单的任务:按相关性递减的顺序返回最相关的文档。
一个典型的提示结构如下所示:
You are tasked with finding the documents most relevant to a user's question.

<user_question>
What happened with INC-2023-Q4-011?
</user_question>

Here are documents that may be relevant:
<documents>
<document>Section 10...</document>
<document>Section 2...</document>
<document>Section 7...</document>
<document>Section 6...</document>
</documents>

Return the 3 most relevant docs, in order of decreasing relevance.效率考量
要求 Claude 返回完整的文本块会效率低下——您将需要等待 Claude 复制大量文本。相反,应提前为每个文本块分配一个唯一的 ID。然后要求 Claude 仅按正确顺序返回这些 ID。
这种方法要快得多,因为 Claude 只需要返回一个简单的列表,如 ["1p5g", "51n3", "ab83"],而不是复制整个文档部分。
实现
重新排序函数在初始混合搜索之后由您的检索器自动调用。以下是基本结构:
python
def reranker_fn(docs, query_text, k):
    # 格式化带 ID 的文档
    joined_docs = "\n".join([
        f"<document><document_id>{doc['id']}</document_id>"
        f"<document_content>{doc['content']}</document_content></document>"
        for doc in docs
    ])

    # 使用用户问题和文档创建提示
    prompt = f"""You are about to be given a set of documents...
    {query_text}
    {joined_docs}
    """

    # 获取 Claude 的响应并解析文档 ID
    result = chat(messages, stop_sequences=["```"])
    return json.loads(result["text"])["document_ids"]
结果
当您使用类似"工程团队对 INC-2023-Q4-011 做了什么?"这样的查询测试重新排序器时,您应该会在顶部看到更相关的结果。Claude 理解上下文,能够识别出关于工程团队的查询应该优先考虑软件工程部分,而不是仅仅提及该事件的其他部分。
这种权衡是显而易见的:重新排序会增加延迟,因为您需要等待 Claude 的响应,但它通过利用 Claude 对上下文和相关性的理解,显著提高了搜索准确性。