扩展思考是Claude的一项高级功能,它让模型在生成最终响应之前有时间对复杂问题进行推理。可以把它想象成Claude的内心独白——您可以看到它是如何一步步处理您的问题的。
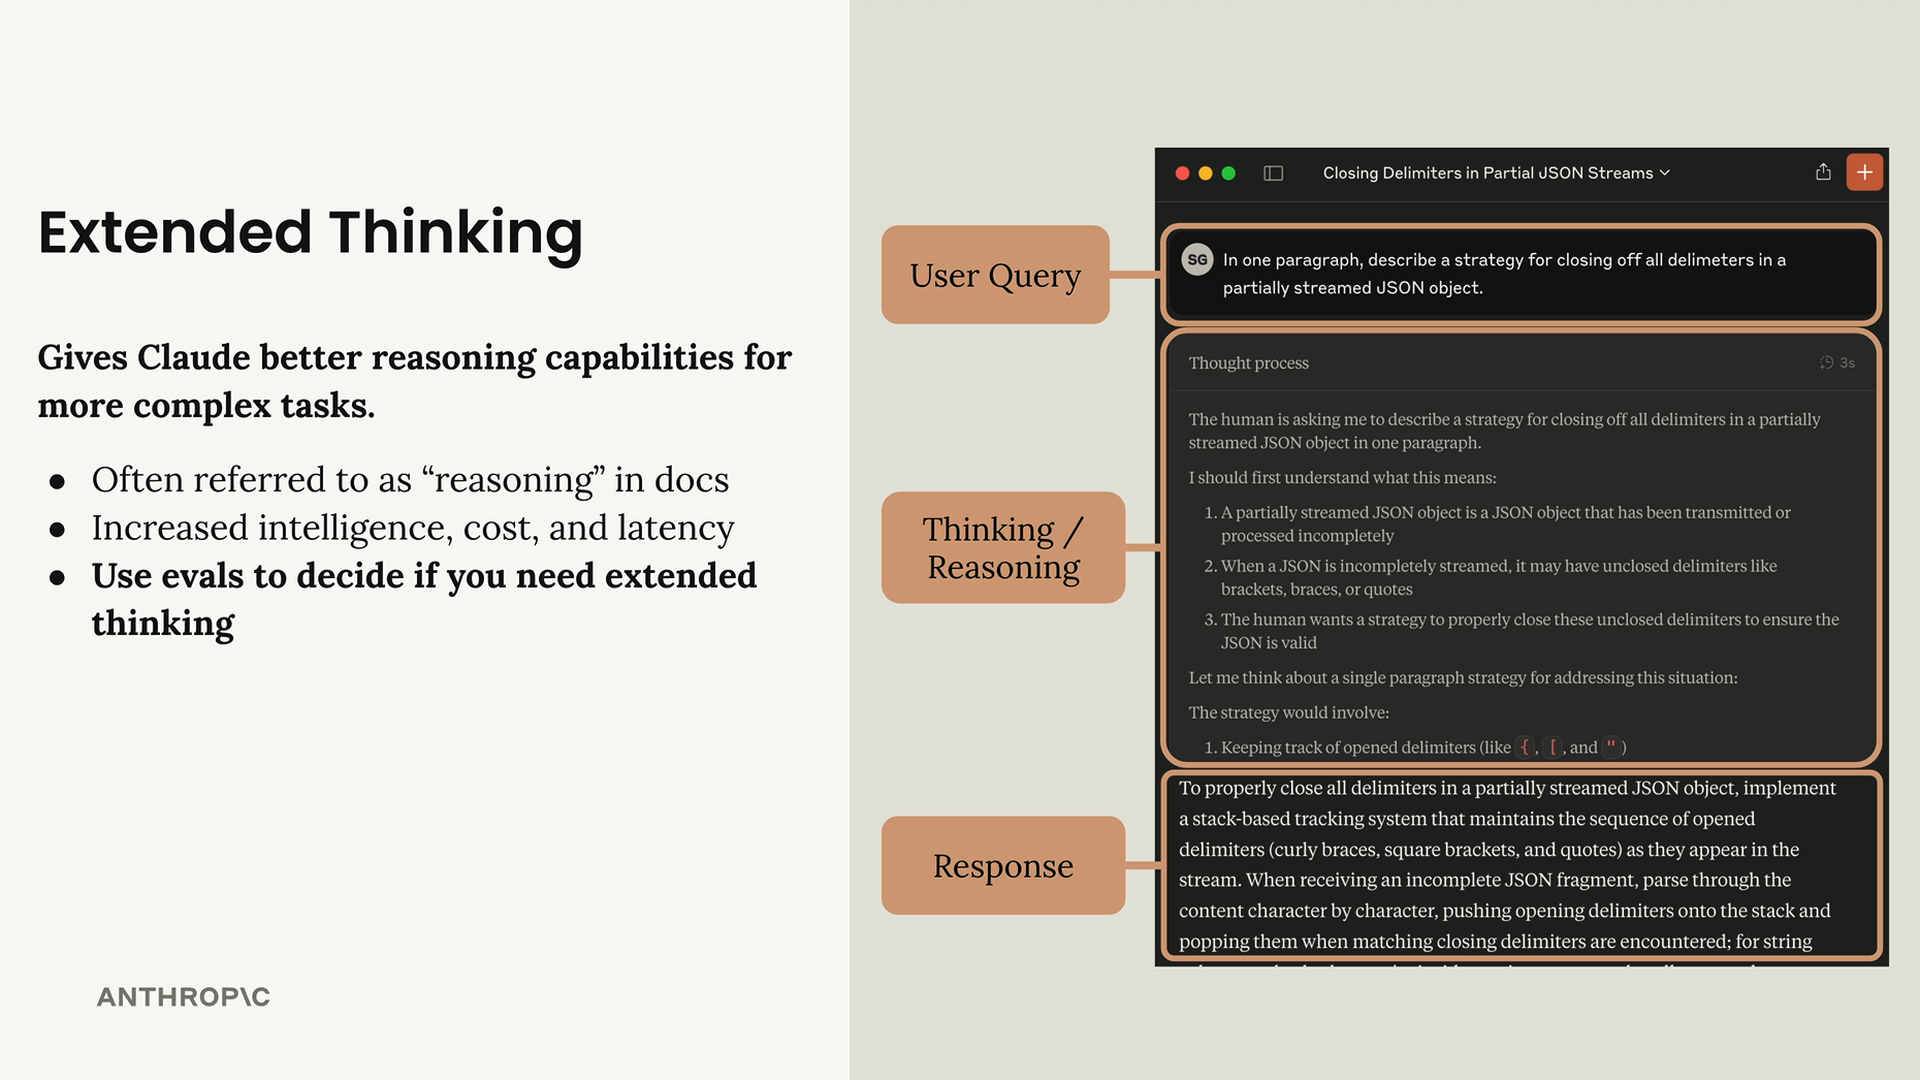
扩展思考的工作原理
当您启用扩展思考时,Claude的响应将包含两个部分,而不是一个:
- 推理内容部分 - Claude的内部思考过程
- 文本部分 - 您实际想要的最终响应
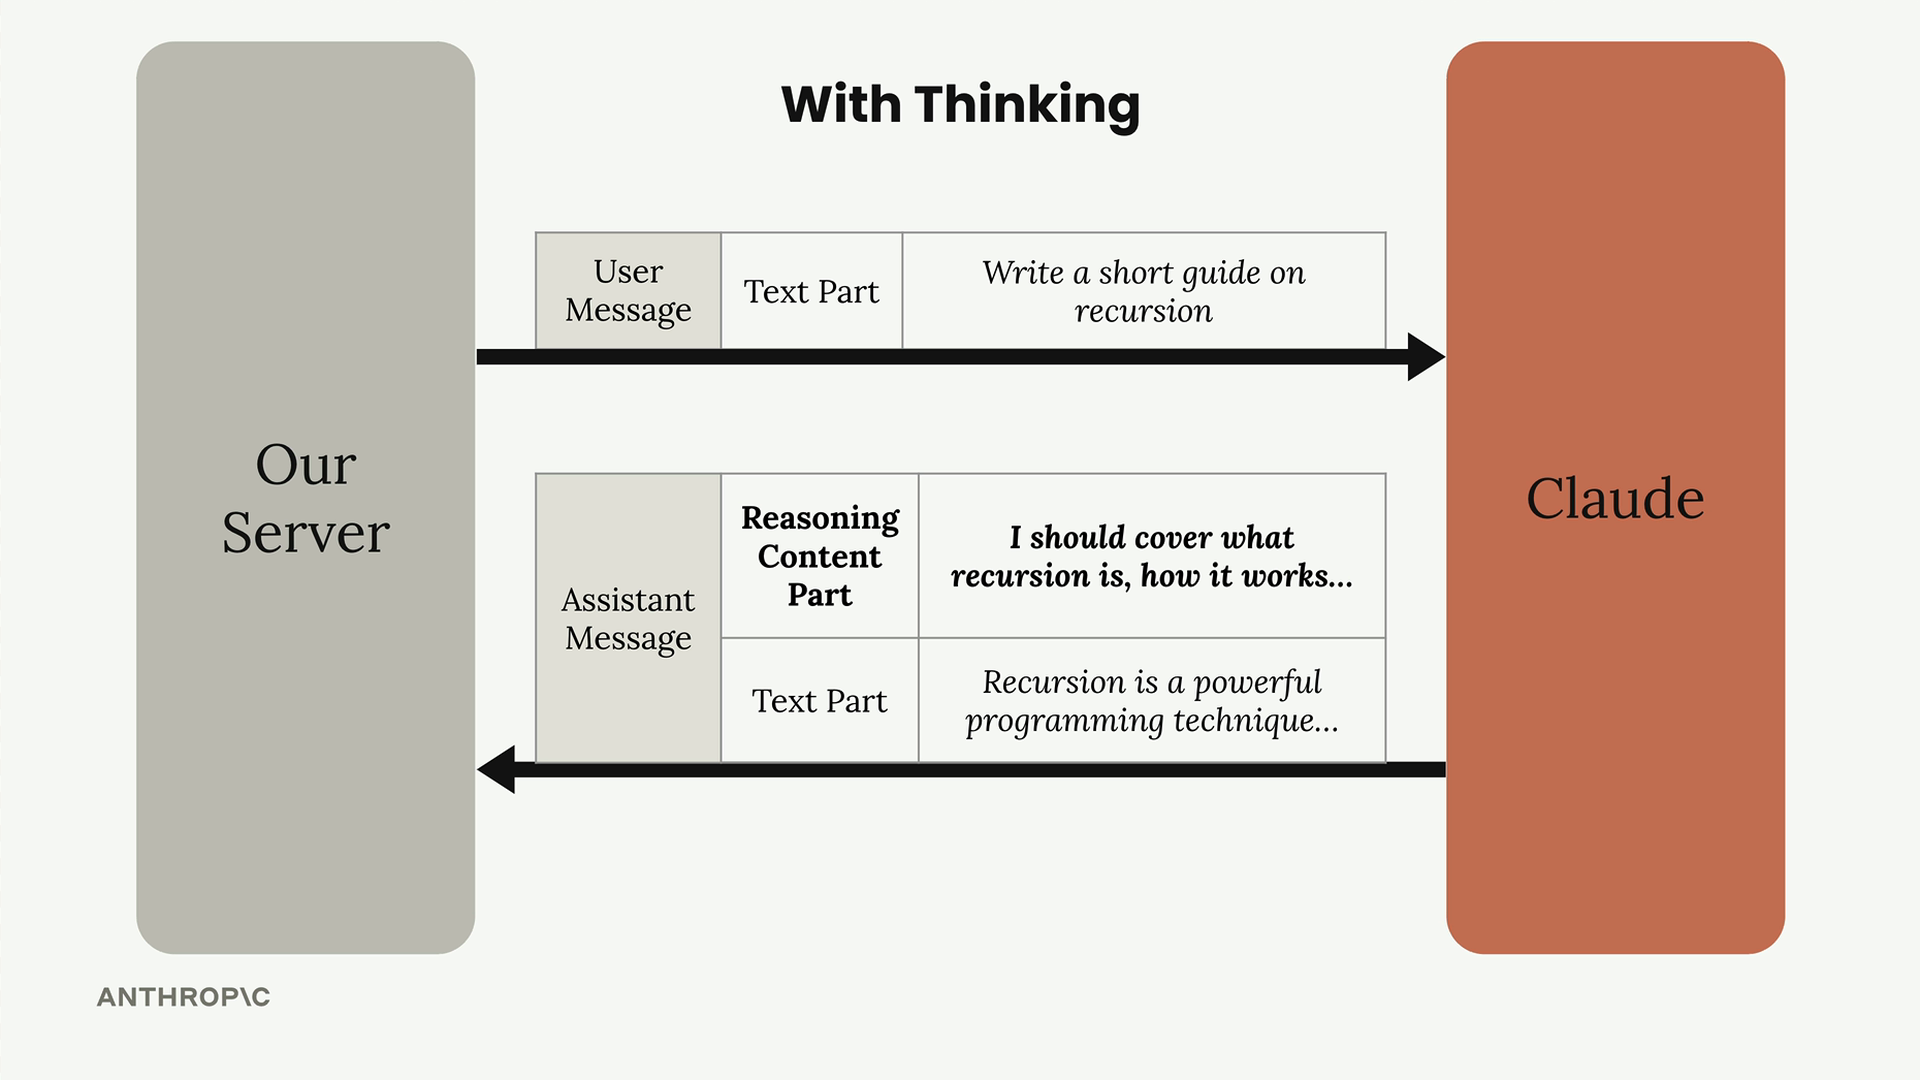
推理内容向您准确展示了Claude是如何分解您的问题、考虑了哪些因素,以及如何得出最终答案的。这种透明度对于理解和调试复杂任务非常有价值。
需要考虑的权衡
扩展思考带来了明显的好处和成本:
- 在复杂任务上更高的准确性
- 更高的成本 - 您需要为所有思考令牌付费
- 增加的延迟 - 思考需要时间
关键的决策点很简单:使用您的评估。如果您已经优化了提示,但仍未获得所需的准确性,那就是考虑使用扩展思考的时候了。
签名系统
您会立即注意到的一个重要细节是附加在推理内容上的加密签名:
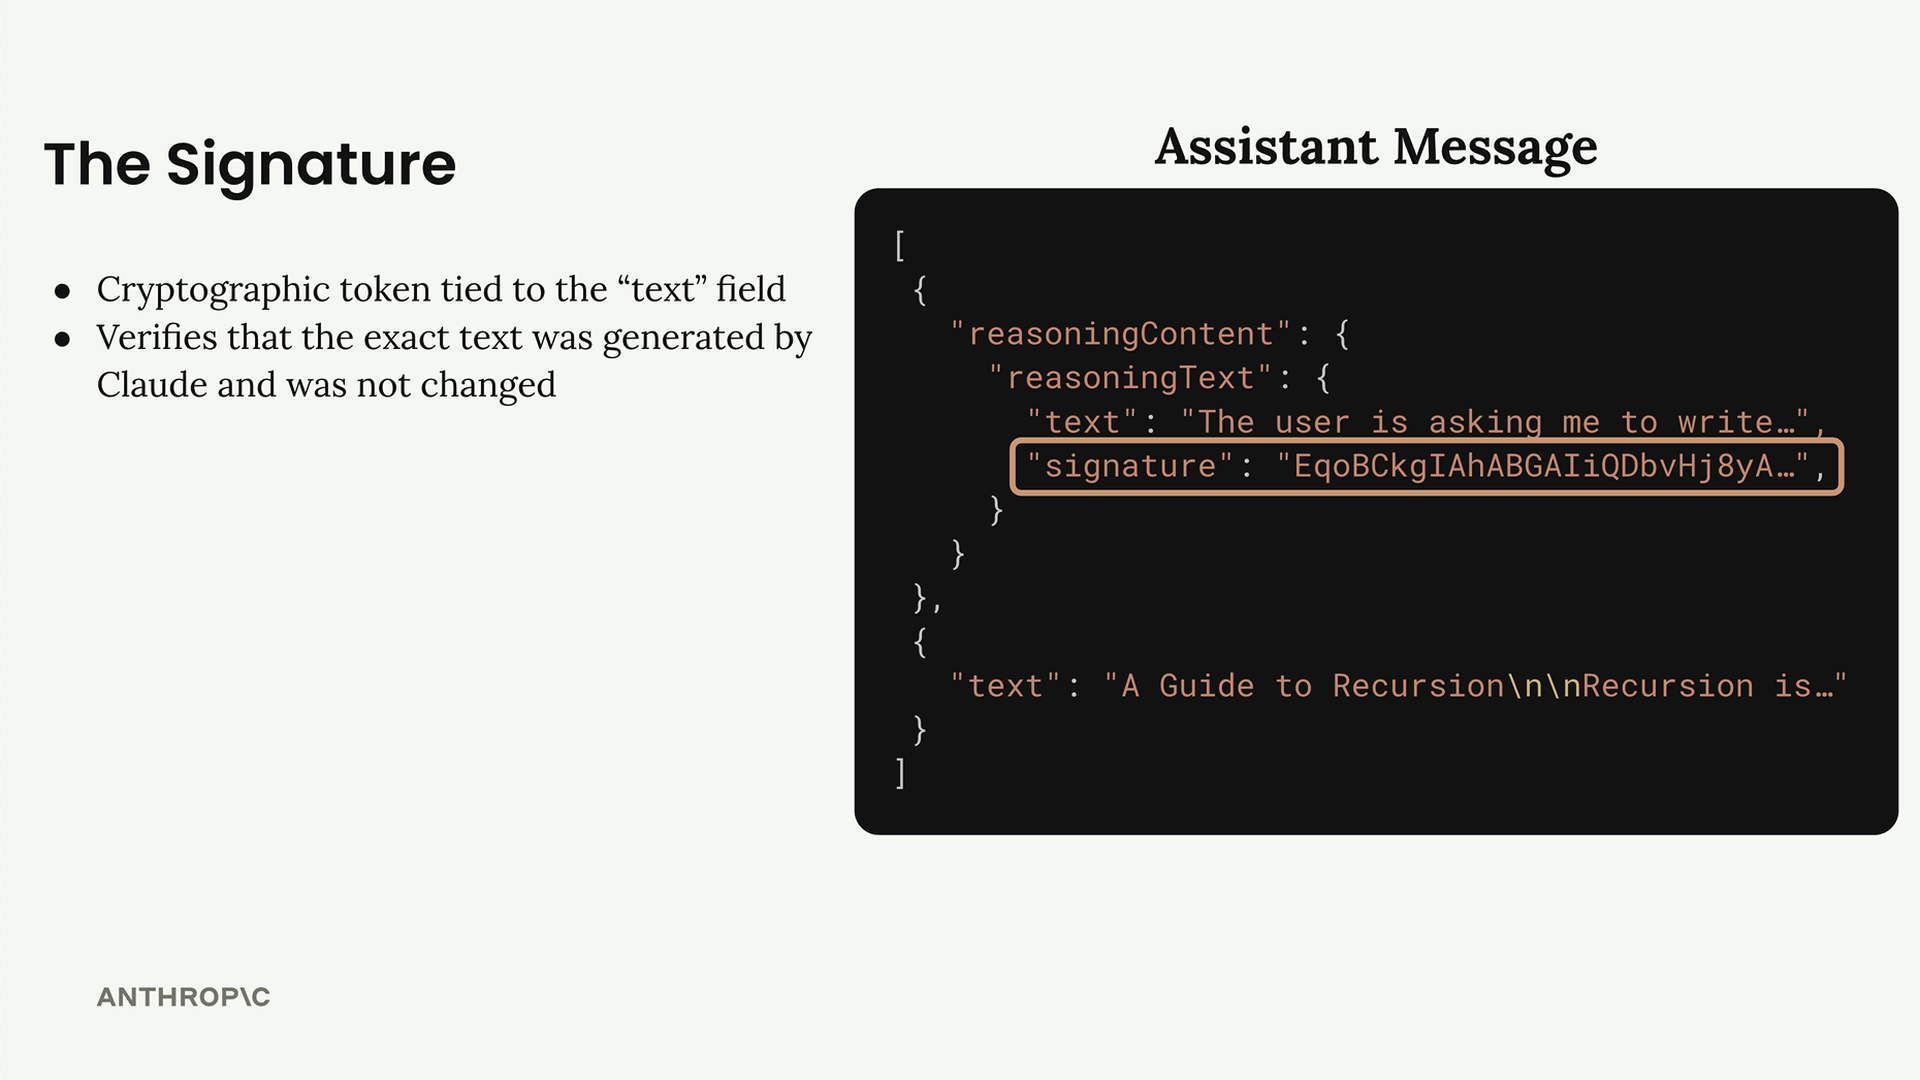
此签名确保您无法修改思考文本。如果您想在后续对话中包含Claude之前的推理内容,该签名会验证内容未被篡改。这可以防止因修改推理文本而产生的潜在安全问题。
已编辑内容
有时Claude的思考会被安全系统标记。发生这种情况时,您将收到一个redactedContent字段,而不是可读的思考文本:
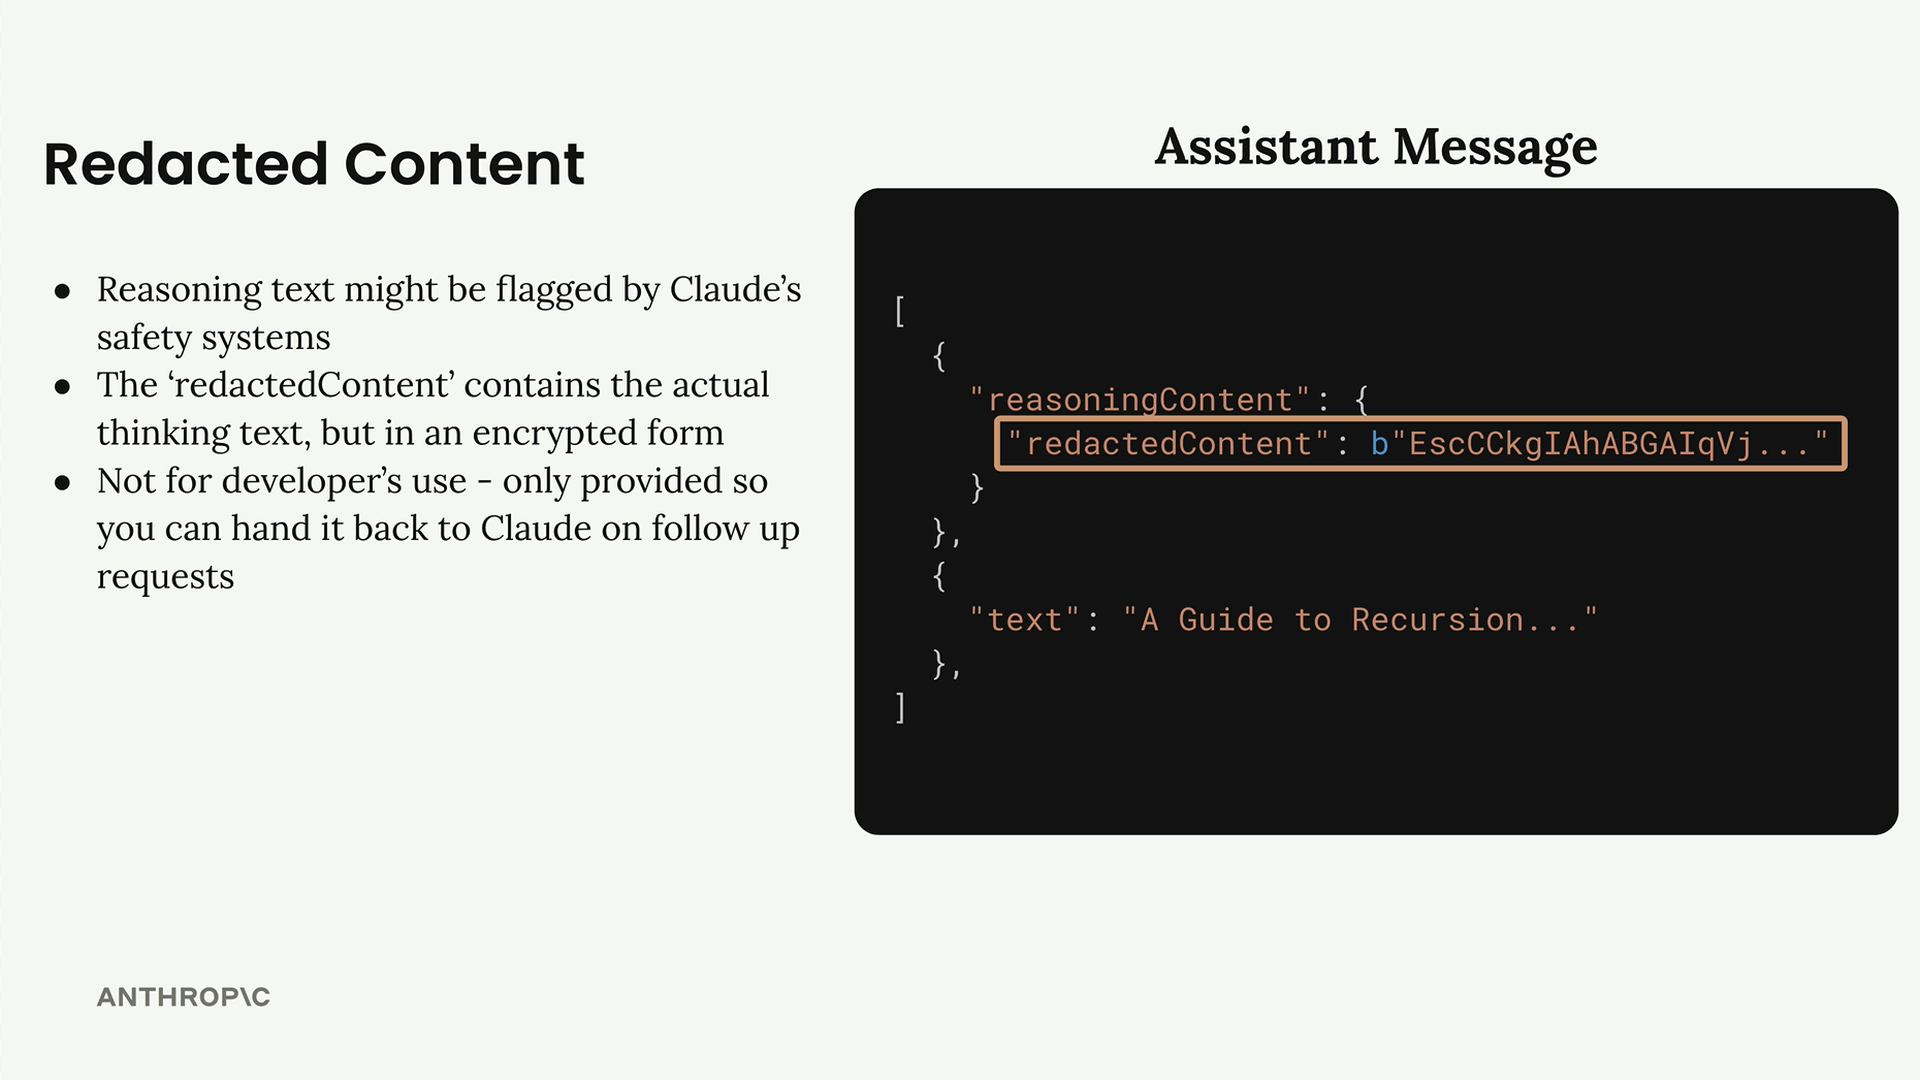
已编辑的内容是加密的,但仍然可用——您可以在未来的对话中将其传回给Claude,而不会丢失上下文。只是作为开发者,您无法读取它。
实现
在当前的Claude模型上,例如Claude Opus 5和Claude Sonnet 5,思考以自适应思考的方式运行,并且默认开启:Claude会自行决定每个请求需要多少推理,无需管理令牌预算。这些模型默认会省略推理文本,除非您要求显示它,因此请将display设置为summarized以查看它:
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}启用自适应思考后,简单的问题通常会很快返回,而较难的问题则会获得更多的推理时间。为了引导Claude思考的程度,您可以将自适应思考与effort参数结合使用。effort级别作为Claude思考分配的软性指导,它取代了您原本需要手动管理的令牌预算。
如果您之前使用过扩展思考,请注意手动配置正在逐步淘汰:在Claude Opus 4.6和Claude Sonnet 4.6上,带有budget_tokens的thinking.type: "enabled"已被弃用,而Claude Opus 4.7及更高版本的模型(包括Claude Opus 5和Claude Sonnet 5)不再支持它,并会以400错误拒绝此类请求。请改用带有effort参数的thinking.type: "adaptive"。
不支持自适应思考的模型
Claude 4.5系列模型(Claude Haiku 4.5、Claude Sonnet 4.5和Claude Opus 4.5)及更早的模型不支持自适应思考。在这些模型上,您需要通过手动令牌预算来启用扩展思考:
additional_model_fields["thinking"] = {
    "type": "enabled",
    "budget_tokens": thinking_budget
}thinking_budget控制Claude可以在推理上花费多少令牌。最小值为1024个令牌,但对于复杂问题,您可能需要更多。与Claude的其他一切一样,使用您的评估来为您的用例找到合适的预算。
以下是更新后的聊天函数的样子:
def chat(
    messages,
    system=None,
    temperature=1.0,
    stop_sequences=[],
    tools=None,
    tool_choice="auto",
    text_editor=None,
    thinking=False,
    thinking_budget=1024
):
测试您的实现
在构建处理扩展思考的应用程序时,您需要测试正常推理内容和已编辑内容两种场景。实际上有一个特殊的测试字符串可以强制Claude返回已编辑内容——这对于确保您的代码能正确处理这两种情况很有用。
关于扩展思考最重要的一点是,使用它的决定应始终以数据为依据。先运行您的评估,优化您的提示,只有在需要为复杂任务提升准确性时,才考虑使用扩展思考。这种纪律性建立在一个简单的习惯之上:在您追求更强能力之前,先确定"好"的标准是什么样子。当您知道任务所需的准确性时,您就能判断扩展思考是否值得其成本,而不是靠猜测。
练习:亲自运行自适应思考
理解自适应思考最简单的方法是观察它做决策的过程。在您一直在构建聊天函数的代码中,将其开启:
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}现在通过这个相同的配置发送两个请求。首先问一个您已经知道答案的简单事实性问题。然后问一个真正困难的问题,比如您自己工作中的一个多步骤分析问题。如果您使用的模型不支持自适应思考,请使用上一节中的手动budget_tokens配置启用思考,并运行相同的两个请求。
检查思考做了什么
设置该标志只能证明请求被接受了。以下检查可以告诉您思考实际做了什么:
- 确认思考已启用。 现在每个响应应该包含两个部分——推理内容和最终文本,而不仅仅是文本。唯一的例外是已编辑内容,您之前已经见过:
redactedContent字段意味着思考已经运行,但文本是加密的。 - 阅读推理内容。 检查它是否真正对您提出的问题进行了推理,而不是简单地复述问题。这与您稍后调试复杂任务时所依赖的透明度是一样的。
- 比较两个请求。 简单的问题通常会很快返回,推理较少,而困难的问题则会明显获得更多推理。这种差异就是自适应思考为您做出的分配决策。
- 权衡成本。 您需要为每个思考令牌付费,因此请检查较难问题的答案是否比不使用思考时更好。您的评估才是判断这一点的依据,看到推理文本出现并不能替代它们。
从本课中值得保留的行为是:每当您在新任务上启用扩展思考时,请阅读几个有代表性请求的推理内容,并在决定保留该设置之前重新运行您的评估。