Ahora que hemos cubierto los fundamentos de RAG, la fragmentación de texto y los embeddings, repasemos el pipeline completo de RAG paso a paso. Este ejemplo detallado te mostrará exactamente cómo todas las piezas se encajan en una implementación real.
Paso 1: Fragmenta tu texto fuente
Primero, tomamos nuestro documento fuente y lo dividimos en fragmentos manejables. Para este ejemplo, usaremos dos secciones de texto simples:
- Sección 1: Investigación Médica - "Este año vimos avances significativos en nuestra comprensión de XDR-47, un 'bicho' que no habíamos visto antes."
- Sección 2: Ingeniería de Software - "Esta división dedicó un esfuerzo significativo a estudiar varios vectores de infección en nuestros sistemas distribuidos"
Paso 2: Genera embeddings
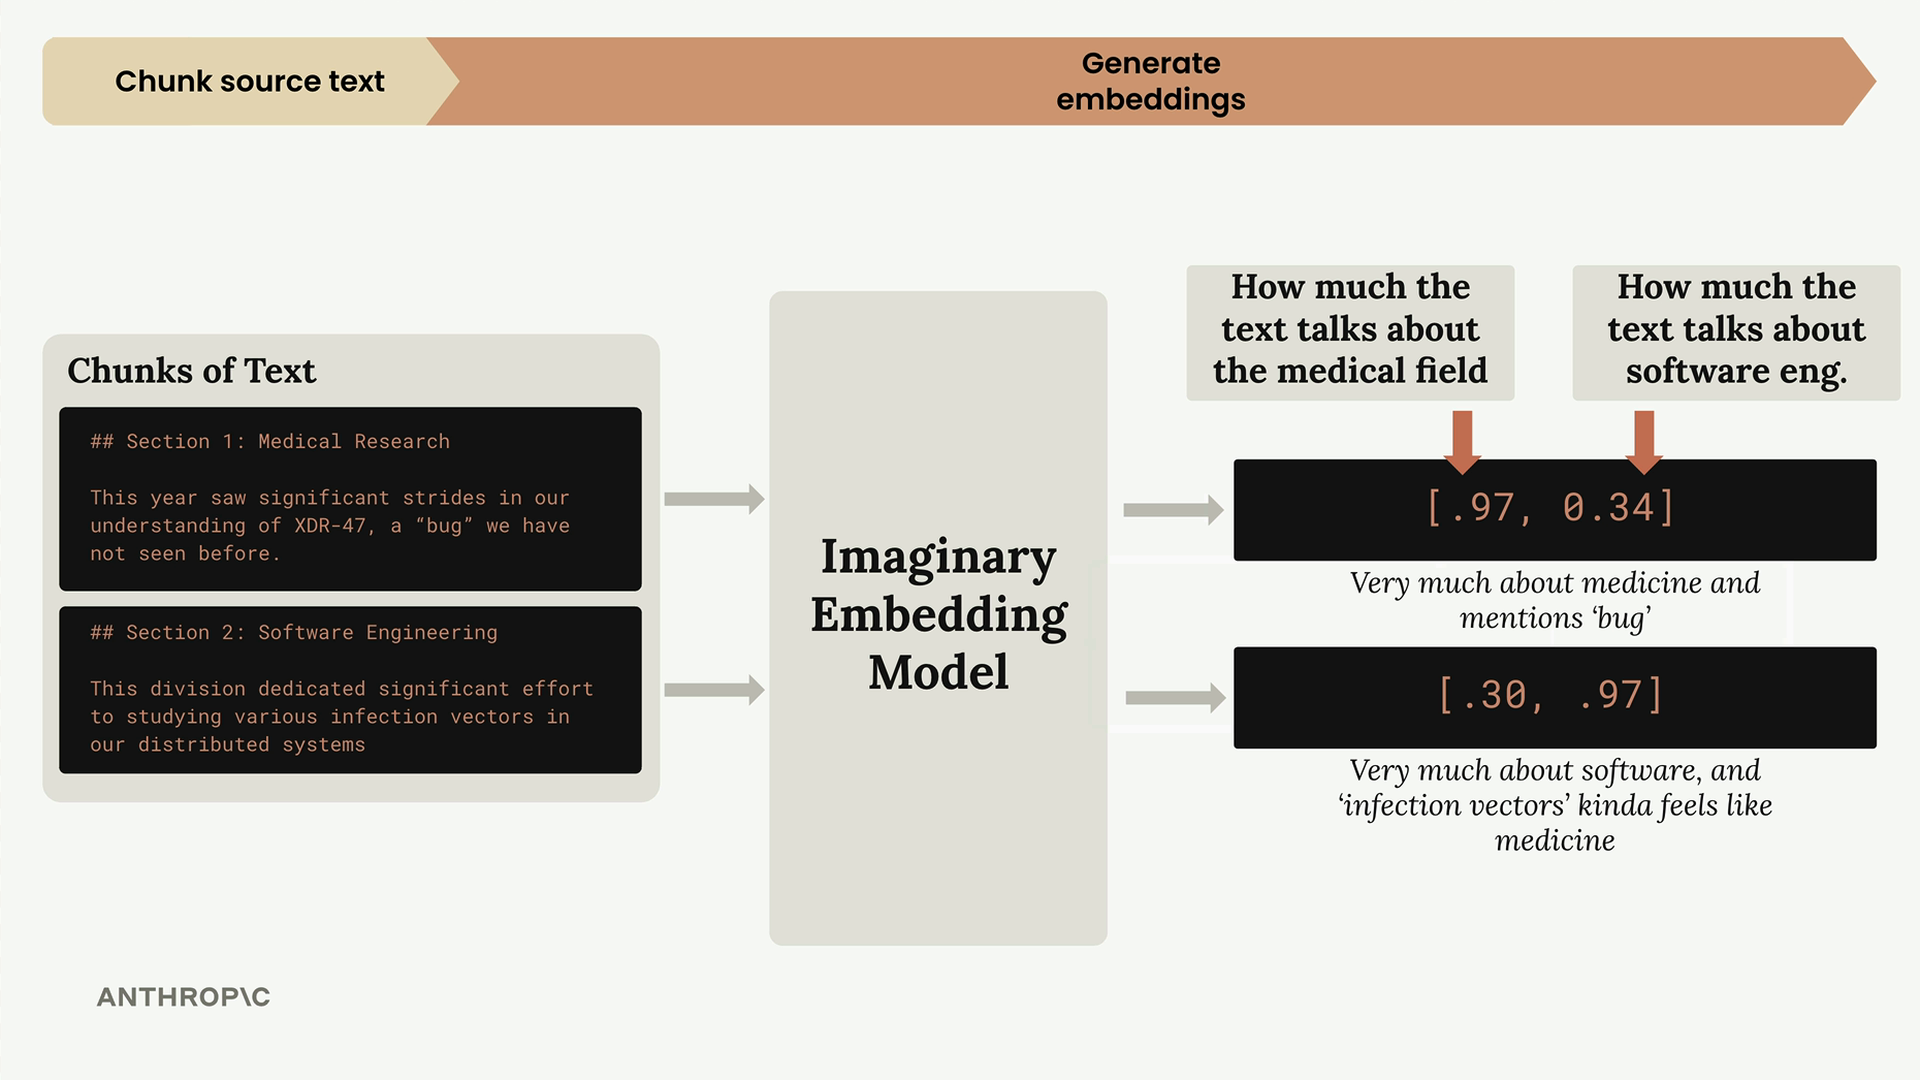
A continuación, convertimos cada fragmento de texto en embeddings numéricos. Para que esto sea más fácil de entender, imaginemos que tenemos un modelo de embeddings perfecto que siempre devuelve exactamente dos números, y sabemos qué representa cada número:
En nuestro modelo imaginario:
- Primer número: Cuánto habla el texto de medicina
- Segundo número: Cuánto habla el texto de ingeniería de software
Así que nuestra sección de investigación médica obtiene [0.97, 0.34] - muy médica, algo relacionada con software debido a la palabra "bicho" (bug). La sección de ingeniería de software obtiene [0.30, 0.97] - muy enfocada en software, pero "vectores de infección" tiene connotaciones médicas.
Normalización
Antes de almacenar estos embeddings, pasan por un proceso de normalización que escala cada vector para que tenga una magnitud de 1.0. Esto normalmente lo maneja automáticamente tu API de embeddings, pero es importante entender que sucede.
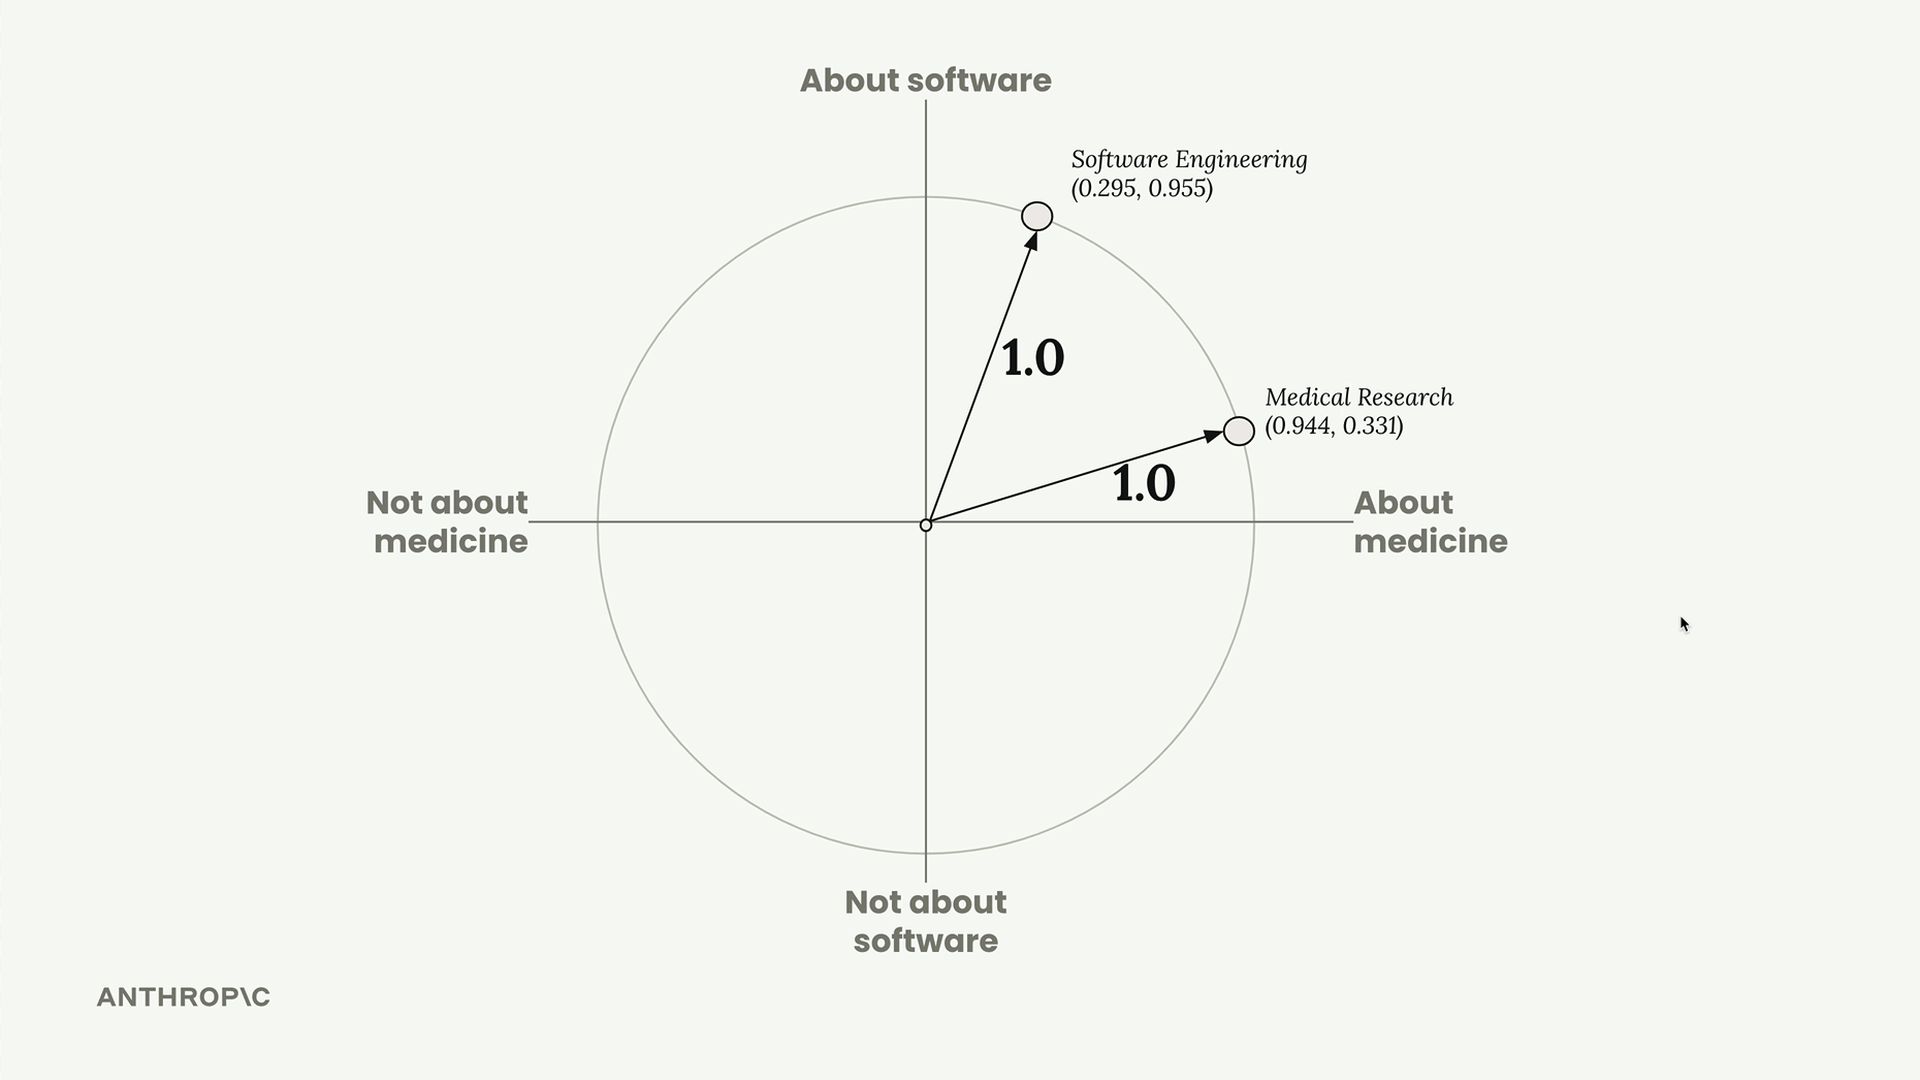
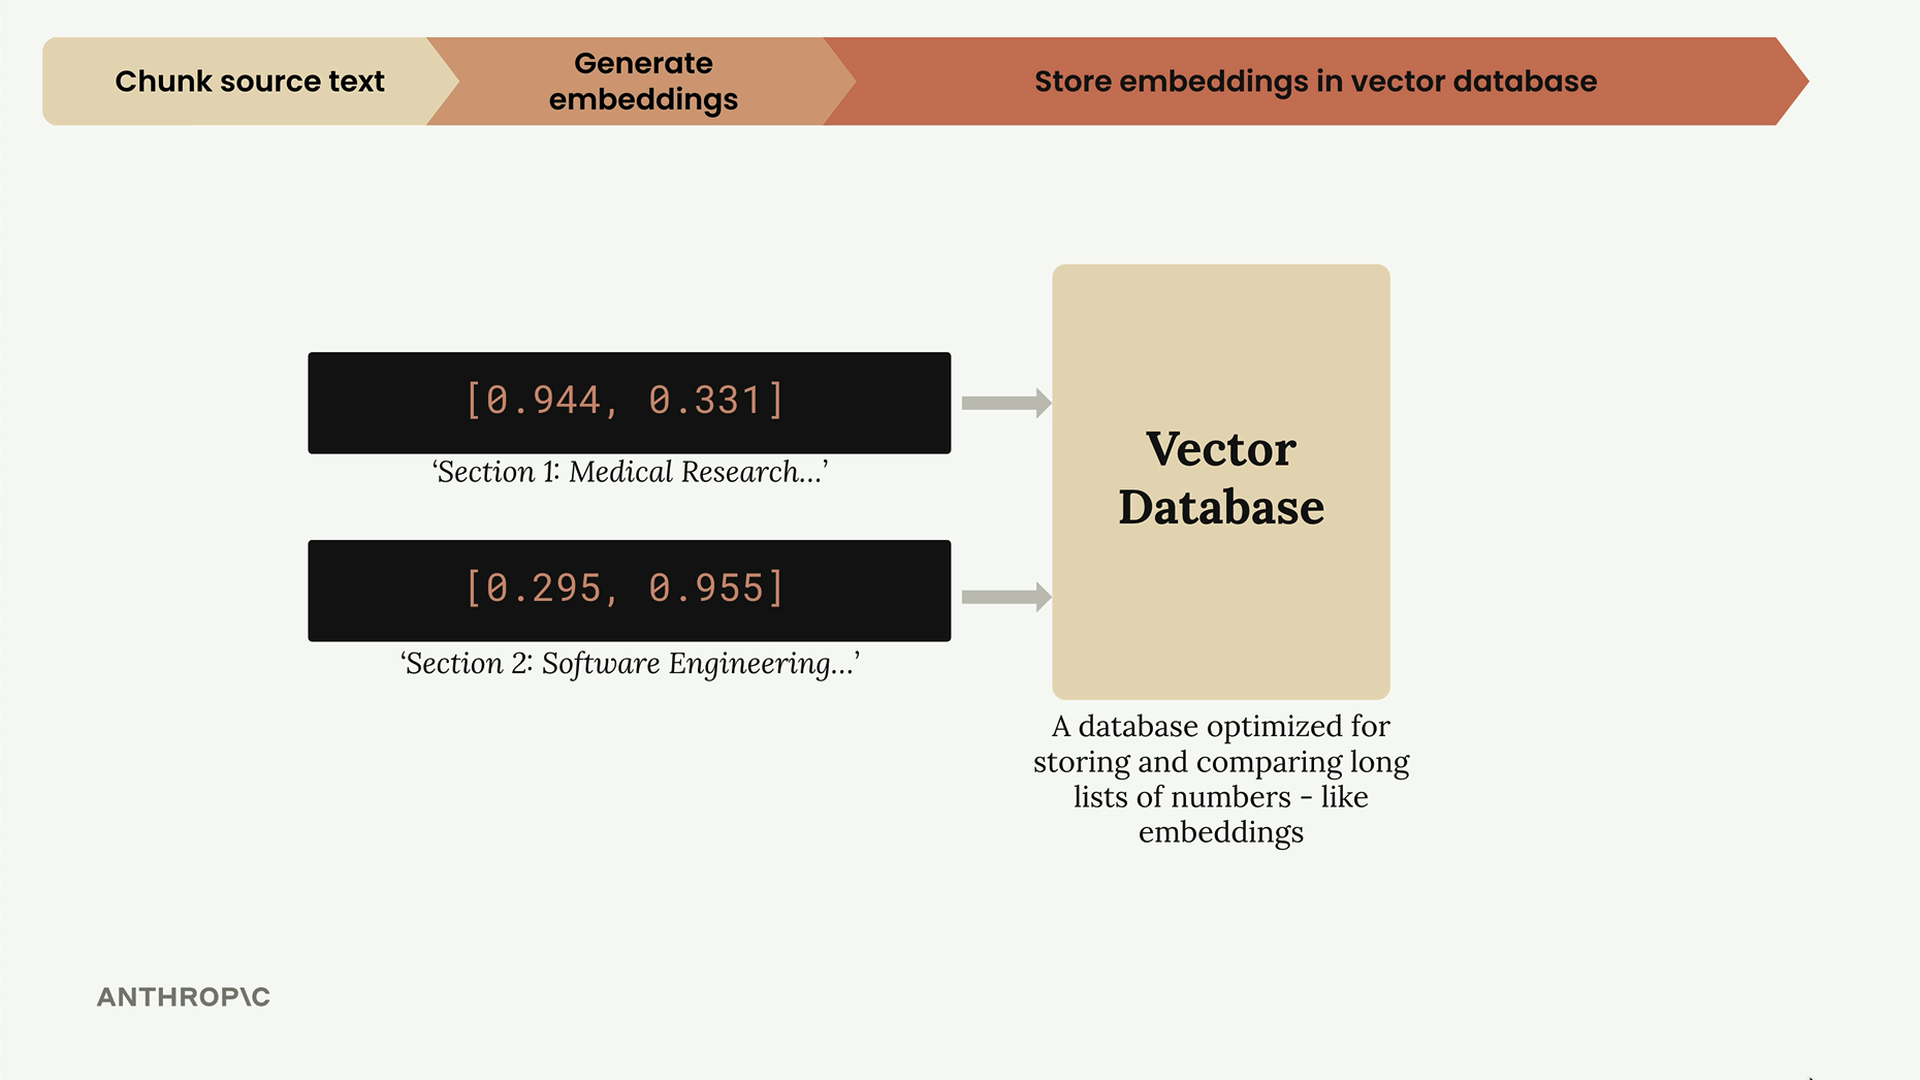
Después de la normalización, nuestros embeddings se convierten en [0.944, 0.331] y [0.295, 0.955]. Podemos visualizarlos en un círculo unitario donde ambos puntos se encuentran exactamente en el borde del círculo.
Paso 3: Almacena en la base de datos vectorial
Los embeddings normalizados se almacenan en una base de datos vectorial - una base de datos especializada optimizada para almacenar, comparar y buscar a través de largas listas de números como nuestros embeddings.
En este punto, hacemos una pausa. Todo el trabajo hasta ahora ha sido preprocesamiento que ocurre con anticipación. Ahora esperamos a que un usuario envíe una consulta.
Paso 4: Procesa la consulta del usuario
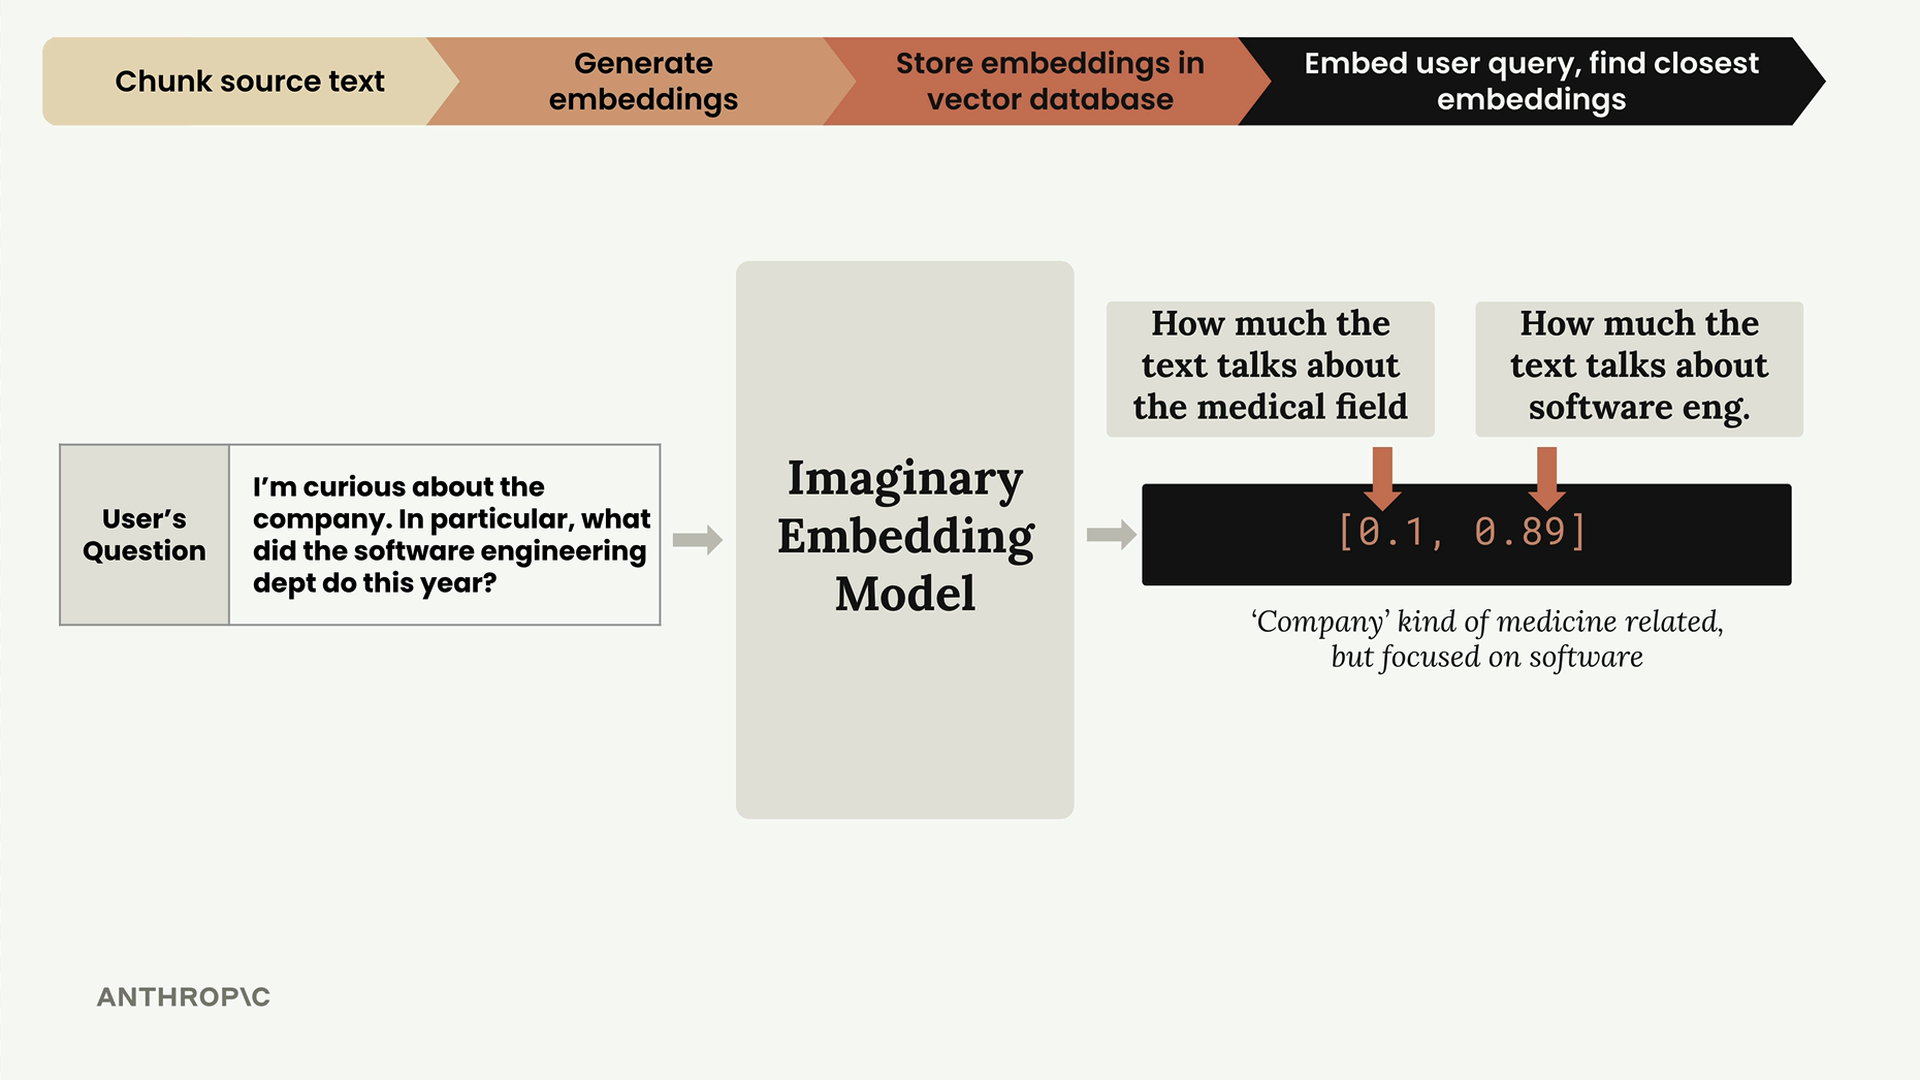
Cuando un usuario hace una pregunta como "Tengo curiosidad sobre la empresa. En particular, ¿qué hizo el departamento de ingeniería de software este año?", ejecutamos su consulta a través del mismo modelo de embeddings.
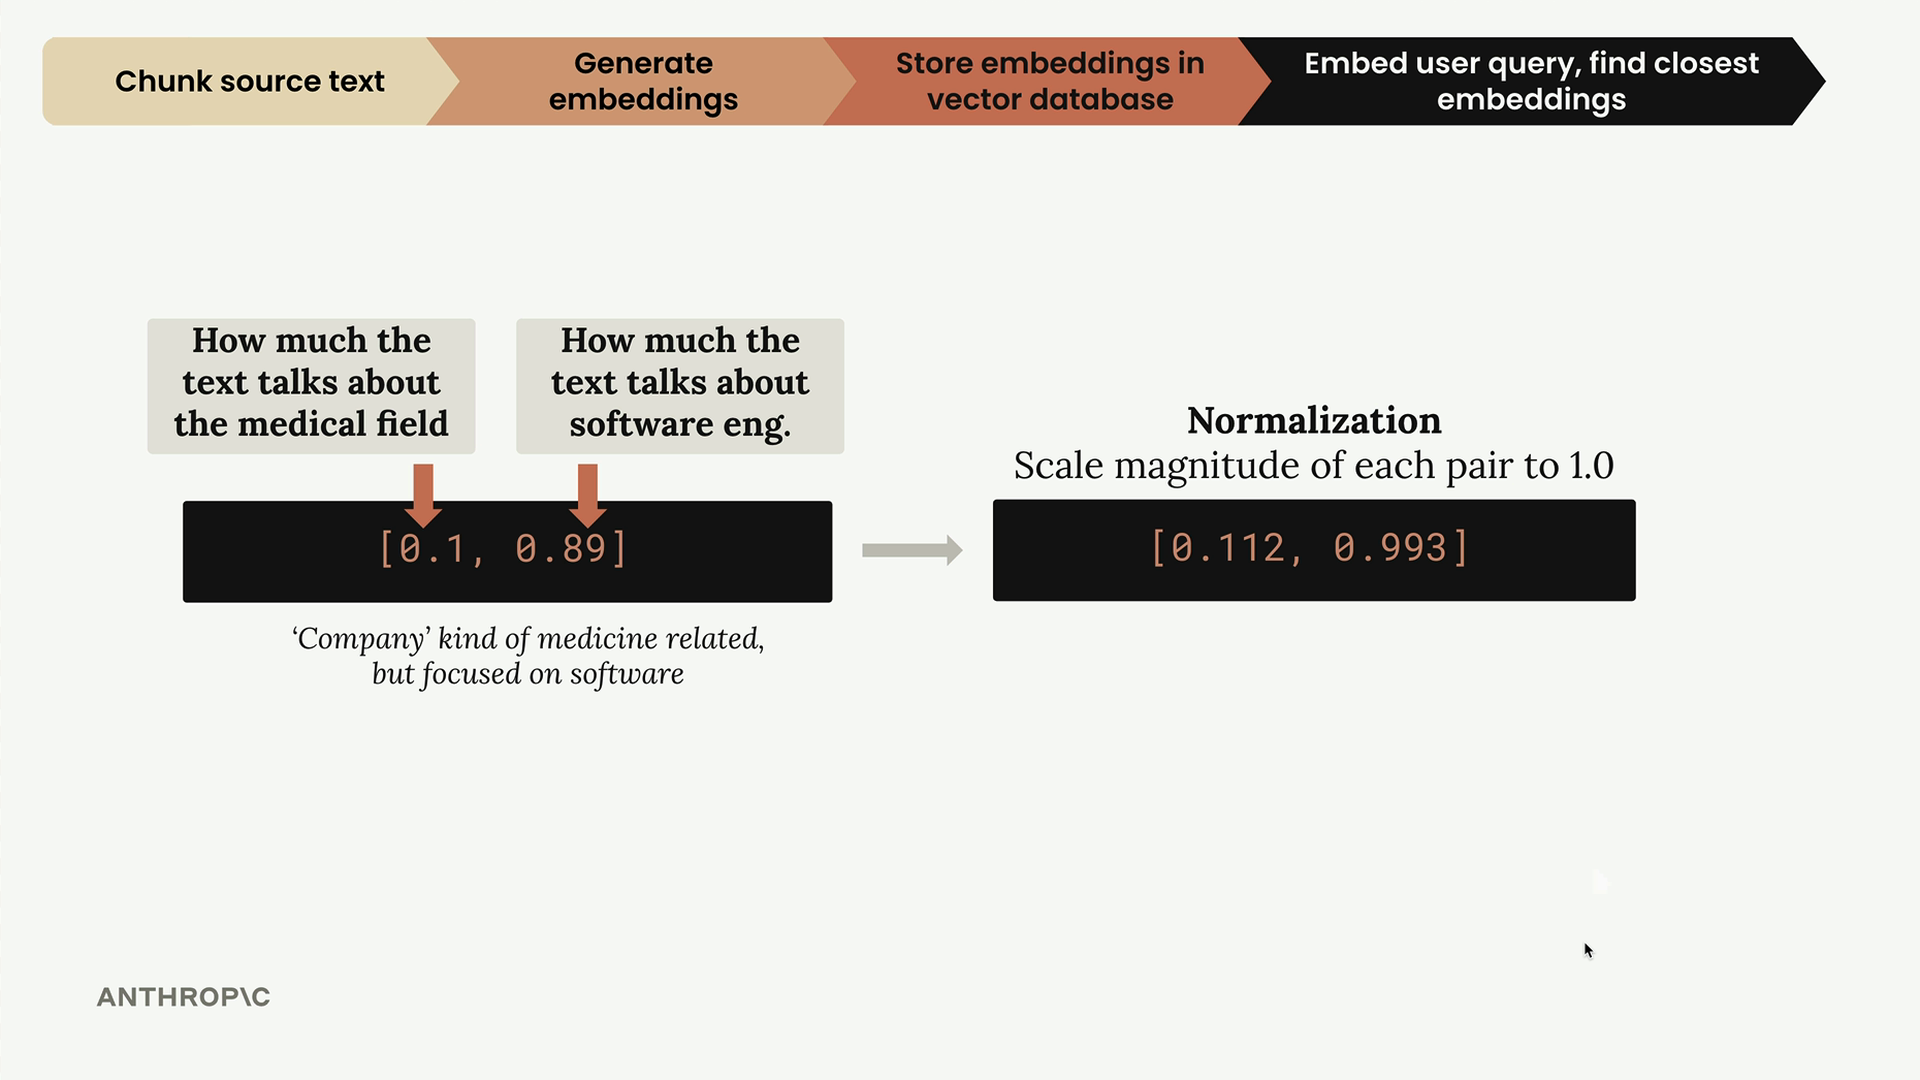
Esta consulta se convierte en embedding como [0.1, 0.89] - puntuación médica baja, puntuación alta de ingeniería de software. Después de la normalización, se convierte en [0.112, 0.993].
Paso 5: Encuentra embeddings similares
Ahora le preguntamos a la base de datos vectorial: "Encuentra el embedding almacenado que esté más cerca de este embedding de la consulta del usuario." La base de datos devuelve la sección de ingeniería de software porque es la más similar.
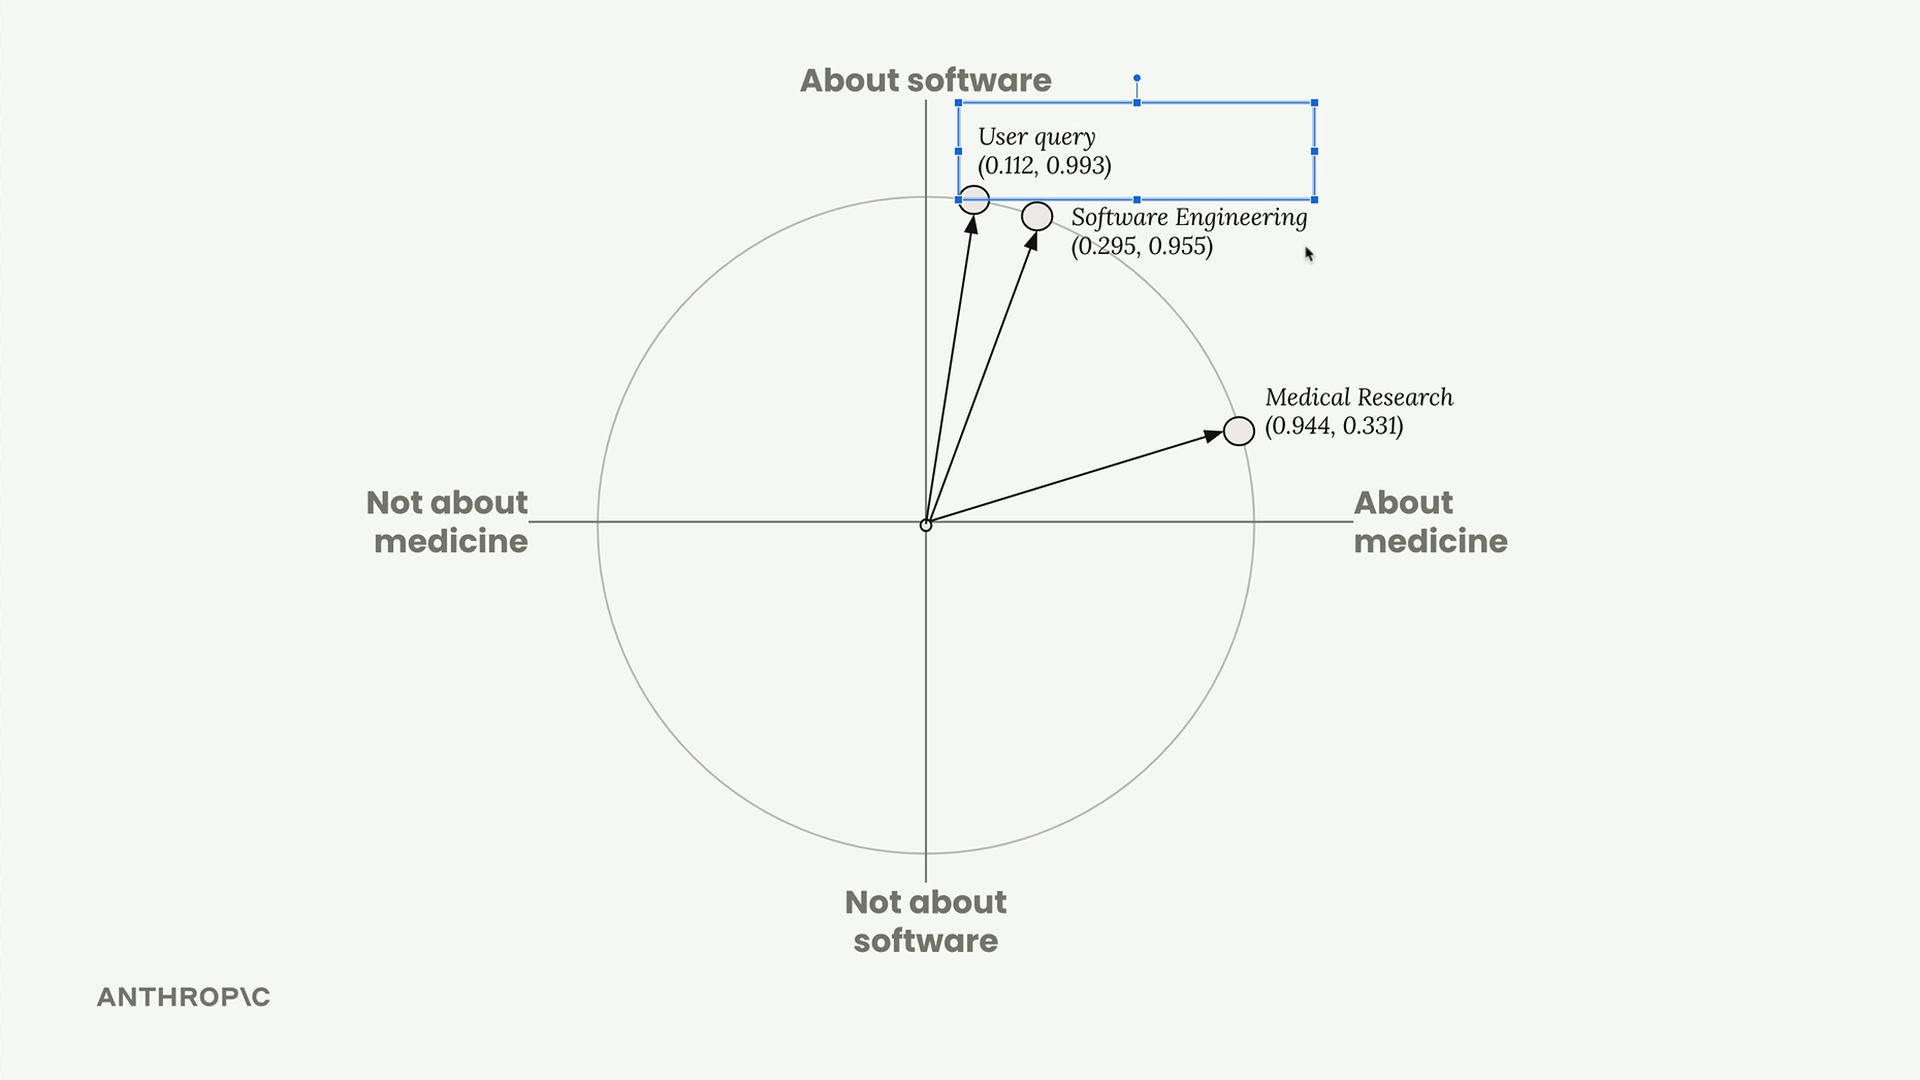
Pero, ¿cómo determina la base de datos qué es "más cercano"? Usa la similitud de coseno.
Similitud de coseno
La base de datos vectorial calcula el coseno del ángulo entre vectores para medir la similitud. Esto nos da un número entre -1 y 1:
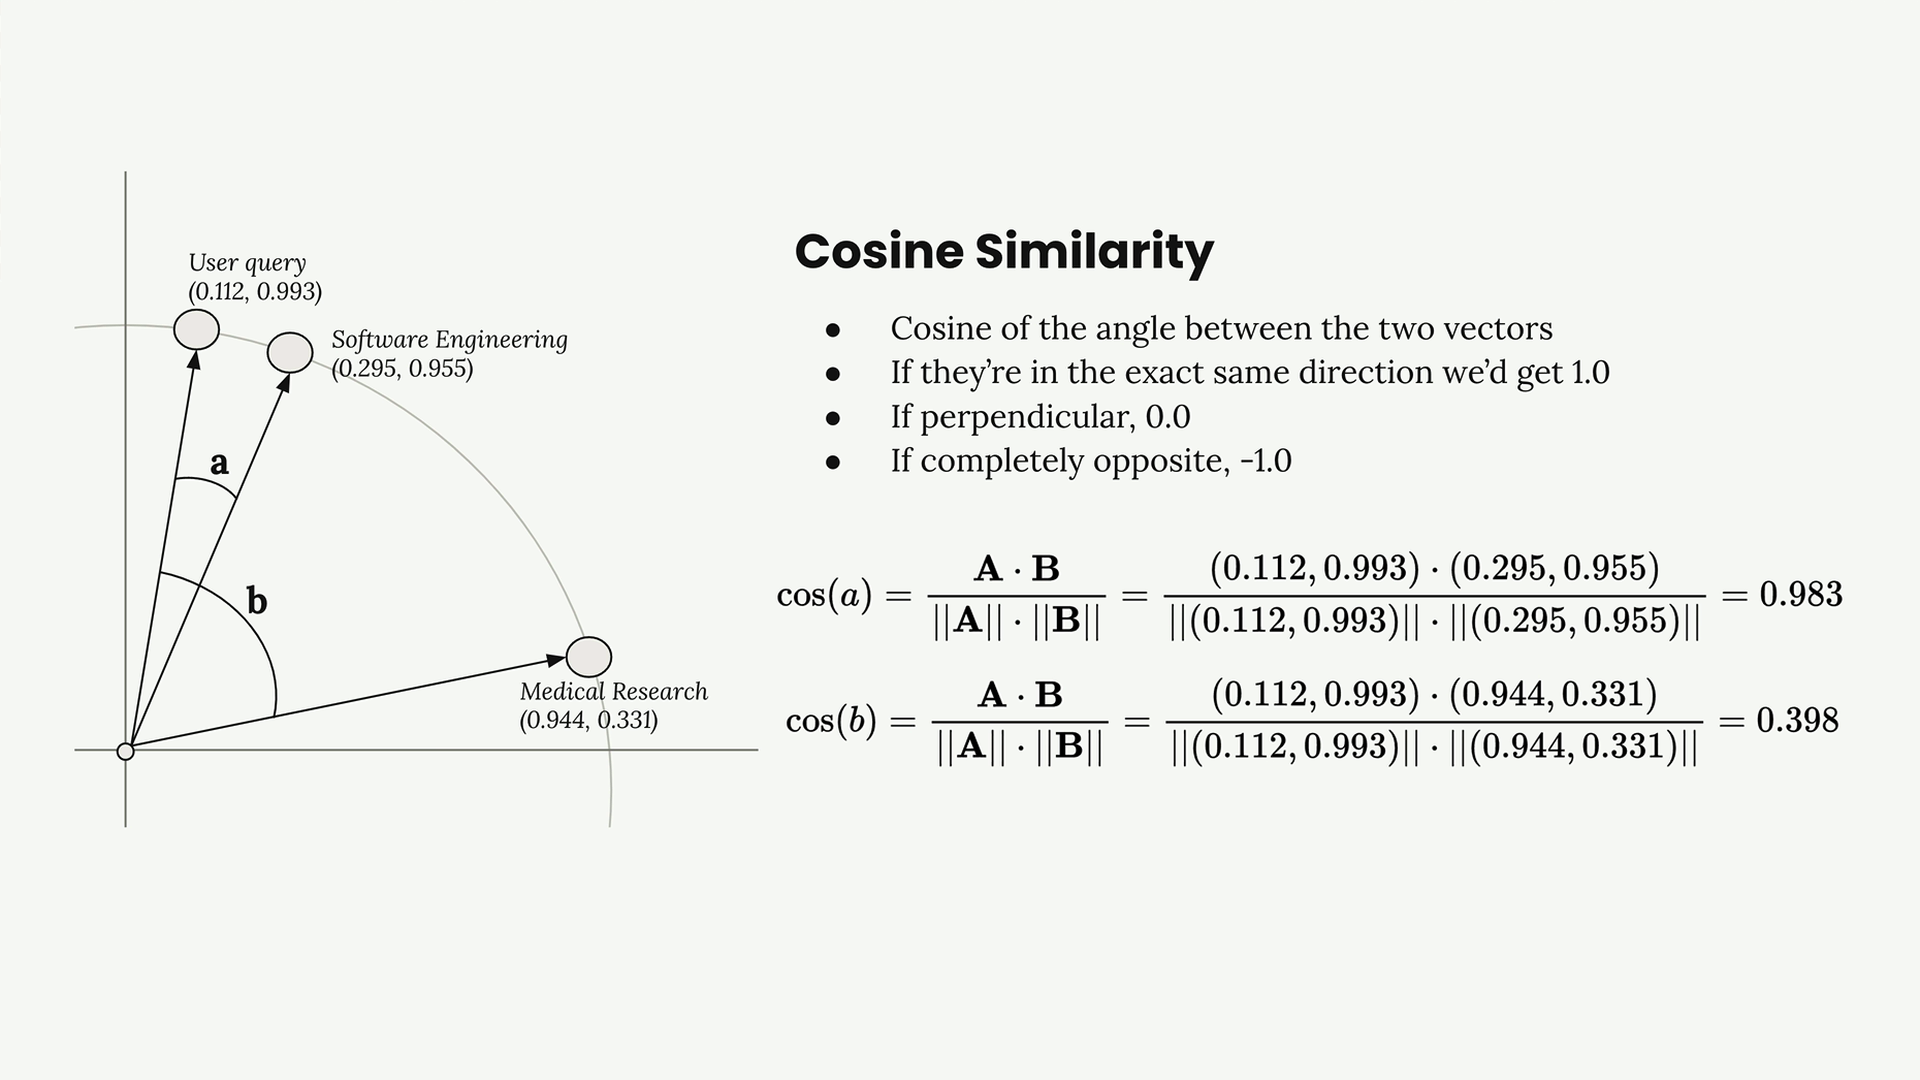
- 1.0 = los vectores apuntan exactamente en la misma dirección (muy similares)
- 0.0 = los vectores son perpendiculares (no relacionados)
- -1.0 = los vectores apuntan en direcciones opuestas (muy diferentes)
En nuestro ejemplo:
- Consulta del usuario vs Ingeniería de Software: similitud de coseno = 0.983 (¡muy similar!)
- Consulta del usuario vs Investigación Médica: similitud de coseno = 0.398 (menos similar)
Distancia de coseno
A menudo verás "distancia de coseno" en la documentación de bases de datos vectoriales. Esto es simplemente 1 - similitud de coseno, lo que invierte la escala para que los números más pequeños signifiquen más similitud:
- 0.0 = muy similar
- 1.0 = perpendicular
- 2.0 = completamente opuesto
Paso 6: Construye el prompt final
Finalmente, tomamos la pregunta del usuario y el fragmento de texto más relevante (sección de ingeniería de software) y los combinamos en un prompt para Claude:
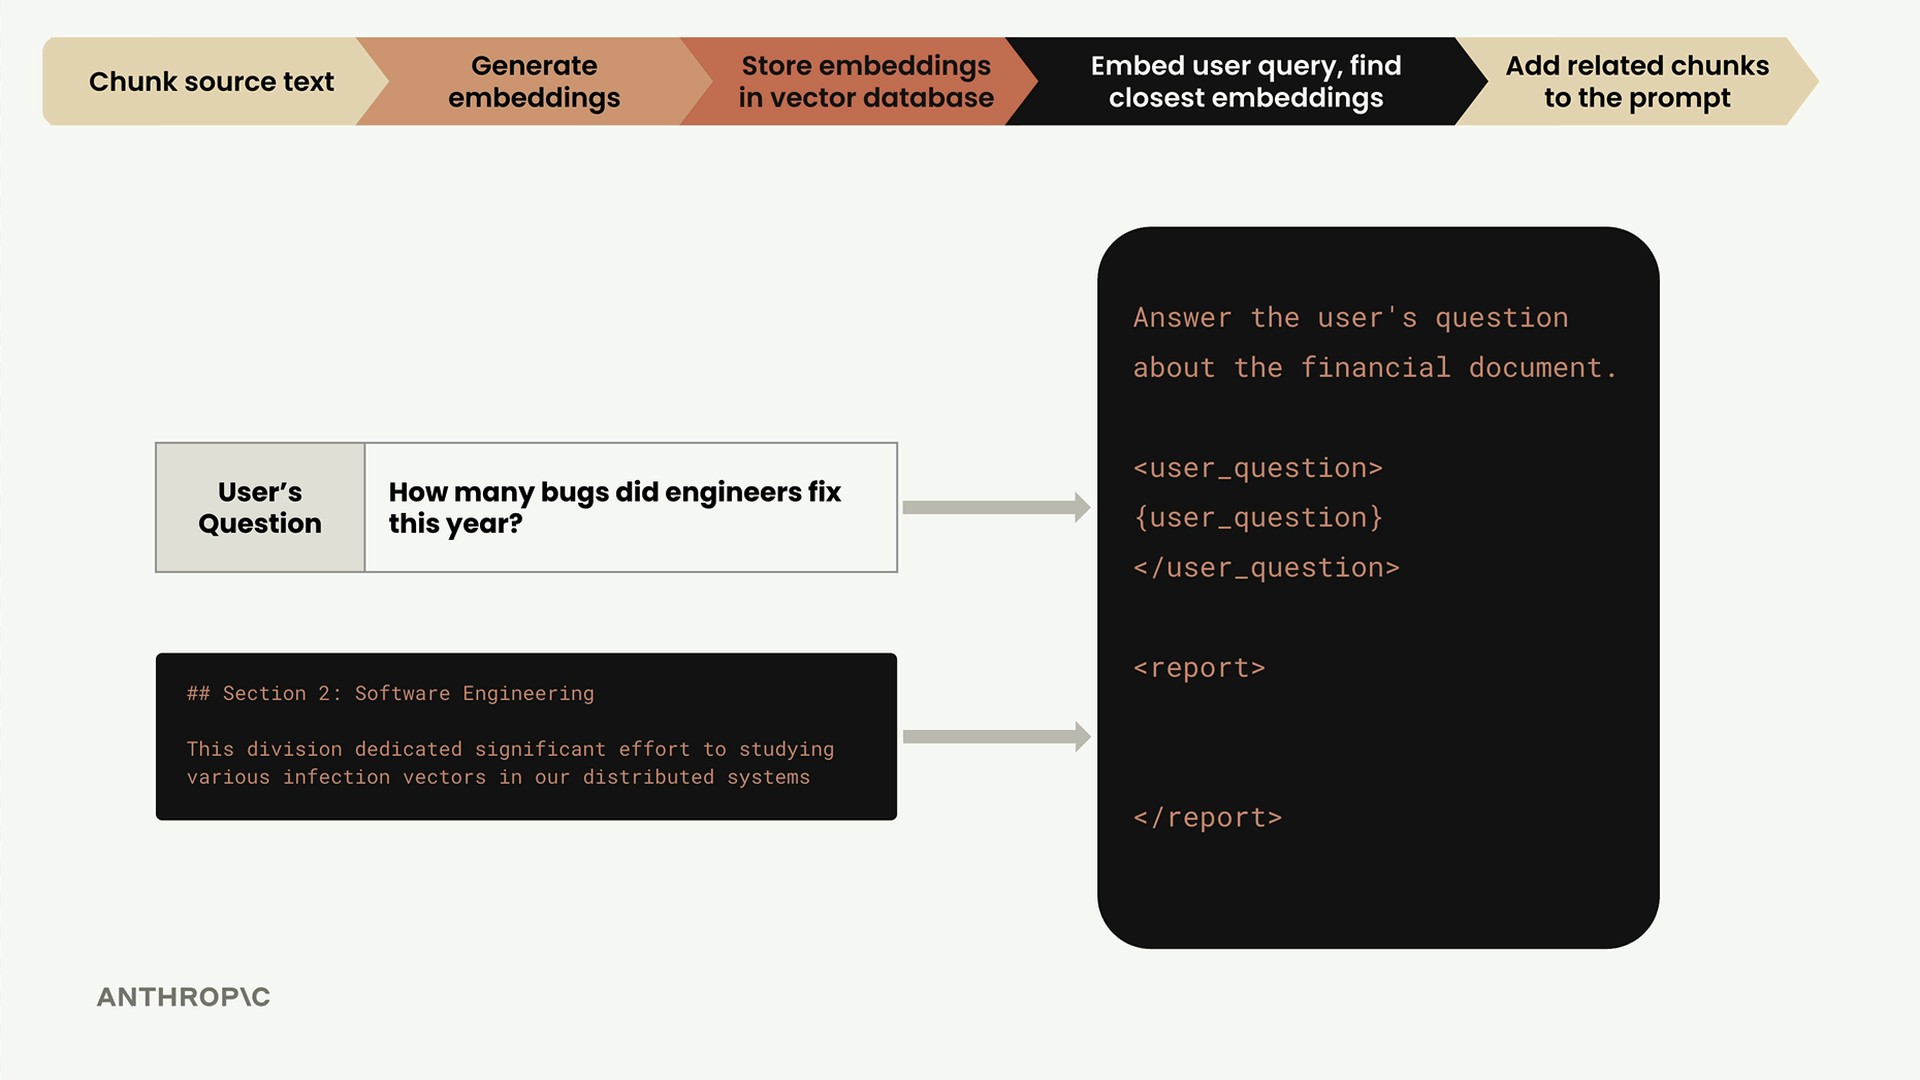
Answer the user's question about the financial document.

<user_question>
How many bugs did engineers fix this year?
</user_question>

<report>
## Section 2: Software Engineering
This division dedicated significant effort to studying various infection vectors in our distributed systems
</report>¡Y ese es el pipeline completo de RAG! El sistema encontró con éxito el contexto más relevante para la pregunta de ingeniería de software del usuario y lo proporcionó a Claude para generar una respuesta informada.
Este proceso ocurre automáticamente cada vez que un usuario envía una consulta, permitiendo que Claude responda preguntas basándose en tus documentos específicos en lugar de solo su conocimiento general de entrenamiento.