Construir un flujo de trabajo de evaluación de prompts personalizado comienza con la creación de un prompt sólido y luego la generación de datos de prueba para ver qué tan bien funciona. Repasemos cómo configurar un sistema de evaluación para un prompt que ayuda a los usuarios a escribir código específico de AWS.
Configurando el objetivo
Nuestro prompt necesita ayudar a los usuarios a escribir tres tipos específicos de salida para casos de uso de AWS:
- Código Python
- Archivos de configuración JSON
- Expresiones regulares
El requisito clave es que, cuando un usuario solicite ayuda con una tarea, devolvamos una salida limpia en uno de estos formatos sin explicaciones, encabezados o pies de página adicionales.
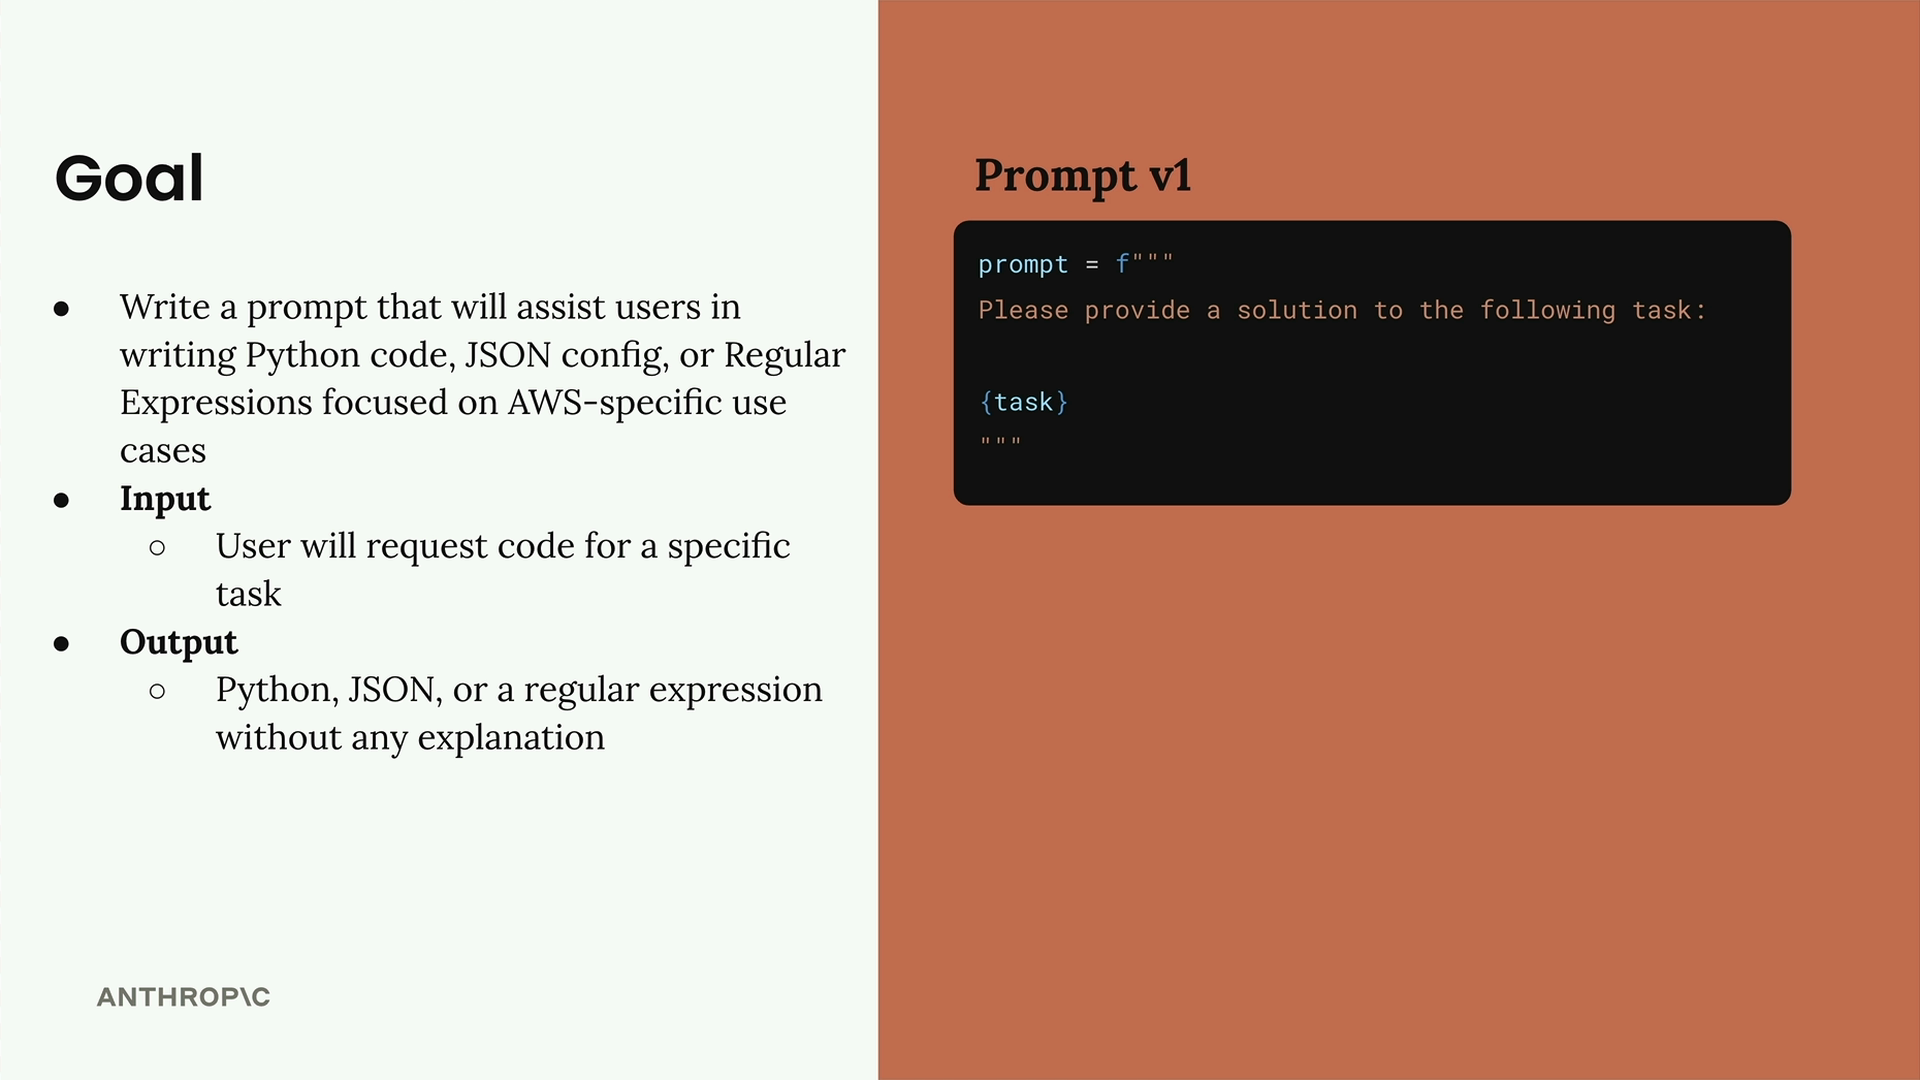
Aquí está nuestra plantilla de prompt inicial:
prompt = f"""
Please provide a solution to the following task:
{task}
"""
Creando un conjunto de datos de evaluación
Un conjunto de datos de evaluación contiene entradas que introduciremos en nuestro prompt para probar su rendimiento. En nuestro caso, necesitamos un array de objetos JSON donde cada objeto tenga una propiedad "task" que describa lo que queremos que Claude logre.
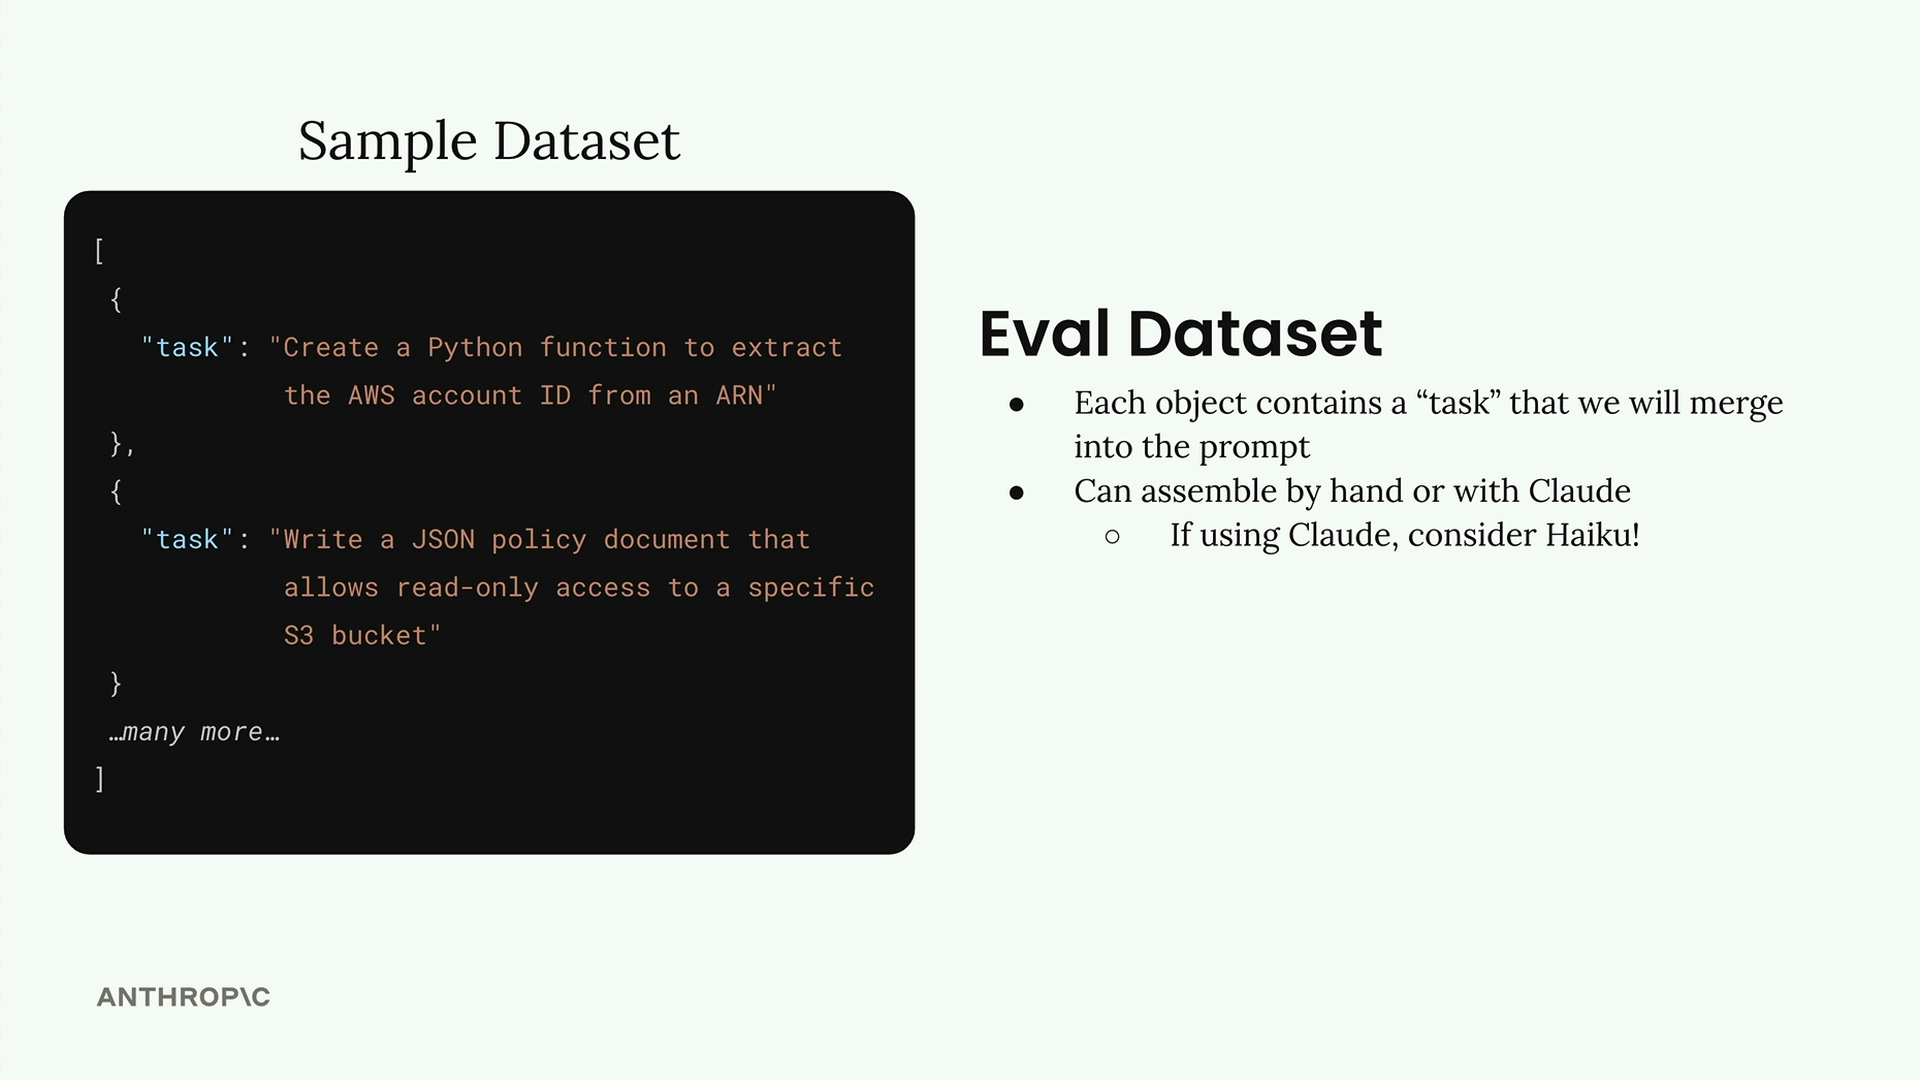
Puedes crear conjuntos de datos de dos maneras:
- Ensamblarlos manualmente
- Generarlos automáticamente usando Claude
Para la generación automática, tiene sentido usar un modelo más rápido como Haiku, ya que estamos generando datos de prueba en lugar de salida de producción.
Generando datos de prueba con código
Construyamos una función que le pida a Claude que genere casos de prueba para nosotros. La función creará un prompt completo que solicita tipos específicos de tareas relacionadas con AWS.
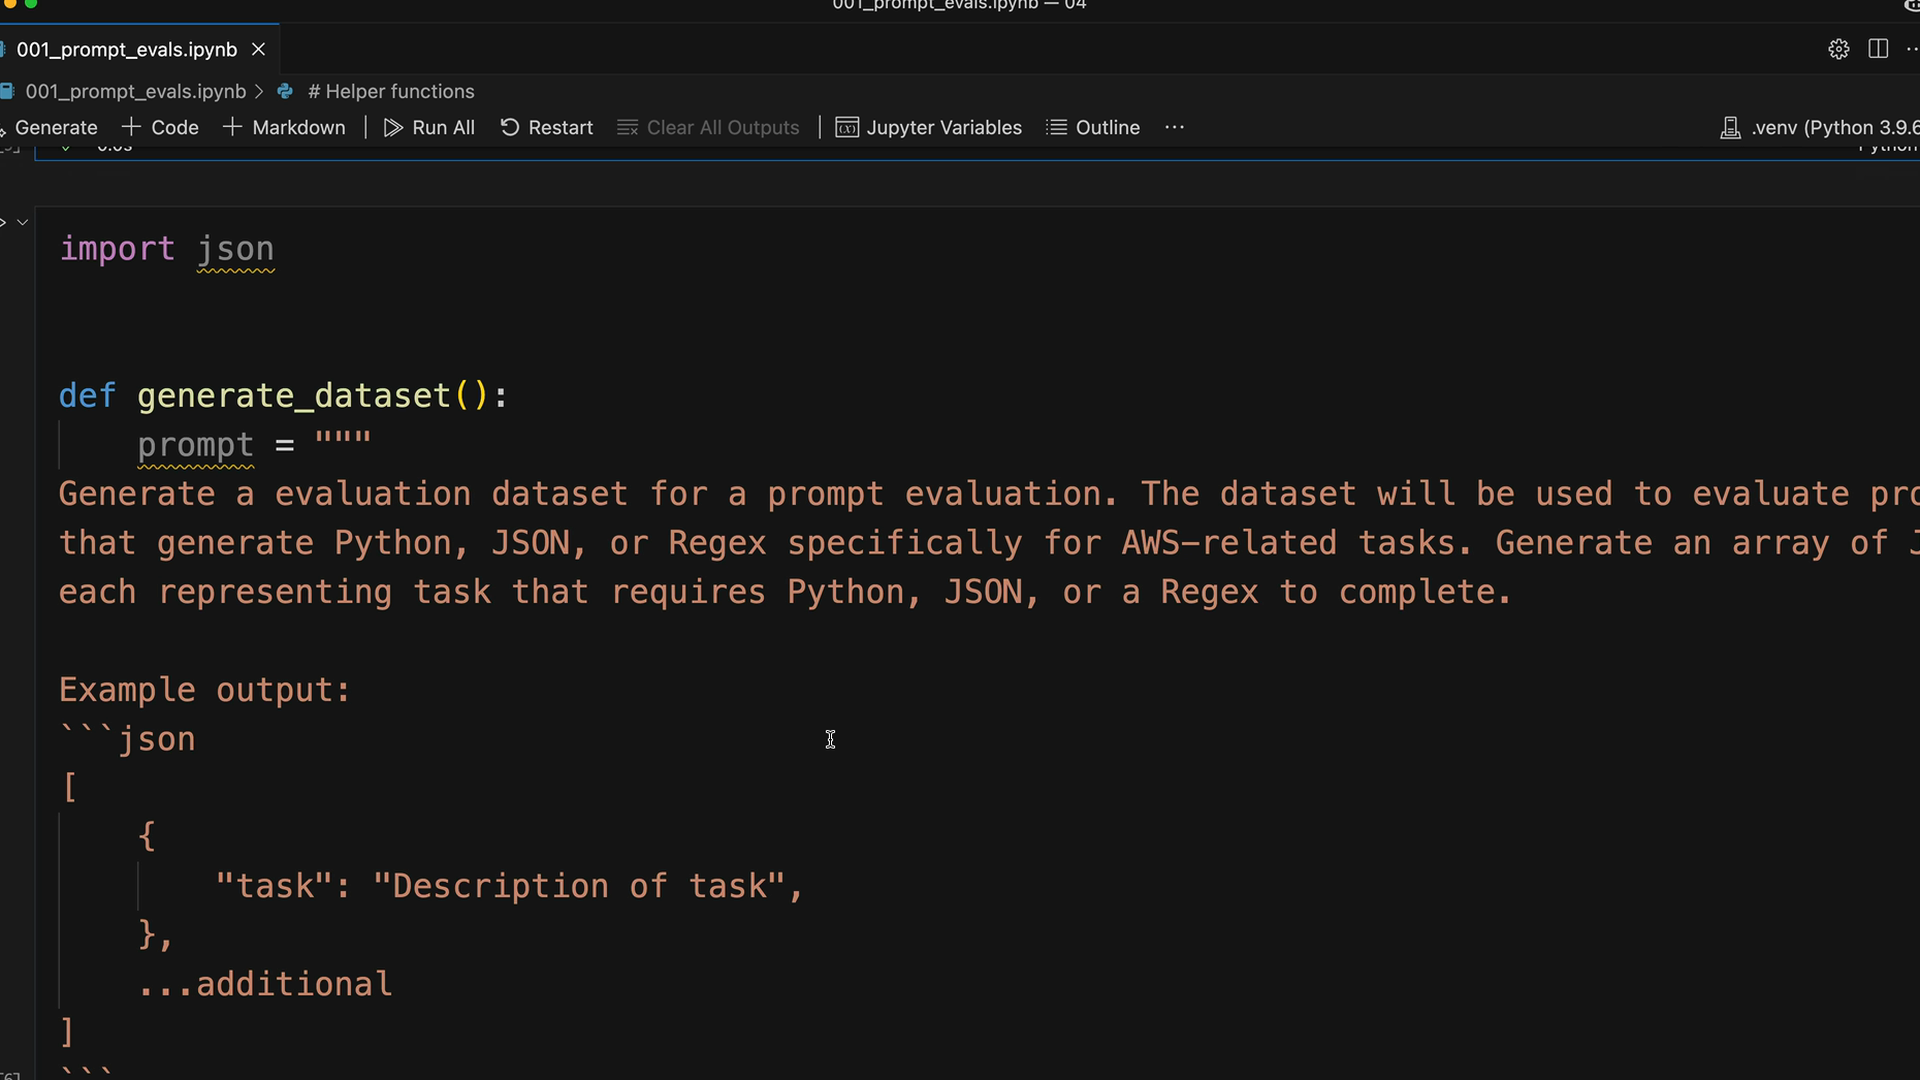
Aquí está la estructura central de la función:
def generate_dataset():
    prompt = """
    Generate an evaluation dataset for a prompt evaluation. The dataset will be used to evaluate prompts
    that generate Python, JSON, or Regex specifically for AWS-related tasks. Generate an array of objects,
    each representing task that requires Python, JSON, or a Regex to complete.

    Example output:
    ```json
    [
        \{
            "task": "Description of task",
        \},
        ...additional
    ]
    ```

    * Focus on tasks that can be solved by writing a single Python function, a single JSON object, or a single regex
    * Focus on tasks that do not require writing much code

    Please generate 3 objects.
    """
Implementando la lógica de generación
Para obtener una salida JSON limpia de Claude, usaremos la técnica de prellenado con secuencias de parada:
messages = []
add_user_message(messages, prompt)
add_assistant_message(messages, "```json")
text = chat(messages, stop_sequences=["```"])
return json.loads(text)
Este enfoque garantiza que Claude comience su respuesta con un JSON correctamente formateado y se detenga en el cierre de la valla de markdown.
Probando y guardando el conjunto de datos
Después de ejecutar la función de generación, deberías obtener casos de prueba realistas como:
- Crear una función Python para extraer la región de AWS de un ARN
- Escribir una configuración JSON para una función de AWS Lambda
- Desarrollar una expresión regular para validar un nombre de bucket de AWS S3
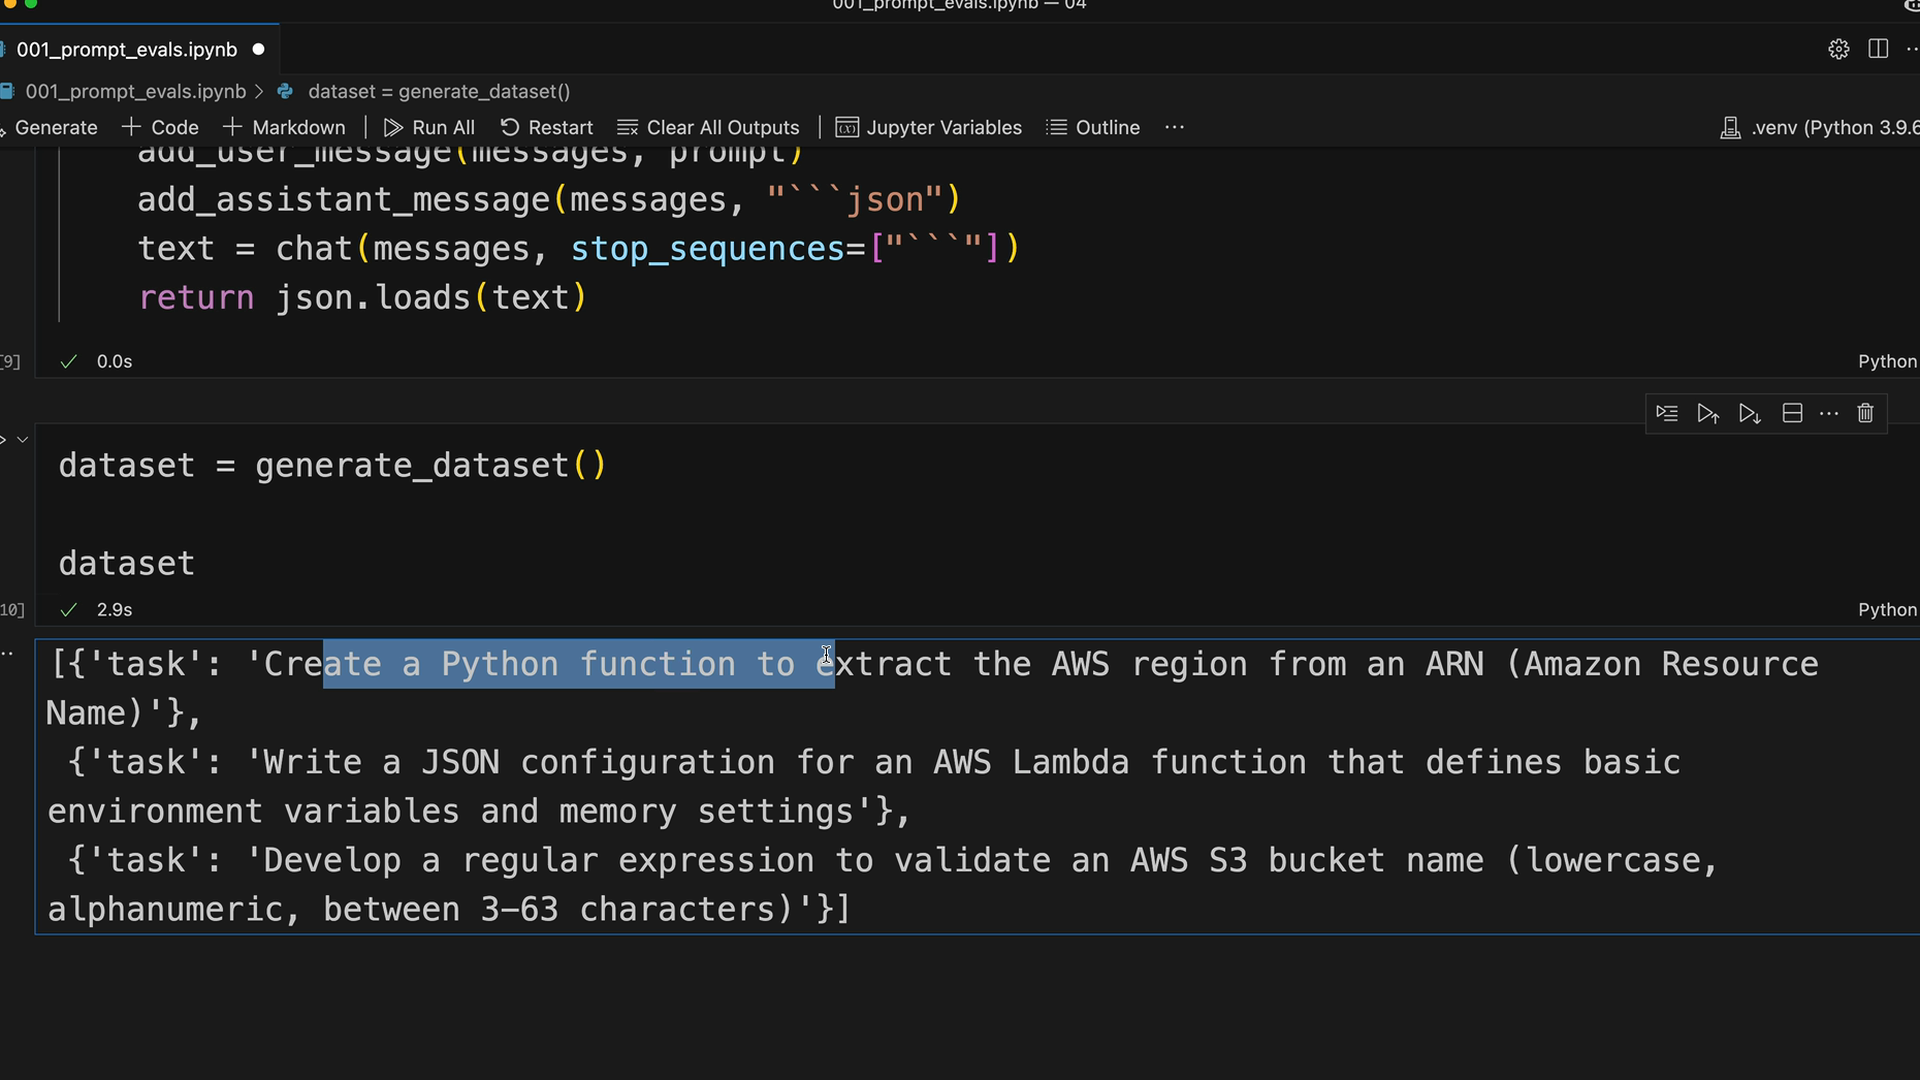
Guarda tu conjunto de datos generado en un archivo para facilitar su reutilización:
dataset = generate_dataset()

with open('dataset.json', 'w') as f:
    json.dump(dataset, f, indent=2)
Esto crea un archivo dataset.json en el directorio de tu notebook que contiene todos tus casos de prueba, listos para usar en la evaluación de prompts en los siguientes pasos de tu flujo de trabajo.