Después de extraer fragmentos de texto de un documento, el siguiente paso en un pipeline de RAG es encontrar qué fragmentos son más relevantes para la pregunta de un usuario. Esto es esencialmente un problema de búsqueda: necesitas revisar todos tus fragmentos e identificar los que se relacionan con lo que el usuario está preguntando.
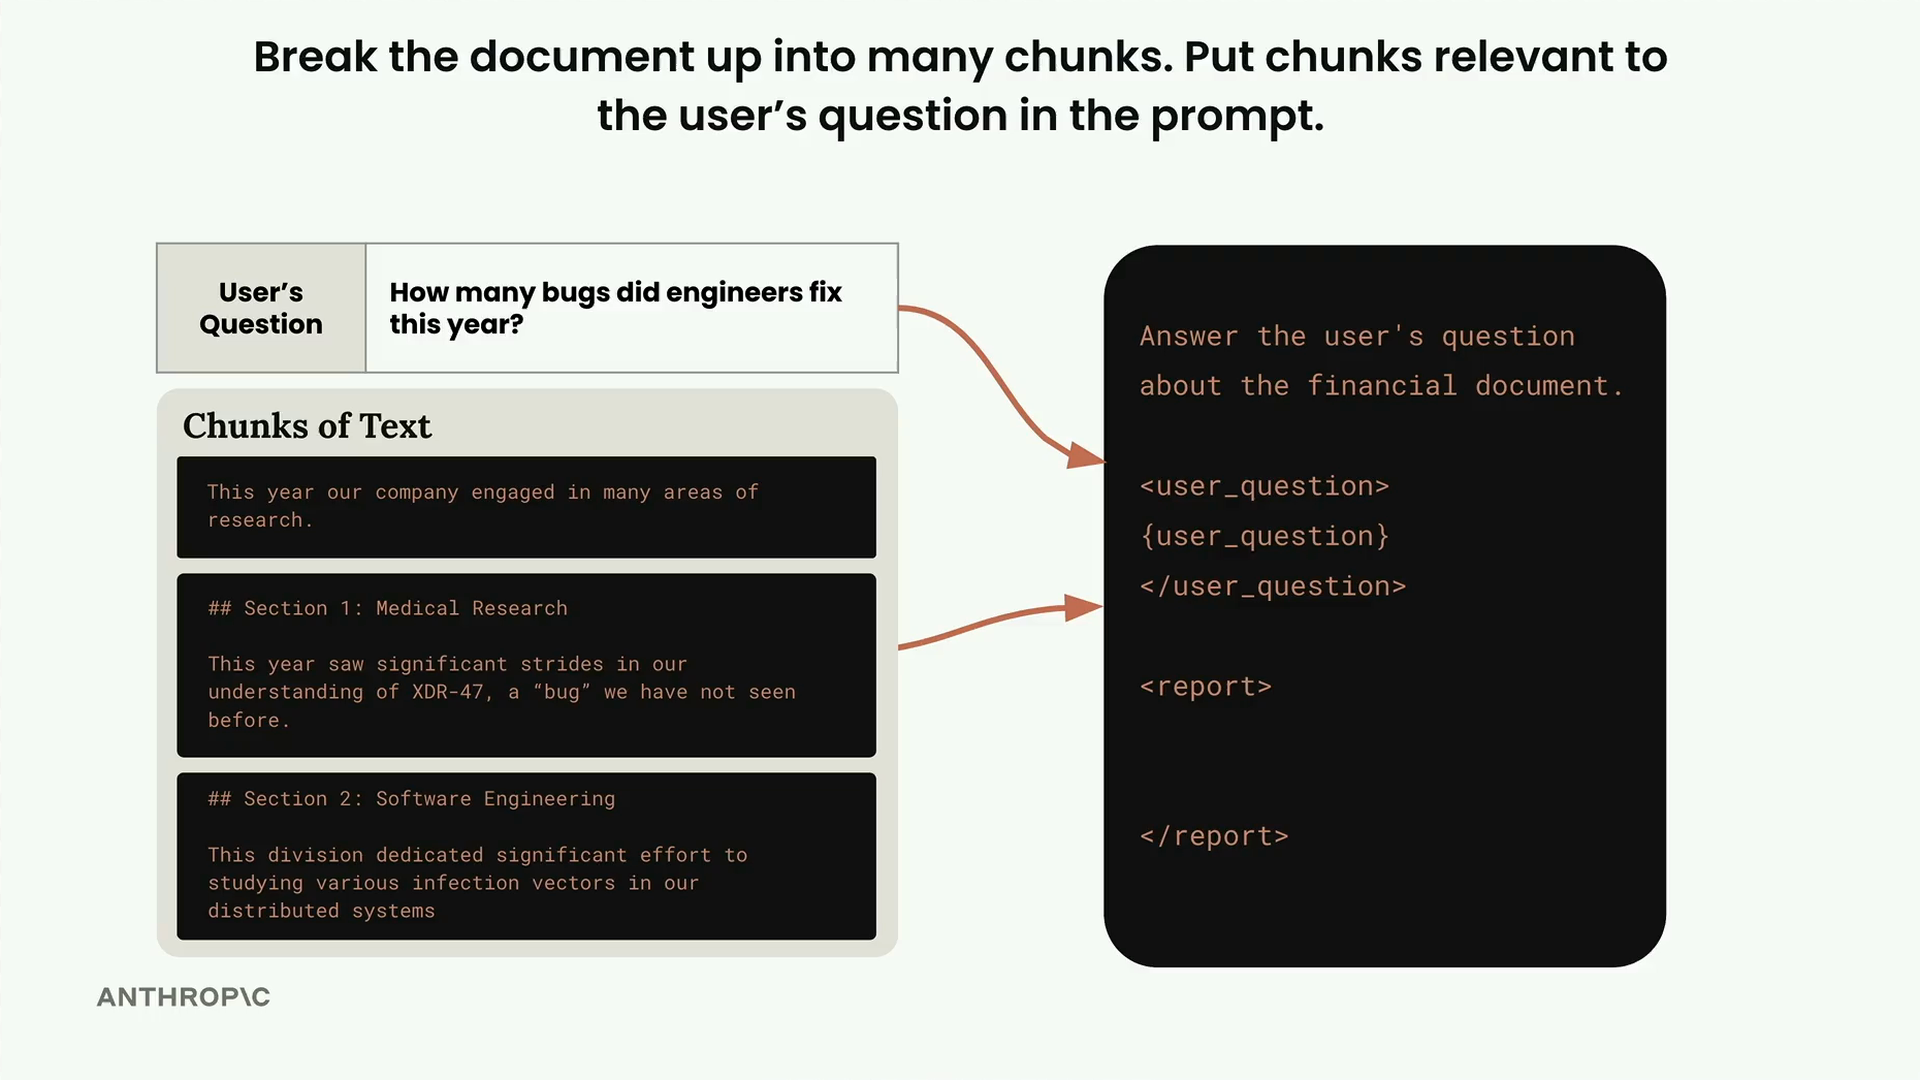
Búsqueda semántica
El enfoque más común para encontrar fragmentos relevantes es la búsqueda semántica. A diferencia de la búsqueda tradicional basada en palabras clave, la búsqueda semántica usa embeddings de texto para comprender el significado real tanto de la pregunta del usuario como de cada fragmento de texto. Esto permite que el sistema encuentre contenido conceptualmente relacionado incluso cuando las palabras exactas no coinciden.
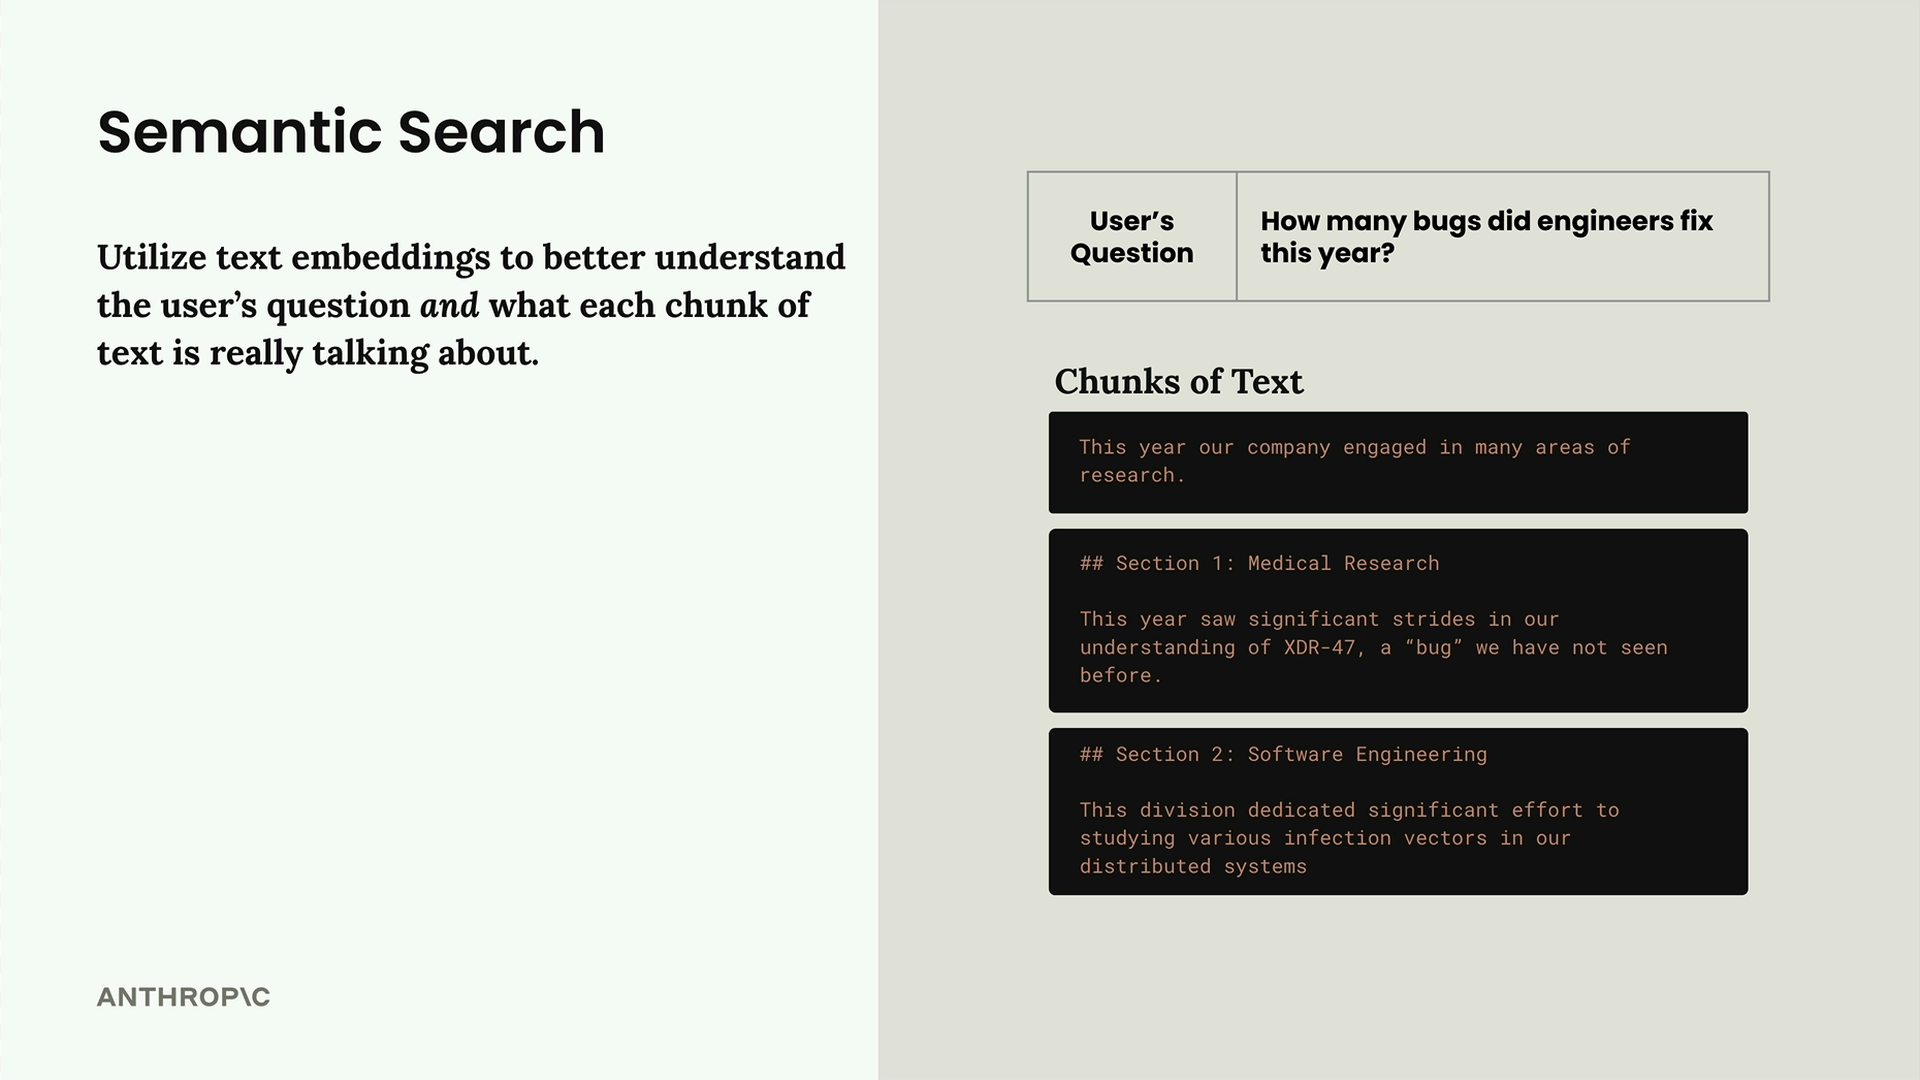
¿Qué son los embeddings de texto?
Un embedding de texto es una representación numérica del significado contenido en algún texto. Piénsalo como convertir palabras y oraciones en un formato con el que las computadoras pueden trabajar matemáticamente.
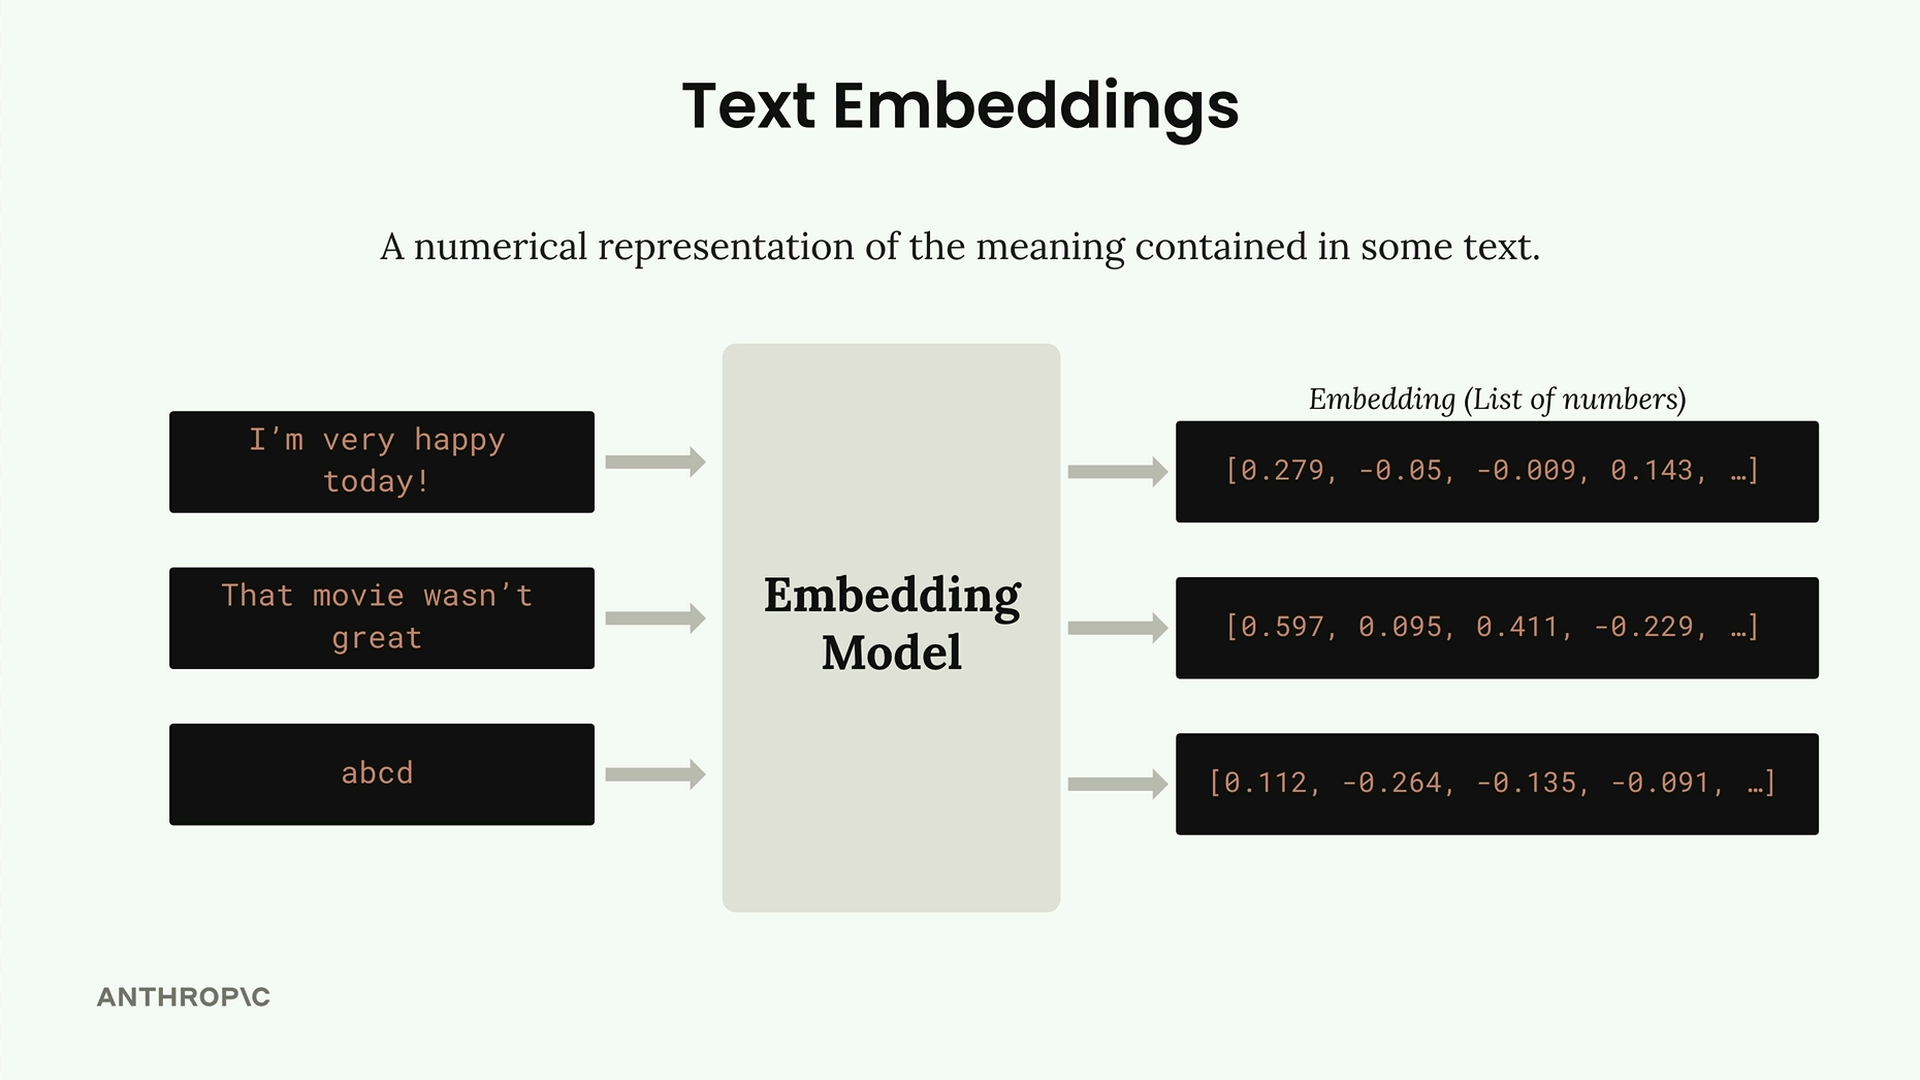
Así es como funciona el proceso:
- Alimentas texto a un modelo de embedding
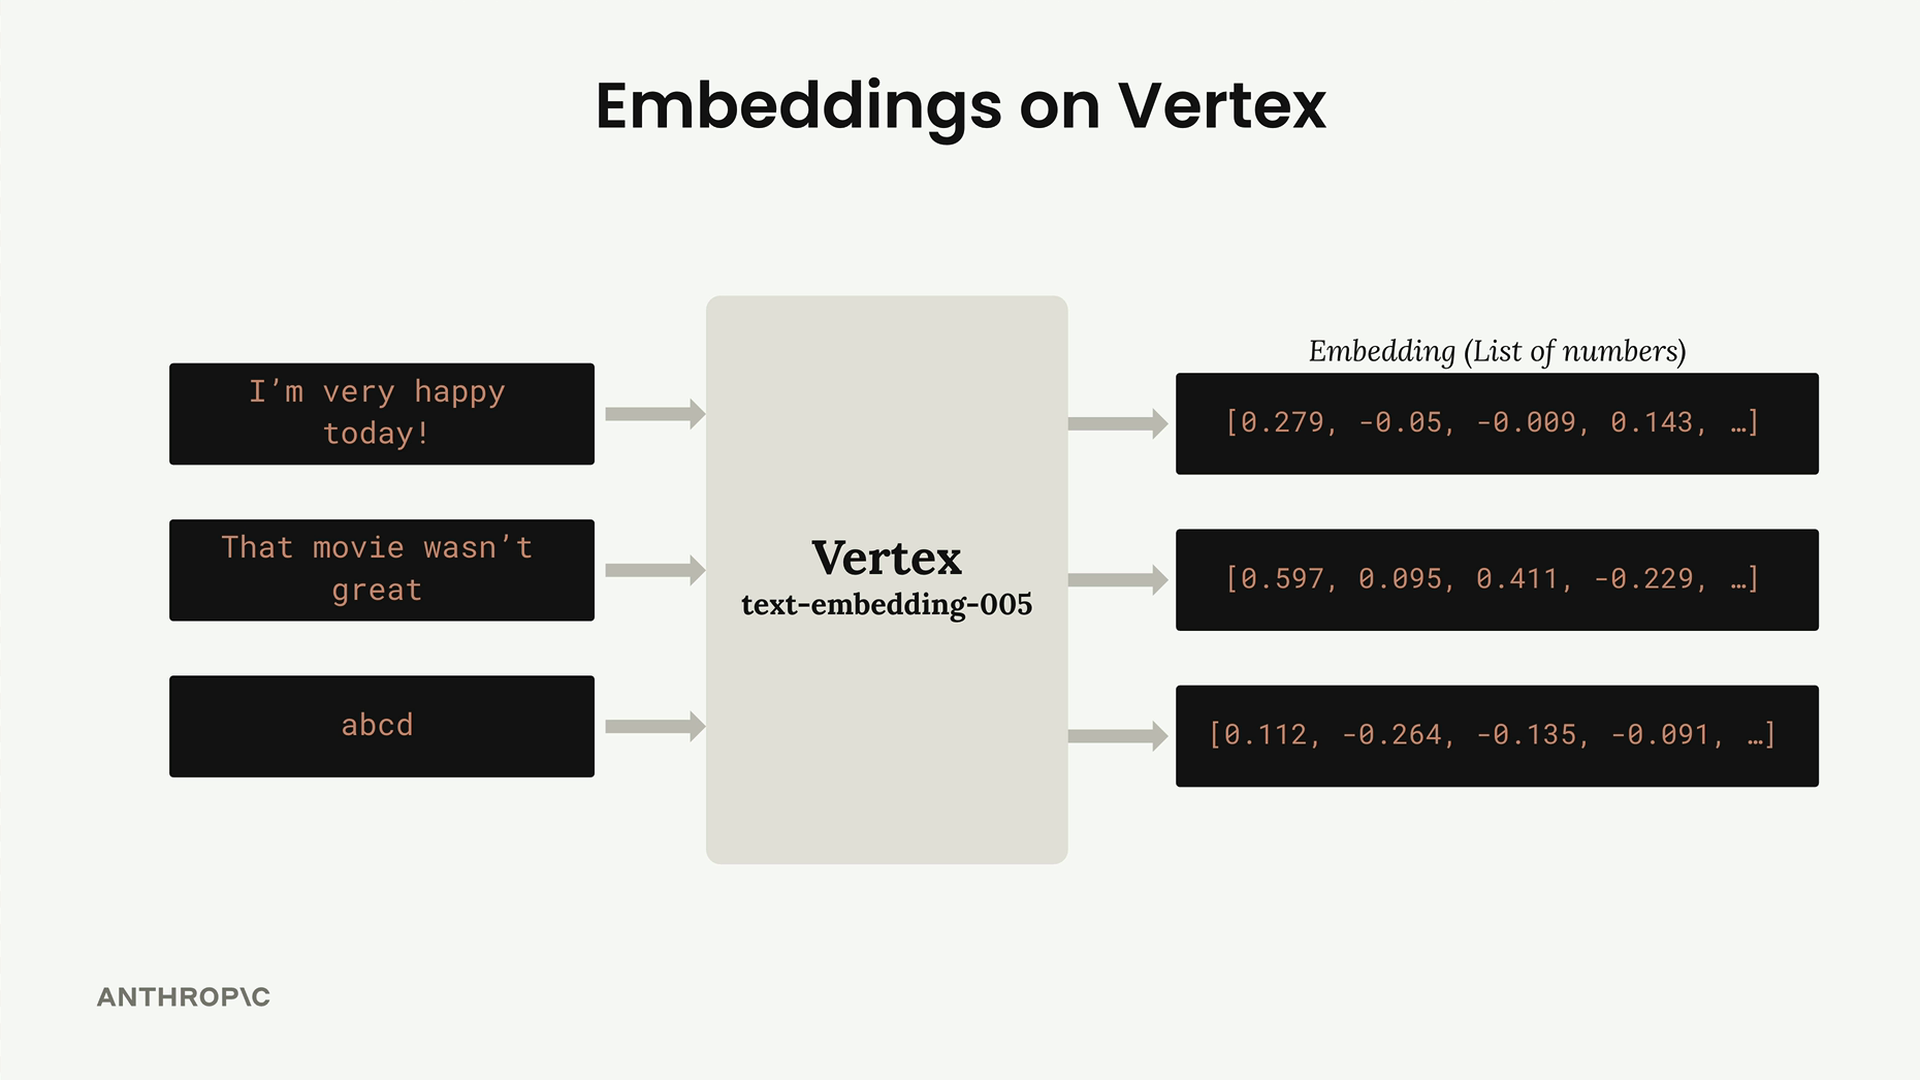
- El modelo genera una larga lista de números (el embedding)
- Cada número varía entre -1 y +1
- Estos números representan diferentes cualidades o características del texto de entrada
Entendiendo los números
Cada número en un embedding es esencialmente una "puntuación" para alguna cualidad del texto de entrada. Sin embargo, aquí está la advertencia importante: en realidad no sabemos qué representa cada número específico.
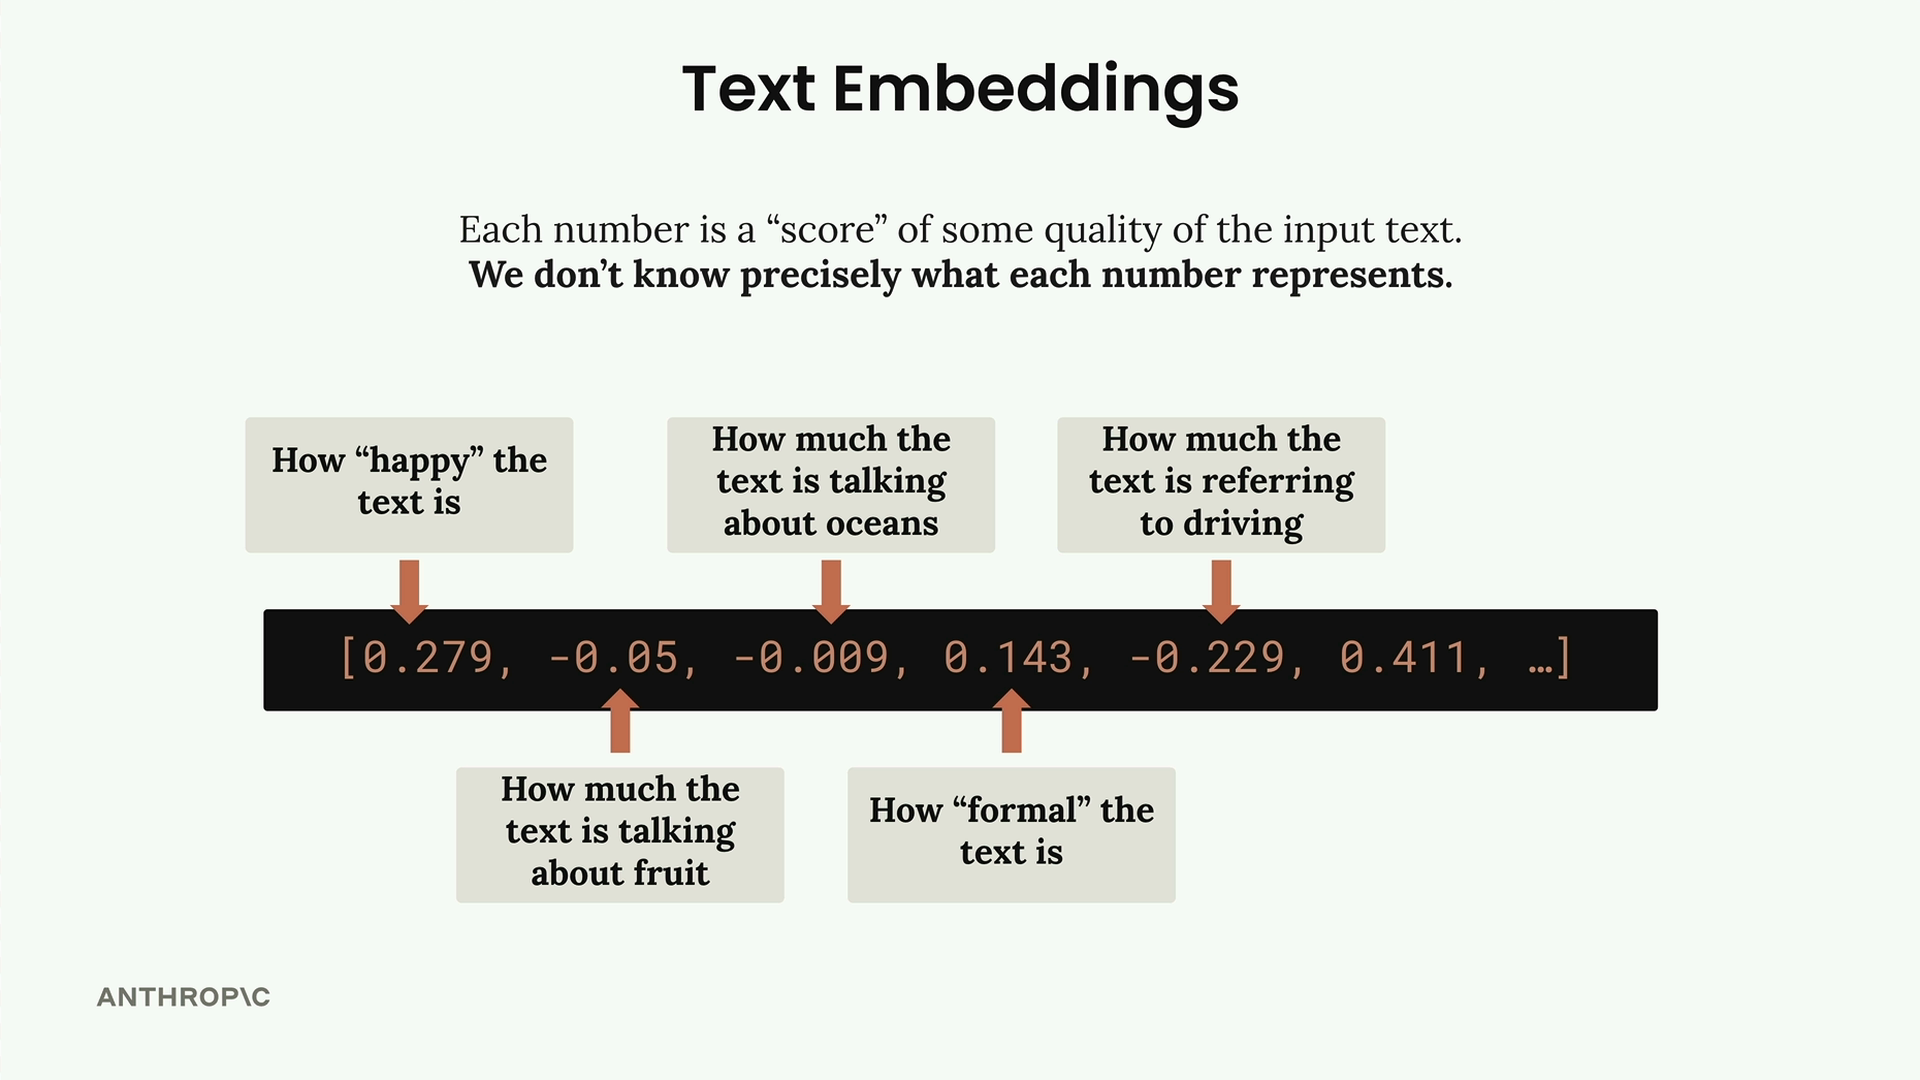
Aunque es útil imaginar que un número podría representar "qué tan feliz es el texto" y otro podría representar "cuánto habla el texto sobre océanos", estos son solo ejemplos conceptuales. El modelo de embedding aprende estas características durante el entrenamiento, pero no están explícitamente etiquetadas ni son interpretables para nosotros.
A pesar de esta opacidad, los embeddings son increíblemente poderosos porque capturan el significado semántico de una manera que permite la comparación matemática entre diferentes fragmentos de texto.
Embeddings en Vertex AI
Claude no puede generar embeddings directamente. En su lugar, necesitas usar un modelo de embedding especializado. En Vertex AI, el modelo que usaremos se llama text-embedding-005.
Implementación
Para trabajar con embeddings en Vertex AI, necesitarás instalar el SDK de Google GenAI:
pip install google-genaiAquí está la configuración básica para generar embeddings:
from google import genai

client = genai.Client(
    project="YOUR_PROJECT_ID",
    location="global",
    vertexai=True
)

def generate_embedding(text):
    response = client.models.embed_content(
        model="text-embedding-005",
        contents=text
    )

    if not response.embeddings:
        return []

    return [e.values for e in response.embeddings]
Cuando ejecutes esta función con un fragmento de texto, obtendrás de vuelta una lista de números de punto flotante que representan el significado semántico de ese texto. Estos embeddings forman la base para implementar la búsqueda semántica en tu sistema de RAG.
El siguiente paso es entender cómo usar estos embeddings para encontrar realmente los fragmentos más relevantes para la pregunta de un usuario, lo cual implica comparar embeddings matemáticamente para determinar la similitud.