Al construir aplicaciones de chat con Claude, existe un desafío significativo de experiencia de usuario: las respuestas pueden tardar entre 10 y 30 segundos en generarse, dejando a los usuarios mirando un indicador de carga. La solución es el streaming de respuestas, que permite a los usuarios ver el texto aparecer fragmento por fragmento mientras Claude lo genera, creando una sensación mucho más receptiva.
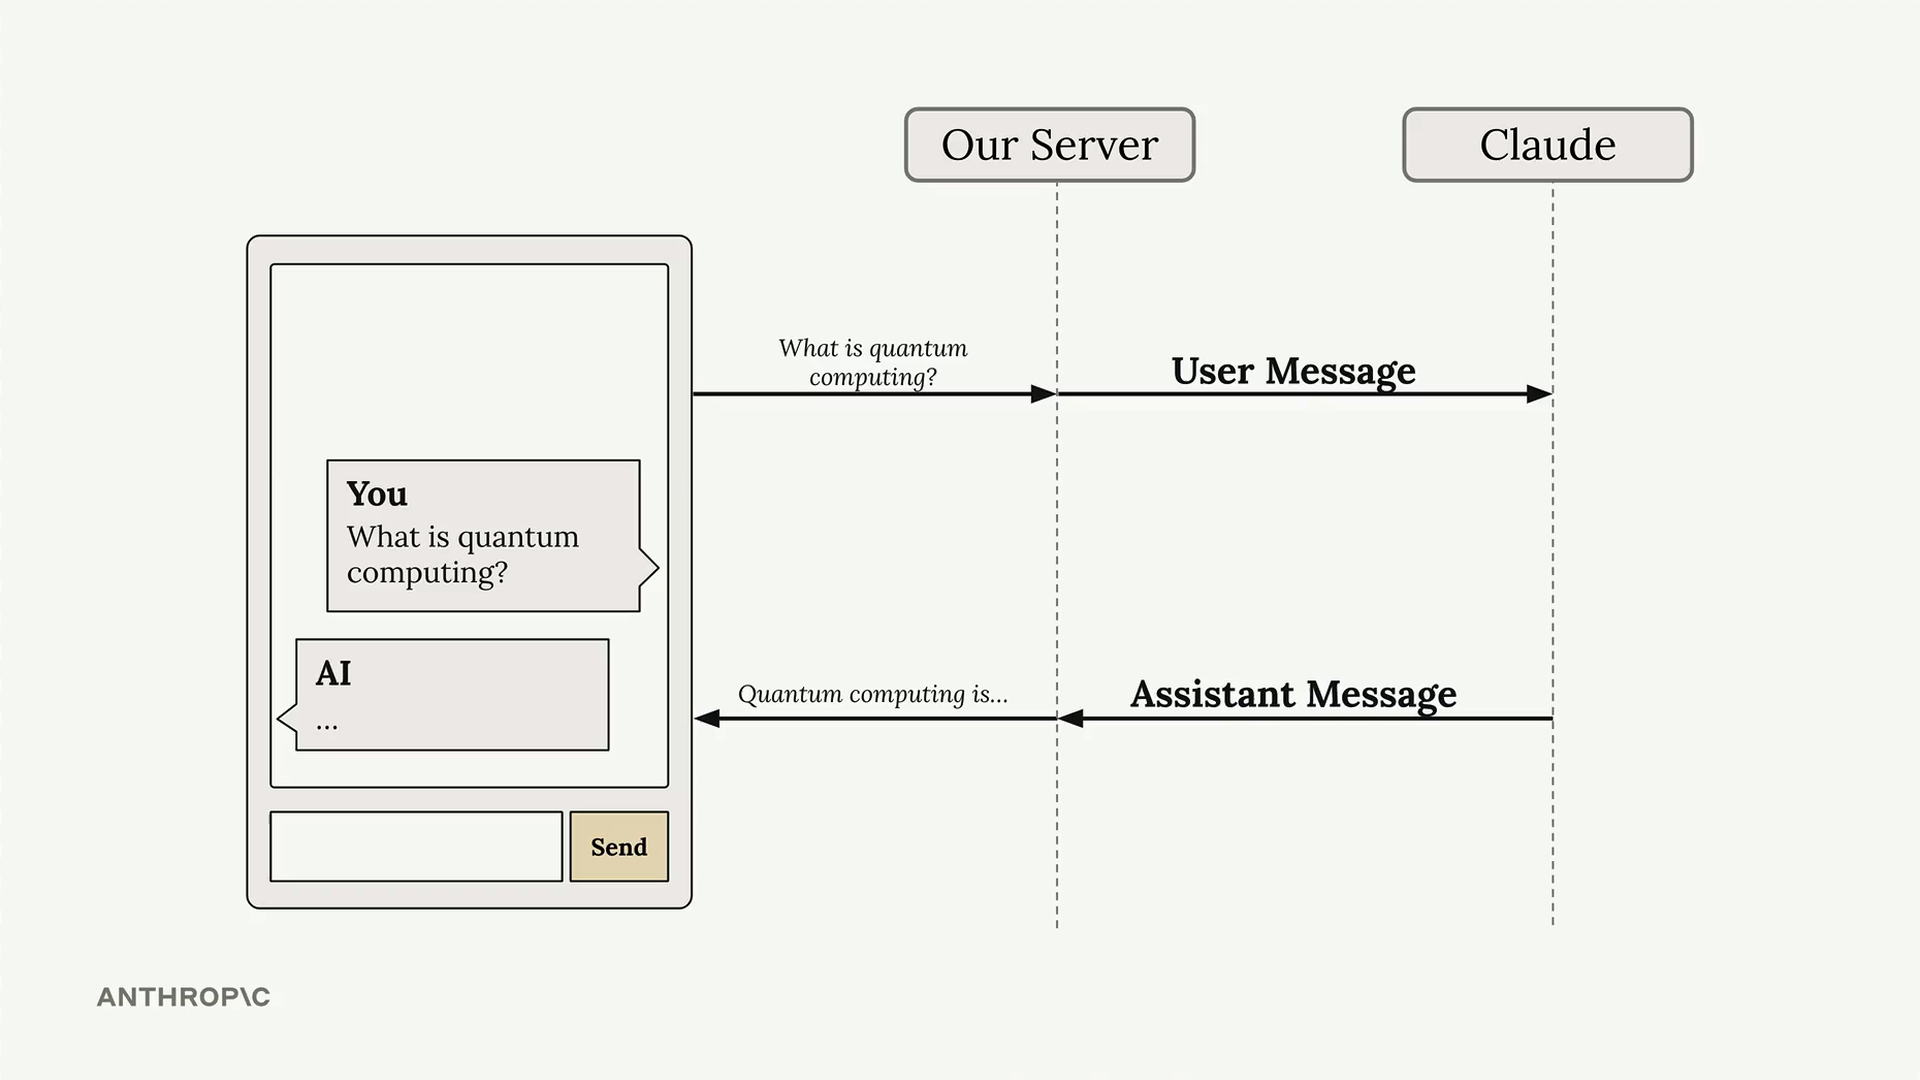
El problema con las respuestas estándar
En una configuración de chat típica, tu servidor envía un mensaje del usuario a Claude y espera la respuesta completa antes de enviar algo de vuelta al cliente. Esto crea un retraso incómodo en el que los usuarios no tienen retroalimentación de que algo está sucediendo.
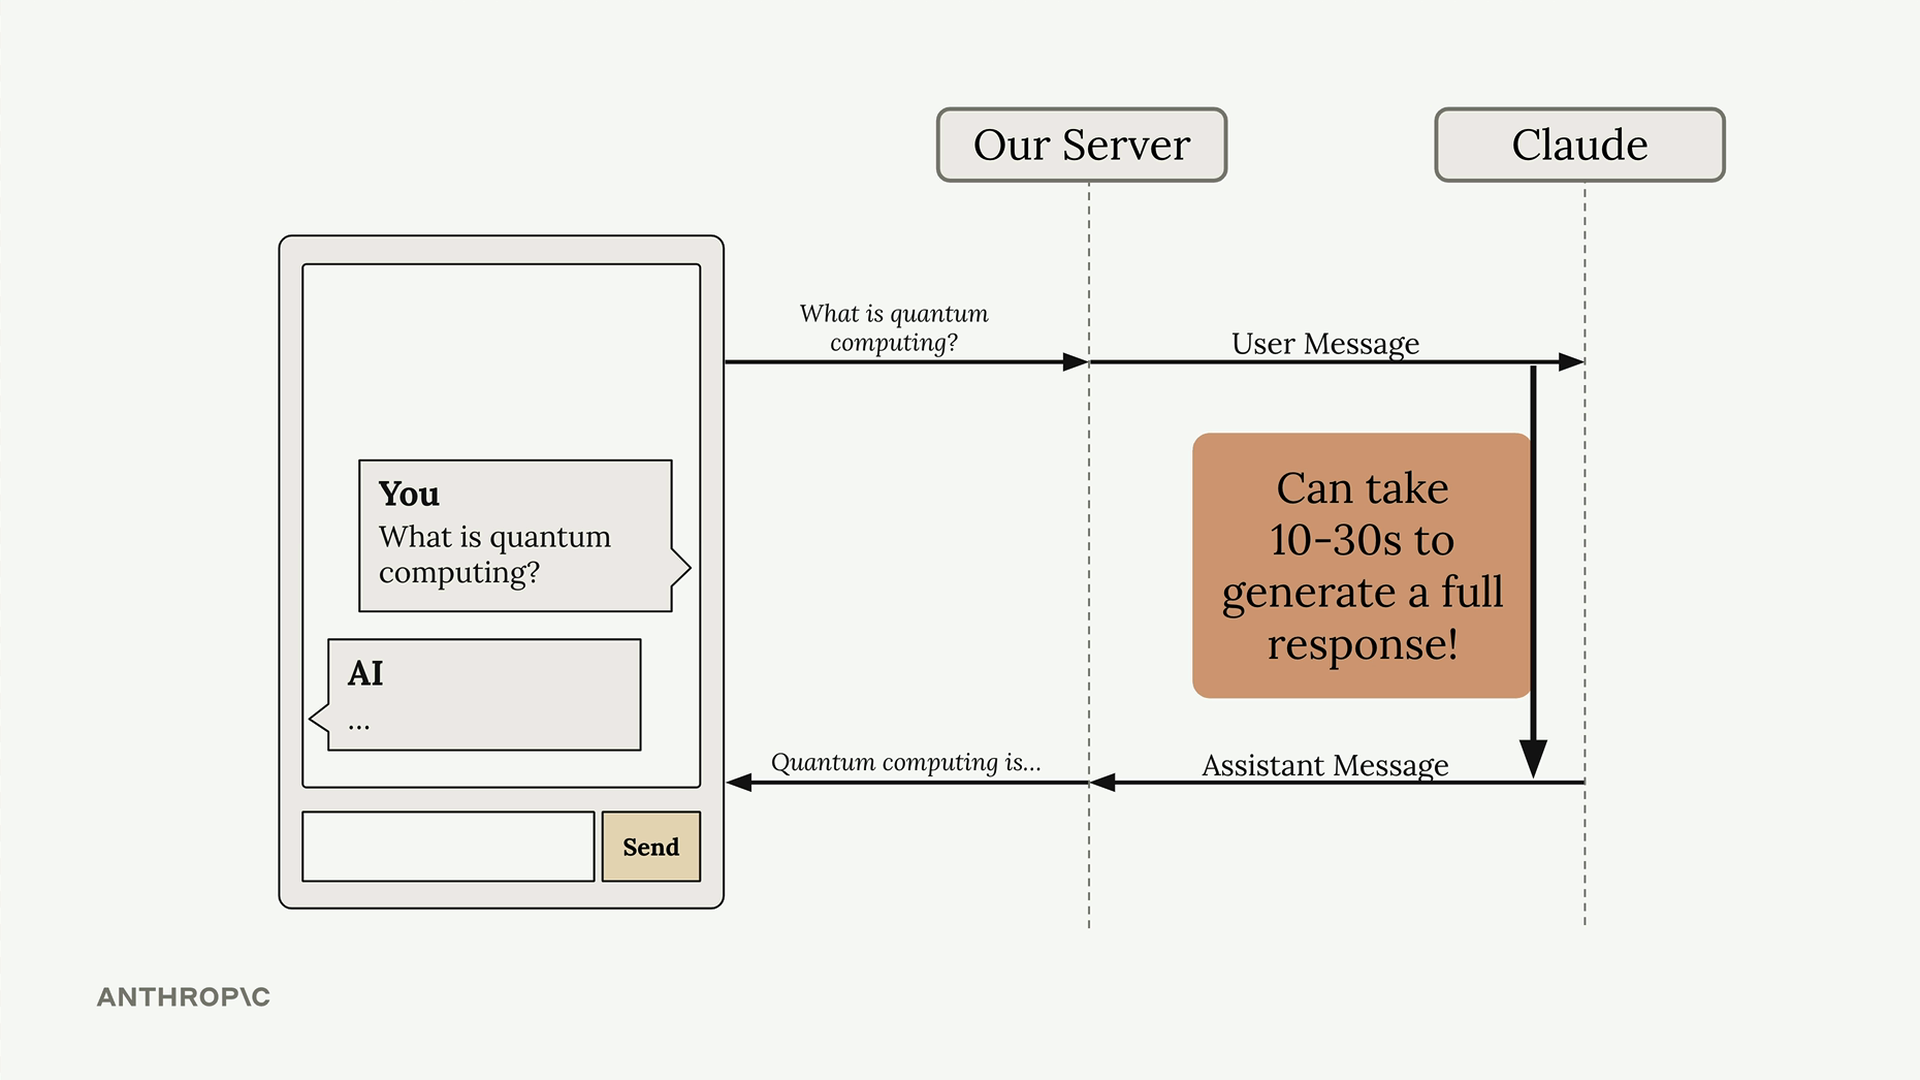
Cómo funciona el streaming
Con el streaming habilitado, Claude envía inmediatamente una respuesta inicial indicando que ha recibido tu solicitud y está comenzando a generar texto. Luego recibes una serie de eventos, cada uno conteniendo una pequeña parte de la respuesta general.
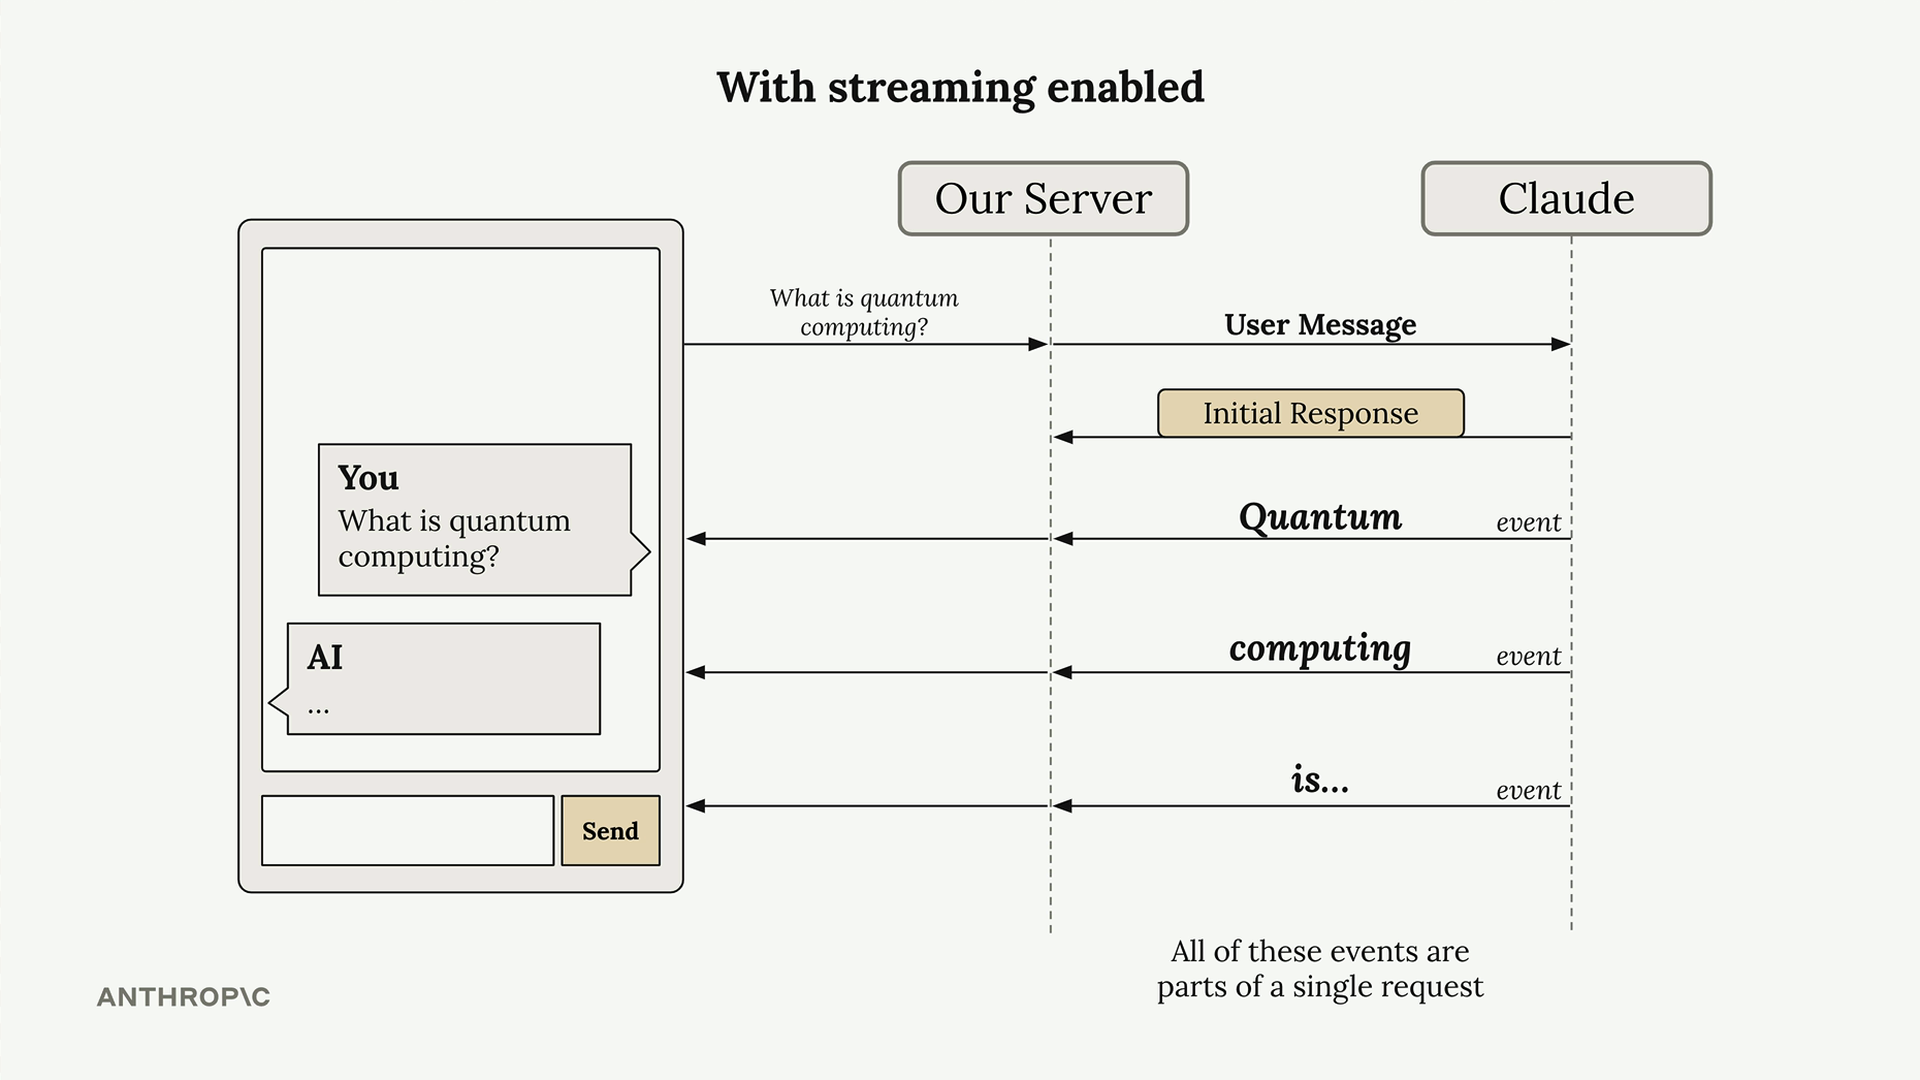
Tu servidor puede reenviar estos fragmentos de texto a tu aplicación cliente a medida que llegan, permitiendo a los usuarios ver la respuesta construirse palabra por palabra. Todos estos eventos son parte de una única solicitud a Claude.
Entendiendo los eventos de stream
Cuando habilitas el streaming, Claude envía varios tipos de eventos:
- MessageStart - Se está enviando un nuevo mensaje
- ContentBlockStart - Inicio de un nuevo bloque que contiene texto, uso de herramientas u otro contenido
- ContentBlockDelta - Fragmentos del texto generado real
- ContentBlockStop - El bloque de contenido actual se ha completado
- MessageDelta - El mensaje actual está completo
- MessageStop - Fin de la información sobre el mensaje actual
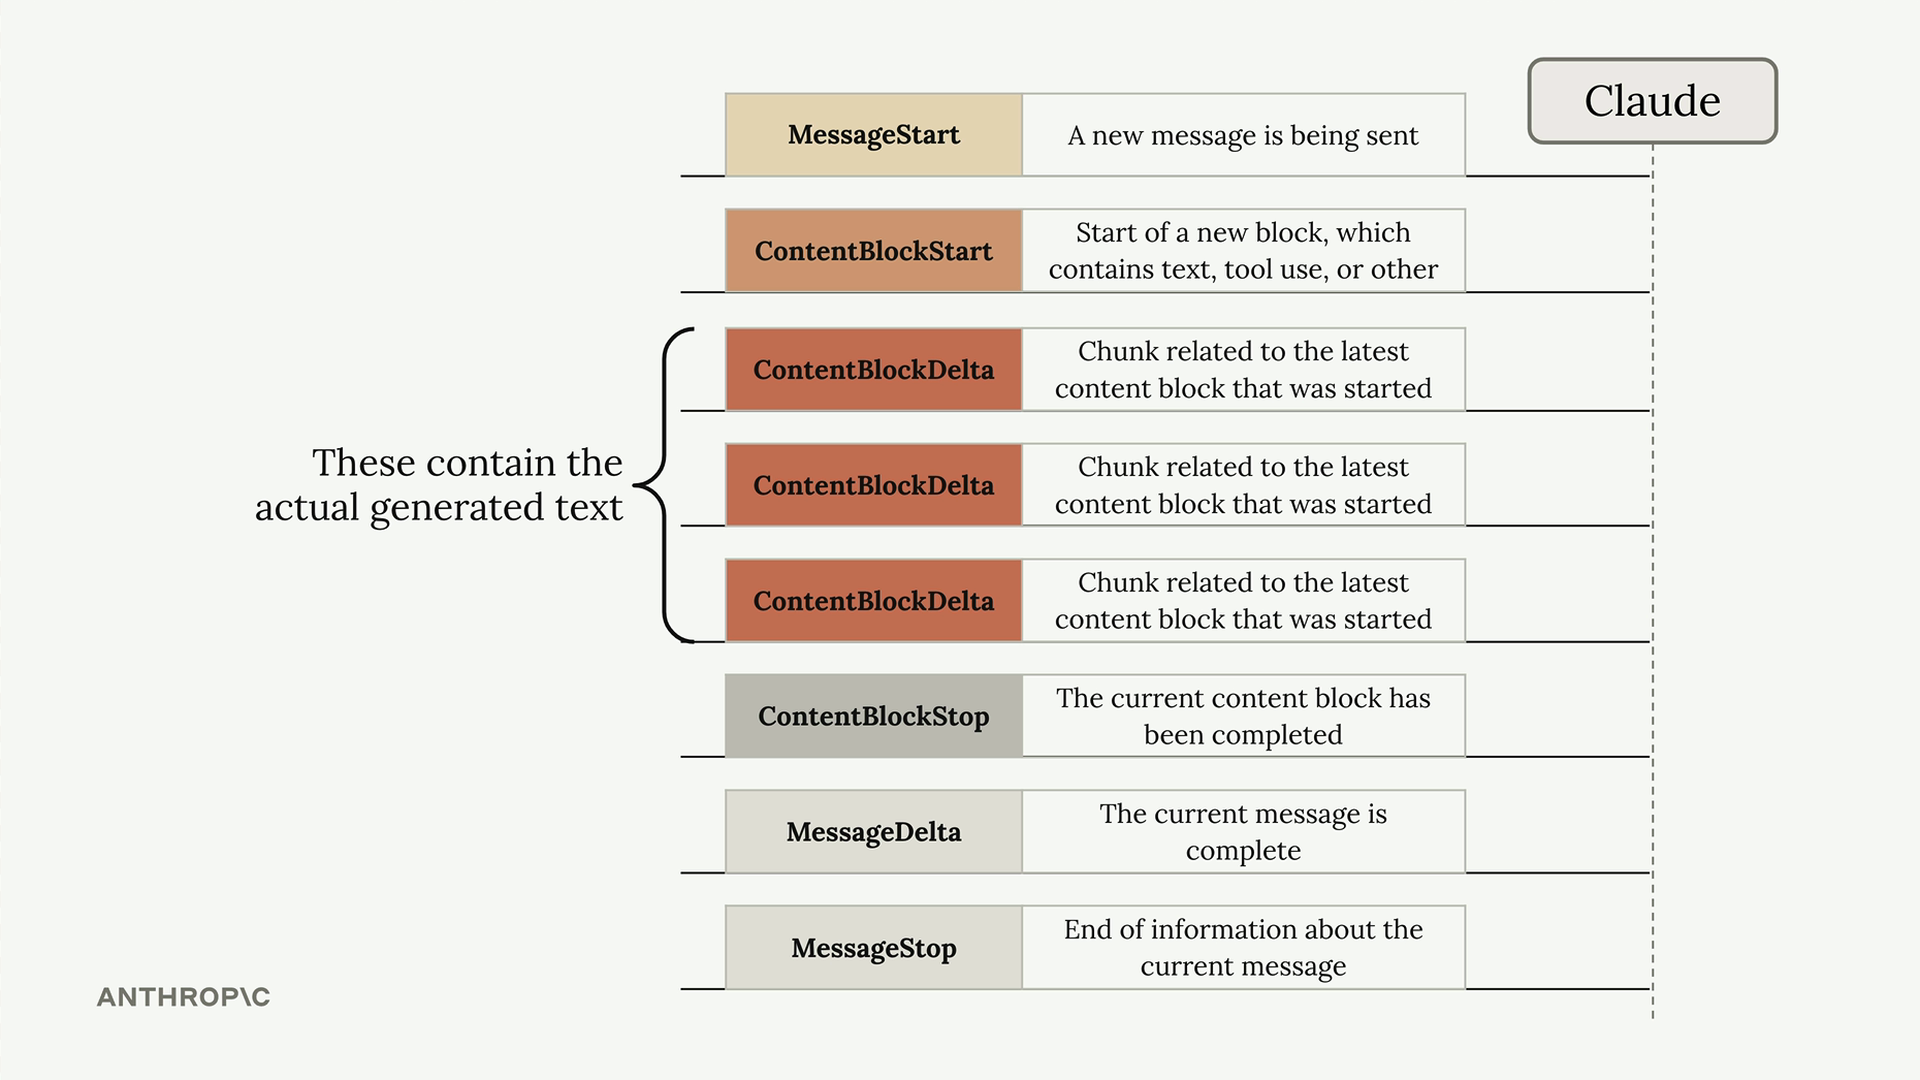
Los eventos ContentBlockDelta contienen el texto generado real que querrás mostrar a los usuarios.
Implementación básica de streaming
Para habilitar el streaming, agrega stream=True a tu llamada messages.create:
messages = []
add_user_message(messages, "Write a 1 sentence description of a fake database")

stream = client.messages.create(
    model=model,
    max_tokens=1000,
    messages=messages,
    stream=True
)

for event in stream:
    print(event)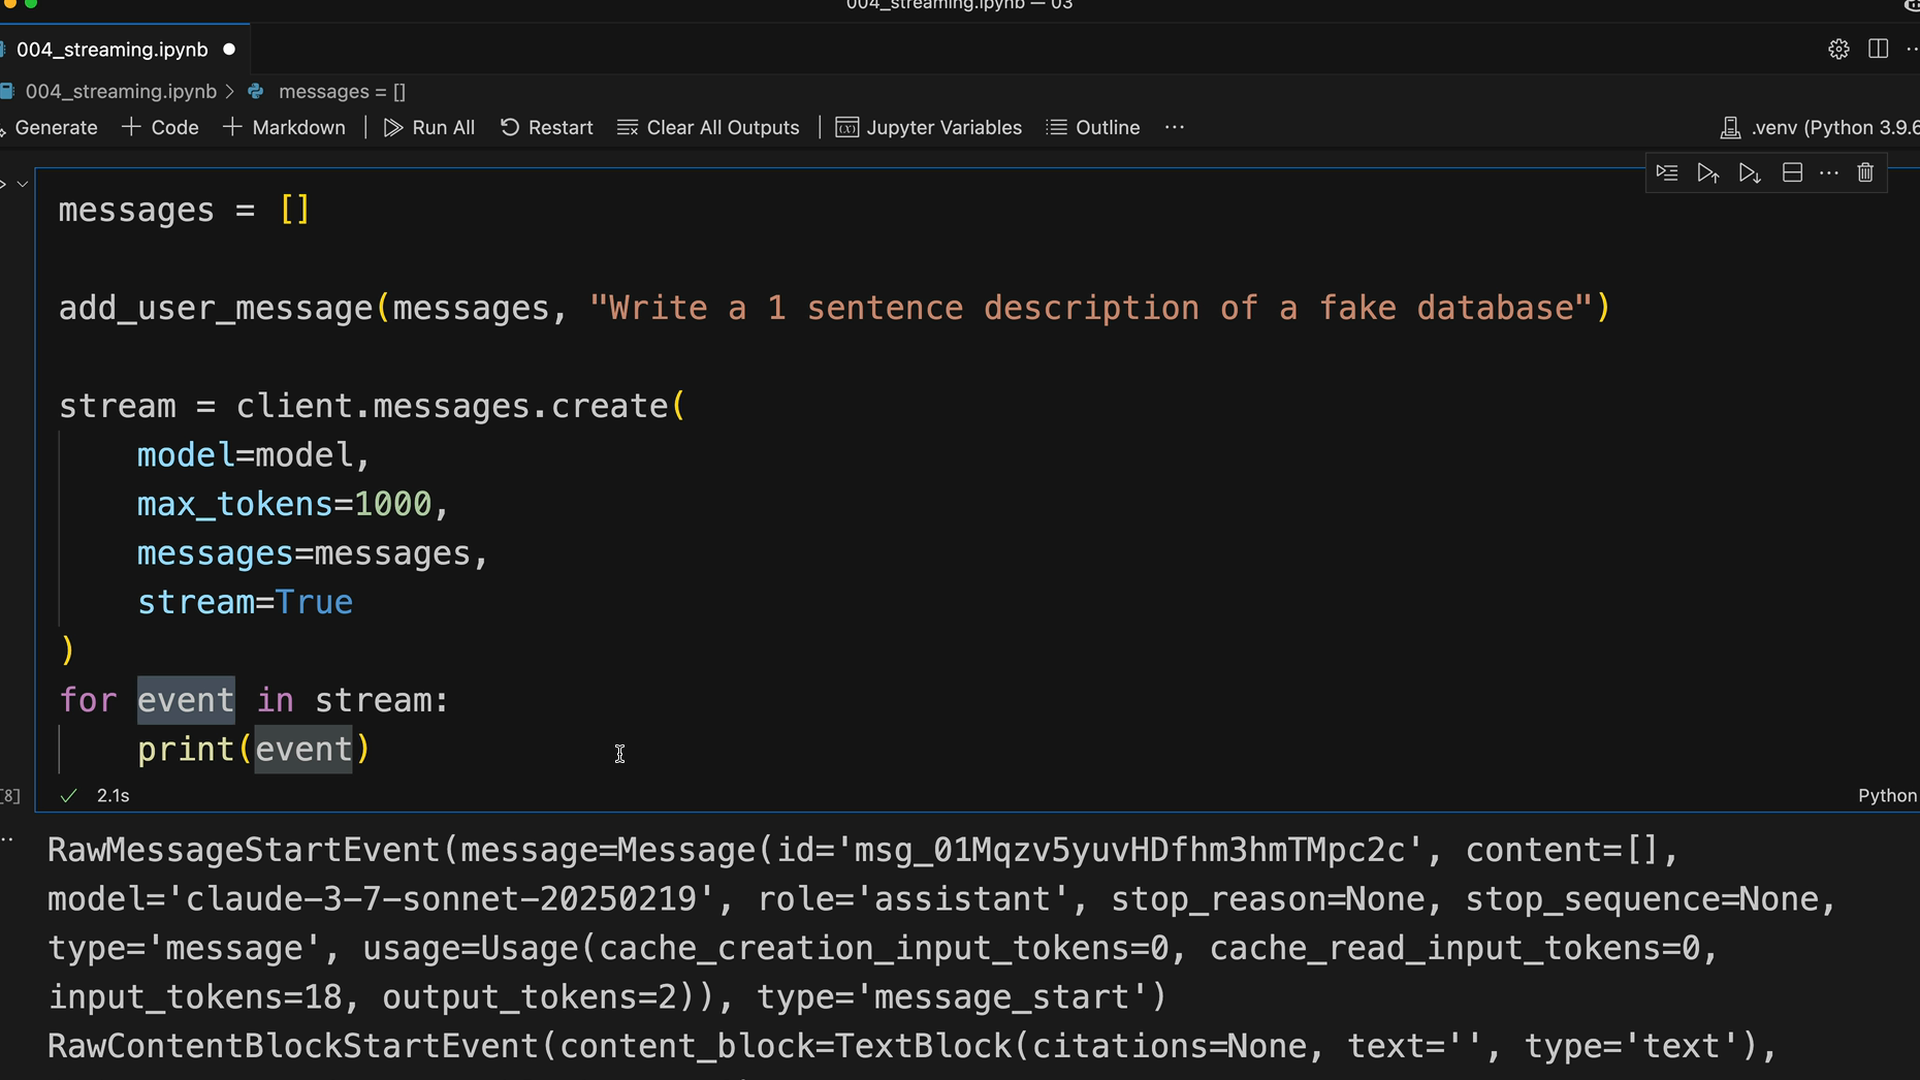
Streaming de texto simplificado
En lugar de analizar manualmente los eventos, puedes usar la interfaz de streaming simplificada del SDK que extrae solo el contenido de texto:
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        print(text, end="")
Este enfoque filtra automáticamente todo excepto el contenido de texto real, que generalmente es lo que necesitas para mostrar respuestas a los usuarios.
Obteniendo el mensaje final
Aunque el streaming es excelente para la experiencia de usuario, a menudo necesitas el mensaje completo para almacenamiento o procesamiento adicional. Después de que el streaming se complete, puedes obtener el mensaje final ensamblado:
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        pass  # Send to client in real application

    final_message = stream.get_final_message()
Esto te brinda tanto la capacidad de streaming para la experiencia de usuario como el objeto de mensaje completo para almacenamiento en base de datos o historial de conversación.
Consideraciones prácticas
Cada fragmento de texto en el stream puede contener múltiples palabras o incluso oraciones completas; no tienes garantizado recibir exactamente una palabra por evento. El tamaño del fragmento depende de qué tan rápido Claude genera cada porción de texto.
En aplicaciones de producción, típicamente reenviarás estos fragmentos de texto inmediatamente a tu aplicación cliente a través de WebSockets o Server-Sent Events, permitiendo a los usuarios ver las respuestas aparecer en tiempo real mientras se mantiene el historial completo de la conversación en tu servidor.