El pensamiento extendido es la función avanzada de razonamiento de Claude que le da al modelo tiempo para pensar en problemas complejos antes de generar una respuesta. Cuando está habilitado, Claude produce un proceso de pensamiento visible que los usuarios pueden examinar para entender cómo el modelo abordó su consulta.
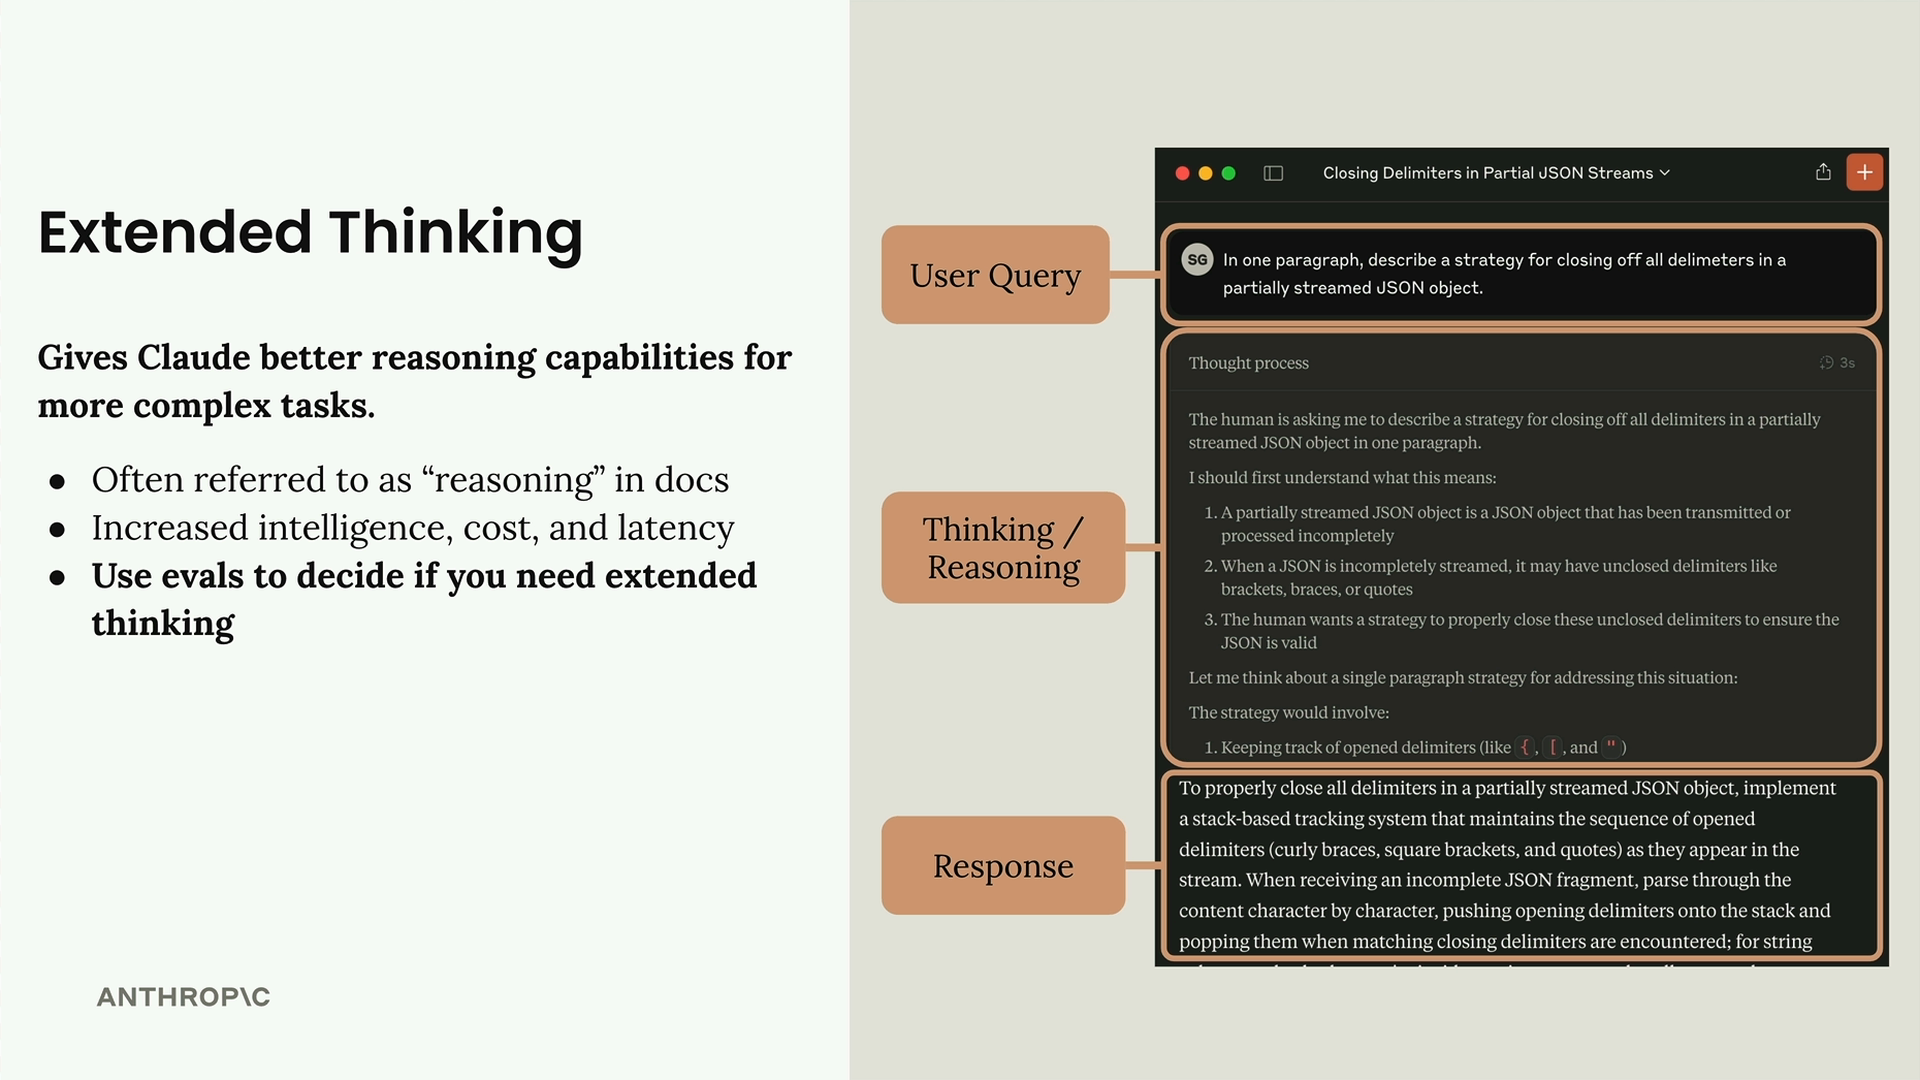
Esta función mejora significativamente la capacidad de Claude para manejar tareas complejas con mayor precisión, pero viene con compensaciones importantes. Se te cobrará por todos los tokens generados durante la fase de pensamiento, y el tiempo de procesamiento adicional aumenta la latencia de respuesta. La clave está en saber cuándo la inteligencia mejorada justifica el costo adicional y el tiempo de espera.
Cuándo usar el pensamiento extendido
La decisión de habilitar el pensamiento extendido debe estar impulsada por tus evaluaciones de prompts. Aquí está el enfoque recomendado:
- Escribe y prueba tu prompt sin pensamiento extendido primero
- Ejecuta evaluaciones para medir la precisión
- Si los resultados no cumplen con tus estándares después de los esfuerzos de optimización del prompt
- Entonces considera habilitar el pensamiento extendido como solución
Cómo el pensamiento extendido cambia las respuestas
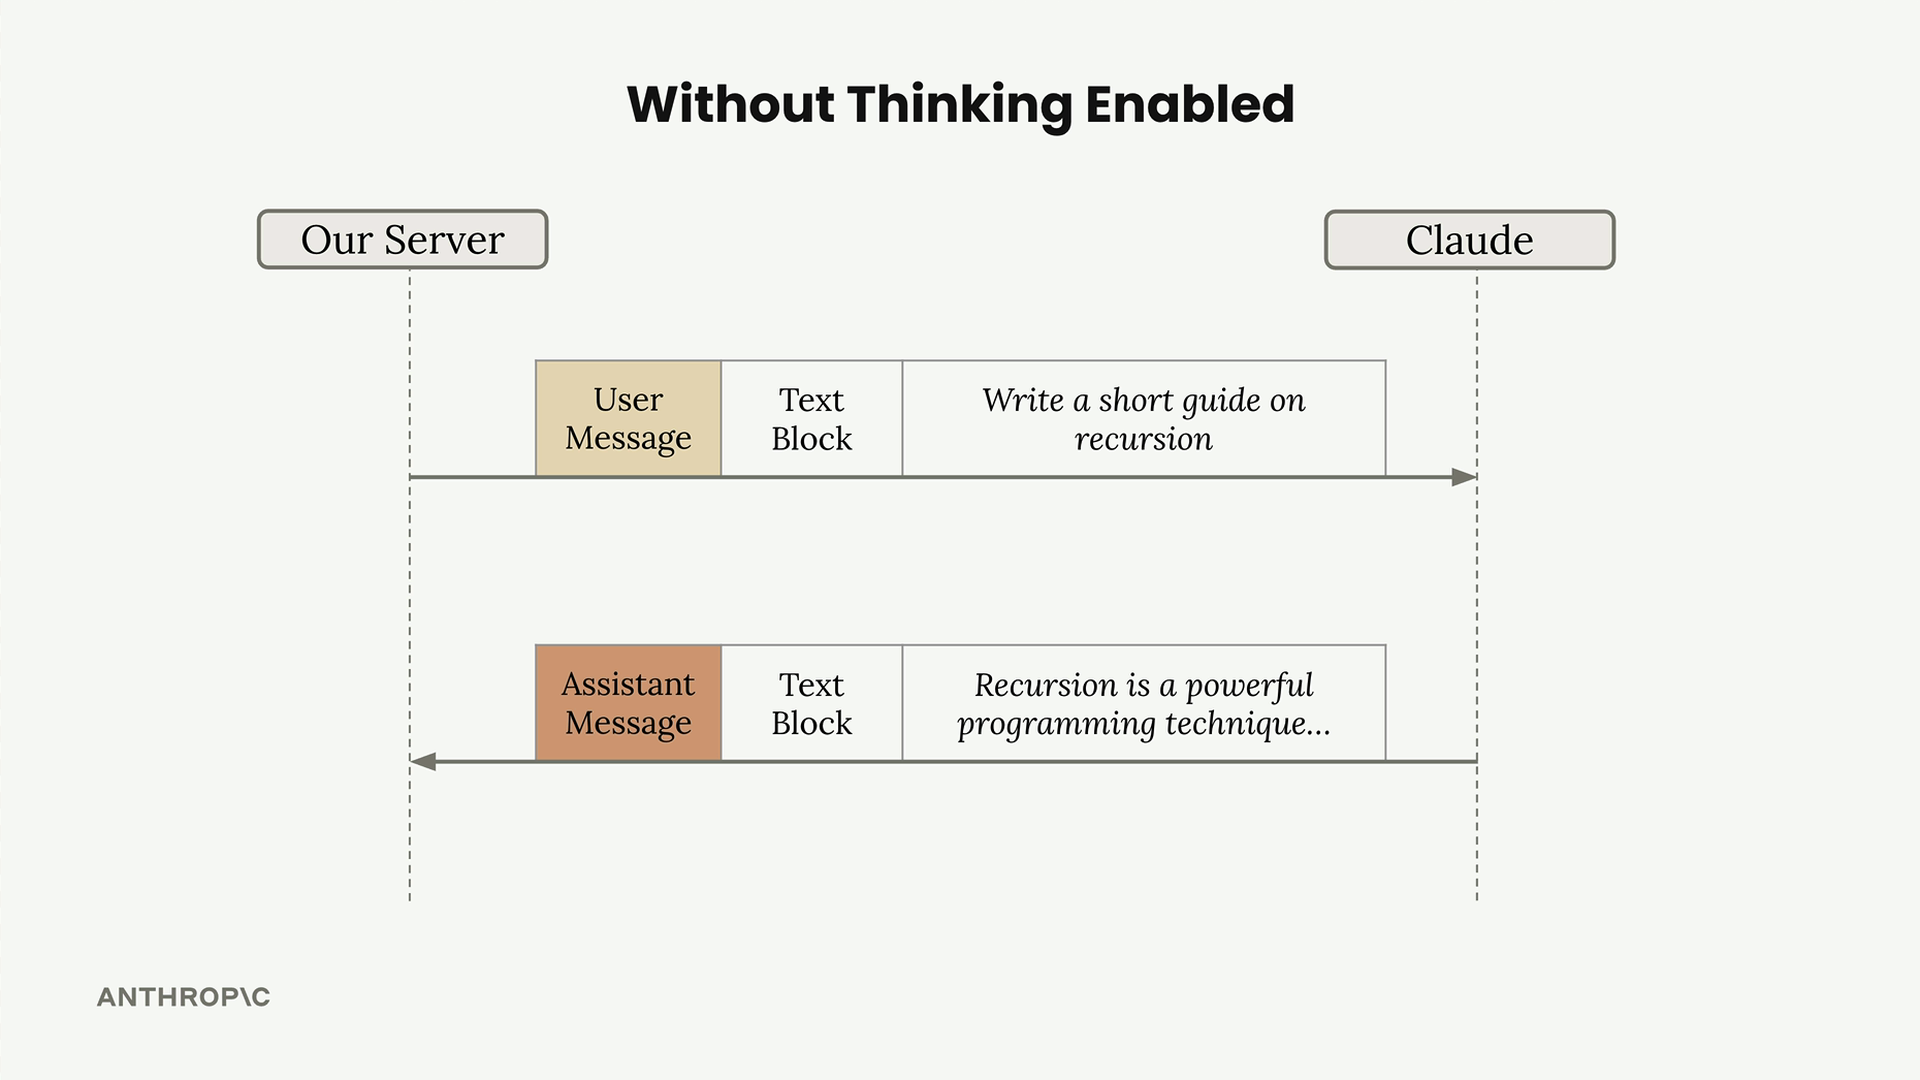
Sin el pensamiento extendido, el flujo de respuesta de Claude es sencillo: envías un mensaje de usuario con un bloque de texto y recibes un mensaje del asistente con un bloque de texto a cambio.
Con el pensamiento extendido habilitado, la estructura de respuesta cambia significativamente. Recibirás un mensaje del asistente que contiene dos bloques distintos:
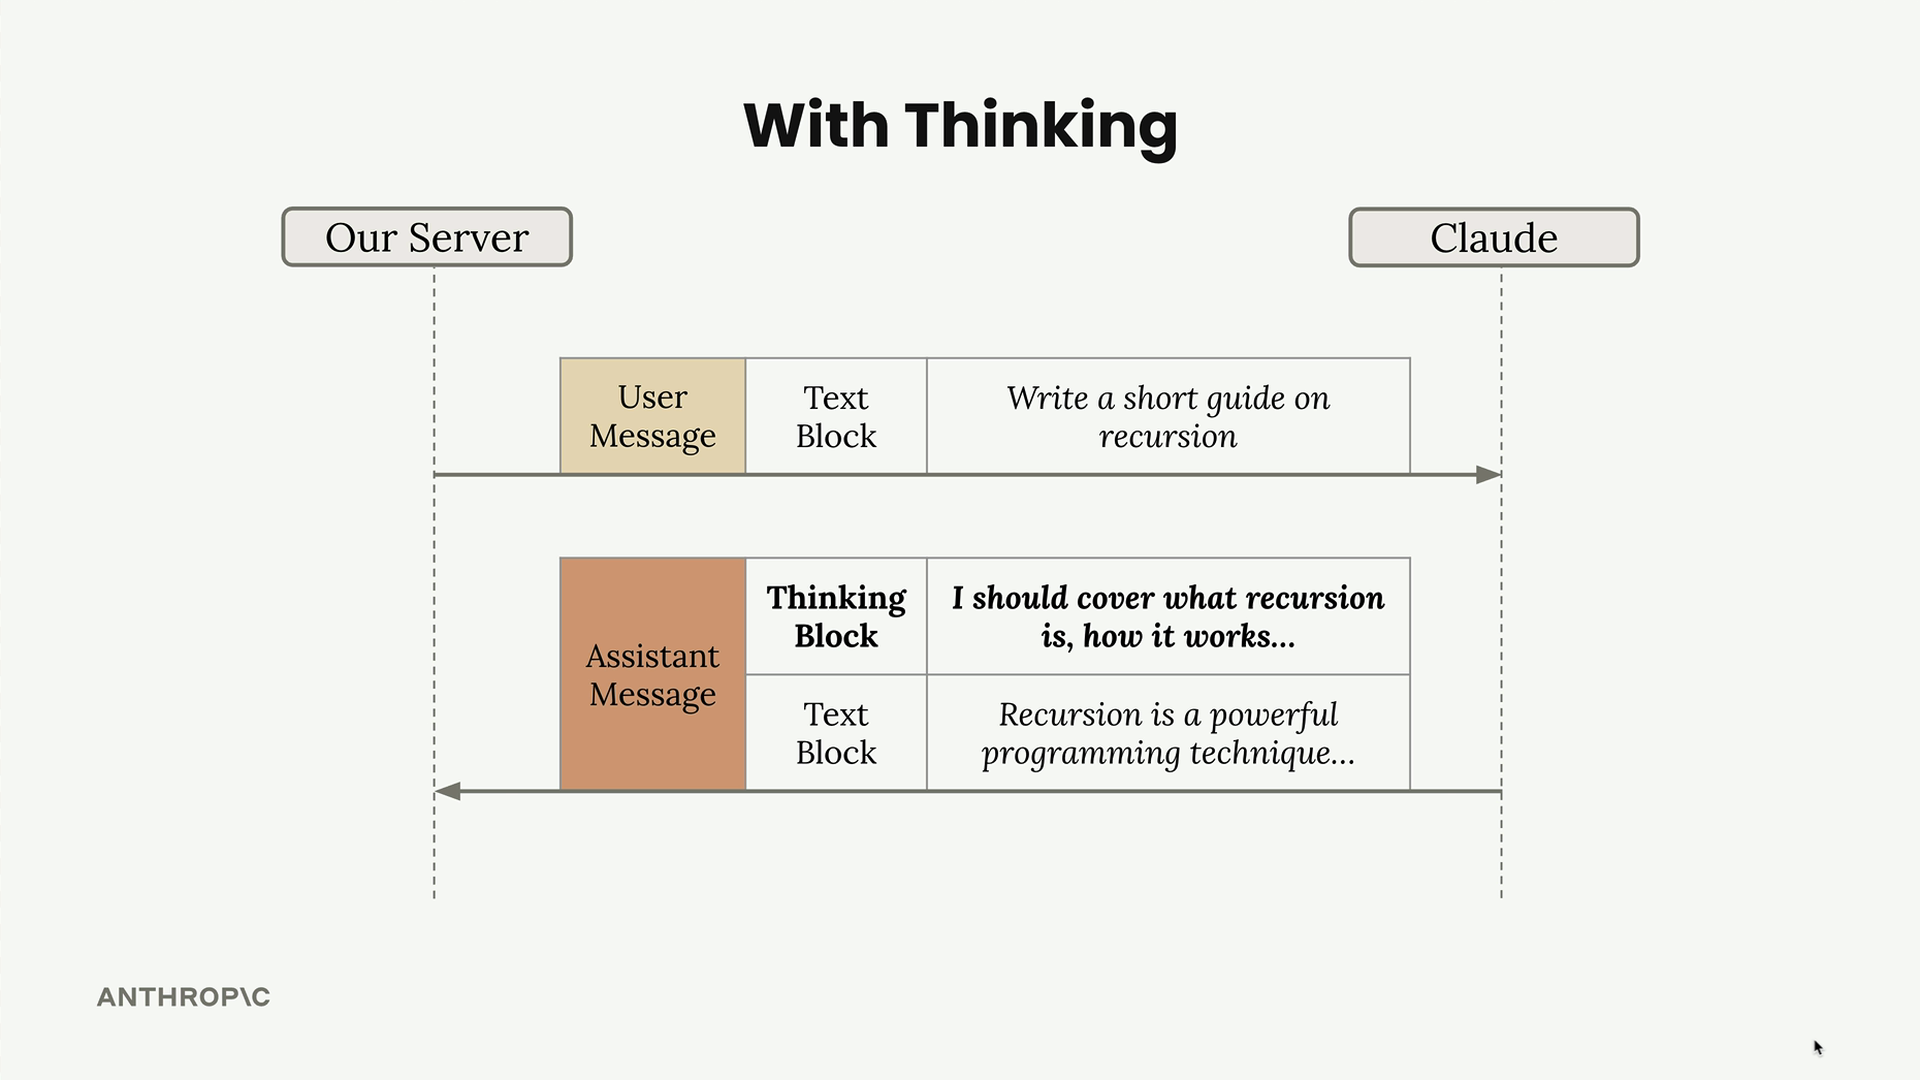
- Un bloque
thinkingque contiene el proceso de razonamiento de Claude - Un bloque
textcon la respuesta final
El sistema de firmas
Cada bloque de pensamiento incluye una firma criptográfica que cumple un propósito de seguridad importante. Esta firma asegura que el texto de pensamiento no haya sido modificado cuando incluyes el mensaje en turnos de conversación futuros.
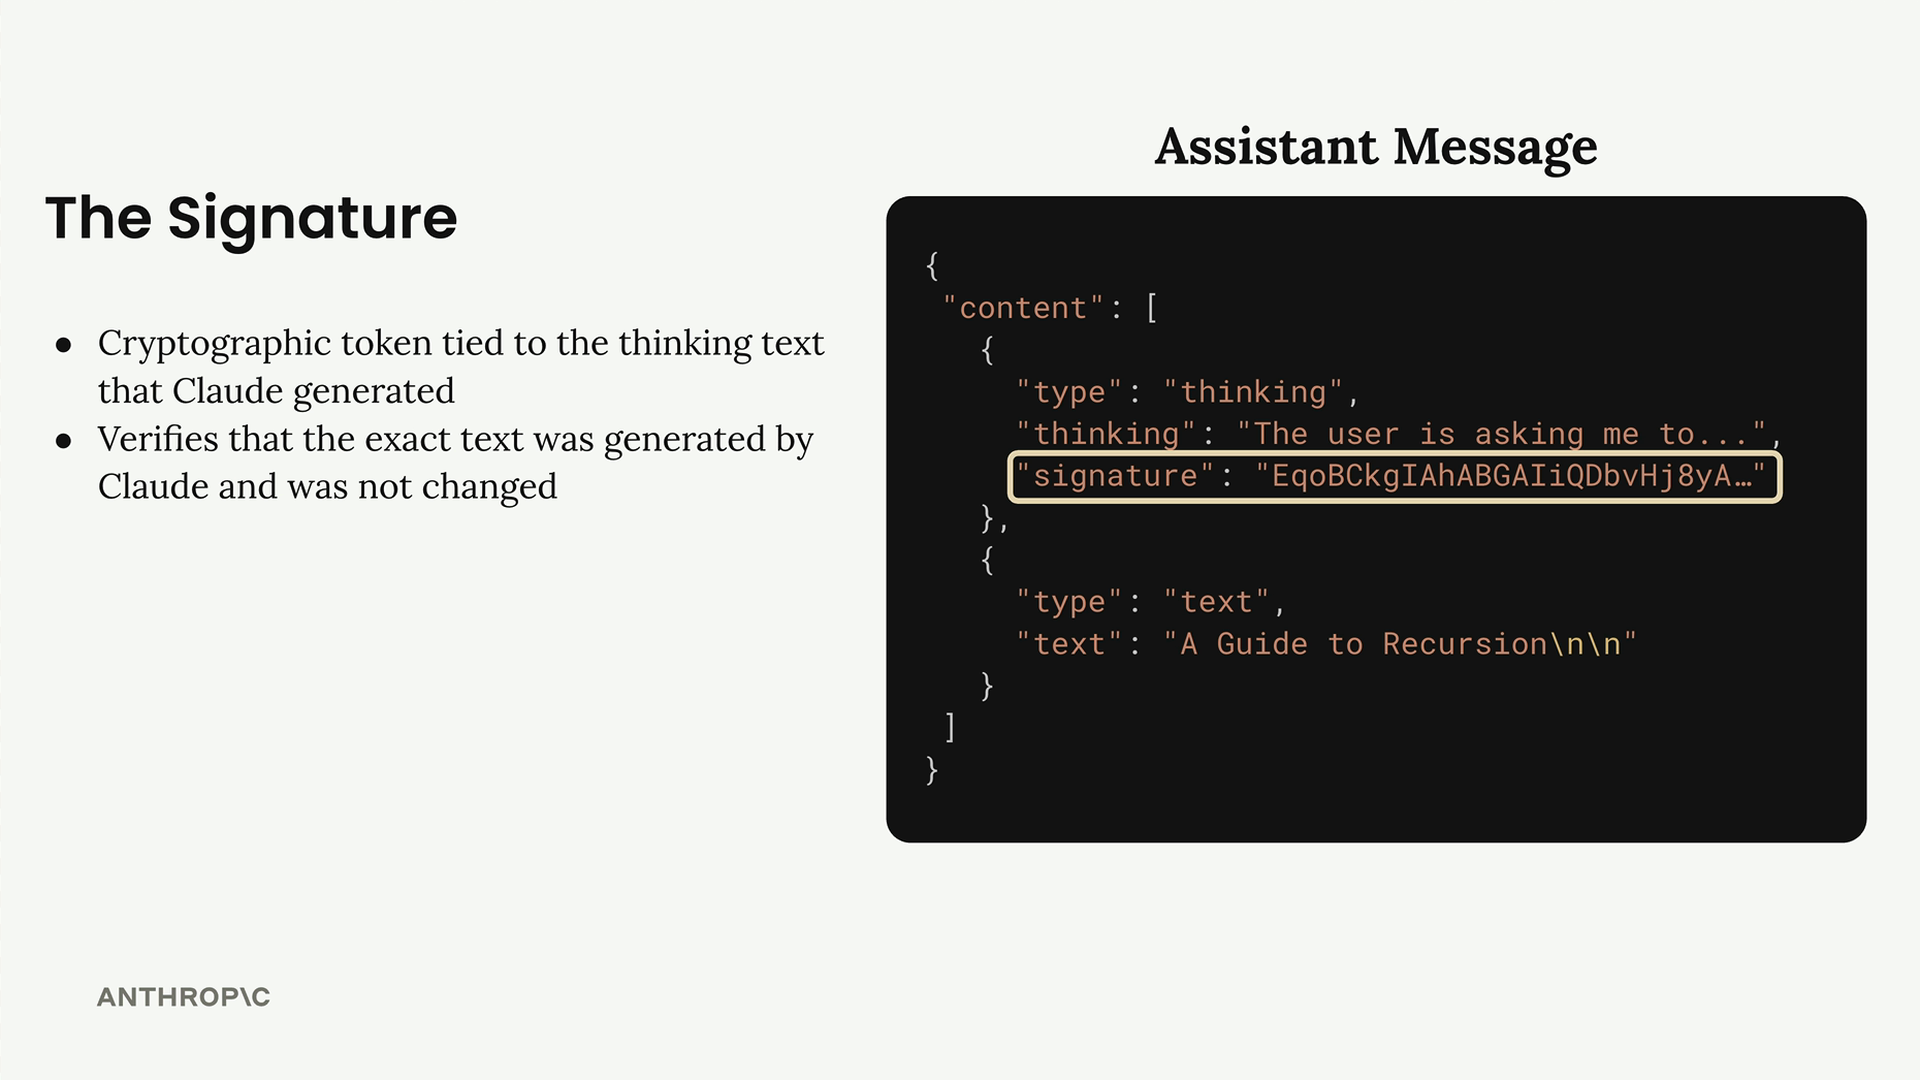
Claude depende en gran medida del contenido de pensamiento para la generación de respuestas, por lo que prevenir la manipulación es crucial para mantener un comportamiento seguro y consistente. Si modificas el texto de pensamiento, la validación de la firma fallará.
Pensamiento redactado
A veces el proceso de pensamiento de Claude es marcado por los sistemas internos de seguridad. Cuando esto sucede, recibirás un bloque de pensamiento redactado en lugar del texto de pensamiento sin procesar.
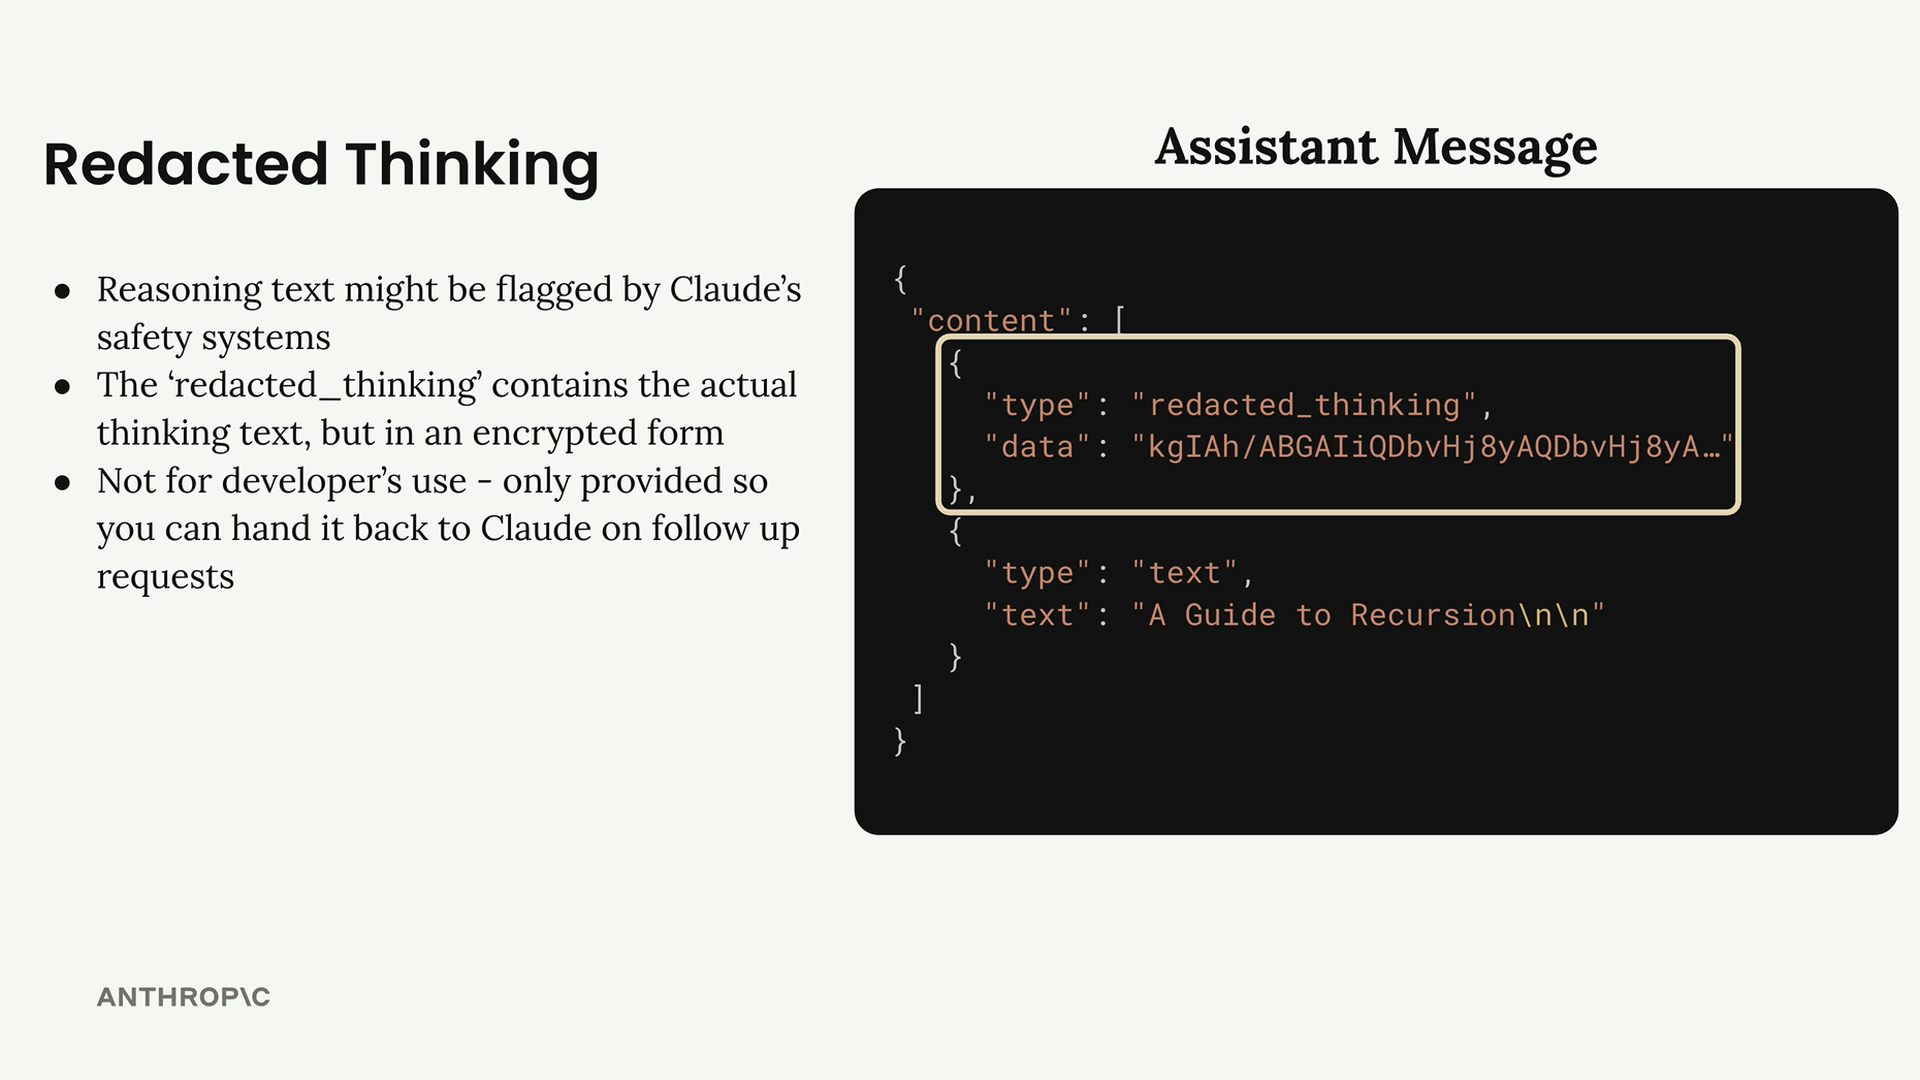
El contenido redactado contiene el texto de pensamiento real en forma encriptada. Aunque no puedes leerlo, aún puedes incluir este bloque en turnos de conversación futuros para que Claude no pierda el contexto de su razonamiento anterior.
Implementación
Para habilitar el pensamiento extendido en tu código, necesitarás modificar tu función de chat con dos nuevos parámetros:
def chat(
    messages,
    system=None,
    temperature=1.0,
    stop_sequences=[],
    tools=None,
    thinking=False,
    thinking_budget=1024
):
El presupuesto de pensamiento representa el máximo de tokens que Claude puede usar para el razonamiento. El valor mínimo permitido es 1024 tokens. Es importante destacar que tu parámetro max_tokens debe exceder tu presupuesto de pensamiento; si estableces un presupuesto de pensamiento de 1024, max_tokens debe ser al menos 1025.
En la práctica, querrás un margen mucho más amplio. Por ejemplo, con un presupuesto de pensamiento de 1024 y max_tokens de 4000, Claude puede usar hasta 1024 tokens para pensar y hasta 2976 tokens para la respuesta real.
Agrega la configuración de pensamiento a tus parámetros de API cuando la función esté habilitada:
if thinking:
    params["thinking"] = {
        "type": "enabled",
        "budget_tokens": thinking_budget
    }
Probando respuestas redactadas
Durante el desarrollo, es posible que quieras probar cómo tu aplicación maneja los bloques de pensamiento redactados. Puedes forzar a Claude a devolver una respuesta redactada incluyendo esta cadena de activación especial en tu mensaje:
TRIGGER_REDACTED_THINKING_46C9A13E193C177646C7398A98432ECCCE4C1253D5E2D82641AC0E52CC2876CBEsto asegura que tu manejo de errores funcione correctamente al encontrar contenido redactado en producción.