Un flujo de trabajo típico de evaluación de prompts sigue cinco pasos clave que te ayudan a mejorar sistemáticamente tus prompts mediante una medición objetiva. Aunque existen muchas formas diferentes de ensamblar estos flujos de trabajo y diversas herramientas de código abierto y de pago disponibles, comprender el proceso central te ayuda a empezar en pequeño y escalar según sea necesario.
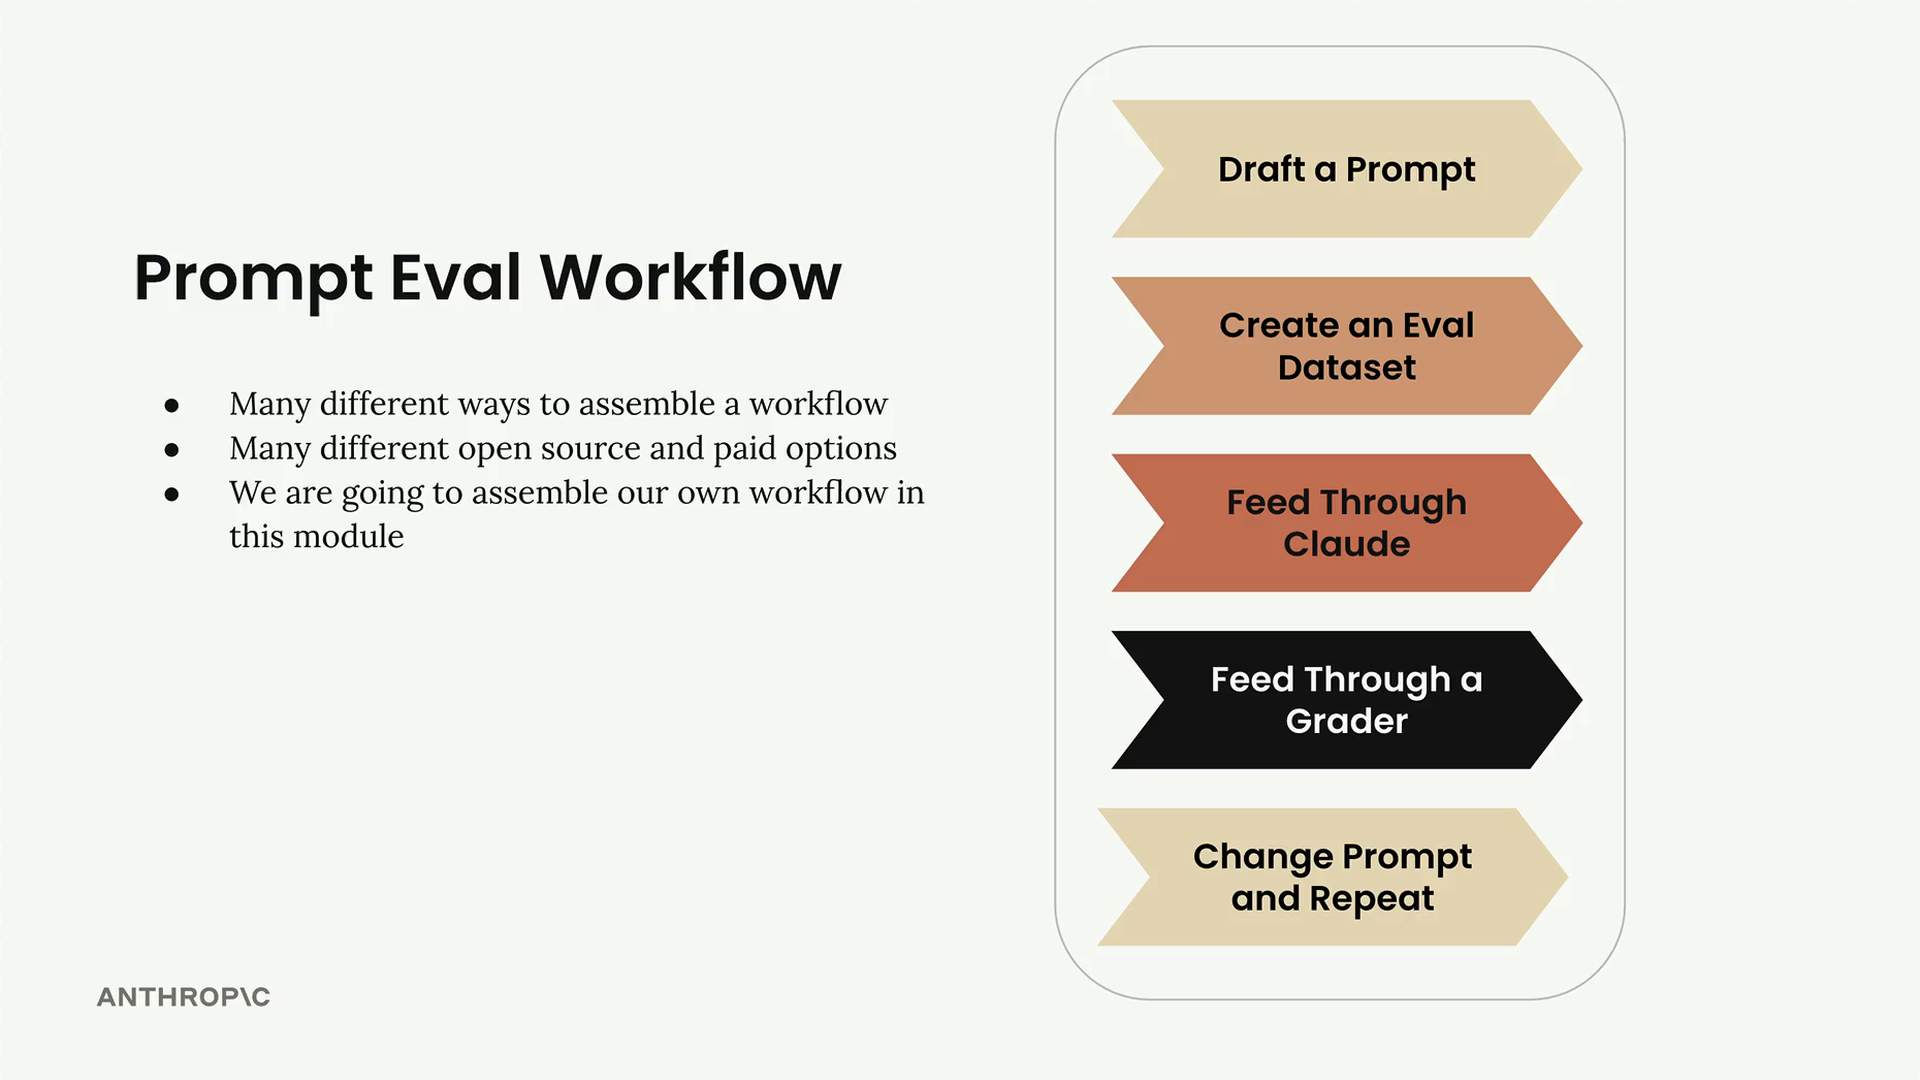
Paso 1: Redacta un prompt
Comienza escribiendo un prompt inicial que quieras mejorar. Para este ejemplo, usaremos un prompt simple:
prompt = f"""
Please answer the user's question:

{question}
"""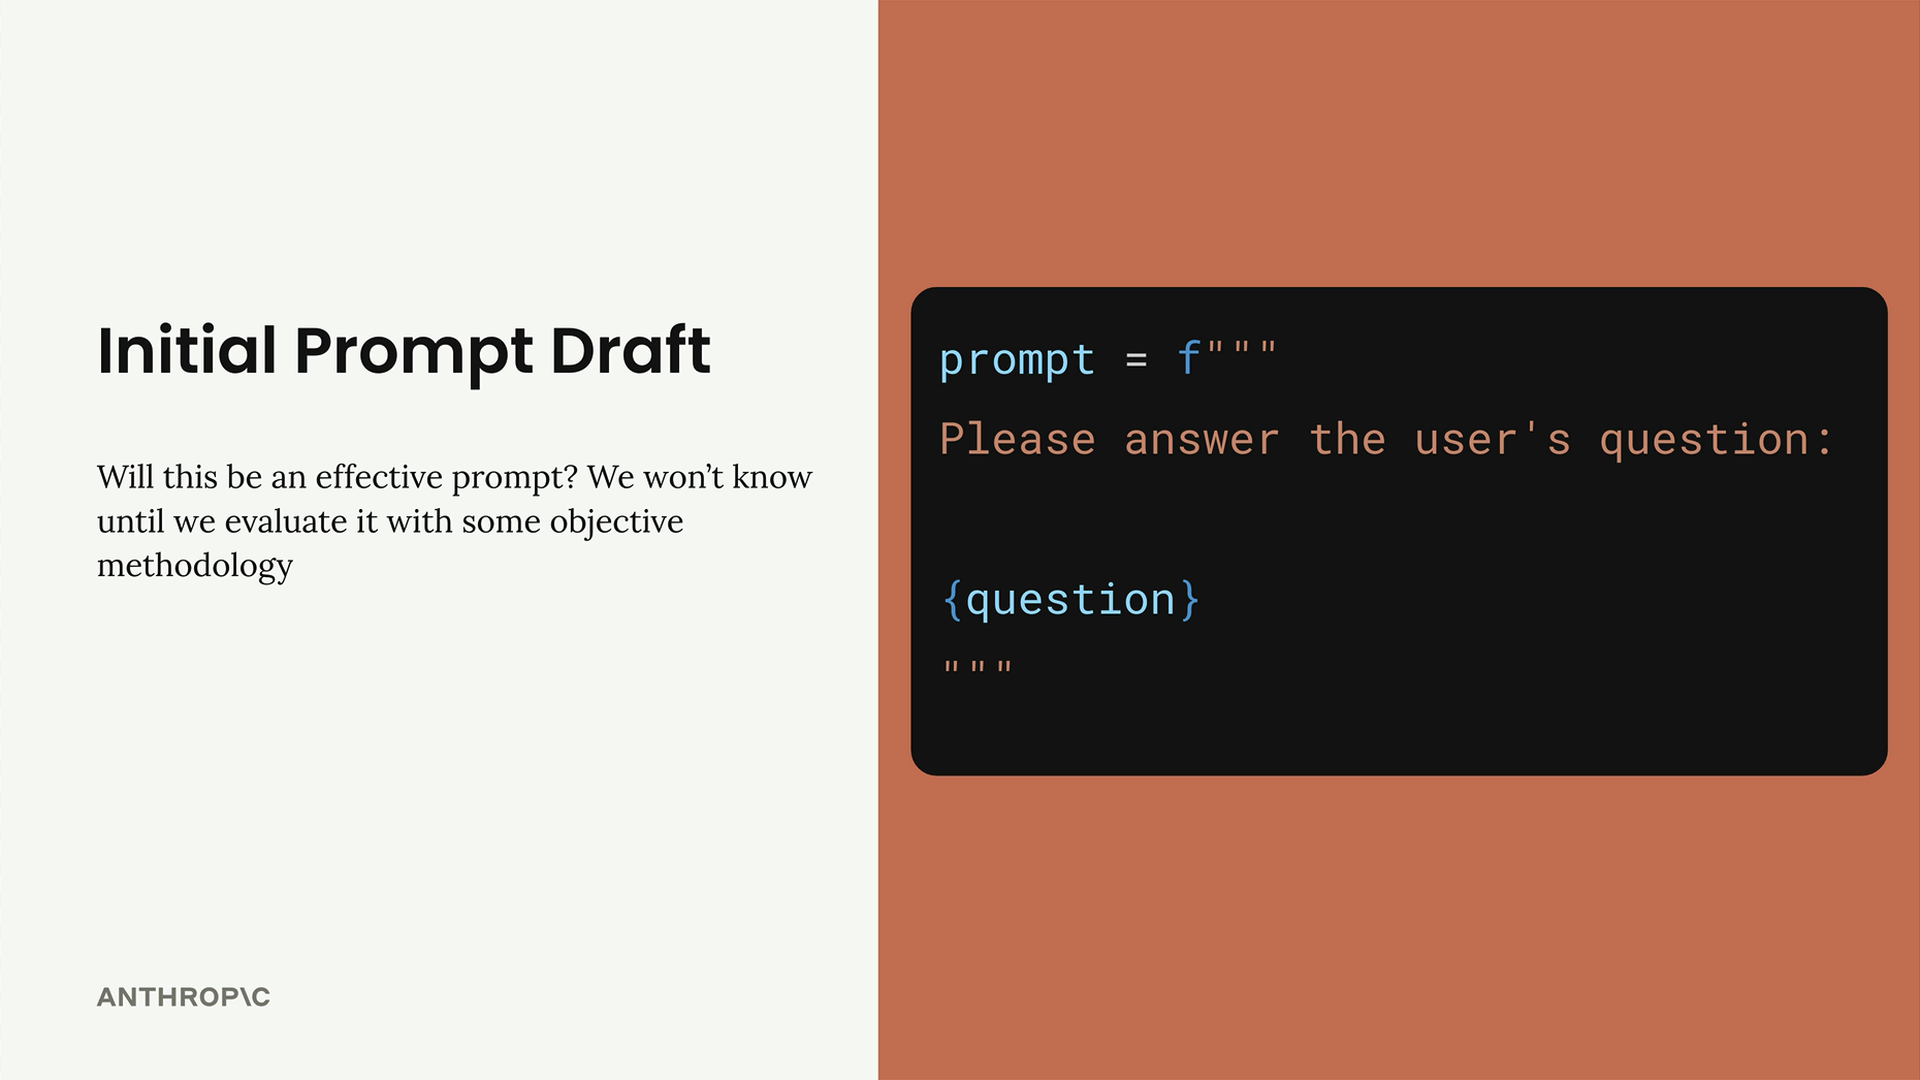
Este prompt básico servirá como nuestra línea base para las pruebas y la mejora.
Paso 2: Crea un conjunto de datos de evaluación
Tu conjunto de datos de evaluación contiene entradas de muestra que alimentarás a tu prompt. Dado que nuestro prompt solo tiene una entrada (la pregunta del usuario), necesitamos una colección de preguntas diferentes para probar.
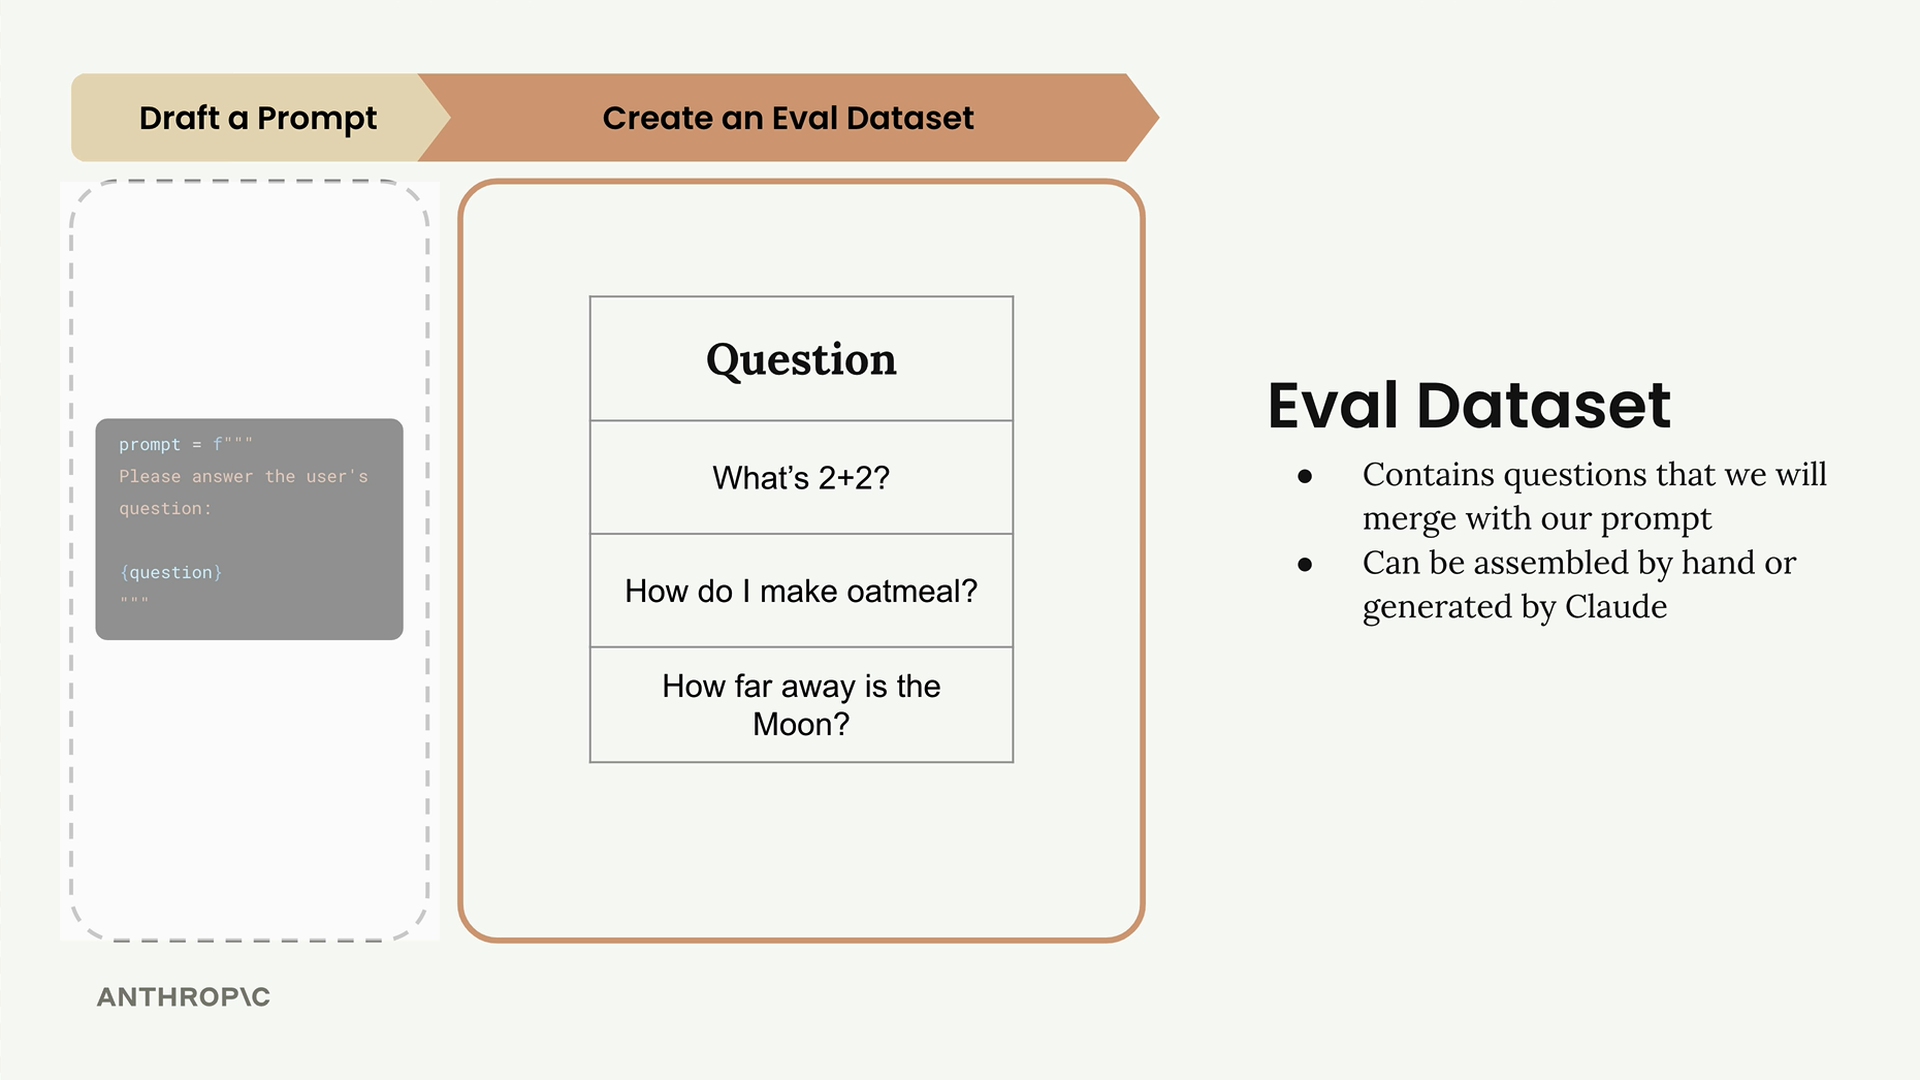
El conjunto de datos contiene preguntas que combinaremos con nuestro prompt. Puedes ensamblar estos conjuntos de datos a mano o generarlos usando Claude. En evaluaciones del mundo real, podrías tener decenas, cientos o incluso miles de registros diferentes, pero comenzaremos con solo tres preguntas para este ejemplo:
- ¿Cuánto es 2+2?
- ¿Cómo hago avena?
- ¿A qué distancia está la Luna?
Paso 3: Pasa las preguntas por Claude
Toma cada pregunta de tu conjunto de datos y combínala con tu plantilla de prompt para crear prompts completos. Luego envía cada uno a Claude y recopila las respuestas.
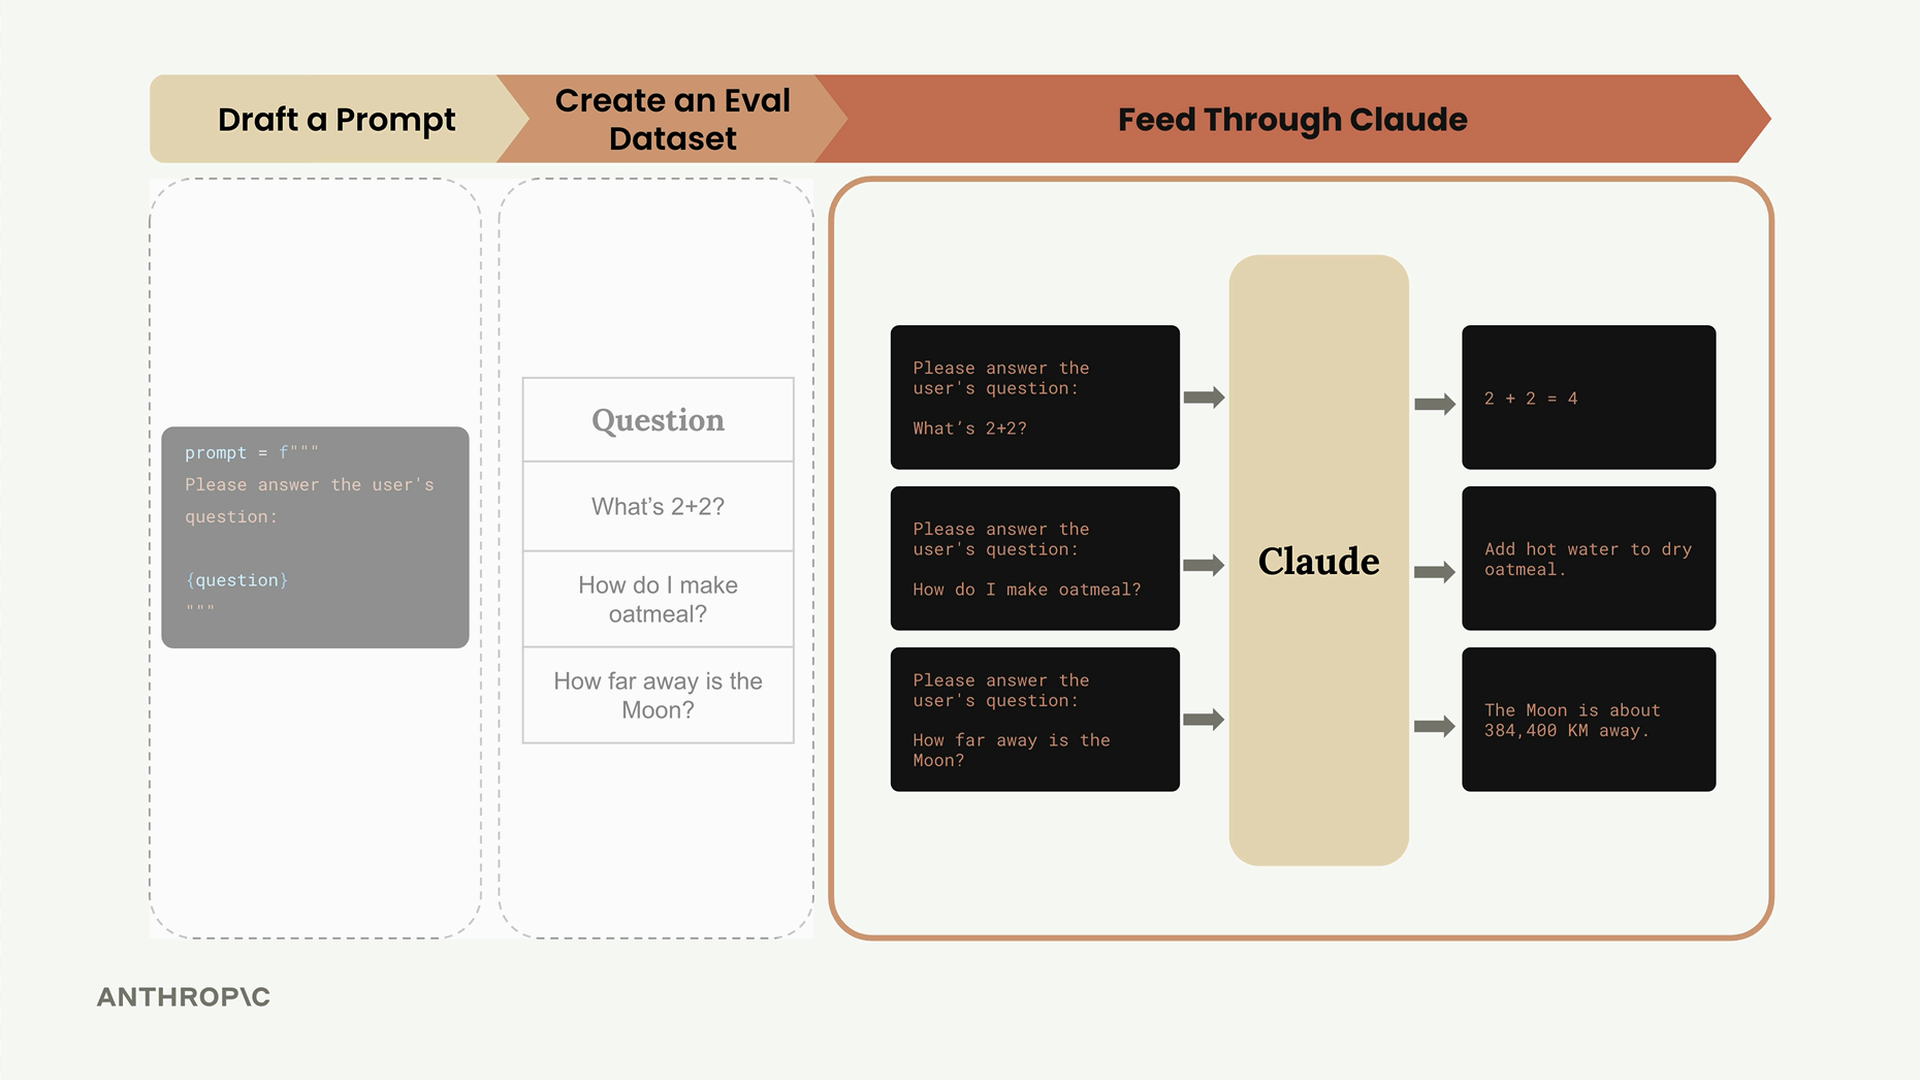
Por ejemplo, la primera pregunta se convierte en un prompt completo que Claude procesa y devuelve una respuesta como "2 + 2 = 4". Repites este proceso para todas las preguntas de tu conjunto de datos, construyendo una colección de pares de pregunta-respuesta.
Paso 4: Pasa las respuestas por un evaluador
Ahora llega el paso crucial de medir objetivamente la calidad de las respuestas de Claude. Tomas cada par de pregunta-respuesta y los alimentas a un evaluador que califica las respuestas.
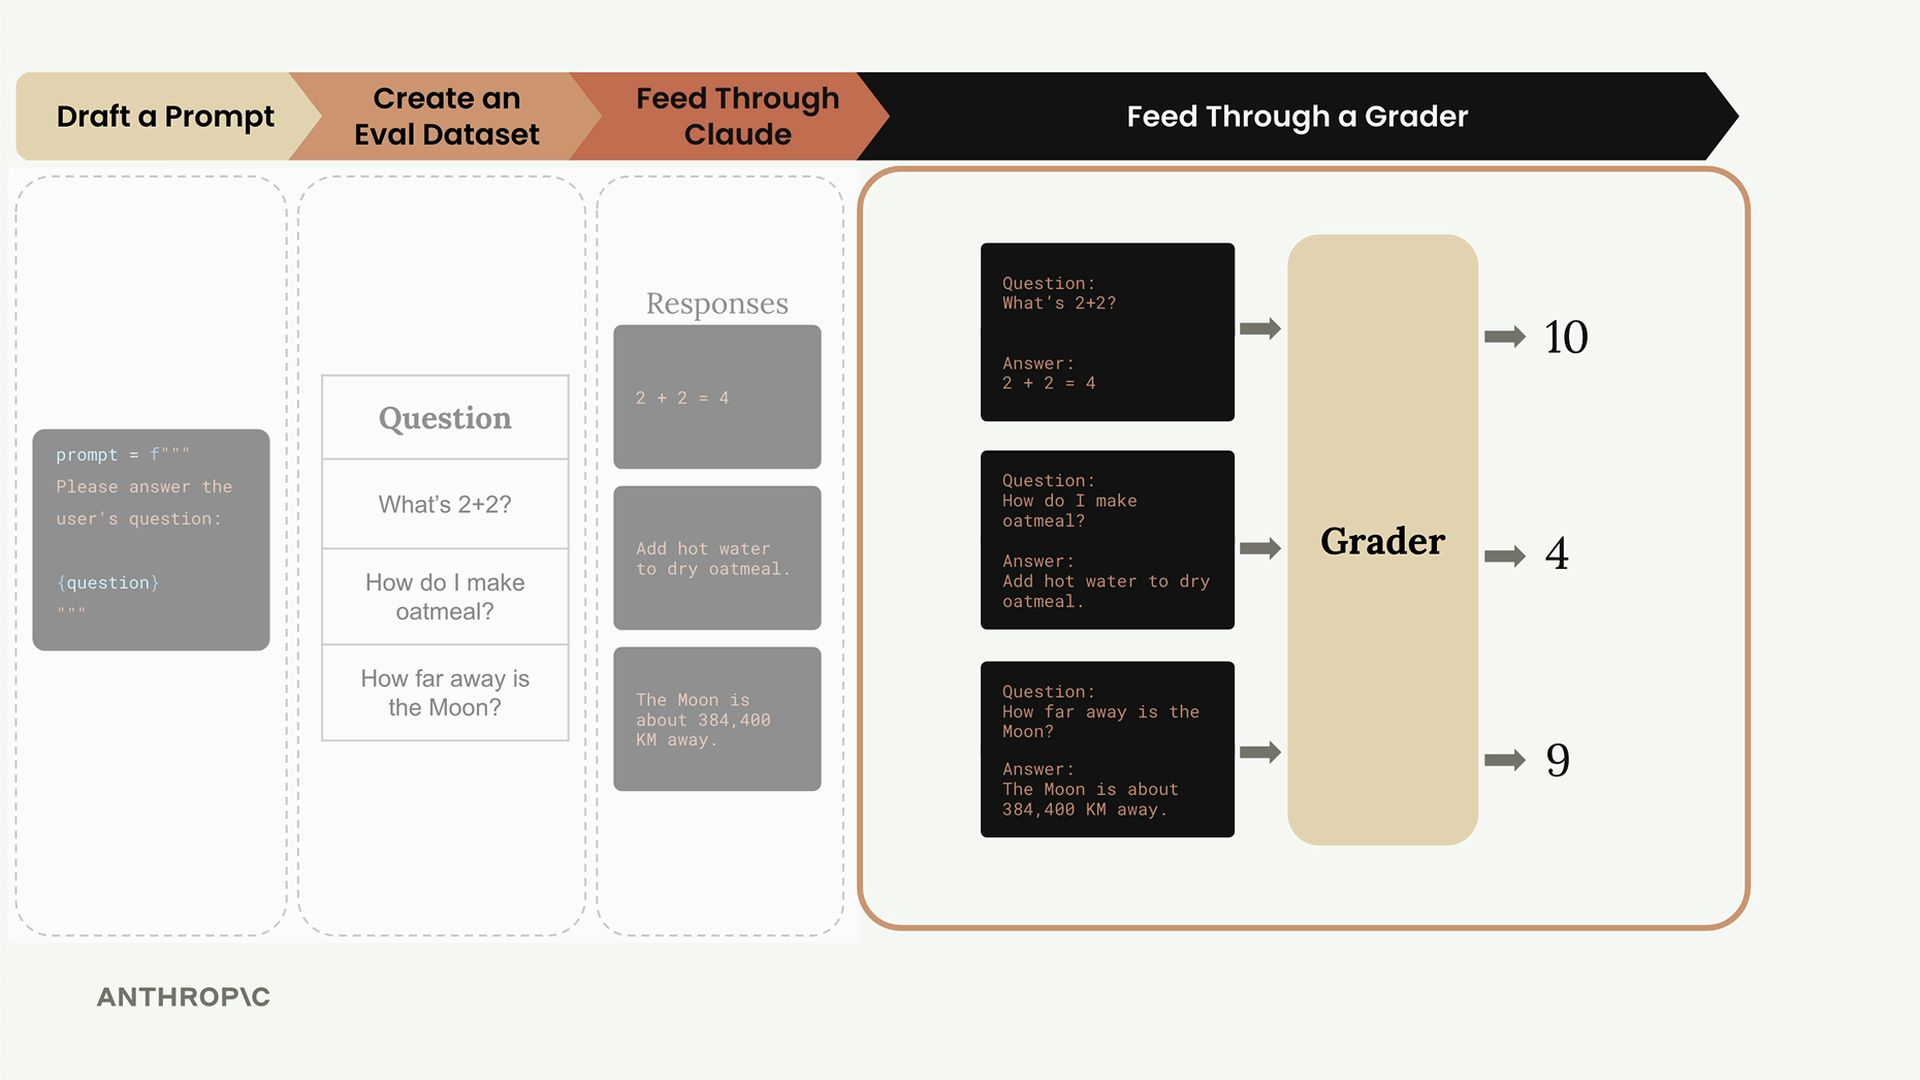
El evaluador asigna puntuaciones (típicamente de 1 a 10) según la calidad de la respuesta:
- 10 = Respuesta perfecta sin margen de mejora
- 4 = Adecuada pero definitivamente con margen de mejora
- Puntuaciones más bajas indican respuestas deficientes
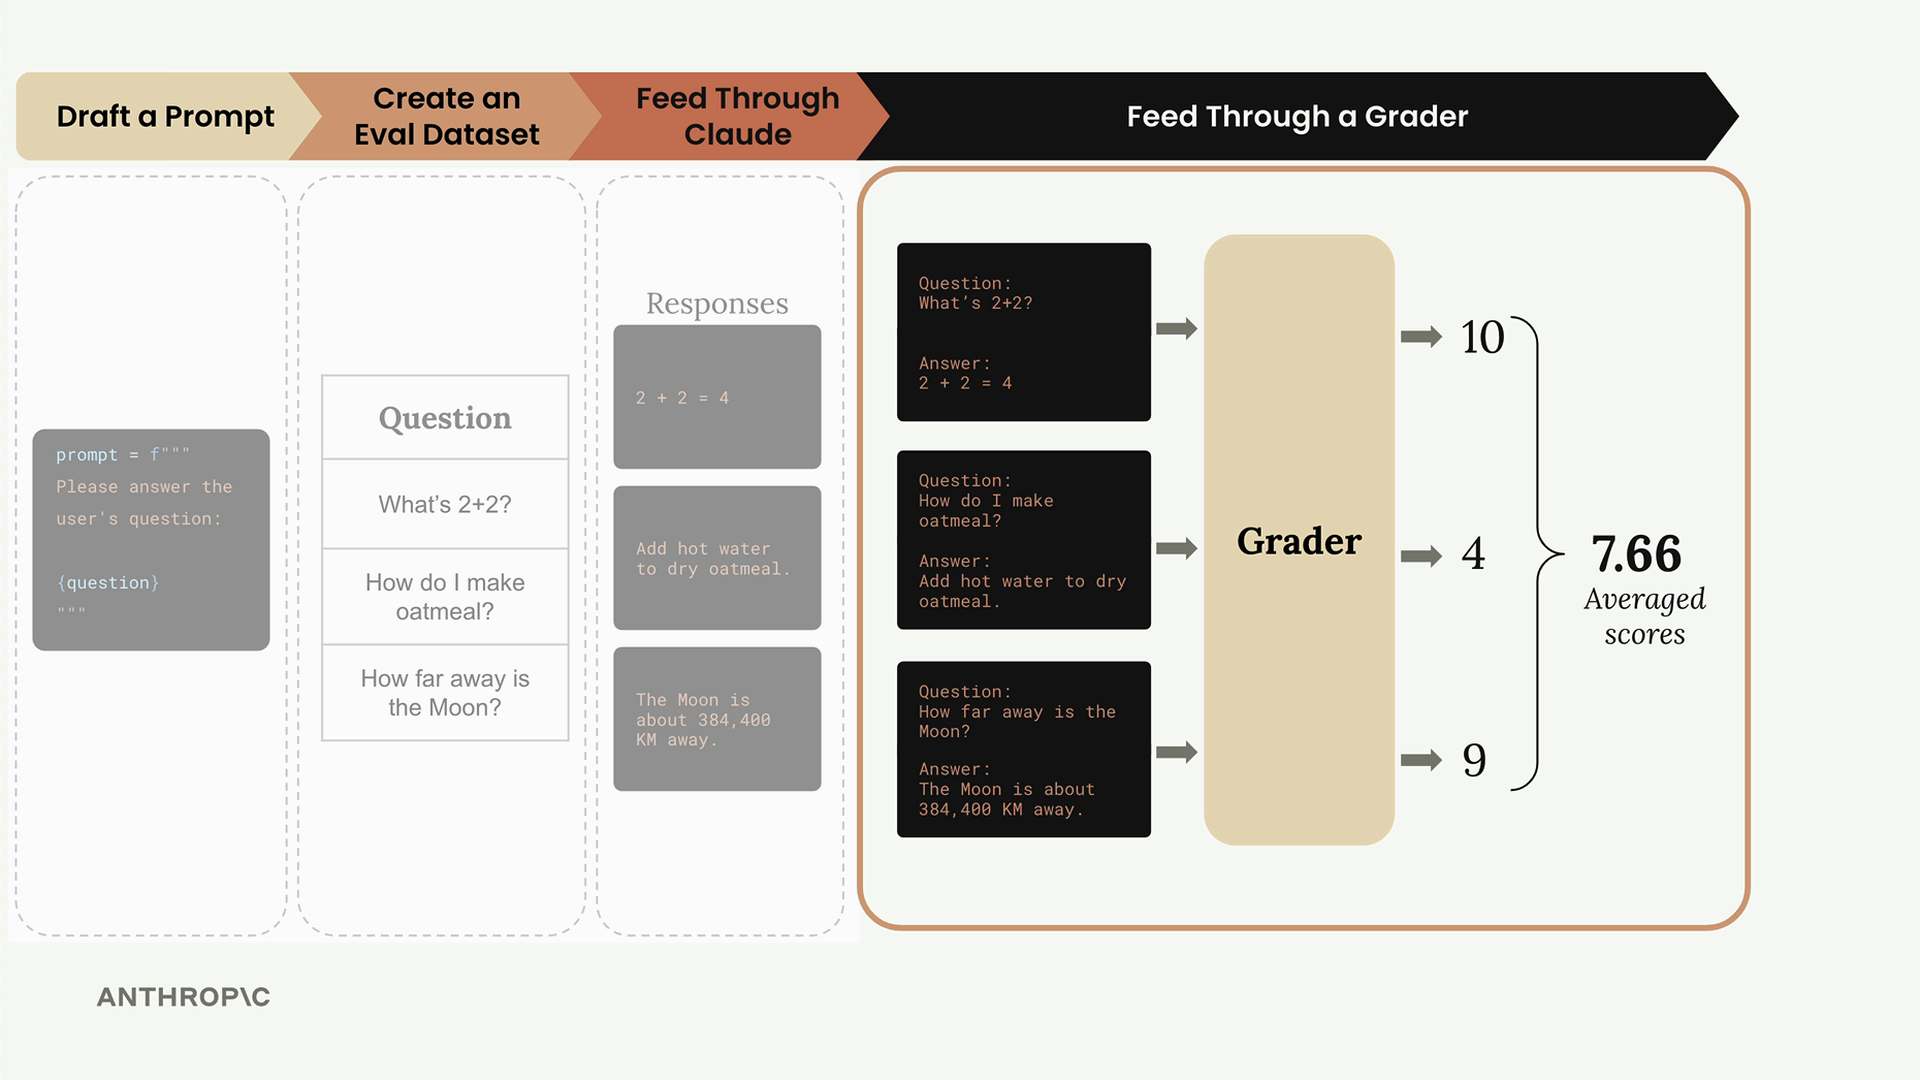
Después de calificar todas las respuestas, promedias las puntuaciones. En nuestro ejemplo, las puntuaciones de 10, 4 y 9 promedian 7.66, lo que te da una medición objetiva del rendimiento de tu prompt.
Paso 5: Cambia el prompt y repite
Con tu puntuación base establecida, ahora puedes modificar tu prompt y ejecutar todo el proceso nuevamente para ver si tus cambios mejoran el rendimiento.
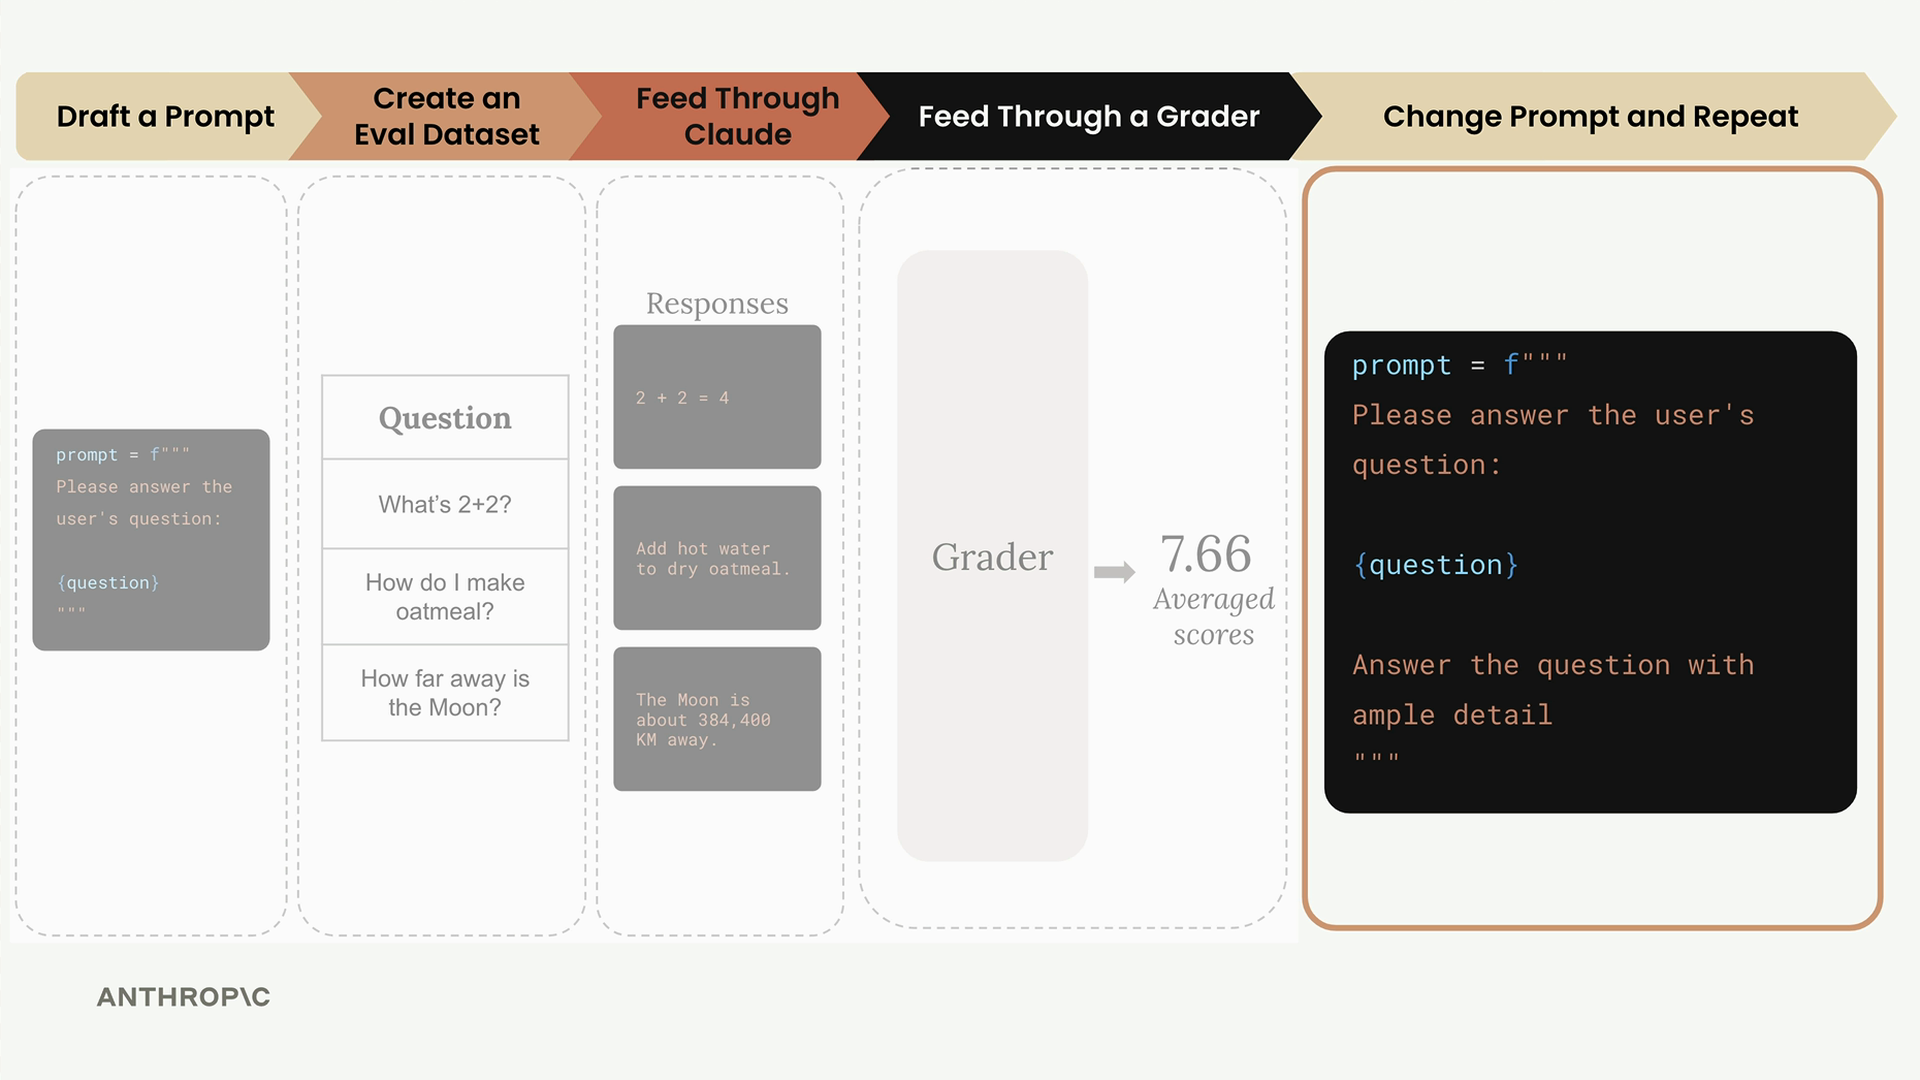
Por ejemplo, podrías mejorar el prompt original agregando instrucciones más específicas:
prompt = f"""
Please answer the user's question:

{question}

Answer the question with ample detail
"""
Puntuación de prompts
El poder de este flujo de trabajo radica en obtener mediciones objetivas del rendimiento del prompt. Puedes comparar puntuaciones entre diferentes versiones de prompts para determinar cuál funciona mejor.
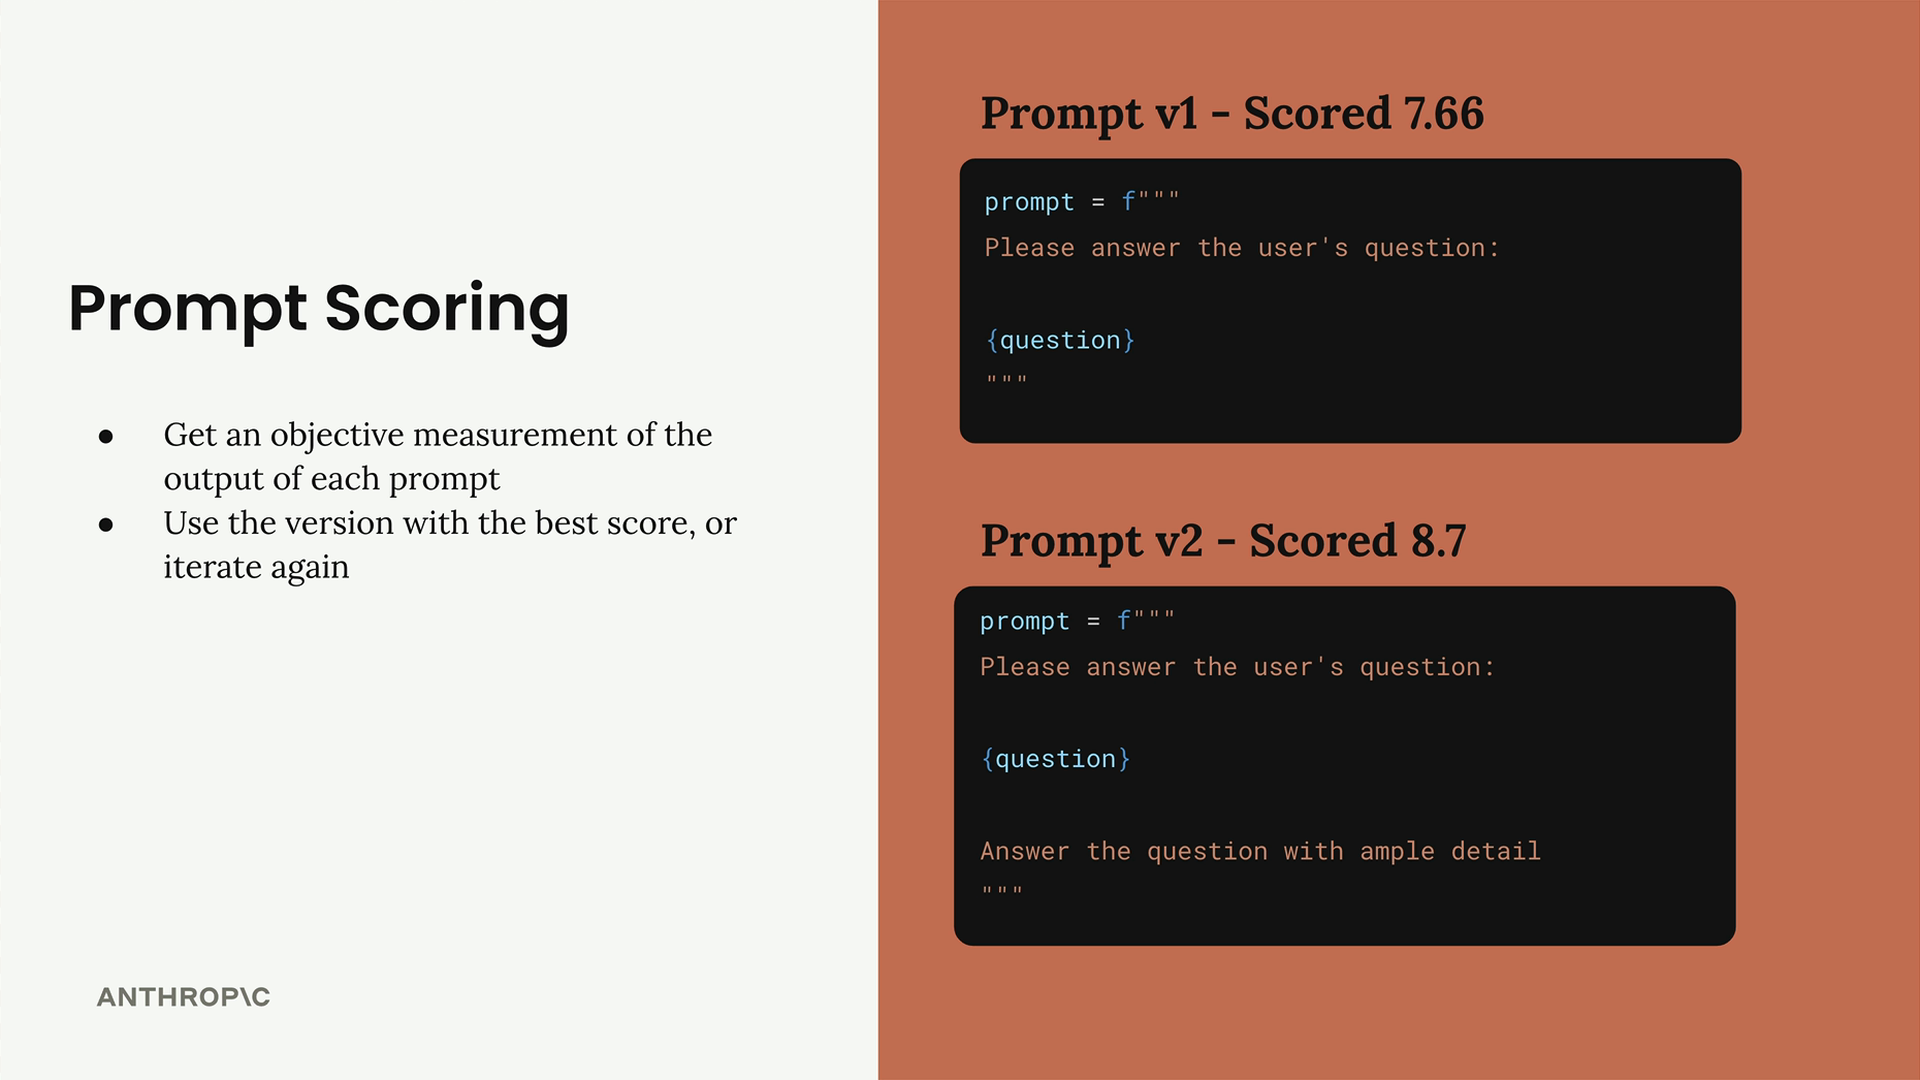
En nuestro ejemplo:
- El prompt v1 obtuvo 7.66
- El prompt v2 obtuvo 8.7
La puntuación más alta para v2 proporciona evidencia objetiva de que agregar "Responde la pregunta con amplio detalle" mejoró el rendimiento del prompt. Luego puedes usar la versión con mejor rendimiento o seguir iterando para lograr puntuaciones aún más altas.
Este enfoque sistemático elimina las conjeturas de la mejora de prompts y te brinda un marco confiable para la optimización. Aunque existe complejidad en la implementación de evaluadores efectivos, este flujo de trabajo proporciona una base sólida para construir tu propio sistema de evaluación.