El enfoque de recuperación híbrida que hemos construido funciona bien, pero todavía tiene algunos puntos ásperos. Cuando buscamos "¿qué hizo el equipo de ingeniería con INC-2023-Q4-011?", esperaríamos que la sección de Ingeniería de Software se clasificara más alto ya que menciona específicamente al equipo de ingeniería y el incidente. Sin embargo, la sección de Ciberseguridad sigue apareciendo primero.
Aquí es donde entra el re-ranking: una técnica de post-procesamiento que puede mejorar significativamente la precisión de la recuperación.
Cómo funciona el re-ranking
El re-ranking añade un paso adicional después de tu proceso de búsqueda híbrida. En lugar de simplemente devolver los resultados combinados de tus índices vectorial y BM25, pasas esos resultados a través de un LLM para una reordenación inteligente.
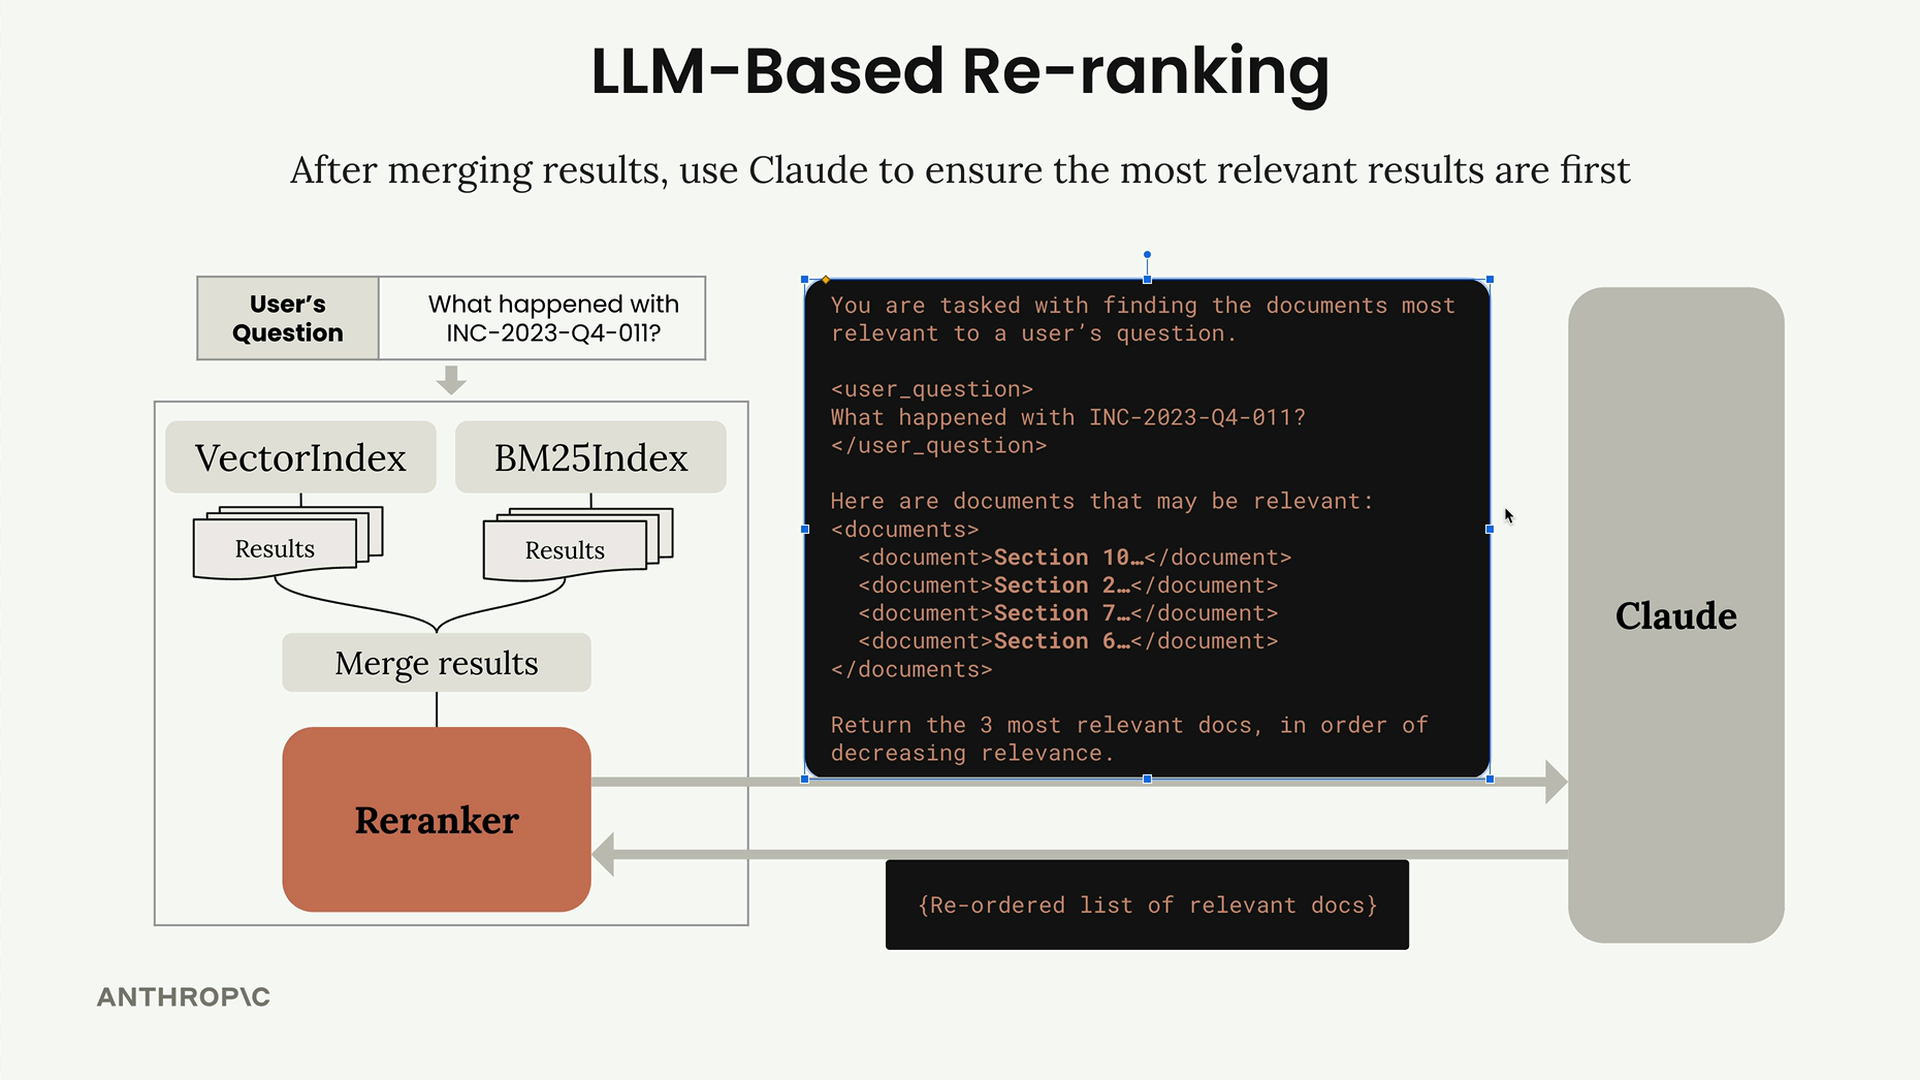
El proceso es sencillo:
- Ejecuta tu búsqueda híbrida existente (vectorial + BM25)
- Combina los resultados como antes
- Envía los resultados combinados a Claude con un prompt de re-ranking
- Obtén de vuelta una lista reordenada de los documentos más relevantes
El prompt de re-ranking
La estructura del prompt es simple pero efectiva. Le proporcionas a Claude la pregunta del usuario y todos los documentos candidatos, y luego le pides que devuelva los más relevantes en orden decreciente de relevancia.
You are about to be given a set of documents, along with an id of each.
Your task is to select the {k} most relevant documents to answer the user's question.

Here is the user's question:
<question>
{query_text}
</question>

Here are the documents to select from:
<documents>
{joined_docs}
</documents>

Respond in the following format:
```json
\{
  "document_ids": str[] # List document ids, \{k\} elements long, sorted in order of decreasing relevance
\}
```Consideraciones de eficiencia
Una optimización clave es usar IDs de documentos en lugar de pedirle a Claude que devuelva fragmentos de texto completos. Si le pidieras a Claude que devolviera el texto completo de cada documento relevante, perderías tiempo esperando a que copie grandes cantidades de texto.
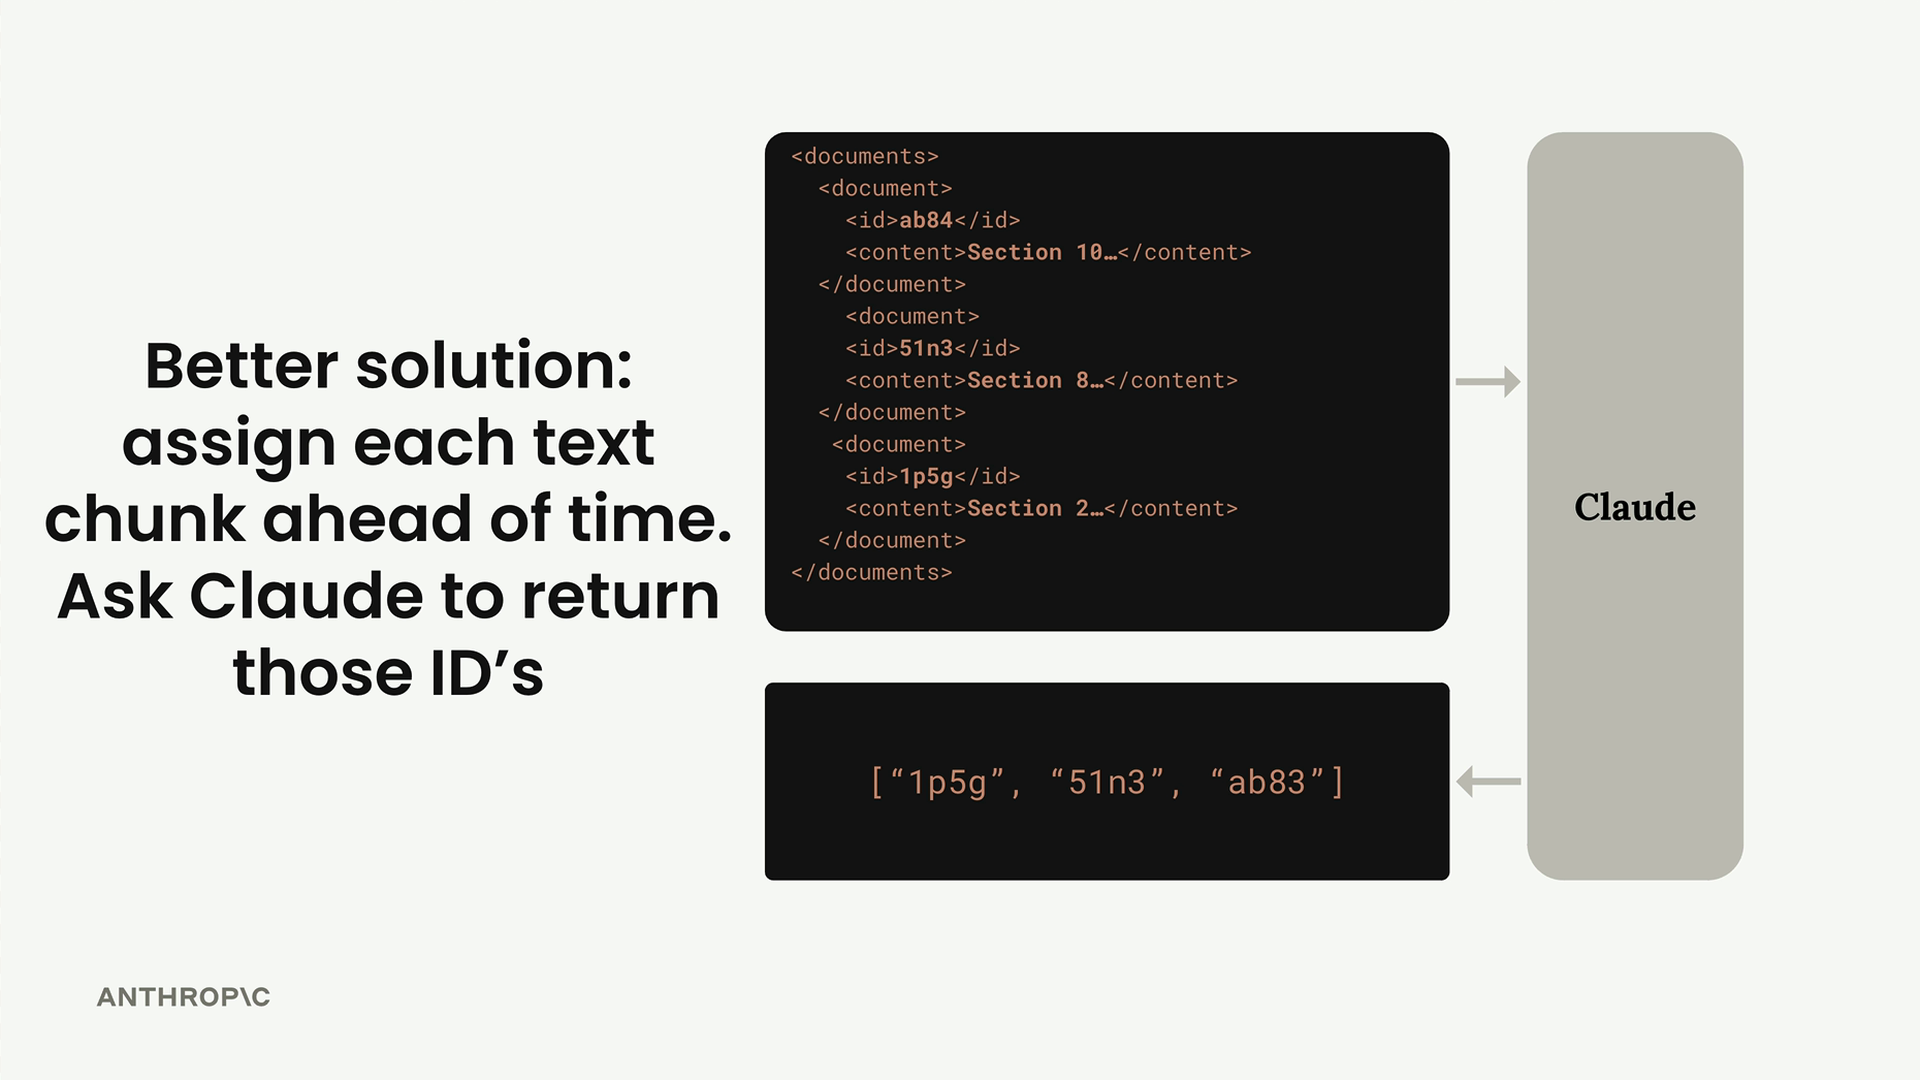
En su lugar, asigna a cada fragmento de texto un ID único de antemano, y luego pídele a Claude que devuelva solo esos IDs en el orden preferido. Esto hace que el proceso de re-ranking sea mucho más rápido, mientras sigue proporcionándote los resultados reordenados que necesitas.
Implementación
La función de re-ranker se llama automáticamente después de que se completa tu búsqueda híbrida inicial. Aquí está la estructura básica:
def reranker_fn(docs, query_text, k):
    joined_docs = "\n".join([
        f"""
        <document>
        <document_id>{doc["id"]}</document_id>
        <document_content>{doc["content"]}</document_content>
        </document>
        """
        for doc in docs
    ])

    # Construir el prompt con la pregunta del usuario y los documentos
    # Enviar a Claude con formato de respuesta JSON
    # Analizar y devolver los IDs de documentos reordenados
Puedes integrar esto en tu retriever pasando la función de re-ranker como parámetro:
retriever = Retriever(bm25_index, vector_index, reranker_fn=reranker_fn)Resultados
El enfoque de re-ranking muestra mejoras claras. Al probar la consulta "¿qué hizo el equipo de ingeniería con INC-2023-Q4-011?", la sección de Ingeniería de Software ahora aparece correctamente primero, por delante de la sección de Ciberseguridad. Claude identificó con éxito que el usuario estaba preguntando específicamente sobre la participación del equipo de ingeniería en el incidente.
Compensaciones
El re-ranking viene con compensaciones a considerar:
- Mayor latencia: Ahora necesitas esperar a que se complete una llamada adicional al LLM
- Mayor precisión: El LLM puede entender el contexto y la intención mejor que las puntuaciones de similitud puras
- Consideraciones de costo: Cada búsqueda ahora requiere una llamada a la API del LLM
Para muchas aplicaciones, la mejora en precisión justifica la latencia y el costo adicionales, especialmente cuando la recuperación precisa es crítica para tu caso de uso.