既然我们已经介绍了 RAG、文本分块和嵌入的基础知识,现在让我们逐步走一遍完整的 RAG 流程。这个示例将向您准确展示所有这些部分如何协同工作,以检索相关信息并生成响应。
第 1 步:对源文本进行分块
首先,我们取源文档并将其分解为可管理的块。在这个示例中,我们将使用两个简单的文本部分:
- 第 1 部分:医学研究 - "今年我们对 XDR-47 的理解取得了重大进展,这是一种我们以前从未见过的'bug'。"
- 第 2 部分:软件工程 - "该部门投入了大量精力研究我们分布式系统中的各种感染途径"
第 2 步:生成嵌入
接下来,我们使用嵌入模型将每个文本块转换为数值嵌入。为了更容易理解,让我们假设我们有一个完美的嵌入模型,它总是恰好返回两个数字,并且我们知道每个数字代表什么。
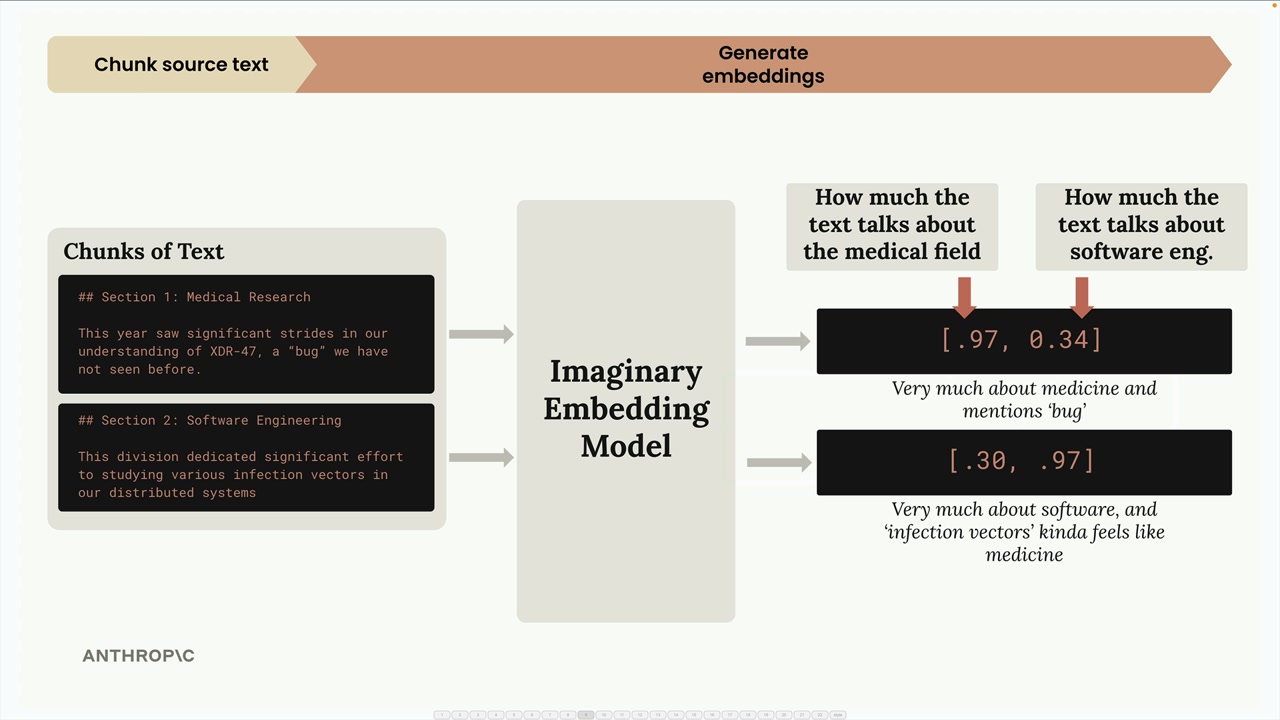
在我们假想的模型中:
- 第一个数字表示文本在多大程度上谈论医学领域
- 第二个数字表示文本在多大程度上谈论软件工程
对于医学研究部分,我们可能得到 [0.97, 0.34] - 非常偏重医学,但由于"bug"这个词而带有一些软件元素。对于软件工程部分,我们得到 [0.30, 0.97] - 高度偏重软件,但由于"感染途径"而带有一些医学色彩。
归一化
嵌入 API 通常会执行一个归一化步骤,将每个向量缩放为幅值为 1.0。您不需要担心这里的数学原理——它是自动处理的。这给我们带来了像 [0.944, 0.331] 和 [0.295, 0.955] 这样的归一化向量。
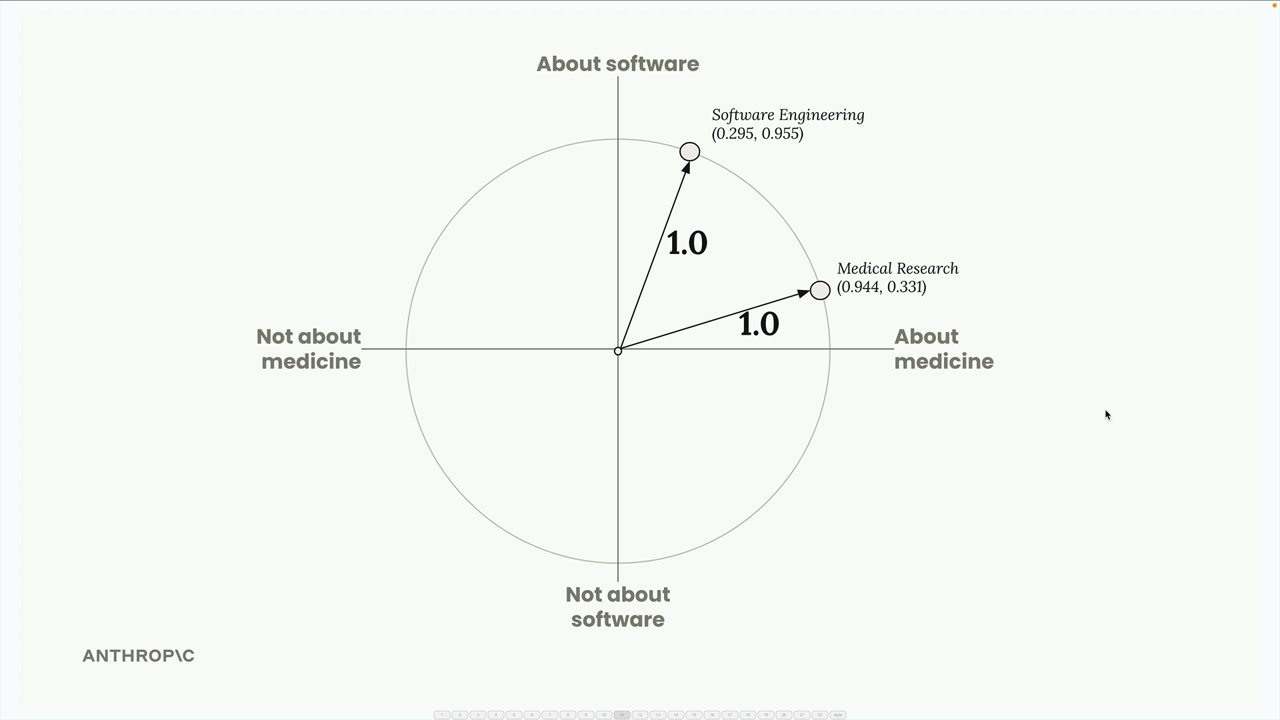
我们可以在单位圆上可视化这些嵌入,其中每个点代表我们的一个文本块。
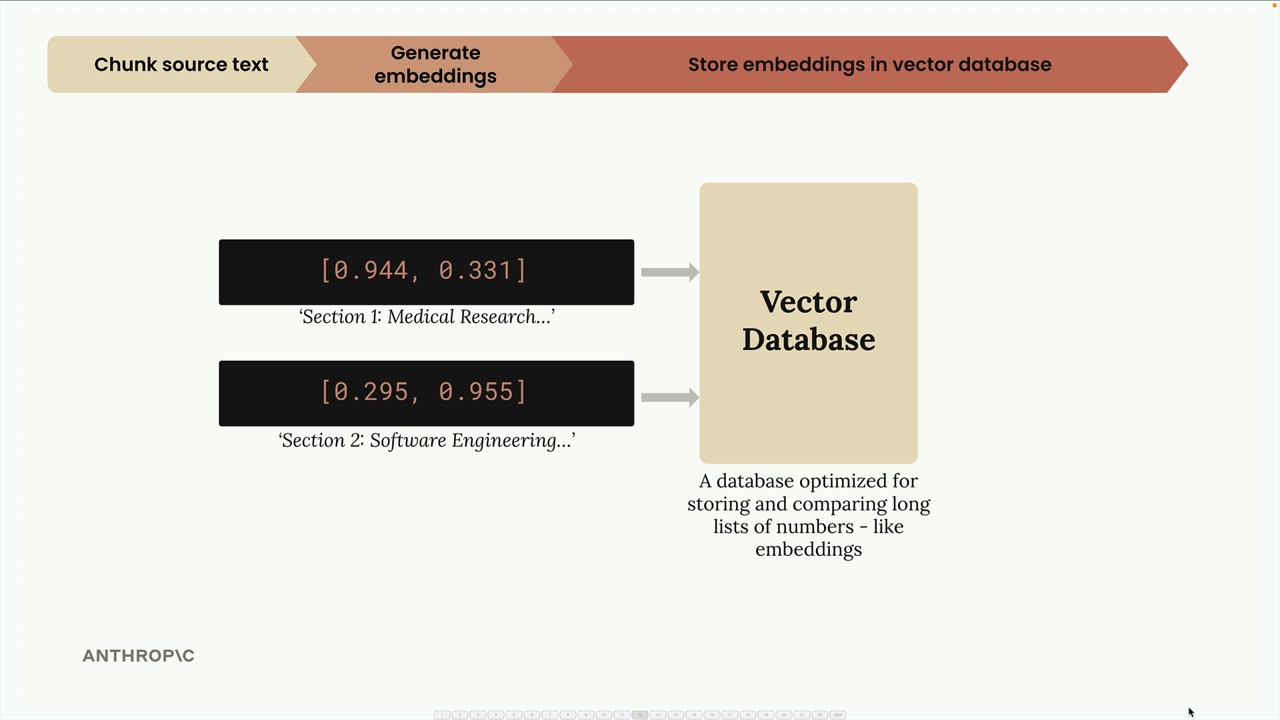
第 3 步:存储到向量数据库
我们将这些嵌入存储在向量数据库中——这是一种专门为存储、比较和搜索像我们的嵌入这样的长数字列表而优化的数据库。
此时,我们暂停一下。到目前为止所做的所有工作都是提前进行的预处理。现在我们等待用户提交查询。
第 4 步:处理用户查询
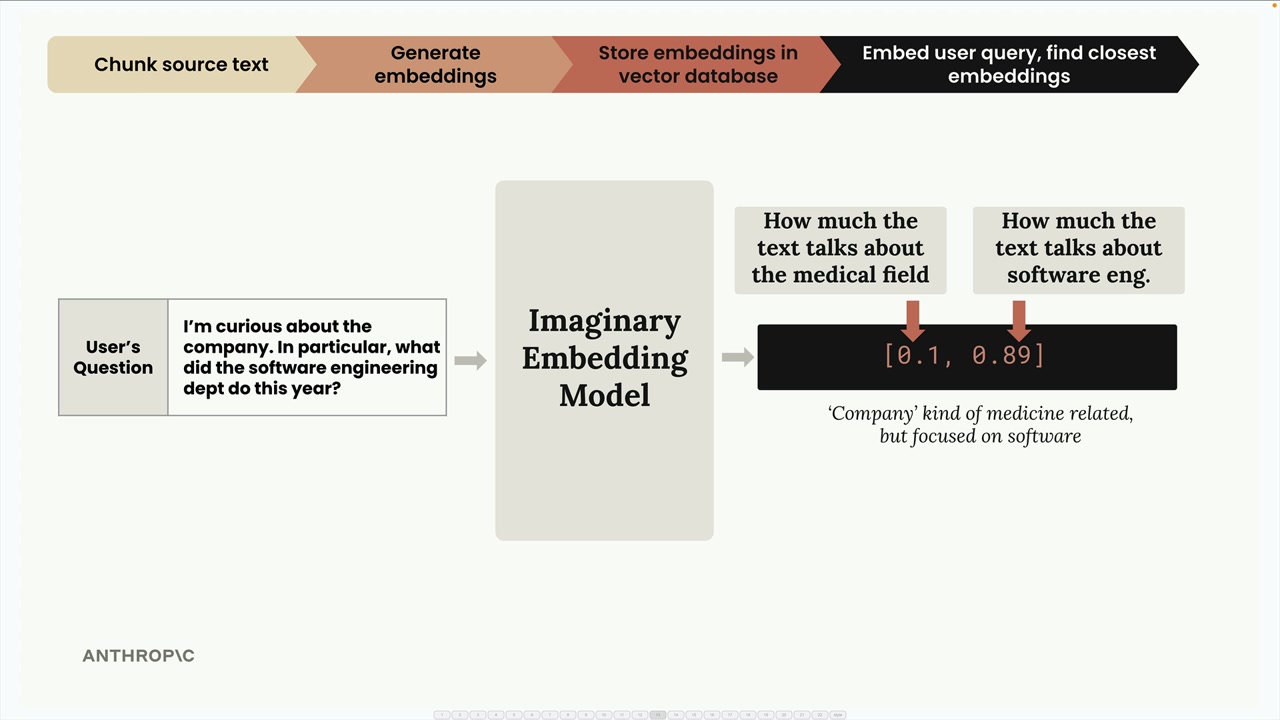
当用户提出类似"我对这家公司很好奇。特别是,软件工程部门今年做了什么?"这样的问题时,我们将他们的查询通过同一个嵌入模型运行。
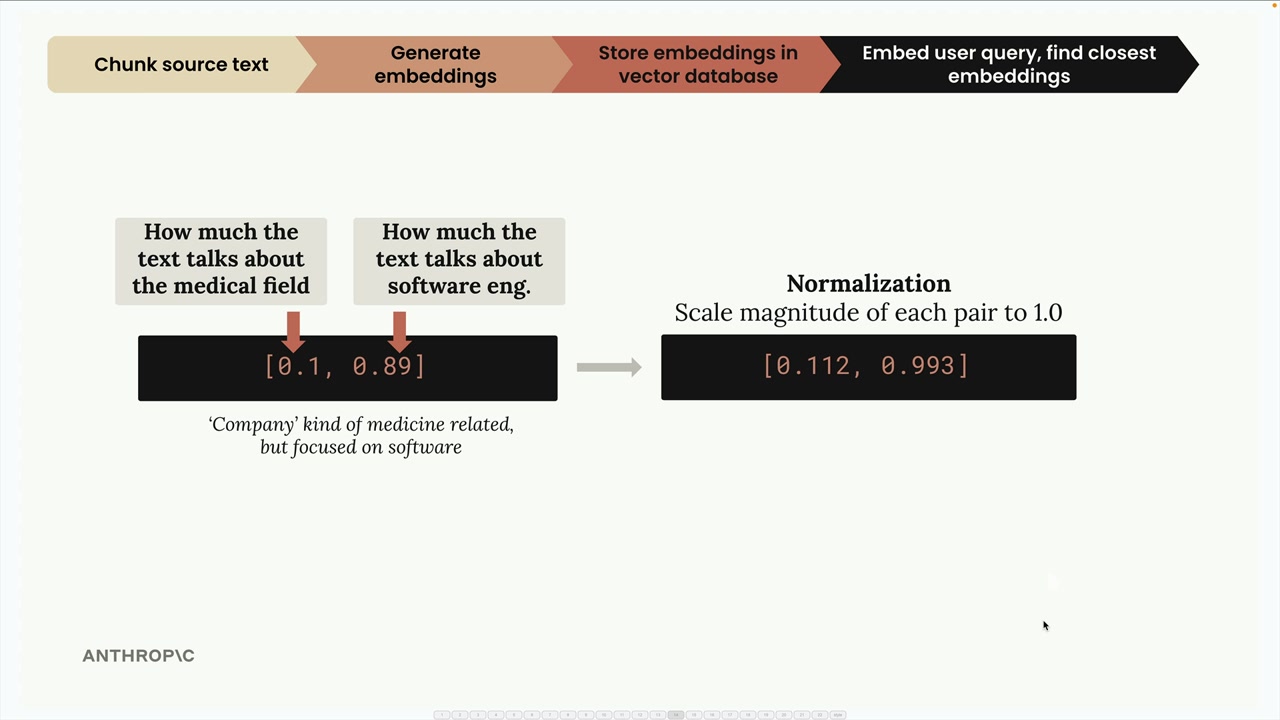
这个查询被嵌入为类似 [0.1, 0.89] 的内容——医学得分低,软件工程得分高。归一化后,我们得到 [0.112, 0.993]。
第 5 步:查找相似的嵌入
我们将用户的查询嵌入发送到我们的向量数据库,并要求它找到最相似的存储嵌入。
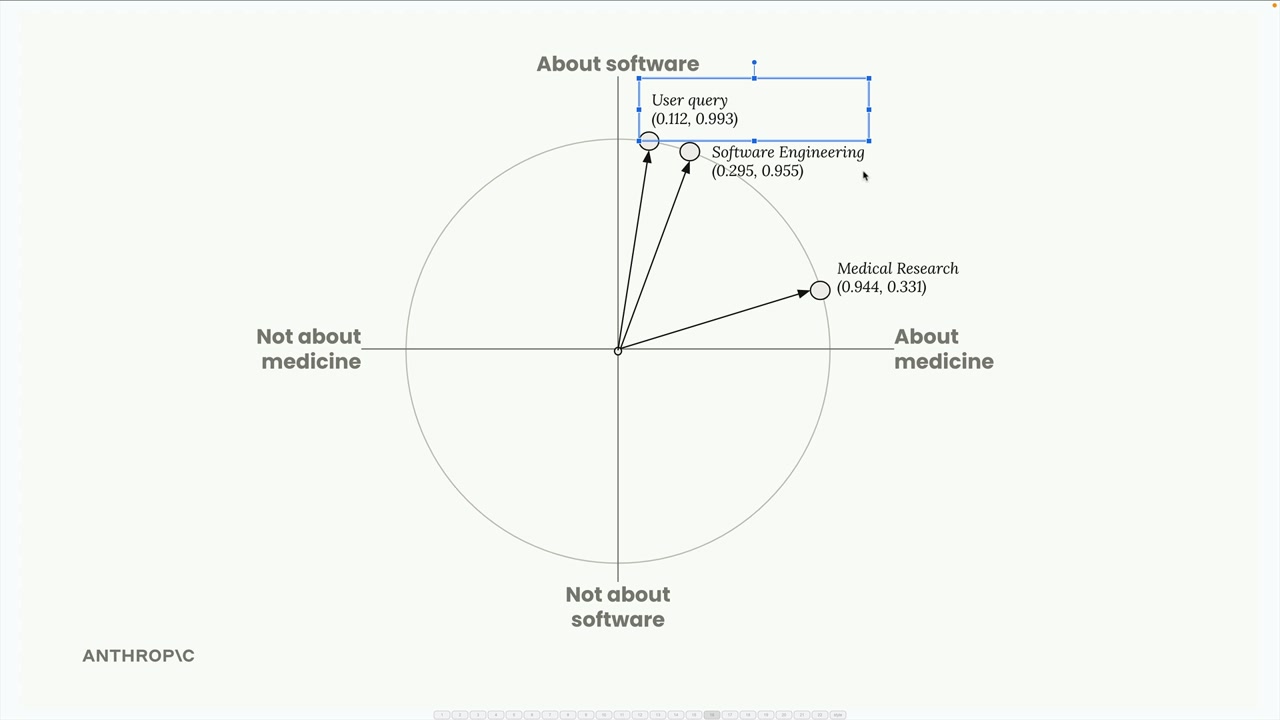
数据库返回了软件工程部分,因为它与用户所询问的内容最匹配。
相似度的工作原理:余弦相似度
向量数据库使用余弦相似度来确定哪些嵌入最相似。这衡量的是两个向量之间夹角的余弦值。
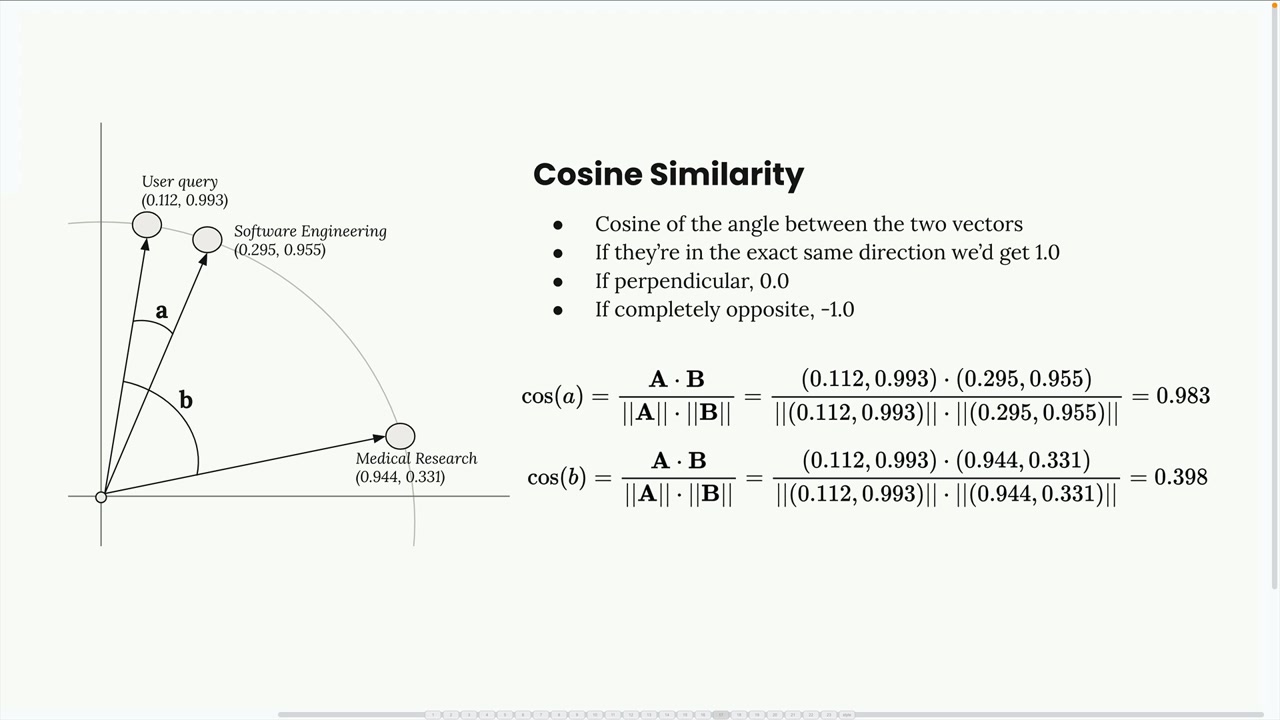
关于余弦相似度的关键点:
- 结果范围从 -1 到 1
- 接近 1 的值表示高相似度
- 接近 -1 的值表示非常不同
- 0 表示垂直(无关系)
在我们的示例中,用户查询与软件工程块之间的余弦相似度为 0.983——非常高的相似度。与医学研究块的相似度仅为 0.398——低得多。
余弦距离
您会经常在向量数据库文档中看到"余弦距离"。这只是简单地计算为 (1 - 余弦相似度)。使用余弦距离:
- 接近 0 的值表示高相似度
- 较大的值表示较低的相似度
这种调整使得数字在许多情境下更容易解读。
第 6 步:创建最终提示
最后,我们取用户的问题和我们找到的最相关的文本块,将它们组合成一个提示,并发送给 Claude 以获取响应。
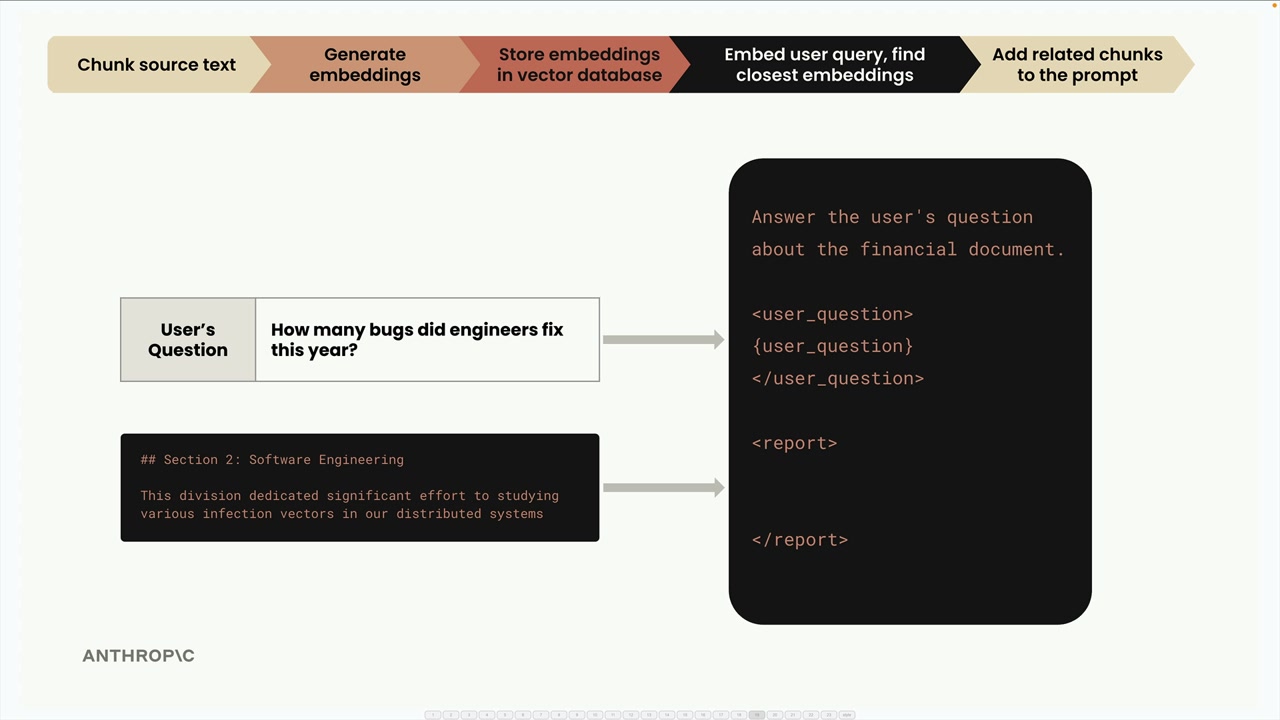
该提示可能如下所示:
Answer the user's question about the financial document.

<user_question>
How many bugs did engineers fix this year?
</user_question>

<report>
## Section 2: Software Engineering
This division dedicated significant effort to studying various infection vectors in our distributed systems
</report>这就是完整的 RAG 流程!该系统成功地基于语义相似度检索到了最相关的信息,并将其作为上下文提供,以生成准确的响应。