在评估生成代码的AI模型时,您需要的不仅仅是检查响应是否合理。您还需要验证生成的代码是否确实具有有效的语法并遵循正确的格式。这正是基于代码的评分发挥作用的地方。
代码评分的工作原理
代码评分验证AI生成响应的两个关键方面:
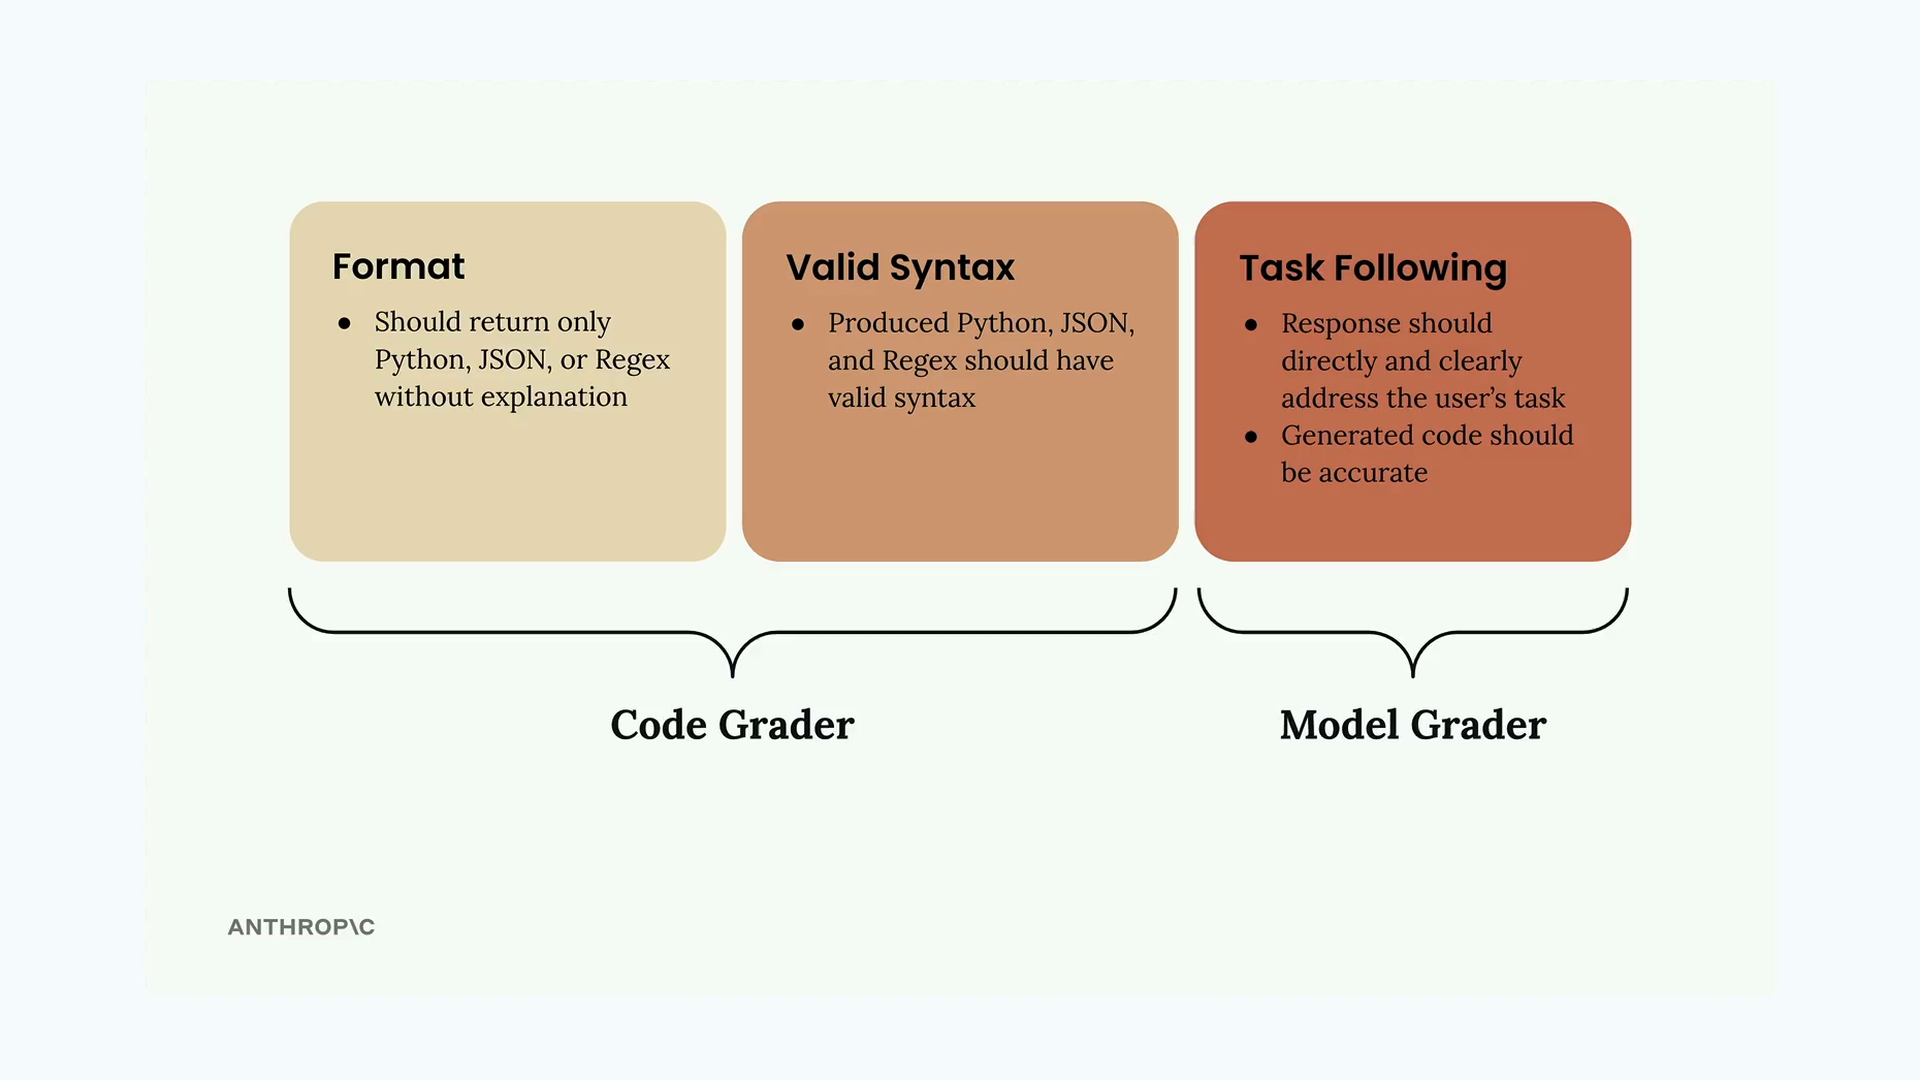
- 格式 - 响应应仅返回所请求的代码类型(Python、JSON或Regex),不包含解释
- 有效语法 - 生成的代码应能够作为预期语言正确解析
- 任务遵循 - 响应应直接针对所提出的问题,并且准确无误
前两项标准由代码评分器处理,而任务遵循则由模型评分器评估。两者结合,提供了一个全面的评估。
语法验证函数
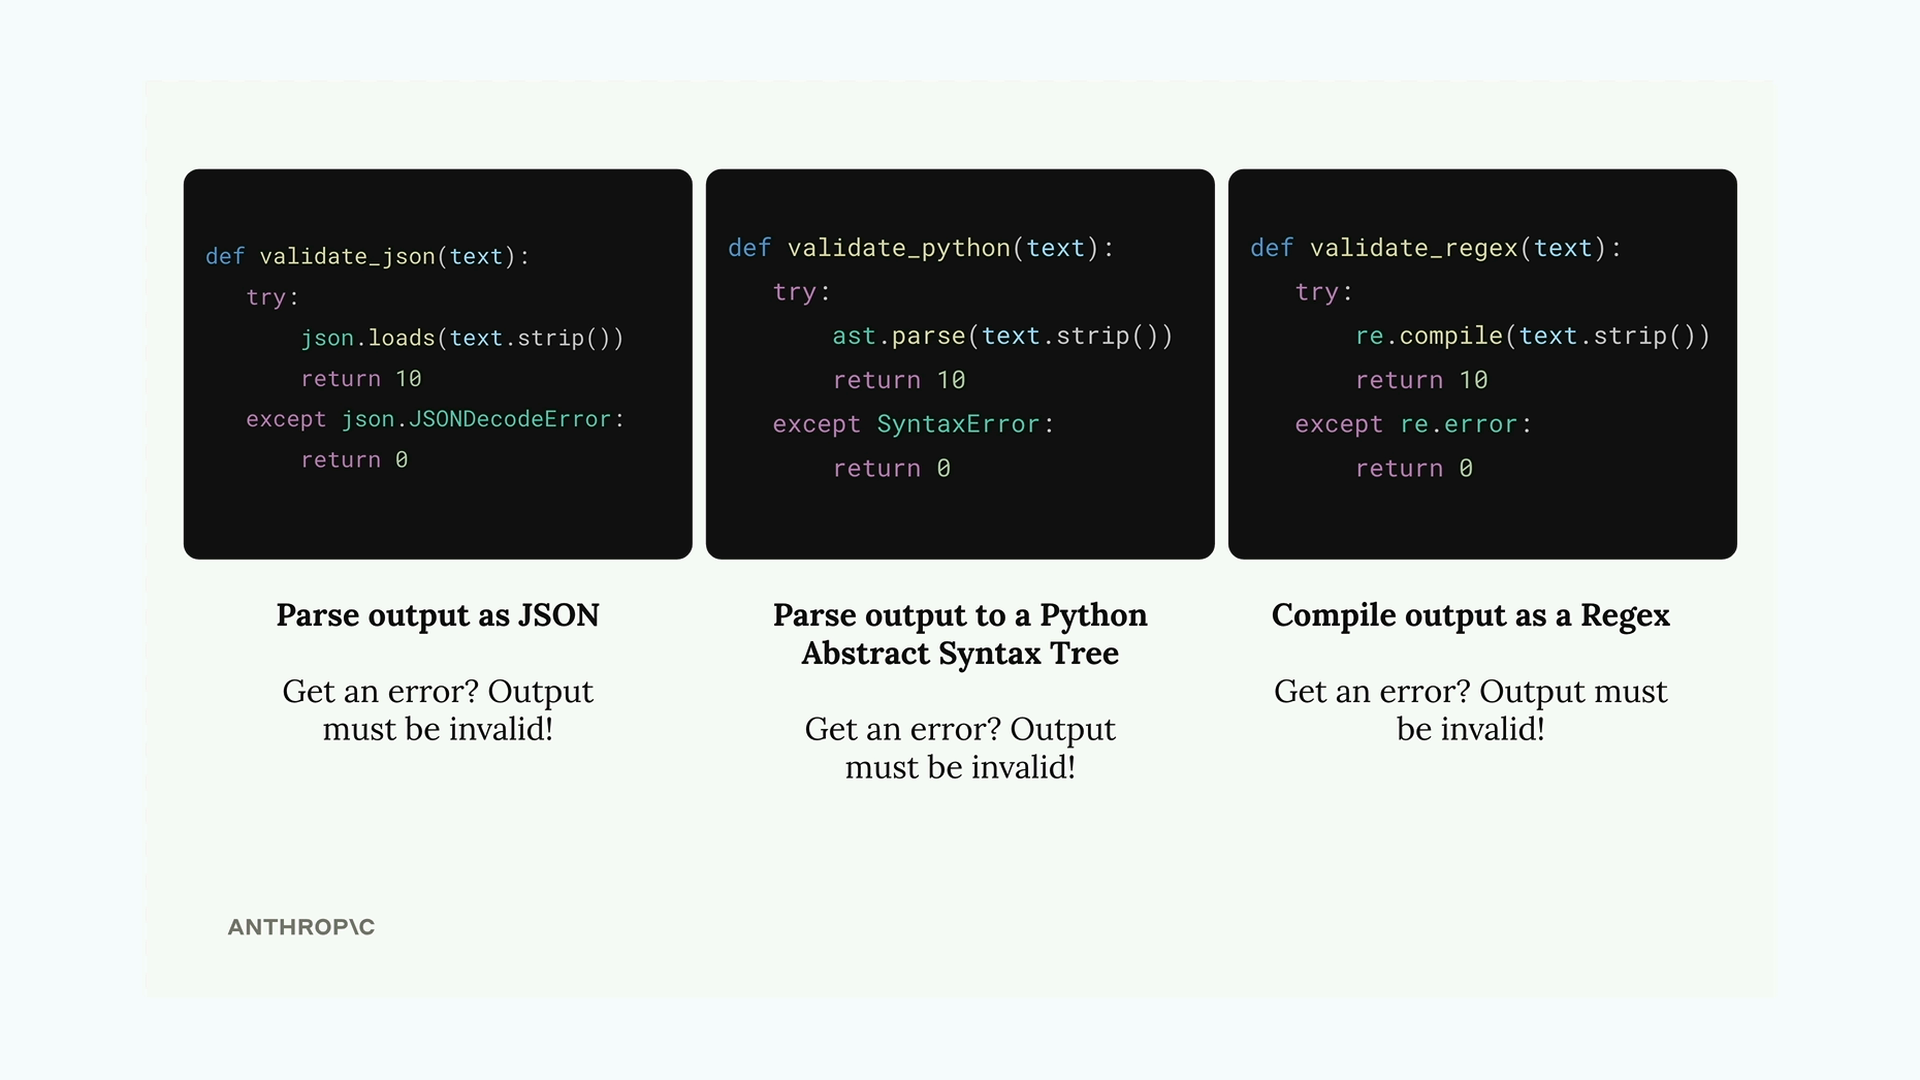
要检查生成的代码是否具有有效语法,您可以创建三个辅助函数来尝试解析输出:
python
def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
        return 0
每个函数都会尝试将文本解析为其各自的格式。如果解析成功,则返回满分10分。如果解析失败并出现错误,则语法无效,返回0分。
数据集格式要求
为了让代码评分器知道使用哪个验证器,您的测试用例需要指定预期的输出格式:
json
{
    "task": "Create a Python function to validate an AWS IAM username",
    "format": "python"
}
您可以更新数据集生成提示,通过将其添加到示例输出结构中,自动包含此格式字段。
提升提示清晰度
为了从您的AI模型获得更好的结果,请使您的提示指令在预期输出格式方面更加具体:
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanation您还可以使用带有代码块的预填充助手消息,以鼓励模型仅返回原始代码:
python
add_assistant_message(messages, "```code")这告诉Claude开始生成代码内容,而无需提前指定它是Python、JSON还是Regex。
合并分数
最后一步是将模型评分器的分数与代码评分器的分数合并。一种简单的方法是取平均值:
python
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
这使内容质量和技术正确性具有同等的权重。您可以根据您特定用例中哪个更重要来调整这些权重。
测试您的实现
一旦您实现了代码评分,运行您的评估以获得基准分数。分数本身并非固有的好或坏——重要的是您是否能够通过改进提示来提高它。这为您提供了一种量化的方式来衡量提示工程的进展,而不是依赖主观评估。