在构建 RAG 管道时,您会很快发现仅靠语义搜索并不总能返回最佳结果。有时您需要精确的术语匹配,而这正是语义搜索可能会遗漏的。解决方案是使用一种称为 BM25 的技术,将语义搜索与词法搜索结合起来。
仅靠语义搜索的问题
假设您要在文档中搜索一个特定的事件 ID,例如"INC-2023-Q4-011"。虽然语义搜索擅长理解上下文和含义,但它可能会返回语义相关但实际上并不包含您要查找的确切术语的部分。
在上面的示例中,语义搜索返回了网络安全部分(确实包含该事件 ID),但也返回了一个根本没有提及该事件的财务分析部分。这是因为语义搜索关注的是概念上的相似性,而不是精确的术语匹配。
混合搜索策略
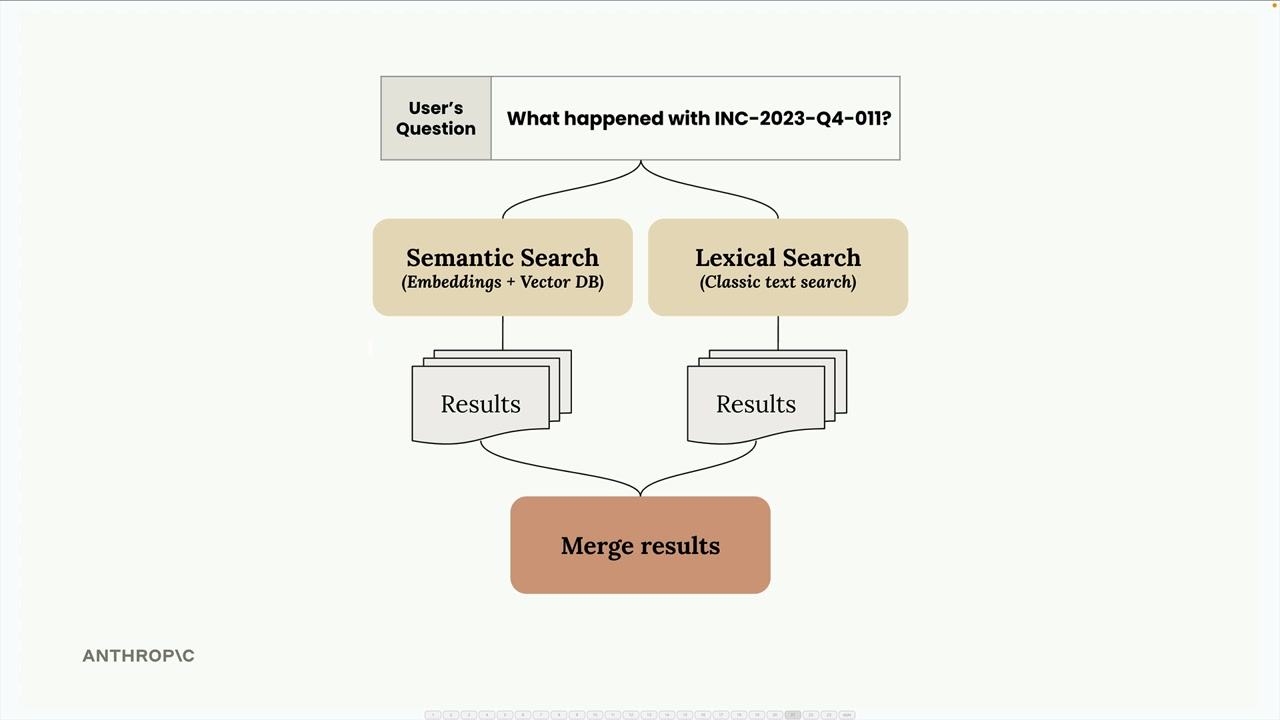
解决方案是并行运行语义搜索和词法搜索,然后合并结果。这样可以兼得两者的优势:
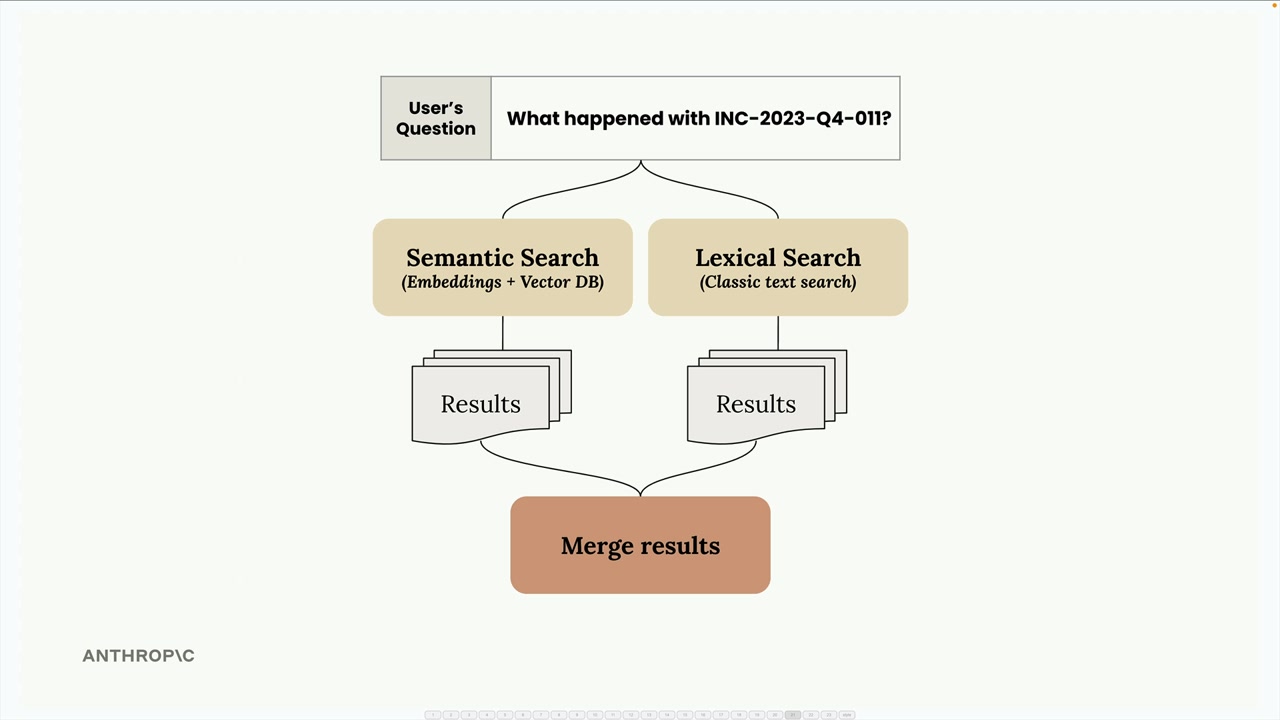
- 语义搜索使用嵌入(embeddings)查找概念相关的内容
- 词法搜索使用经典文本搜索查找精确的术语匹配
- 合并结果结合两种方法以获得更好的准确性
BM25 的工作原理
BM25(Best Match 25)是 RAG 系统中一种流行的词法搜索算法。以下是它处理搜索查询的方式:
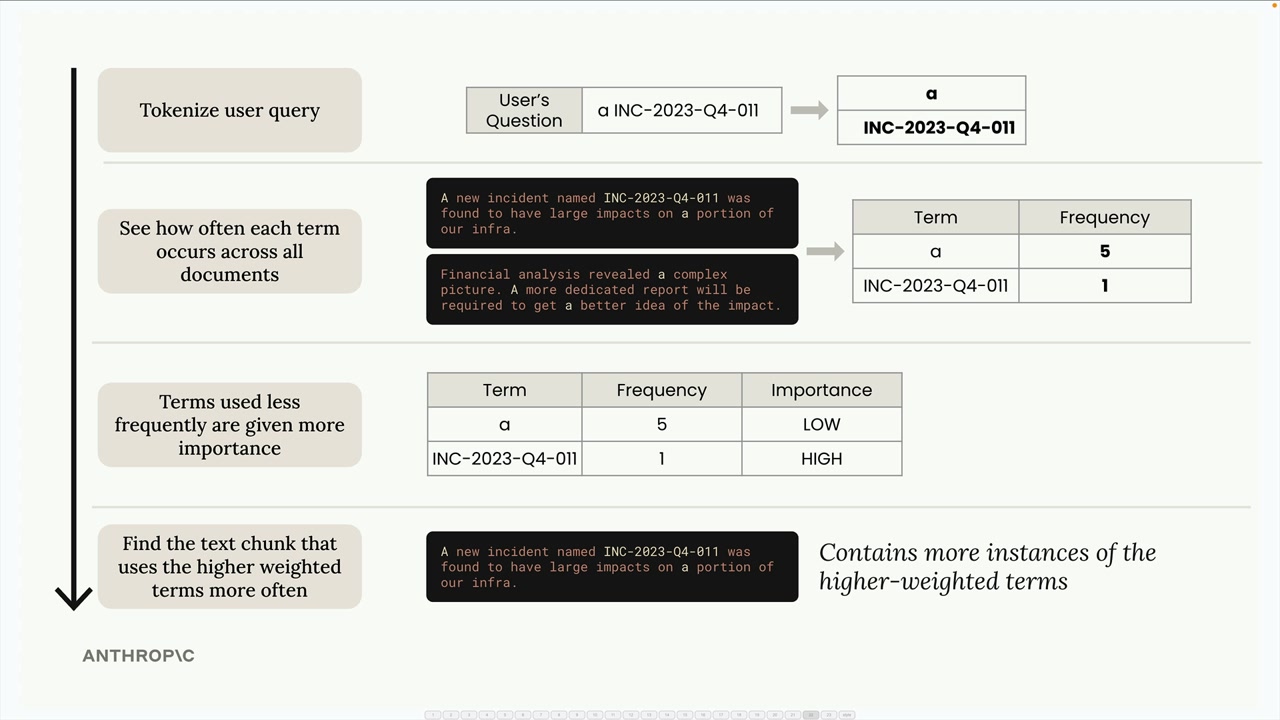
第 1 步:对查询进行分词 将用户的问题拆分为单个术语。例如,"a INC-2023-Q4-011"会变成 ["a", "INC-2023-Q4-011"]。
第 2 步:统计术语频率 查看每个术语在所有文档中出现的频率。像"a"这样的常见词可能出现 5 次,而像"INC-2023-Q4-011"这样的特定术语可能只出现一次。
第 3 步:按重要性对术语加权 出现频率较低的术语会获得更高的重要性分数。"a"这个词因为很常见而获得较低的重要性,而"INC-2023-Q4-011"因为很罕见而获得较高的重要性。
第 4 步:找到最佳匹配 返回包含更多高权重术语实例的文档。
实现 BM25 搜索
以下是设置基本 BM25 搜索系统的方法:
# 1. 按章节对文本进行分块
chunks = chunk_by_section(text)

# 2. 创建 BM25 存储并添加文档
store = BM25Index()
for chunk in chunks:
    store.add_document({"content": chunk})

# 3. 搜索存储
results = store.search("What happened with INC-2023-Q4-011?", 3)

# 打印结果
for doc, distance in results:
    print(distance, "\n", doc["content"][:200], "\n----\n")
运行此搜索时,您将获得比单独使用语义搜索更好的结果。BM25 算法会优先处理实际包含您特定搜索术语的部分,尤其是像事件 ID 这样的罕见术语。
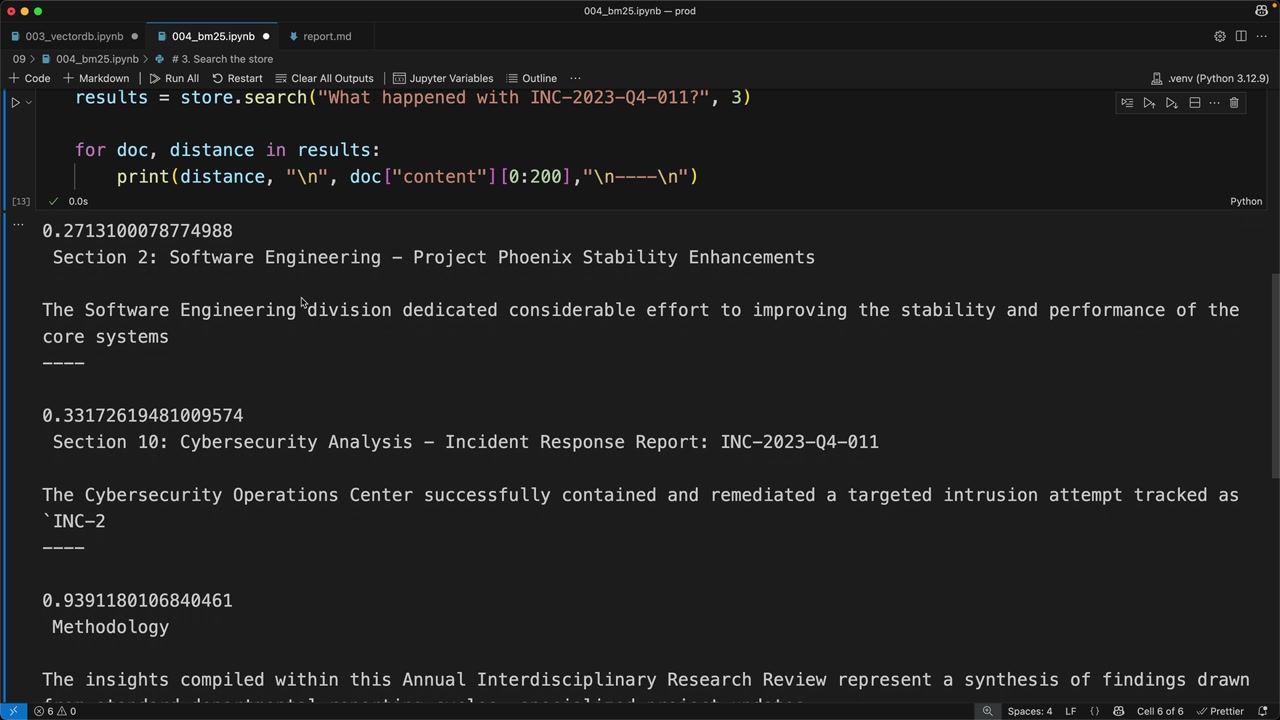
请注意,结果现在正确地优先显示了软件工程部分和网络安全部分——这两部分都确实包含您正在搜索的事件 ID。
为什么这种方法效果更好
BM25 擅长查找精确匹配,因为它:
- 对罕见的特定术语赋予更高的权重
- 忽略不增加搜索价值的常见词
- 关注术语频率而非语义含义
- 特别适用于技术术语、ID 和特定短语
关键的洞察是,这两种搜索方法具有互补的优势。语义搜索理解上下文和含义,而词法搜索确保您不会错过精确的术语匹配。通过将它们结合起来,您可以创建一个更强大的搜索系统,有效地处理概念性查询和特定查找。
在下一步中,您将学习如何合并来自两个搜索系统的结果,以创建统一的混合搜索体验。