当您在Claude中将工具使用与流式传输结合使用时,您会在AI生成工具参数的过程中获得实时更新。这创造了更具响应性的用户体验,但关于其背后的工作原理,有一些重要细节需要了解。
基础工具流式传输
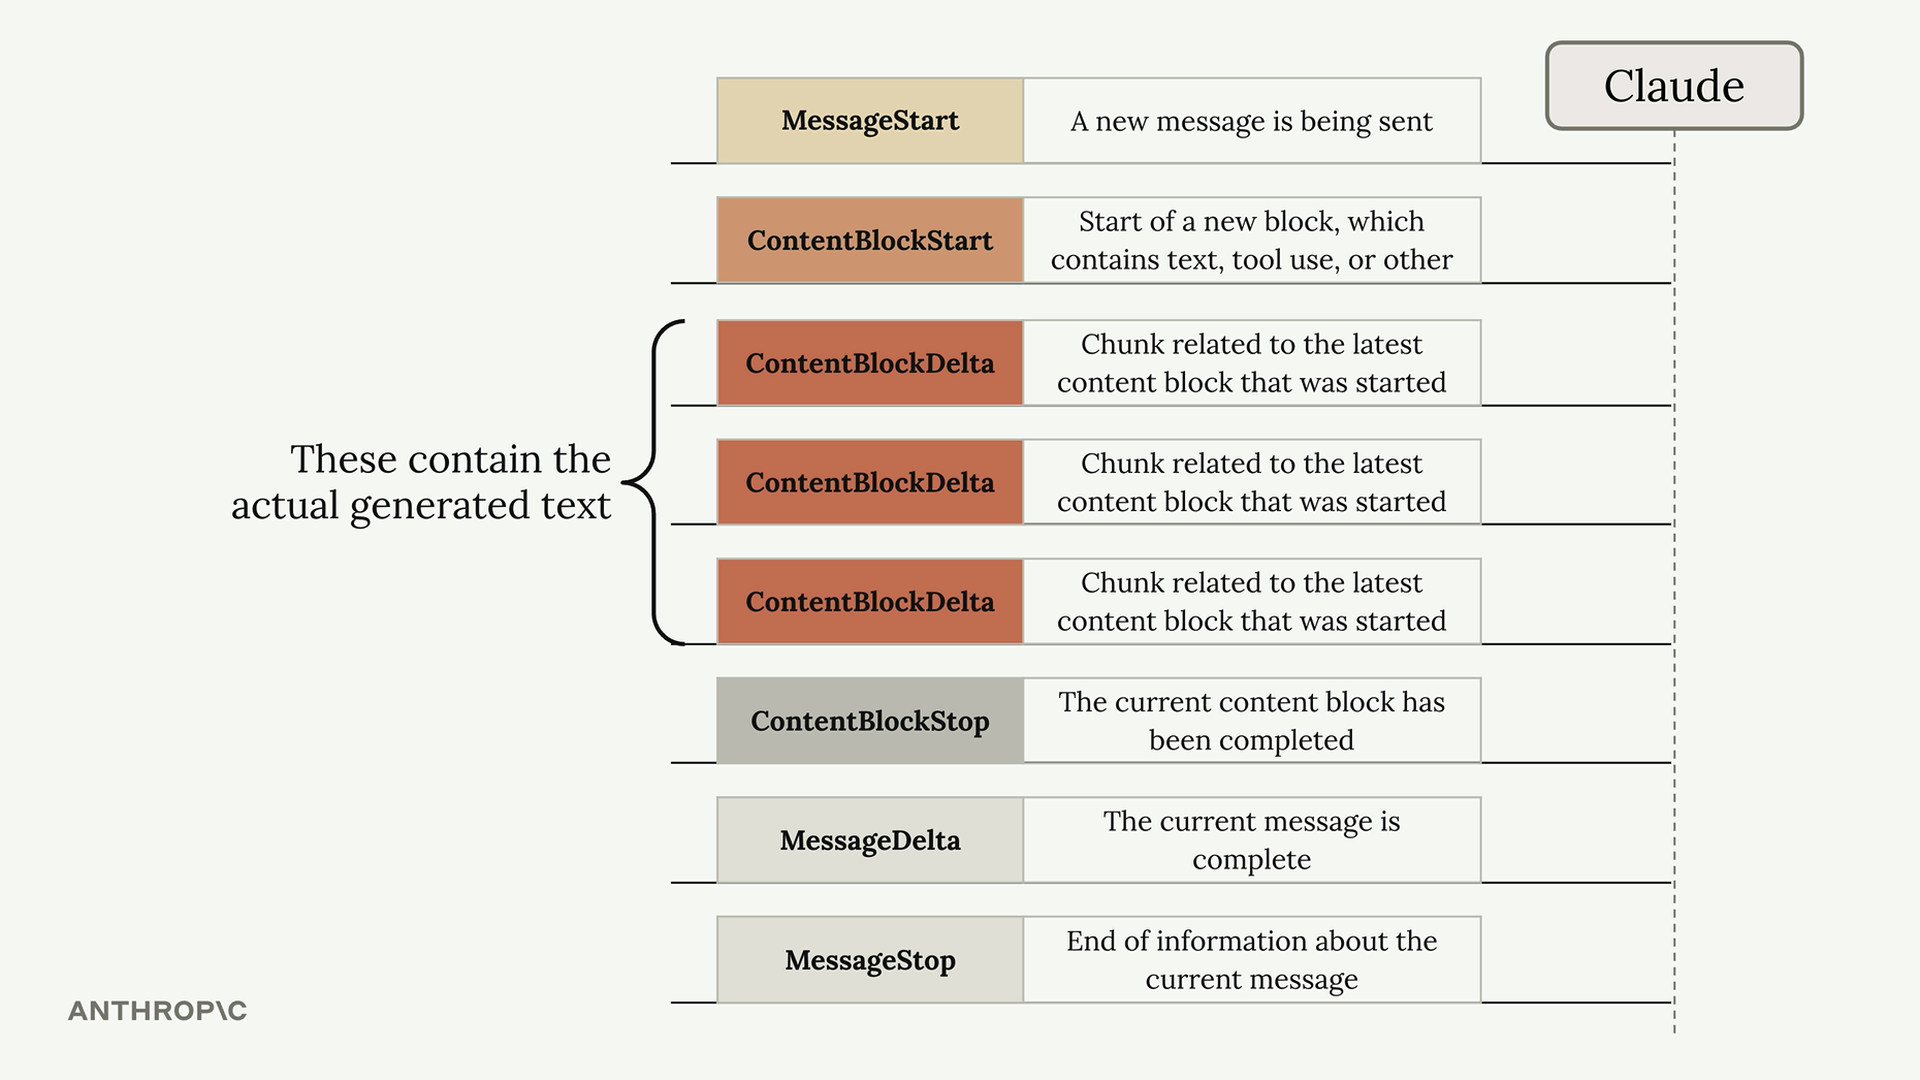
启用流式传输后,Claude会在处理您的请求时发回不同类型的事件。您已经熟悉了用于常规文本生成的ContentBlockDelta等事件。对于工具使用,您还需要处理一种名为InputJsonEvent的新事件类型。
每个InputJsonEvent包含两个关键属性:
- partial_json - 表示工具参数一部分的JSON片段
- snapshot - 由目前收到的所有片段累积构建而成的JSON
以下是您在流式传输管道中处理这些事件的方式:
for chunk in stream:
    if chunk.type == "input_json":
        # 处理部分 JSON 数据块
        print(chunk.partial_json)
        # 或使用目前为止的完整快照
        current_args = chunk.snapshot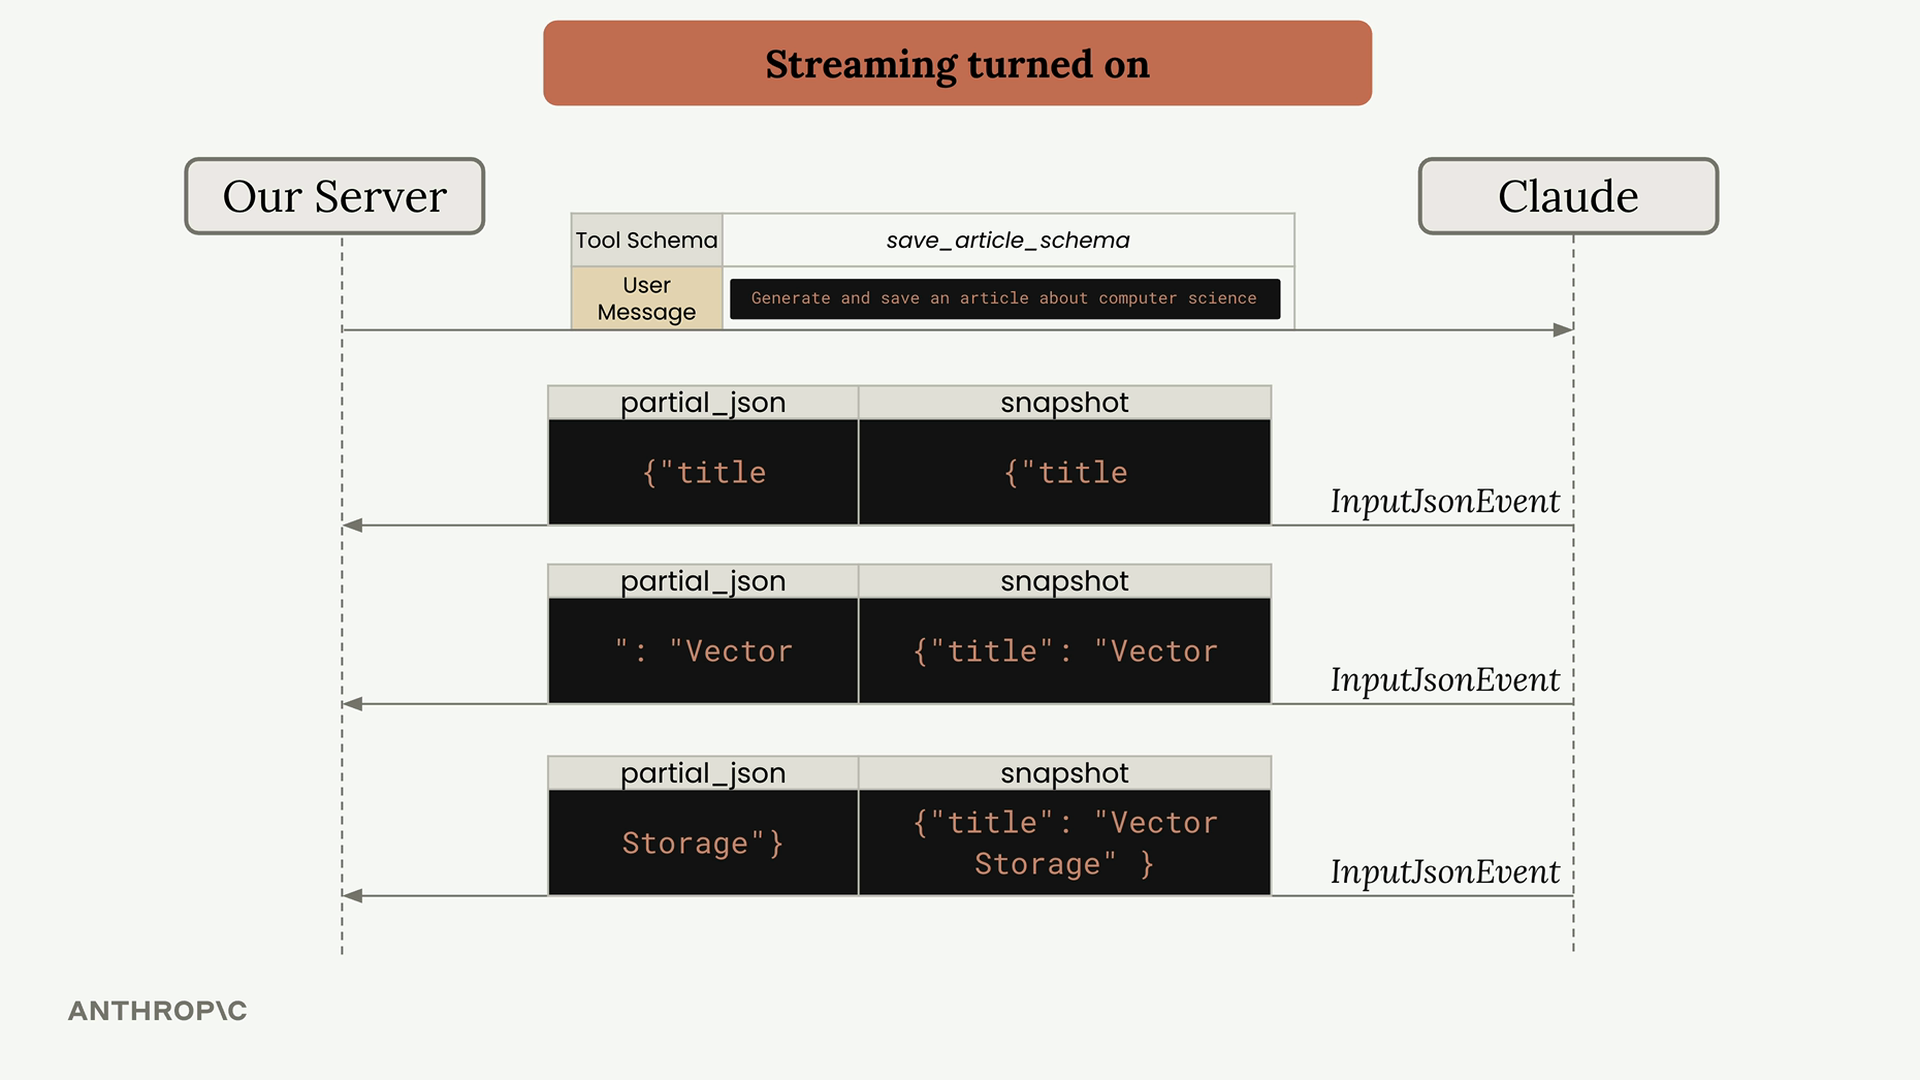
JSON验证的工作原理
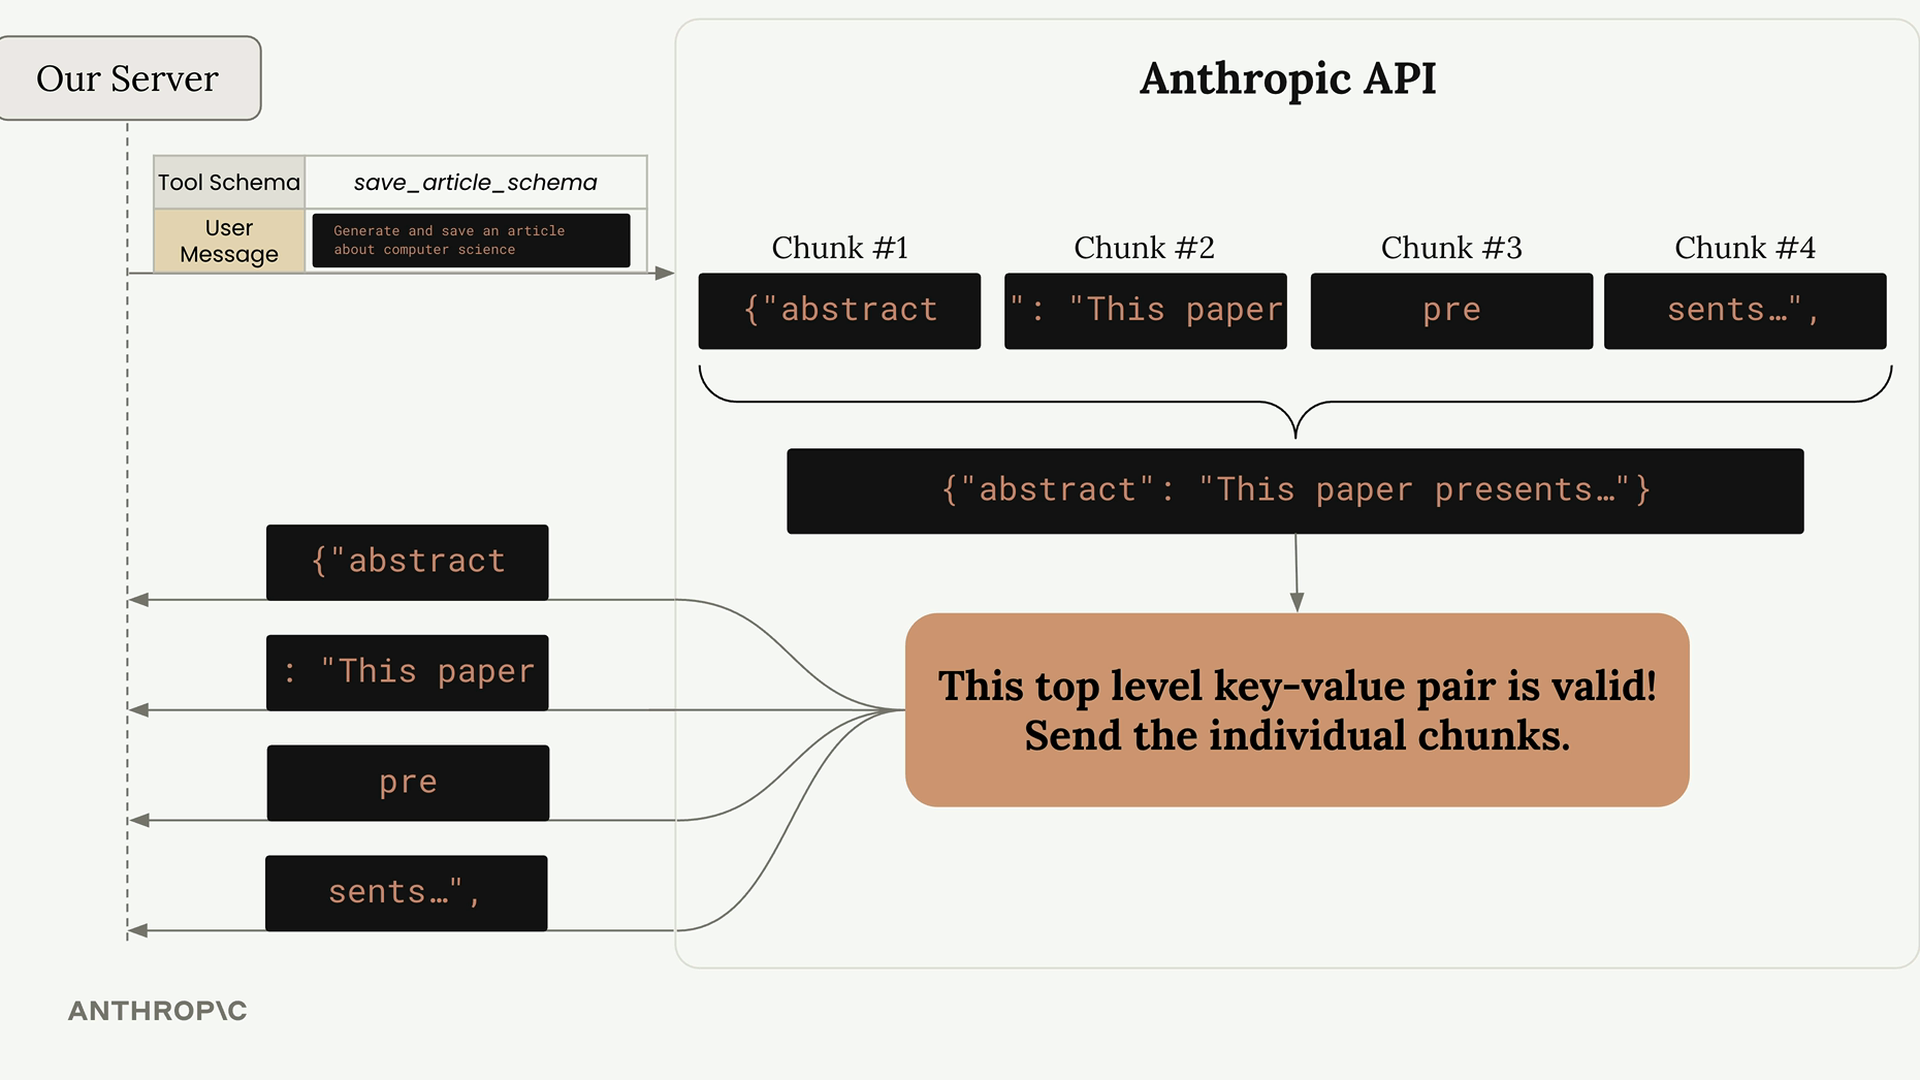
这正是有趣的地方。Anthropic API不会在Claude生成每个片段时立即发送给您。相反,它会先缓冲这些片段并进行验证。
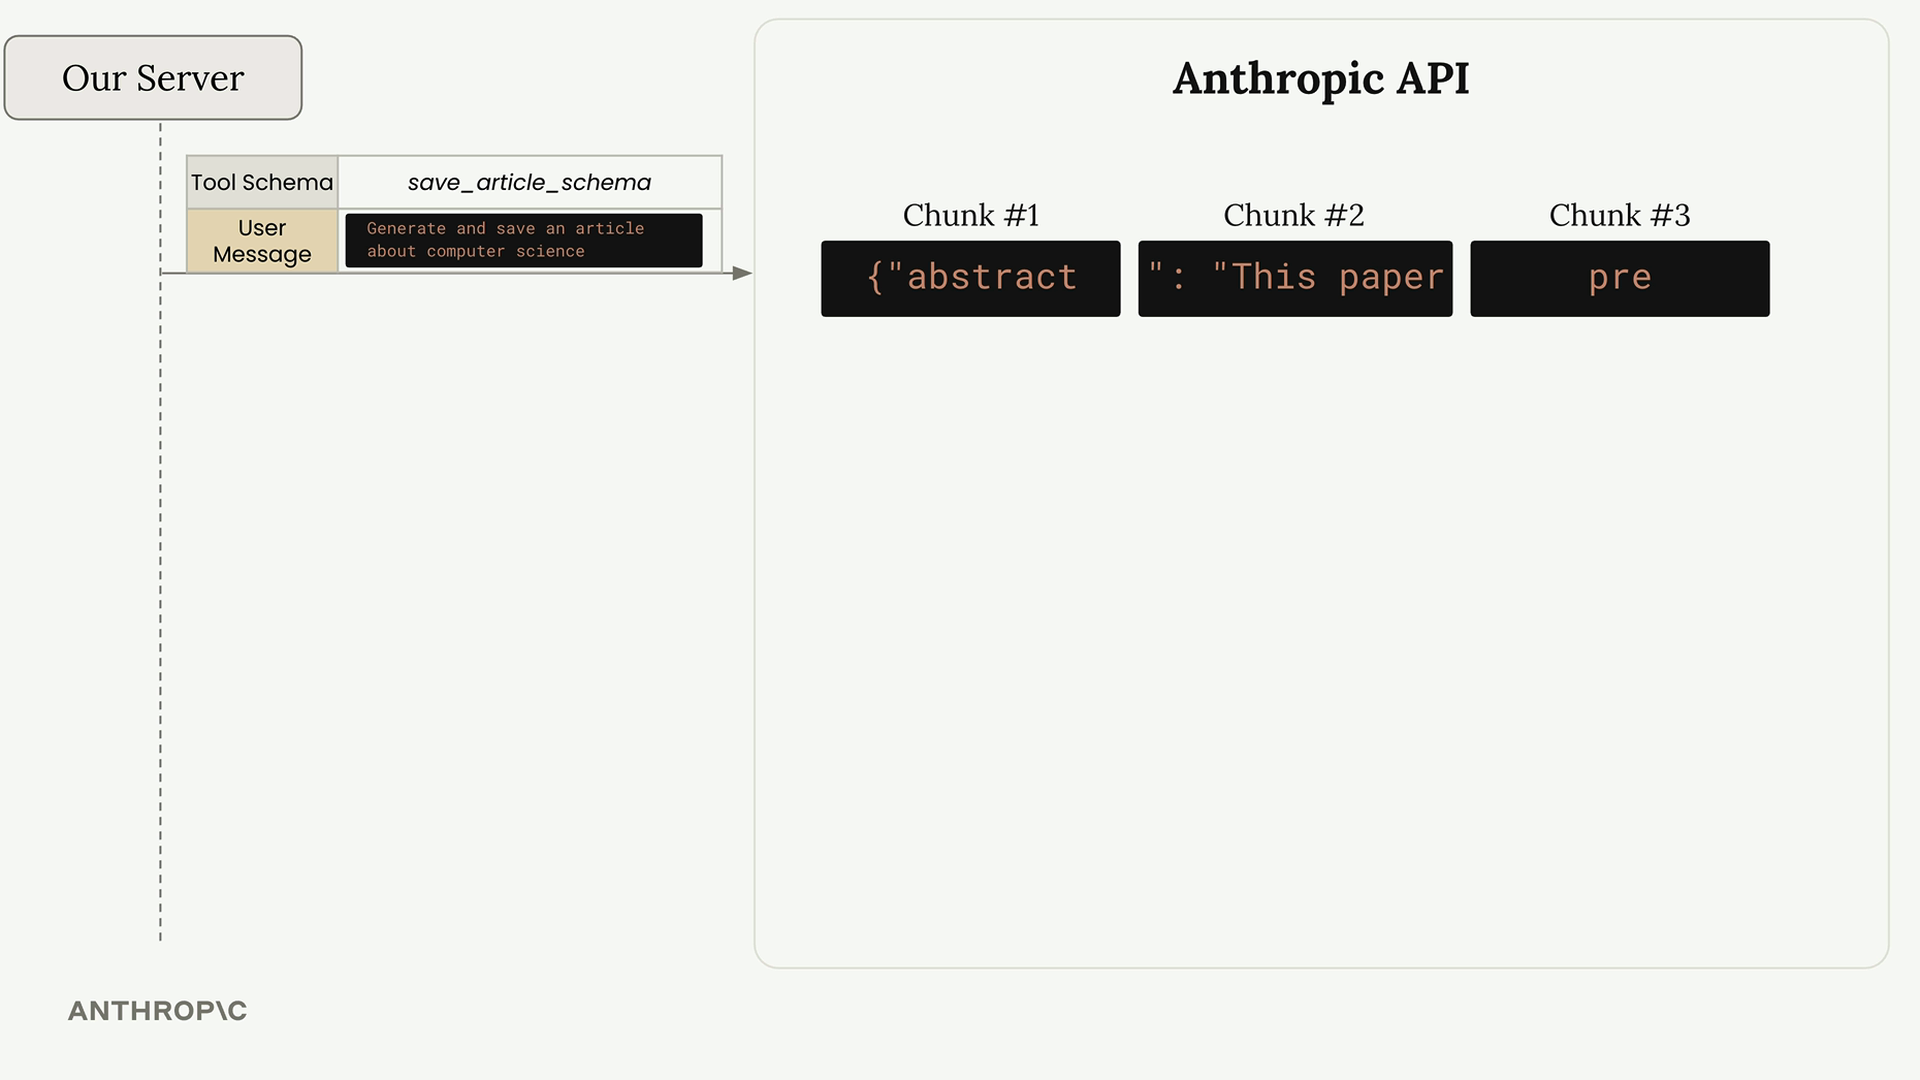
API会等待完整的顶层键值对后才发送任何内容。例如,如果您的工具期望以下结构:
{
  "abstract": "This paper presents a novel...",
  "meta": {
    "word_count": 847,
    "review": "This paper introduces QuanNet..."
  }
}
API将会:
- 等待整个
abstract值完成 - 根据您的模式验证该键值对
- 一次性发送
abstract的所有缓冲片段 - 对
meta对象重复此过程
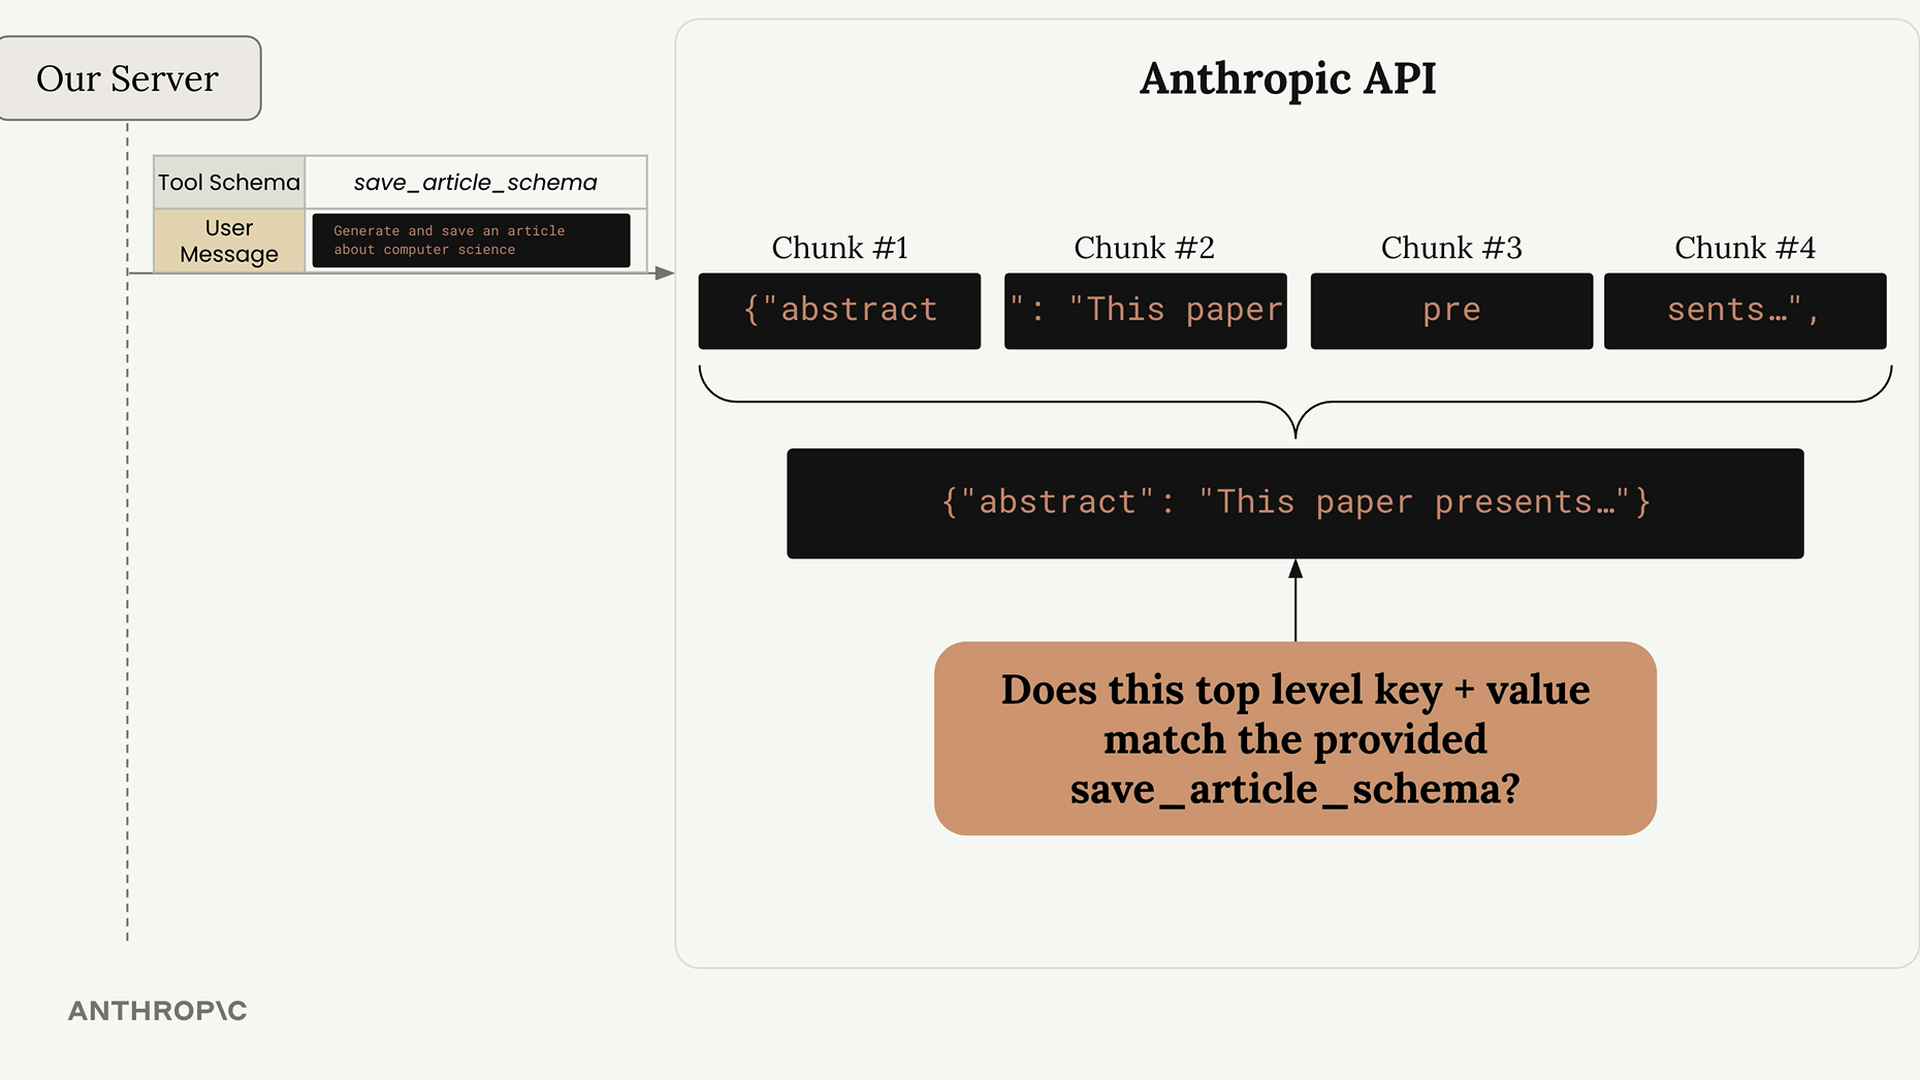
这个验证过程解释了为什么即使启用了流式传输,您仍会看到延迟后紧跟着一连串文本爆发的现象。这些片段会被保留,直到一个完整、有效的顶层键值对准备就绪。
细粒度工具调用
如果您需要更快、更细粒度的流式传输——也许是为了向用户展示即时更新或快速开始处理部分结果——您可以启用细粒度工具调用。
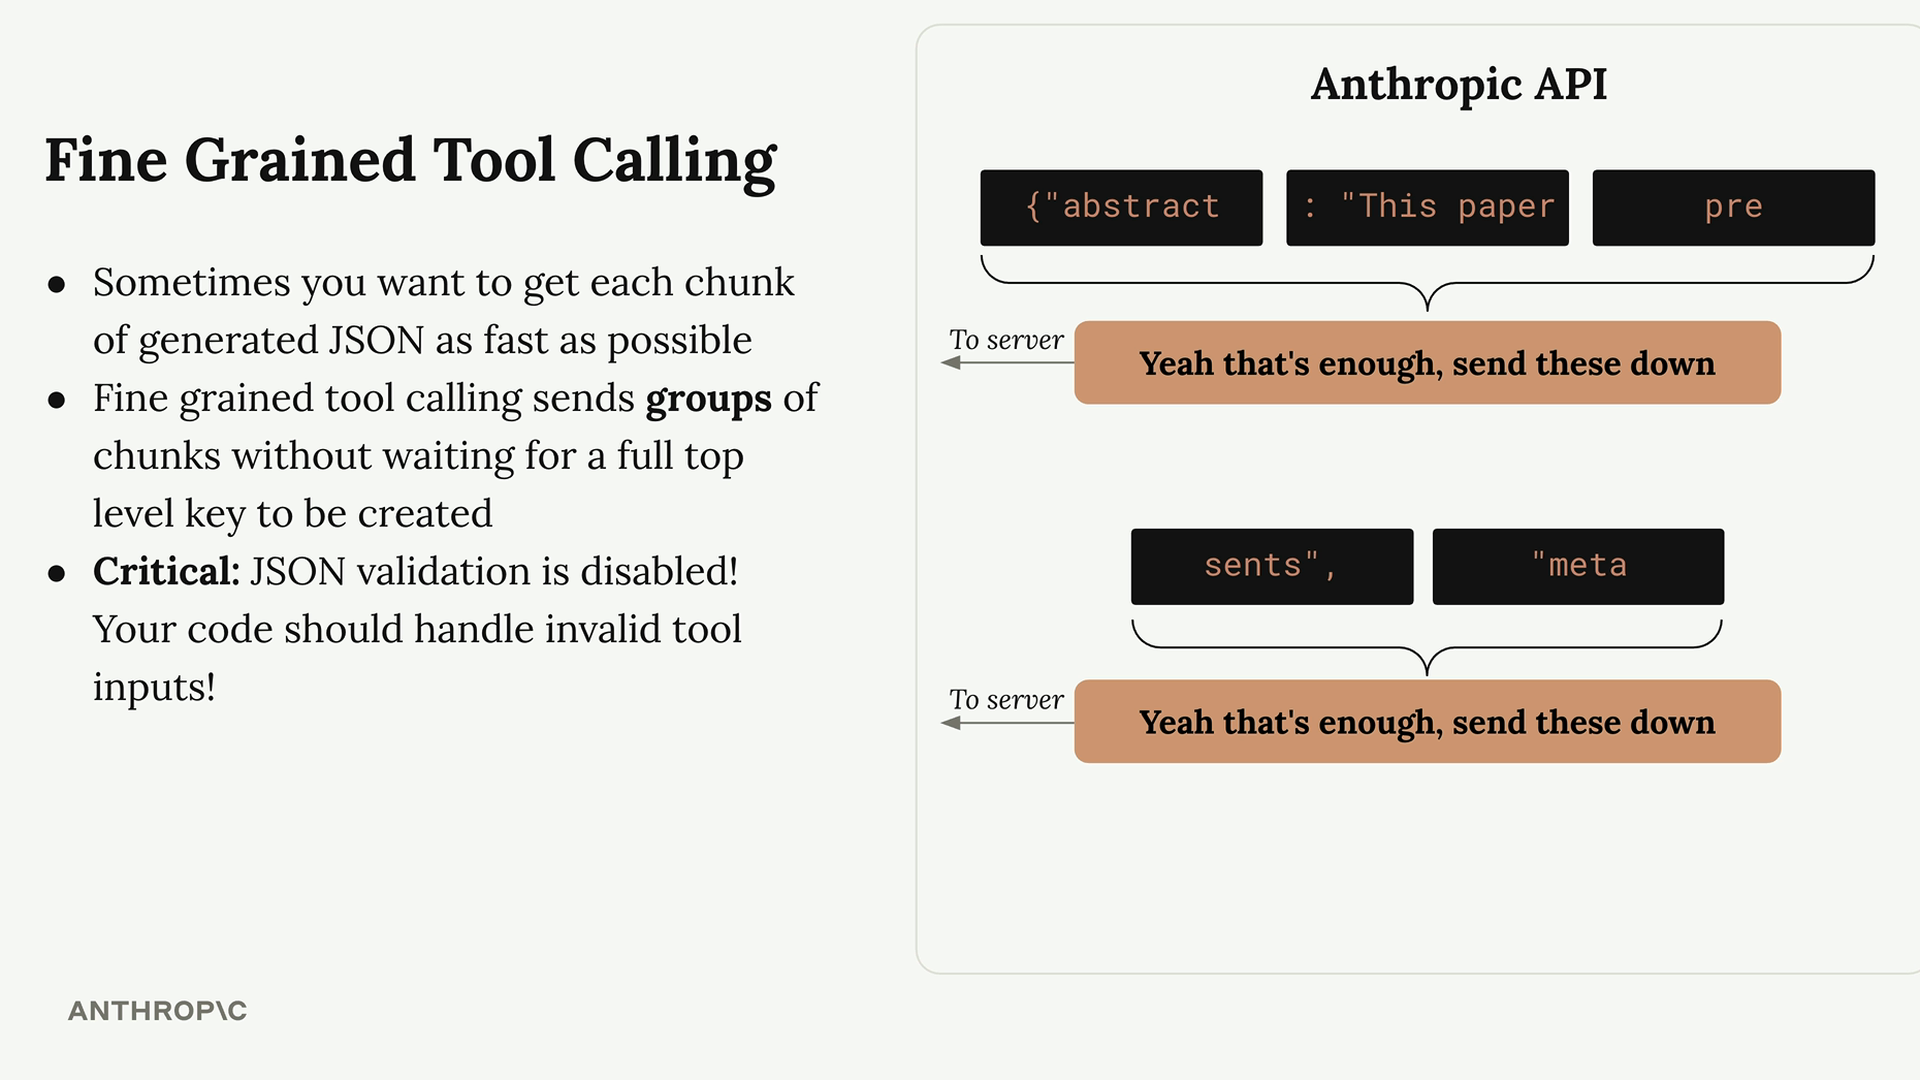
细粒度工具调用主要做一件事:它在API端禁用JSON验证。这意味着:
- 您会在Claude生成片段后立即获得它们
- 顶层键之间没有缓冲延迟
- 更传统的流式传输行为
- 关键: JSON验证被禁用——您的代码必须处理无效的JSON
通过在API调用中添加fine_grained=True来启用它:
run_conversation(
    messages,
    tools=[save_article_schema],
    fine_grained=True
)使用细粒度工具调用,您可能会在流中更早地收到word_count值,而不必等待整个meta对象完成。
处理无效JSON
使用细粒度工具调用时,Claude可能会生成无效的JSON,例如"word_count": undefined而不是正确的数字。您的应用程序需要妥善处理这些情况:
try:
    parsed_args = json.loads(chunk.snapshot)
except json.JSONDecodeError:
    # 适当处理无效的 JSON
    print("Received invalid JSON, continuing...")
如果不使用细粒度工具调用,API的验证会捕获此错误,并可能将有问题的值包装在字符串中,这可能与您期望的模式不匹配。
何时使用细粒度工具调用
在以下情况下考虑启用细粒度工具调用:
- 您需要向用户展示工具参数生成的实时进度
- 您希望尽快开始处理部分工具结果
- 缓冲延迟对您的用户体验产生了负面影响
- 您能够熟练实现健壮的JSON错误处理
对于大多数应用程序而言,带有验证的默认行为已经完全足够。但当您需要那种额外的响应性时,细粒度工具调用能让您以Claude生成片段的最快速度获取它们,从而掌握控制权。