在构建提示评估工作流时,评分系统提供关于输出质量的客观信号。评分器接收模型输出并返回某种可衡量的反馈——通常是1到10之间的数字,其中10代表高质量,1代表质量较差。
评分器的类型
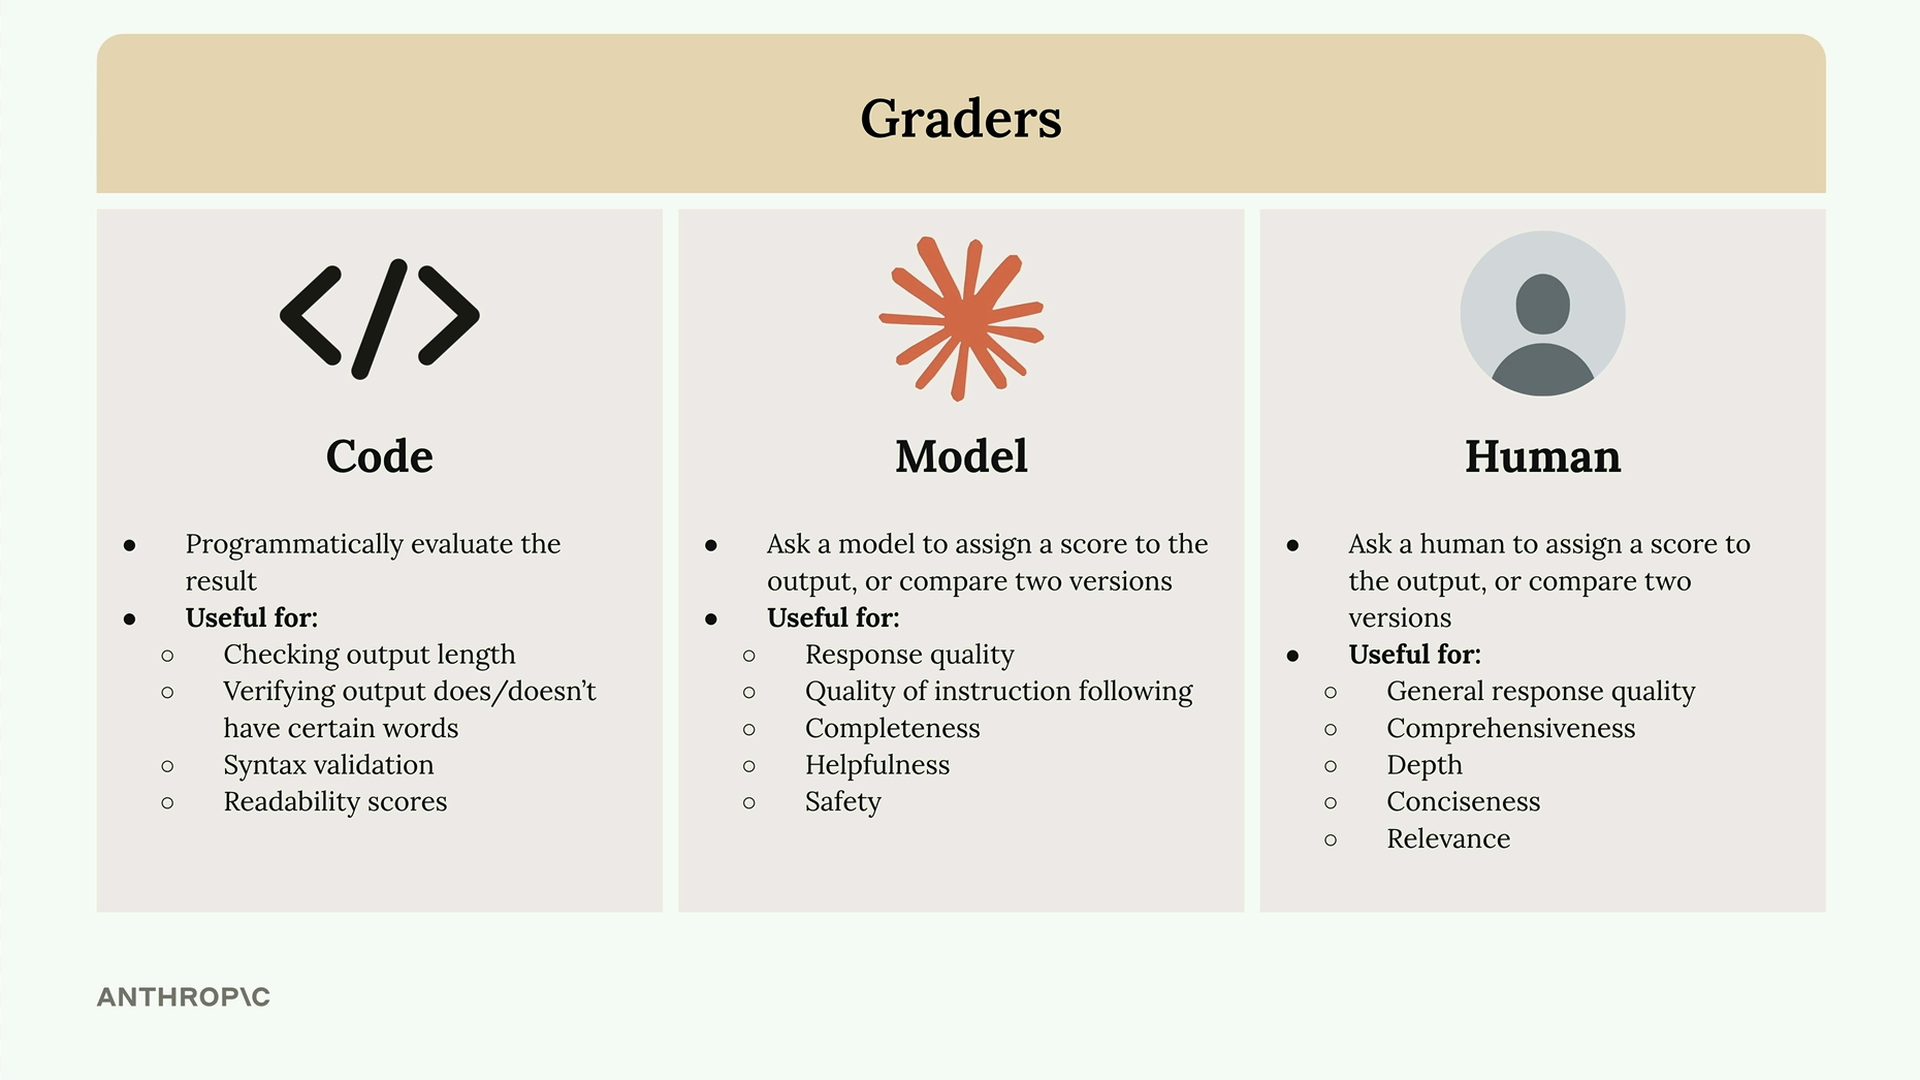
评估模型输出主要有三种方法:
- 代码评分器 - 使用自定义逻辑以编程方式评估输出
- 模型评分器 - 使用另一个AI模型来评估质量
- 人工评分器 - 让人工手动审查并打分输出
代码评分器
代码评分器让您可以实现任何您能想到的编程检查。常见用途包括:
- 检查输出长度
- 验证输出是否包含/不包含某些词语
- JSON、Python或正则表达式的语法验证
- 可读性评分
唯一的要求是您的代码返回某种可用的信号——通常是1到10之间的数字。
模型评分器
模型评分器将您的原始输出输入到另一个API调用中进行评估。这种方法在评估以下方面提供了极大的灵活性:
- 响应质量
- 指令遵循的质量
- 完整性
- 有帮助性
- 安全性
人工评分器
人工评分器提供最大的灵活性,但耗时且繁琐。它们适用于评估:
- 总体响应质量
- 全面性
- 深度
- 简洁性
- 相关性
定义评估标准
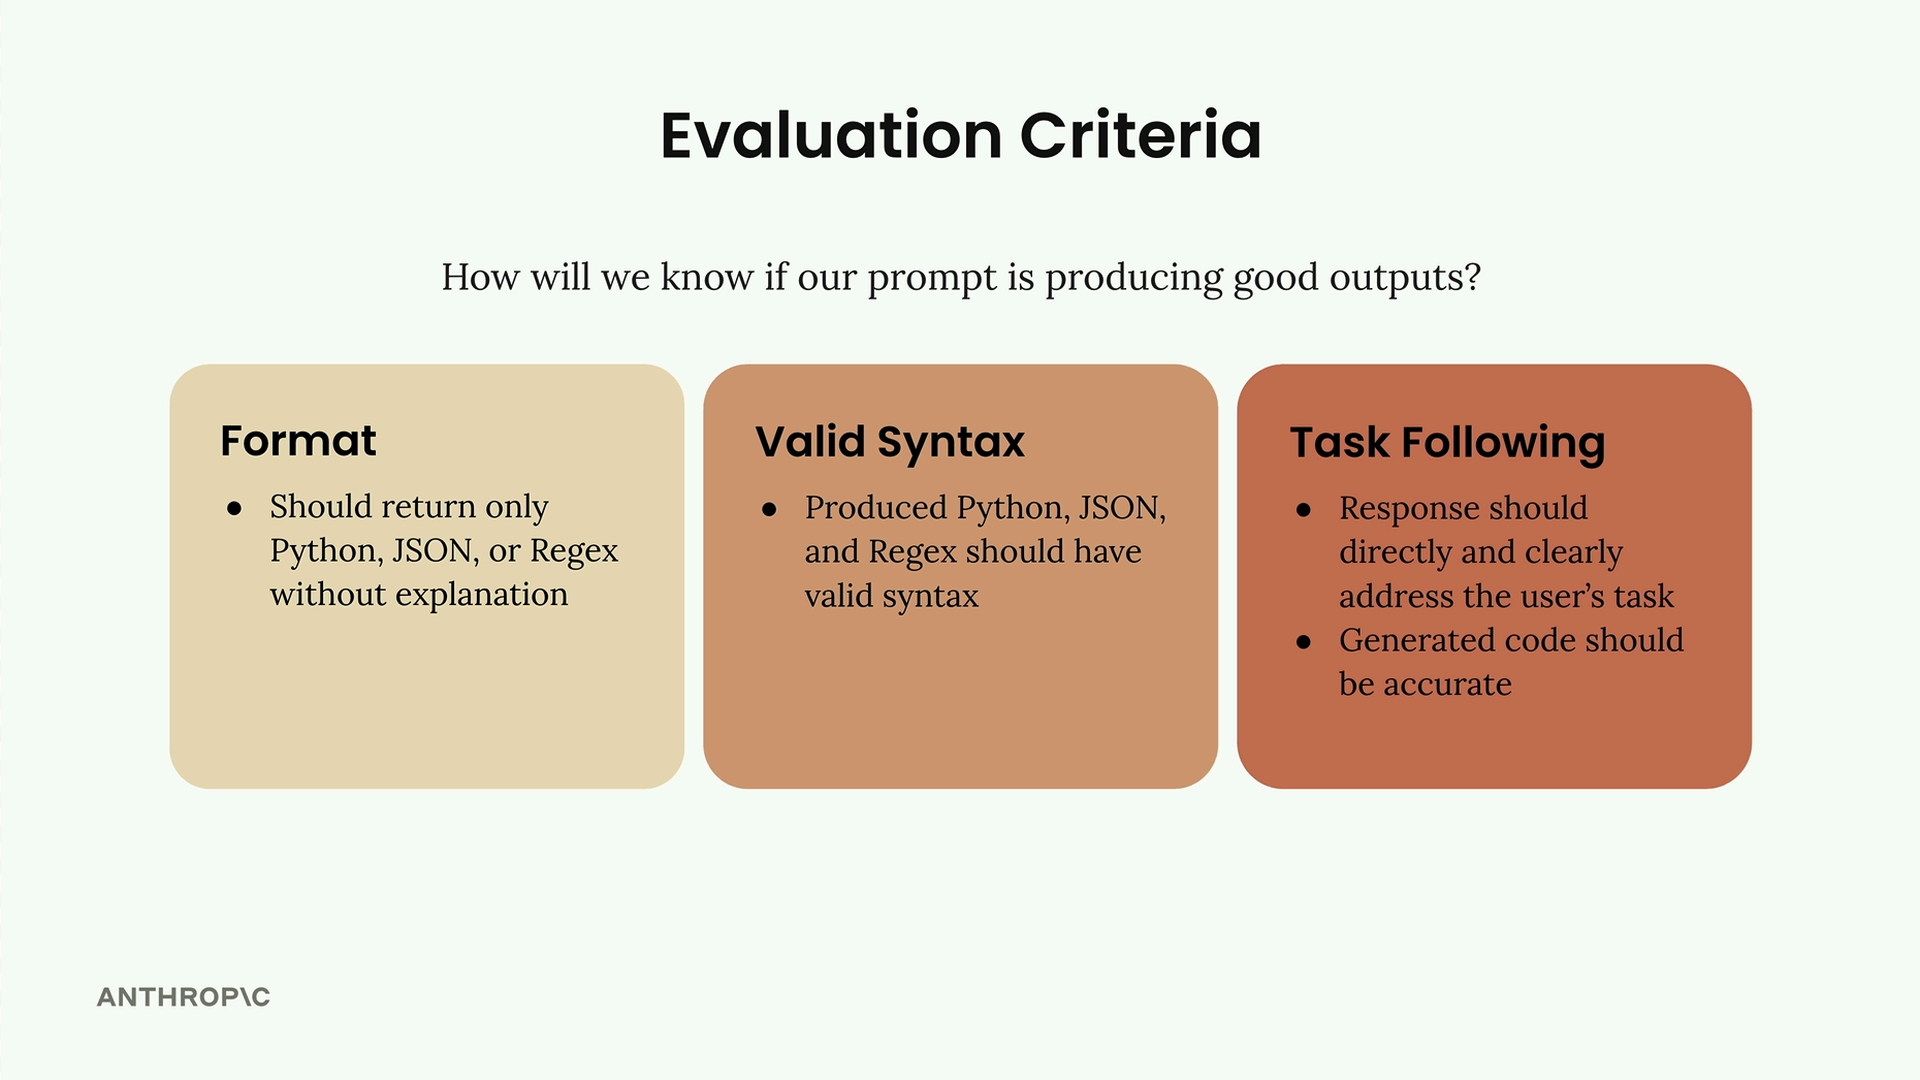
在实施任何评分器之前,您需要明确的评估标准。对于代码生成提示,您可能会关注:
- 格式 - 应仅返回Python、JSON或正则表达式,不带解释
- 有效语法 - 生成的代码应具有有效的语法
- 任务遵循 - 响应应直接针对用户的任务,并提供准确的代码
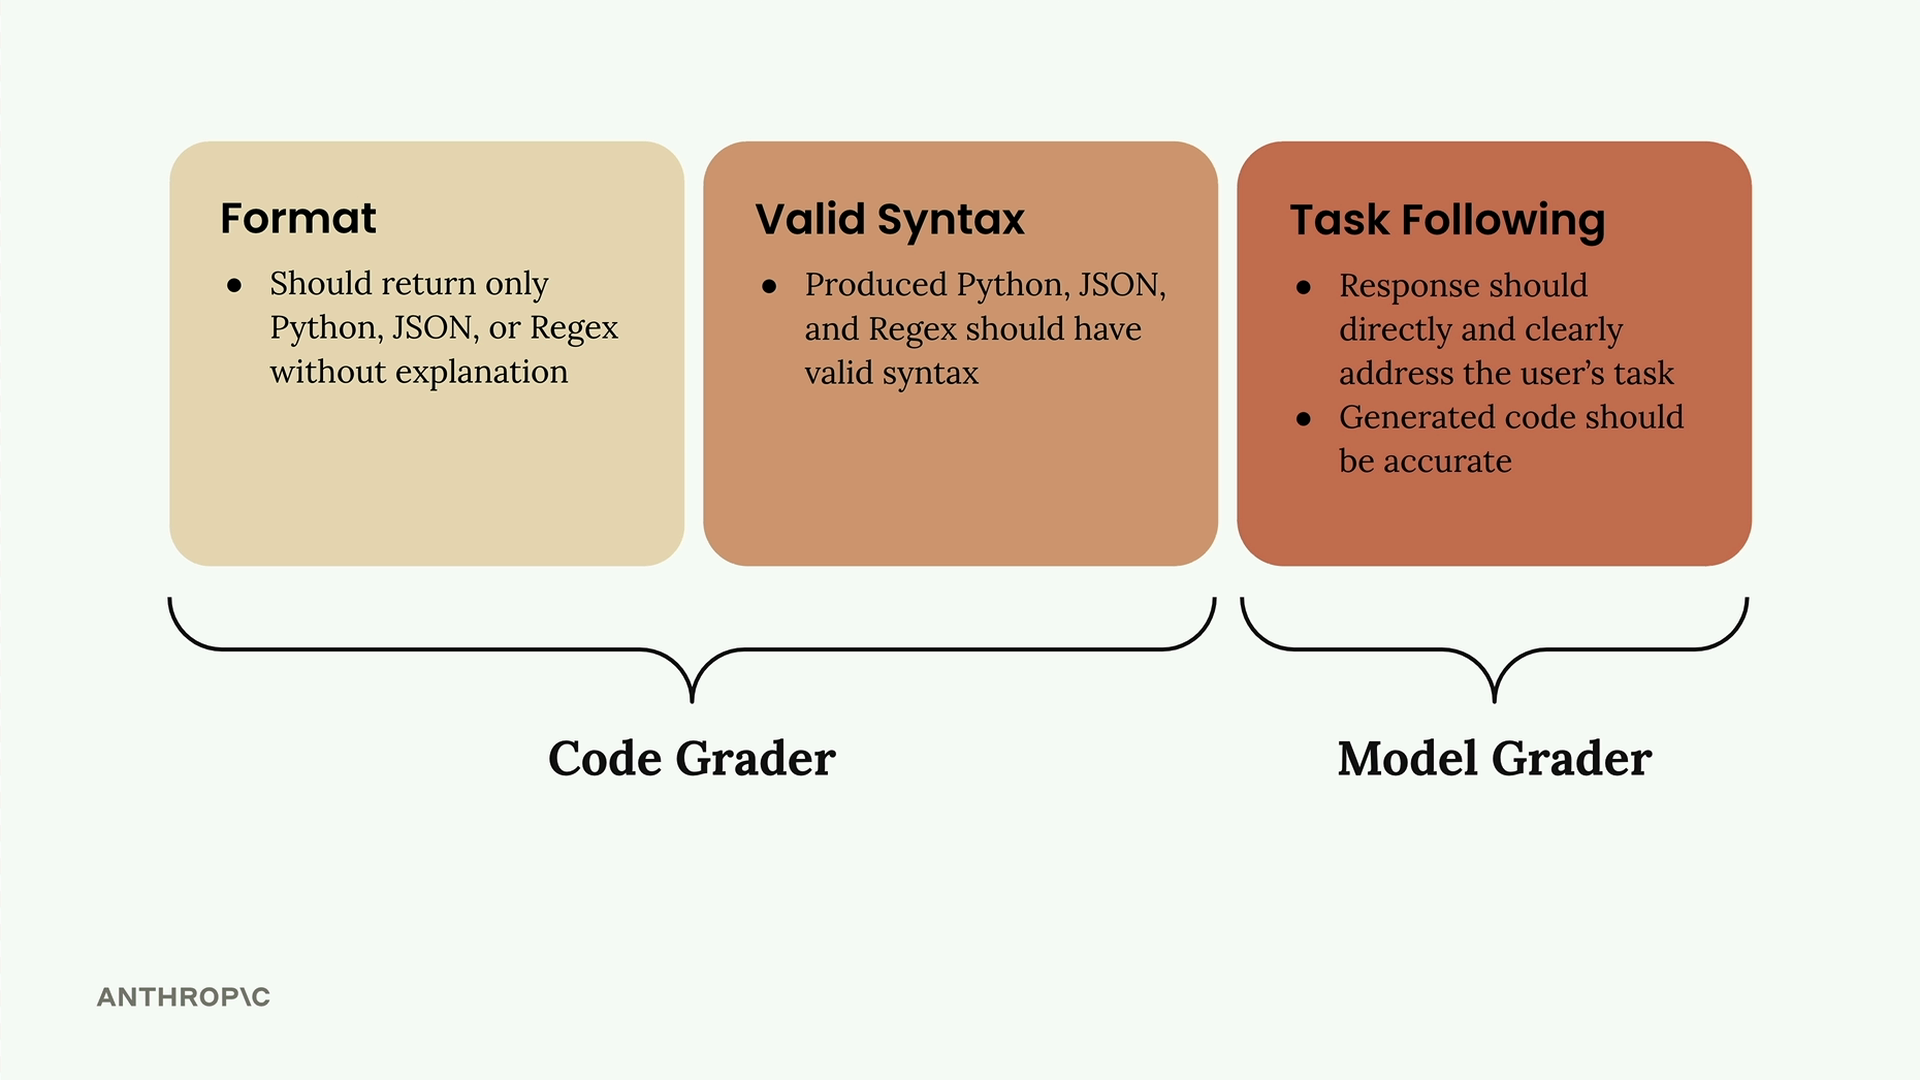
前两个标准适合使用代码评分器,而任务遵循由于其灵活性更适合使用模型评分器。
实现模型评分器
以下是构建模型评分器函数的方法:
def grade_by_model(test_case, output):
    # 创建评估提示
    eval_prompt = """
    You are an expert code reviewer. Evaluate this AI-generated solution.

    Task: {task}
    Solution: {solution}

    Provide your evaluation as a structured JSON object with:
    - "strengths": An array of 1-3 key strengths
    - "weaknesses": An array of 1-3 key areas for improvement
    - "reasoning": A concise explanation of your assessment
    - "score": A number between 1-10
    """

    messages = []
    add_user_message(messages, eval_prompt)
    add_assistant_message(messages, "```json")

    eval_text = chat(messages, stop_sequences=["```"])
    return json.loads(eval_text)
关键的洞察是在给出分数的同时要求说明优点、缺点和推理过程。如果没有这些背景信息,模型往往会默认给出大约6分的中等分数。 ## 将评分集成到您的工作流中 更新您的测试用例运行器以调用评分器: ``` def run_test_case(test_case): output = run_prompt(test_case) # Grade the output model_grade = grade_by_model(test_case, output) score = model_grade["score"] reasoning = model_grade["reasoning"] return \{ "output": output, "test_case": test_case, "score": score, "reasoning": reasoning \} ``` `` 最后,计算所有测试用例的平均分数: ``` from statistics import mean def run_eval(dataset): results = [] for test_case in dataset: result = run_test_case(test_case) results.append(result) average_score = mean([result["score"] for result in results]) print(f"Average score: \{average_score\}") return results ``` ` 这为您提供了一个客观的指标,可以在迭代提示时进行跟踪。尽管模型评分器有时可能不太稳定,但它们为衡量改进提供了一个一致的基准。 ` ``