现在我们已经从概念上理解了 RAG 流程,让我们逐步实现它。我们将通过一个完整的示例来演示如何对文本进行分块、生成嵌入、将它们存储在向量数据库中,并执行相似性搜索。
五步 RAG 实现
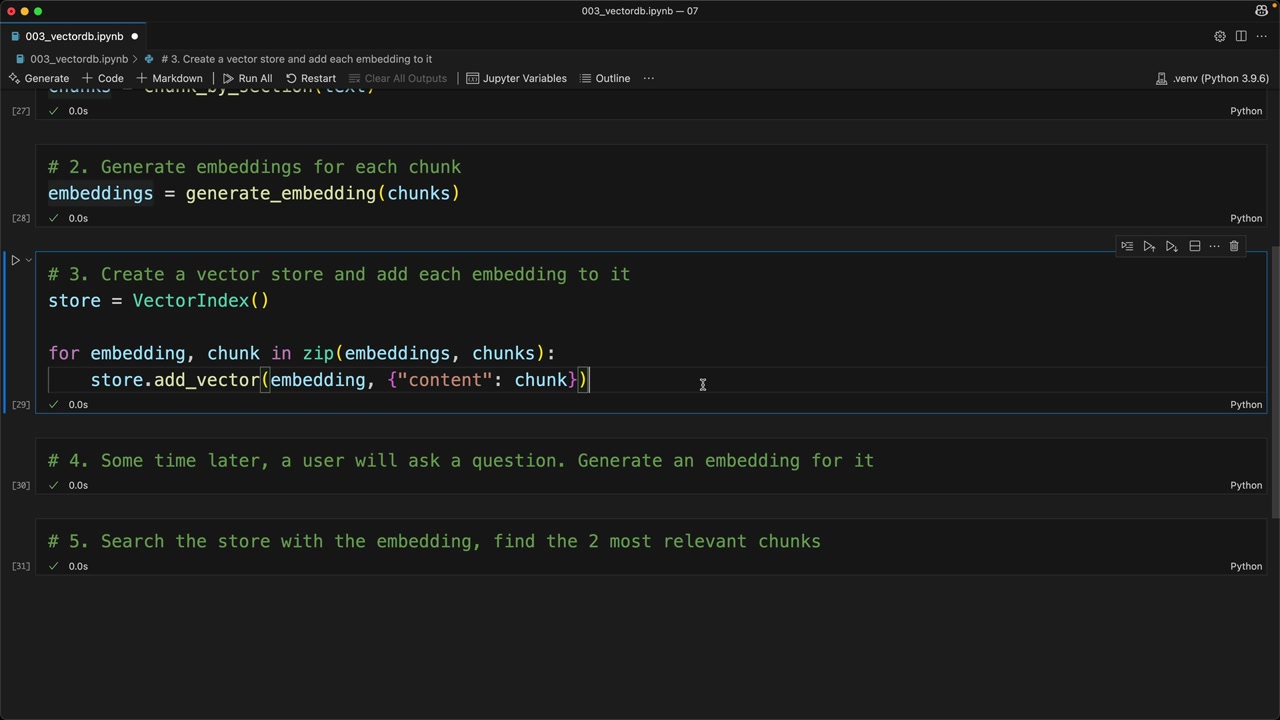
我们的实现遵循之前讨论过的相同五个步骤:
- 按章节对文本进行分块
- 为每个分块生成嵌入
- 创建一个向量存储并将每个嵌入添加到其中
- 为用户的问题生成嵌入
- 搜索存储以找到最相关的分块
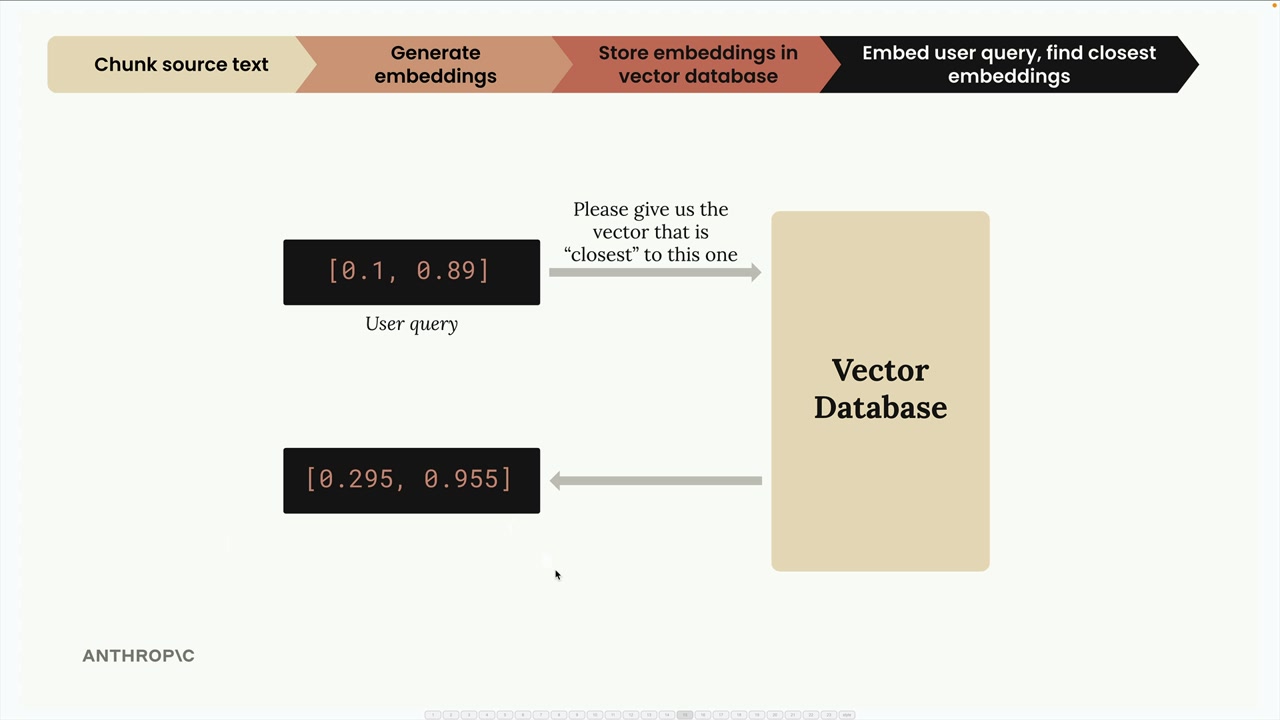
此图展示了我们如何将用户查询转换为嵌入,并搜索我们的向量数据库以找到最相关的内容。
第一步:对文本进行分块
首先,我们加载文档并将其拆分为可管理的部分:
python
with open("./report.md", "r") as f:
    text = f.read()

chunks = chunk_by_section(text)
chunks[2]  # Test to see the table of contents
我们使用之前相同的 chunk_by_section 函数,将文档拆分为逻辑上的各个部分。
第二步:生成嵌入
接下来,我们一次性为所有分块创建嵌入:
python
embeddings = generate_embedding(chunks)嵌入函数已更新,可以同时处理单个字符串和字符串列表,使其在批处理时更加高效。
第三步:存储到向量数据库
现在我们创建向量存储,并用嵌入及其关联的文本填充它:
python
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
请注意,我们同时存储了嵌入和原始文本内容。这一点至关重要,因为当我们稍后进行搜索时,需要返回实际的文本,而不仅仅是数值化的嵌入值。
为什么要存储原始文本?
当我们查询向量数据库时,仅仅得到嵌入数字是没有用的。我们需要用于生成这些嵌入的实际文本。这就是为什么我们要在数据库中将原始分块文本(或至少是对它的引用)与每个嵌入一起存储。
第四步:处理用户查询
当用户提出问题时,我们为其查询生成一个嵌入:
python
user_embedding = generate_embedding("What did the software engineering dept do last year?")第五步:查找相关内容
最后,我们搜索向量存储以找到最相似的分块:
python
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
此搜索返回两个最相关的分块及其相似度分数(余弦距离)。
搜索结果向我们展示了文档中哪些部分与用户的问题最相关,并附有相似度分数。
理解结果
当我们运行关于软件工程部门的示例查询时,我们得到:
- 第 2 节:软件工程,距离为 0.71(最接近的匹配)
- 方法论部分,距离为 0.72(第二接近)
距离值越低表示相似度越高,因此第 2 节与我们的查询最相关。
接下来是什么?
这种实现方式在基本情况下效果良好,但在某些场景下它的表现不如预期。在接下来的部分中,我们将探讨一些改进措施,使我们的 RAG 系统更加稳健和准确。
关键要点是,RAG 从根本上来说是将文本转换为数字(嵌入),高效地存储这些数字,然后在用户提出问题时使用数学相似性来查找相关内容。